Как мультимодальные модели научились понимать товар, а не картинку
Меня зовут Владимир Старыгин и я старший исследователь в команде ритейла в tevian [1]. Сегодня поговорим о мультимодальных моделях в e-commerce и попробуем разобраться, зачем вообще понадобилось очередное большое направление исследований, если поиск по фотографии научились делать уже довольно давно.
На первый взгляд задача выглядит почти закрытой. Берём фотографию товара, прогоняем ее через нейросеть и получаем его цифровое представление, которое впоследствии будем называть эмбеддингом или дескриптором. Каталог заранее превращаем в такой же набор эмбеддингов, после чего остаётся посчитать расстояния между этими векторами и показать пользователю ближайшие результаты.
Пользователь сфотографировал белые кроссовки – получил белые кроссовки. Что ещё нужно и что может пойти не так?
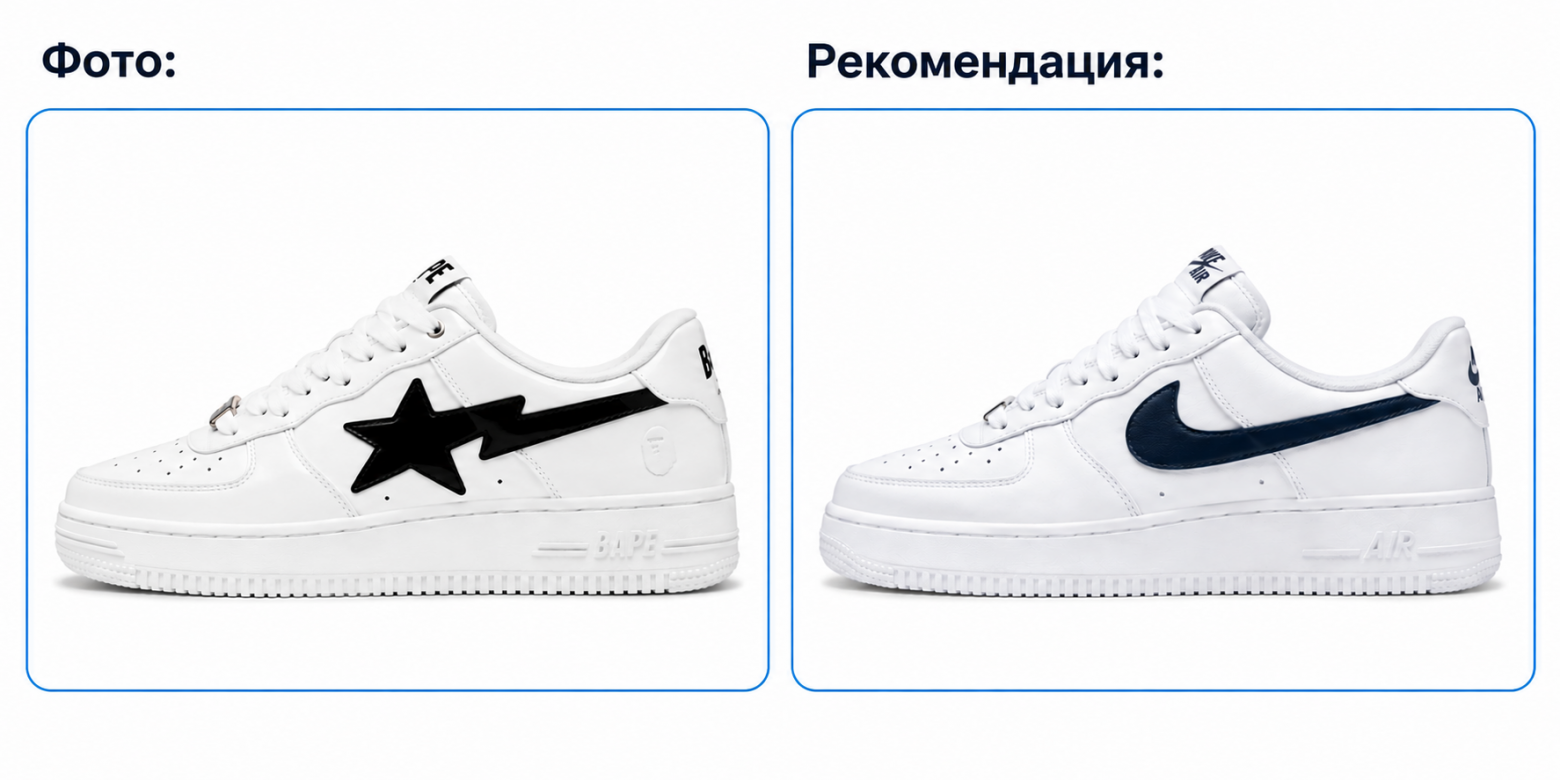
Может, например, найтись очень красивый белый светильник в форме кроссовка. Это немного утрированный пример, но сама проблема вполне настоящая. Визуальный поиск хорошо отвечает на вопрос «что здесь похоже?», а магазину часто нужен более конкретный ответ: это тот же товар или просто что-то очень похожее?
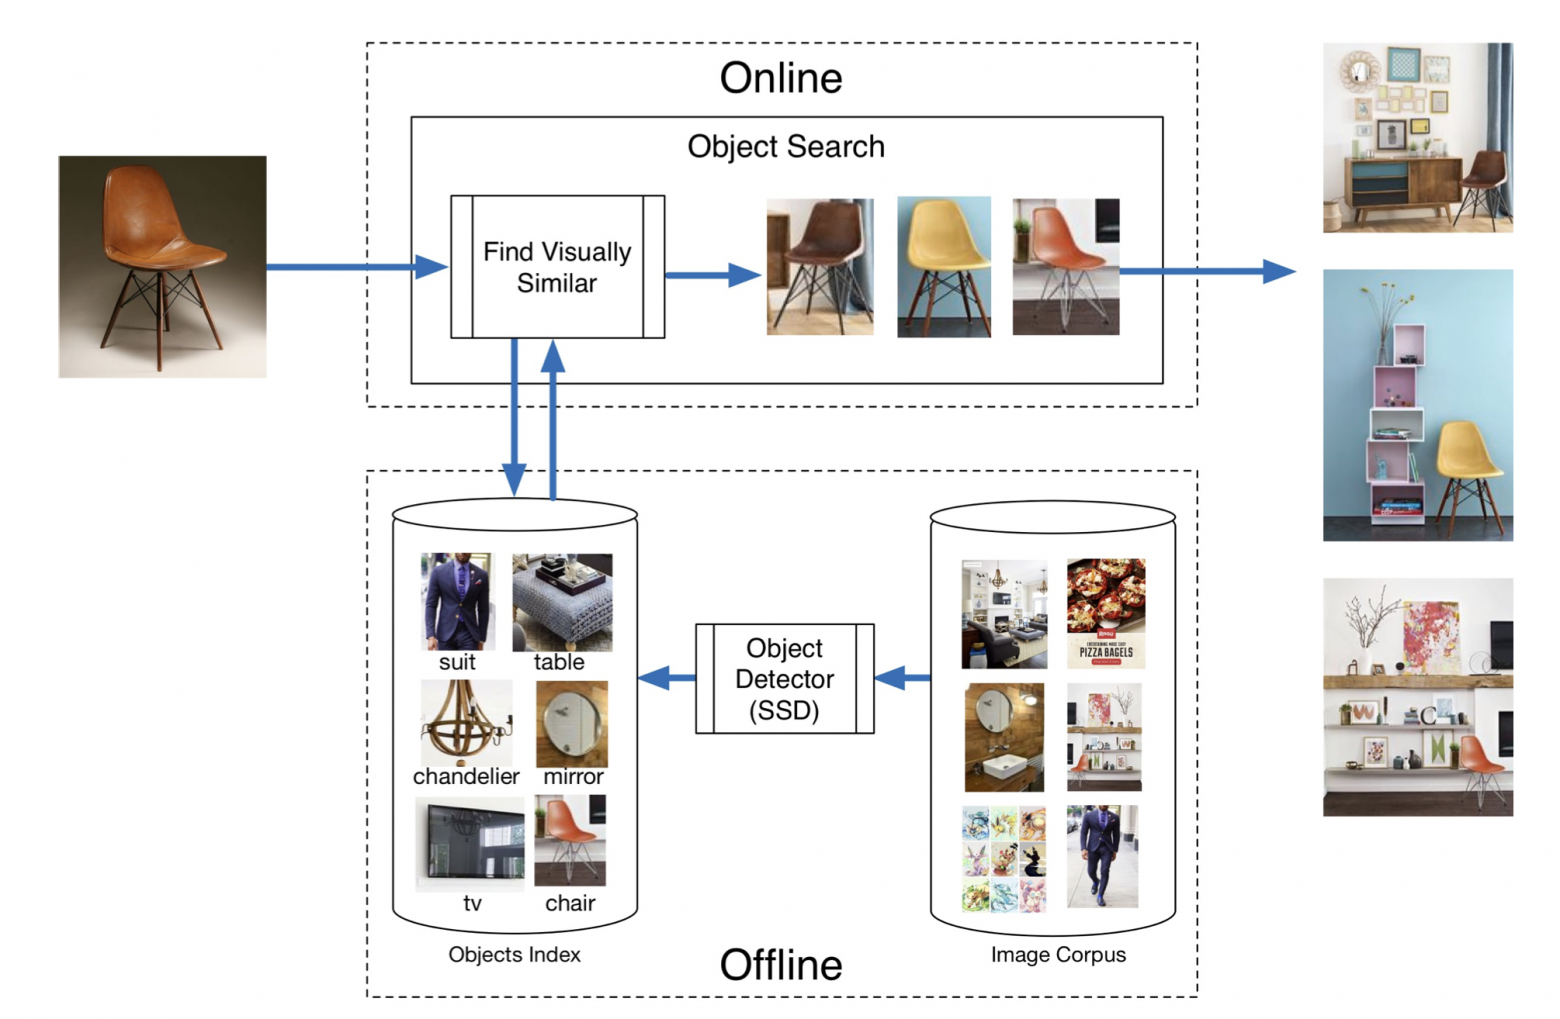
Ещё в 2017 году Pinterest [2] описывал свою систему Visual Discovery: признаки сверточной сети использовались для поиска визуально похожих изображений и объектов, а Pinterest Lens позволял выбрать предмет на фотографии и искать похожие объекты уже внутри огромного каталога изображений. Это хороший пример того, насколько далеко можно было уехать на визуальных признаках ещё до нынешней волны мультимодальных моделей.
Но попробуем чуть усложнить задачу. Есть две модели кроссовок одного бренда. Цвет одинаковый, силуэт почти не отличается, но у одной другая подошва и небольшая вставка на пятке. Для человека, который просто ищет «что-нибудь похожее», оба результата нормальные. Для поиска конкретного SKU один из них уже ошибка [3].
А теперь добавим реальный каталог. У одного SKU может быть пять фотографий, название, описание и десяток характеристик. На одной фотографии хорошо виден силуэт, на другой – подошва, на третьей – логотип, а на четвёртой вообще размерная сетка. В характеристиках при этом может быть указан материал, который по фотографии не определить.
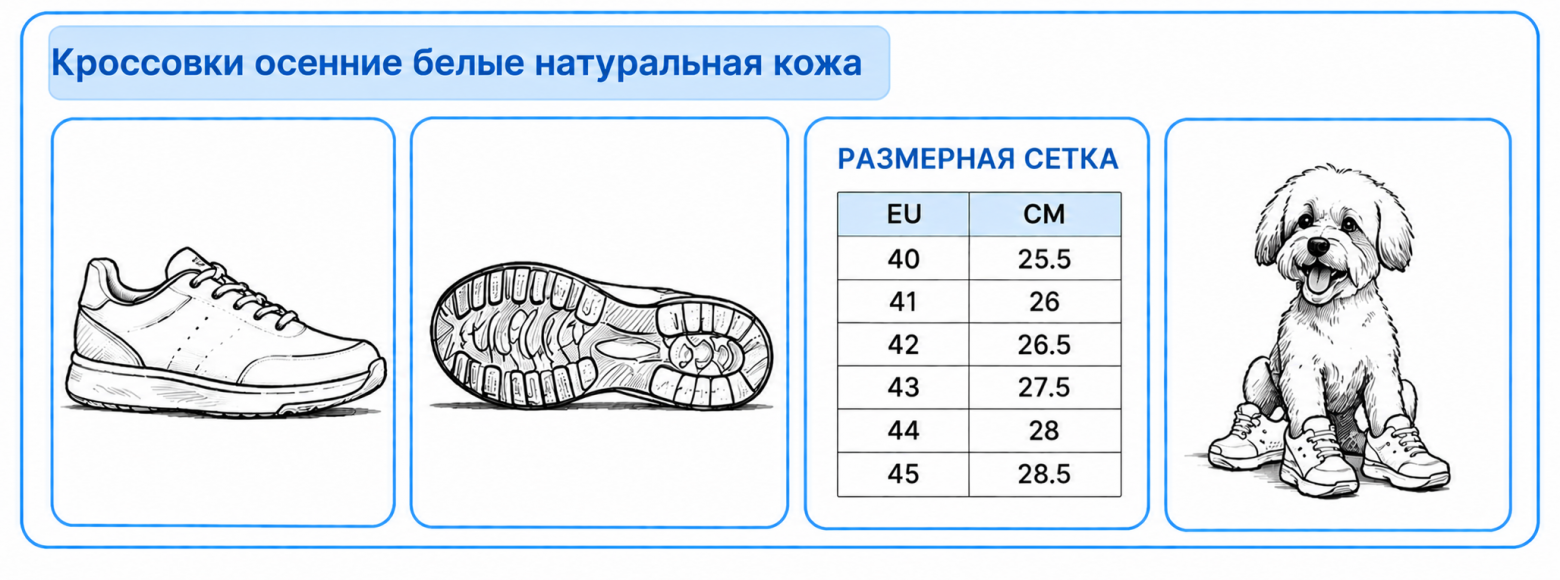
Глядя на всё это, исследователи довольно быстро пришли к естественному вопросу: почему при построении рекомендательных и поисковых систем мы вообще пытаемся описать товар только через одну модальность?
У товара уже есть несколько источников информации. Фотографии показывают форму, цвет и визуальные детали, название может содержать модель и назначение, характеристики – размер, материал и состав. Иногда к этому добавляется ещё и поведение [4] пользователей, которое тоже помогает понять, какие товары оказываются близки друг к другу.
И тут становится интересно: что именно мы хотим упаковать в эмбеддинг – одну фотографию или представление самого товара, собранное из всей доступной информации? Примерно вокруг этого вопроса и начала развиваться мультимодальная часть e-commerce.
Для начала немного формализма
Пусть изображение товара проходит через визуальный энкодер и превращается в вектор:
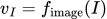
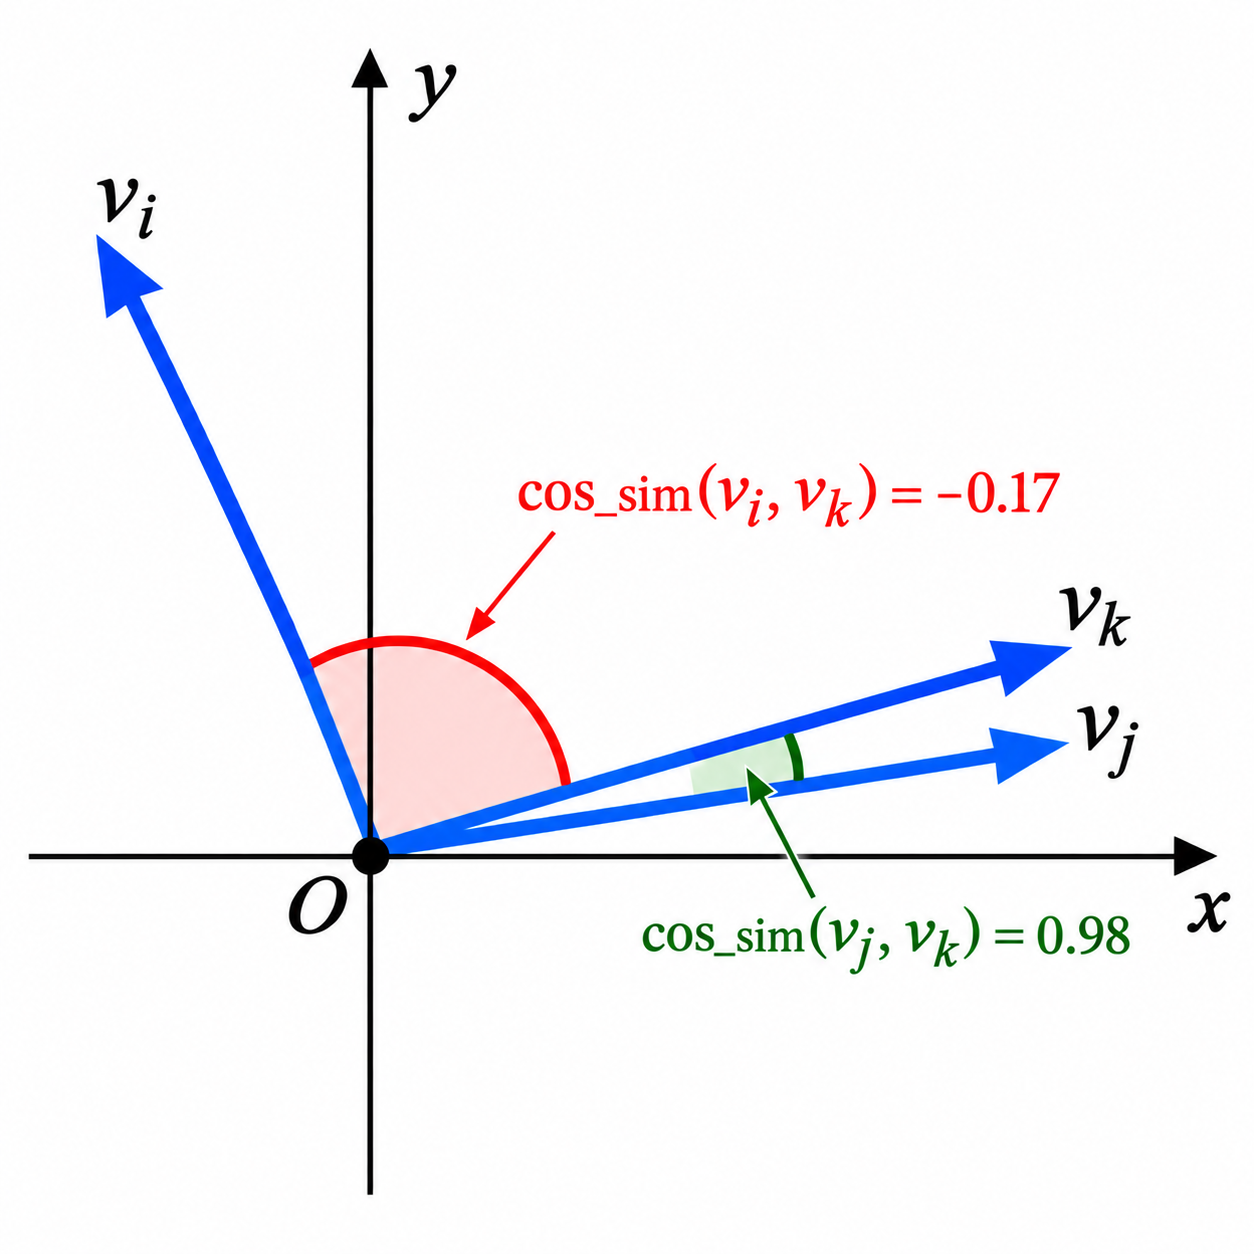
Другой товар превращается в  . Самый простой поиск дальше сводится к сравнению двух векторов, например, по евклидову расстоянию (однако в задачах поиска принято использовать косинусную схожесть). Чем они ближе, тем выше товар оказывается в выдаче.
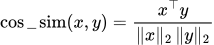
В этом подходе нет ничего плохого. Он отлично работает, пока интересующая нас информация действительно находится на обоих изображениях, но эти условия выполняются далеко не всегда.
Возьмем две белые футболки. У первой обычный хлопок, у второй спортивная синтетическая ткань. При одинаковом ракурсе и похожем крое визуально они могут быть очень близкими. Или обратная ситуация: одна и та же куртка снята сначала на белом фоне, а потом на человеке на улице.
Поэтому довольно быстро возникла идея: хорошо бы дополнить визуальное представление текстовой информацией – например, описанием товара.
«Вот это, только с длинными рукавами»
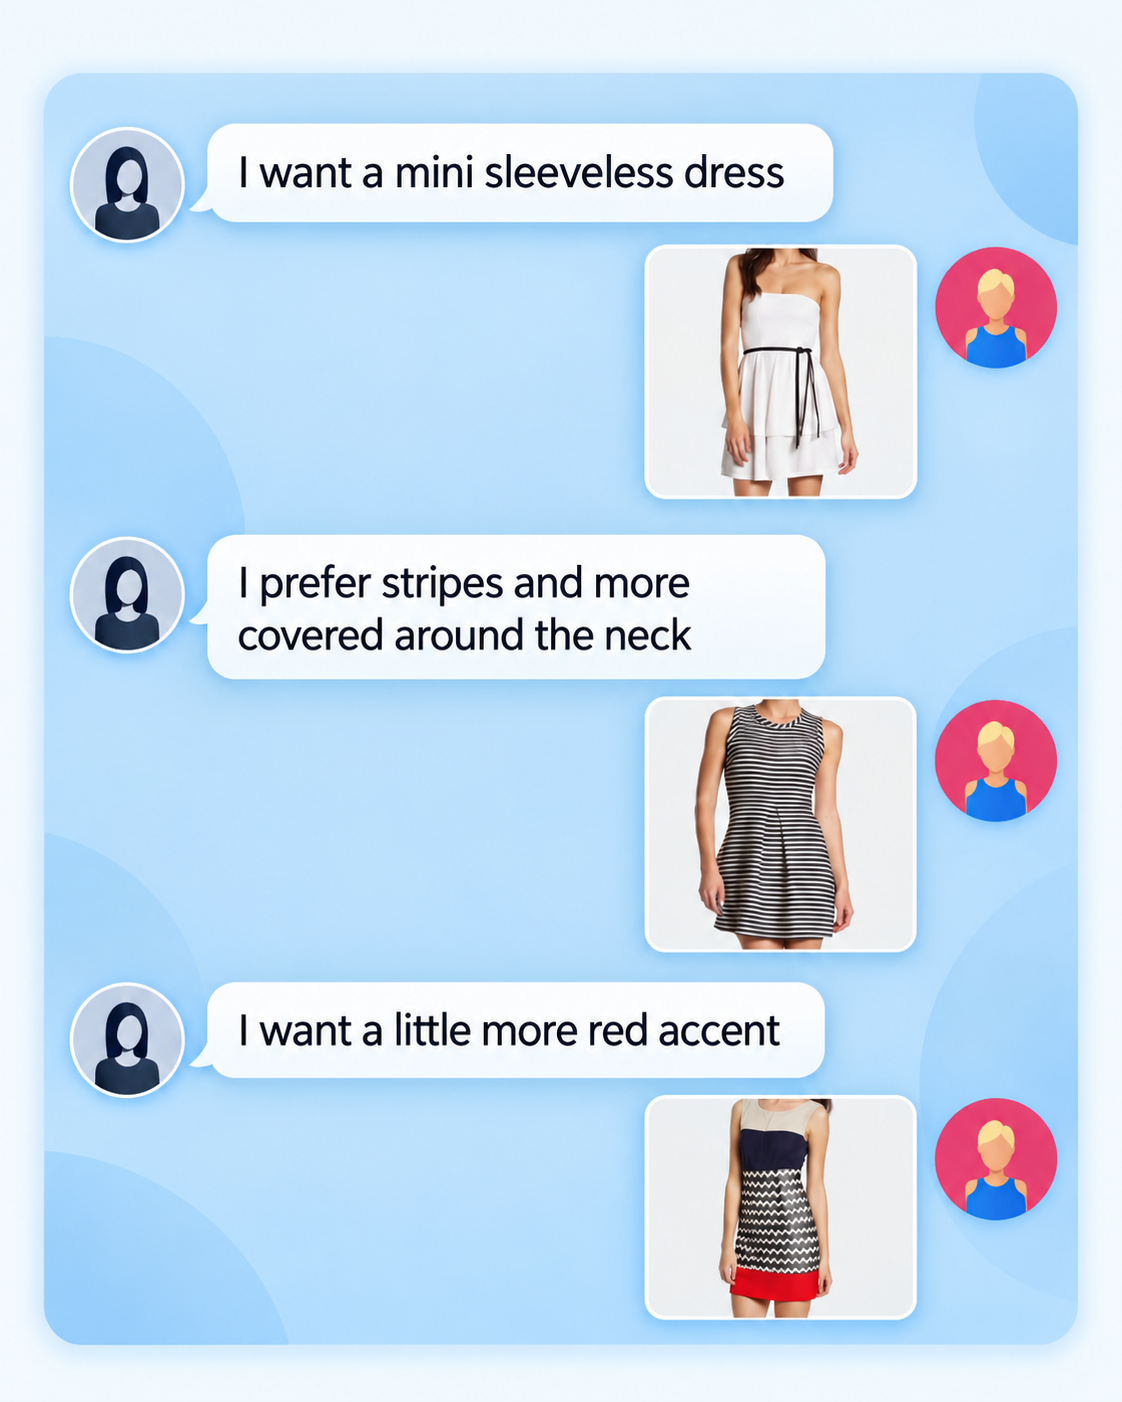
Хороший пример – Fashion IQ [6]. Авторы предложили задачу interactive fashion retrieval, в которой недостаточно просто дать системе картинку. Пользователь может объяснить словами, чем искомая вещь должна отличаться от исходной, а также отреагировать на неверно выданную картинку новыми уточнениями. Так у пользователя выстраивается диалог с системой, правда отвечает она только изображениями.
Сам датасет содержит сгенерированные человеком описания, показывающие различия между похожими предметами одежды. Условно запрос может выглядеть так:Мне нравится это платье, но хочу похожее с длинными рукавами.
Для обычного image retrieval задача довольно неприятная. Нужно сохранить часть свойств исходной вещи и одновременно изменить другие.
Причём пользователь не обязан формулировать запрос через заранее заданный набор атрибутов вроде color, sleeves или length: он может свободно описать нужное изменение естественным языком. При этом сам Fashion IQ содержит дополнительные атрибуты товара, которые модель может использовать как дополнительный источник информации [7]. Поэтому задача модели – совместить визуальные признаки, атрибуты и свободную пользовательскую формулировку в одном процессе поиска.
Уже здесь картинка перестаёт быть единственной характеристикой товара.
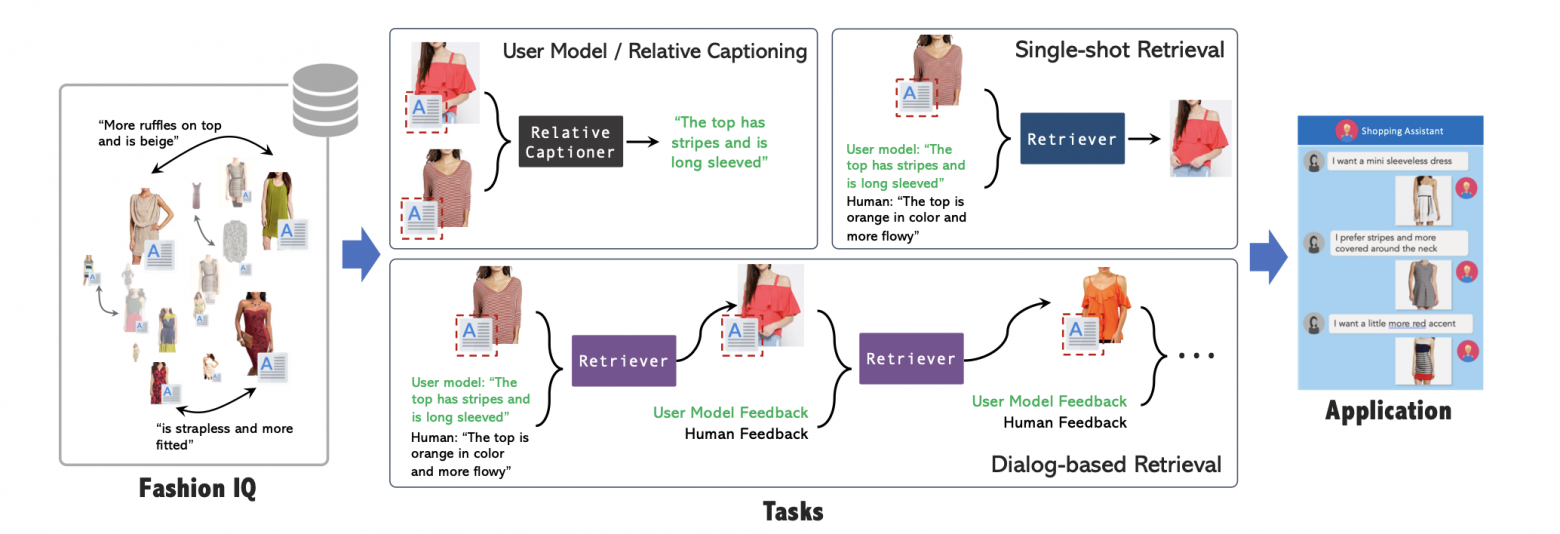
(Figure 5 из статьи)
Авторы здесь рассмотрели несколько видов обучения [8] и несколько разных задач, в которые подробно углубляться не будем. В качестве основной архитектуры для диалогового поиска авторы предложили multimodal transformer, который объединяет признаки изображения, атрибуты товара, текстовую обратную связь пользователя и историю предыдущих шагов диалога.
До CLIP был ещё любопытный промежуточный эпизод – FashionBERT [9]. В 2020 году, ещё до появления ViT [10], авторы разбивали изображение товара на патчи, извлекали для каждого признаки сверточной нейронной сетью и вместе с текстовыми токенами подавали их в общий BERT [11]. Отдельной разметки вида «слово воротник соответствует этому участку изображения» не было; напрямую согласовывать текст и изображение модель заставляла задача Text–Image Alignment, где нужно определить, относятся ли они к одному товару. В контексте нашей истории интересно прежде всего то, что изображение уже начали рассматривать как последовательность визуальных токенов, хотя полноценного ViT тогда ещё не было.
Потом появился CLIP, и всё стало очень удобно.
До vision-language pretraining модели компьютерного зрения [12] довольно часто были жёстко привязаны к заданному на обучении набору атрибутов. CLIP [13] предложил обучать визуальную и текстовую модель совместно: правильные пары «изображение – текст» сближаются, неправильные – раздвигаются. Для обучения авторы использовали 400 млн пар изображение–текст. После такого обучения текст можно использовать как запрос к визуальному пространству, а названия новых классов – как текстовые prompts для zero-shot классификации.
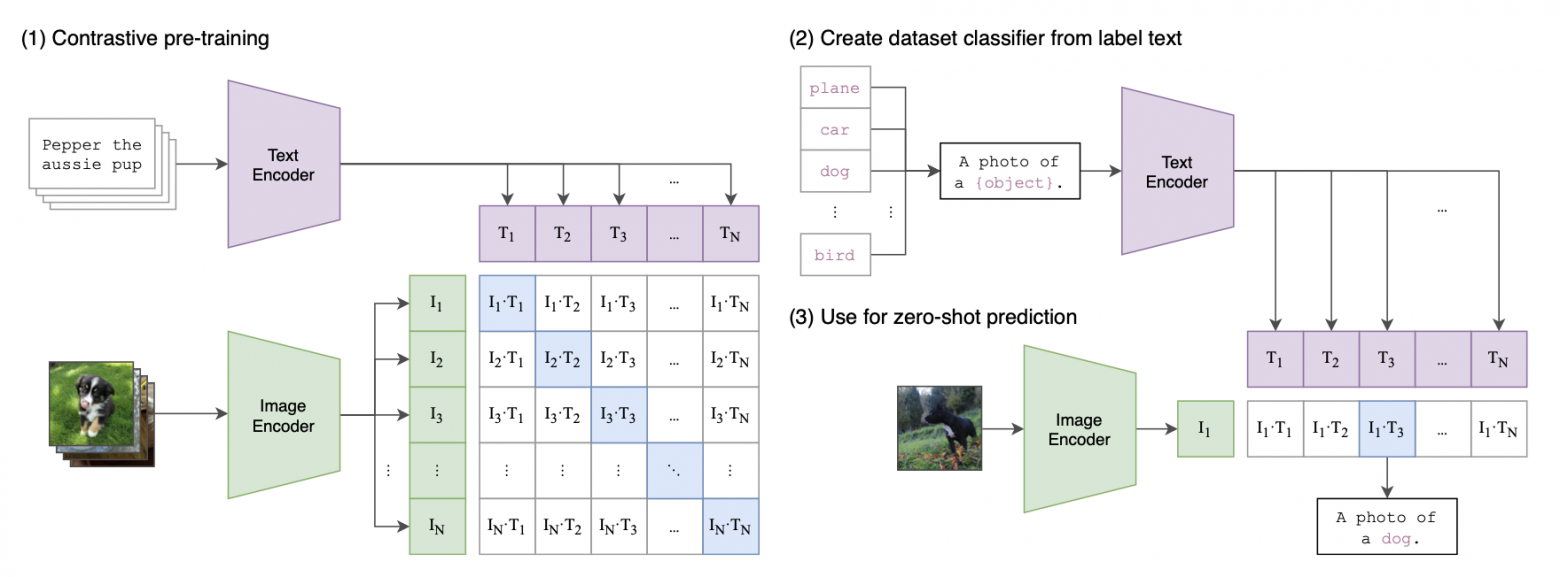
Для интернет-магазина идея выглядит почти идеально.
Есть фотография: картинка белой льняной рубашки
И есть текстовый запрос: белая льняная рубашка
Оба превращаются в векторы одного пространства, и дальше их можно сравнивать. Лосс для обучения этих моделей тоже знаменит и используется часто в других работах:
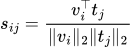
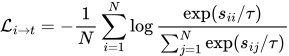
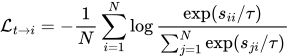
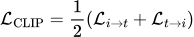
Если изображение и описание соответствуют друг другу, модель должна сделать  большим. Для остальных текстов в батче – наоборот, меньшим. Лосс здесь разбивается на две части, потому что авторы хотят по изображению найти правильный текст и в то же время по тексту найти правильное изображение.
И все было бы хорошо, но тут мы упираемся в специфику каталога. Интернет в целом и интернет-магазин – не совсем один домен. Допустим, общая модель хорошо понимает, что dress, evening dress и summer dress находятся где-то рядом. Для обычного понимания картинки этого достаточно. Для магазина это могут быть разные категории, фильтры и совершенно разная выдача.
Кроме того, у товаров есть понятия, которые в обычных image-text данных встречаются гораздо реже: конкретные материалы, особенности фасона, модельные названия, технические атрибуты.
Поэтому довольно быстро начали появляться специализированные e-commerce варианты CLIP-подобных моделей именно для интернет-магазинов. Более того, стоит отметить, что обучать с нуля такие модели непросто. В оригинальном CLIP использовался глобальный batch size 32768. Для contrastive learning большой батч особенно полезен: каждый объект получает огромное количество in-batch negatives, хотя ценой становятся серьёзные требования к вычислениям. Точное воспроизведение такого режима обучения требует серьёзных вычислительных ресурсов.
Вернемся к ритейлу и подобным моделям. В e-CLIP [14], например, авторы обучали contrastive-модель на сотнях миллионов пар товарных изображений и текстов, а затем проверяли полученные дескрипторы сразу на нескольких прикладных задачах: category classification, attribute extraction, product matching и clustering.
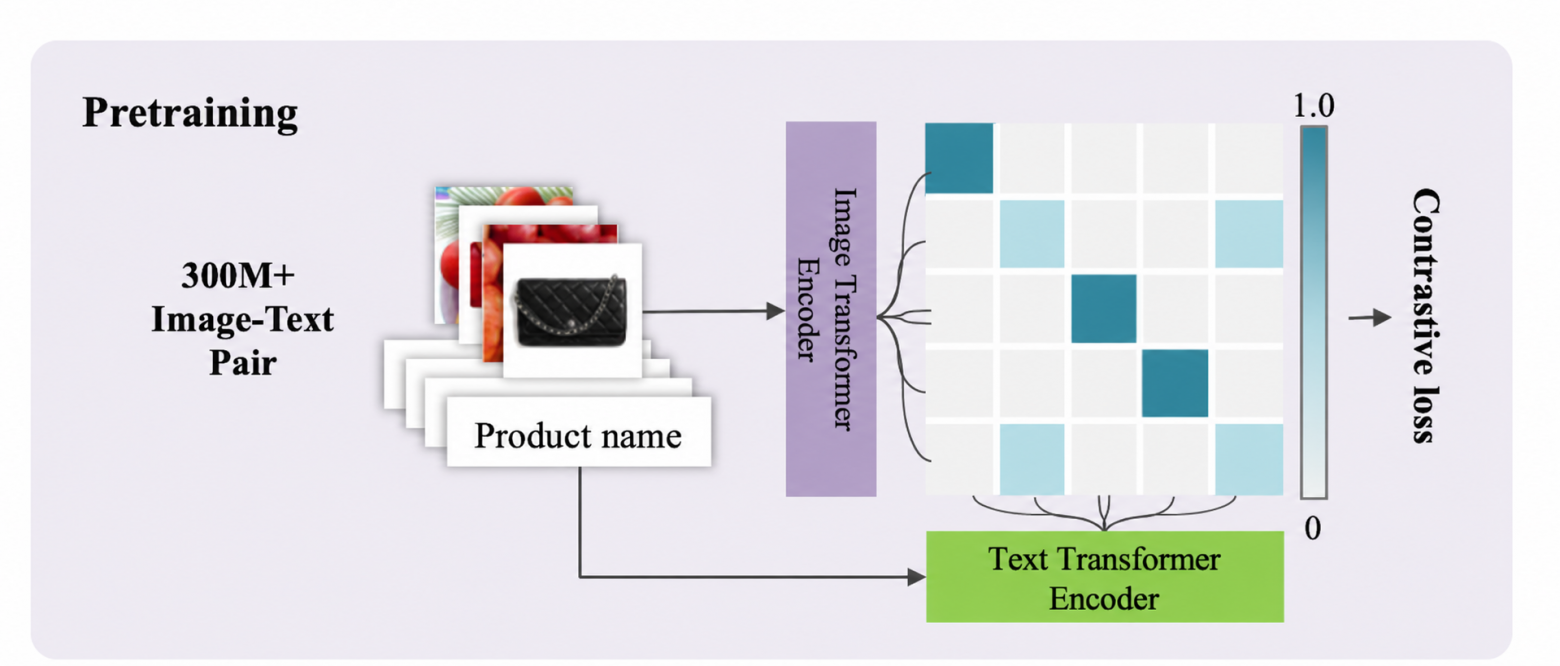
Но при переносе модели на маркетплейс обнаруживается довольно специфическая проблема. В обычной CLIP-схеме остальные объекты для каждого элемента внутри батча выступают отрицательными примерами. На маркетплейсе один и тот же физический товар могут разместить несколько продавцов. Формально перед нами разные карточки, но фактически – один товар. Если считать такую пару отрицательной (то есть negative-примером), модель сама учится раздвигать то, что хотелось бы расположить рядом.
В e-CLIP для этого использовали catalog_id, объединяющий карточки одного товара. Если внутри батча встречается несколько таких карточек, они перестают быть взаимоисключающими negative примерами и учитываются как несколько положительных соответствий.
Есть и обратная проблема: случайные отрицательные примеры часто слишком простые. Отличать телевизор от женского платья полезно недолго. Гораздо интереснее показать модели два телевизора близких категорий или две похожие модели обуви. Поэтому авторы отдельно экспериментировали с сэмплингом внутри категории, чтобы contrastive-задача чаще сталкивала модель с семантически близкими товарами.
А как на самом деле работать с карточкой маркетплейса?
Как мы уже видели выше стандартный датасет для обучения CLIP-подобных моделей выглядит примерно так:
На практике карточка товара может выглядеть иначе:
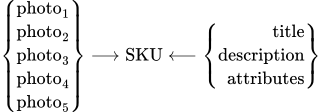
И вот здесь появляется не самый очевидный вопрос: какое изображение считать главным?
Возьмём кроссовки. На первой фотографии сбоку хорошо виден дизайн. На второй фотографии подошвы – рисунок протектора. На крупном плане – материал. На снимке коробки может быть маркировка модели.
Если мы выберем только первую картинку, потеряем часть информации. Если усредним эмбеддинги пяти изображений, тоже не факт, что получим то, что хотелось: важная маленькая деталь легко растворится среди признаков остальных фотографий.
Авторы MOON [15] отмечают, что классические dual-flow, или bi-encoder, модели хорошо выравнивают отдельное изображение с текстом, но плохо объединяют несколько изображений одного товара и его текстовые характеристики в единое представление продукта. Для объединения информации из нескольких фотографий они предлагают использовать MLLM. Для борьбы с фоновым шумом авторы используют Qwen2.5-VL для локализации основного продаваемого объекта, после чего в MLLM одновременно подаются исходное изображение и crop товара. MOON проверяли на retrieval, product classification и attribute prediction; работа была принята на WSDM 2026.
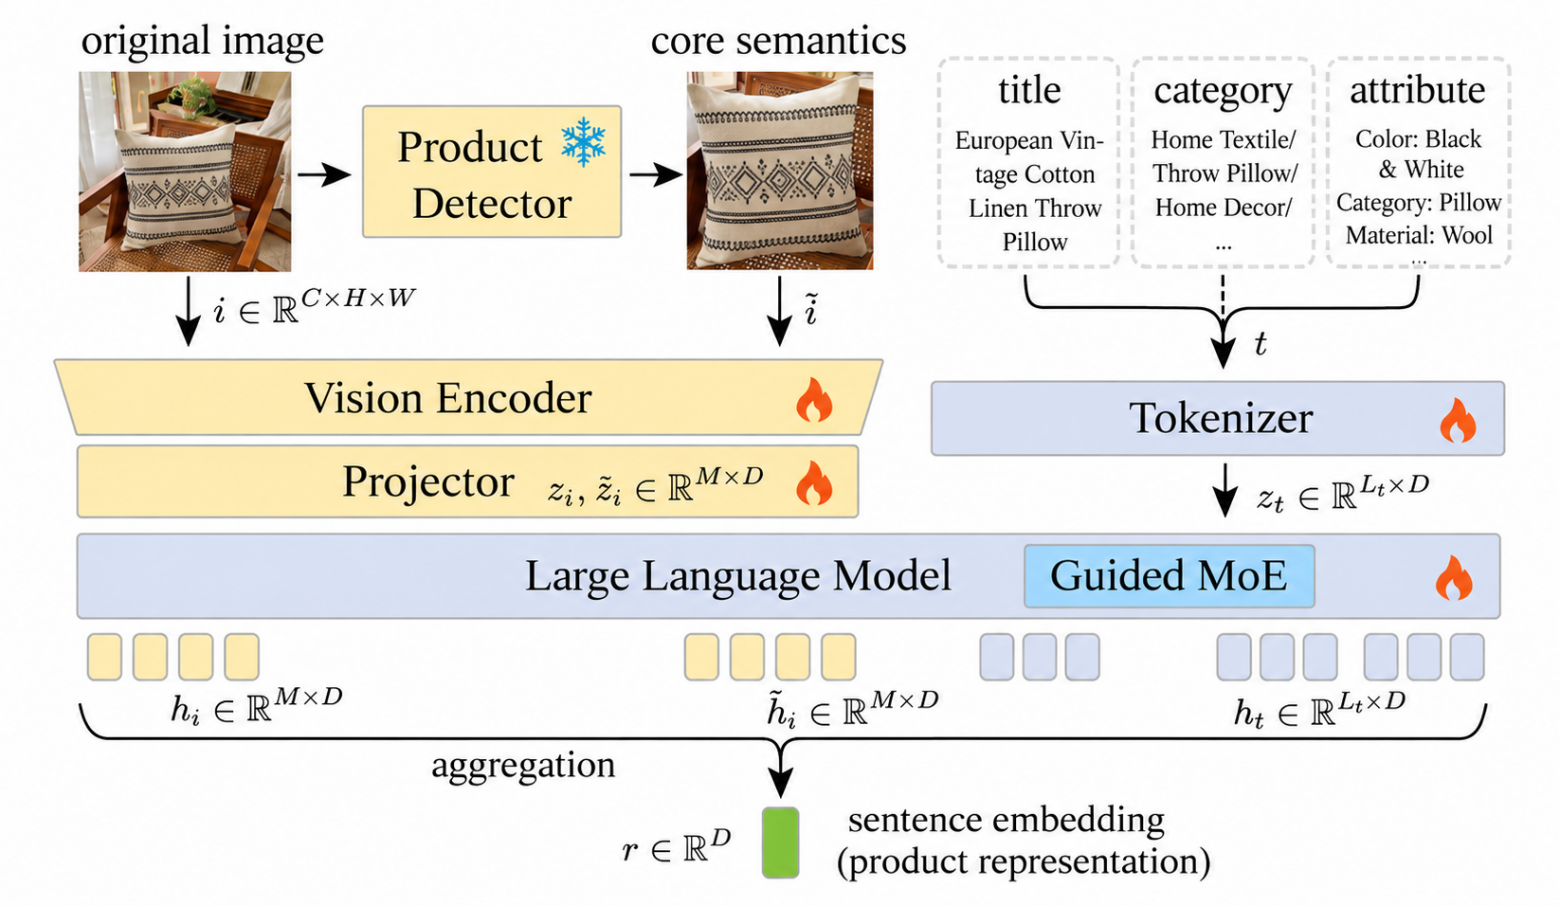
Из этой архитектуры хорошо виден тренд последних лет: вместо отдельных визуального и текстового энкодеров всё чаще пытаются использовать MLLM как единый механизм для построения мультимодального представления товара.
Но в MOON интересно не только то, как собираются несколько модальностей. Меняется и цель обучения. В классической CLIP-постановке положительная пара задаётся самой карточкой: изображение соответствует своему тексту. Здесь в обучение можно включить реальное пользовательское поведение [16] – запрос связывается с товаром, который пользователь после этого запроса купил.
Это уже несколько другой вид похожести. Запрос белые мужские беговые кроссовки и название конкретной модели могут почти не совпадать словами, но покупка всё равно даёт сигнал, что товар оказался релевантен пользовательскому намерению.
Больше данных не всегда лучше
Тут хочется сделать очевидный вывод: хорошо, давайте просто дадим модели вообще всё, что есть в карточке.
Картинки, название, категорию, атрибуты, описание – хуже ведь не станет? – Станет.
Предположим, что по названию товара категорию почти всегда можно определить без фотографии. Модель быстро обнаруживает этот короткий путь и начинает сильнее полагаться на текст. Формально перед нами мультимодальная архитектура, но практически одна из модальностей используется значительно хуже.
Есть и обратный вариант. Продавец пишет бессмысленное SEO-название, ошибается в характеристиках или загружает фотографию коробки вместо самого товара.
Данные в e-commerce вообще довольно шумные, и это не то место, где можно рассчитывать на лабораторную чистоту датасета.
В MOON2.0 [17] авторы выделяют сразу три связанные проблемы: дисбаланс модальностей, недостаточное использование связей между визуальной и текстовой информацией внутри одного товара и шум в мультимодальных e-commerce данных. Для решения всех этих проблем авторы предложили следующие идеи: Modality-driven Mixture-of-Experts, двухуровневое выравнивание и MLLM-based image-text co-augmentation вместе с динамической фильтрацией данных. Работа принята на CVPR 2026.
Вторую проблему проще понять на конкретном примере. Допустим, пользователь сделал запрос и в итоге купил пару кроссовок. Модель может учиться сближать query ↔ купленный товар – это связь между разными объектами, или inter-product alignment. Но внутри самой карточки уже есть ещё одна естественная положительная пара: фотография кроссовок и текст, который описывает именно эти кроссовки.
В MOON эта внутренняя связь специально отдельным contrastive loss не оптимизировалась. В MOON2.0 авторы добавляют второй уровень – intra-product alignment: изображение товара должно быть близко к тексту этого же товара и дальше от текста другого товара. В итоге модель одновременно учится понимать, какой товар подходит запросу, и согласовывать между собой разные модальности внутри одной карточки.
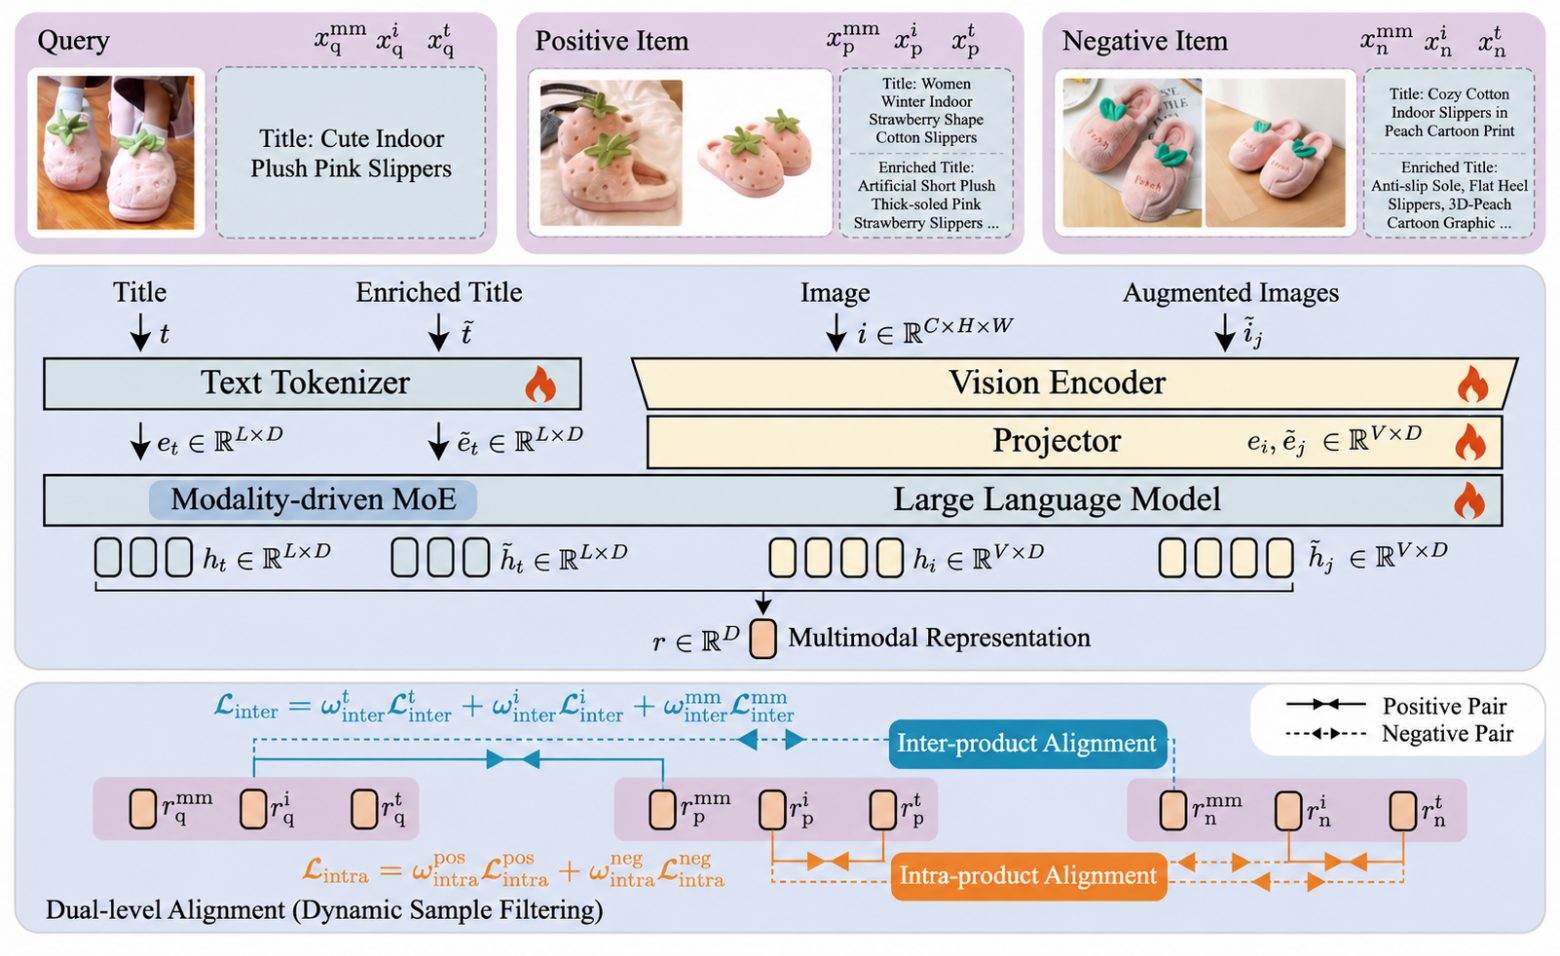
Mixture-of-Experts здесь особенно логичен. Если входные данные бывают разного состава, нет большого смысла всегда обрабатывать их абсолютно одинаковым маршрутом.
И это хороший пример того, почему современные архитектуры выглядят значительно сложнее первого CLIP. Дело не только в погоне за очередным процентом на бенчмарках. Сам объект стал сложнее. Мы пытаемся построить представление сущности, у которой может быть пять изображений разного качества, нормальный заголовок, плохое описание и несколько ошибочных атрибутов. Финальный дескриптор как-то должен пережить всё это.
Авторы MOON2.0 попытались улучшить и сами исходные данные. Если название карточки короткое или забито рекламными словами, отдельная MLLM может собрать более информативное описание из текста, характеристик товара и изображения. Для визуальной части генерируются дополнительные представления товара: другой фон, ракурс или вариант, в котором лучше видны мелкие детали.
Тут возникает уже знакомая генеративная проблема: сделать ещё одну красивую картинку легко, а сохранить на ней тот же SKU – сложнее. Поэтому после генерации авторы дополнительно проверяют согласованность синтетического изображения с текстом товара с помощью CLIP и отбрасывают низкокачественные варианты.
Почти одинаковые товары оказались отдельной проблемой
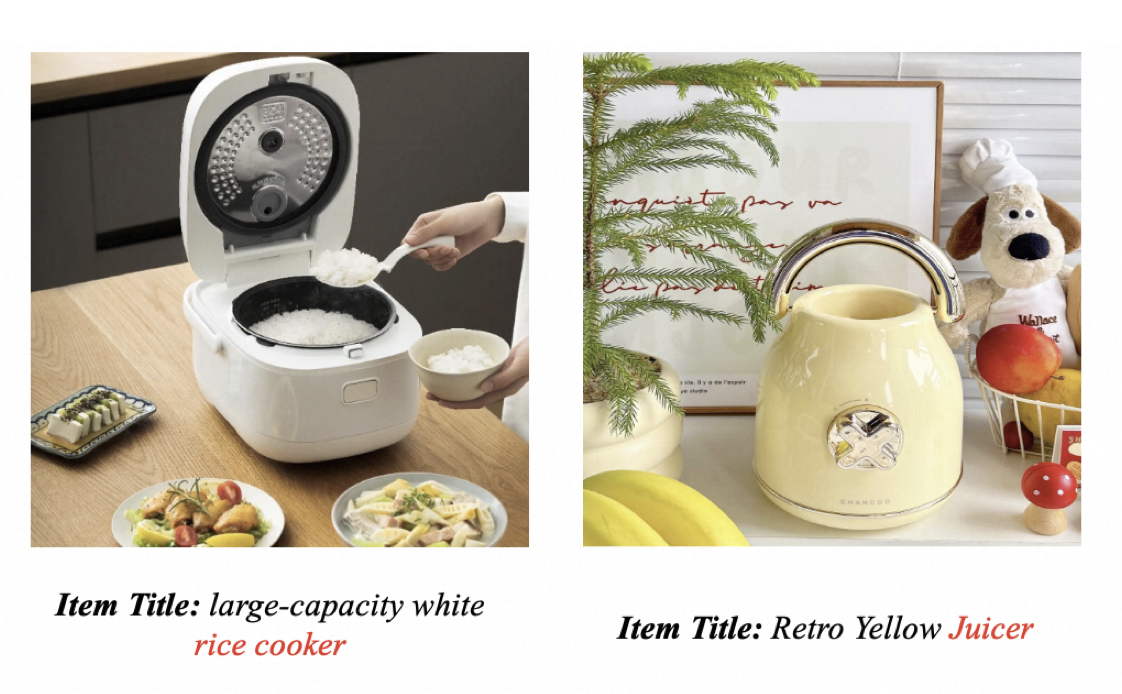
Допустим, с несколькими модальностями разобрались. Модель уже довольно хорошо понимает, что перед ней белые беговые кроссовки.
Для многих задач этого достаточно. Для identical product retrieval – ещё нет.
Представим два товара:
SKU 1: белые кроссовки, сетчатый верх, синяя вставка на пятке
SKU 2: белые кроссовки, кожаный верх, серая вставка на пятке
Большая часть семантики у них одинаковая. Если представление хорошо кодирует общий смысл, эти товары и должны оказаться рядом.
Но теперь нам требуется противоположное: заметить именно те несколько признаков, которыми они различаются.
Это не придуманная проблема специально для статьи. В AFMRL [18] авторы прямо называют fine-grained semantic comprehension ключевой сложностью для различия слишком похожих товаров в e-commerce. Их подход превращает fine-grained product understanding в задачу генерации атрибутов: MLLM сначала извлекает ключевые характеристики из изображения и текста, а затем эти признаки используются в contrastive learning, в том числе для поиска сложных примеров и фильтрации шумных false negatives. Работа опубликована в Findings of ACL 2026.
И вот здесь появляется довольно забавный поворот.
Несколько лет исследователи пытались уйти от ручных атрибутов в сторону больших end-to-end representations. А теперь атрибуты возвращаются.
Только их уже не обязательно заранее размечать вручную. MLLM может сама сказать: здесь другой материал, другая застёжка или другой рисунок.
А зачем тогда вообще reasoning?
Если взять большую MLLM и после одного прямого прохода просто получить глобальный embedding – например, через last-token representation или mean pooling скрытых состояний, – мы фактически используем дорогую генеративную модель как большой энкодер.
Авторы MOON3.0 как раз считают это ограничением существующего подхода: MLLM обычно неявно сжимает информацию о продукте в общий эмбеддинг, из-за чего трудноразличимые детали могут теряться. Их идея – задействовать размышления модели для явного моделирования атрибутов перед получением итогового представления. В архитектуре используются fusion исходных сигналов, совместное contrastive и reinforcement learning и отдельный механизм сохранения fine-grained деталей, но в целом архитектура модели остается похожей. MOON3.0 [19] принят на ACM Multimedia 2026.
Если упростить до одной строчки, получается примерно такая эволюция [20]:
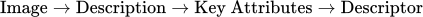
Вместо прежнего:
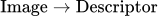
Не факт, что именно эта архитектура и процесс обучения окажется окончательным. Скорее всего, нет – в e-commerce вообще сложно найти что-то окончательное. Но сама постановка выглядит показательно: reasoning начали использовать не только для генерации ответа пользователю, но и как промежуточный этап при построении поискового представления.
Так что всё-таки значит «понимать товар»?
После всего сказанного хочется провести красивую черту и объявить, что современные MLLM наконец-то поняли товары, но мы бы не спешили.
Во-первых, один дескриптор всё ещё вынужден очень сильно сжимать информацию. Если товар отличается от соседнего SKU единственной маленькой надписью, сохранить её вместе с общей семантикой непросто. Именно поэтому fine-grained retrieval остаётся отдельным активным направлением.
Во-вторых, несколько модальностей могут не помогать, а конфликтовать. Фотография говорит одно, описание – другое, атрибут заполнен неправильно. MOON2.0 посвящает этой проблеме существенную часть метода, что само по себе хорошо показывает: просто передать модели больше данных недостаточно.
Наконец, разные задачи требуют разной похожести.
Если пользователь ищет альтернативу платью, два разных SKU вполне могут быть хорошими соседями. Если задача – найти ровно тот товар, который человек сфотографировал, они уже должны хорошо различаться.
Это важный момент. Не существует одного очевидного ответа на вопрос «насколько похожи эти товары». Всё зависит от того, что именно мы собираемся делать с эмбеддингом после этого.
Вместо вывода
Если посмотреть на развитие области не через названия моделей, а через постановку задачи, получается довольно понятная история.
Сначала мы кодировали фотографию и искали визуально похожую фотографию.
Потом добавили текст и научились обрабатывать запросы вроде «такое же, но с другими рукавами». Fashion-IQ как раз строился вокруг интерактивного поиска с пользовательской обратной связью.
CLIP дал удобный общий язык для изображения и текста, а e-commerce модели начали адаптировать его под категории, атрибуты, matching и другие специфические задачи каталога.
Затем выяснилось, что товар не помещается в пару image-text: у SKU несколько изображений, источники информации могут быть шумными, а маленькая визуальная деталь иногда важнее всей остальной семантики. MOON, MOON2.0, AFMRL и MOON3.0 с разных сторон пытаются решить именно эти ограничения.
Поэтому современное представление продукта всё меньше похоже на «вектор картинки».
Скорее это попытка ответить на вопрос: что мы знаем об этом товаре по всем доступным сигналам и какие из этих знаний понадобятся модели?
И вот этот вопрос, похоже, оказался значительно сложнее обычного поиска по фотографии.
Ссылки
-
Visual Discovery at Pinterest [21], 2017.
-
Fashion IQ: A New Dataset Towards Retrieving Images by Natural Language Feedback [6], 2019.
-
FashionBERT: Text and Image Matching with Adaptive Loss for Cross-modal Retrieval [9], 2020.
-
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale [10], 2020.
-
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding [22], 2018.
-
Learning Transferable Visual Models From Natural Language Supervision (CLIP) [23], 2021.
-
e-CLIP: Large-Scale Vision-Language Representation Learning in E-commerce [14], 2022.
-
MOON: Generative MLLM-based Multimodal Representation Learning for E-commerce Product Understanding [24], 2025.
-
MOON2.0: Dynamic Modality-balanced Multimodal Representation Learning for E-commerce Product Understanding [17], CVPR 2026.
-
AFMRL: Attribute-Enhanced Fine-Grained Multi-Modal Representation Learning in E-commerce [25], Findings of ACL 2026.
-
MOON3.0: Reasoning-aware Multimodal Representation Learning for E-commerce Product Understanding [26], ACM Multimedia 2026.
Автор: vsstar
Источник [27]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36396
URLs in this post:
[1] tevian: https://tevian.ai
[2] Pinterest: https://arxiv.org/pdf/1702.04680
[3] ошибка: http://www.braintools.ru/article/4192
[4] поведение: http://www.braintools.ru/article/9372
[5] IQ: http://www.braintools.ru/article/7605
[6] Fashion IQ: https://arxiv.org/abs/1905.12794
[7] источник информации: http://www.braintools.ru/article/8616
[8] обучения: http://www.braintools.ru/article/5125
[9] FashionBERT: https://arxiv.org/abs/2005.09801
[10] ViT: https://arxiv.org/abs/2010.11929
[11] BERT: https://arxiv.org/pdf/1810.04805
[12] зрения: http://www.braintools.ru/article/6238
[13] CLIP: https://arxiv.org/pdf/2103.00020
[14] e-CLIP: https://arxiv.org/abs/2207.00208
[15] MOON: https://arxiv.org/pdf/2508.11999
[16] поведение: http://www.braintools.ru/article/5593
[17] MOON2.0: https://arxiv.org/abs/2511.12449
[18] AFMRL: https://arxiv.org/pdf/2604.20135
[19] MOON3.0: https://arxiv.org/pdf/2604.00513
[20] эволюция: http://www.braintools.ru/article/7702
[21] Visual Discovery at Pinterest: https://arxiv.org/abs/1702.04680
[22] BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding: https://arxiv.org/abs/1810.04805
[23] Learning Transferable Visual Models From Natural Language Supervision (CLIP): https://arxiv.org/abs/2103.00020
[24] MOON: Generative MLLM-based Multimodal Representation Learning for E-commerce Product Understanding: https://arxiv.org/abs/2508.11999
[25] AFMRL: Attribute-Enhanced Fine-Grained Multi-Modal Representation Learning in E-commerce: https://arxiv.org/abs/2604.20135
[26] MOON3.0: Reasoning-aware Multimodal Representation Learning for E-commerce Product Understanding: https://arxiv.org/abs/2604.00513
[27] Источник: https://habr.com/ru/companies/tevian/articles/1089458/?utm_campaign=1089458&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.