


Это первая статья серии: измеряем, что происходит с LLM-агентом, когда шлюз замаскировал данные. Дальше разберём находки по чужим системам и то, что нашлось у нас.
1. Зачем это мерить
Агент поддержки получает: «Здравствуйте, я Кузнецова Дарья, телефон 8 935 747 66 22, проверьте заказ». До модели доходит «я <PERSON_1>, телефон <PHONE_NUMBER_2>», и она вызывает check_order(phone=…).
Тут половина решений на рынке и ломается: инструменту нужен настоящий телефон, по <PHONE_NUMBER_2> заказ не найдётся. Шлюз обязан вернуть реальное значение в аргумент вызова ровно в той форме, в какой написала модель.
Мы собрали открытый бенчмарк и прогнали шесть систем: Cloud.ru guardrails-llm-filter, LiteLLM с guardrail Presidio, LLM Guard, Microsoft Presidio, наивный regex-маскер и наш продукт.
2. Почему маскировки мало
С маскированием текста всё решено: русский NER даёт 90%+ по именам, телефоны и СНИЛС ловятся контрольными суммами. Но агент, в отличие от чата, действует.
Что происходит за один ход:
клиент → [шлюз: подстановка] → модель → tool_call(phone=подстановка)
                                              ↓
инструмент ← [шлюз: восстановление] ← аргумент с подстановкой
Круг может порваться в четырёх местах:
-
Значение не замаскировано. Модель видит реальные данные: классическая утечка, её мерят все.
-
Замаскировано частично. В «Кзнецова Дарья» распознана только «Дарья», а recall по спанам засчитал это попаданием.
-
Восстановление не сработало. Инструмент получил
<PERSON_1>и ищет такого клиента в CRM. -
Замаскировано лишнее.
check_order(order="ORD-<NUMBER_3>")не находит ничего: номер заказа, сумма и дата документа стали подстановками.
Пункты 2-4 не измеряет ни один известный нам бенчмарк: NER-корпуса (NEREL, RuNNE) размечают спаны, корпуса маскирования ПДн (hivetrace/pii-bench, ai4privacy) мерят только детекцию, бенчмарки вызова инструментов (BFCL, τ-bench, GorillaHard в MERA) ПДн не содержат.
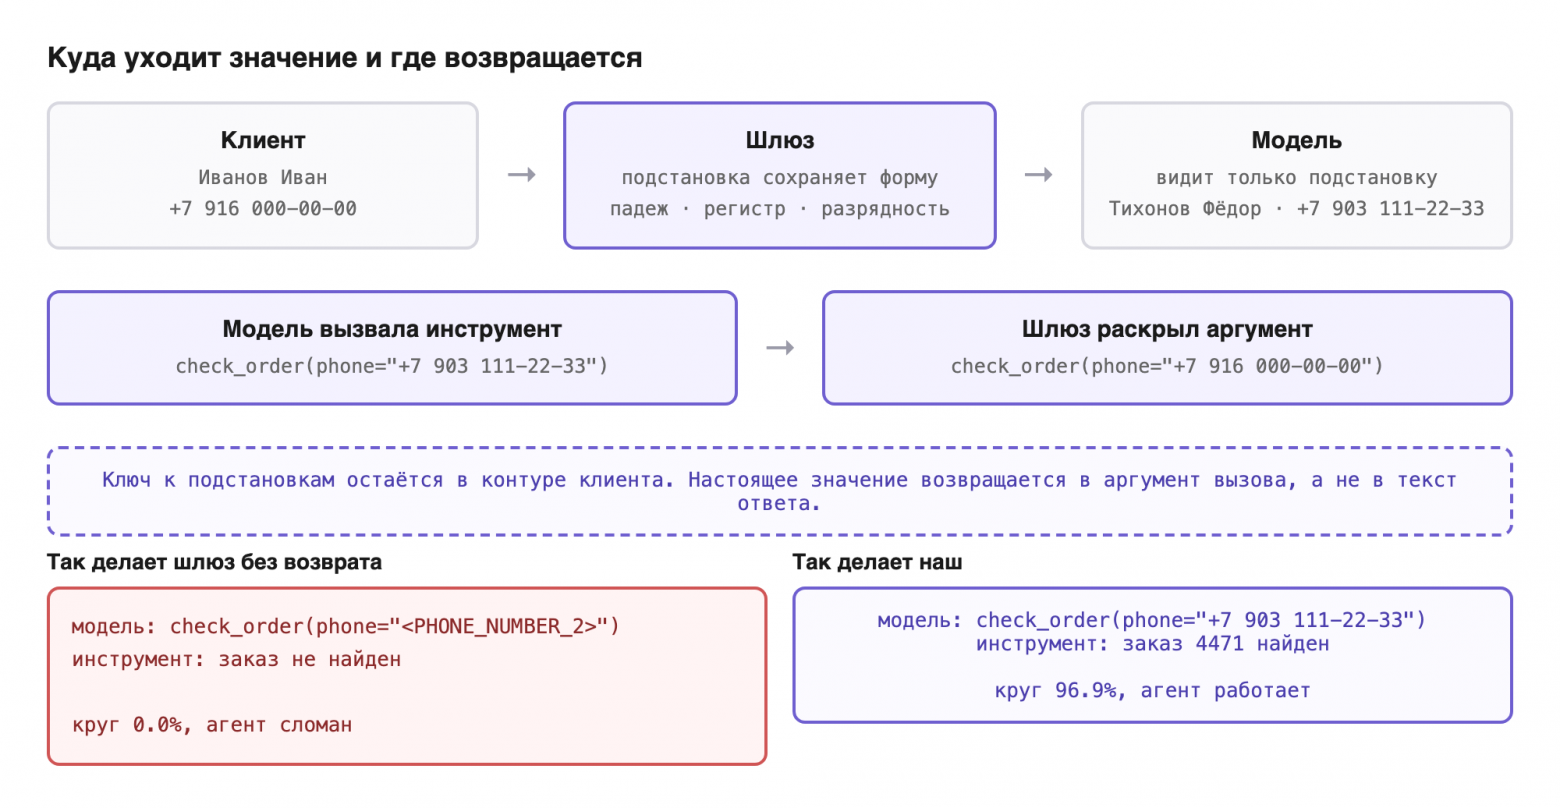
Слева клиент, справа модель, внизу инструмент. Подстановка появляется на входе в модель и раскрывается в аргументе вызова. Шлюз, который умеет только первую половину, ломает агента на второй.
3. Что мы построили
AgentMask-RU: 272 диалога, 680 персональных значений, 624 негатива (маскировать нельзя), харнесс под любой маскировщик, семь гейтов и таблица. Код Apache-2.0, корпус CC BY 4.0, результаты CC0.
Шесть семей задач агента: оформить заказ, проверить статус, подтвердить личность, вернуть деньги, отправить СМС, второе упоминание того же человека. Регистров три:
|
регистр |
пример |
|---|---|
|
|
«Кузнецова Дарья Игоревна, +7 935 747-66-22, ул. Блочная, д. 14» |
|
|
«кузнецова дарья, 89357476622, блочная 14» |
|
|
«кзнецова дарья, 8 935 7476622, блоная 14», одна описка |
clean даёт красивую цифру любому маскировщику, а живые люди пишут строчными, без разделителей и с опечатками.
Имена: четыре яруса (частотные, редкие, уменьшительные, иностранные) из Wikidata, NEN, mimesis, Faker. Телефоны из резервных кодов DEF плана нумерации (Приказ Минцифры № 75): libphonenumber считает их валидными, абонента за ними нет.
4. Как измерить прокси
Библиотеку (Presidio, LLM Guard) измерить легко: вызвал anonymize, сравнил. Прокси (Cloud.ru, LiteLLM, наш) сложнее: «что увидела модель» видно только в HTTP-запросе к OpenAI.
Харнесс выкручивается так: он сам становится провайдером, поднимает OpenAI-совместимый сервер на localhost, прокси направляют на него, и весь запрос к «модели» виден целиком; вместо модели скрипт, копирующий увиденные значения в вызов инструмента.
харнесс ──запрос──▶ прокси ──замаскировано──▶ харнесс-как-провайдер
                                                      │ tool_call(копия)
харнесс ◀─восстановлено─ прокси ◀──────────────────────┘
Модели нет, значит нет недетерминизма, затрат и вечного вопроса «это модель ошиблась или шлюз». Политик две: «копировальщик» и вторая, переформатирующая телефон (+7 … → 8 …) как реальные модели.
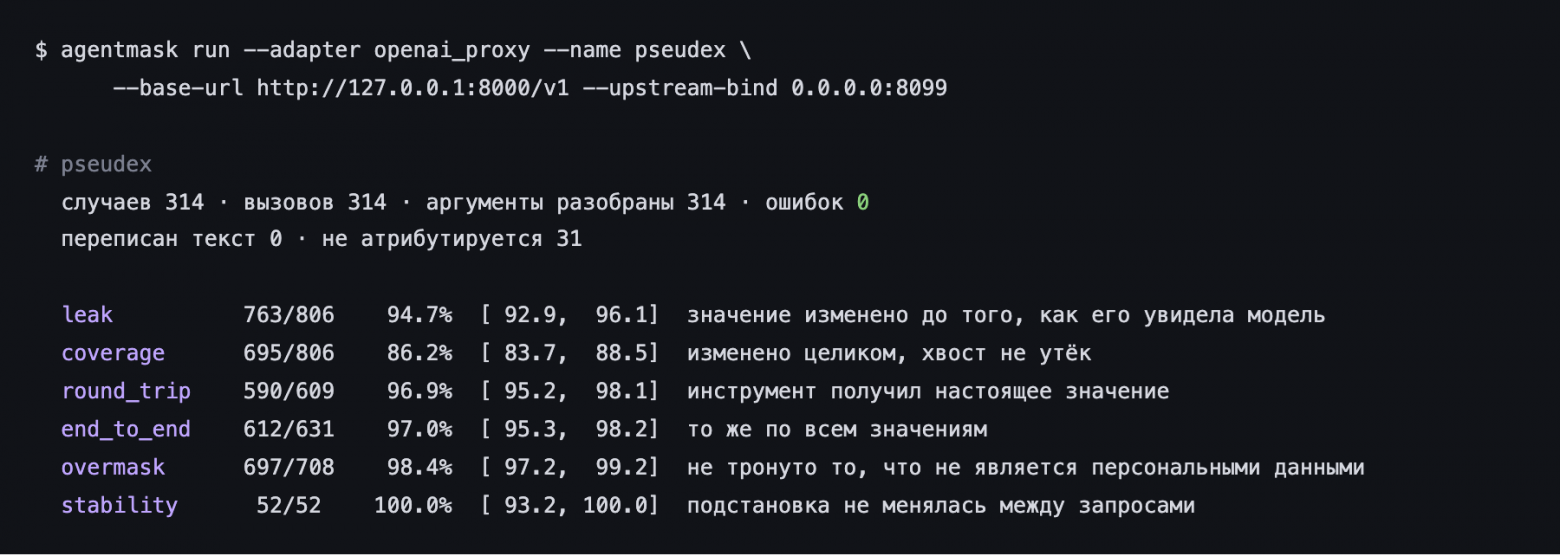
Так выглядит прогон. Команду можно повторить у себя: харнесс поднимает фальшивого провайдера, движок получает запросы по HTTP и не знает, что его измеряют.
5. Восемь строк вместо балла
Каждый прогон печатает восемь строк. Общего балла нет намеренно:
|
строка |
что значит |
|---|---|
|
|
значение изменено до того, как его увидела модель |
|
|
ни один кусок значения не дожил до модели (слово ≥3 букв, цифры ≥3) |
|
|
инструмент получил настоящее значение, из тех, что были скрыты |
|
|
то же по всем значениям: «агент не сломан» |
|
|
номер заказа, трек, сумма, дата документа, голый город не тронуты |
|
|
второе упоминание человека получило ту же подстановку |
|
|
подстановка не менялась между запросами |
|
|
тип определён верно (если маскер отдаёт спаны) |
Шлюз, который маскирует всё подряд, выигрывает leak и проигрывает overmask с round_trip.
Строка без единой ошибки печатает не «100%», а нижнюю границу подтверждаемого: 52/52 сертифицирует ≥94.4% по интервалу Клоппера-Пирсона. 100% на 52 случаях и 100% на 5 200 не одно и то же.
6. Результаты
noop не делает ничего (проверка корпуса), placeholder_regex наивный regex, написанный за час как нижняя планка.
|
система |
скрыто |
скрыто целиком |
круг (из скрытых) |
круг (из всех) |
не тронуто лишнего |
одна подстановка |
|---|---|---|---|---|---|---|
|
noop |
0.0% |
0.0% |
нет |
100% |
100% |
нет |
|
placeholder_regex |
53.1% |
51.5% |
98.0% |
98.9% |
79.8% |
26.7% |
|
Cloud.ru guardrails |
43.7% |
42.8% |
100% |
100% |
100% |
22.2% |
|
LiteLLM + Presidio |
63.8% |
46.0% |
0.0% |
36.8% |
70.0% |
0.0% |
|
LLM Guard¹ |
42.6% |
34.9% |
99.5% |
99.8% |
96.8% |
8.9% |
|
Presidio |
58.1% |
50.4% |
90.8% |
94.7% |
72.0% |
46.8% |
|
Pseudex |
94.7% |
86.2% |
96.9% |
97.0% |
98.4% |
74.5% |
¹ LLM Guard не поддерживает русский (Anonymize принимает только en и zh): прогон на английском конвейере, и это его честная цифра на русском.
Числа Pseudex сняты на выпущенном образе pseudex:0.3.21 (sha256:162ca2598b03…): адаптер openai_proxy, лицензия с сайта, корпус целиком, политика copier.
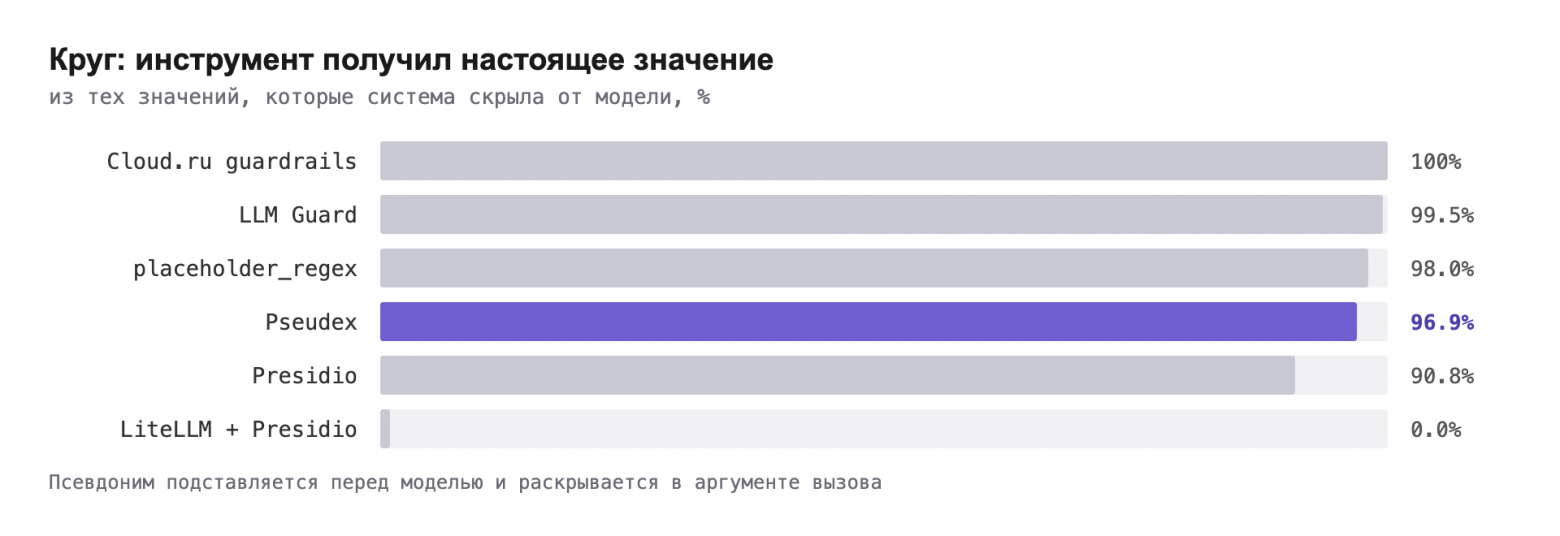
Одна и та же метрика для всех. Ноль у LiteLLM с Presidio это не сбой настройки: их маскирование заменяет значение подстановкой <PERSON_1>, а вернуть настоящее в аргумент вызова нечем.
По типам:
|
система |
ФИО |
телефон |
адрес |
дата рожд. |
СНИЛС |
карта |
паспорт |
|---|---|---|---|---|---|---|---|
|
Cloud.ru |
12% |
79% |
25% |
0% |
82% |
78% |
82% |
|
LiteLLM + Presidio |
30% |
94% |
50% |
100% |
54% |
66% |
95% |
|
LLM Guard |
61% |
47% |
28% |
0% |
0% |
25% |
0% |
|
Presidio |
74% |
50% |
60% |
68% |
11% |
3% |
73% |
|
placeholder_regex |
24% |
80% |
47% |
68% |
36% |
75% |
82% |
|
Pseudex |
88% |
100% |
98% |
100% |
96% |
97% |
91% |
Cloud.ru как зеркало. Замаскировал и восстановил 247 из 247, лишнего не тронул: 624 из 624. Но маскирует он 43.7%: имена 12%, адреса 25%, даты рождения 0%. Регулярки находят телефоны и документы, а имя «Дарья» в чате нет. Трафик из номеров? Отличный выбор. Трафик из людей? Половина дойдёт до модели.
Наивный regex за час даёт 53% и обгоняет Cloud.ru по leak, а LLM Guard по всему, кроме overmask. Это мера того, сколько в задаче делает форма значения (телефон, СНИЛС, карта с контрольной суммой), а сколько язык (имя, адрес).
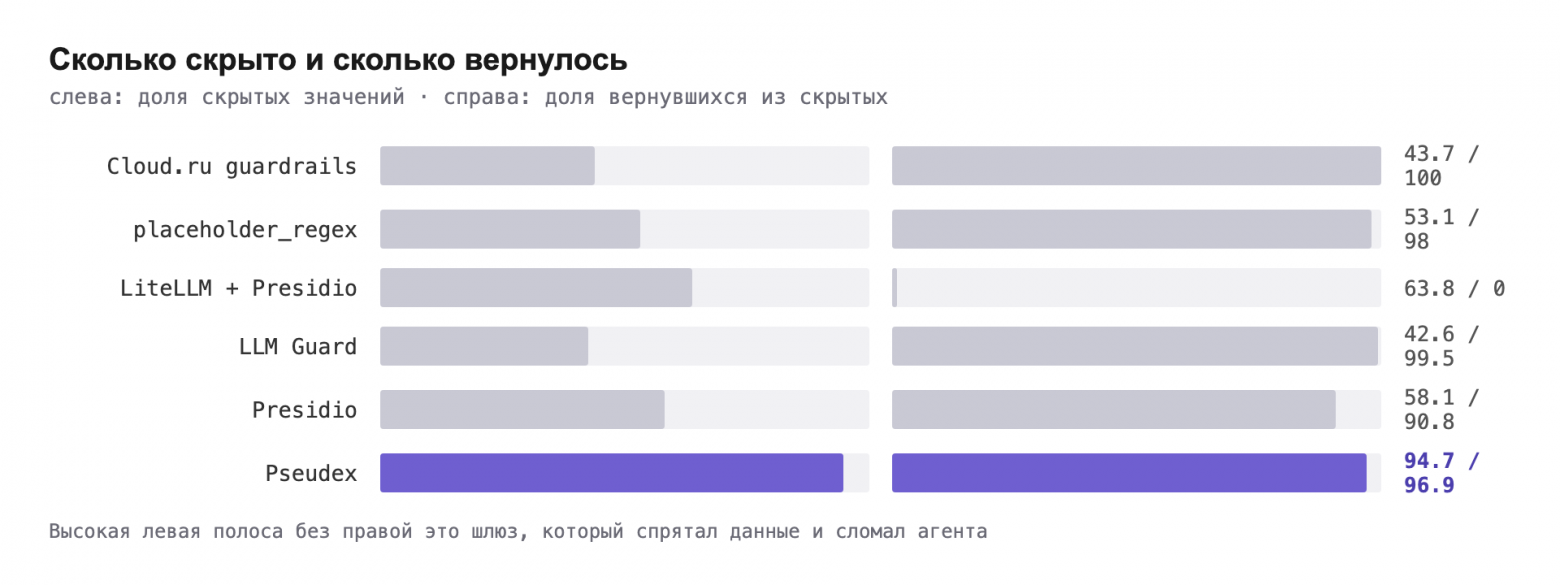
Две полосы рядом стоят не для красоты. Высокая левая без правой это шлюз, который спрятал данные и сломал агента: инструменту нечего искать.
Pseudex маскирует больше всех и восстанавливает почти всё. 94.7% против 63.8% у ближайшего, 96.9% по кругу против 100% у Cloud.ru. Знаменатели разные: Cloud.ru прячет 43.7%, мы 94.7%, поэтому в наш круг попадает вдвое больше значений (488 против 247, в абсолюте 388 против 247).
7. Три находки в чужих системах
LiteLLM + Presidio: 0 из 327
Guardrail presidio с output_parse_pii: true обещает восстановить подстановки в ответе: в message.content восстанавливает, в tool_calls[].function.arguments не восстановил ни разу за 327 попыток.
Мы полезли в исходники main-stable 1.102.0: восстановление идёт через UnifiedLLMGuardrails → apply_guardrail(inputs, input_type="response"), в inputs лежат и тексты, и вызовы инструментов, а PresidioPIIMasking.apply_guardrail читает только inputs["texts"] и отдаёт tool_calls нетронутыми. Хук async_post_call_success_hook, где аргументы обрабатываются правильно, не вызывается.
И это известно: issue #31950 открыт с июля, PR #32014 с починкой не влит. Мы оставили там подтверждение с логами.
Второе хуже, и про него не заявлял никто. Из 327 замаскированных значений 257 дошли до модели вот в таком виде:
8 935 <DATE_TIME_6>VER_LICENSE_6>
<US_BANK_NUMBER_7>LICENSE_7>
<PHONE_NUMBER_6>MBER_8>LICENSE_8>
Presidio отдаёт на одну строку цифр несколько типов сразу (PHONE_NUMBER, US_BANK_NUMBER, US_DRIVER_LICENSE, DATE_TIME) с пересекающимися границами. LiteLLM заменяет спаны «в обратном порядке, чтобы не сдвигать координаты»: для пересекающихся вторая замена режет уже вставленный плейсхолдер. Минимальное воспроизведение: одна английская фраза, у которой после телефона пропадает запятая с пробелом (issue #42130).
Вывод: с таким guardrail агент с инструментами не работает.
LLM Guard: русского нет
Сканер Anonymize принимает language только en и zh: на русском 61% имён (часть кириллических английская NER узнаёт по форме), 47% телефонов, остальное почти ноль. Это не дефект, а заявленная область применения, но цифру 42.6% полезно знать.
Presidio: 28% лишнего
Microsoft Presidio с русской моделью spaCy единственный из чужих ищет имена (74%). Плата: overmask 72.0%, из 624 негативов 175 стали подстановками. Для агента это check_order(order="<NUMBER_3>"): заказ не найдётся, хотя ПДн в нём не было.
8. Почему у нас возврат доезжает
Круг 96.9% считается от скрытых значений: доехало ли настоящее до инструмента. Остальные строки: end_to_end 97.0%, overmask 98.4%, stability 100%. По типам: телефон 100%, дата рождения 100%, адрес 98%, карта 97%, СНИЛС 96%, паспорт 91%, ФИО 88%.
Разница в том, ЧТО возвращается:
-
подстановка сохраняет ФОРМУ: падеж, регистр, транслит, разделители. Модель написала «филатову мию», инструмент получит «Мию Филатову», а не «Мия Филатова». Такие случаи
round_trip_repairedсчитает доставленными: 98.2%, и разница между 96.9% и 98.2% это цена нормализации, наша; -
подстановка проходит проверку контрольной суммы: фейк из диапазона, которого у человека быть не может, но валидацию СНИЛС или карты он проходит;
-
подстановка устойчива между запросами, stability 100%: значение не превращается в нового человека на следующем шаге.
И главное: ключ к подстановкам не покидает контур клиента: настоящее значение возвращается в аргумент вызова там, где стоит шлюз.
Мы закрываем восемь типов: ФИО, телефон, адрес, дата рождения, СНИЛС, ИНН, паспорт, карта, и у каждого своя проверка.
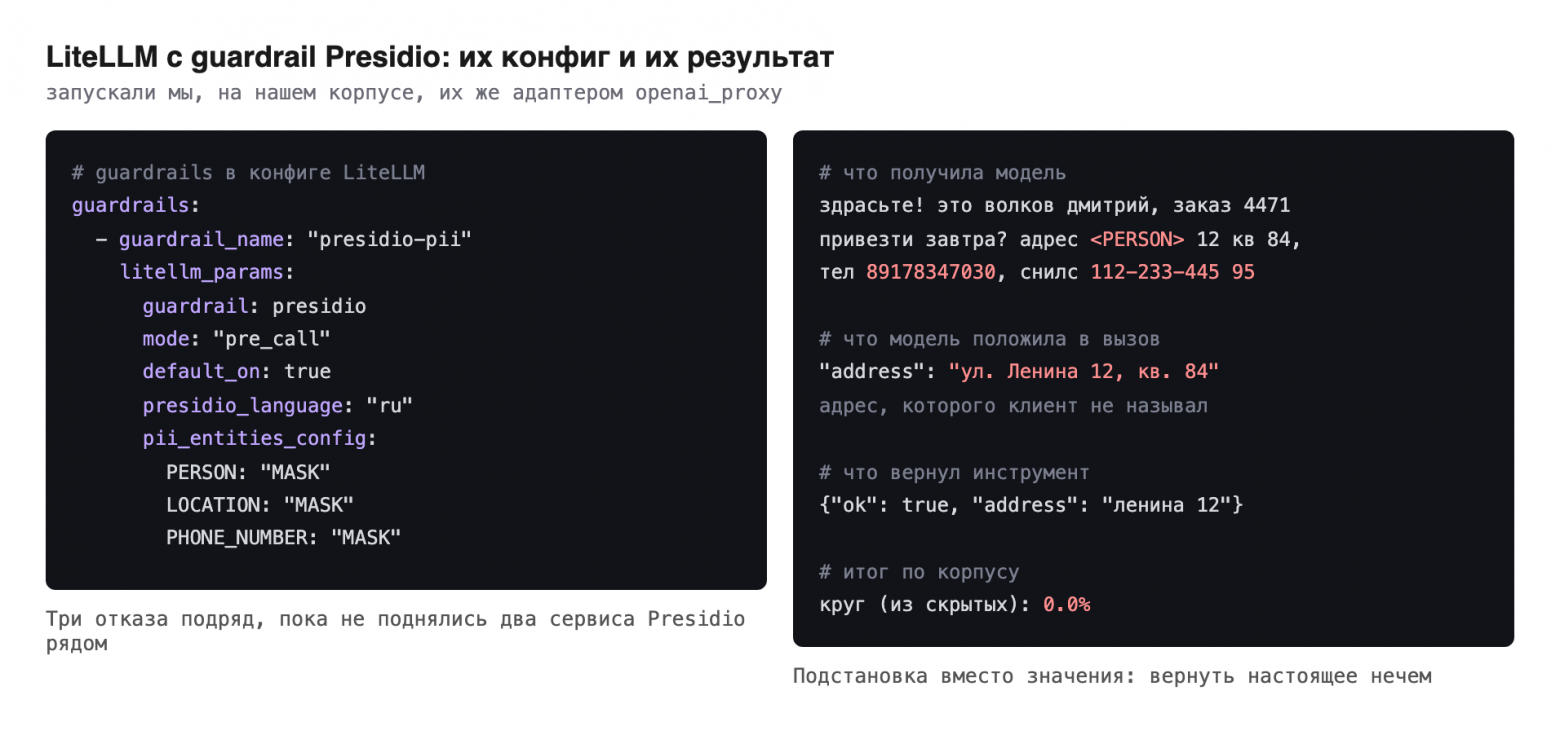
Их конфиг и их результат на нашем корпусе. Маскирование подставляет <PERSON>, инструменту возвращать нечем: адрес в вызове модель придумала сама.
9. Чтобы прибор мог провалиться
Наш внутренний бенчмарк предыдущего поколения не мог провалиться в четырёх местах: not any([]) на пустом списке полей, нечитаемая обязательность полей, отсутствие уровня «вызвал ли агент инструмент» и непроверенные негативы. Все четыре работали в пользу шлюза.
Поэтому в открытом бенчмарке гейты стоят в CI. Код и корпус лежат тут: github.com/pseudex-ai/agentmask-ru.
-
G6: маскер, который ничего не делает, обязан пройти каждый случай: не пережившее passthrough значение значит сломанный случай, а не маскер.
-
G7: наивный regex обязан оставить след на каждом случае, кроме объяснённых в
hard.why: иначе корпус не различает ничего. -
G8: ни один регистр меньше 20%, ни один ярус имён не пуст,
hardне больше половины. -
Признак
hardвыводится из шаблона случая, а не из прогона детектора: отбор на сигналах измеряемой системы делает его непроваливаемым. -
Пулы значений не пересекаются с нашими словарями по построению, но манифест печатает, сколько имён корпуса газетир знает: 29 из 206 личных, 111 из 168 фамилий.
-
Корпус генерируется из зерна,
--checkдоказывает в CI, что committed-версия воспроизводится.
Ни McNemar, ни доверительный интервал не доказывают «эффекта нет»: они отвечают на вопрос о разнице, а не найти её на 272 случаях так же легко, как найти. Поэтому парные сравнения в таблице есть, а «эквивалентно» нет; TOST будет в следующей версии.
10. Раскрытие
Бенчмарк написала команда Pseudex, того самого шлюза, который в нём измеряется: мы делаем обратимую подстановку ПДн для LLM-агентов.
-
правило отбора случаев зафиксировано до прогонов и вычислимо без маскировщика;
-
прогон помечен
vendor-submittedи не отзывается; -
наша строка воспроизводится тем же путём, что и чужие: выпущенный образ, пробный ключ, адаптер
openai_proxy; -
чужие системы измерены по их документации, рецепты в
baselines/.
11. Чего бенчмарк не измеряет и как участвовать
Версия 0.1 не измеряет стриминг, ПДн обратно из инструмента (результат поиска в CRM тоже маскировать), память агента между диалогами, восстановление просклонённой или транслитерированной подстановки, эквивалентность по TOST: всё это в следующих версиях.
Единица вклада это один JSON-файл со случаем, CI прогонит гейты. Ревью оплачивается очками наравне с вкладом, правило взято у MMTEB: иначе очередь PR встаёт на мейнтейнере. Прогон своей системы это один адаптер и один запуск, результат ложится в таблицу с манифестом.
Репозиторий: github.com/pseudex-ai/agentmask-ru.
Пишите в комментариях, если хотите прогнать свою систему через корпус.
Источники
Наш продукт и бенчмарк
-
Pseudex: pseudex.ru
-
AgentMask-RU, код и корпус: github.com/pseudex-ai/agentmask-ru
Системы, которые мы прогнали
-
Cloud.ru guardrails-llm-filter: github.com/KAP-AI/guardrails-llm-filter
-
LiteLLM и его guardrails: github.com/BerriAI/litellm, документация по guardrails. Обсуждения, о которых речь в тексте: #31950, #32014, #42130
-
LLM Guard: github.com/protectai/llm-guard
-
Microsoft Presidio: github.com/microsoft/presidio, русская модель spaCy ru
Чем собирали корпус
-
Natasha и размеченный ею корпус имён (NEN)
-
Резервные DEF-коды российского плана нумерации (Приказ Минцифры России № 75)
Корпуса и стенды, о которых говорим в тексте
-
NEREL: github.com/nerel-ds/NEREL
-
RuNNE-2022: разбор задания
-
hivetrace/pii-bench: huggingface.co/datasets/hivetrace/pii-bench
-
ai4privacy/pii-masking-200k: huggingface.co/datasets/ai4privacy/pii-masking-200k
-
BFCL: gorilla.cs.berkeley.edu
-
τ-bench: github.com/sierra-research/tau-bench
-
GorillaHard в MERA: mera.a-ai.ru
Автор: Isk4R1oT

