


Вместо введения.
Когда приложение состоит из одного процесса и нескольких десятков методов, найти причину медленной работы относительно просто: можно включить профилировщик, посмотреть логи и найти проблемный участок кода.
В распределённой системе всё меняется.
Один пользовательский запрос может пройти через API Gateway, несколько микросервисов, очередь сообщений, базу данных и внешний API. При этом каждый компонент может находиться на отдельном сервере или в отдельном контейнере.
Если такой запрос выполняется 4 секунды, возникает вполне практический вопрос: где именно были потрачены эти 4 секунды? На сети? На базе данных? На блокировке потока? На выполнении конкретного метода? На внешнем сервисе?
Именно для ответа на этот вопрос в APM используются трассировка (distributed tracing) и инструментация приложений.
Один из наиболее интересных подходов — автоматическая инструментация, при которой разработчику не требуется вручную добавлять tracing-код в каждый сервис.
Разберём, как это работает на уровне архитектуры, что происходит внутри приложения на разных языках и где у автоматизации проходят границы.
Что такое трассировка
Начнём с базовых понятий. В distributed tracing каждый пользовательский или системный запрос представляется как trace — распределённая трасса, то есть полный маршрут прохождения запроса через систему. Trace состоит из отдельных операций — span (каждый отдельный вызов: на фронте, на бэке, на шине).
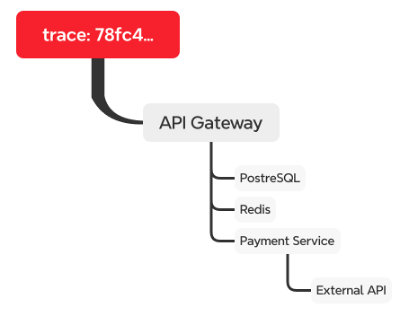
Каждый span описывает отдельную операцию:
Span: trace_id, span_id, parent_span_id, start_time, duration, operation, service, status, attributes
Например:
trace_id: 4bf92f3577b34da6…
span_id: 00f067aa0ba902b7
parent_span_id: 7a085853722dc6…
operation: POST /api/orders
duration: 183 ms
status: OK
Связь между span формирует дерево выполнения. При этом trace не обязательно ограничивается одним процессом. Именно поэтому возникает самая интересная часть задачи: как система понимает, что запрос, который сейчас обрабатывается в Service B, является продолжением запроса, который несколько миллисекунд назад обрабатывался в Service A?
Trace context: как связать несколько сервисов
Представим цепочку: Client → Service A → Service B.
Service A создаёт trace и span: Trace ID = ABC123, Span ID = 111.
Когда Service A отправляет HTTP-запрос в Service B, tracing-инструментация добавляет в запрос специальный контекст. Современный стандартный вариант — W3C Trace Context: в запрос добавляется заголовок traceparent. Упрощённо: traceparent: 00-ABC123-111-01 (в реальности trace-id — это 32 hex-символа, а span-id — 16). Service B получает запрос и извлекает из него trace context. После этого он создаёт дочерний span: Trace ID = ABC123, Span ID = 222, Parent = 111.
Trace ABC123
└── Service A (span 111)
└── Service B (span 222, parent 111)
Таким образом, отдельные процессы начинают выглядеть для APM как единая цепочка выполнения. Это фундаментальный механизм distributed tracing. Ключевой момент здесь заключается в том, что инструментация должна не только измерять время выполнения операций, но и корректно переносить контекст между компонентами системы.
Контекст за пределами HTTP
С HTTP всё относительно просто: заголовок traceparent едет вместе с запросом. Сложнее с асинхронными сценариями.
Очереди (Kafka, RabbitMQ). Контекст записывается в заголовки сообщения: продюсер добавляет traceparent, консьюмер извлекает его и создаёт span, связанный с исходной трассой. Даже если сообщение пролежало в очереди несколько минут, связь между отправкой и обработкой сохраняется.
Пулы потоков. Задача создаётся в одном потоке, а выполняется в другом. Инструментация должна «завернуть» задачу так, чтобы вместе с ней в поток пула переехал и текущий контекст, иначе трасса рвётся.
Именно такие места чаще всего ломаются при ручной инструментации, их автоинструментация и берёт на себя.
Но кто создаёт эти span? Есть два принципиально разных подхода.
Подход №1. Ручная инструментация
Разработчик сам добавляет в код создание span: где начинается операция, где заканчивается, какие атрибуты записать. Например, на Java с OpenTelemetry SDK это выглядит так:
Span span = tracer.spanBuilder(“processOrder”).startSpan();
try (Scope scope = span.makeCurrent()) {
span.setAttribute(“order.id“, orderId);
processOrder(orderId);
} finally {
span.end();
}
Плюсы такого подхода:
• полный контроль;
• можно инструментировать собственную бизнес-логику;
• можно добавлять специфические атрибуты.
Но есть и проблема. В реальном enterprise-приложении таких точек могут быть тысячи. Кроме того, разработчику нужно самостоятельно учитывать:
• HTTP;
• JDBC;
• Kafka;
• Redis;
• gRPC;
• очереди;
• асинхронные операции;
• thread pools;
• внешние API.
В результате наблюдаемость становится частью application code. Чтобы выпустить приложение в прод с наблюдаемостью внутри, нужно закладывать много дополнительного времени. Что-то можно и забыть. А с каждым новым релизом придётся обновлять и разметку.
Отдельно стоит сказать об OpenTelemetry. Сегодня это фактический стандарт observability. То есть набор стандартных API, SDK и библиотек, который единообразно описывает, как собирать трассировки.
Можно размечать код вручную через SDK, как в примере выше, а можно подключить готовые агенты автоинструментации.
Плюсы очевидны: единый формат данных и независимость от вендора. Но есть и ограничения:
-
автоинструментация OpenTelemetry покрывает популярные библиотеки и фреймворки, а бизнес-логику всё равно приходится размечать вручную;
-
OpenTelemetry отвечает за сбор и передачу телеметрии, но не за её анализ. Корреляция с инфраструктурой, построение топологии, поиск первопричины — для этого нужна отдельная платформа.
Подход №2. Автоматическая инструментация
Рассмотрим, как это устроено технически и как это работает у нас в Ключ-АСТРОМ.
Идея достаточно проста: если система знает, какие библиотеки и фреймворки использует приложение, ей не обязательно ждать, пока разработчик вручную добавит instrumentation code. Можно автоматически перехватывать интересующие операции.
Например: Application → HTTP request → Controller → Business logic → JDBC → PostgreSQL.
На каждом этапе инструментация добавляет точки наблюдения, и приложение превращается в источник структурированных telemetry-данных.
Где именно происходит автоинструментация
Конечно, это зависит от языка программирования. Условно можно выделить несколько механизмов.
Java
Для Java одним из распространённых вариантов является bytecode instrumentation. Java-приложение работает поверх JVM, поэтому агент может модифицировать bytecode классов таким образом, чтобы добавить необходимую instrumentation-логику.
Разработчик при этом исходный код не меняет. Инструментация происходит на уровне выполнения приложения.
Технически в параметры запуска приложения добавляется jar-файл агента (-javaagent), который стартует вместе с приложением. Так, например, работает OpenTelemetry Java agent.
Способ давно известен и широко используется, но у него есть ограничения:
-
приложение всё-таки модифицируется: в классы вставляется байт-код, и ошибка в инструментации может повлиять на работу приложения;
-
инструментация добавляет overhead, поэтому многие решения по умолчанию сэмплируют данные и видят не каждый запрос;
-
набор данных ограничен тем, что можно получить через вставленный код: события GC, аллокации, блокировки агенту напрямую не видны;
-
в ряде реализаций новые настройки (новый entry point или извлечение нового атрибута) применяются только после рестарта приложения.
Есть и другой путь, который мы используем в Ключ-АСТРОМ, — нативный агент на базе JVMTI.
JVMTI (JVM Tool Interface) появился ещё в Java 5, одновременно с механизмом java-агентов, но работает на другом уровне. Агент подключается к JVM как нативная библиотека (-agentpath) и получает доступ к внутренним событиям виртуальной машины.
Процесс сбора информации тоже отличается. Java-агент видит только то, что сообщает вставленный им код. Нативный агент дополнительно получает callback-уведомления от самой JVM. Что это даёт:
-
доступ к событиям, которые обычному Java-агенту не видны без внедрения кода в каждый метод;
-
возможность выполнять memory profiling: аллокации, работа GC, состояние heap;
-
гибкое управление overhead: агент сам решает, где достаточно событий JVM, а где нужна вставка кода;
-
возможность «на лету» добавлять новые точки сбора информации, без рестарта приложения.
JVMTI позволяет также сильно расширить набор собираемых событий, включая:
-
Вызовы методов (вход/выход). Это возможно без модификации байт-кода, но дорого, поэтому на практике используется точечно.
-
Создание и удаление объектов, перемещение объектов сборщиком мусора.
-
Начало/окончание сборки мусора (с деталями о поколениях).
-
Загрузка/выгрузка классов, создание потоков, блокировки, мониторы.
-
Обработка исключений, изменение состояния VM, завершение работы.
Java Agent не умеет получать эти события напрямую — для их эмуляции пришлось бы внедрять инструментирующий код в каждый метод, что дорого и ненадёжно.
-
.NET
В .NET роль, аналогичную JVMTI, играет CLR Profiling API (ICorProfiler). Агент подключается к среде исполнения через переменные окружения при старте процесса, получает уведомления от CLR и может переписывать IL-код методов на этапе JIT-компиляции. На этом же механизме построена и автоинструментация OpenTelemetry для .NET.
В Ключ-АСТРОМ для .NET мы используем два дополняющих друг друга подхода.
Во-первых, агент мониторинга размещает трассировочные операторы в основных точках кода (методах, вызовах зависимостей), обеспечивая сквозную трассировку транзакций и отслеживание зависимостей без изменения исходного кода приложения.
Во-вторых, работает always-on CPU-профилирование, которое собирает данные о горячих методах (method hotspots) и узких местах в стеке вызовов. Также агент собирает метрики сборки мусора (по поколениям Gen 0/1/2), размеры managed-памяти и другие процессные показатели.
Node.js
В Node.js ситуация ещё интереснее из-за асинхронной модели выполнения. Инструментация должна учитывать не только вызовы функций, но и сохранение контекста между асинхронными операциями. Важно не потерять связь: HTTP request → await DB → await Payment API → HTTP response. Для этого используется механизм async_hooks / AsyncLocalStorage, который позволяет «протащить» контекст трассы через цепочку промисов и колбэков.
Ключ-АСТРОМ поддерживает автоматическую инструментацию Node.js, включая наблюдение за HTTP-вызовами, базами данных и другими операциями. При этом у Node.js есть объективные ограничения, связанные с асинхронной моделью и особенностями самого runtime, так что автоинструментация здесь — не просто «вставить несколько строк кода».
Node.js работает на движке V8, поэтому агент внедряется в процесс и использует возможности рантайма для сбора данных. Ключевые возможности профилирования включают CPU-сэмплирование, метрики event loop (задержки, загрузка), а также heap-метрики и heap dumps. Отслеживаются входящие и исходящие HTTP-вызовы, запросы к поддерживаемым базам данных с захватом текста запросов, а также метрики worker threads (continuous thread analysis). Поскольку Node.js часто используется как прокси-слой между сервисами, агент автоматически выстраивает связи между вызовами, позволяя видеть распределённые транзакции в контексте всей цепочки.
Go
Go компилируется напрямую в машинный код, у него нет виртуальной машины с готовым интерфейсом для перехвата. Поэтому автоинструментация в Go устроена иначе: агент перехватывает вызовы функций на уровне скомпилированного бинарника, без перекомпиляции приложения. Для сравнения: в OpenTelemetry для Go автоинструментация строится либо на eBPF-зондах (uprobes), либо на инструментации во время сборки. Это обеспечивает full code-level visibility: агент мониторинга различает код, выполняемый в контексте распределённой трассировки (например, обработчик входящего HTTP-запроса), и фоновые активности.
Каждый входящий запрос в net/http порождает новую горутину — она и связанные с ней горутины помечаются как service-related, тогда как остальные учитываются как background. В Ключ-АСТРОМ агент оптимизирован для работы с параллелизмом Go и избегает неявных точек синхронизации между горутинами при сборе данных. Также собираются специфичные для Go метрики: размеры heap (offheap, stack), количество объектов, вызовы GC, состояние worker-потоков и очередей горутин.
Автообнаружение процессов
Осталось разобраться, как агент вообще узнаёт, какой процесс и на каком языке ему инструментировать. В Ключ-АСТРОМ за это отвечает автоматическое обнаружение процессов с последующей активацией соответствующих code modules для поддерживаемых технологий. Один агент на хосте может собирать данные сразу для нескольких типов сущностей и приложений.
Это принципиально отличается от модели «установить отдельный агент + изменить код приложения + подключить SDK + настроить каждый сервис».
Вместо этого получается: установить агент → обнаружить процесс → определить технологию → активировать code module → инструментировать поддерживаемые операции → собрать телеметрию. Именно автоматическое прохождение этой цепочки делает подход интересным для больших инфраструктур.
При запуске процесса агент определяет, что именно было запущено, и, если процесс поддерживается и не исключён правилами, устанавливает связь с соответствующим модулем глубокого мониторинга. В результате инструментация становится частью работающего процесса. После внедрения агент получает возможность наблюдать за интересующими операциями непосредственно внутри процесса.
Комбинирование подходов
У автоинструментации есть естественные границы: самописные протоколы, нестандартные фреймворки, внутренняя бизнес-логика. Например, «рассчитать скоринг клиента» для агента — просто цепочка вызовов методов, без бизнес-смысла. В таких местах автоматическое покрытие дополняют ручной разметкой.
Поэтому Ключ-АСТРОМ не ограничивается собственной моделью инструментации. Единый агент может работать совместно с OpenTelemetry и объединять OpenTelemetry spans с данными, полученными собственной инструментацией. Для этого предусмотрены механизмы настройки span capturing, context propagation и entry points. Получается гибридная модель.
Заключение
Если коротко, автоинструментация превращает обычное приложение в источник подробной телеметрии, плюс никому не нужно вручную расставлять tracing-код по всему проекту. Под капотом всё выглядит примерно так:
Application → Process discovery → Technology detection → Code instrumentation → Operation interception → Span generation → Context propagation → Distributed trace → Service detection → Topology → Code-level visibility → Problem investigation
Но смысл не в том, чтобы просто «поставить агент», а в том, когда агент понимает, что происходит внутри приложения, связывает операции между сервисами и не теряет нить запроса: от клика пользователя до конкретного метода, SQL-запроса или внешнего API. Этот шаг от «сервер жив, CPU в норме» к «вот путь, по которому прошёл запрос» — главная идея современного APM.
В Ключ-АСТРОМ автоинструментация не живёт отдельной фичей, она встроена в общую картину. Агент сам находит процессы, подключает подходящие модули, собирает данные на уровне кода, связывает их через distributed tracing и строит по ним карту сервисов и зависимостей. А где автоматического покрытия недостаточно или оно невозможно, его дополняют OpenTelemetry и ручной разметкой.
Получается вполне практичный рецепт: сначала собрать автоматически максимум полезной информации → стандартизировать то, что должно быть стандартизировано → вручную дополнить только действительно уникальные участки приложения.
В больших распределённых системах команда переносит фокус с вопроса «Как нам вообще это инструментировать?» на более полезный: «Где именно потерялись эти 4 секунды?»
Автор: AmidN

