


Когда LLM в компании используют несколько энтузиастов, можно обойтись личными ключами и договорённостями в духе «не отправляйте ничего чувствительного». Но когда к моделям подключаются десятки команд, IDE, внутренние агенты и автоматизации, эксперимент превращается в инфраструктуру — с требованиями к безопасности, стоимости и отказоустойчивости.
В статье разберём, как AI Gateway становится единой точкой доступа к моделям: проверяет и обезличивает данные до отправки, управляет правами и лимитами, маршрутизирует запросы между провайдерами и позволяет увидеть реальную экономику корпоративного ИИ. Отдельно поговорим о совместимости с OpenAI API, миграции на китайские модели и границах между Gateway, DLP и MCP.
Меня зовут Назар Башинский, я разработчик в AGIMA.
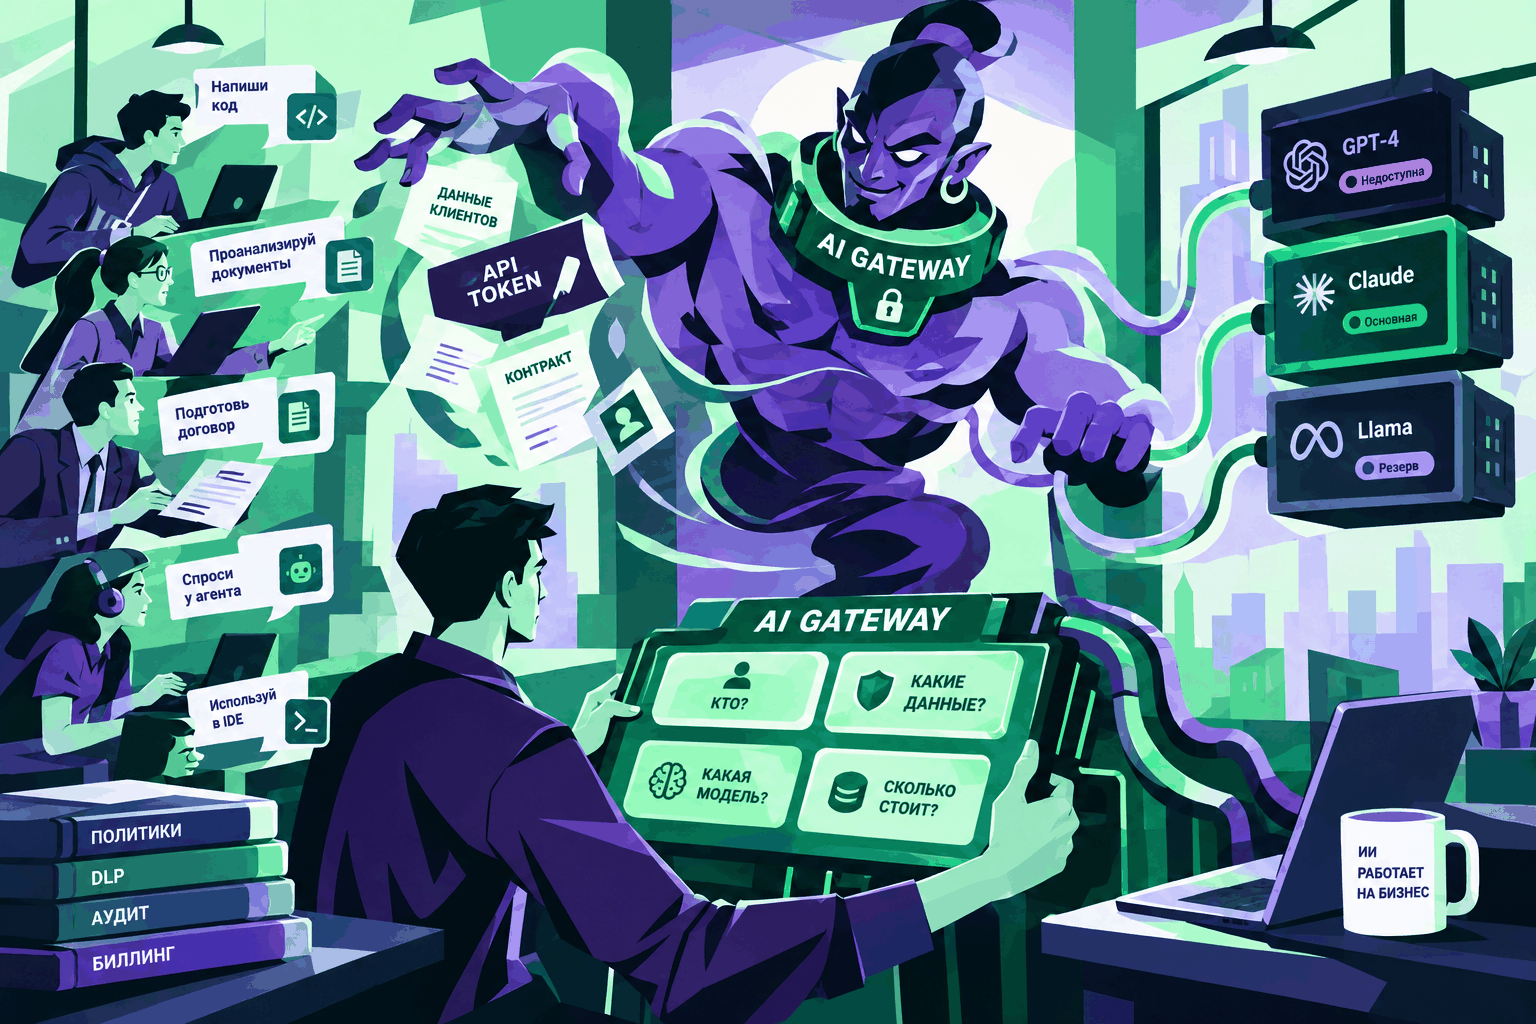
AI Gateway нужен именно в этой точке. Это слой между людьми, агентами, корпоративными системами и LLM-провайдерами. Он не делает модель умнее, зато делает использование LLM наблюдаемым, управляемым и безопаснее для компании.
Gateway — не просто прокси
В минимальном варианте AI Gateway выглядит как прокси: клиент отправляет запрос в совместимый API endpoint, а gateway пересылает его к нужной модели. Но если слой только гоняет JSON туда-сюда, ценность быстро заканчивается.
Корпоративный gateway нужен, чтобы перед каждым запросом принять несколько решений:
-
кто делает запрос и из какого инструмента;
-
к каким моделям и функциям у пользователя есть доступ;
-
не содержит ли запрос персональные данные, токены, секреты или клиентскую информацию;
-
нужно ли замаскировать часть данных до отправки;
-
какая модель подходит по качеству, стоимости, latency и политике;
-
куда переключиться, если основной провайдер недоступен;
-
что записать в аудит и как отнести стоимость на команду, проект или центр затрат.
Такой набор функций уже виден у зрелых gateway-решений. Cloudflare AI Gateway описывает аналитику, логи, caching, rate limiting и fallback. Kong выделяет маршрутизацию и governance для AI-трафика. Microsoft показывает GenAI gateway-паттерны в Azure API Management: token limits, quotas, load balancing и управление потреблением. То есть рынок уже смотрит на LLM не как на отдельный чат, а как на трафик, который нужно контролировать.
Почему нельзя просто «дать всем ChatGPT»
Проблема крупных компаний редко в том, что сотрудники не хотят пользоваться ИИ. Обычно наоборот: они уже подключают ИИ-функции в IDE, браузерные чаты, CLI, внутренних агентов и внешние сервисы. При этом ChatGPT официально недоступен в России, поэтому сотрудники могут обращаться к нему через неуправляемые и не одобренные компанией способы.
Для enterprise это особенно опасно: есть требования информационной безопасности, персональные данные, клиентские NDA, внутренний код, договорные ограничения и ответственность за то, куда уходит корпоративная информация. Последствия могут быть не только репутационными. Например, за повторные утечки персональных данных для компаний предусмотрены оборотные штрафы — от 20 млн рублей.
Простой запрет не работает: люди находят обходные пути, потому что модели уже помогают им писать код, анализировать тексты, готовить ответы и ускорять рутинные задачи. Полное разрешение тоже опасно: компания теряет контроль над данными, бюджетами и юридическими рисками.
Нужен третий вариант: удобный корпоративный доступ к моделям через единый управляемый слой. Сотрудник продолжает работать в привычном инструменте, а компания получает политики доступа, DLP, аудит, лимиты и маршрутизацию запросов.
Как проходит один запрос
Упрощённый пайплайн выглядит так:
IDE / чат / агент / OpenWebUI

↓

AI Gateway

↓

Auth: кто пользователь

↓

Policy: что ему разрешено

↓

DLP: есть ли ПДн, токены, секреты, клиентский код

↓

Depersonalization: замена чувствительных сущностей на маркеры

↓

Router: выбор модели, провайдера и режима

↓

LLM

↓

Reverse depersonalization, если она допустима

↓

Audit, billing, metrics

↓

Ответ пользователю
Главная проверка должна происходить до выхода запроса к модели. Если в промпт попал API-токен или фрагмент клиентского договора, его недостаточно потом увидеть в логах. Его нужно остановить, вырезать или заменить до отправки во внешний сервис.
Для российских компаний отдельно важна рамка 152-ФЗ «О персональных данных». Не каждый промпт с именем автоматически становится юридической катастрофой, но gateway должен помогать контролировать состав данных, цель обработки, контур передачи и допустимость отправки внешнему поставщику. Конкретная схема зависит от сценария, оператора, состава данных и трансграничной передачи, поэтому перед публикацией такие формулировки стоит согласовать с ИБ и юристами.
Совместимый API снижает цену внедрения
У сотрудников уже есть рабочие привычки: IDE, CLI, чат, OpenWebUI, внутренние агенты. Если заставить каждую команду переписывать интеграции под новый корпоративный стандарт, внедрение gateway может остановиться на старте.
Поэтому важна совместимость с распространенными API-форматами. Для пользователя меняется минимум: base URL и токен. Инструмент продолжает работать привычным образом, но запрос идет не напрямую к модели, а через корпоративный слой.
Совместимость важна и для миграций. Модельный рынок меняется быстрее, чем корпоративные интеграции. Сегодня команда использует одного провайдера, завтра переносит часть сценариев на другую модель, послезавтра добавляет локальную модель для чувствительных данных. Если весь код жестко завязан на один API, миграция превращается в длинный хвост переписываний. Gateway берет на себя маппинг протоколов, routing и часть несовместимостей, чтобы клиенты менялись медленнее, чем поставщики моделей.
Мы потратили много времени и набили немало шишек при миграции между моделями — особенно когда переходили с OpenAI API на API китайских провайдеров.
На бумаге всё выглядит красиво: заявлена совместимость с OpenAI API. На практике часть инструментов, например веб-поиск, распознавание и генерация изображений, может отсутствовать или работать иначе. Чтобы сохранить совместимость существующих клиентов и сценариев, недостающую функциональность приходится реализовывать на уровне LLM Gateway.
Деперсонализация сложнее, чем кажется
На уровне идеи деперсонализация выглядит просто. Пользователь пишет:
Покажи задачи Васи за прошлую неделю
Gateway заменяет имя на технический маркер:
Покажи задачи PERSON_1 за прошлую неделю
Модель отвечает с тем же маркером, а система на обратном пути восстанавливает исходную сущность.
В реальных корпоративных сценариях этого мало. Внутренние системы работают не со строкой из текста, а с канонической сущностью: сотрудником, его ID, логином, записью в справочнике. Вася, Василий и Vasily могут быть одним человеком; имя может прийти в падеже; часть данных может быть на русском, часть на английском; LLM может вернуть маркер не в обычном тексте, а в tool call.
Если просто заменить строку обратно, автоматизация может сломаться или обратиться не к той сущности. Поэтому рядом с деперсонализацией нужен entity resolution: сопоставление текстовой формы с каноническим объектом внутри корпоративного контура. Это пример того, почему AI Gateway быстро выходит за рамки прокси: он начинает понимать не только провайдеров моделей, но и правила работы с корпоративными данными.
Что gateway не должен выпускать наружу
На gateway обычно навешивают несколько типов политик. Базовый слой — ФИО, телефоны, email, паспортные данные, СНИЛС, ИНН, API-токены, пароли, ключи, секреты из кода, клиентские NDA-данные, фрагменты внутренних документов и проектная информация.
Часть политик должна блокировать запрос. Часть — маскировать опасный фрагмент. Часть полезно запускать в review или shadow mode: система только пишет срабатывания в аудит, но не мешает пользователю.
Для внедрения это принципиально. Если в первый день включить жесткие блокировки на все подозрительное, сотрудники решат, что корпоративный AI мешает работать, и вернутся к обходным путям. Более рабочая траектория: сначала наблюдение, затем разбор ложных срабатываний, настройка правил и только потом enforcement для самых рискованных классов данных.
Токены становятся управленческой метрикой
Когда все ходят в модели через gateway, компания впервые видит реальную экономику AI. Не абстрактное «мы активно пользуемся нейросетями», а конкретные срезы.
Например, в отчёте за месяц компания может увидеть, что Иван Петров из отдела продаж использовал модели в рамках проекта «Личный кабинет клиента» через SiteOS и автоматизацию подготовки коммерческих предложений. За этот период он отправил 1,2 млн входных токенов и получил 800 тыс. выходных токенов, а общая стоимость использования составила 420 рублей.
Эти данные нужны не только финансам. Они помогают понять, сколько тратит отдел, где дорогая модель действительно оправдана, какие команды используют AI системно, какие сценарии можно перевести на более дешевую модель и какую стоимость отнести на проект или центр затрат.
Для enterprise это часто не менее важно, чем маршрутизация. Gateway превращает LLM из общей подписки «где-то у кого-то» в управляемый ресурс.
Fallback: когда модель упала
LLM-провайдеры иногда недоступны. У них могут закончиться лимиты, измениться API, вырасти latency, сломаться конкретная модель или регион.
Если каждая автоматизация ходит в модель напрямую, отказ одного провайдера превращается в набор несвязанных инцидентов: где-то падает чат, где-то IDE, где-то пайплайн, где-то агент. Gateway позволяет управлять деградацией централизованно:
Запрос уходит в основную модель

↓

Модель недоступна или возвращает ошибку

↓

Gateway фиксирует отказ

↓

Circuit breaker временно закрывает проблемный маршрут

↓

Запрос уходит в fallback-модель

↓

Пользователь получает ответ или понятное сообщение о деградации
Fallback не означает, что все модели одинаковые. Если сильная reasoning-модель недоступна, запасная может дать результат хуже. Поэтому правила деградации должны быть явными: где можно переключиться автоматически, где нужно предупредить пользователя, а где лучше остановить сценарий, чем получить слабый ответ.
Где провести границы
AI Gateway, MCP Gateway, DLP, depersonalization и guardrails часто смешивают в одну сущность. В MVP это понятно: функций мало, команда одна, все хочется собрать рядом. Но для развития платформы границы лучше провести сразу.
AI Gateway отвечает за доступ к моделям: маршрутизацию, ключи, лимиты, аудит, совместимость API, fallback и стоимость. DLP проверяет данные: что можно отправлять, что нужно замаскировать, что следует заблокировать. Depersonalization заменяет чувствительные сущности и восстанавливает их на обратном пути. MCP Gateway управляет доступом агентов к Jira, Wiki, CRM, DWH, GitLab и другим корпоративным системам. Guardrails описывают допустимое поведение агента: какие действия разрешены, когда нужно подтверждение, какие ответы нельзя выдавать.
Если все это назвать одним gateway, система быстро превращается в «волшебную коробку», которую сложно развивать, поддерживать и объяснять ИБ.
Что заложить с первого дня
Если проектировать такой слой не как эксперимент, а как production-инфраструктуру, я бы заложил пять вещей сразу.
Первое — владельца сервиса, мониторинг, алерты, runbook, staging и понятную поддержку. Gateway быстро становится зависимостью для людей и автоматизаций.
Второе — аудит с самого начала. Когда AI уже используют десятки людей, восстановить историю потребления задним числом почти невозможно.
Третье — проверку реальной совместимости клиентов. Streaming, tool calls, vision, structured output, разные SDK и IDE ломаются в деталях, а не в презентационных схемах.
Четвёртое — DLP через shadow mode. Сначала нужно увидеть реальные срабатывания и ложные позитивы, потом включать блокировки.
Пятое — разделение публичной архитектуры и внутренних временных решений. В статье, документации и клиентских материалах должны оставаться только те решения, которые можно легально поддерживать и объяснять.
Итог
AI Gateway нужен не тогда, когда компания «хочет попробовать нейросети». Для экспериментов хватит личного аккаунта, пары скриптов и осторожности.
Gateway нужен, когда AI становится рабочей средой: сотрудники используют LLM каждый день, агенты ходят во внутренние системы, бюджеты становятся заметными, а ИБ хочет понимать, какие данные куда уходят.
В этот момент единая точка входа перестаёт быть архитектурной прихотью. Она становится способом дать компании AI без потери контроля.
Если вам близка тема корпоративной AI-инфраструктуры, подпишитесь на Telegram-канал нашего CTO «Непряхин и машины»: там он пишет про разработку, AI, аутсорс, продажи и управление людьми.
Что еще почитать
-
Почему мы не нашли готового PII-детектора для русского языка: грабли боевого контура перед LLM — про маскирование персональных данных, кириллицу, морфологию и устройство защитного слоя перед моделью.
-
Дообучение детектора промпт-инъекций: пять раундов, четыре неудачи и гейты против регресса — продолжение про обучение guard-модели, релизные гейты и ошибки в боевом контуре.
-
GenAI и кибербезопасность в e-commerce: как защитить бизнес и не создать новые уязвимости — более широкий разбор рисков GenAI, данных, API и уязвимостей в бизнес-системах.
Автор: nbhk2015

