


С 1 сентября 2026 года в России действует первый специальный федеральный закон об искусственном интеллекте — № 243-ФЗ. А с 1 марта 2027 года начнут действовать отдельные нормы об информировании пользователей о правах на результаты, созданные с помощью ИИ.
НООООООО новый закон не дал бизнесу главного ответа: кому принадлежат права на то, что сотрудники создают с помощью ChatGPT, Claude, Midjourney и других нейросетей? Основные вопросы авторства по-прежнему приходится решать через ГК РФ и разбираться, какой творческий вклад в результат внёс человек.
На связи Стефан Соловьев, юрист AG-LEGAL, пока ещё не заменённый нейросетью. Разберёмся, кому могут принадлежать права на ИИ-контент и что стоит предусмотреть компании, чтобы не обнаружить проблему уже после публикации или релиза. В меню:
-
Почему об этом столько говорят
-
Что говорит российское авторское право
-
Промпт не является свидетельством о праве собственности
-
А когда результат принадлежит компании?
-
А в России уже есть закон об ИИ?
-
Что говорят ChatGPT и Claude
-
Уже есть суды?
-
Что делать, если компания использует ИИ?
Сегодня примерно в каждой компании smm-щик написал пост в ChatGPT, дизайнер собрал иллюстрацию в Midjourney, разработчик попросил Claude дописать модуль, потом поправил код и отправил его в прод. Компания заплатила зарплату, подписку на сервис, налоги, авторское вознаграждение. Кажется логичным, что все права теперь у компании. Но в споре могут всплыть неприятные детали, которые не кажутся достойными внимания на первый взгляд. Среди них:
-
нейросеть не может быть автором по российскому праву;
-
сотрудник тоже не обязательно становится автором только потому, что он написал промпт;
-
сервис передаёт пользователю лишь те права, которые у самого сервиса вообще могли быть;
-
результат может совпасть с чужим или содержать фрагменты, права на которые принадлежат третьим лицам;
-
вместе с запросом сотрудник может отправить иностранному провайдеру персональные данные и коммерческую тайну.
Поэтому вопрос «правда ли, что нейронке не принадлежат права?» не совсем корректный. Если коротко — да. Если развернуто — добро пожаловать в законодательство и судебную практику :)
Если права не принадлежат ИИ, это ещё не значит, что они автоматически достаются тому, кто первым нажал кнопку «сгенерировать». Нужно разобраться, возникло ли вообще авторское право на результат, кто внёс в него творческий вклад и как права этого человека перешли компании. А заодно не нарушены ли при создании результата чужие права, требования конфиденциальности и правила обработки данных.
Без однозначных ответов на эти вопросы и без учета деталей выше, всё то, что создаётся ИИ для компании может находиться в серой (а иногда и в черной) зоне.
Почему об этом столько говорят
Если вы используете нейросеть, чтобы сгенерировать мем для чата с друзьями, вопрос об авторстве кажется душным и как будто не нужным.
Но он становится практическим, когда результат превращается в актив, как это происходит в компании: логотип идет на регистрацию и в рекламу, код попадает в коммерческий продукт, дизайн передают крупному заказчику с гарантией юридической чистоты, инвестор проверяет права на ИС перед сделкой и так далее.
Если результат не охраняется авторским правом, компания не сможет запретить конкуренту использовать его только на том основании, что «мы сделали это первыми». Если авторское право возникло, но переход прав не оформили, правообладателем может остаться сотрудник или подрядчик. А если ИИ использовал в результате чужие элементы, претензии могут прийти уже к компании, которая опубликовала материал или включила код в свой продукт.
Во всём этом получается неприятная конструкция, когда у бизнеса нет реальных прав, а ответственность перед третьими лицами всё равно может появиться.
Что говорит российское авторское право
По статье 1257 ГК РФ автором произведения признается гражданин, творческим трудом которого оно создано. Статья 1228 ГК РФ отдельно уточняет, что техническая, организационная или материальная помощь сама по себе авторства не создает.
Авторское право возникает автоматически в момент создания произведения, отдельно регистрировать текст, изображение или код не нужно! Но защищается конкретный результат творчества, а не сама идея. Другой человек может использовать похожую идею и получить собственный результат.
Поэтому для авторского права важно не только что вы придумали, но и какой конкретный результат был создан и какой творческий вклад в него внёс человек.
Из этого следуют три базовых вывода.
-
нейросеть автором быть не может. Паспорта у нее пока нет (надеюсь, и не будет) + российский закон связывает авторство именно с человеком и его творческим трудом;
-
владение аккаунтом или оплата подписки не равны авторству. Деньги отвечают на вопрос о доступе к сервису, но не доказывают творческий вклад в конкретный результат;
-
использование ИИ не лишает человека авторства автоматически. Фотошоп, камера, музыкальный синтезатор тоже являются инструментами. Вопрос в том, управлял ли человек созданием формы произведения или только сформулировал задачу, а все выразительные решения приняла модель.
Фраза «ИИ всего лишь инструмент» может быть верной, но ее мало написать в договоре или иске. Нужно показать, как именно человек этим инструментом пользовался.
Промпт не является свидетельством о праве собственности
Сам по себе промпт может охраняться как текст, если он достаточно оригинален. Но права на промпт и права на полученную картинку, статью или программу не одно и то же. Допустим, пользователь пишет: «Нарисуй ночную Москву в стиле киберпанк». Идея пришла от человека, но композицию, свет, персонажей и детали выбрала модель. Убедительно доказать авторство пользователя в итоговом изображении будет сложно.
Ещё пример. Дизайнер делает эскиз, задает композицию и палитру, генерирует десятки вариантов отдельных элементов, отбирает и сочетает их, вручную меняет перспективу, свет и детали, а затем доводит макет в графическом редакторе. Здесь человеческий вклад заметнее, поэтому охраняться может итоговая композиция и внесенные человеком элементы.
С кодом логика та же, ибо ПО охраняется как литературные произведения, в том числе в форме исходного текста. Но генерация файла по короткому запросу и разработка системы с помощью ИИ-ассистента выглядят юридически по-разному.
|
Как создавался результат |
Что с авторством человека |
|---|---|
|
Один общий промпт, результат опубликован без изменений |
Слабо, ибо трудно показать контроль над выразительной формой |
|
Очень подробный промпт, но модель самостоятельно выбрала финальную форму |
Лучше, но объем промпта сам по себе еще ничего не гарантирует |
|
Несколько итераций, осознанный отбор, сочетание вариантов и ручная переработка |
Сильнее, особенно если процесс сохранен |
|
ИИ предложил идеи или факты, человек самостоятельно написал финальный текст |
Обычно автором текста будет человек |
|
ИИ предложил фрагменты, разработчик спроектировал архитектуру, переработал код, интегрировал и протестировал его |
Авторство человека в программе в целом и в его собственных элементах обосновать проще |
|
Модель сгенерировала модуль, который без проверки отправили в продукт |
Высокий риск и для авторства, и для качества, безопасности, лицензий |
❗️Важно: наша таблица – это не формула суда и не шкала с гарантированным результатом, каждый объект всегда оценивают отдельно. Более того, два судьи в одном и том же суде могут по-разному смотреть на одинаковый результат. Практика всё ещё не устоялась, трактовок всё ещё может быть очень много.
Но общий принцип понятен: чем больше человек определял конкретную форму результата, тем проще обосновать его творческий вклад.
А компании результат когда принадлежит?
Даже доказанное авторство сотрудника еще не завершает анализ. Если произведение создано работником в пределах трудовых обязанностей, по общему правилу исключительное право принадлежит работодателю. Это следует из статьи 1295 ГК РФ. Но работодателю для доказательства потребуется трудовой договор, должностные обязанности, служебное задание, переписка о приемке и версия результата.
С подрядчиком права нужно распределить в договоре. Формулировка «заказчик оплатил работу» не заменяет условие об исключительном праве. Для программ и баз данных, созданных по заказу, есть специальное правило статьи 1296 ГК РФ, но полагаться только на название договора все равно рискованно. Предмет, режим создания результата, момент перехода прав и вознаграждение лучше описать прямо.
Здесь есть важная оговорка. Документы не создают авторство задним числом, потому что они фиксируют реальный процесс и выстраивают цепочку прав. Если охраняемого результата не возникло, передавать компании может быть нечего.
А в России уже есть закон об ИИ?
С 1 сентября 2026 года действует Федеральный закон от 26 июля 2026 года № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации». Но он, к сожалению, не отвечает одной строкой на вопрос, кто автор любой картинки или программы, созданной с помощью ИИ. Закон в основном регулирует разработку и применение больших фундаментальных моделей, меры поддержки российских разработчиков и отдельные обязанности провайдеров.
Для нашей темы там есть полезности – две нормы, которые вступят в силу с 1 марта 2027 года:
-
статья 9 говорит о возможности размещать предупреждение об использовании ИИ в аудио- и визуальных материалах. Крупные платформы должны дать пользователям техническую возможность поставить такое предупреждение;
-
статья 10 обязывает провайдера модели информировать пользователя о принадлежности прав на результаты, созданные с помощью ИИ, а также об условиях доступа, использования и хранения таких результатов. Эта же статья вводит ограниченное правило об использовании произведений при обучении суверенных и национальных моделей.
Основные вопросы авторства по-прежнему решаются через часть четвертую ГК РФ. Пока прямо не урегулированы точный порог творческого вклада пользователя, единая презумпция принадлежности прав на результат заказчику или владельцу аккаунта, универсальные требования к доказательствам процесса создания и куча других очень важных вопросов.
Что говорят ChatGPT и Claude
Условия зарубежного сервиса нужно читать отдельно от российского закона. Они регулируют отношения между пользователем и провайдером, но не могут заставить российский суд признать объект произведением.
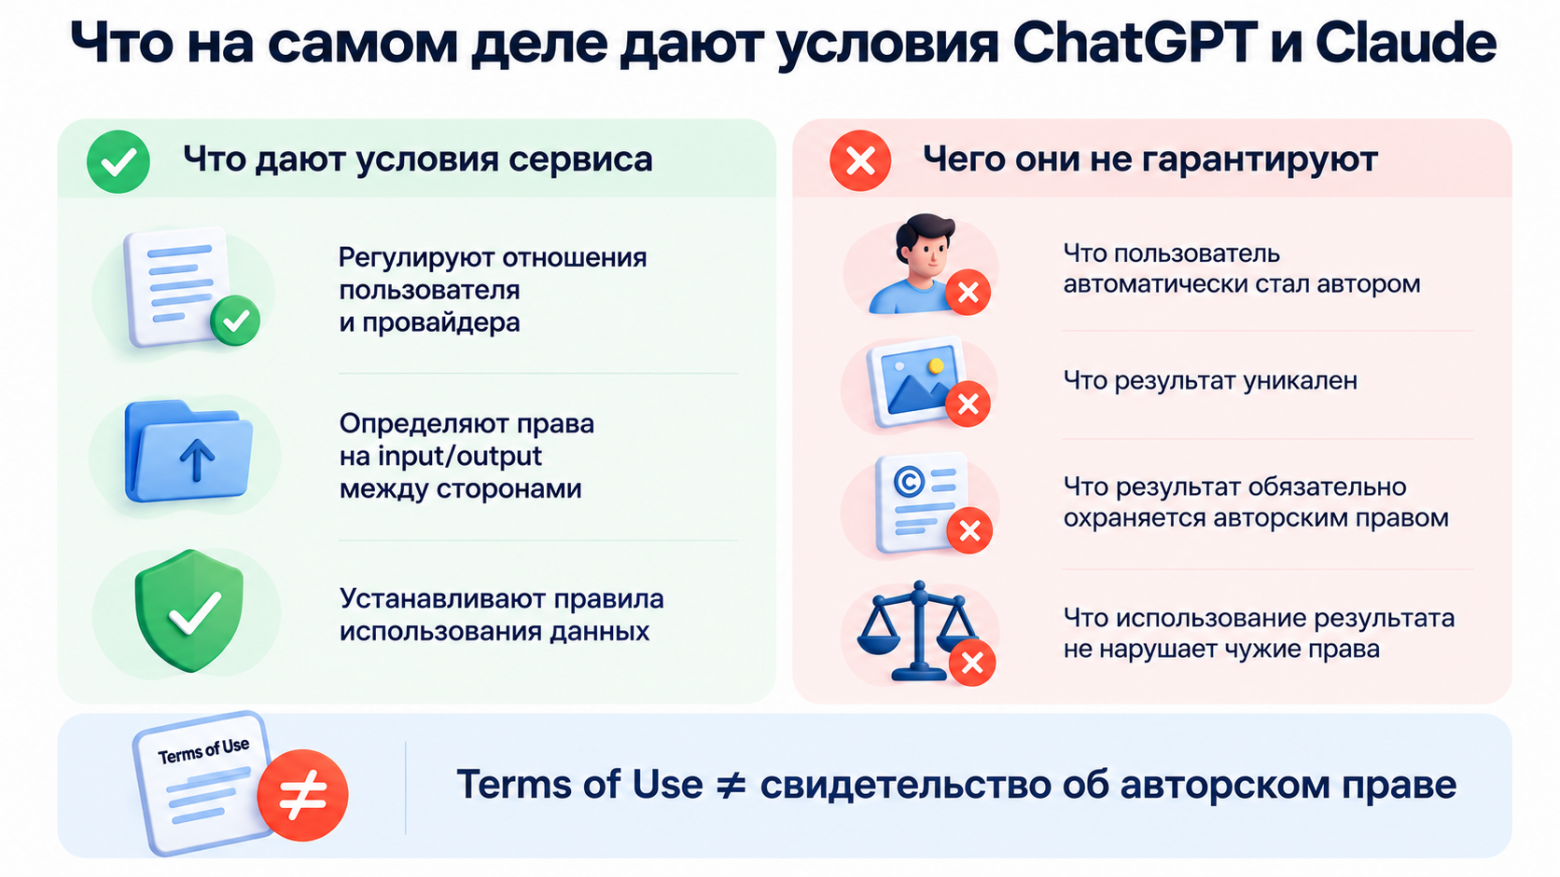
В условиях OpenAI логика примерно такая: то, что пользователь загружает в сервис, остаётся его. А права, которые могут принадлежать самой OpenAI на сгенерированный результат, компания передаёт пользователю. Но это не делает пользователя автором автоматически. Пользовательское соглашение OpenAI регулирует отношения между сервисом и пользователем, но не может само по себе превратить любой ответ ChatGPT в произведение, защищённое авторским правом. Результат может быть неуникальным, а значит другой пользователь может получить похожий ответ.
У Anthropic похожий подход. Пользовательское соглашение закрепляет права пользователя на инпут и передает ему возможные права Anthropic на аутпут, но при этом возлагает на пользователя ответственность за исходные данные и необходимые разрешения. Материалы потребительского аккаунта могут использоваться для обучения, если не выбран отказ. По коммерческим условиям клиент сохраняет права на инпут и получает аутпут, а Anthropic не обучает модели на контенте коммерческих клиентов.
Ключевые слова в обоих случаях: «в отношениях между сторонами» и «в той мере, в какой допускает закон». Провайдер снимает возможный спор между собой и клиентом. Он не выдает государственное свидетельство об авторстве и не гарантирует уникальность результата.
Есть еще один момент. Россия отсутствует в опубликованных перечнях поддерживаемых стран OpenAI и Anthropic. Ну вы знаете! Для российского бизнеса это означает риск блокировки, изменения доступности и сложностей с корпоративным оформлением отношений. Если сотрудник работает через личный аккаунт, компания может даже не знать, какую версию условий он принял, включено ли обучение на данных и где хранится история запросов.
Эта история, кстати, как раз совсем недавно всплыла в деле «Родина» против «Яблока», где Верховный суд как раз ссылался на это. Раз России нет в перечне, то и пользовательское соглашение не распространяется, а потому картинка, сгенерированная СhatGPT всё ещё принадлежит OpenAI.
Уже есть суды?
Да! Они хорошо показывают, почему одной красивой формулы пока нет.
В деле № 02-4220/2025 Пресненский районный суд Москвы рассматривал спор об изображениях с Моной Лизой и Статуей Свободы, измененных с помощью ИИ. В первой инстанции истцу отказали. Суд не увидел доказательств достаточного творческого вклада в спорные объекты и, среди прочего, отметил, что авторское право не охраняет сами идеи и концепции. Этот вывод нельзя превращать в правило «все изображения с ИИ не охраняются». Суд оценивал конкретные работы, доводы и доказательства.
В деле № А40-47850/2026 получился другой акцент. Оппонент ссылался на автоматическое создание спорных работ, однако не доказал отсутствие человеческого участия. Девятый арбитражный апелляционный суд оставил решение первой инстанции без изменения. Суд признал автором любого пользователя нейросети, а одного подозрения, что работа создана ИИ, может быть недостаточно.
За рубежом подход тоже строится вокруг человеческого вклада. Апелляционный суд США в деле Thaler подтвердил отказ в регистрации изображения, для которого единственным автором была указана машина. Ведомство по авторскому праву США в докладе об охраноспособности AI-результатов пришло к более тонкому выводу: использование ИИ как вспомогательного инструмента не мешает охране человеческого творчества, но одних промптов при нынешних технологиях обычно недостаточно для контроля над выразительными элементами результата.
Для российского суда эти документы не являются источником права, но они показывают общую проблему, с которой сталкиваются разные юрисдикции: нужно отделить идею и постановку задачи от творческого контроля над финальной формой.
Что делать, если компания использует ИИ?
Запрещать ИИ целиком обычно бессмысленно. Сотрудники продолжат пользоваться им, только компания перестанет видеть этот процесс. Лучше открыто определить допустимые сценарии и оставить след, достаточный для уровня риска.
1. Проведите короткую инвентаризацию. Узнайте, какие команды, сервисы и аккаунты уже используются. Отдельно отметьте работу с кодом, клиентскими материалами, HR-данными, медицинской информацией, изображениями людей и коммерческой тайной.
2. Разделите сценарии по риску. Для идей заголовка и черновика внутреннего письма достаточно простых правил. Для логотипа, ключевого программного модуля, рекламной кампании или материала клиента нужен более строгий процесс и доказательства человеческого вклада.
3. Утвердите сервисы и корпоративные аккаунты. Зафиксируйте, какими продуктами можно пользоваться, кто покупает подписку, какие настройки обязательны, допускается ли обучение на запросах, сколько хранятся данные и как сотрудник передает компании историю работы при увольнении или смене роли. Для значимых проектов полезно сохранять действовавшую на тот момент версию условий сервиса: провайдеры их обновляют.
4. Ограничьте входящие данные. В правилах нужны не общие слова «не разглашать конфиденциальное», а понятные примеры. Нельзя вставлять боевую базу, ключи, непубличный код клиента, договор с реквизитами и переписку с персональными данными. Если задачу можно решить на синтетических или действительно обезличенных данных, используйте их.
5. Сохраняйте человеческий вклад. Для значимых результатов храните постановку задачи, промпты, промежуточные версии, комментарии, историю правок и финальную приемку. Не нужно архивировать каждую просьбу исправить запятую. Глубина фиксации должна соответствовать цене актива и вероятности спора.
6. Обновите договоры. С сотрудниками проверьте трудовые функции, режим служебных произведений и внутреннюю ИИ-политику. С подрядчиками стоит согласовать, можно ли использовать ИИ и в каких сервисах, какие данные запрещено отправлять модели, обязан ли подрядчик раскрыть использование ИИ и так далее.
7. Проверяйте результат перед публикацией и релизом. Для текста и изображений это проверка источников, сходства, товарных знаков, изображений людей и лицензий исходных материалов. Для кода к обычному ревью добавляются тестирование, поиск секретов и анализ зависимостей и лицензий. Нейросеть не должна быть последней инстанцией, даже если ответ выглядит уверенно.
Что держать на контроле
Юридическая рамка будет меняться очень быстро. Я бы поставил на регулярный контроль пять вещей:
-
Подзаконные акты и практику применения Закона № 243-ФЗ, особенно правила информирования о правах и маркировки с марта 2027 года.
-
Российские решения, в которых суды будут оценивать конкретный человеческий вклад, а не только наличие или отсутствие ИИ.
-
Условия выбранных провайдеров, распределение прав, обучение на данных, сроки хранения, доступ администраторов и поддерживаемые страны.
-
Требования по локализации и трансграничной передаче персональных данных.
-
Лицензии и политики моделей, которые компания запускает локально. Опен-сорс не всегда означает отсутствие ограничений на использование модели и ее результатов.
Вместо вывода
ИИ сам по себе прав не получает. Автором может быть человек — если в результате есть его творческий вклад. А чтобы исключительные права оказались у компании, нужно правильно оформить их переход от сотрудника или подрядчика. Условия ChatGPT, Claude и других сервисов этого не заменяют.
Поэтому для бизнеса нейросеть лучше воспринимать не как автомат с безлимитным «чистым» контентом, а как ещё один инструмент внутри обычного рабочего процесса. Если с помощью ИИ создаётся код, дизайн, текст или другой значимый для компании результат, должны быть понятны правила его использования: что можно загружать в сервис, кто и как проверяет результат, кому принадлежат права и чем можно подтвердить вклад человека.
Тогда вопрос «кому принадлежат права на творчество ИИ?» превращается в гораздо более полезный: «может ли компания доказать права на результат, который она использует?».
Жду вопросы в комментариях!
Если хочется уточнить еще пару вопросов по персональным данным при работе с ИИ внутри компании или нужно правильно оформить права на то, что ваши сотрудники нагенерили – напишите мне в телеграме.
Ещё про ИИ и не ИИ писал тут:
Автор: zoomerlawyer

