


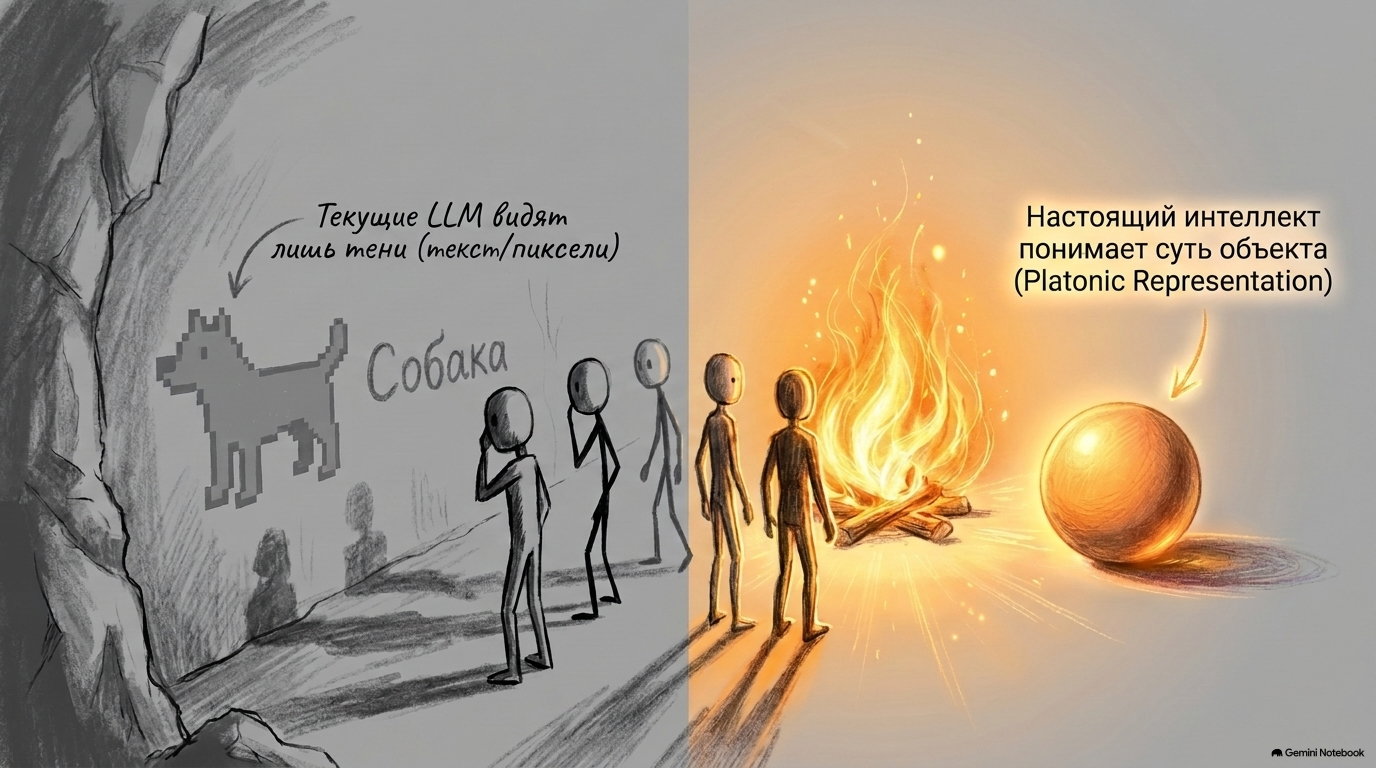
Важный дисклеймер: это адаптация недавнего исследования Рэнделла Балестриеро и Яна ЛеКуна «Proving and Improving the Platonic Representation Hypothesis with JEPAs». Оно наделало так много шума, что Ян чуть позже в своем *** фоллоу-апом сделал пост со ссылкой на видео, поясняющее концепцию этой работы. Я постаралась осмыслить работу с опорой на последние оговорки одного из авторов исследования.
❗️ Иллюстрации к статье сгенерированы с помощью Gemini Notebook
Индустрия искусственного интеллекта оказалась в плену авторегрессионной монокультуры. Ведущие технологические гиганты инвестируют сотни миллиардов долларов в строительство гигантских дата-центров, масштабируя традиционные языковые модели (LLM) до сотен миллиардов параметров и скармливая им десятки триллионов токенов текста. Однако фундаментальная проблема остается нерешенной: современные нейросети способны решать задачи университетской математики и проходить юридические экзамены, но оказываются абсолютно беспомощными при попытке управлять физическим роботом или вести автомобиль без ухищрений.
Новое фундаментальное исследование Рэнделла Балестриеро (Brown University) и Яна ЛеКуна (AMI Labs / NYU) «Proving and Improving the Platonic Representation Hypothesis with JEPAs», подкрепленное публичными выступлениями ЛеКуна и запуском стартапа AMI Labs ($1.03B инвестиций), доказывает: стремление достичь универсального интеллекта (AGI) исключительно за счет масштабирования предсказания следующего токена — это тупиковый путь. Авторы превратили эмпирическую Гипотезу платоновского представления (Platonic Representation Hypothesis) в строгую математическую теорему и доказали, что компактная архитектура Joint-Embedding Predictive Architecture (JEPA) с «хорошими видами» выравнивает представление о реальном мире в десятки раз эффективнее гигантских LLM.
1. Кризис авторегрессионного масштабирования
Доминирующая парадигма современного ИИ строится на представлении о том, что накопление декларативных знаний из текста способно привести к созданию полноценного интеллекта. Ян ЛеКун, лауреат премии Тьюринга и один из отцов-основателей глубокого обучения, категорически отвергает этот подход, характеризуя текущий период развития Кремниевой долины как «LLM-ослепление» (LLM-pilled monoculture).
«Все в Кремниевой долине работают над одним и тем же, копают одну и ту же траншею. Они переманивают инженеров друг у друга и не могут позволить себе попробовать что-то иное, опасаясь отстать в гонке. Но идея о том, что мы получим страна-подобный интеллект в дата-центре просто за счет масштабирования языковых моделей — это абсолютное заблуждение». — Ян ЛеКун, основатель AMI Labs
Именно несогласие с монокультурой генеративных моделей побудило ЛеКуна покинуть пост главного научного сотрудника Meta и основать исследовательский институт AMI Labs (Advanced Machine Intelligence) в Париже, привлекая $1.03 млрд первоначального финансирования от Jeff Bezos, Nvidia, Samsung и Toyota.
«Расчет 4-летнего ребенка»
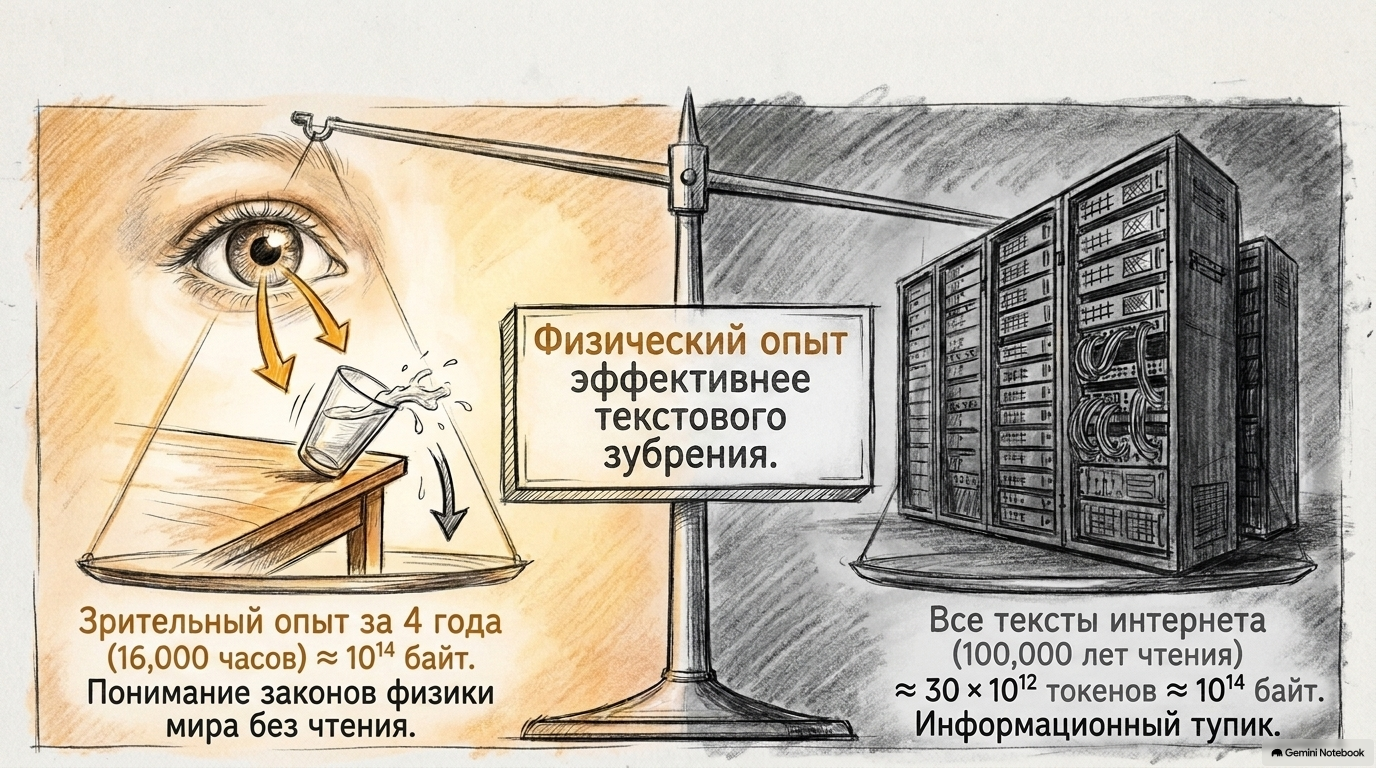
Философский и инженерный разрыв между генеративным текстом и пониманием физической реальности наглядно иллюстрируется простым информационным расчетом, предложенным ЛеКуном:
-
Масштаб обученности LLM: Современная гигантская языковая модель (например, Llama-3 или Qwen2.5) обучается на корпусе объемом от 20 до 30 триллионов токенов. При среднем кодировании 3 байта на токен это составляет около
 байт текстовых данных. Человеку потребовалось бы несколько сотен тысяч лет непрерывного чтения, чтобы освоить такой объем.
-
Масштаб восприятия ребенка: 4-летний ребенок за первые 16 000 часов бодрствования получает через зрительный нерв пропускной способностью примерно 2 МБ/с объем информации, равный те же
 байт.
Однако фундаментальная разница заключается в качестве и структуре этих данных. За 4 года ребенок полностью усваивает физическую модель мира: инвариантность объектов, законы гравитации, инерцию, хрупкость материалов и причинно-следственные связи — не прочитав ни единого слова. В то же время LLM, прочитавшая весь интернет, лишена интуитивной физики и «гибнет» при необходимости планирования в реальном времени.
|
Параметр сравнения |
Традиционные LLM (Next-Token Prediction) |
Зрительный опыт ребенка |
|
Объем данных |
|
|
|
Субстрат обучения |
Дискретные текстовые токены высокого уровня |
Непрерывный, высокоразмерный физический поток |
|
Усваиваемые знания |
Фактологические связи, лексикон, стилистика |
Физика реальности, причинность, объектная стабильность |
|
Эффективность AGI |
Ограничена «стеной данных» (Text Wall) |
Высокая: планирование в физическом пространстве |


Язык является идеальным субстратом для рассуждений в областях, где сам язык задает правила (математика, программирование, формальная логика). Однако реальный мир непрерывен, незашумлен в своей сущности и непредсказуем в мелких деталях, что делает авторегрессионный текстовый подход фундаментально ограниченным.
2. Теорема о платоновском представлени
ВНИМАНИЕ! Дальше мозговыносная математика
В 2024 году исследователи из MIT (Huh et al.) сформулировали Гипотезу платоновского представления (Platonic Representation Hypothesis, PRH). Она утверждала, что по мере роста масштаба параметров и данных нейросети разного типа и модальностей (зрение, текст, аудио) сближаются в своих внутренних векторных пространствах, сходясь к единому «платоновскому» представлению реального мира. Однако до работы Балестриеро и ЛеКуна PRH оставалась лишь эмпирическим наблюдением без теоретического доказательства и математического руководства к действию.
В отличие от генеративных моделей или автокодировщиков (MAE), которые пытаются предсказать или восстановить каждый сырой элемент входа (пиксель или слово), Joint-Embedding Predictive Architecture (JEPA) выполняет предсказание исключительно в абстрактном пространстве векторных представлений (эмбеддингов).
Архитектурно JEPA отображает входные данные x в представление  , минимизируя следующую функцию потерь:
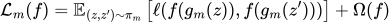
где  — инъективное отображение состояния мира z в модальность
 — функция расстояния в векторном пространстве, а
 — оператор регуляризации от коллапса (anti-collapse mechanism: SIGReg, VICReg, отбеливание второго порядка).
Теорема 1 (Platonic Representation Theorem)
Пусть  модальностей независимо наблюдают конечное множество состояний мира Z с вероятностным распределением
 через инъективные функции отображения
 . Если все модальности обучаются с помощью JEPA на одном и том же распределении позитивных пар
 (обозначающих два разных наблюдения одного состояния мира) и минимизаторы функционала потерь уникальны с точностью до ортогонального вращения, то существует единое фундаментальное представление мира
 такое, что для любой модальности m:
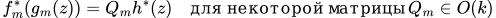
Из этого следует, что векторные пространства любых двух модальностей  и
 связаны единым ортогональным вращением
 .
Спектральная уникальность и граница расхождения
Авторы доказывают, что для JEPA с отбеливанием второго порядка 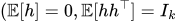 ) оптимизационное решение математически эквивалентно спектральному погружению (Laplacian Eigenmaps) графа позитивных пар:
-
Пропозиция 1 (Proposition 1): Если спектр нормированной матрицы смежности графа позитивных пар
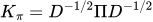 имеет спектральный разрыв (eigengap)
 , пространства решений всех модальностей уникальны с точностью до вращения.
-
Теорема 2 (Kernel Mismatch Bound): Если модальности обучаются на слегка различающихся распределениях позитивных пар
 , среднее квадратичное расхождение между их оптимально повернутыми представлениями строго ограничено сверху:
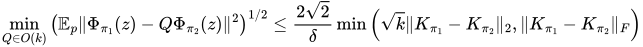
где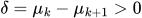 — величина спектрального разрыва.
3. «Хорошие» против «Плохих» и цена шума модальности
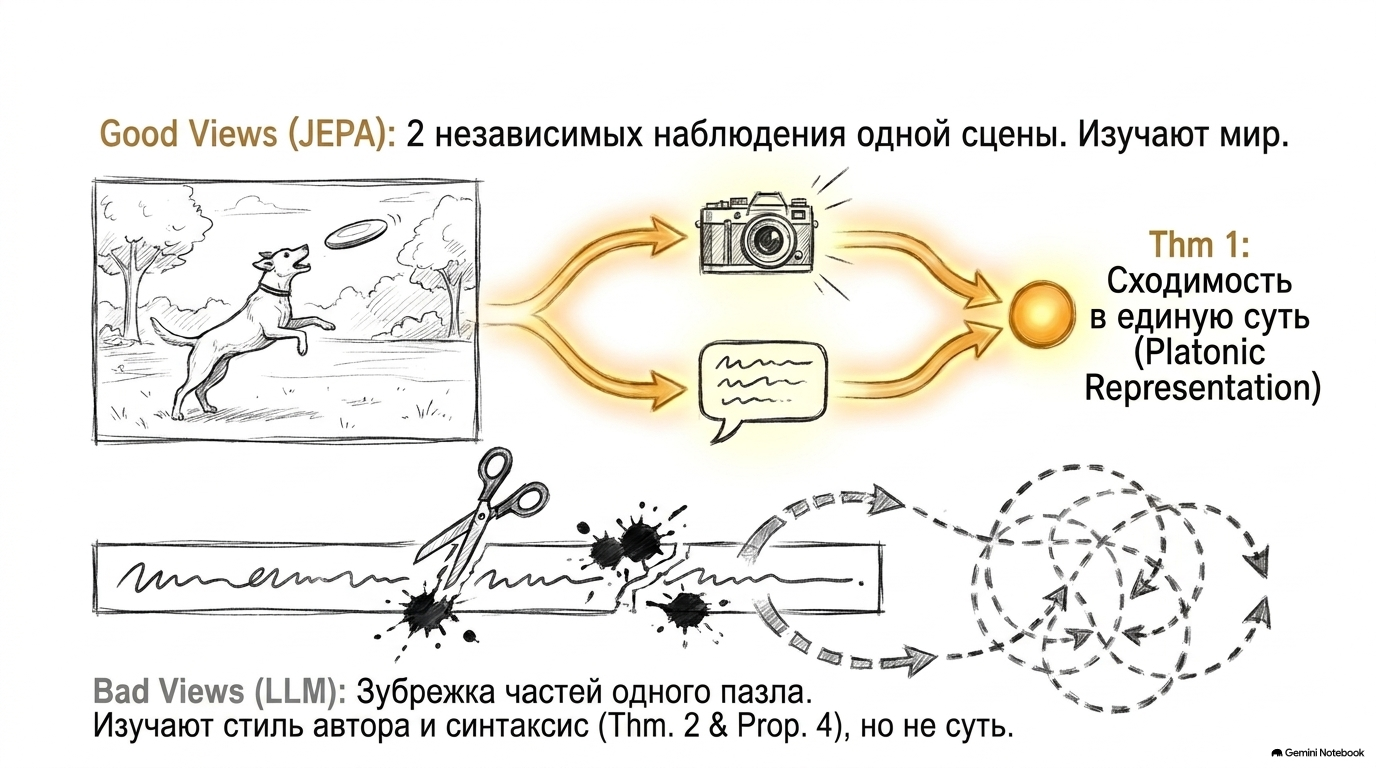
Центральным теоретическим открытием работы является точное разделение типов позитивных пар, используемых при контрастивном и векторном обучении.
🟢 Хорошие виды (Good Views)
Позитивной парой объявляются два независимых наблюдения одного и того же состояния реального мира:
-
В тексте: две разные подписи к одной фотографии («Собака бежит по пляжу»
 «Щенок играет у моря»).
-
В видео: два разных кадра из одного видеоролика.
-
В мультимодальности: фотография сцены и её текстовое описание.
Каждое наблюдение содержит специфическую «помеху» модальности  (авторский лексикон, ракурс, освещение). В хороших видах позитивные пары имеют независимые помехи
 . В результате модель вынуждена игнорировать поверхностный шум модальности и тратить векторные измерения на кодирование истинного состояния мира z.
🔴 Плохие виды (Bad Views)
Позитивной парой объявляются два искажения одного и того же наблюдения:
-
В тексте: два варианта маскирования одного предложения («Собака [MASK] по пляжу»
 «[MASK] бежит по [MASK]»).
-
В компьютерном зрении: два обрезка (crop) одного и того же снимка.
-
В авторегрессионных LLM: префикс предложения и его продолжение.
Теорема 3 (Nuisance Costs Alignment)
Авторы доказывают, что для центрированных и отбеленных кодировщиков f_1, f_2 ошибка выравнивания ограничена снизу долей энергии представления, объясняемой состоянием сцены 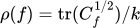 :
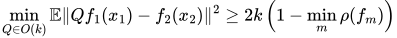
Любое измерение векторного пространства, потраченное кодировщиком на специфические помехи своей модальности (стиль автора, конкретные формулировки), безвозвратно теряется для выравнивания с другими модальностями.
[ Хорошие виды (Good Views) ]
Изображение X  ───>  Подпись A ("Собака на пляже")  ┐
               ───>  Подпись B ("Щенок у моря")    ┴──> Игнорируют шум ν, кодируют ядро мира z (ρ = 1)

[ Плохие виды (Bad Views / NTP) ]
Текст A  ───>  Маска 1 / Префикс      ┐
         ───>  Маска 2 / Продолжение  ┴──> Тратят измерения на стиль и лексикон ν (ρ < 1)
Пропозиция 4: Предсказание следующего токена — это «плоховидная» JEPA
Авторы доказывают, что целевая функция предсказания следующего токена (Next-Token Prediction, NTP) в LLM математически идентична JEPA с негауссовым термином анти-коллапса (log-partition softmax):
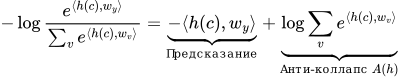
Позитивными парами в NTP являются контекст c и следующий токен y, принадлежащие одному и тому же документу. Модель неизбежно связывает представления через авторский стиль и специфический лексикон. Смысловые контексты объединяются в платоновские кластеры не по прямой конструкции видов, а лишь опосредованно — через длинные цепочки случайно совпадающих точечных продолжений, что требует гигантских объемов данных.
4. 109M модель против гигантских LLM
Теоретические выводы были подвергнуты жесткой эмпирической валидации на масштабе от 145 тысяч локальных подписей Flickr30k до 940 миллионов веб-изображений (Recap-DataComp).
Рекордная эффективность по выборке (Sample Efficiency)
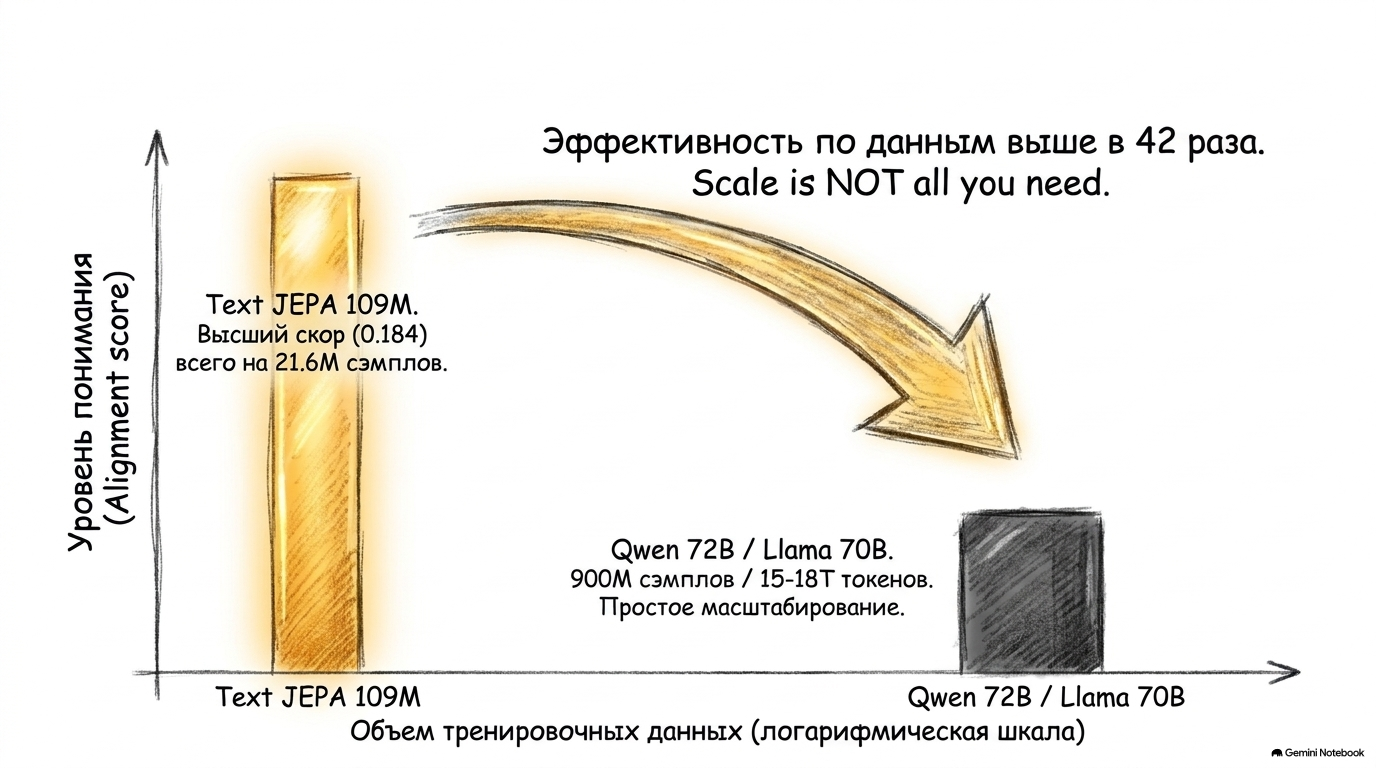
Эксперименты показали, что текстовый кодировщик Good-View Text JEPA обучается выравниванию смыслового пространства в 42 раза эффективнее по числу образцов и в 14 раз эффективнее по количеству прочитанных токенов, чем модель с предсказанием следующего токена на том же самом корпусе.
Разгром моделей масштаба 72B на бенчмарках выравнивания
Текстовый кодировщик Text JEPA архитектуры BERT-B объемом всего 109 млн параметров, обученный на текстах 940 млн веб-изображений, был протестирован на бенчмарке WIT-1024 в паре с замороженным визуальным кодировщиком DINOv2 ViT-B.
|
Текстовая модель |
Количество параметров |
Обучающие токены / Образцы |
WIT-1024 Mutual 10-NN ( |
WIT-1024 Unbiased CKA ( |
Flickr30k R@1 ( |
|
Good-View Text JEPA (BERT-B) |
109M |
116B токенов (900M образцов) |
.184 |
.507 |
.478 |
|
Qwen2.5-72B |
72,000M |
18,000B токенов |
.154 |
.418 |
— |
|
Llama-3-70B |
70,000M |
15,000B токенов |
.151 |
.380 |
— |
|
Qwen2.5-7B |
7,000M |
18,000B токенов |
.118 |
.353 |
— |
|
CLIP Text Encoder |
123M |
400M пар (Image-Text) |
.124 |
.339 |
.489 |
|
all-mpnet-base-v2 |
110M |
1B предложений (Supervised) |
.118 |
.390 |
.481 |
|
Bad-View Text JEPA (BERT-B) |
109M |
900M образцов (Masked) |
.088 |
— |
.318 |
|
Next-Token Prediction (BERT-B) |
109M |
900M образцов (Causal) |
.111 |
— |
.335 |


Компактная модель на 109M параметров, превосходящая Qwen2.5-72B и Llama-3-70B по точности выравнивания смыслового пространства, оказалась в 660 раз меньше по числу параметров и потребовала более чем в 100 раз меньше обучающего текста.
Закон масштабирования выравнивания (Scaling Law)
Авторы вывели эмпирический закон масштабирования, позволяющий предсказывать качество выравнивания R@1 на основе доли «хороших видов» q, числа просмотренных образцов M и объема уникальных изображений N:
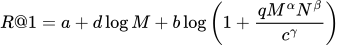
Данная формула смогла предсказать результаты 85 новых невидимых экспериментальных запусков с точностью до уровня шума между случайными инициализациями (RMSE .0093 против .0096).
Инженерные ключевые факторы
-
Обрезка/Кадрирование (Trimming): Выделение случайных непрерывных фрагментов текста (50–100% для глобальных видов, 15–50% для локальных) является главным фактором успеха. Обучение на целых предложениях снижает качество выравнивания на 25%, так как именно обрезка заставляет модель отбрасывать внешние контексты.
-
Градиентный клиппинг (Gradient Clipping): Необходим для предотвращения внезапных коллапсов обучения при использовании SIGReg-регуляризации.
5. Композиция без дообучения
Доказанная теорема о том, что пространства представлений сходятся с точностью до ортогонального вращения  , открывает возможность создавать сложные мультимодальные системы без совместного обучения нейросетей.
1. Генератор подписей к изображениям (Image Captioning) без обучения на парах
Авторы построили генератор описаний к изображениям, в котором ни одна нейросеть не обучалась на парах «изображение-текст»:
-
Текстовый декодер (Qwen2.5-1.5B) обучался исключительно на тексте восстанавливать предложения из зашумленного эмбеддинга text-JEPA.
-
Уровень шума при обучении рассчитывался аналитически исходя из косинусного расхождения:
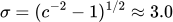 .
-
Визуальный кодировщик (DINOv2 / DINOv3) и текстовый декодер связывались единственной матрицей вращения, полученной через классическую задачу Прокруста (Orthogonal Procrustes).
На датасете COCO система достигла показателя CIDEr 0.838, превзойдя специализированные мультимодальные системы, обучавшиеся на сотнях миллионов пар.
2. Абсолютно беспарное выравнивание (Pair-Free Alignment)
Используя геометрию облаков точек и оптимальный транспорт (метод Schnaus et al.), авторы нашли матрицу вращения между кодировщиками вообще без парных данных.
Text JEPA 109M показала точность 64.4% top-5 на ImageNet-100, опередив все 21 пару моделей из работы Schnaus et al. (где максимум составлял 56%), и превзошла языковую модель Qwen3-8B на 17 процентных пунктов при идентичных условиях.
6. Будущее ИИ: Модели Мира, робототехника и границы применения
Результаты исследования Балестриеро и ЛеКуна выходят далеко за рамки сухой академической теории. Они закладывают фундамент для смены архитектурной парадигмы всей индустрии ИИ.
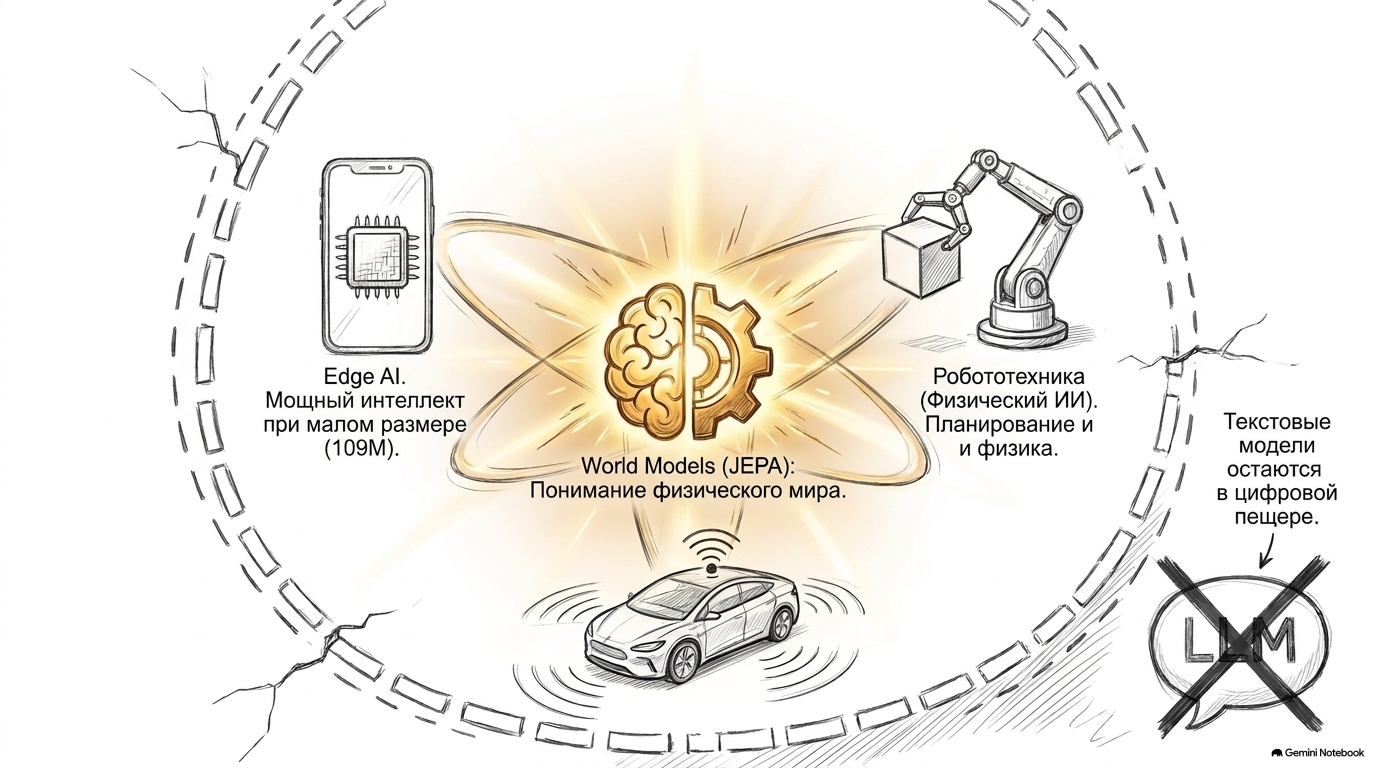
Модели Мира (World Models) vs Генеративные модели
Традиционный подход заставляет ИИ предсказывать будущие пиксели или токены со всеми мелкими деталями. ЛеКун приводит пример поворачивающейся камеры в аудитории: модель физически не может предсказать лица слушателей или точное расположение пустых стульев. Попытка заставить сеть угадывать непредсказуемый шум «убивает» обучение.
JEPA отбрасывает непредсказуемый шум на уровне кодировщика, выполняя предсказания в абстрактном пространстве состояний мира.
Влияние на робототехнику и автономные системы
-
Пример с домашней кошкой: Мозг обычной кошки содержит всего около 2.8 млрд нейронов, но она демонстрирует идеальное понимание физики, трехмерного пространства и мгновенное моторное планирование.
-
Снятие ограничения дата-центров: Поскольку Good-View JEPA требует в 42 раза меньше данных и работает на моделях размера 100M–1B параметров, высокоинтеллектуальные Модели Мира становятся применимы на локальных устройствах — в роботах-пылесосах, автономных дронах, смартфонах и AR-очках без обращения к облаку.
-
Решение проблемы «Стены данных»: Индустрия исчерпала качественный текст в интернете, однако потоковое видео и данные сенсоров поступают в объемах петабайт непрерывно. JEPA способна напрямую усваивать эти данные без текстовой разметки.
Трезвая оценка и границы применимости
Важно избежать ложных трактовок результатов исследования:
-
Модель 109M — не универсальный чат-бот: Она не умеет вести диалог, решать задачи по высшей математике или писать код лучше, чем 72B LLM. Она превзошла их строго в одной задаче — точности и структурированности внутреннего представления реального мира.
-
Происхождение «хороших видов»: В текущих экспериментах хорошие виды формировались либо из человеческих подписей (Flickr/COCO), либо с помощью синтетического переописания (LLaVA recaptions). Для создания чисто визуальных «хороших видов» в масштабах веб-видео требуется дальнейшее развитие видео-JEPA.
Заключение
Исследование Яна ЛеКуна и Рэнделла Балестриеро превратило Гипотезу платоновского представления в строгую теорему. Оно доказало, что ключом к построению единой, универсальной модели реальности является не слепое увеличение количества параметров и дата-центров, а правильная структура обучающих позитивных видов (Good Views). Переход от накопителей текста к Моделям Мира на базе JEPA обозначает начало новой эры в разработке автономного и физически обоснованного искусственного интеллекта.
Автор: catprokhorova

