


Меня зовут Максим Макаренко, я руковожу командой прикладных исследований в Sber AI Lab Сбера. Вместе с Юлией Беликовой, старшим исследователем из нашей команды, мы занимаемся новыми подходами к большим языковым моделям и ИИ-агентам: от памяти и рассуждений до надёжности, контроля и обнаружения ошибок.
Одно из направлений нашей работы — разработка методов обнаружения и контроля ошибок в сложных ИИ-системах. По мере того как LLM переходят от обычных чат-ботов к RAG, памяти, инструментам и мультиагентным системам, меняется и сама задача проверки: уже недостаточно посмотреть только на финальный ответ, нужно понимать, где именно в цепочке рассуждений и действий могла возникнуть ошибка.
В этой статье мы расскажем о двух наших работах — SIRIN и AutoJudge — и покажем, как задача обнаружения галлюцинаций постепенно превращается в более общую задачу контроля сложных ИИ-систем.
1. Проблема галлюцинаций: почему она никуда не исчезла
Большие языковые модели уже давно вышли за пределы обычного чат-бота. Сегодня они отвечают по корпоративным документам, работают в RAG-системах, вызывают инструменты, используют долговременную память и становятся частью агентных систем. Казалось бы, чем больше у модели внешних данных и инструментов, тем меньше места остаётся для галлюцинаций. Но на практике проблема никуда не исчезает: LLM по-прежнему может уверенно сгенерировать утверждение, которого в доступных ей данных нет. Для чат-бота это может быть выдуманный факт или ссылка. В RAG-системе ситуация интереснее: ответ звучит убедительно и даже опирается на найденные документы, но часть утверждений из них не следует. Такой случай обычно называют контекстной галлюцинацией.
Контекст: «В исследовании участвовали 120 человек».
Ответ модели: «В исследовании участвовали 120 человек, поровну разделённых на контрольную и экспериментальную группы».
На первый взгляд, ответ выглядит вполне правдоподобно. Число участников действительно есть в контексте, а вот разбиение поровну модель добавила сама. Здесь и возникает важное различие: нас интересует не только фактическая правильность ответа «вообще», но и то, подтверждается ли он данными, которые реально были доступны системе. Автоматическую проверку ответов модели на подобные ошибки называют детекцией галлюцинаций.
Пока ответ просто показывается пользователю, ошибку ещё можно заметить и исправить. Но всё становится неприятнее, когда результат LLM автоматически идёт дальше: записывается в память, становится входом для следующего шага или влияет на действие системы. Поэтому детекция галлюцинаций постепенно превращается из исследовательской задачи в часть рабочего контура контроля.
контекст → LLM → ответ → детектор → принять, повторить или проверить
Детектор может проверять ответ целиком или локализовать конкретный неподтверждённый фрагмент. Второй вариант полезен для выборочной перегенерации и диагностики.
2. Как обнаруживать галлюцинации?
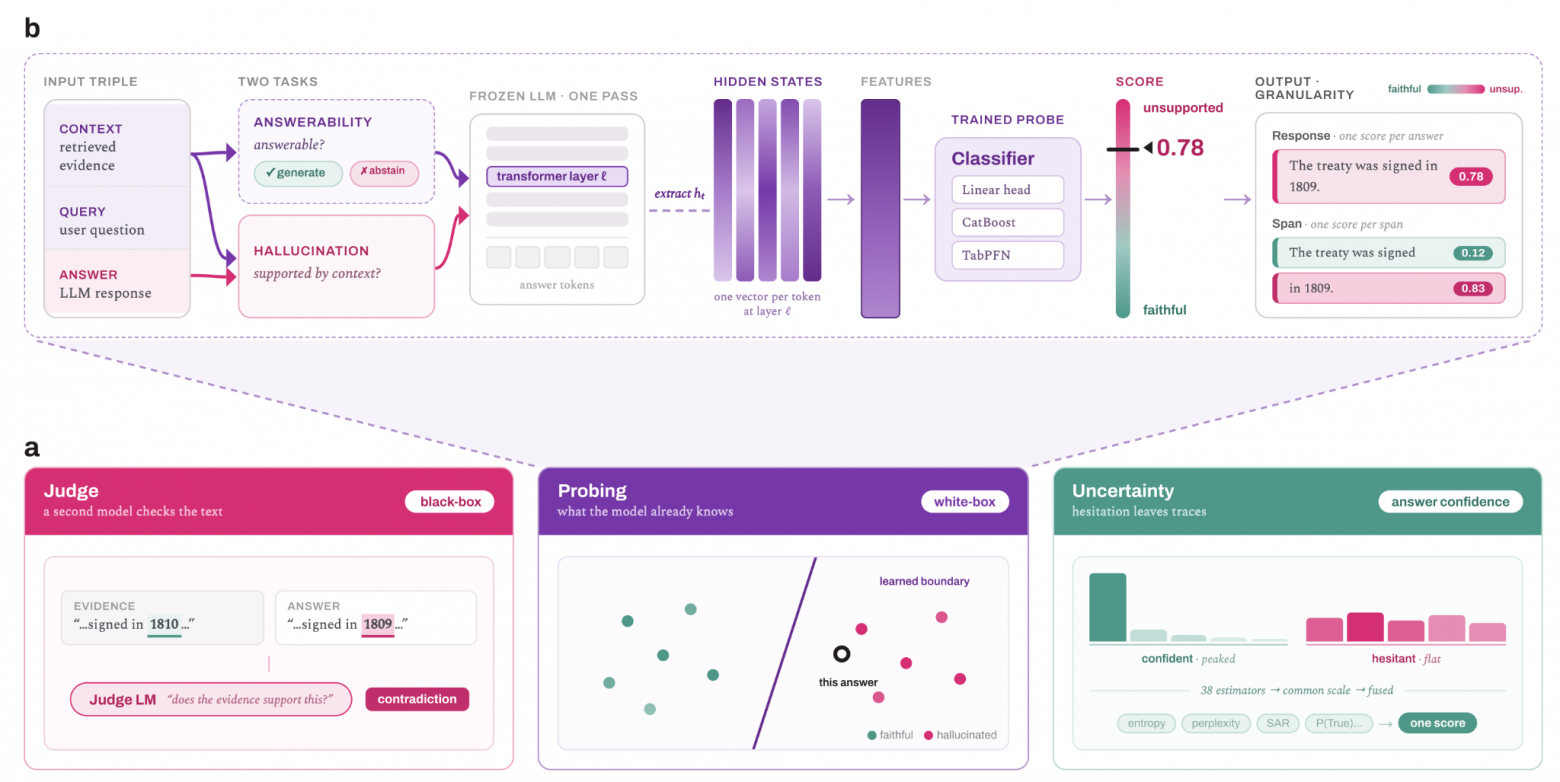
Как понять, что модель ошиблась? Универсального признака здесь нет. Поэтому методы детекции галлюцинаций подходят к проблеме с разных сторон: одни оценивают неопределённость предсказаний, другие напрямую ищут признаки галлюцинаций во внутренних представлениях моделей, третьи поручают проверку отдельной модели-судье. Разберём эти подходы.
2.1. Методы на основе оценки неопределённости
Одна из естественных идей — оценить, насколько модель уверена в своём ответе, то есть измерить её неопределённость (англ. uncertainty estimation). Это широкое семейство методов, использующих разные источники информации: вероятности токенов, энтропию предсказаний, согласованность нескольких генераций и даже скрытые состояния модели. Например, если при повторных запусках ответы заметно расходятся по смыслу, то это может сигнализировать об ошибке.
Подход привлекателен тем, что иногда позволяет обойтись без отдельной модели-проверяющего. Но есть важная оговорка: уверенность не равна корректности. LLM умеет очень уверенно ошибаться, а высокая неопределённость иногда означает лишь то, что правильный ответ можно сформулировать несколькими способами.
2.2. Методы на основе зондирования внутренних представлений
Другой подход — использовать внутренние представления нейросети: скрытые состояния, активации отдельных слоёв, логиты и другие признаки. Поверх них обучается небольшой классификатор — зонд (англ. probe), который пытается отличить поддержанные контекстом фрагменты от галлюцинаций, не изменяя веса исходной модели.
При этом зондирование не обязательно требует доступа к внутренним состояниям самой модели-генератора. Если она доступна только через API, то можно использовать другую, открытую модель — proxy-LLM. Ей передают исходный контекст и полученный ответ, предлагая воспроизвести его, а затем используют её скрытые состояния для обучения и работы детектора. Основные ограничения здесь связаны с необходимостью обучающих данных и зависимостью качества детектора от выбранной модели и домена.
2.3. Модели-судьи: от encoder-классификаторов до LLM-as-a-Judge
Ещё один подход — поручить проверку отдельной модели, которая получает исходный контекст, вопрос и ответ генератора и оценивает, насколько ответ подтверждается доступными данными. При этом судья не обязательно должен быть генеративной LLM. Например, можно обучить encoder-классификатор на основе BERT-подобной модели, который анализирует входные данные целиком и возвращает класс или оценку согласованности. Похожий сценарий негeнеративной оценки реализует Jev от TypeSafe AI: модель возвращает вероятности для заданных вариантов решения вместо генерации текста.
контекст + вопрос + ответ → модель-судья → подтверждено или не подтверждено
Другой вариант — LLM-as-a-Judge: передать те же данные генеративной модели и попросить её проверить утверждения, локализовать проблемный фрагмент или дать объяснение. Такой подход гибче и удобен, когда заранее размеченных данных мало, но он зависит от инструкции и контекста, может ошибаться и обычно дороже. Encoder-классификаторы, напротив, часто компактнее и дешевле, но требуют обучающих данных и сильнее привязаны к конкретной задаче.
|
Подход |
Доступ к модели |
Основное ограничение |
|
Оценка неопределённости |
Частичный доступ ко внутренним состояниям LLM или дополнительные вызовы LLM. |
Уверенность ≠ корректность. |
|
Пробинг внутренних представлений |
Доступ ко внутренним состояниям LLM или proxy-LLM. |
Минимум 300-500 обучающих примеров. |
|
Модели-судьи |
Не нужен. |
Дополнительная языковая модель и минимум 1000 обучающих примеров (в случае дообучения судьи). |
3. SIRIN: как собрать разные методы в одном месте
На практике методы детекции галлюцинаций предъявляют разные требования к инфраструктуре. Одним нужны внутренние состояния модели, другим — несколько генераций, третьим — отдельная модель-судья. Из-за этого их сложно интегрировать в одну систему, сравнивать между собой, комбинировать и разрабатывать новые методы.
Чтобы решить эту проблему, мы разработали SIRIN — Semantic Inconsistency Recognition and Inspection Nexus [1]. Библиотека предоставляет единый интерфейс для методов оценки неопределённости, зондирования и моделей-судей, включая encoder-классификаторы и генеративные LLM-судьи. Она позволяет работать как с открытыми, так и с закрытыми моделями-генераторами, а также обнаруживать галлюцинации на уровне всего ответа или отдельных его фрагментов.
Помимо проверки готовых ответов, SIRIN позволяет оценивать достаточность контекста ещё до генерации. Например, в RAG-системе можно сначала проверить, хватает ли найденных документов для ответа, и при необходимости повторить поиск или отказаться от генерирования, а после получения ответа — проверить, насколько его утверждения подтверждаются источниками.
запрос → поиск → проверка достаточности → генерация → проверка галлюцинаций → пользователь
4. Что меняется в мультиагентных системах?
С одной LLM всё относительно понятно: есть контекст, есть ответ, между ними можно искать несоответствия. Но стоит добавить несколько агентов и инструменты — и объект проверки меняется. Теперь нужно учитывать всю историю работы системы: сообщения агентов, вызовы инструментов, результаты этих вызовов и промежуточные решения.
Представим простой сценарий: исследователь неверно извлёк число из документа, аналитик корректно посчитал результат уже с этим числом, а координатор аккуратно собрал финальный ответ. Последние шаги сами по себе выглядят разумно, но вся цепочка построена на ошибочной предпосылке.
пользователь → планировщик → исследователь → инструмент → аналитик → координатор → ответ
К галлюцинациям добавляются ошибки планирования, использования инструментов, коммуникации и агрегирования. Причём ранняя ошибка может пройти через несколько агентов и к финалу выглядеть как согласованное решение всей системы.
Отсюда следующий шаг: проверять нужно уже не только финальный ответ, но и то, как система к нему пришла. Специализированные методы оценки истории выполнения уже решают отдельные части этой задачи. Но часто они привязаны к конкретной таксономии ошибок и заранее спроектированному конвейеру проверки. Если меняется система или набор критериев, то приходится заново проектировать и саму оценку.
5. AutoJudge: как проверять историю работы системы
Здесь мы приходим к нашей следующей работе AutoJudge [2]. Если SIRIN помогает выбирать и применять детекторы для отдельного ответа, то в AutoJudge объектом оценки становится история работы агентной системы. Основной вопрос уже другой: «Можно ли автоматически построить подходящую процедуру проверки под конкретный запуск агентской системы?»
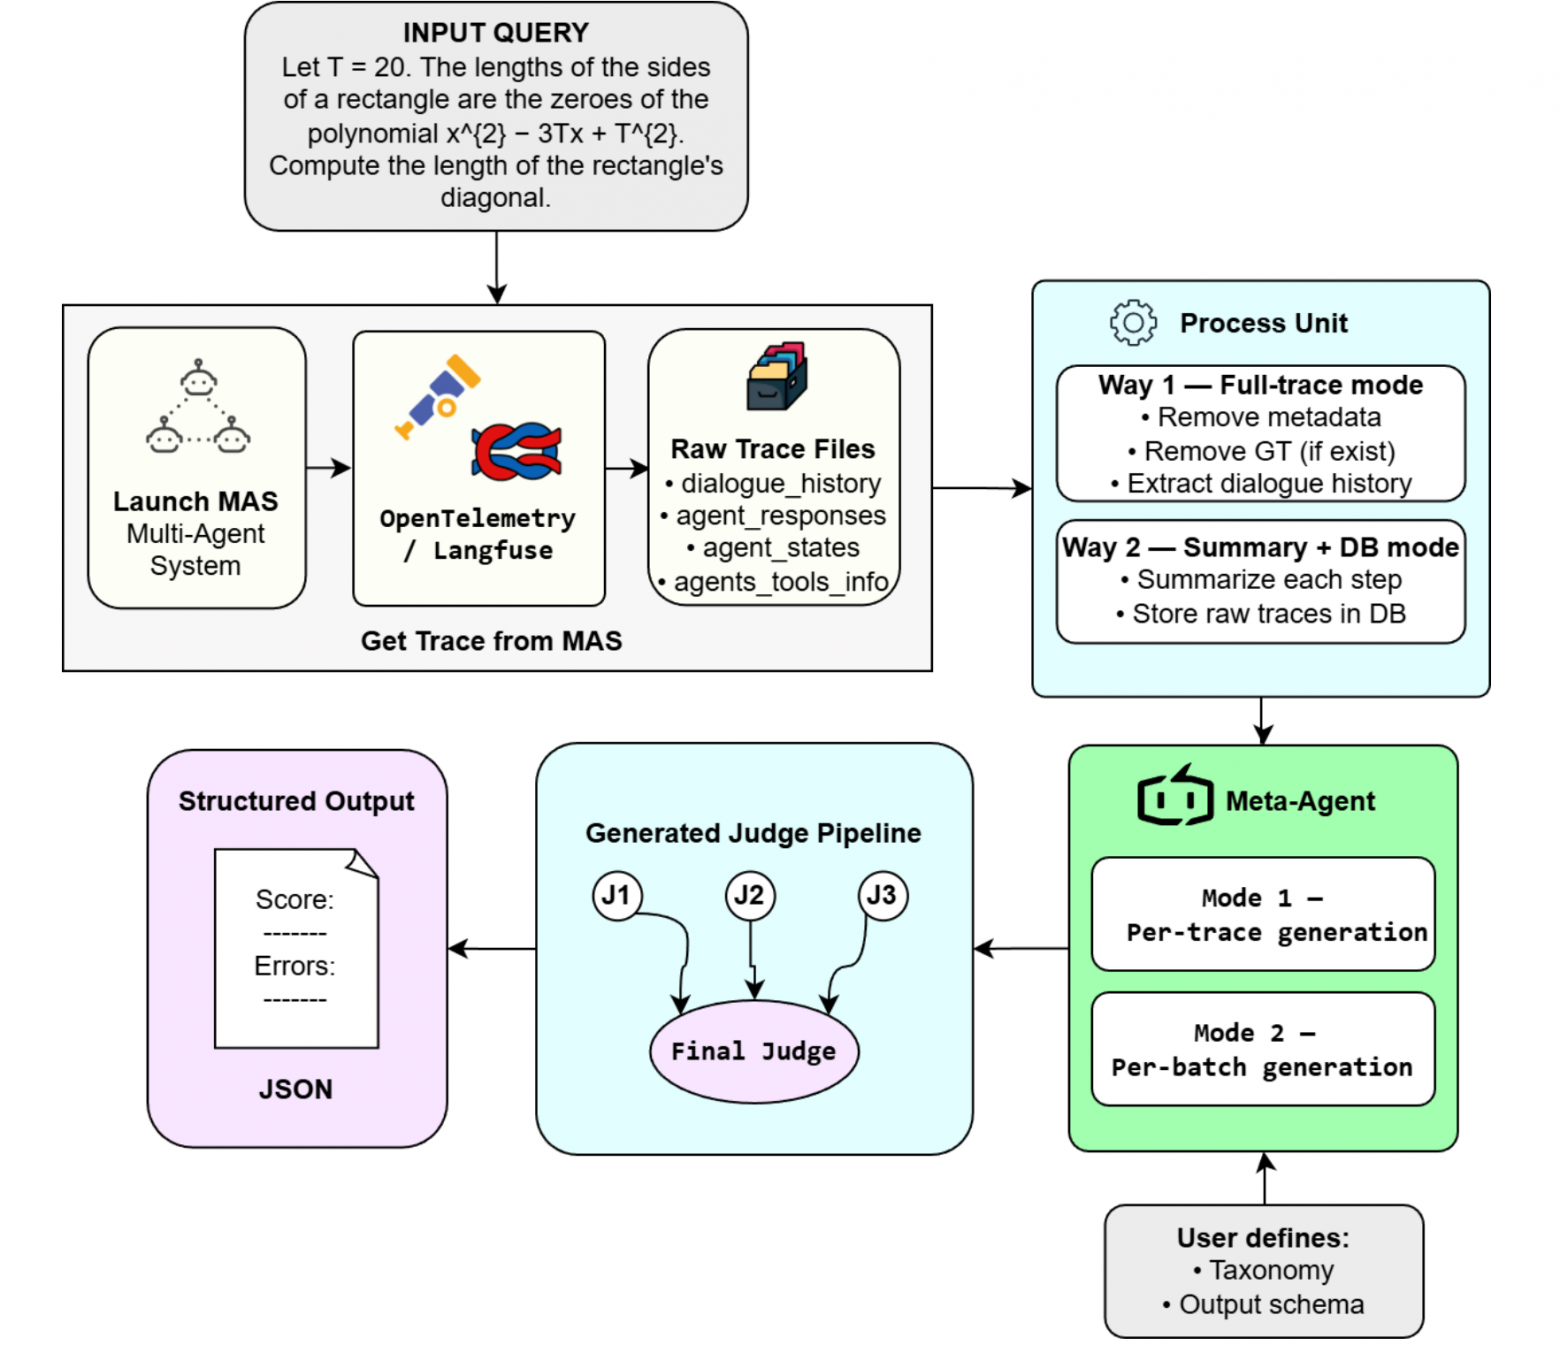
На вход AutoJudge получает историю выполнения, таксономию оценки и схему требуемого результата. Дальше мета-агент анализирует задачу и сам формирует набор специализированных промежуточных судей и итогового агрегатора. То есть автоматизируется не только проверка, но и проектирование её конвейера.
Промежуточные судьи смотрят на разные этапы работы системы, а итоговый агрегатор сопоставляет их выводы с исходными данными и формирует структурированный результат. Важный момент: это не простое голосование. Если оценки расходятся, то агрегатор может обратиться к исходной истории выполнения и разрешить противоречие.
5.1. Адаптивная проверка
Здесь есть два режима. В основном варианте отдельный конвейер создают для каждого запуска системы — получается дороже, зато оценка лучше адаптируется к конкретному поведению агентов. Более экономный вариант: создать один конвейер и переиспользовать его для всего набора данных. В экспериментах адаптация к отдельному запуску обычно оказывается полезнее, особенно когда поведение агентов сильно различается.
Отдельная практическая проблема — объём истории исполнения. Сообщения агентов вместе с результатами инструментов могут быть слишком большими, чтобы каждый раз целиком отправлять их каждому судье. Поэтому AutoJudge умеет работать как с полной историей, так и с кратким представлением: судьи видят сжатые шаги, а при необходимости точечно запрашивают оригинал нужного шага из внешнего хранилища.
5.2. Что получилось в экспериментах?
Чтобы проверить, работает ли такая схема за пределами одного сценария, мы протестировали AutoJudge на нескольких наборах данных с разными историями работы агентных систем и критериями оценки. Для нас здесь важен не отдельный сценарий, а способность одной схемы генерирования судей подстраиваться под разные таксономии ошибок и агентские системы без отдельного обучения под каждый набор.
Результат получился ожидаемо не абсолютным: AutoJudge не становится универсальным эталоном, а на отдельных узкоспециализированных метриках вручную настроенные судьи всё ещё могут быть сильнее. При этом динамически построенные конвейеры остаются конкурентоспособными в разных задачах и часто превосходят фиксированные варианты.
Самый показательный для нас контрольный эксперимент — Who&When с одной и той же моделью GPT-4o. AutoJudge повышает точность определения ошибочного агента с 55,17% до 67,24%. Здесь важно именно одинаковое основание сравнения: прирост нельзя списать просто на более сильную модель-судью.
Конечно, цена за гибкость остаётся. Полную историю выполнения дорого проверять, сжатие может потерять важную деталь, а для очень узких критериев ручная настройка иногда оправдана.
Заключение
В итоге SIRIN и AutoJudge можно рассматривать как два уровня решения одной задачи. Сначала мы хотим понять, поддерживается ли конкретный ответ исходными данными, а затем, когда LLM становится частью агентной системы, приходится разбирать уже весь путь до этого ответа. Именно здесь привычный вопрос о галлюцинации перестаёт быть только вопросом к тексту. Ошибка может появиться при планировании, вызове инструмента или передаче информации между агентами — и проявиться лишь через несколько шагов. AutoJudge продолжает эту линию на уровне истории выполнения: вместо одного заранее заданного судьи создают конвейер оценки под конкретный запуск системы, таксономию и требуемый формат результата. Получается естественная эволюция задачи: от «подтверждается ли этот ответ?» к «где именно ошиблась система и какой способ проверки нужен, чтобы это увидеть?»
Материалы
1. SIRIN — Semantic Inconsistency Recognition and Inspection Nexus: статья arxiv.org/abs/2608.00033; код github.com/sb-ai-lab/SIRIN
2. AutoJudge — Automatic Generation of LLM-Based Judges from Execution Traces: статья https://icml.cc/virtual/2026/77847; код github.com/sb-ai-lab/MASeval
Автор: Sber

