


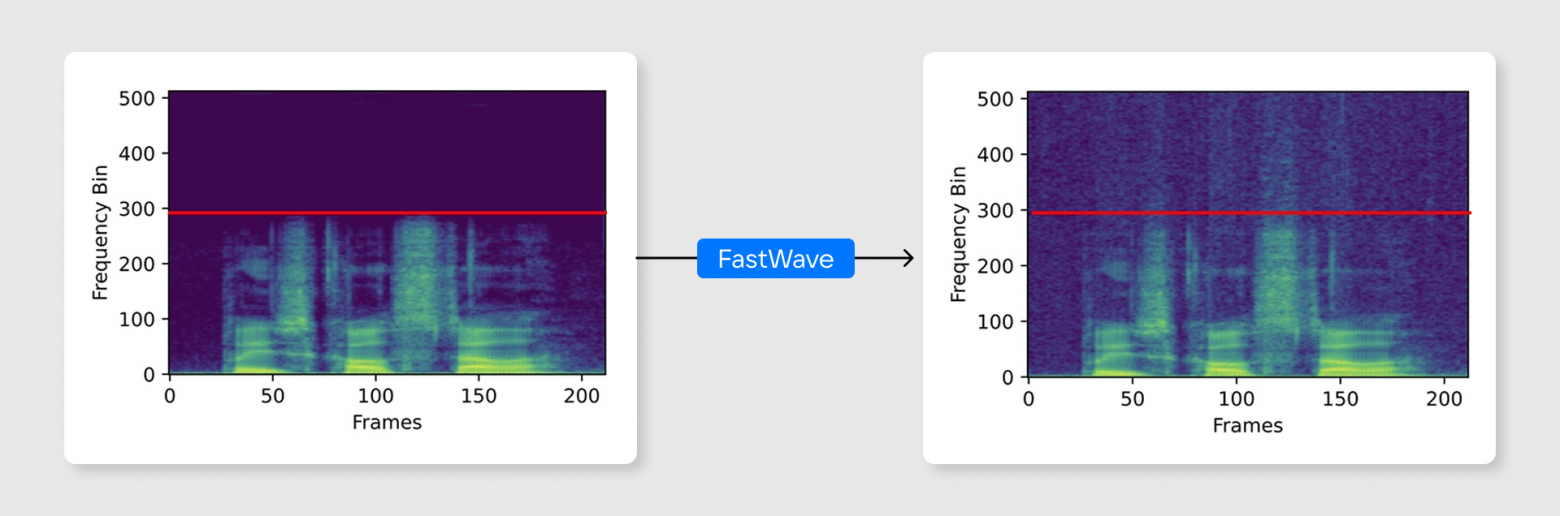
Меня зовут Никита Кузнецов, я студент мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK. Хочу поделиться историей и техническими подробностями нашего проекта FastWave, который был реализован под руководством Максима Каледина, доцента ФКН НИУ ВШЭ, и Александра Тараканова, исследователя AI VK и доцента ФКН НИУ ВШЭ. Мы разработали лёгкую диффузионную модель для восстановления высокочастотных деталей звука (BWE, Bandwidth Extension). Она повышает частоту дискретизации любого аудио до студийных 48 кГц, весит всего 1,3M параметров и быстро работает.
Постановка задачи
General Audio Super-Resolution (ASR), или Bandwidth Extension (BWE) — это набор методов, направленных на высококачественную оценку заданного сигнала, как если бы он был дискретизирован с более высокой частотой. Среди BWE-методов есть модели диффузии и потока (считаются более медленными) и генеративно-состязательные сети (считаются более быстрыми). Оба метода представлены высокопараметрическими сетями, требующими высоких вычислительных затрат как на обучение, так и на вывод.
Для решения этих проблем мы переосмыслили последние достижения в обучении моделей диффузии и применили их к сверхразрешению с любой частотой дискретизации до 48 кГц. Наш подход показывает результаты лучше, чем у NU-Wave 2, и сопоставим с моделями SOTA.
Мы назвали нашу модель FastWave. Её вычислительная сложность — около 50 GFLOPS и 1,3 млн параметров. Обучается она меньшими ресурсами и значительно быстрее, чем большинство недавно предложенных решений, основанных на диффузии и потоке. Наш код мы выложили здесь.
Текущее состояние области
Сейчас в BWE есть 2 основных подхода:
Диффузионные модели (NU-Wave, NU-Wave 2, AudioSR). Дают высокое качество, но страдают от двух проблем: много параметров и медленный инференс, поскольку требуют итеративного денойзинга — множества последовательных вызовов модели.
Flow-based модели (FlowHigh). Хороший компромисс — один шаг инференса, качество, близкое к SOTA. Но модели всё ещё крупные: у FlowHigh, например, 49M параметров.
Почти все решения сфокусированы на качестве звука, а вопрос вычислительной сложности в их разработке отошёл на второй план.
Что в основе
Мы выбрали NU-Wave 2 как отправную точку по двум причинам:
-
Это самая компактная диффузионная модель для BWE — всего 1,8 млн параметров.
-
Поддерживает режим any-to-48 kHz — работает с любой входной частотой.
Проблема: даже эта компактная модель обучается около двух недель на GPU 2 × A100 с большим батчем. У нас в наличии были только V100, поэтому для дальнейших экспериментов мы выбрали 1 × V100.
Три направления оптимизации
1. Методология EDM
EDM (Elucidating the Design Space of Diffusion Models) — работа исследователей из NVIDIA (Karras et al., NeurIPS 2022), которая системно переосмысливает пайплайн обучения диффузионных моделей. Изначально EDM создавался для изображений, и мы адаптировали его к задаче Audio Super-Resolution.
Что именно мы перенесли:
-
σ-параметризация. Вместо предсказания шума модель учится предсказывать сам чистый сигнал. Это более стабильная постановка, которая упрощает оптимизацию.
-
Предобуславливание входов и выходов. Входные данные и выход модели масштабируются в зависимости от текущего уровня шума.
-
Log-нормальное распределение уровней шума при обучении. Вместо равномерного семплирования мы концентрируем обучение на информативных уровнях шума, где градиенты наиболее полезны. Параметры распределения (среднее Pmean и дисперсия логарифма σ) вычислены непосредственно из обучающего датасета.
-
Непрерывное шумовое расписание при инференсе. Вместо фиксированного log-SNR расписания из NU-Wave 2 мы используем гибкое расписание из EDM, где шаги концентрируются в области низких шумов — там, где точность восстановления критична.
-
Взвешенная L2-функция потерь. Лосс в EDM взвешивается в зависимости от уровня шума, что стабилизирует обучение и ускоряет сходимость.
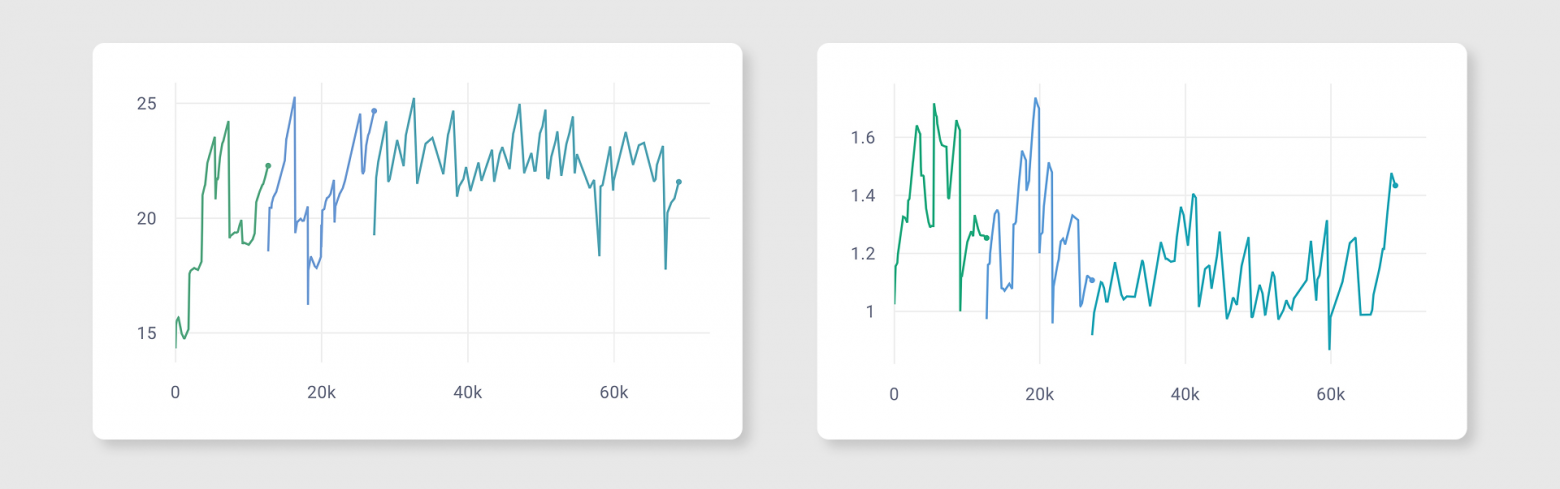
После внедрения мы достигли пиковых показателей метрик (представленных в таблице с финальным сравнением), затратив втрое меньше итераций по сравнению с NU-Wave.
2. Архитектурные изменения из ConvNeXt V2
Улучшив методологию обучения, мы занялись самой моделью. Цель — уменьшить число параметров и вычислительную сложность без потери качества.
Depthwise separable convolutions. В исходной архитектуре NU-Wave 2 используются обычные свёртки, число параметров которых растёт квадратично с числом каналов. Мы заменили их на разделяемые: сначала обрабатываем каждый канал независимо (depthwise), затем смешиваем каналы через точечную свёртку 1 × 1 (pointwise). Это классический приём, позволяющий снизить параметрическую сложность при сохранении рецептивного поля.
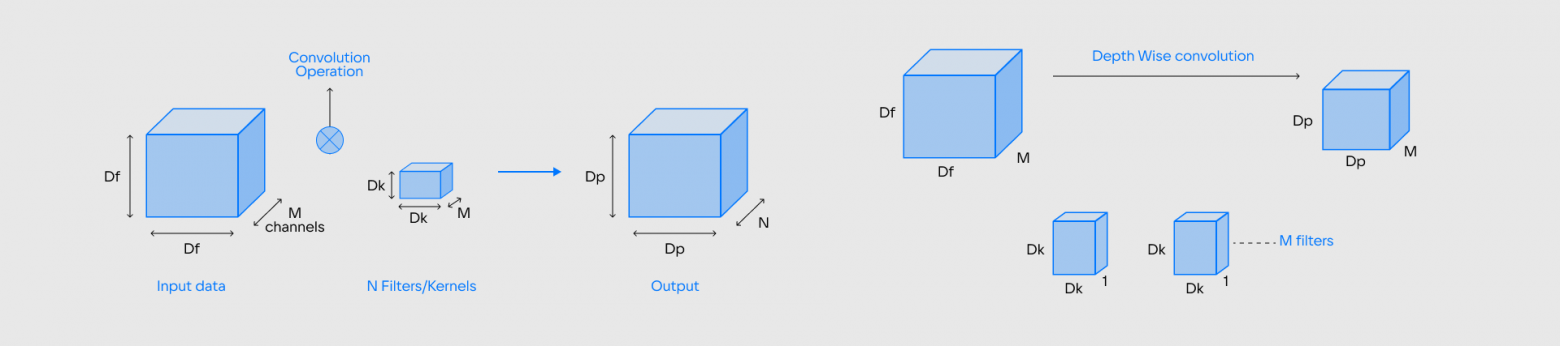
Global Response Normalization (GRN). При замене обычной свертки на depthwise+pointwise каналы плохо смешиваются друг с другом. У depthwise-свёрток есть недостаток — каналы перестают взаимодействовать друг с другом. GRN решает эту проблему: она нормализует отклики каналов относительно друг друга, явно усиливая кросс-канальное взаимодействие. Мы вставили GRN-слои после ключевых трансформаций в блоках модели.
Итог: модель уменьшилась с 1,8M до 1,3M параметров (−30%) и с 19,0 до 12,9 GFLOPs за один вызов, при этом качество реконструкции сохранилось.
3. Сокращение числа шагов инференса
Оригинальный NU-Wave 2 требует 8 вызовов модели (NFE) для генерации одного аудиофрагмента. Благодаря улучшенному обучению и непрерывному шумовому расписанию из EDM, наша модель стабильно выдаёт хорошие результаты уже за 4 шага. Это напрямую удваивает скорость инференса.
Эксперименты
Датасет: VCTK — 110 спикеров, ~44 часа аудио, 48 кГц. Стандартный сплит: 100 спикеров на обучение, 8 на тест.
Бенчмарк: апсемплинг из 8, 12, 16 и 24 кГц в 48 кГц.
Условия обучения: одна GPU V100, до 30 часов. Для сравнения: оригинальный NU-Wave 2 обучался ~649 эпох на двух A100 — это порядка двух недель.
Метрики:
-
SNR (Signal-to-Noise Ratio) — отношение сигнала к шуму, выше = лучше;
-
LSD (Log-Spectral Distance) — расстояние между спектрами, ниже = лучше;
-
LSD-LF и LSD-HF — то же, но отдельно для низких и высоких частот;
-
RTF (Real-Time Factor) — отношение времени обработки к длительности аудио, ниже = быстрее.
Промежуточные результаты (ограниченный режим)
Все модели обучались одинаковое время на одинаковом железе:
|
Модель |
NFE |
SNR↑ (8→48) |
LSD↓ (8→48) |
Параметры |
GFLOPs |
|
NU-Wave 2 (baseline) |
8 |
17,47 |
1,31 |
1,8M |
19,0 |
|
NU-Wave 2 + EDM |
4 |
16,72 |
1,25 |
1,8M |
19,0 |
|
NU-Wave 2 + EDM |
8 |
16,02 |
1,21 |
1,8M |
19,0 |
|
FastWave |
4 |
18,49 |
1,22 |
1,3M |
12,9 |
|
FastWave |
8 |
18,10 |
1,26 |
1,3M |
12,9 |
Важно: EDM-методология уже на 30-й эпохе обгоняет baseline по LSD. FastWave с 4 шагами обгоняет baseline с 8 шагами по SNR — при меньшей модели и меньшем числе вызовов.
Финальное сравнение
Здесь мы сравниваем нашу модель, обученную в ограниченных условиях, с полностью обученными моделями из литературы:
|
Модель |
NFE |
SNR↑ (24→48) |
LSD↓ (24→48) |
Параметры |
GFLOPs |
RTF |
|
AudioSR |
1 |
23,03 |
1,27 |
1285M |
2536 |
4,99 |
|
FlowHigh |
1 |
27,80 |
0,74 |
49,4M |
30,4 |
0,06 |
|
NU-Wave 2 |
8 |
27,68 |
0,78 |
1.8M |
19,0 |
0,26 |
|
FastWave |
4 |
27,09 |
0,93 |
1,3M |
12,9 |
0,16 |
|
FastWave |
8 |
27,22 |
0,83 |
1,3M |
12,9 |
0,30 |
Примечания:
-
AudioSR — огромная модель (1,28B параметров), изначально заточена под аудио вообще, а не только речь. На речевом бенчмарке она проигрывает всем без тонкой настройки.
-
FlowHigh — лучшее качество по LSD, но 49M параметров — это в 38 раз больше, чем у FastWave.
-
NU-Wave 2 — ближайший baseline. FastWave при 8 NFE показывает LSD 0,83 против 0,78 — разница минимальна, при этом модель меньше на 30% и обучалась в более скромных условиях.
-
FastWave при 4 NFE — SNR 27,09, что лишь немного уступает NU-Wave 2 (27,68) и FlowHigh (27,80). По SNR все три модели (FlowHigh, NU-Wave 2 и FastWave) находятся в одном классе качества.
По RTF: FastWave с 4 шагами обрабатывает звук в ~6 раз быстрее реального времени. Этого уже достаточно для потоковых приложений на устройствах с GPU.
Итог
FastWave — компактная диффузионная модель для суперразрешения аудио, которая обучается быстрее NU-Wave 2 при качестве восстановления звука, близком к базовой модели. За счёт сокращённого числа шагов и невысоких вычислительных затрат модель подходит для потоковой обработки аудио на устройствах с GPU.
Мы оформили результаты проекта в научную статью, можно почитать здесь. Код и предобученный чекпойнт выложены на GitHub, а статья принята на конференцию Interspeech 2026.
Автор: NIKAIT

