


Всем привет!
Не давно сделал свою Gated RNN, то есть с другой математикой, ни как у LSTM, GRU и подобного.
Я хочу (для вас) разобрать её теоретически, практически, замерить (я не умею замерять так что буду замерять как могу), ну и конечно же расскажу плюсы и минусы.
То, что будет в статье.
Э-э-э, плохое название для заголовка, но вот те заголовки которые вы сейчас будете встречать (в правильном порядке):
-
Теория.
-
Практика (без замеров).
-
Бенчмаркинг.
-
Плюсы и минусы моей сети.
-
Вывод.
Это моя первая статья похожая на реально научную, так что могут быть недочёты.
Теория.
Начнём с теории и формул.
Я сделал несколько нестандартных решений:
-
 и его моя версия за место
 и
 .
-
 +
 за место конкатенирования.
На самом деле их много чем два, но перейдем к теории.
И так, для справки напишу формулу  :
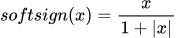
Всё просто:  делим на его модуль + 1.
Теперь я хочу показать мою формулу  :
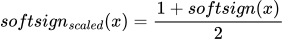
Эта формула мне нужна для замены  (сигмоида выдает диапазон от 0 до 1, а обычный софтсайн – от -1 до 1, а мне нужно было от 0 до 1).
Показываю первую формулу для своеобразного “насыщения” (нужно для более лучшего обобщения)  :
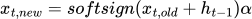
То есть,  теперь это
 , если что. Работает просто –
 (старый) суммируем с
 и сумму пропускаем через
 умножаем на обучаемый параметр
 (я его на 2 с начало ставлю, вроде так лучше по качеству и обобщению).
И так, показываю формулу для гейта forget ( ):
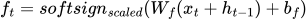
В общем, это как из обычного LSTM, но без конкатенирование (заменил на +) и с моим 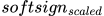 .
Теперь нам нужен гейт input ( ):
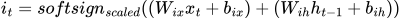
Работает так:
Прогоняем  и
 через два разных линейных слоёв со смещением, суммируем оба результата и прогоняем сумму через
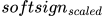 .
Сейчас я запишу вычисление кандидата:
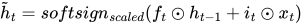
То есть, просто суммирование поэлементного  на
 и
 на
 , а потом прогоняем через scaled softsign.
Я сам сомневаюсь в таком вычисление, но пока что это самый рабочий вариант (для моих задач).
Потом вычисляем output gate:
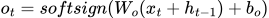
У вас наверняка вопроса:
Почему тут не
?
Ну, я уже пробовал сделать наоборот – в вычислении кандидата обычный софтсайн, а в вычисление output гейта – скейлед софтсайн, но качество проседало аж до 23%.
Новый  вычисляем просто:

Скорее всего ещё один вопрос у читателей – где  , где CEC?
Ответ прост – я решил убрать эту всю мишуру (ладно, это не мишура) ещё на старте, и оно заработало, я подумал – “ну ладно, если работает – в принципе, пока не надо” и так и осталось по сей день (уже нет).
Это первый этап вычисления в моей Gated RNN.
Возможно вы спросите – а где же долгосрочная (Long-Term) память?
Ну, вот щас покажу.
На выходе первого этапа идет:
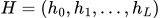
L тут это длина всей последовательности X.
Потом идет второй этап (одна формула, да):
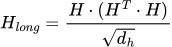
 – это размерность скрытого состояния.
Работает так:
Умножаем  на
 – получаем что-то вроде “матрицы внимания” (термин не к месту наверно, да?).
Умножаем  на эту самую “матрицу внимания” чтобы сделать размерность правильной и делим на
 чтобы не взорвать градиенты.
Всё, это вся долгосрочная память.
Если моя Gated RNN – это последний слой всей сети (ну или там дальше идет LayerNorm или классификатор) – то мы выдаём такой output:
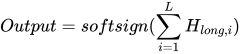
Если что,  тут считает сумму каждой строки матрицы H_long и все результаты в один список. То есть возьмём пример: [[1, 2], [2, 3]].
 тут посчитает и выдаст такой результат: [3, 5]. То есть, 1 + 2 = 3, 2 + 3 = 5, собираем в список – готово.
Если же дальше идёт какой то слой – просто передаем  как есть, хотя можно и прогнать через
 если надо.
Дальше в моей Gated RNN после этих двух этапов идёт LayerNorm.
Почему не RMSNorm и не BatchNorm?
С ними у меня качество не поднималось никуда, а даже опускалось (да!). А дальше может идти классификатор, но я решил не ставить потому что и так все работало я боялся переобучения или что-то вроде того.
Это кажется, вся структура моей сети.
Если что – первый этап назвал SWM – Short Working Memory, а второй – LWM – Long Working Memory (я так назвал потому что не мог другое придумать на самом деле), в общем эта махина называется LSWM – Long-Short Working Memory.
Теперь общая цепочка которую я написал у себя в коде:
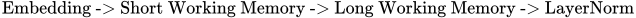
Конец теории! Время практики…
Практика (Без замеров).
Перейдем к практике!
Я решил сразу сделать достаточно сложную задачу – называют её “Multi-hop branching”.
Обычный multi-hop – это “a = b = c, что такое a?” и модель в теории должна выдать “c”, но как оказалось, для моей сети это была простая задача.
А branching multi-hop – это типа “a = b, а ещё a = c. Какой a в начале был задан, а какой в конце?”.
В общем, у меня было два инференса после обучения:
-
Просто тест (“a = b, a = c”), без всяких изменений.
-
Тест, но на (как это пафосно называют) экстраполяцию длины – типа длину теста делают больше. Так что тут уже было вот так: “a = b = c, a = c = b”.
На втором тесте моя сеть и всегда валила.
Изначально мне казалось что это проблема в слое LWM.
Пытался “решить” я так – с начало попытался за место деления на  поставить LayerNorm (качество было больше, но всё равно валила), потом вообще решил H с начало пропускать через три матрицы – Q, K, V – без изменений.
В общем перепробовал я все адекватные на мой взгляд варианты, и я понял что LWM мне не чем не поможет.
Тогда я подумал-подумал – и понял – я забыл поставить output gate (ну да…).
В общем спустя час ковыряний с output gate (то превращал в обычный линейный слой, то ставил  за место нормального
 ) я пришёл к выводу каким надо сделать output gate. Ну, в разделе “Теория.” к этому варианту и пришёл.
И вот резко моя сеть стала проходить эти multi-hopы.
Код теста
import torch
import torch.nn as nn
import torch.optim as optim
import numpy as np

device = torch.device("cuda")

class LSWM(nn.Module):
    def __init__(self, vocab_size, d_model):
        super().__init__()

        self.d = d_model
        self.sd = d_model ** 0.5

        self.vocab_size = vocab_size
        self.embedding = nn.Embedding(vocab_size, d_model).to(device)

        self.W_f = nn.Linear(d_model, d_model).to(device)
        self.W_ix = nn.Linear(d_model, d_model).to(device)
        self.W_ih = nn.Linear(d_model, d_model).to(device)
        self.W_o = nn.Linear(d_model, d_model).to(device)
        self.a = nn.Parameter(torch.scalar_tensor(2)).to(device)

        self.norm = nn.LayerNorm(d_model).to(device)

    def softsign(self, x):
        return x / (1.0 + torch.abs(x))

    def softsign_scaled(self, x):
        return (1.0 + self.softsign(x)) / 2.0

    def forward(self, token_seq):
        batch_size, seq_len = token_seq.size()

        x_seq = self.embedding(token_seq)

        h_t = torch.zeros(batch_size, self.d).to(device)
        h = []

        for t in range(seq_len):
            x_t = x_seq[:, t, :]

            x_normed = (self.softsign(x_t + h_t)) * self.a

            f_t = self.softsign_scaled(self.W_f(x_normed + h_t))
            i_t = self.softsign_scaled(self.W_ix(x_t) + self.W_ih(h_t))
            o_t = self.softsign(self.W_o(x_normed + h_t))

            c = self.softsign_scaled(f_t * h_t + i_t * x_normed)

            h_t = o_t * c

            h.append(h_t)

        h = torch.stack(h, dim=1)
        res = torch.bmm(h, torch.bmm(h.transpose(-2, -1), h))
        h = res / self.sd

        res = self.softsign(h.sum(dim=1))

        return self.norm(res)

VOCAB_SIZE = 21
TOKEN_ARROW = 15
TOKEN_Q_1 = 16
TOKEN_Q_2 = 17

def generate_branching_batch(batch_size, epoch):
    x = np.zeros((batch_size, 7), dtype=np.int64)
    y = np.zeros(batch_size, dtype=np.int64)

    for i in range(batch_size):
        a, b, c = np.random.choice(15, 3, replace=False)

        ask_live = epoch % 2 == 0

        if ask_live:
            x[i] = [a, TOKEN_ARROW, b, a, TOKEN_ARROW, c,  TOKEN_Q_1]
            y[i] = b
        else:
            x[i] = [a, TOKEN_ARROW, b, a, TOKEN_ARROW, c,  TOKEN_Q_2]
            y[i] = c

    return torch.tensor(x).to(device), torch.tensor(y).to(device)

D_MODEL = 128
model = LSWM(vocab_size=VOCAB_SIZE, d_model=D_MODEL).to(device)
criterion = nn.CrossEntropyLoss().to(device)
optimizer = optim.Adam(model.parameters(), lr=0.0002, weight_decay=0.0099999)

acc = 0
epoch = 1
while epoch != 1001:
    inputs, targets = generate_branching_batch(64, epoch)

    optimizer.zero_grad()
    outputs = model(inputs)
    loss = criterion(outputs, targets)
    loss.backward()
    optimizer.step()

    if epoch % 500 == 0:
        preds = torch.argmax(outputs, dim=1)
        acc = (preds == targets).float().mean().item() * 100
        print(f"Loss: {loss.item():.4f} | Accuracy: {acc:.1f}%")

    epoch += 1

a, b, c = 3, 7, 12

model.eval()

with torch.no_grad():
    test_live = torch.tensor([[a, TOKEN_ARROW, b, a, TOKEN_ARROW, c, TOKEN_Q_1]]).to(device)
    pred_live = torch.argmax(model(test_live), dim=1).item()

    test_work = torch.tensor([[a, TOKEN_ARROW, b, a, TOKEN_ARROW, c, TOKEN_Q_2]]).to(device)
    pred_work = torch.argmax(model(test_work), dim=1).item()

    print("test 1:")
    print(f"a 1: {pred_live}")
    print(f"a 2: {pred_work}")

with torch.no_grad():
    test_live = torch.tensor([[b, TOKEN_ARROW, c, TOKEN_ARROW, a, b, TOKEN_ARROW, a, TOKEN_ARROW, c, TOKEN_Q_1]]).to(device)
    pred_live = torch.argmax(model(test_live), dim=1).item()

    test_work = torch.tensor([[b, TOKEN_ARROW, c, TOKEN_ARROW, a, b, TOKEN_ARROW, a, TOKEN_ARROW, c, TOKEN_Q_2]]).to(device)
    pred_work = torch.argmax(model(test_work), dim=1).item()

    print("test 2:")
    print(f"b 1: {pred_live}")
    print(f"b 2: {pred_work}")
Запускаю и…
Loss: 0.5694 | Accuracy: 89.1%
Loss: 0.1655 | Accuracy: 100.0%
test 1:
chain: 3, arrow, 7, and, 3, arrow, 12
need: 7 a 1: 7
need: 12 a 2: 12
test 2:
chain: 7, arrow, 12, arrow, 3, and, 7, arrow, 3, arrow, 12
need: 3 b 1: 3
need: 12 b 2: 12
Всё как и надо.
Если что “need: число” и “chain: цепочка” – это я уже к результату приписал чтобы было понятнее.
Кстати – я ещё попробовал в тест 2 добавлять “мусорные” токены (их мало было – всего 3, но даже 3 я считаю уже значительным изменением) – так же работало, на мое удивление.
Другие тесты опубликовывать не буду (на Гитхаб опубликую уже), но вот таблица:
|
Тест |
Правильно? |
Эпох |
|
Multi-hop braching |
Да |
1000 |
|
Multi-hop (обычный) |
Да |
1000 |
|
Простая синусоида |
Близко (надо 0.2440, а сеть выдала 0.2698) |
600 |
Как видим, сеть достаточно правильно отвечает!
Я правда ещё не делал тесты на генерацию текста, но я буду обязан их сделать в обозримом будущем.
Бенчмаркинг.
Время перейти к бенчмаркам!
Записывать буду в таблицу все результаты.
Правда, вот появилась проблема – на моём Google Colab я исчерпал лимиты на GPU, так что замерять буду на CPU.
Я решил замерять на том же multi-hop branching тесте (первом где a = b, a = c) который у меня описан ранее в разделе “Практика (без замеров).”.
|
Метрика |
LSTM |
GRU |
LSWM (torch.compile) |
|
Лосс в конце обучения (400 эпох). |
0.8333 |
0.2362 |
0.1666 |
|
Качество в конце обучения (400 эпох). |
71.9% |
96.9% |
100.0% |
|
Результат сети (1). |
7 |
7 |
7 |
|
Результат сети (2). |
12 |
12 |
12 |
|
Количество параметров. |
68609 |
68880 |
68609 |
|
Скорость обучения (400 эпох). |
4 сек |
4 сек |
8 сек |
|
Weight decay |
0.0099999 |
0.0099999 |
0.0099999 |
|
Learning rate |
0.0004 |
0.0004 |
0.0004 |
|
Hidden size |
91 |
105 |
128 |
Как видим, LSWM обходит всех по точности, а GRU и LSTM – по скорости обучения, но их объединяет одно – у них всех ответы одинаково правильные.
Я не хочу делать второй бенчмарк на второй тест (там практически всё так же по скорости и всему остальному), так что дам результаты:
|
LSTM |
GRU |
LSWM |
|
3 |
3 |
3 |
|
12 |
12 |
12 |
В общем это подтверждает то что они при любом случае выдадут одинаковые ответы после обучения на этой задаче.
Я решил изменить первую цепочку второго теста на такую цепочку:
“b – c – a – b – a”.
Протестировал и я понял – моя сеть чувствительна к сиду (рандома).
Тогда я решил найти оптимальный вариант математики моей LSWM чтобы убрать чувствительность к сиду (рандома).
В итоге я сделал изменения:
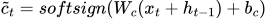
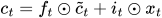
Потом:
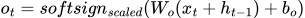
И убрал изменение  (
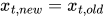 теперь считай).
Ну и конечно же:

То есть я убрал  .
И только тогда моя сеть стала намного лучше (и даже быстрее!).
Плюсы и минусы моей сети.
Плюсы LSWM (оригинальной):
-
Более “большие” хвосты softsign.
-
Легкость операций (0 экспонент).
-
Достаточно мало параметров (нету W_c).
-
“Self-Attention” в LWM слою.
Минусы оригинальной LSWM:
-
Иногда “большие” хвосты softsign’а могут вредить.
-
 – это на самом деле плохое вычисление которое делает
 слишком сильным из-за чего сеть становится более чувствительной к рандомному сиду.
-
Отсутствие CEC – все таки карусель постоянной ошибки важна.
У модифицированной LSWM (где есть карусель постоянной ошибки которая описана в разделе “Бенчмаркинг.” и остальные модификации) есть один минус и убирается один плюс.
Этот самый минус – это хвосты softsign.
Убирается один плюс – маленькое число параметров.
Вывод.
Сделаю быстрый вывод.
Constant Error Carousel – очень важная штука, без неё никуда.
Не делай  слишком сильным даже если потом нормируешь его softsignом.
Softsign и его масштабированная версия (для диапазона от 0 до 1) в качестве замены tanh и sigmoid – идея рабочая.
Заменить concat суммой – тоже рабочая идея.
LWM слой – тоже рабочая идея (ведь качество не упало из-за него, модель по-прежнему хорошо отвечает).
P.S: Это моя первая такая статья, писал на коленке, увидите изъян в математике – пишите, грамматическую ошибку увидели – тоже пишите, потому что просто минусовать статью не даёт мне нужного фидбэка чтобы я чему то научился. Гитхаб опубликую потом…
Автор: pureooplover

