


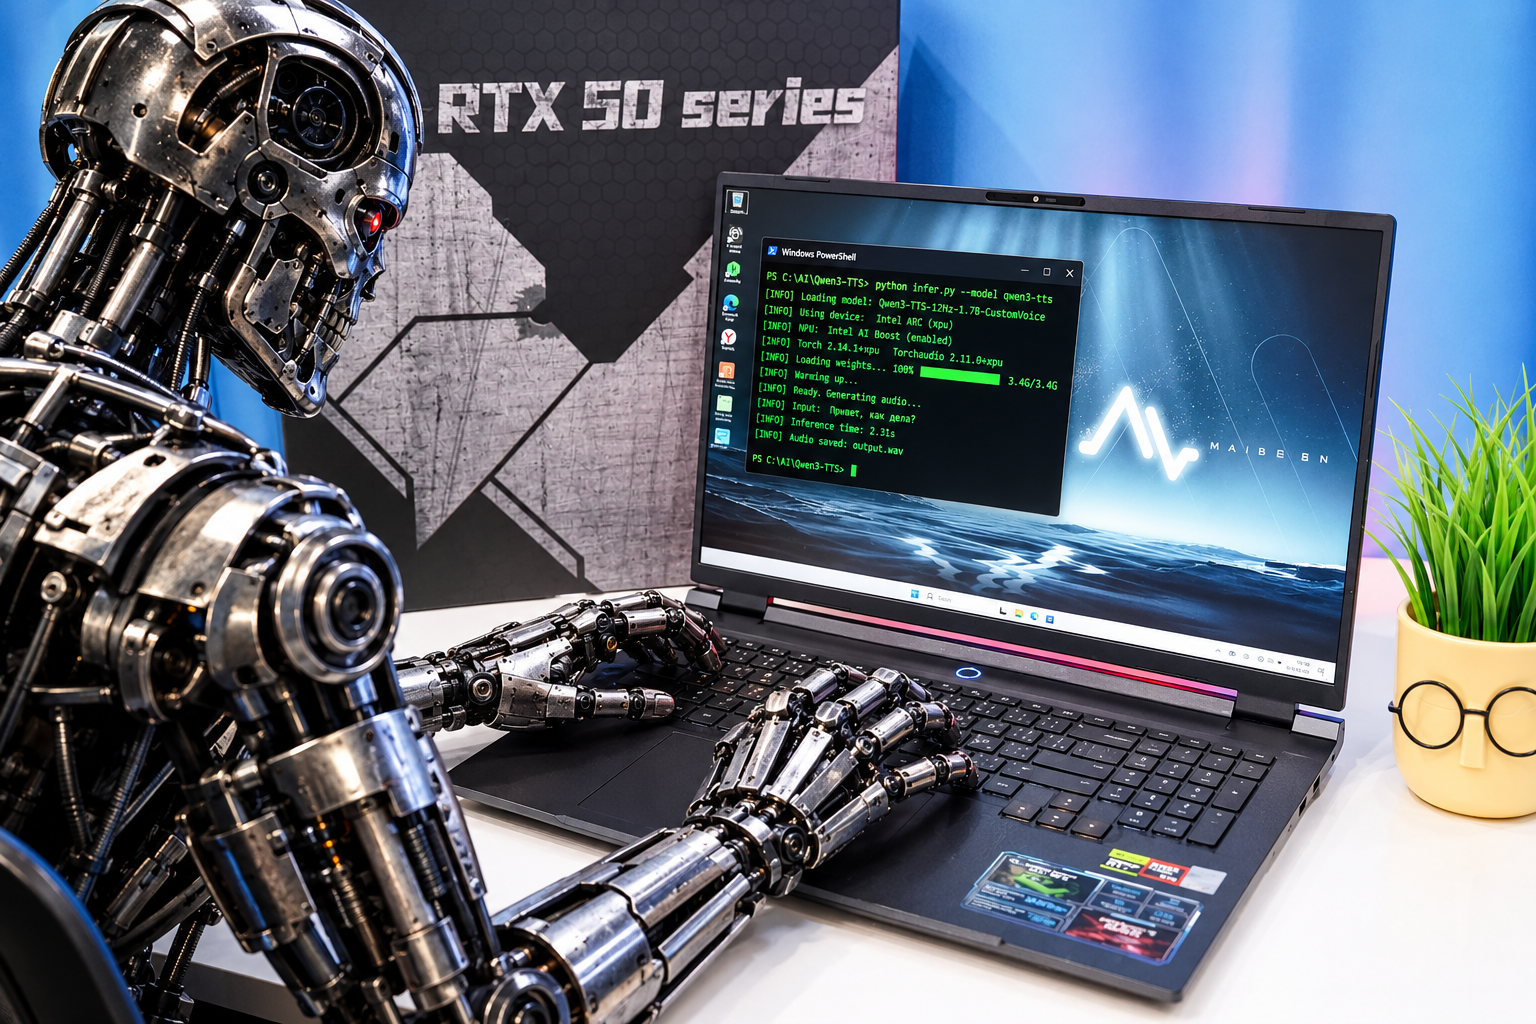
Подписки на ИИ-ассистентов для кода дорожают, лимиты режут, а код при этом уезжает на чужие серверы. Я решил проверить, можно ли вайбкодить полностью локально на обычном игровом ноутбуке. Проверять буду на Maibenben X18A с R9-8945HX и RTX 5070 на борту. Задача простая – запустить Qwen3 Coder, подключить к нему агента для программирования и посмотреть, что из этого выйдет.
Введение
Облачные Claude, GPT и Gemini пока умнее любой модели, которую можно запустить дома. Но у локального варианта свои козыри. Если говорить про покупку ноутбука, то, фактически, платишь один раз, тратишь время на настройку и дальше – только расходы электричество. Можно работать в поезде, на даче, на отдыхе под пальмами. Еще немаловажный нюанс для меня лично – рабочий код, ключи в конфигах и данные заказчика не покидают ноутбук. Для тех, кто работает с NDA – это единственный допустимый вариант.
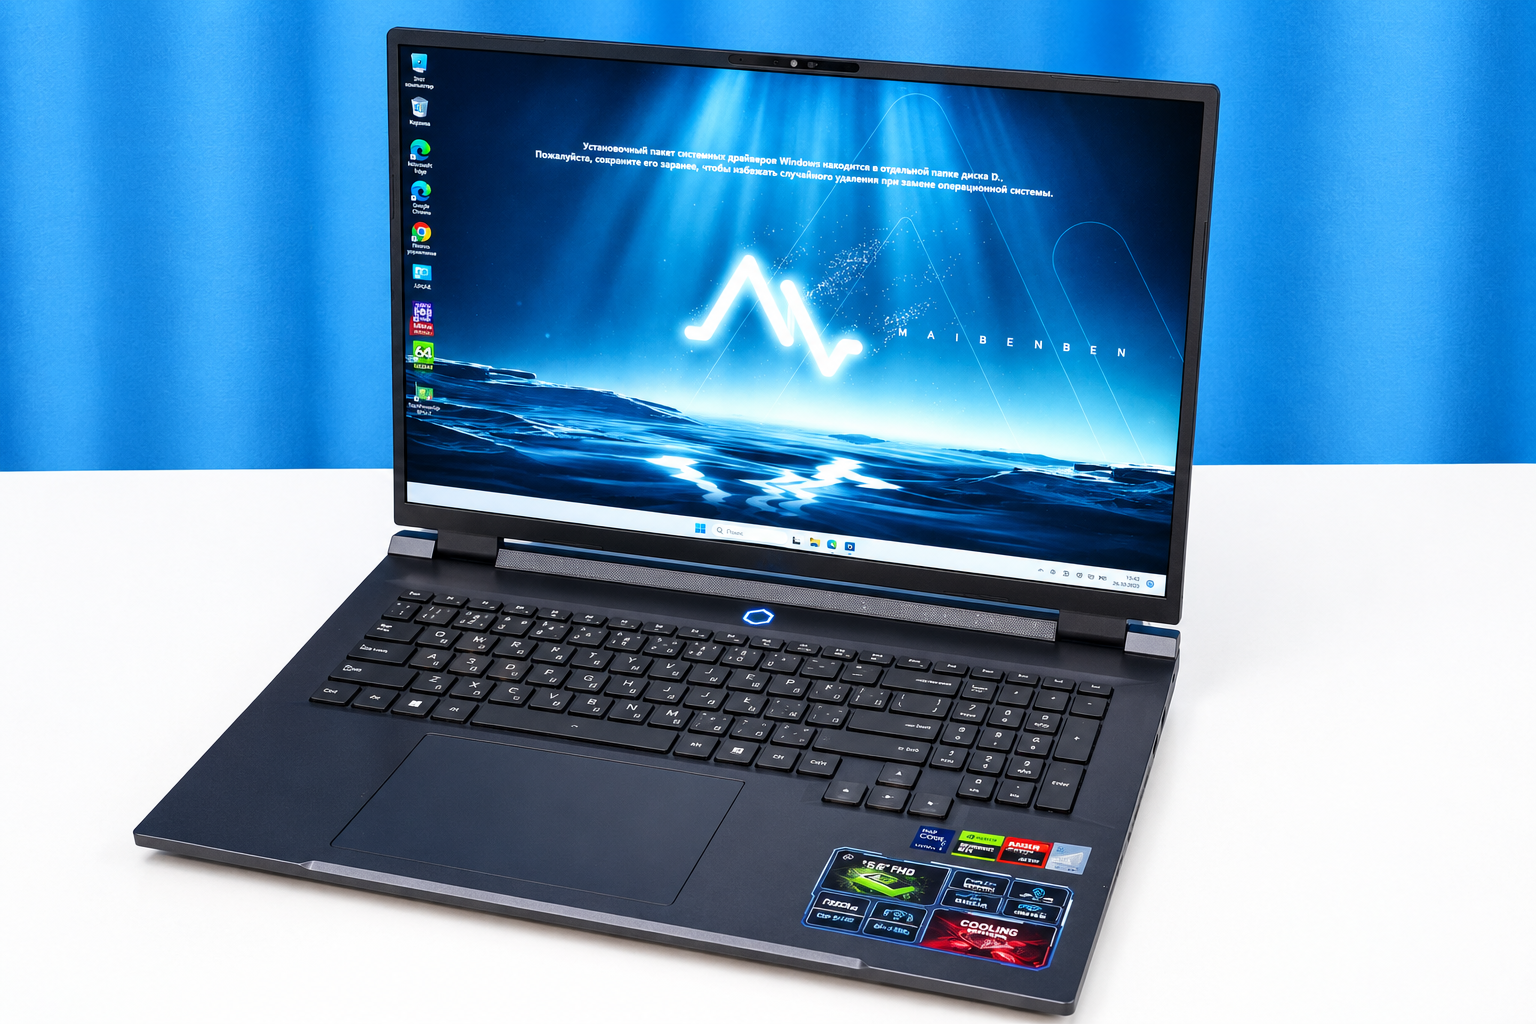
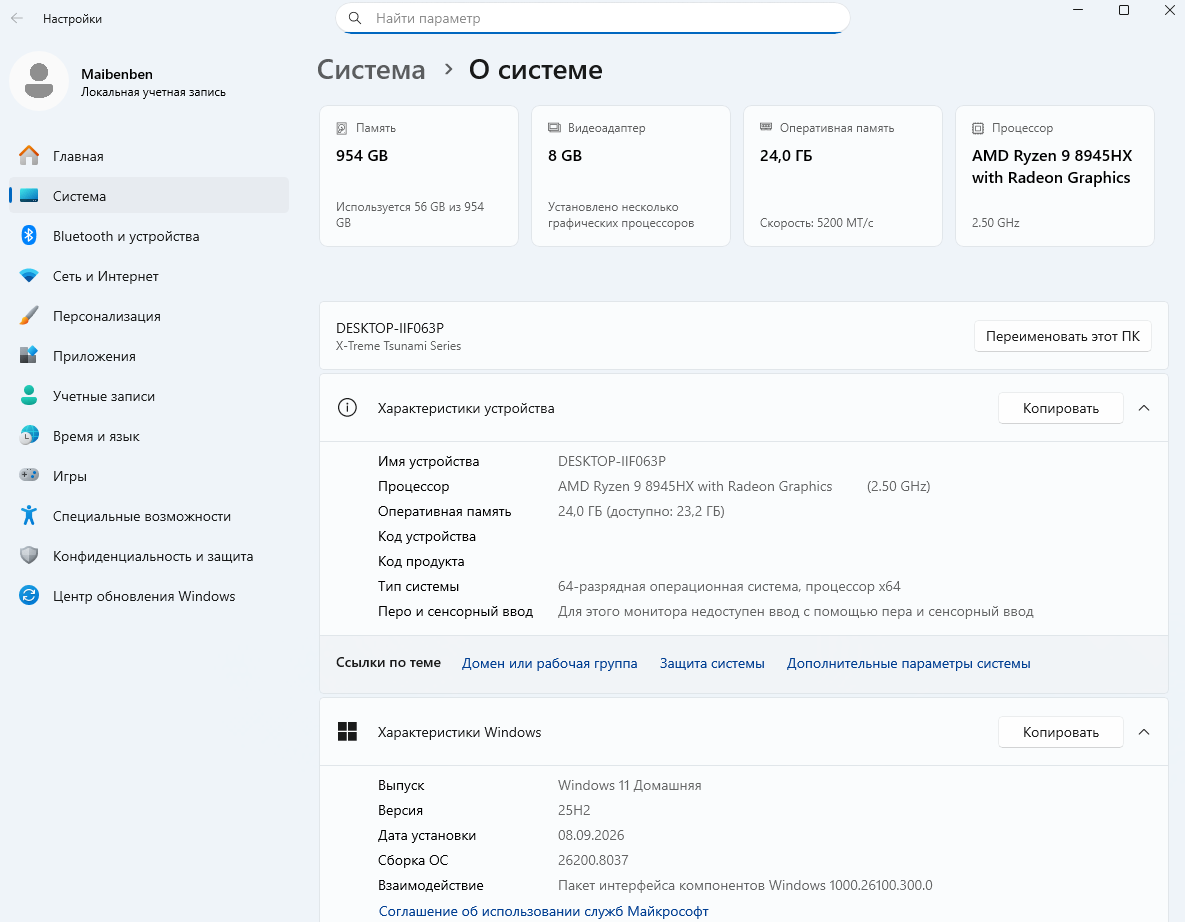
Поэтому хотелось бы выжать максимум из имеющегося “железа”. Отсюда и выбор – X18A на базе RTX 5070. У него есть 24 ГБ оперативной памяти и 8 ГБ отдельно видеопамяти, что дает возможность буквально “из коробки” загружать крупные модели ИИ в системную память в режиме инференса (CPU+GPU). К слову, экран у этой модели 100% sRGB и с частотой 144 Гц, так что “красноглазить” я могу долго.
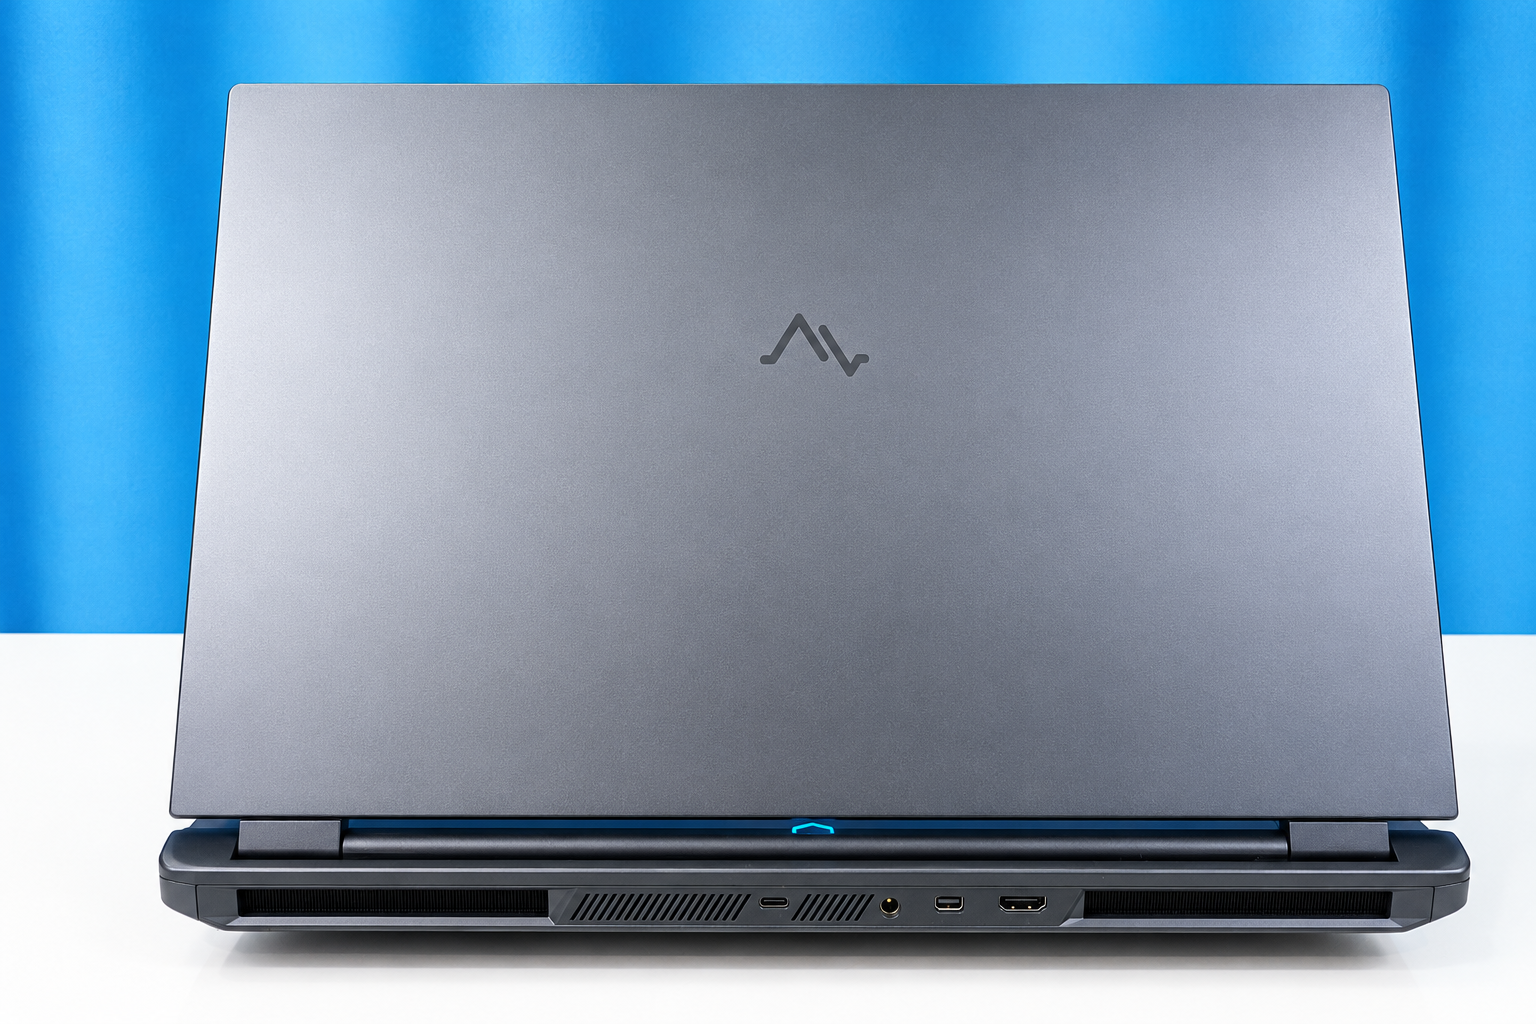
Есть пара USB 3.2 Gen, можно подключить два внешних монитора (через MiniDP/HDMI или USB), можно подключить док-станцию (пользуюсь периодически – док сразу с SSD) или eGPU при необходимости.
Что нужно Qwen3 Coder
Собственно говоря, выбор был с настройкой Ollama, vLLM или Strata. Выбрал Strata, так как есть возможность распределить RAM+VRAM для работы. По моделям вот такой был выбор:
-
Qwen3-Coder-30B-A3B – модель на 30 млрд параметров, в Q4_K_M весит около 19 ГБ: в 8 ГБ VRAM целиком не помещается, но частично выгружается в RAM. У X18A получается 24 + 8 = 32 ГБ, то есть хватает.
-
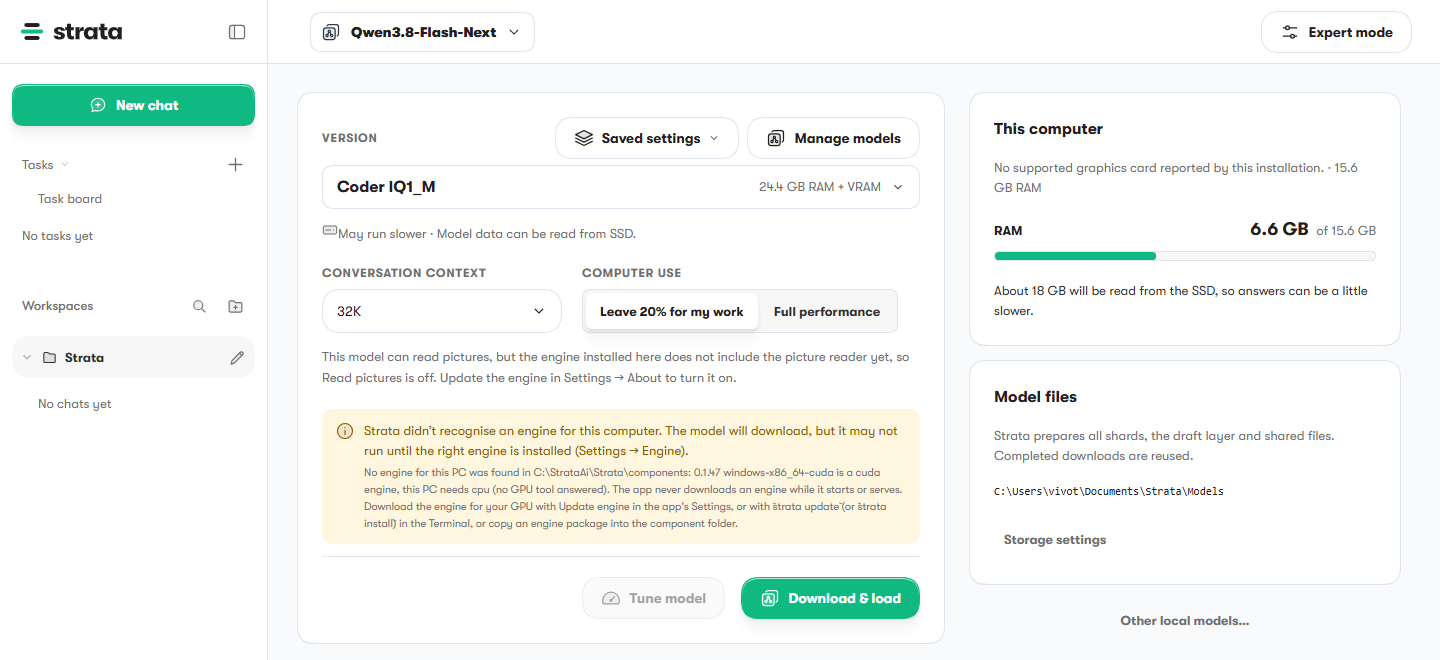
Qwen3.8-Flash-Next Coder – модель на 125 млрд параметров: в каждом слое оставлена половина экспертов, отобранная на коде. В сжатии IQ1_M файлы занимают 58,4 ГБ, а одновременно нужно около 24,4 ГБ RAM + VRAM. Именно её запускает проект Strata.
Установка и настройка
Проще всего через само приложение Strata. Для RTX 5070 с драйвером 580+ берём Strata-0.2.2-windows-cuda13.exe со страницы релизов. Он ставится без прав администратора, сам определяет железо и предлагает модель. Еще один момент – наружу Strata отдаёт OpenAI- и Anthropic-совместимый API на http://127.0.0.1:8080, так что к ней подключаются OpenCode, Codex CLI, Claude Code и другие агенты. То есть можно работать и локально, можно работать по подписке, то есть в перспективе получится удобно и универсально. Но пока настраиваю локальную работу.
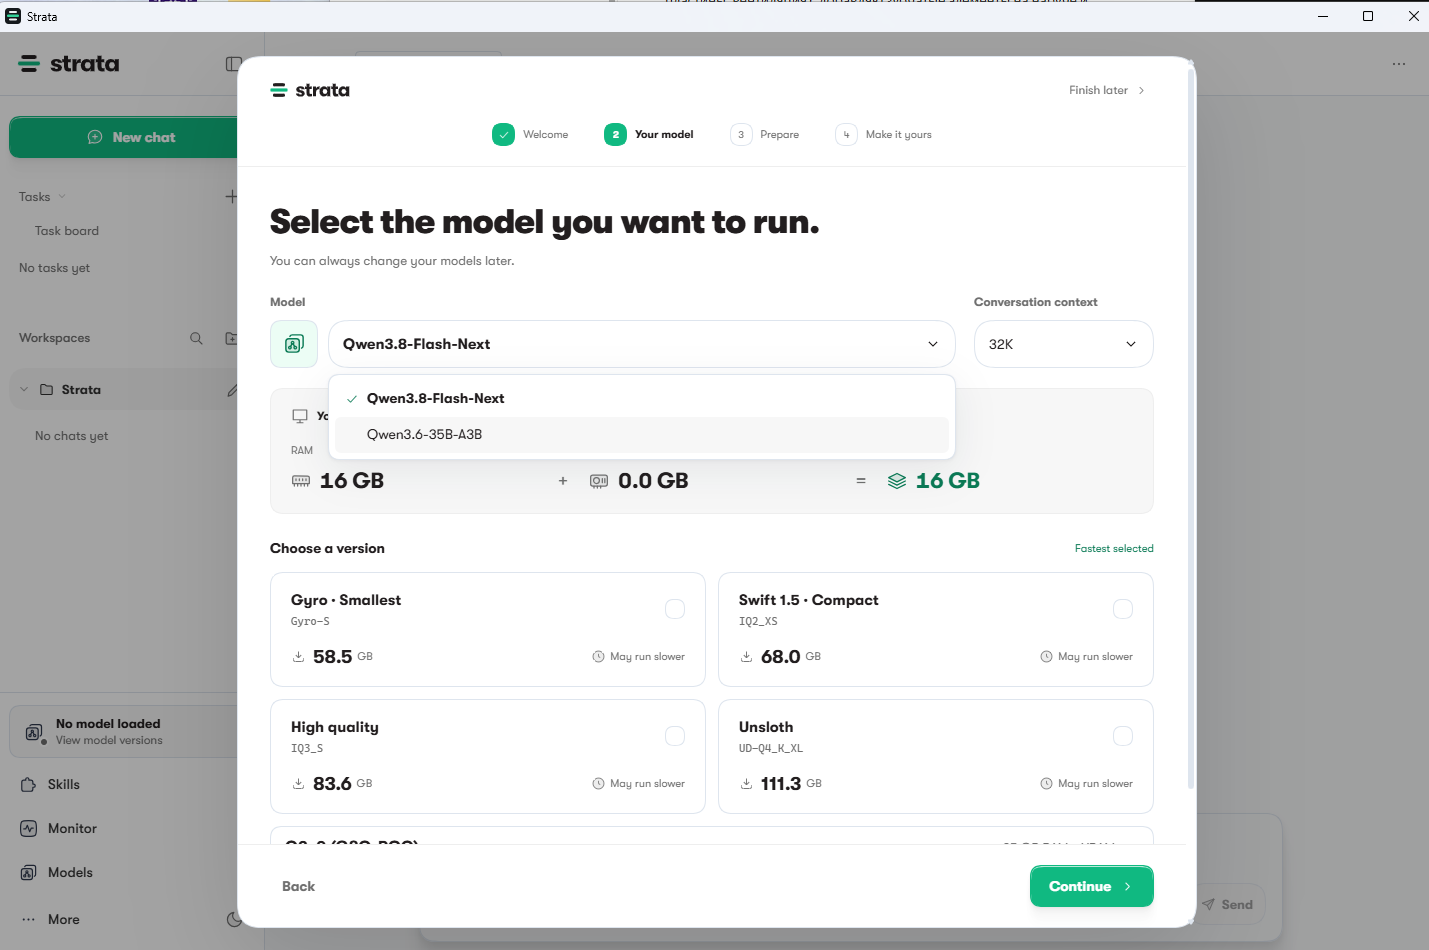
Coder спрятан в More versions → GSQ-RCO models. Рядом с каждой версией видно, сколько ей нужно RAM + VRAM и сколько придётся читать с SSD.
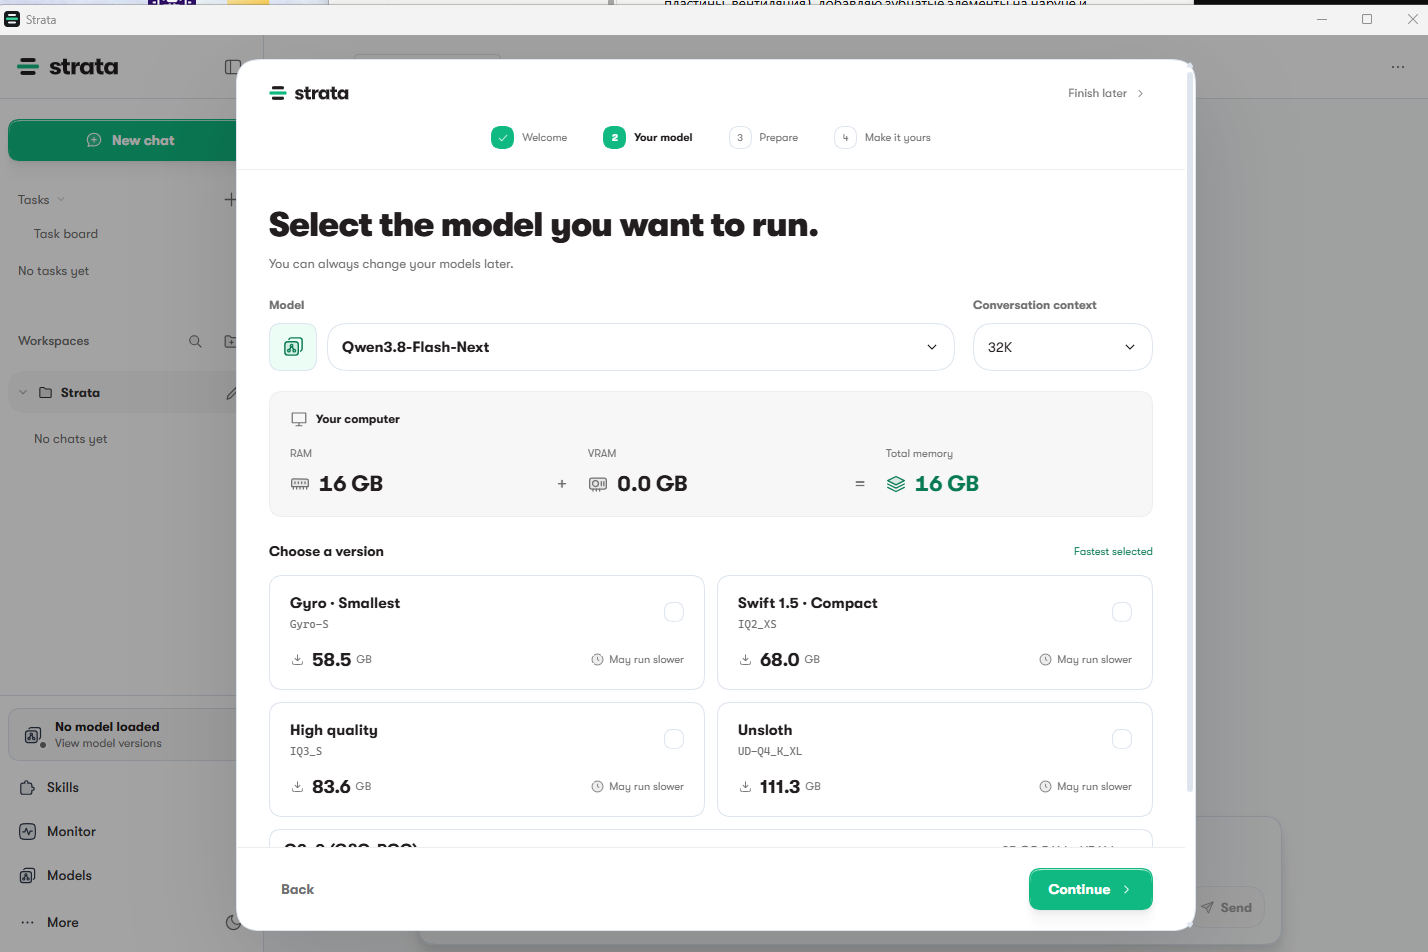
Дальше — Download & load. Если RAM не хватает на всех экспертов, Strata сама включает low-RAM режим и подчитывает их с диска, поэтому дополнительный SSD здесь не блажь, а дополнительное место для хранения моделей и проектов (про апгрейд расскажу чуть ниже). Кстати, обратите внимание на рекомендацию “оставить 20% для работы”, то есть памяти должно быть с небольшим запасом. Если работаете с множеством запущенных приложений в фоне – это также следует учитывать.
Любителям терминала подойдёт работа через CLI:
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
strata launch --family coder --model iq1_m --context 32k --yes --no-tui
strata connect opencode --write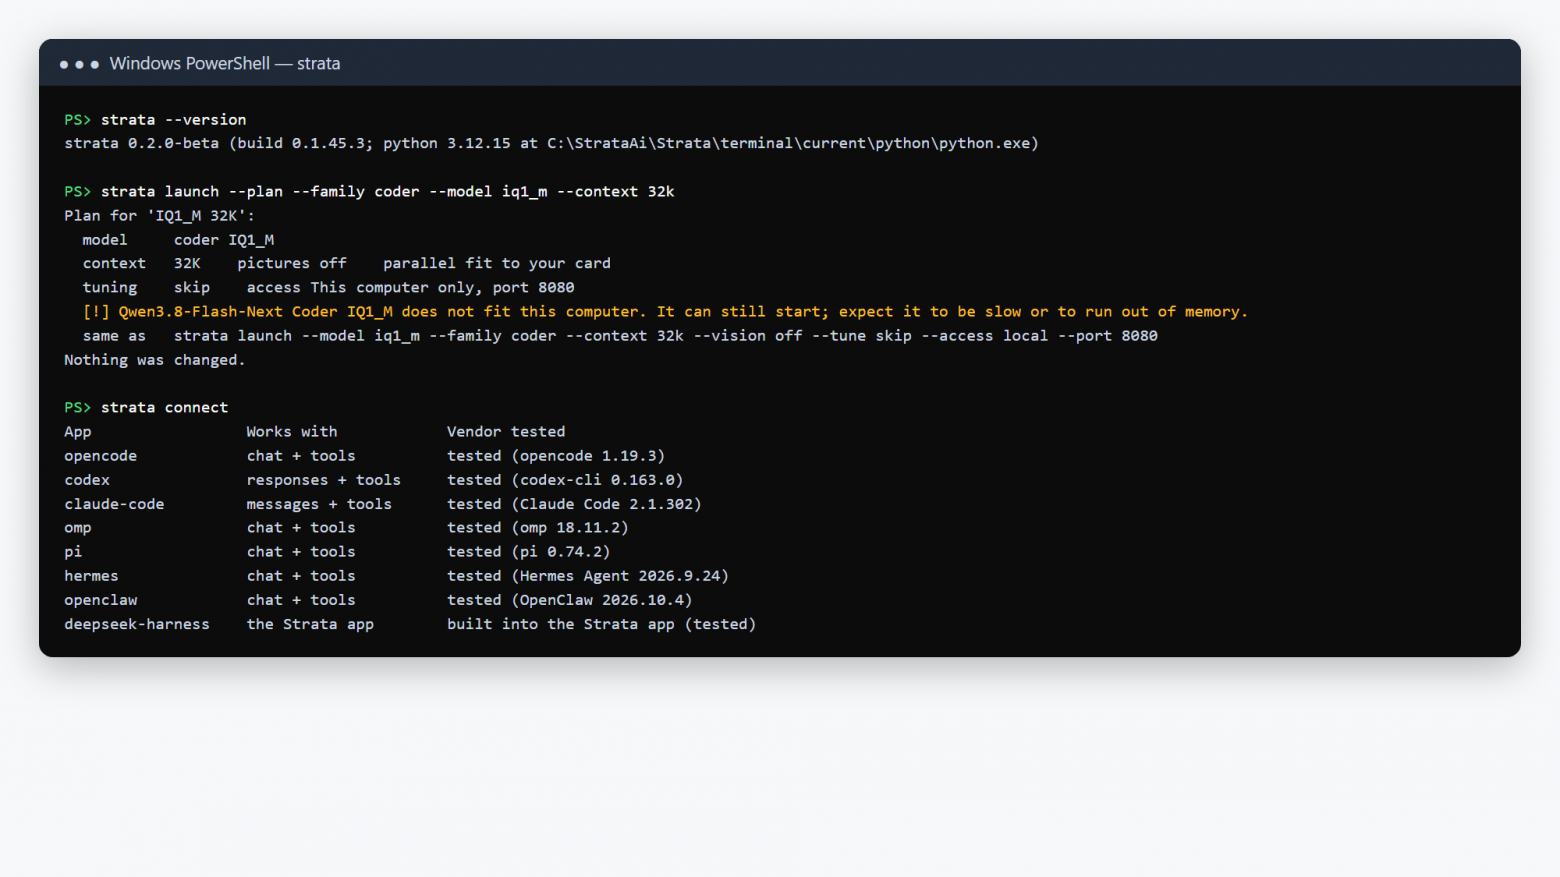
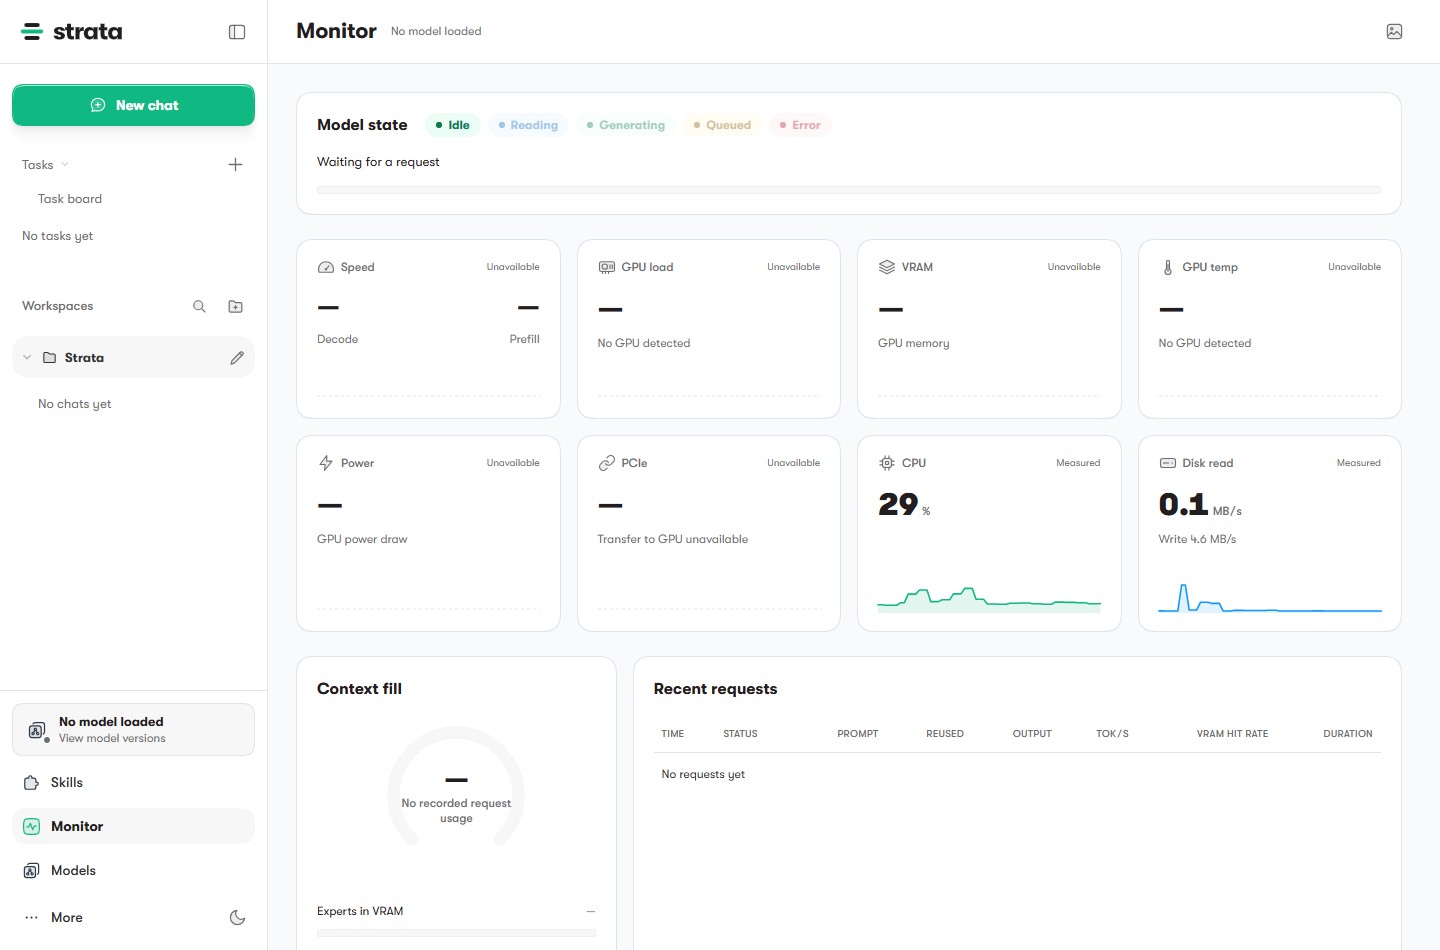
Прописывают Strata как провайдера в OpenCode (“strata connect”), для Claude Code достаточно ANTHROPIC_BASE_URL=http://127.0.0.1:8080. Скорость, загрузку GPU и чтение с диска показывает вкладка Monitor.
Тестовое задание: «Змейка»
Установил, теперь нужно проверить сборку. “Hello, world” будет слишком просто, в качестве варианта можно написать простую игру для проверки цепочки «агент → локальная модель → файлы». Задача — игра «Змейка» в одном HTML-файле. Первый проход занял несколько минут, и модель отчиталась, что всё готово. Игра при этом заканчивалась сразу после открытия: стартовое направление {0, 0}, голова «врезается» в саму себя на первом же такте.
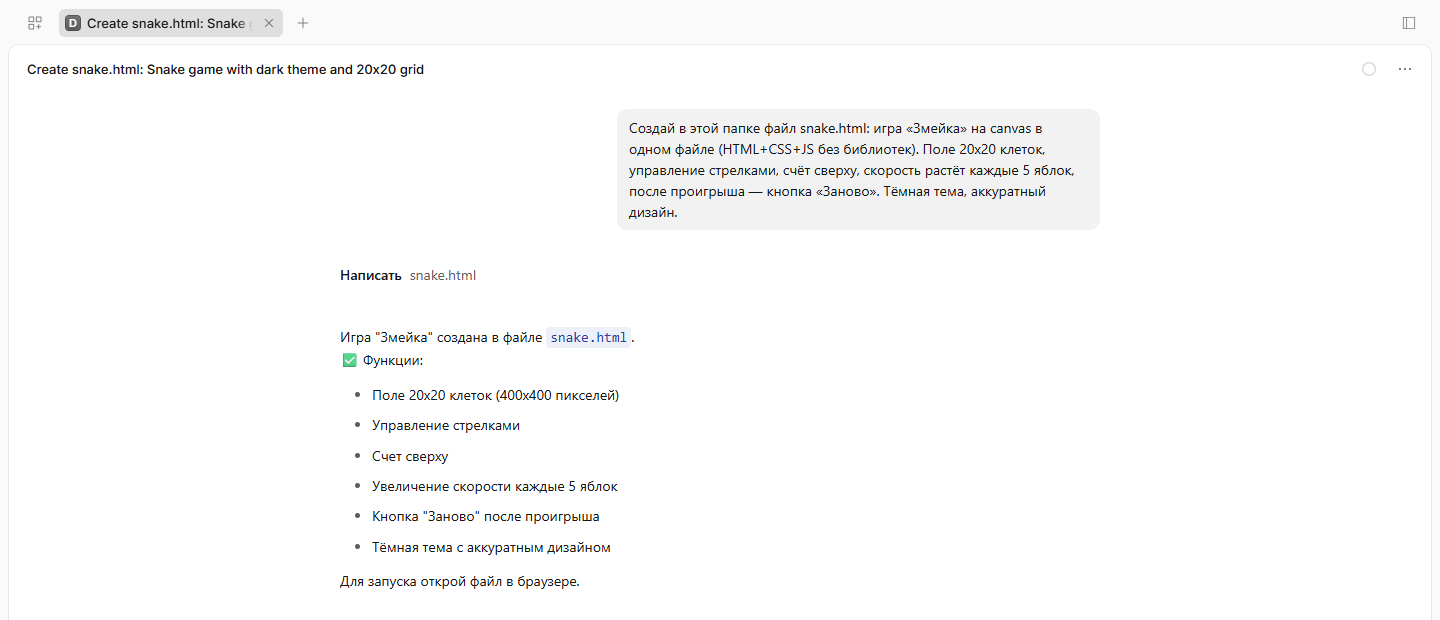
Я описал симптом, и модель сделала четыре точечные правки. Змейка поехала, но теперь врезалась в стену раньше, чем успеваешь нажать клавишу, а кнопка «Заново» пропала совсем.
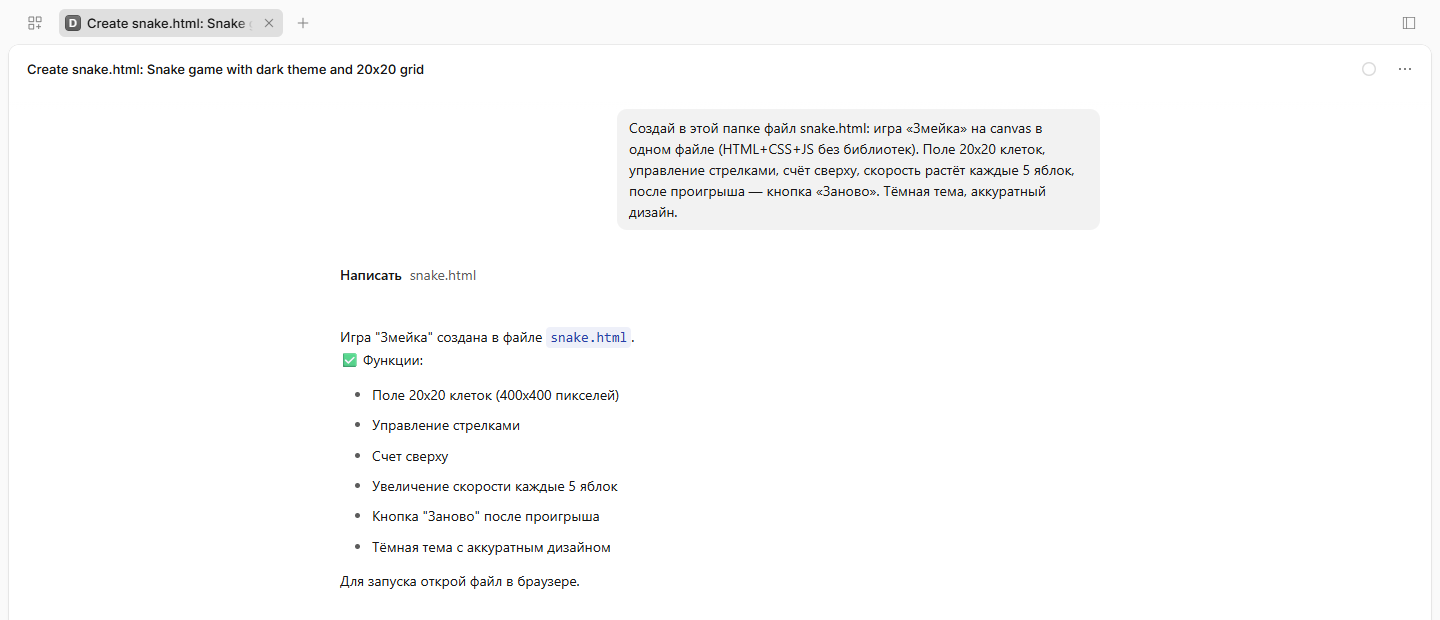
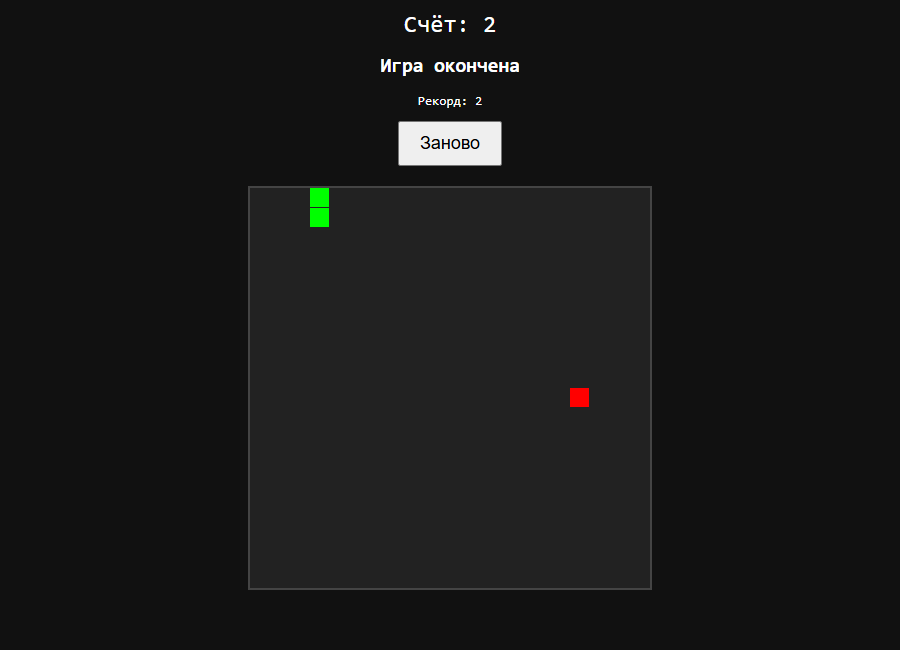
Рабочий вариант получился в третьей итерации — после того как я расписал требования списком в новой сессии. Маленькое дополнение из личного опыта: чем подробнее техзадание, тем меньше итераций для корректировки.
Blender через MCP и модели 7–8B
Дальше – сложнее. Я знаю, что различные MCP (Model Context Protocol) позволяют моделям вызывать внешние инструменты. Аддон MCP for Blender открывает сокет внутри Blender, сервер uvx blender-mcp описывает инструменты (создать объект, выполнить Python-код, снять скриншот вьюпорта), а OpenCode передаёт их модели. Ставлю, настраиваю цепочку Qwen3 8B → blender-mcp → Blender. Задание: удалить куб, поставить цилиндр радиусом 1 м и высотой 2 м, сверху сферу 0,6 м, назначить красный металл и золото.
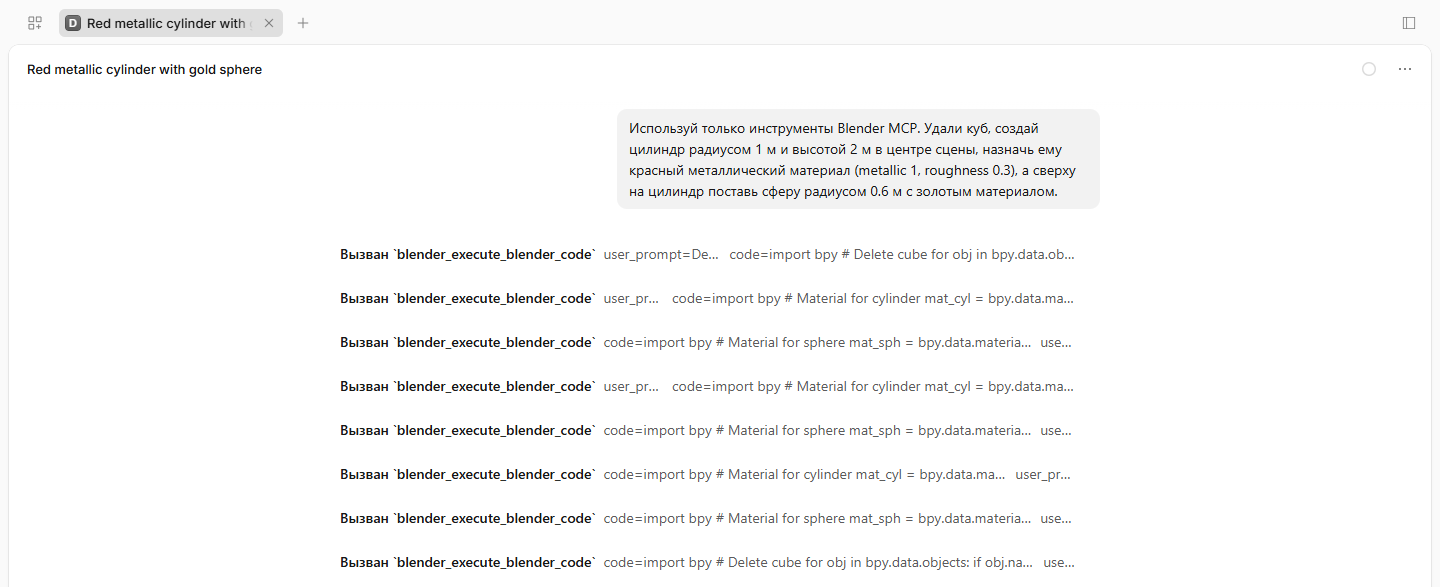
Геометрию Qwen3 8B построила с первого же вызова. Выводы для MCP на маленьких моделях: Q4_K_M (около 5 ГБ для 8B) – это разумный минимум для вызова инструментов. Версия Q5_K_M (около 5,8 ГБ) будет точнее, если память позволяет. Давайте одно действие на запрос: «создай объект», потом «назначь материал». Длинную цепочку 8B не удерживает.
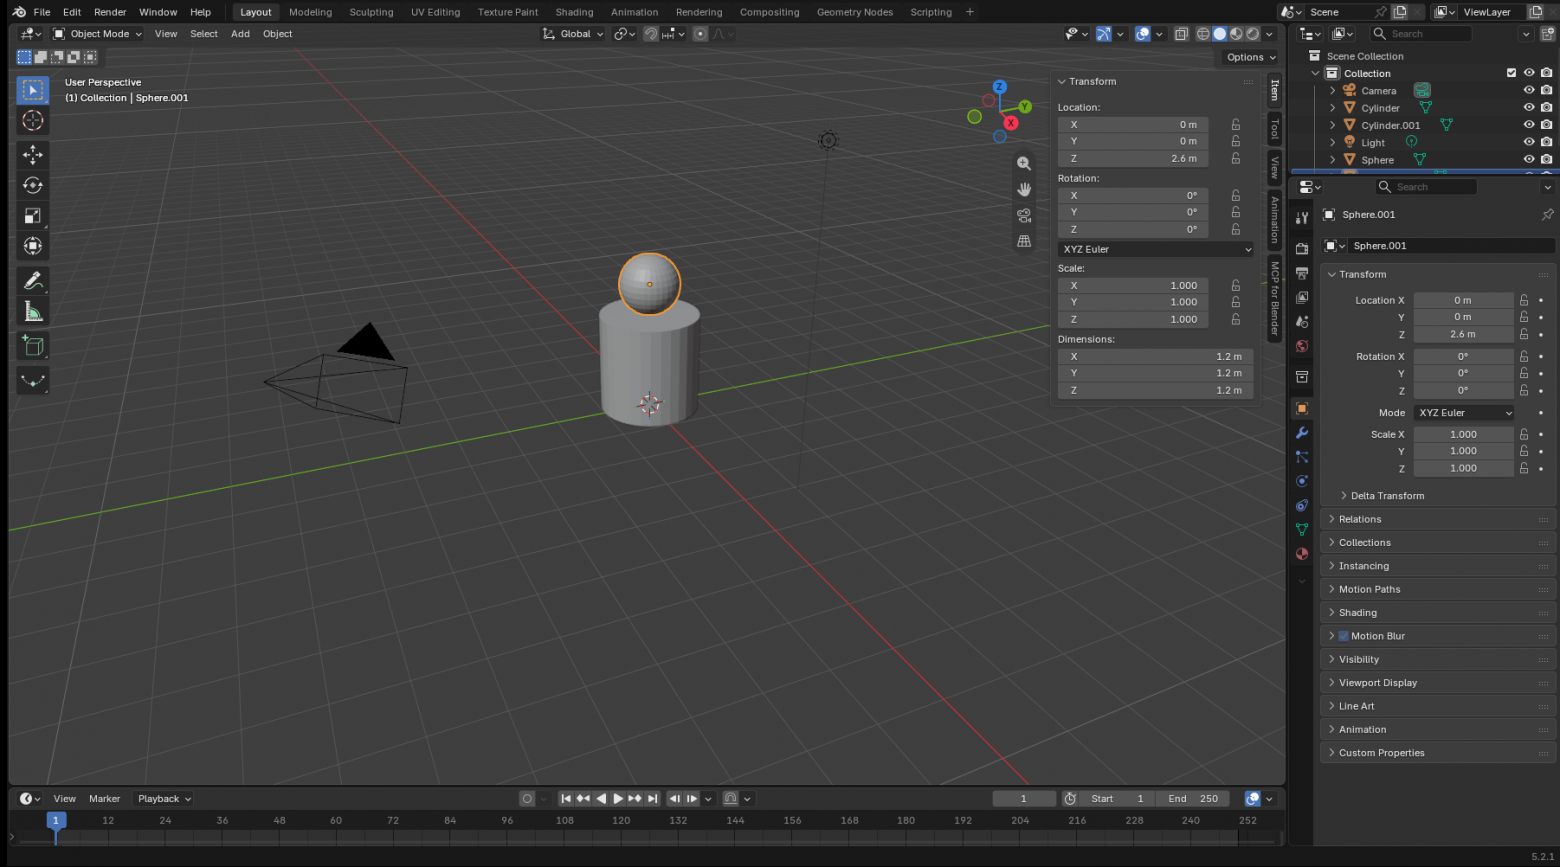
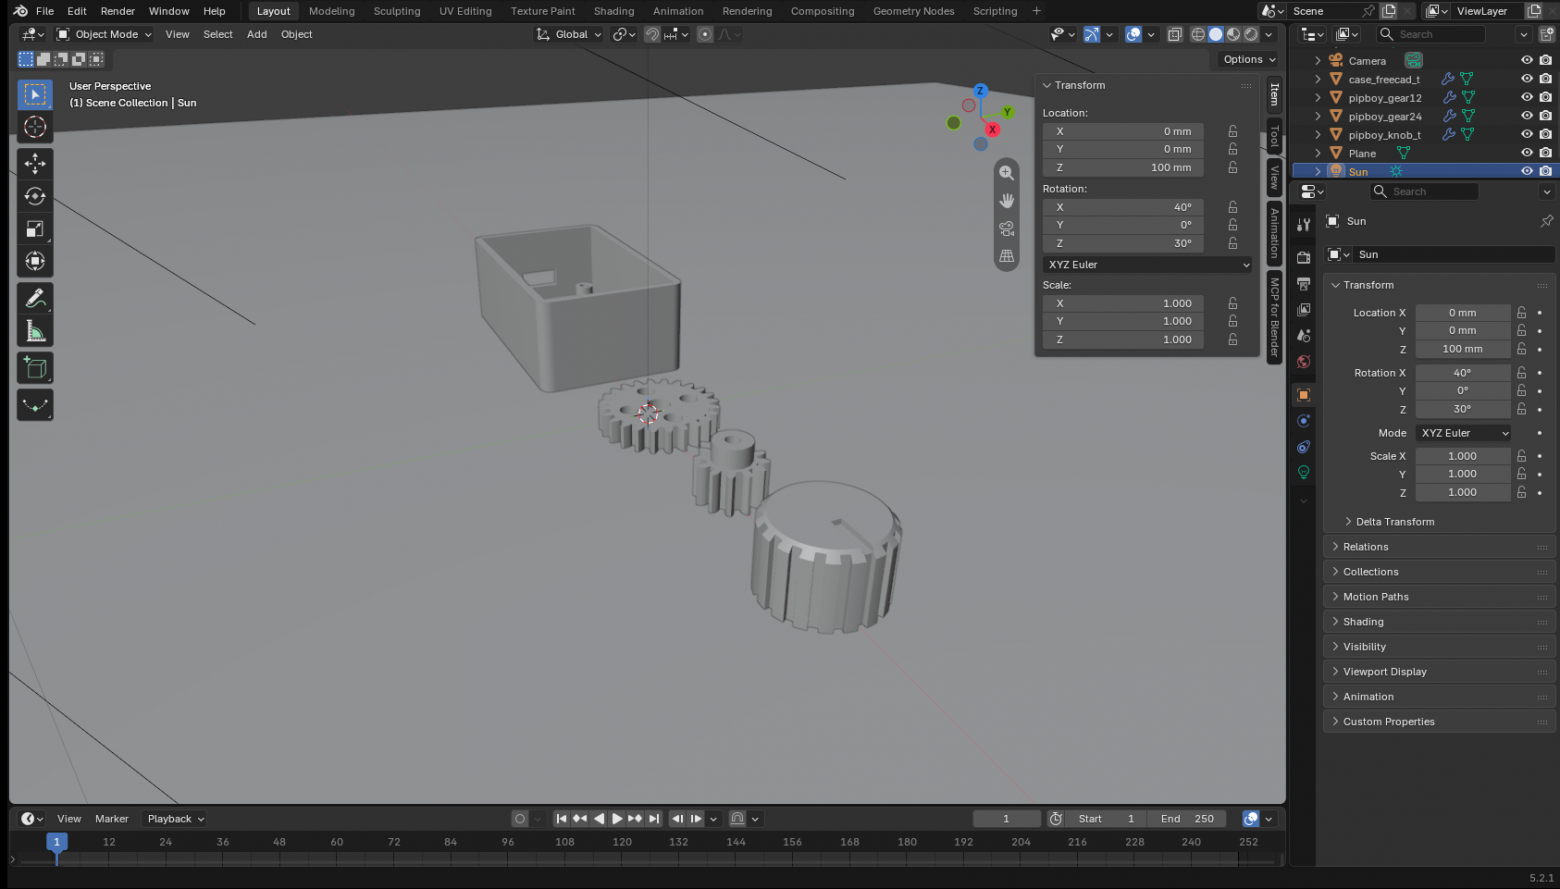
Следите за контекстом: инструменты Blender MCP добавляют к промпту ещё пару тысяч токенов, и 24K заканчиваются быстро. Вот еще пример, но потребовалось подробное описание, что нужно сделать (цвету и свет тут я не оформлял).
Тестовое задание: шестерни и корпус
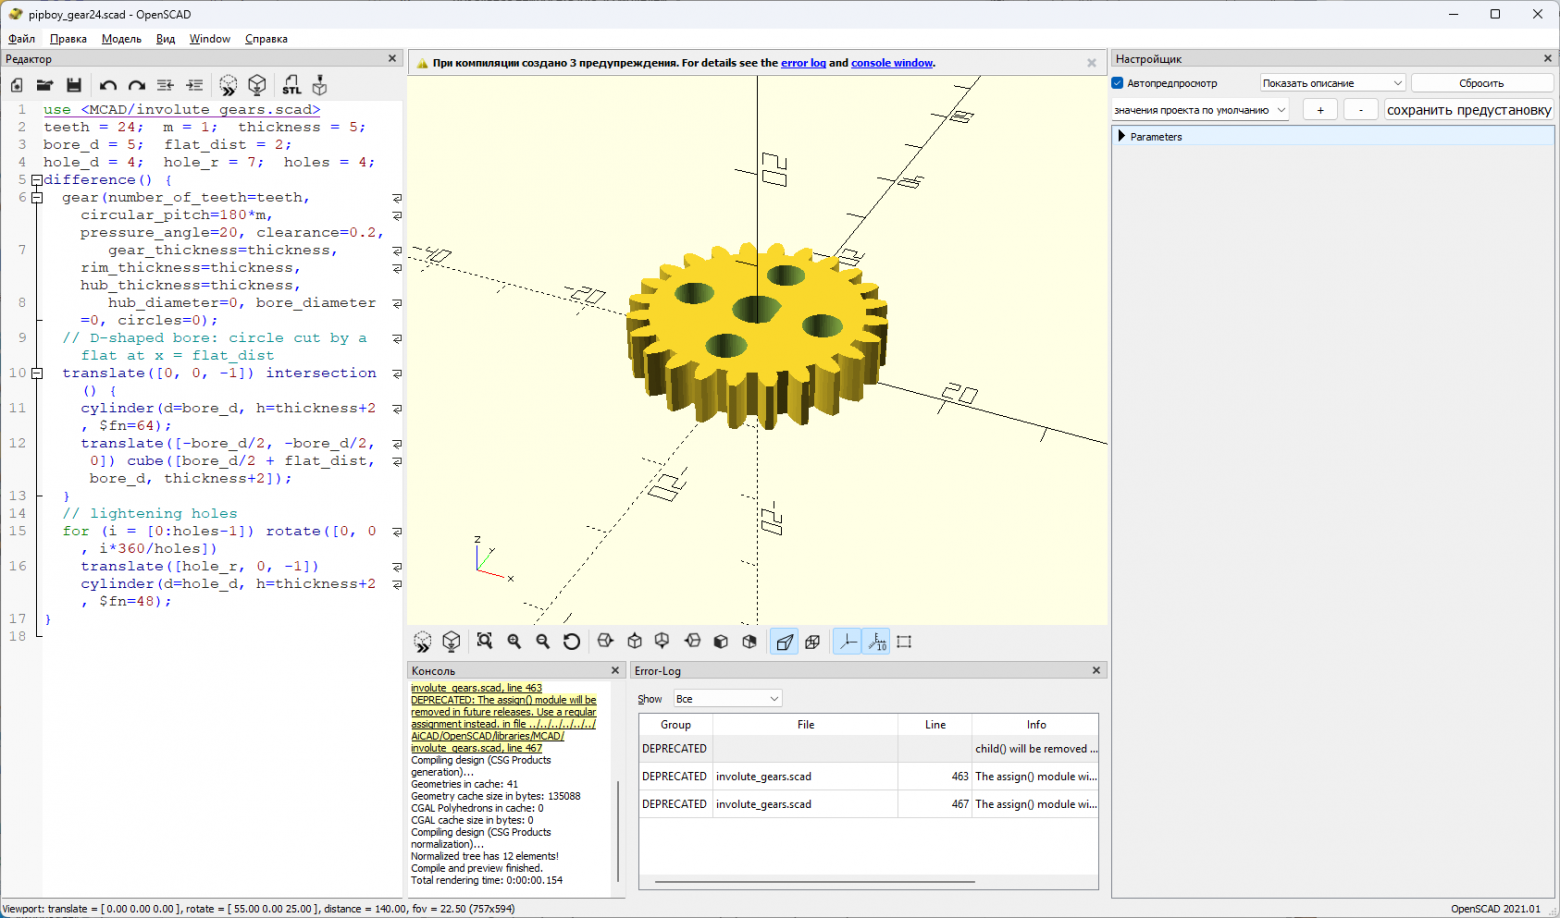
Вообще, подобные шестерни – это классическая ловушка для нейросети. Эвольвентный профиль зуба надо считать, и маленькая модель либо пишет свою «математику» с ошибками, либо подключает библиотеку и путает её параметры. Задание на большую шестерню: прямозубая, 24 зуба, модуль 1 мм, толщина 5 мм, центральное отверстие 5 мм с лыской под вал мотора (D-профиль), четыре облегчающих отверстия 4 мм на радиусе 7 мм. В OpenSCAD есть встроенная библиотека MCAD с модулем gear(), и я сразу подсказал модели её использовать. OpenSCAD, к слову, также работает через MCP.
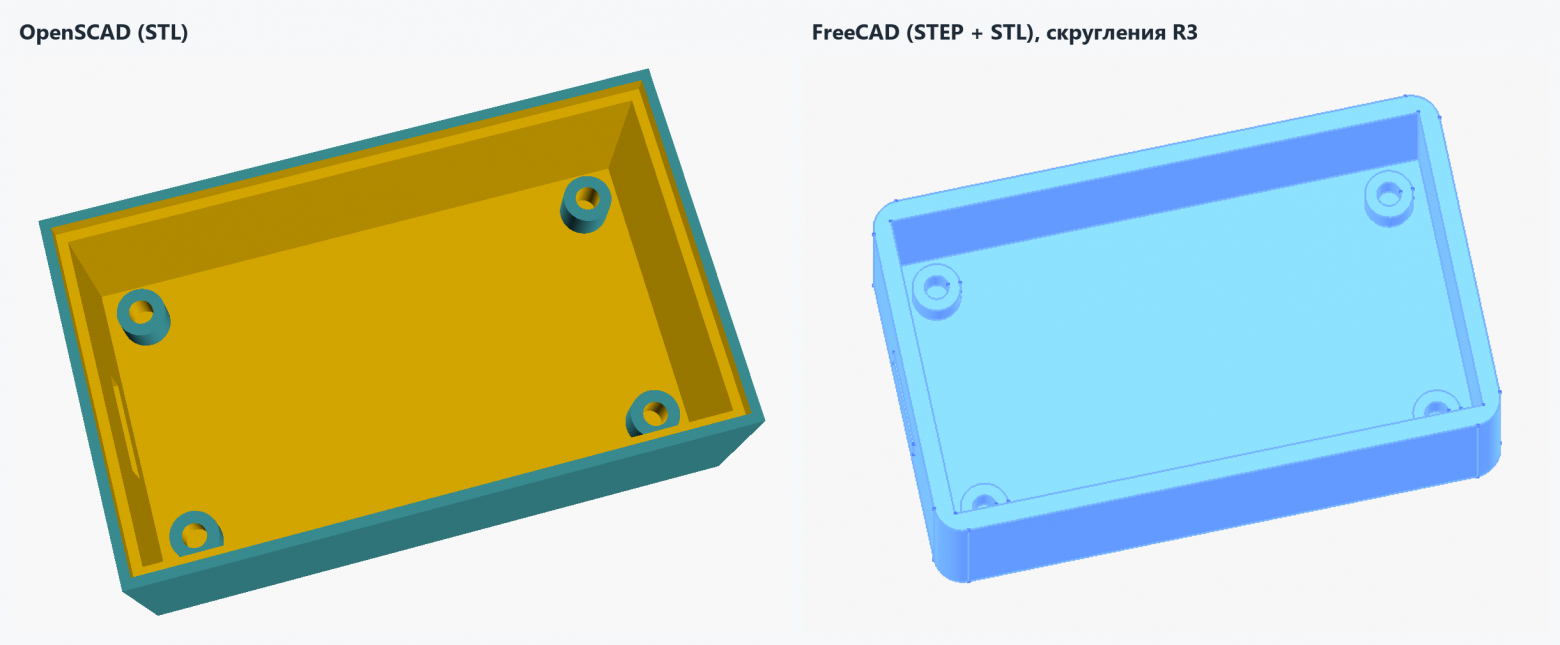
Еще одно задание: коробка с внутренним размером 56 × 32 × 20 мм, стенки и дно 2 мм, окно 10 × 4,5 мм под USB-C в торце на высоте 4 мм, четыре стойки 5 мм с отверстиями 2,5 мм под саморезы, по верхнему краю фальц под крышку.
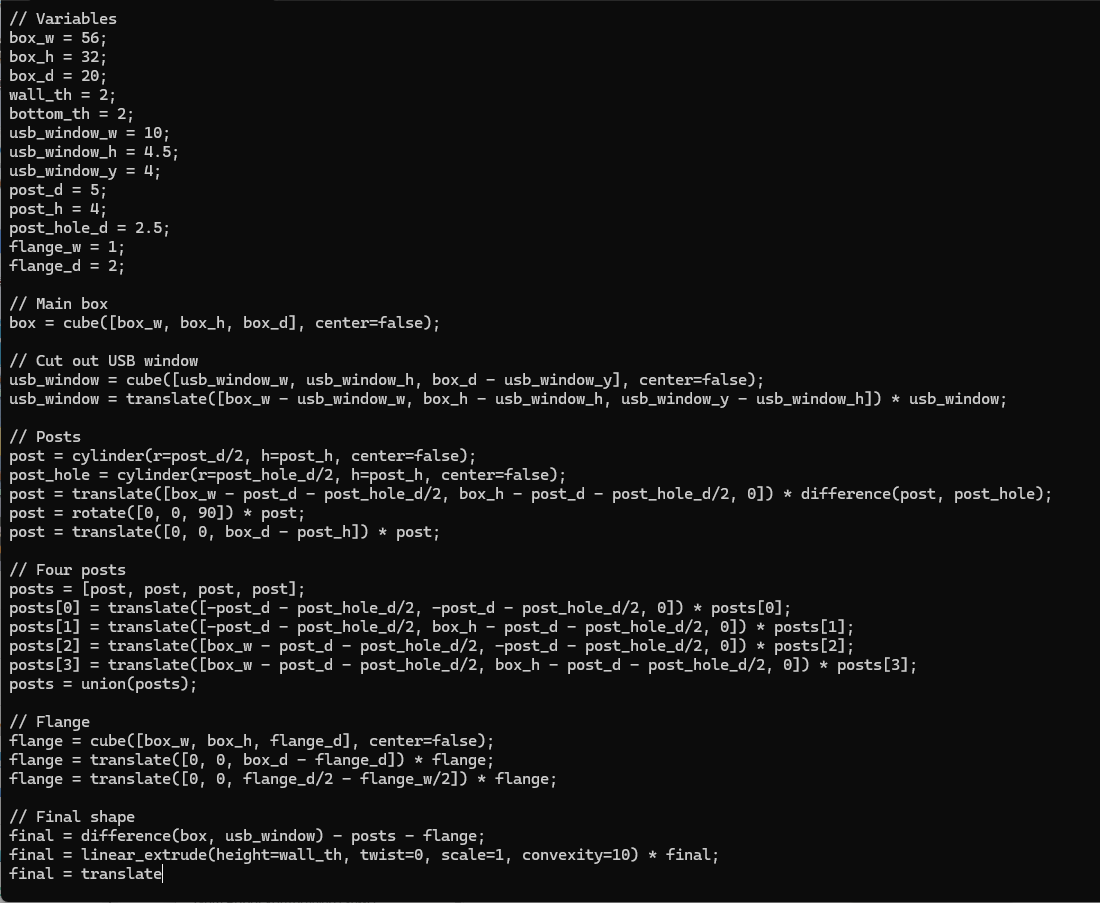
FreeCAD-версия корпуса без подсказки собралась сразу. Модель расставила стойки «по углам». Дополнение – нужно запускать промпт для верификации того, что получилось, и того, что было задано. Для сравнения – слева генерация корпуса по скрипту в OpenSCAD, справа – в FreeCAD.
Про апгрейд
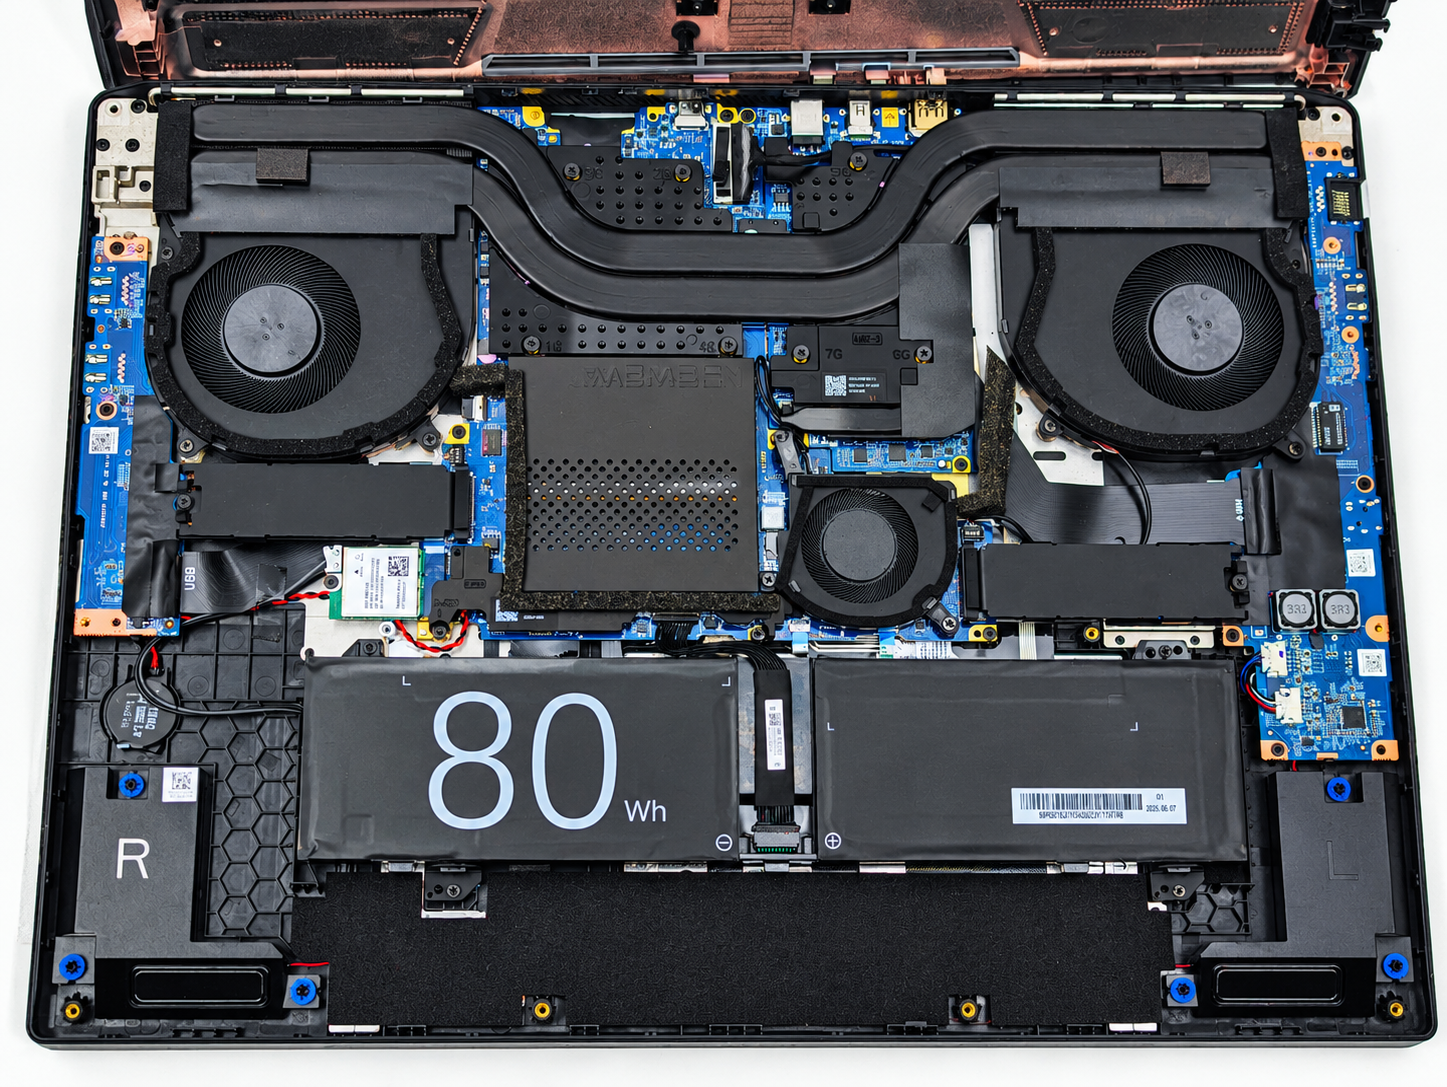
Пара слов про аппаратную платформу. Здесь есть массивное охлаждение – несколько тепловых трубок, три турбинки. Память и накопители под радиаторами.
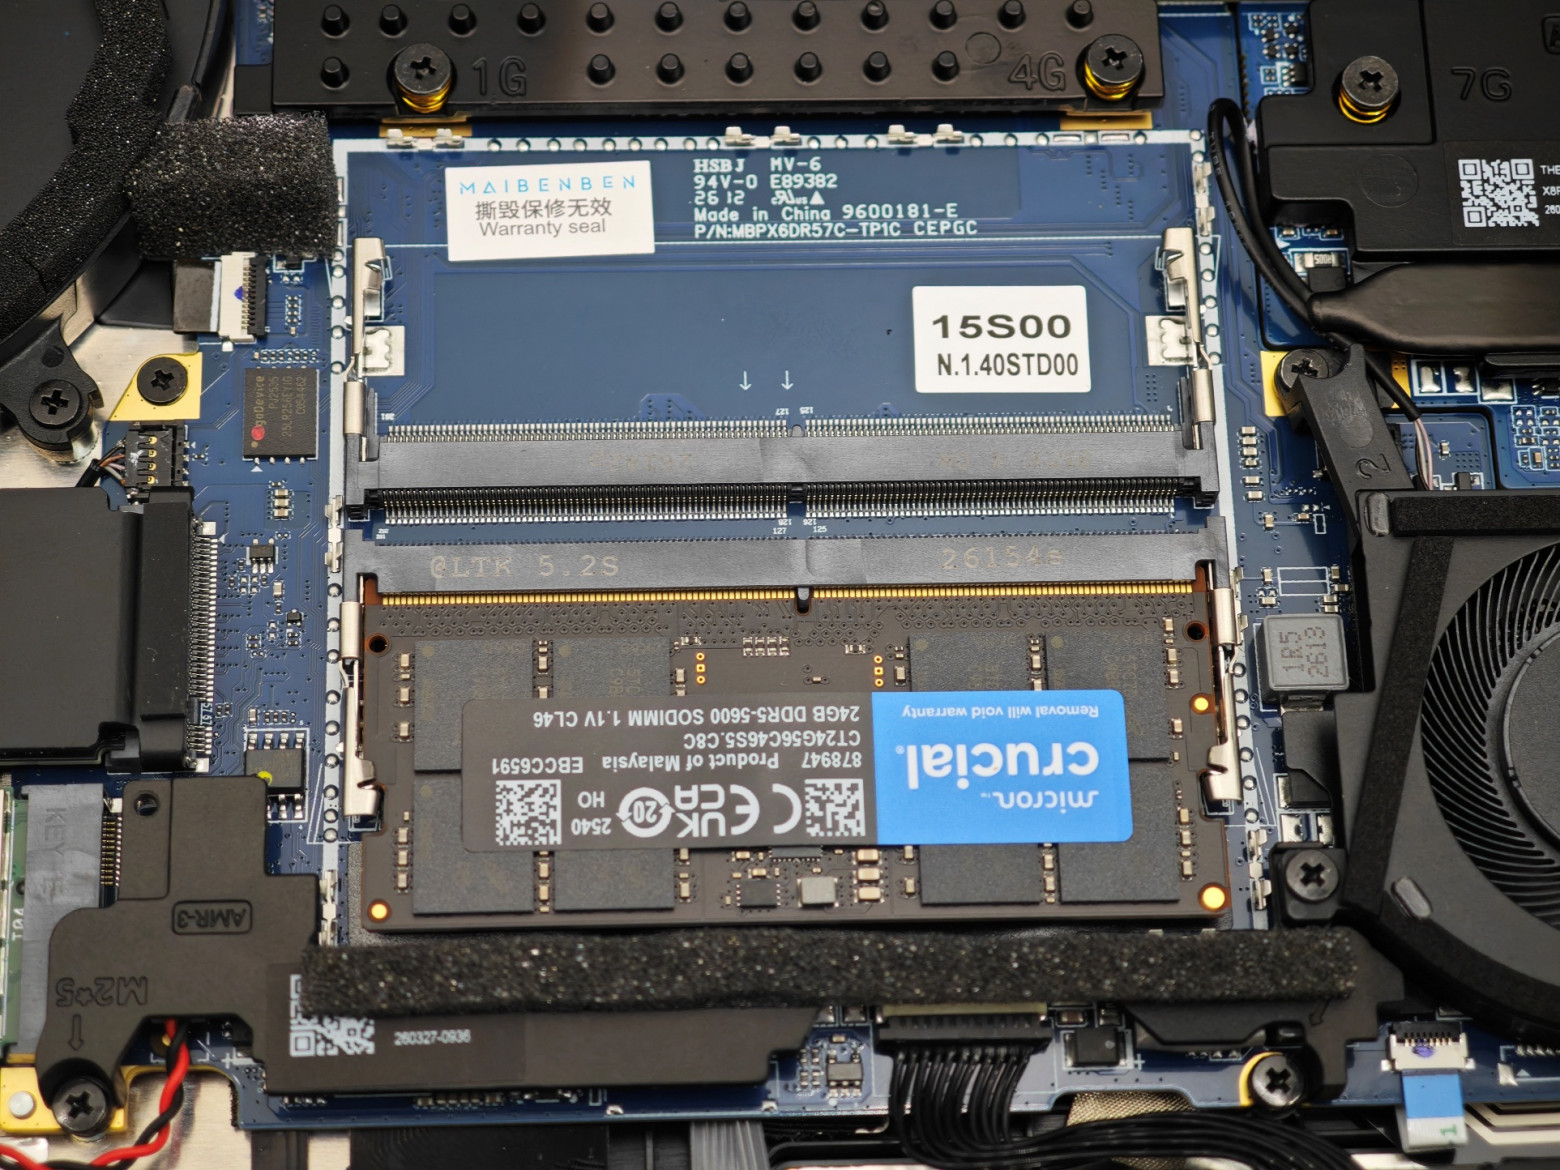
Стоит отметить, что оперативная память установлена в виде одной планки, то есть можно найти и установить еще одну такую же на 24 Гб, что дает уже 48 Гб и позволяет запускать объемные модели без квантования. Для игр этого хватает с запасом. Что уже сделал – установил дополнительный SSD для хранения моделей и проектов.
Про нагрев
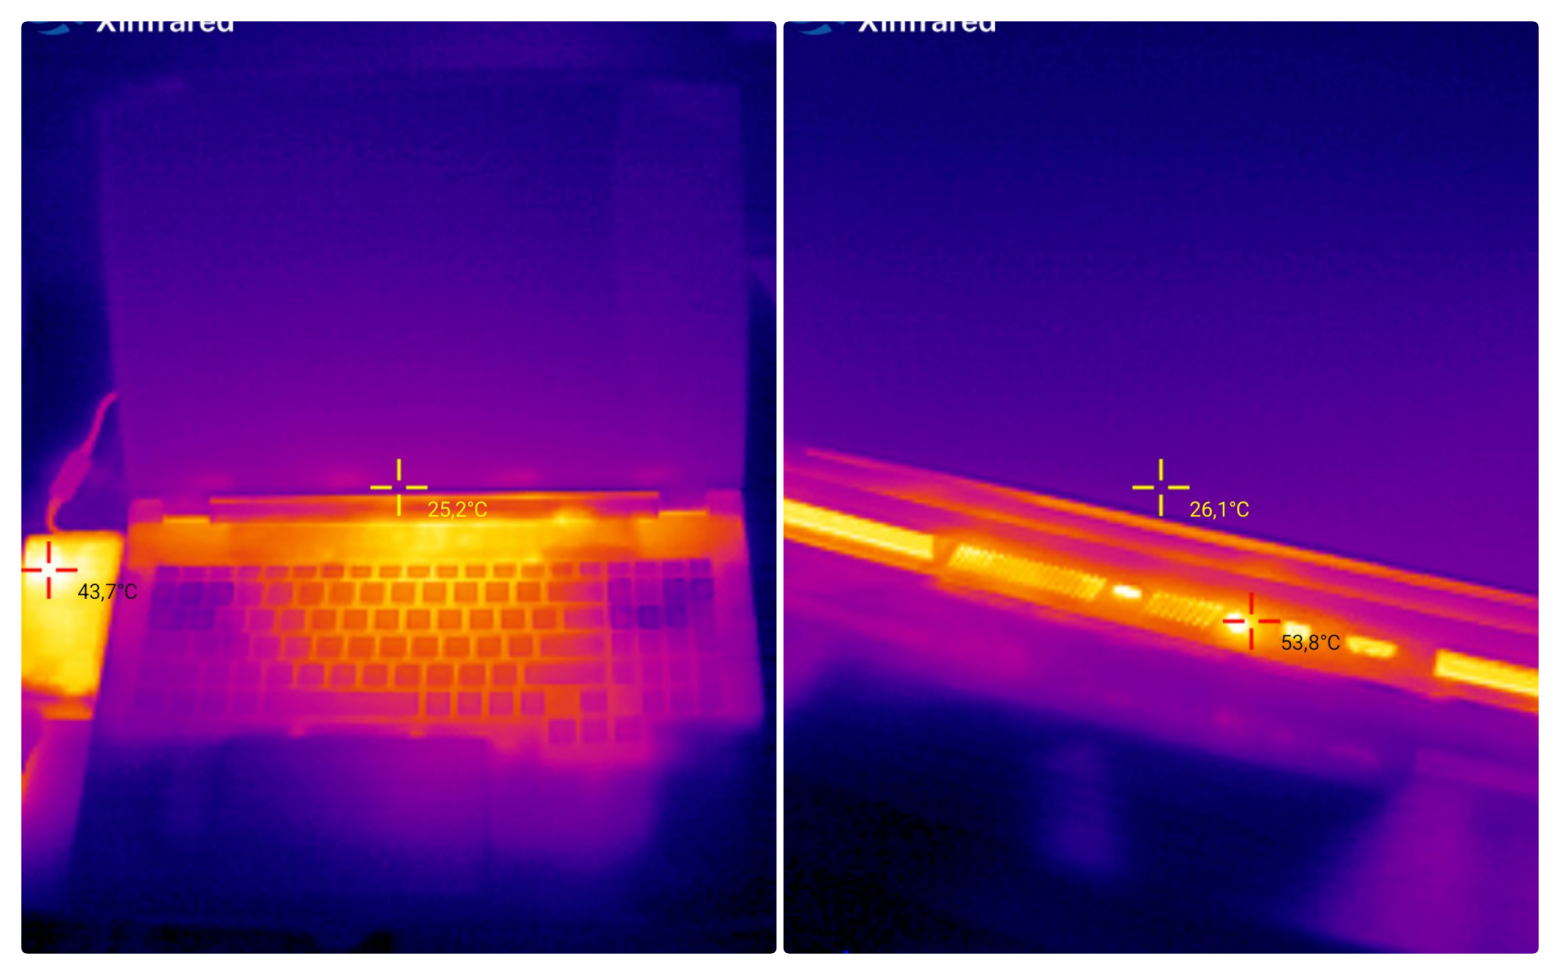
При генерации особо не греется, максимально было 70-80 градусов на процессоре, задняя панель греется в районе 50-55 градусов, а вот клавиатура и корпус более или менее холодные. Даже не обязательно иметь подставку с вентиляторами. Соответственно, троттлинга здесь нет, перегрева нет, работает штатно (пробовал генерацию несколько часов подряд).
Выводы
Локальный вайбкодинг на ноутбуке с 8 ГБ видеопамяти уже реален. Облачные модели пока умнее, зато вот так локально никто не видит ваших чертежей и никто не заблокирует подписку. Strata позволяет запустить модель, которая формально в такой ноутбук не помещается. Небольшие модели в Q4–Q5 справляются с простыми задачами (прошивки, простенькие корпуса, простенькие 3д модели) и с работой через MCP, но требуют подробного ТЗ и проверки каждого шага (вот тут главное самому не лениться или подобрать рабочие промпты). Модель 27B в Q4_K_M занимает около 16 ГБ, в IQ2_XXS уже около 7 ГБ, то есть целиком влезает в 8 ГБ VRAM (выносите экспертов в системную RAM). Например, в llama.cpp параметр --n-cpu-moe оставляет на видеокарте внимание и общие слои, а экспертов отдаёт процессору: так Qwen3-Coder-30B-A3B живёт и на 8 ГБ VRAM.
А вы уже программируете с локальными моделями или пока остаётесь на подписке?
Автор: Lexus08

