


В программный продукт наряду с собственным кодом попадает и сторонний код через зависимости, которые могут содержать уязвимости и накладывать лицензионные ограничения. Чтобы разобраться в таком наследстве, используется документ с названиями, версиями компонентов и связями между ними. Для него есть название – Software Bill of Materials (SBOM), или перечень программных компонентов (ППК). По этому перечню разработчик может быстро найти библиотеки с известными уязвимостями в своих приложениях. Команда CodeScoring часто работает с этим форматом, так как мы разрабатываем собственное решение для композиционного анализа ПО (Software Composition Analysis, или SCA).
Разработчики могут взять готовую модель машинного обучения в открытом доступе, дообучить её на своих данных и уменьшить точность весов для запуска на машинах послабее. В их продукт таким образом попадёт уже производная модель. Чтобы разобраться в её происхождении, понадобится знать исходную модель, данные и выполненные преобразования.
Для этого были введены понятия MLBOM и AIBOM, которыми обозначают документы с составом моделей и систем, использующих искусственный интеллект. В этой статье мы разберёмся, что за ними стоит, чем отличаются эти названия и какие сведения для таких документов можно собрать автоматически.
Как к стандартному перечню компонентов добавились модели и данные
Для обмена сведениями о составе ПО между инструментами изначально появился SPDX – стандарт описания состава ПО, лицензий и отношений между компонентами. Работу над его спецификацией начали в 2010 году, а в 2011 году выпустили версию 1.0 для описания пакетов. В последующих версиях появились связи между несколькими пакетами и файлами. Так можно было передать получателю продукта сведения о заимствованиях в форме, пригодной для автоматической обработки.
Другой стандарт, CycloneDX, развивался с акцентом на задачи безопасности. Его первая версия вышла в 2018 году. Чтобы искать известные уязвимости и разбирать зависимости, требовалось передавать сведения о компонентах, их версиях и отношениях. По мере развития стандарта в нём появлялись способы описывать происхождение компонентов, внешние сервисы и полноту состава.
В области машинного обучения в это же время пытались решить другой вопрос – откуда берутся данные для обучения модели? Авторы работы Datasheets for Datasets, опубликованной в марте 2018 года, предложили сопровождать наборы данных описанием их состава, происхождения, обработки и рекомендуемого использования.
Осенью того же года появилось исследование Model Cards for Model Reporting. Его авторы предложили сопровождать модель карточкой – документом с описанием её назначения, результатов оценки и ограничений применения.
Эти два подхода развивались параллельно. SBOM помогал учитывать состав поставки, а документация ML позволяла понимать свойства данных и моделей. Когда обученные модели стали переиспользовать как самостоятельные компоненты (в том числе в open source), получателям понадобилось знать и состав поставки, и то, как модель обучали и оценивали. Для этого есть несколько причин. Во-первых, под одним именем могут распространяться разные ревизии и производные модели. Во-вторых, для повторного запуска нужны те же веса и настройки, что и у оригинальной модели. Наконец, для проверки сообщения поставщика о проблеме или уязвимости в модели нужно установить, какая именно версия попала в продукт – так же, как и с зависимостями программного обеспечения.
В июне 2023 года произошло ключевое событие – CycloneDX 1.5 явно включил поддержку MLBOM, а также описание процессов создания компонентов. В апреле 2024 года в SPDX 3.0 тоже появились профили для AI и датасетов. Впервые к привычному учету заимствований в продуктах добавились объекты, у которых финальный состав зависит от входных данных и процесса обучения.
Чем отличаются MLBOM и AIBOM
Machine Learning Bill of Materials, или MLBOM, описывает модель машинного обучения и связанные с ней компоненты и сведения о происхождении. В зависимости от задачи в документ могут входить данные о базовой модели, датасетах, преобразованиях, программном окружении и условиях использования. Эти сведения можно записать в CycloneDX или SPDX, чтобы вместе с моделью передать следующей команде и описание её происхождения.
Название AI Bill of Materials, или AIBOM, обычно используют для более широкого состава ИИ-системы. Помимо модели, приложение может, например, обращаться к внешнему API, извлекать документы из поискового индекса, применять системный промпт, подключать инструменты или выполнять агентный сценарий. Наглядный пример можно увидеть в документации Cisco AIBOM: инструмент учитывает агентов, MCP-серверы и другие элементы приложения.
На практике по одному названию не всегда можно понять, что окажется в документе. К примеру, OWASP AIBOM Generator формирует документ по сведениям о моделях Hugging Face, то есть решает и задачи, которые называют MLBOM. В документации CycloneDX AIBOM и MLBOM также рассматриваются вместе.
В этой статье под MLBOM будем понимать прежде всего сведения о модели, её составе и происхождении, а под AIBOM – инвентаризацию ИИ-системы в более широком смысле.
Есть еще один важный термин. Карточка модели (Model Card) – это сопроводительный документ с описанием обучения, результатов оценки и рекомендаций по использованию модели. На Hugging Face такая карточка обычно оформлена как README с описанием и метаданными модели. Когда модель включают в BOM, часть сведений из её карточки можно записать в структурированном виде. В CycloneDX для этого служит одноименный объект modelCard внутри компонента типа machine-learning-model. Запись с таким объектом может находиться и в SBOM приложения рядом с библиотеками, и в отдельном MLBOM модели.
|
Документ |
Вопрос, на который документ помогает ответить |
|
SBOM (ППК) |
Какие программные компоненты входят в выбранную поставку и как они связаны? |
|
Карточка модели (Model Card) |
Для чего модель предназначена, как её оценивали и какие ограничения известны? |
|
MLBOM |
Какая модель или её производная используется, что известно о её составе, происхождении и создании? |
|
AIBOM |
Какие модели, сервисы, конфигурации и другие ИИ-компоненты участвуют в работе приложения? |
Как связать готовую модель с её источниками
Вернёмся к абстрактной модели из вступления. Представим, что после дообучения и уменьшения точности весов команда получила свой вариант исходной модели. В MLBOM потребуется связать этот вариант с исходной моделью, датасетом и выполненными преобразованиями. ML-библиотеки и среду обучения описывают отдельно от библиотек и среды, которые понадобятся для обработки пользовательских запросов.
После нескольких дообучений может накопиться целая коллекция «последних» версий модели. Файл с названием вроде «model-final-final.gguf» многое рассказывает о переживаниях автора, но почти ничего не говорит о происхождении модели. Чтобы корректно связать дообученную модель с исходной, в MLBOM записывают идентификатор коммита репозитория с моделью и контрольную сумму выбранного файла весов. По коммиту можно найти состояние репозитория, а контрольная сумма пригодится для проверки самого файла.
Код приложения, веса и датасеты могут распространяться по разным правилам. В MLBOM стоит сохранить ссылки на лицензии и другие условия использования каждого из них, чтобы при проверке поставки не собирать эти документы заново.
Все перечисленные сведения не обязаны находиться в одном файле. Состав может связываться с другими документами по устойчивым идентификаторам. Важнее сохранить возможность пройти от поставленного артефакта к описывающим его источникам.
В модели CycloneDX для этого есть нужные поля: компоненты, сервисы, зависимости, сведения о происхождении и описание процессов создания. Модельный компонент имеет тип machine-learning-model, а связанные сведения размещаются, в частности, в modelCard, pedigree и formulation. Подробный разбор этих структур можно прочитать в руководстве по AIBOM и MLBOM.
В SPDX 3.0.1 используется другая модель представления: AIPackage описывает ИИ-приложение или обученную модель, а DatasetPackage описывает набор данных. У объектов есть собственные свойства и типизированные отношения. Если вдруг вы захотите перенести данные из CycloneDX в SPDX или обратно, то стоит проверить, что случилось со сведениями о модели и её связях. Особенно если инструмент, который будет читать документ, поддерживает только часть выбранной спецификации.
Сведения о модели и её происхождении можно записать в обоих стандартах. В таблице ниже сопоставлены основные поля и связи, которые для этого используются:
|
Объект описания |
CycloneDX 1.7 |
SPDX 3.0.1 |
|
Анализируемая модель |
Компонент с |
Объект класса AIPackage с тем же именем |
|
Источник версии |
Идентификатор модели – в |
Тот же PURL можно записать в |
|
Исходная модель |
Исходная модель описывается в |
Отдельный объект исходной модели и отношение descendantOf от производной модели к исходной |
В CycloneDX сведения о предке вложены в запись модели, а в SPDX между объектами задаётся отдельная связь. Чтобы проследить происхождение конкретной поставки, важно указать версии как производной, так и исходной модели.
Как собрать сведения о моделях
CycloneDX и SPDX позволяют описать происхождение модели. А откуда взять сведения для такого описания?
При собственном обучении команда может собрать их из файлов конфигурации, журналов экспериментов и версий данных. Для сторонней модели придётся обратиться к тому, что опубликовал поставщик. Как правило, это карточка модели.
С такими источниками работает OWASP AIBOM Generator. Он извлекает метаданные моделей Hugging Face и представляет их средствами CycloneDX. Смысл этого режима в том, чтобы сохранить сведения поставщика в форме, которую можно передать следующему инструменту или сопоставить с другими поставками.
После установки OWASP AIBOM Generator можно запустить его через командную строку. Например, для разбора BERT, модели для обработки текста, команда может выглядеть так:
python3 -m src.cli google-bert/bert-base-uncased
  --output owasp-bert.json
Генератор создаёт документы CycloneDX 1.6 и 1.7 и HTML-отчёт. Ниже приводим сокращённую запись модели из файла owasp-bert_1_7.json. В поле version сохранён короткий идентификатор коммита модели, а в licenses – её обозначенная лицензия Apache-2.0. Поле task со значением fill-mask означает, что задачей модели является восстановление пропущенных слов в тексте, modelArchitecture указывает семейство bert. В поле datasets попали два набора данных, перечисленных в карточке модели.
{
  "name": "bert-base-uncased",
  "type": "machine-learning-model",
  "version": "86b5e093",
  "licenses": [{"license": {"id": "Apache-2.0"}}],
  "modelCard": {
    "modelParameters": {
      "task": "fill-mask",
      "modelArchitecture": "bert",
      "datasets": [
        {"type": "dataset", "name": "bookcorpus"},
        {"type": "dataset", "name": "wikipedia"}
      ]
    }
  }
}
Инструмент cdxgen, в свою очередь, охватывает как модельные артефакты, так и код приложения. В нём есть отдельная команда aibom для работы со ссылками Hugging Face, локальными модельными файлами, конфигурацией промптов и так далее. В исходниках cdxgen ищет обращения к моделям, а из опубликованных метаданных собирает сведения об указанной модели. Эти источники могут дополнять друг друга.
После развёртывания можно узнать, какие модели и среды запуска указаны в конфигурации приложения. Например, k8s-aibom (контроллер инвентаризации ИИ-нагрузок Kubernetes) читает конфигурацию объектов и состояние запущенных контейнеров. Если k8s-aibom прочитал имя модели в параметрах запуска контейнера, то в BOM он укажет и само имя, и источник этих сведений.
Один и тот же инструмент получит из кода приложения и из карточки модели разные сведения. Далее в статье мы проверим, насколько существенной разница может быть на практике.
Что попадает в готовый MLBOM
Руководство CycloneDX рассматривает MLBOM как описание конкретной модели. Её помещают в metadata.component и задают тип machine-learning-model. Общие поля стандартного SBOM сохраняются: имя, версия, идентификаторы, лицензия и контрольные суммы файлов. Если модель входит в BOM приложения, то её описывают среди его компонентов.
В modelCard описывается задача модели, архитектура, подход к обучению, результаты оценки и ограничения применения. В modelCard.modelParameters.datasets сохраняются описания обучающих и оценочных наборов или ссылки на отдельные компоненты типа data. В pedigree фиксируется происхождение от базовых моделей, а через formulation можно описать процесс обучения. Большинство этих сведений можно собрать существующими инструментами из карточек моделей, конфигураций и файлов репозитория.
Но в реальности автоматическая генерация MLBOM может не давать нужных результатов с первой попытки. Для небольшого эксперимента возьмём nanoGPT, популярный открытый проект обучения GPT-моделей. Мы выбрали одну ревизию исходников и запустили команду aibom из cdxgen 13.5.0, чтобы собрать сведения о моделях из репозитория:
aibom nanoGPT --spec-version 1.7 --no-install-deps --no-cache -o nanogpt.cdx.jsoncdxgen включил в перечень компонентов два файла Jupyter Notebook (.ipynb) из репозитория nanoGPT. Также в BOM оказалась и модель с именем 3.46.
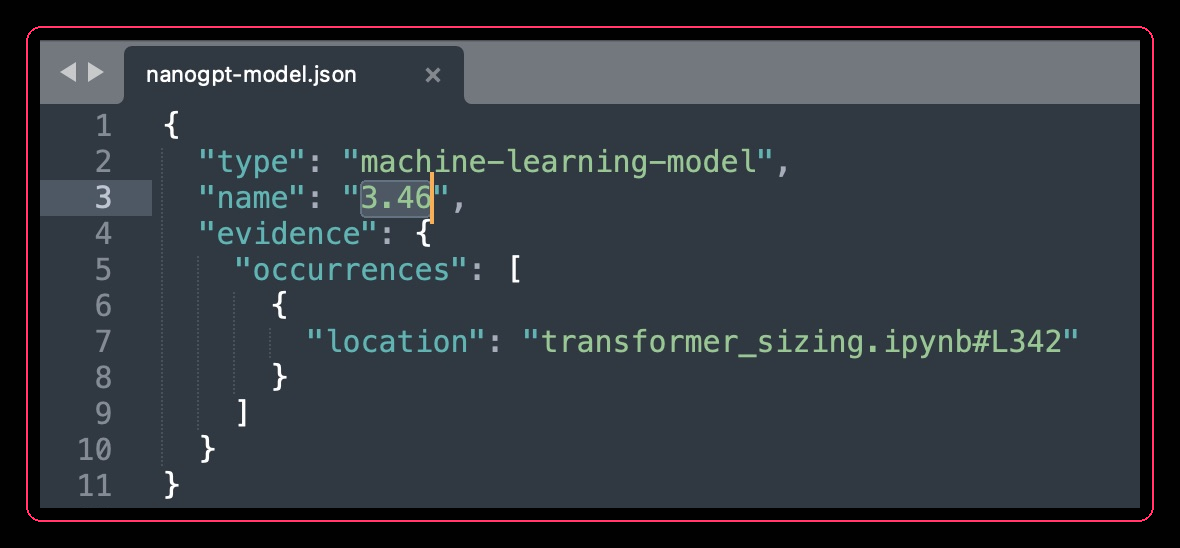
Откуда взялось такое имя? Ссылка в BOM ведёт к результату расчёта времени обучения: “time needed to train the model: 3.46 days”. Инструмент принял число дней за имя модели, так неудачно сработала эвристика поиска имени модели в тексте. При этом в коде nanoGPT есть загрузка модели GPT-2, но её выбор зависит от конфигурации запуска. В полученном BOM конкретной версии GPT-2 нет.
Для сравнения мы передали той же команде идентификатор компактной модели SmolLM2-135M-Instruct в формате PURL (Package URL) с закреплённым коммитом. В этом запуске cdxgen собирал опубликованные метаданные модели. Теперь он сохранил идентификатор и ревизию, объявленную лицензию Apache-2.0, задачу генерации текста и архитектуру модели. В документ попала и связь с базовой моделью SmolLM2-135M, указанной в исходной карточке без ревизии.
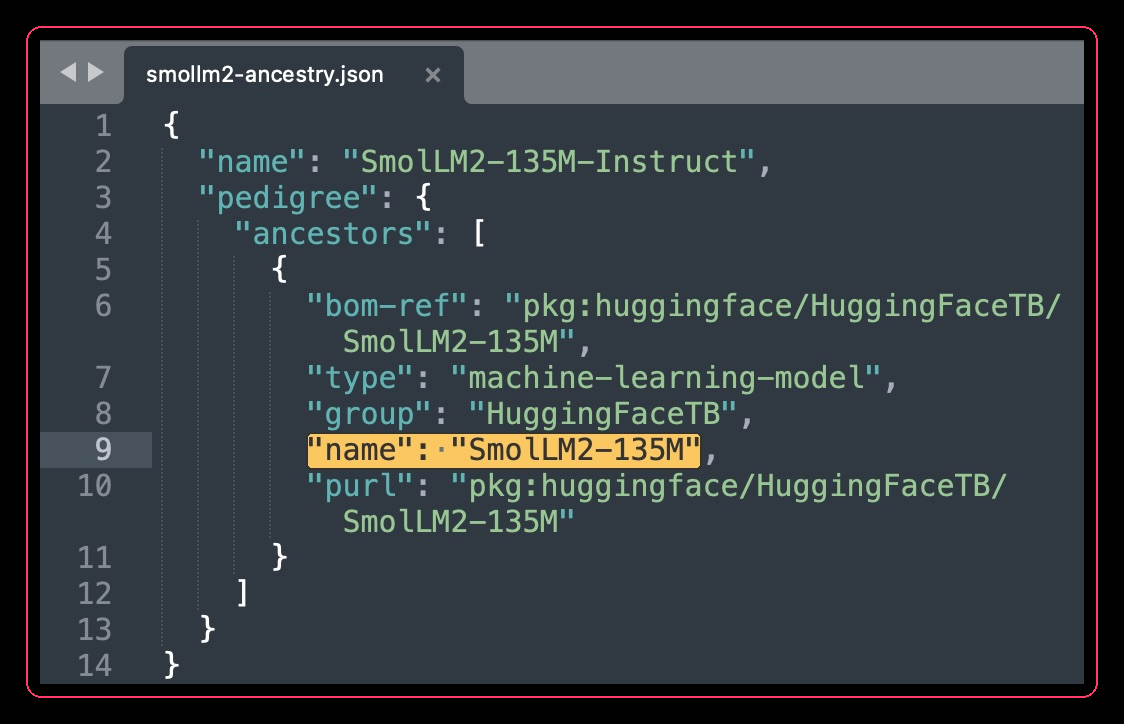
При обращении по PURL cdxgen берёт датасеты из структурированных полей карточки. В тексте карточки SmolLM2 есть ссылки на наборы данных, но в служебном блоке в начале README они не перечислены. Для того чтобы они появились в BOM, понадобилось явно указать два набора в поле datasets локальной копии карточки.
При этом оба документа прошли встроенную и независимую проверку по схеме CycloneDX 1.7, то есть структура и поля оказались допустимыми. К сожалению, найти потерянный датасет валидатор за пользователя не сможет. В первом случае нам пришлось отсеять ложную модель, а во втором – выяснить, каких сведений не было во входных метаданных. Поэтому готовый BOM всегда нужно сверять с источниками, прежде чем использовать его для поиска уязвимостей или других задач.
Как использовать эти сведения при проверке продукта
В композиционном анализе ПО перечень компонентов нужен для инвентаризации и обогащения данных о продукте. Когда приходит сообщение об уязвимости, изменении условий использования или проблеме у поставщика, команда может определить, какие её системы затронуты и где они используются. Для моделей сохраняется тот же принцип, но характер связей становится посложнее.
Предположим, поставщик отозвал определённую ревизию модели или сообщил о подмене артефакта. Идентификаторы и хеши в таком случае позволяют искать его в поставках, а история происхождения помогает найти производные, которые требуют проверки. Но если в учёте осталось только имя семейства, то отбор получится шире и часть работы придётся выполнять вручную.
В нашем примере по версии модели SmolLM2 можно искать продукты, в которых используется эта же версия. А если проблема касается базовой SmolLM2-135M, то проверять придётся и её производные. Но версия базы в BOM не указана, поэтому список затронутых продуктов непонятен.
С уязвимой библиотекой сначала нужно выяснить, где она использовалась. Если уязвимая библиотека используется в приложении, которое запускает модель и обрабатывает запросы пользователей, то нужно проверить, можно ли в этом приложении воспользоваться уязвимостью. Если библиотека участвовала только в обучении, то одной такой связи недостаточно, чтобы объявить уязвимыми полученные веса.
Отдельно нужно проверять безопасность загрузки модельных файлов. Например, формат pickle допускает выполнение кода при десериализации. Этот механизм подробно разбирает документация Hugging Face и явно предупреждает о потенциальной опасности загрузки таких файлов. Формат файла подсказывает, какие меры нужны при его загрузке, а вот чтобы найти скрытую реакцию на определённые запросы, придётся проверять поведение самой модели.
По ссылкам из BOM можно также открыть лицензии кода, весов и данных. Дальше стоит сопоставить их требования с тем, как команда собирается использовать модель в продукте. Иначе использование модели может грозить неприятными юридическими последствиями.
Для модели, доступной только через внешний API, возможности проверки будут не такие широкие. Команда может учитывать провайдера, адрес сервиса, объявленный идентификатор модели, конфигурацию обращения и условия использования. Получить хеш внутренних весов или проверить полную цепочку обучения без участия провайдера она не сможет, это нужно учитывать.
При составлении SBOM в CodeScoring мы держим в уме три базовые проверки: соответствует ли документ спецификации, достаточно ли сведений о проверяемом объекте и чем они подтверждены. Как видно из примеров выше, для MLBOM эти правила так же актуальны.
Кому пригодится MLBOM и с чего начать
MLBOM пригодится разработчикам, которым нужно проследить происхождение модели в своей сборке, и командам безопасности, которые ищут затронутые продукты после сообщения о проблеме. В документе можно сохранить версии, исходные модели и преобразования, чтобы обеим командам не восстанавливать эту цепочку заново.
Для составления первого MLBOM стоит выбрать одну модель из конкретной поставки и проследить её до источника. Пусть инструмент соберёт доступные сведения, а команда вручную проверит находки и уточнит недостающую информацию у владельцев обучения и сборки. Если данные закрыты, то в распространяемом документе можно оставить разрешённый идентификатор и ссылку на описание с контролем доступа. Передавать сам обучающий корпус не обязательно.
После этой проверки важно сохранить документ вместе с версией продукта и обновлять его при изменении модели. Иначе при следующем расследовании придётся заново выяснять, к каким весам относятся аккуратно заполненные поля.
Мы бы оценивали результат по тому, сможет ли другой участник найти по его записям использованную модель и проверить её связь с поставкой. В рабочем процессе конкретной компании эти связи стоит сохранить один раз и передавать дальше вместе с компонентом. Тогда после сообщения о проблеме у поставщика можно будет приступать к поиску конкретных затронутых продуктов, не запуская расследование происхождения с нуля.
Автор: amaksimovv

