


Представьте парк из более чем 700 экземпляров СУБД. Классический сценарий: приходит оповещение о высокой нагрузке, администратор начинает вручную собирать метрики с десятков дашбордов в Prometheus/Grafana, анализировать журналы, ища ошибки и медленные запросы, пытаться сложить разрозненные данные в единую картину, сформулировать проблему и создать задачу на исправление.
На это уходит много ресурсов, а ценное время на реакцию уходит.
Наша команда решила автоматизировать этот цикл, создав систему, которая не просто собирает данные, но и анализирует их, генерирует контекст и сама запускает процессы по созданию заявки.
С вами Станислав Епишин и Константин Резник из команды «R4C.Support.Всадники апокалипсиса» в СберТехе. В этой статье покажем, как мы соединили Prometheus, Pipeliner (CI/CD-оркестратор, разработан в СберТехе, аналог Jenkins), TaskTracker (система управления задачами, разработана в СберТехе, аналог Jira) и GigaChat (продукт Сбера) через AI Hub API (анализ) в единый механизм.
Получилось два ключевых инструмента:
-
Monitoring_Checker_TT: система оперативного реагирования с автоматическим созданием заявок;
-
Analyze_Pangolin_AI: ИИ-отчёт для ускоренной диагностики Platform V Pangolin — реляционной СУБД от СберТеха, PostgreSQL с нашими доработками под требования к усиленной безопасности и производительности.
Monitoring_Checker_TT: связываем Prometheus, Pipeliner и TaskTracker для автоматического создания заявок
В основе нашей системы автоматического реагирования Monitoring_Checker_TT лежит серия заданий в Pipeliner. Задания по расписанию собирают метрики через Prometheus API напрямую, используя PromQL-запросы без промежуточного слоя Grafana, и автоматически создают заявки в TaskTracker.
Рассмотрим ключевые компоненты этой интеграции.
Специализированный экспортёр для мониторинга СУБД
Для контроля состояния СУБД Pangolin мы использовали наработки из предыдущей статьи про pangolin_exporter, на основе которых создали stdguard_pgexporter — кастомный экспортёр. Репозиторий проекта доступен по ссылке. Экспортёр работает, выполняя bash-команды и SQL-запросы, описанные в конфигурационных файлах stdguard_system.yaml и stdguard_queries.yaml. С их помощью он каждые 15 минут собирает критически важные метрики, в том числе из журналов СУБД.
Например, так выглядят команды для мониторинга блокировок и сбора критических ошибок:
# Мониторинг блокировок и дедлоков
grep -E -i -A 10 -B 10 'deadlock detected|lock timeout|deadlock will be retried|process [0-9]+ blocked by|waiting for' '{latest_log}'
# Сбор критических ошибок
grep -E -i -A 10 -B 10 'ERROR:|FATAL:|PANIC:' '{latest_log}'
Эти команды преобразуют текстовые журналы в Prometheus-метрики. Вот как выглядит фрагмент точки подключения экспортёра /metrics :
# HELP postgres_log_errors_count Count of ERROR/FATAL/PANIC messages in /pgerrorlogs/
# TYPE postgres_log_errors_count gauge
postgres_log_errors_count{log_file="default"} 1

# HELP postgres_log_file_count Number of log files in /pgerrorlogs/
# TYPE postgres_log_file_count gauge
postgres_log_file_count{directory="default"} 4

# HELP postgres_log_lock_errors_count Count of DEADLOCK/LOCK/BLOCKED/WAITING messages in /pgerrorlogs/
# TYPE postgres_log_lock_errors_count gauge
postgres_log_lock_errors_count{log_file="default"} 0

# HELP postgres_log_size_bytes Size of log file in /pgerrorlogs/ in bytes
# TYPE postgres_log_size_bytes gauge
postgres_log_size_bytes{log_file="default"} 6.165924e+06
Конфигурационные файлы позволяют собирать не только журналы, но и множество других метрик:
-
stdguard_queries.yaml содержит сложные SQL-запросы для контроля соответствия внутренним стандартам: проверка имён объектов, наличие комментариев, разделение таблиц и индексов по табличным пространствам, выявление внешних ключей без индексов и многое другое.
-
stdguard_system.yaml описывает bash-команды для сбора системных данных: количество процессов СУБД Pangolin, размеры журналов, частота блокировок и ошибок.
Вместе они образуют единый инструмент stdguard_pgexporter, который предоставляет единую точку сбора как внутренних показателей БД, так и внешних системных параметров.
Примеры метрик из stdguard_queries:
# Проверка использования кавычек в именах объектов
object_mixcase{database="app_db", object_type="table", object_name="public.OrderItems", issue="Запрещён верхний регистр"} 1

# Контроль наличия комментариев к таблицам и полям
object_comments{database="app_db", object_type="field", object_name="public.users.created_at", issue="отсутствие комментария"} 1

# Разделение таблиц и индексов по табличным пространствам
wrong_tablespace_names{database="app_db", object_type="index", object_name="public.idx_orders_dt", tablespace="pg_default", issue="В имени табличного пространства отсутствует 'idx'"} 1

# Количество запущенных процессов СУБД Pangolin (системная метрика)
pangolin_process_count{service="pangolin"} 12

# Размер последнего лог-файла в байтах
postgres_log06_size_bytes{log_file="postgresql-2026-02-13.log"} 6165924
Эти метрики затем используются в заданиях Monitoring_Checker_TT для создания заявок (например, при превышении порога ошибок в жерналах) и в отчёте Analyze_Pangolin_AI как исходные данные для ИИ-анализа. Гибкость конфигурации (параметр master: true/false, глобальные исключения схем, поддержка меток) позволяет адаптировать сбор под любую топологию кластера — от отдельных экземпляров до крупных мультимастерных конфигураций.
Таким образом, stdguard_pgexporter выступает фундаментом автоматизированного мониторинга, обеспечивая поставку качественных, структурированных данных для всех последующих этапов — от оперативного реагирования до ИИ-диагностики.
Прямой доступ к данным через Prometheus API
В отличие от традиционного подхода с визуализацией в Grafana наша система работает напрямую с Prometheus API. Это позволяет:
-
получать данные в структурированном формате JSON для дальнейшей программной обработки;
-
выполнять сложные агрегации на стороне Prometheus с помощью PromQL;
-
избежать накладных расходов на рендеринг графиков и дашбордов;
-
интегрировать данные напрямую в скрипты обработки.
Пример работы задания Monitoring_pg_usage_conn (скрипт monitoring_pg_usage_conn.py):
# Прямой PromQL-запрос к Prometheus API для получения использования соединений
promql_query = f"""clamp(
    100 * sum by (job, instance) (
        pg_stat_activity_count{{
        job=~'{prometheus_target_job_name}',
        state=~'active|idle|idle in transaction'
    }}
    ) / avg by (job, instance) (
        pg_settings_max_connections{{
        job=~'{prometheus_target_job_name}',
    }}
    ),
    0,
    100
)"""

# Получение данных напрямую через Prometheus HTTP API
def get_from_prometheus(promql_query: str, metric_name: Optional[str] = None):
    response = requests.get(
        f"{prometheus_url}/api/v1/query",
        params={'query': promql_query},
        verify=False
    )
    response.raise_for_status()
    # Обработка JSON-ответа напрямую
    for result in response.json()['data']['result']:
        entry = {
            'solution_stend': result['metric']['job'],
            'instance': result['metric']['instance'],
            metric_name: float(result['value'][1])
        }
        data_hosts.append(entry)
    return pd.DataFrame(data_hosts), False
Скрипт анализирует полученные данные, фильтрует экземпляры, превышающие пороговое значение подключений, и готовит данные для создания заявок.
Интеграция с TaskTracker через Python-клиент
Для работы с TaskTracker мы разработали Python-клиент (task_tracker.py), который обеспечивает прямую интеграцию без промежуточных слоев.
Аутентификация и управление сессией:
class SberTrackClient:
    def __init__(self, login, password, space):
        self.login = login
        self.password = password
        self.space = space
        self.token = None
        self.session = None

    def connect(self):
        """Установка соединения с TaskTracker"""
        self.token = self.get_token()
        if not self.token:
            return False
        self.session = self.create_session(self.token)
        return self.session is not None
Создание заявок:
def create_ticket(self, issue_dict, space):
    """Создание новой заявки"""
    url_create = f"{self.sber_track_server}{self.url_create_unit.format(suit=f'task_{space.lower()}')}"
    return self.url_query_post(url_create, data=issue_dict)
Поиск активных заявок для избегания дублирования:
# Проверка существующих заявок перед созданием новых
response = task_tracker_client.found_ticket_tql(
    "space ="CORESUP" AND label = "MONITORING_PG_USAGE_CONN" "
    "AND workflow_status NOT IN ("done", "closed", "resolved")"
)
Автоматическое создание заявок с полным контекстом
Скрипт в Pipeliner формирует структурированные заявки:
# Формирование данных для заявки
summaryText = f"{row['instance']} {str(row['solution_stend']).upper()} лимит подключений max_connections достигнут."
ticketText = f"""n<b>Сервер: {row['instance']} </b>
Solution: {row['solution_stend']}
Статус: Критический
Текущее значение: {row['PGUsageConn']}%
Порог срабатывания: > {totalUsageConnections}%
Описание: Скоро будет исчерпан лимит подключений max_connections.
Все обычные слоты заняты, оставшиеся зарезервированы только для администраторов.
При достижении 100% новые подключения приложений отклоняются.
Время проверки: {time_incident}."""

# Создание заявки
id_new_issue = create_ticket(row['solution_stend'], 'CORESUP', summaryText, ticketText)
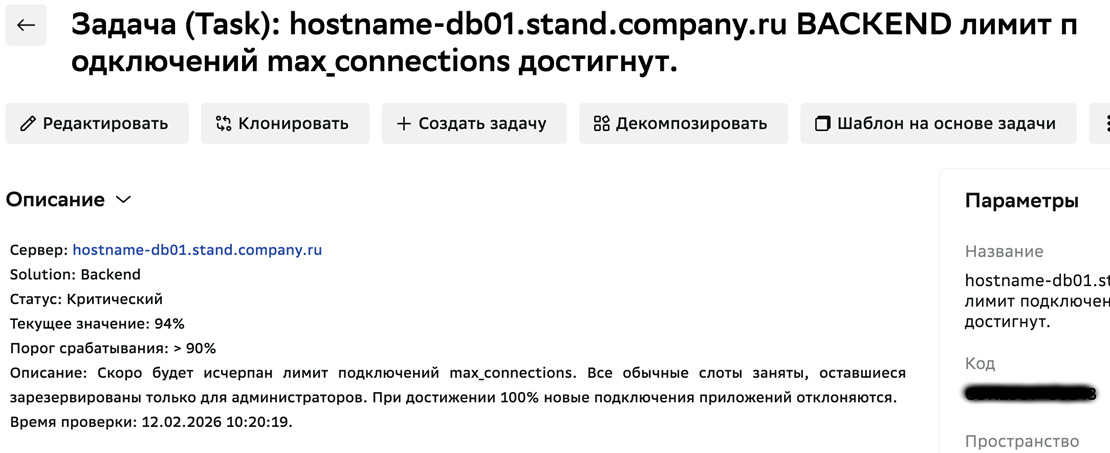
Пример из жизни, 94% подключений. 10:20 утра. На одном из ключевых стендов резко выросла нагрузка. Задание Monitoring_pg_usage_conn отработало по расписанию, получило свежие метрики из Prometheus и обнаружило, что экземпляр hostname-db01.stand.company.ru (данные обезличены) уже использует 94% от лимита max_connections. Порог в 90% превышен и система мгновенно среагировала.
Через две минуты в TaskTracker упала новая заявка:
А ответственным на почту ушло письмо:
Создана заявка по инциденту: https://portal.company.ru/swtr/units/all/unit/CORESUP-36143
Сервер: hostname-db01.stand.company.ru
Solution: Platform V Backend IFT
Статус: Критический
Текущее значение: 94%
Порог срабатывания: > 90%
Описание: Скоро будет исчерпан лимит подключений max_connections.
Все обычные слоты заняты, оставшиеся зарезервированы только для администраторов.
При достижении 100% новые подключения приложений отклоняются.
Время проверки: 12.02.2026 10:20:19.
До внедрения Monitoring_Checker_TT такой инцидент заметили бы только после того, как приложения начали бы падать с ошибками «too many clients». Администратору пришлось бы вручную лезть на сервер, смотреть журналы, собирать статистику и уже потом создавать задачу. Теперь же заявка пришла сама, с полным контекстом. Осталось лишь проанализировать, почему приложения наплодили столько подключений, и накатить фикс.
Преимущества подхода Monitoring_Checker_TT
-
Полная автоматизация: от сбора метрик Prometheus до создания заявки в TaskTracker.
-
Интеллектуальная фильтрация: проверка на дубликаты перед созданием новых заявок.
-
Богатый контекст: каждая заявка содержит ссылки на сервер, стенд, метрики и сборку мониторинга.
-
Сокращение времени реакции: заявка формируется в среднем за 2–3 минуты после возникновения инцидента.
-
Масштабируемость: система обслуживает сотни экземпляров СУБД Pangolin без ручного вмешательства.
Такой подход позволяет перейти от пассивного мониторинга к активному управлению инцидентами, где проблемы не просто обнаруживаются, но автоматически превращаются в задачи с чётким контекстом и рекомендациями по исправлению.
Analyze_Pangolin_AI: ИИ-отчёт для высокоуровневой диагностики СУБД Pangolin
Задача: быстро, без погружения в тонны графиков, понять общее состояние парка из 700 экземпляров СУБД, где есть проблемы с процессором, памятью и дисками, какие ошибки сыпятся в журналы.
Решение: проект Analyze_Pangolin_AI — ежедневный (или по запросу) отчёт, который агрегирует данные Prometheus через прямые PromQL-запросы и анализирует их через GigaChat (продукт ПАО Сбер).
Интеграция с GigaChat через AI Hub API
Для работы с LLM мы разработали универсальный клиент llm_client.py, который поддерживает различные модели через единый интерфейс:
class LLMClient:
    def __init__(self):
        config = {
            'model_name': 'GigaChat-2-Max',
            'base_url': 'https://api.ai.company.ru/openai/v1',
            'temperature': 0.1,
            'max_tokens': 100000,
            'max_retries': 10
        }
        self.config = config
Ключевые настройки модели:
-
temperature: 0.1: низкая «температура» обеспечивает детерминированные и консервативные ответы. В контексте мониторинга БД это критически важно: нам нужны точные, воспроизводимые рекомендации, а не креативные предположения. Значение0.1минимизирует случайность в ответах, что повышает надёжность системы, как компромисс между детерминированностью и гибкостью, но для повышения предсказуемости можно использовать 0. -
max_tokens: 100000позволяет обрабатывать большие объёмы данных (метрики, логи, SQL-запросы). -
max_retries: 10: устойчивость к временным сбоям сети или API.
def _ask(self, messages: List, file_path: Optional[str] = None):
    try:
        if file_path:
            file_content = self._read_file_content(file_path)
            if isinstance(messages[-1], HumanMessage):
                messages[-1].content += f"nnДанные из файла:n{file_content}"
        # Создание клиента для работы с AI Hub API
        client_with_verify = httpx.Client(verify=False, timeout=200)
        API_KEY = self._read_api_token()
        llm = ChatOpenAI(
            model = self.config['model_name'],
            base_url = self.config['base_url'],
            api_key = API_KEY,
            http_client = client_with_verify,
            max_retries = self.config['max_retries'],
        )
        response = llm.invoke(messages)
        return response
Клиент поддерживает различные модели (GigaChat-2-Max, Qwen, DeepSeek) и позволяет анализировать как текстовые промпты, так и содержимое файлов.
Генератор отчётов Analyze_Pangolin_AI с ИИ-анализом
Основной модуль report_generator.py проекта Analyze_Pangolin_AI создаёт HTML-отчёты с интегрированным ИИ-анализом.
Анализ метрик ресурсов:
def create_report_html(self, TARGET_HOST, pg_role, df_top, df_query, output_path, bOnlyLog):
    # Анализ использования ресурсов через ИИ
    if bAI:
        messages = [
            SystemMessage(content="Ты являешься специалистом по СУБД Pangolin..."),
            HumanMessage(content=f"Проанализируй метрики: CPU avg: {cpu_avg}%, RAM avg: {ram_avg}%, HDD avg: {hdd_avg}%...")
        ]
        response = llm_client._ask(messages)
        # Добавление AI-анализа в отчёт
        html_template += f"""
        <div class="ai-analysis-section">
            <div class="ai-analysis-header">🤖 AI Анализ использования ресурсов</div>
            <div class="ai-analysis-content">{html.escape(response.content)}</div>
        </div>
        """
Анализ логов БД через SSH:
def _quick_log_analysis(self, TARGET_HOST, bAI):
    # Сбор логов через SSH
    analysis_cmd = f"grep -E -i -A 10 -B 10 'ERROR:|FATAL:|PANIC:' '{latest_log}'"
    stdin, stdout, stderr = ssh_client.exec_command(analysis_cmd)
    log_text_err_ai = stdout.read().decode().strip()

    # AI-анализ ошибок
    if bAI and log_text_err_ai:
        messages = [
            SystemMessage(content="Ты эксперт по анализу лог-файлов СУБД Pangolin..."),
            HumanMessage(content=f"Проанализируй ошибки из лога:n{log_text_err_ai}")
        ]
        response = llm_client._ask(messages)
        ai_error_response_txt = response.content
Анализ SQL-запросов:
def analyze_sql_query(self, llm_client, query, instance, database, user, query_id, bAI_t):
    messages = [
        SystemMessage(content="Ты являешься экспертом по СУБД Pangolin..."),
        HumanMessage(content=f"Проанализируй этот SQL-запрос из экземпляра {instance}:n{query[:2000]}")
    ]
    response = llm_client._ask(messages)
    return response.content
Пример ИИ-вывода для экземпляра
Под спойлером приведены фрагменты реального отчёта, сгенерированного для одного из экземпляров. Все данные (имена хостов, пользователей, IP-адреса, OID и пр.) обезличены. Они наглядно демонстрируют, как GigaChat интерпретирует собранные метрики, логи и SQL-запросы.
🤖 ИИ-анализ использования ресурсов
Факты по ресурсам:
-
CPU: среднее использование — 28,59%, максимальное — 56,8%. Значения низкие, процессор не является узким местом.
-
RAM: среднее использование — 55,91%, максимальное — 81,84%. Показатель близок к верхней границе, но не превышает 85%, что считается приемлемым.
-
HDD & Disk I/O Await: средняя загрузка диска — 2,8%, максимальная — 5,61%. Время ожидания операций ввода-вывода (await) — 0,0% (среднее и максимум), что говорит о высокой скорости работы дисков.
Рекомендации:
-
Наблюдение за использованием памяти Linux и кешированием Pangolin: текущие значения RAM указывают на эффективное использование ресурсов, но стоит следить за тем, чтобы не превышать 80% использования, чтобы избежать риска перехода в своп.
Параметры кеширования Pangolin: возможно, стоит увеличить
shared_buffers*иeffective_cache_size, если система имеет достаточную память и данные часто повторяются. -
Уровень загрузки дисков и время ожидания I/O — низкие, что говорит о хорошей производительности хранилища. Однако, если в будущем возрастёт нагрузка, то стоит обратить внимание на тип носителя (HDD vs SSD) и настройки I/O.
-
В целом, система работает стабильно, но следует избегать перегрузки памяти и регулярно мониторить использование ресурсов при увеличении нагрузки.
🚨 ИИ-нализ ошибок в базе данных
-
00:10:06 MSK [40536]: Подключение к серверу с хоста 192.168.1.1 порт 60144. Аутентификация пользователя service_user_2 методом scram-sha-256. Авторизация пользователя service_user_2 в базе данных app_db с использованием SSL (TLSv1.3).
-
00:10:08 MSK [32917]: Отключение сессии пользователя api_user_1 из базы данных app_db после 29 секунд работы. Подключение с хоста 192.168.1.2 порт 40074. Аутентификация пользователя api_user_1 методом scram-sha-256. Авторизация пользователя api_user_1 в базе данных app_db с использованием SSL (TLSv1.3).
-
00:10:09 MSK [40497]: Процесс 40497 ожидает получение блокировки ShareUpdateExclusiveLock на таблице с OID 12345 в базе данных 1001 более 1000 мсек. Блокировка удерживается процессом 40534. Выполняется команда VACUUM ANALYZE.
-
00:10:09 MSK [40534]: Процесс autovacuum worker был принудительно остановлен из-за конфликта с запросом VACUUM ANALYZE. Ошибка возникает при обрезке отношения “schema_api.gateway_node_status”.
-
00:10:09 MSK [40497]: Процесс 40497 получает блокировку ShareUpdateExclusiveLock после 1000 мсек. Команда VACUUM ANALYZE завершается успешно.
-
00:10:09 MSK [37715]: Запись аудита сессии для пользователя service_user_3, создание временной таблицы temp_table_1.
Краткое резюме основных проблем:
-
Конфликт блокировок между процессом выполнения VACUUM ANALYZE и процессом autovacuum worker.
-
Автовакуум был принудительно отменён из-за конфликта с пользовательским запросом.
-
Наличие долгих операций блокировки может указывать на проблемы с производительностью или настройками autovacuum.
Конкретные рекомендации по устранению проблем:
-
Проверить параметры autovacuum (autovacuum_vacuum_scale_factor, autovacuum_vacuum_insert_scale_factor) и настройки уровня изоляции транзакций, чтобы избежать конфликтов блокировок.
-
Планировать выполнение операций VACUUM ANALYZE в периоды низкой нагрузки.
-
Рассмотреть возможность увеличения времени ожидания блокировки или настройки параметров autovacuum_max_workers.
-
Проверить размер таблицы “schema_api.gateway_node_status” и наличие необходимости в регулярном VACUUM или ANALYZE.
-
Убедиться, что используемые клиентские приложения не вызывают длительных блокировок на уровне базы данных.
🔒 ИИ-анализ блокировок и ожиданий в базе данных
-
2026-02-13 05:21:04 MSK [107215]: SQL statement “SELECT 1 FROM ONLY “schema_api”.”gateway_table” x WHERE “gateway_id” OPERATOR(pg_catalog.=) $1 FOR KEY SHARE OF x” LOG: process 107215 acquired ShareLock on transaction 1000001 after 1021.213 ms CONTEXT: while locking tuple (3,38) in relation “gateway_table”
-
2026-02-13 06:11:44 MSK [115617]: LOG: process 115617 still waiting for ShareLock on transaction 1000002 after 1000.062 ms DETAIL: Process holding the lock: 114863. Wait queue: 115617. CONTEXT: while locking tuple (3,38) in relation “gateway_table” LOG: process 115617 acquired ShareLock on transaction 1000002 after 1277.593 ms
Краткое резюме основных проблем:
Все инциденты связаны с блокировками (ShareLock) на строках таблицы “gateway_table”. Основная проблема заключается в длительном времени ожидания этих блокировок, что приводит к задержкам в выполнении операций INSERT в таблицу “gateway_node_status”.
Конкретные рекомендации по устранению проблем:
-
Проверить активность транзакций, удерживающих блокировки. Убедиться, что они завершаются вовремя.
-
Оптимизировать запросы SELECT с FOR KEY SHARE, которые вызывают блокировку. Возможно, стоит пересмотреть стратегию изоляции транзакций или добавить индексы для ускорения поиска.
-
Рассмотреть возможность использования более мелких транзакций или уменьшения времени жизни транзакций.
-
Проверить производительность и нагрузку на таблицу “gateway_table” и соответствующие индексы.
-
При необходимости, рассмотреть использование других типов блокировок или изменение логики приложения для минимизации конфликтов блокировок.
Анализ SQL-запросов. Для каждого из топ-запросов приводится форматированный SQL и комментарий от ИИ. Например:
SELECT COUNT(DISTINCT e.group_id)
FROM outbox_event_table e
WHERE e.status = $1
  AND ALIAS = 'alias_value'
  AND block_id = $2
🤖 ИИ-анализ запроса
Это запрос на подсчёт уникальных group_id с определёнными фильтрами по статусу, алиасу и block_id, что указывает на выборку событий с конкретным признаком. Потенциальная нагрузка зависит от размера таблицы и индексов по полям status, alias и block_id — отсутствие индексов может привести к сканированию. Запрос простой, но требует оптимизации при большом объёме данных.
Итог по отчёту Analyze_Pangolin_AI: за пять минут администратор получает приоритизированный список проблемных экземпляров с готовыми гипотезами и рекомендациями. Можно сразу переходить к углублённой диагностике, а не собирать информацию.
Как это собрать: ключевые принципы интеграции
Prometheus как источник
Все метрики доступны через HTTP API с поддержкой PromQL, что позволяет писать гибкие запросы без зависимостей от Grafana.
Прямые PromQL-запросы как основа
Вместо готовых дашбордов мы делаем целевые запросы, которые:
-
извлекают только необходимые метрики;
-
агрегируют на стороне Prometheus;
-
возвращают данные в формате, готовом для программной обработки.
Pipeliner как оркестратор
-
запускает скрипты, выполняющие PromQL-запросы напрямую к Prometheus API;
-
обрабатывает JSON-ответы без промежуточных преобразований;
-
интегрируется с AI Hub API для анализа данных;
-
создаёт заявку через TaskTracker API.4.
AI Hub API (GigaChat) как аналитик
Ключевой компонент для составления правильных системных промптов. Современные LLM-модели уже обладают достаточными знаниями о СУБД, поэтому мы сосредотачиваемся на предоставлении чёткого контекста и структуры ответа, чтобы получать технически точные рекомендации по оптимизации параметров БД.
Важный аспект — использование низкой температуры (например, 0,1) для существенного снижения вариативности ответов и получения практически воспроизводимых результатов.
TaskTracker как точка входа в workflow
Автоматически созданная, насыщенная контекстом заявка — это триггер для начала работы команды разработки или эксплуатации.
Перспективы: от диагностики к проактивной оптимизации
Следующий шаг – переход от анализа уже случившегося к предсказанию проблем. С выходом СУБД Pangolin 7+ с поддержкой EXPLAIN (GENERIC_PLAN TRUE) мы планируем научить наш проект Analyze_Pangolin_AI:
-
Собирать планируемые, но ещё не выполненные, «тяжёлые» запросы.
-
Передавать их гипотетический план выполнения (
EXPLAIN) на анализ в GigaChat. -
Получать рекомендации по созданию индексов или изменению запроса до того, как он вызовет проблему в эксплуатации.
Гипотетический план запроса — это мощный инструмент, который позволяет анализировать, как запрос будет выполняться при текущих условиях базы данных (статистика, индексы, настройки) без фактического выполнения запроса. Это открывает возможности для:
-
автоматического подбора индексов для новых запросов;
-
выявления потенциальных проблем с производительностью на этапе разработки;
-
оптимизации схемы базы данных на основе анализа паттернов запросов.
Заключение: от автоматизации к автономному агенту
Представленная связка инструментов не просто «ещё один дашборд». Это цифровой коллега-аналитик, который берёт на себя рутину:
-
мониторит соблюдение стандартов и сам создаёт задачи (Monitoring_Checker_TT);
-
агрегирует состояние сотен сервисов и даёт экспертные заключения (Analyze_Pangolin_AI);
-
ускоряет время реакции на инциденты с часов до минут.
Для внедрения подобной системы не обязательно иметь именно наш стек. Вы можете использовать:
-
Prometheus или любой другой мониторинг с API;
-
Jenkins, GitLab CI или GitHub Actions вместо Pipeliner;
-
Jira, YouTrack или Redmine вместо TaskTracker;
-
GigaChat, GPT или Claude через соответствующие API.
Главное, понять принцип: связать источник метрик, CI/CD-оркестратор, систему управления задачами и современный LLM-API в автономный контур анализа и действия.
Следующий эволюционныйшаг — создание автономного агента, который сможет:
-
Самостоятельно принимать решения — не только обнаруживать проблемы, но и применять стандартные исправления (сброс соединений, очистка временных файлов, перезапуск воркеров).
-
Обучение на исторических данных — анализ паттернов возникновения проблем и прогнозирование инцидентов.
-
Контекстно-зависимые действия — разный набор действий в зависимости от времени суток, нагрузки, важности сервиса.
-
Естественно-языковое взаимодействие — возможность получать сводки и отдавать команды через чат-интерфейс.
Такой агент станет полноценным участником команды SRE, работающим 24/7 и освобождающим человеческие ресурсы для решения действительно сложных, нестандартных задач.
Автор: Pelmen421

