


Меня зовут Лёша, я разработчик из команды перспективных технологий Центра развития искусственного интеллекта СПАО «Ингосстрах». Мы занимаемся интеллектуальной обработкой документов (Intelligent Document Processing, IDP) и для извлечения структурированных данных из входящих документов используем мультимодальные LLM, минуя отдельный этап распознавания текста (OCR).
Часто для заказчиков важно не только получить результат распознавания, но и понять, какие документы стоит отправить на ручную проверку. Поэтому к нам неоднократно обращались с запросом на confidence score – оценку уверенности в правильности извлечённых данных. Ведь даже с ошибкой в номере паспорта или фамилии ответ модели остаётся синтаксически корректным JSON, и следующая система может принять неверные данные за достоверные.
В привычном OCR-пайплайне (например, модели CRNN, Surya, Easy-OCR, Tesseract OCR) вместе с распознанным текстом часто доступна оценка уверенности для символа, слова или строки. Она не гарантирует правильность распознавания и может нуждаться в калибровке, но даёт исходный сигнал для отбора подозрительных результатов.
В нашей системе на основе мультимодальных LLM такой оценки не было. Поэтому мы решили посмотреть на сам процесс генерации ответа. На каждом шаге модель выбирает следующий токен с учётом изображения, инструкции и уже сгенерированного текста. Для выбранных токенов можно получить logprobs – логарифмы их вероятностей. Они показывают, насколько ожидаемым было каждое продолжение для модели, но сами по себе не говорят о том, правильно ли распознано поле.
Мы решили проверить, можно ли по token logprobs находить ошибки в ответах модели. В этой статье расскажу, как мы превратили вероятности токенов в оценку риска и проверили её на реальных данных.
(эксперименты и некоторые другие вещи основаны на оригинальной статье Can You Trust the Confidence? ConfBench for Vision-Language Models on Document Extraction)
Немного контекста
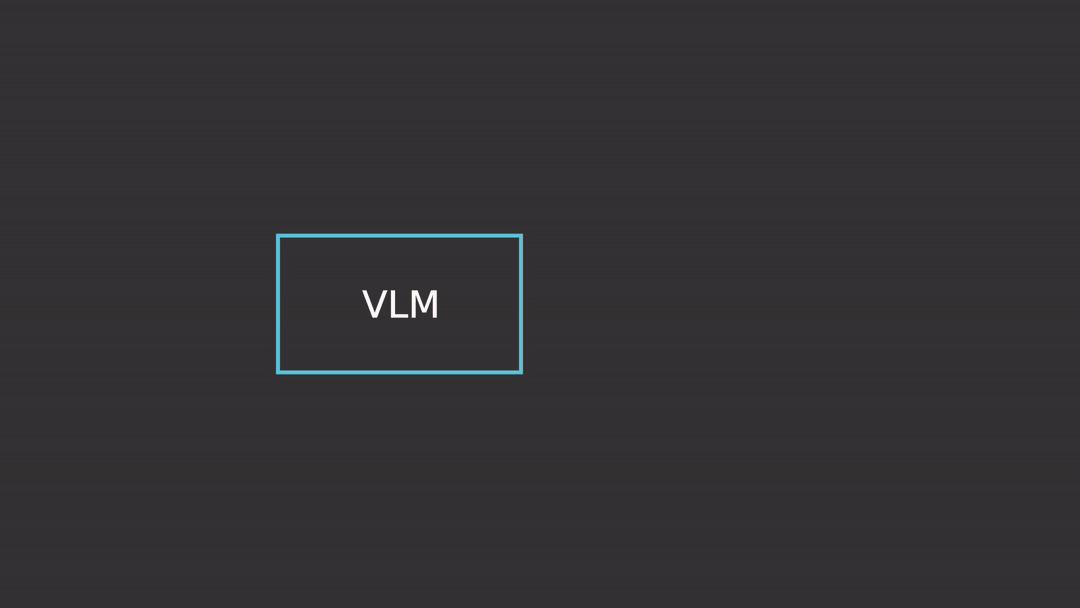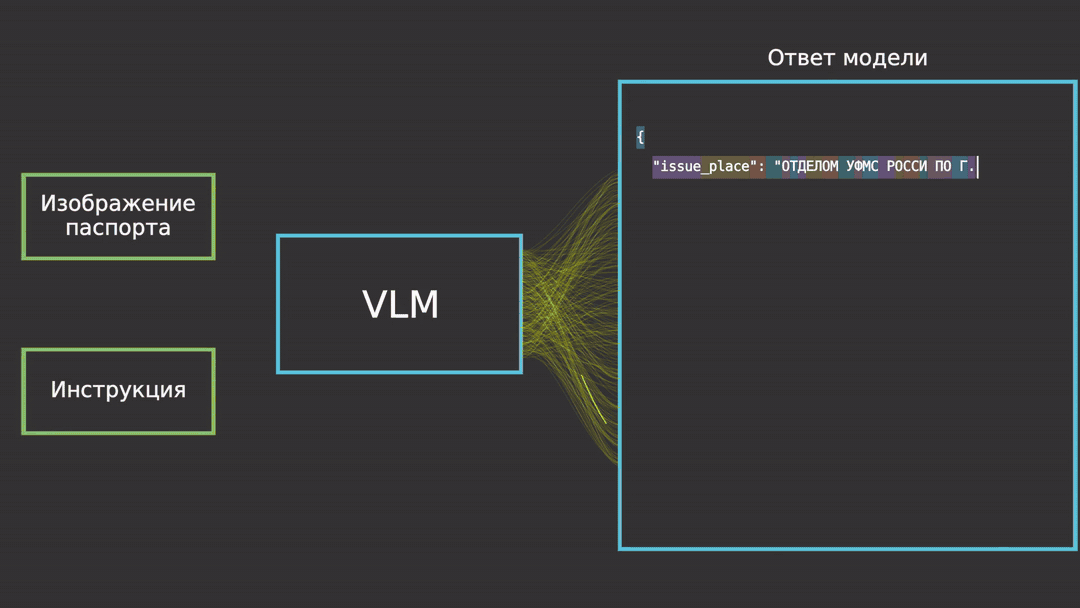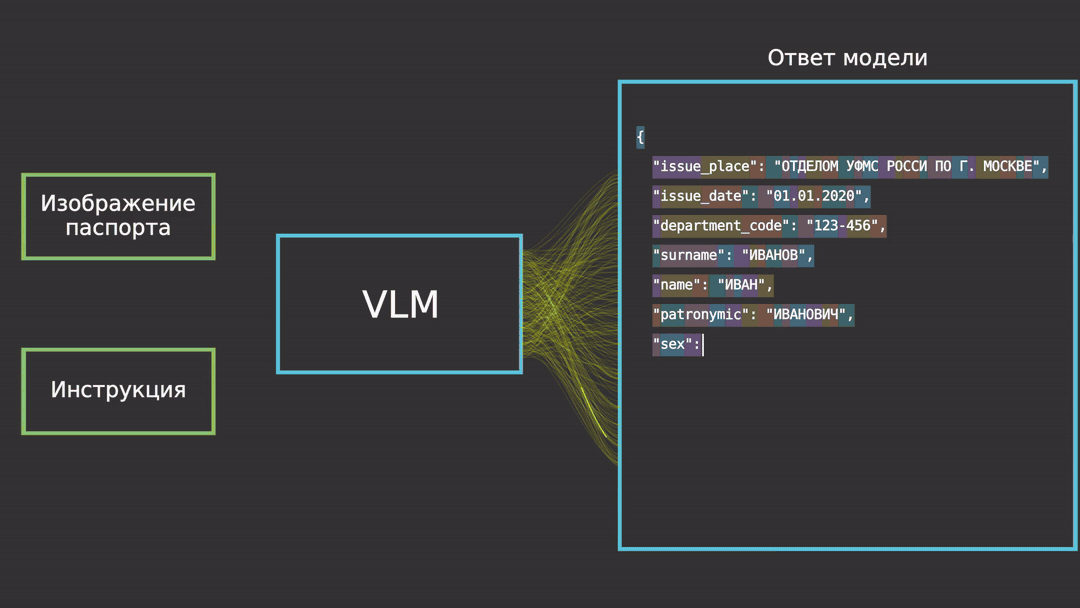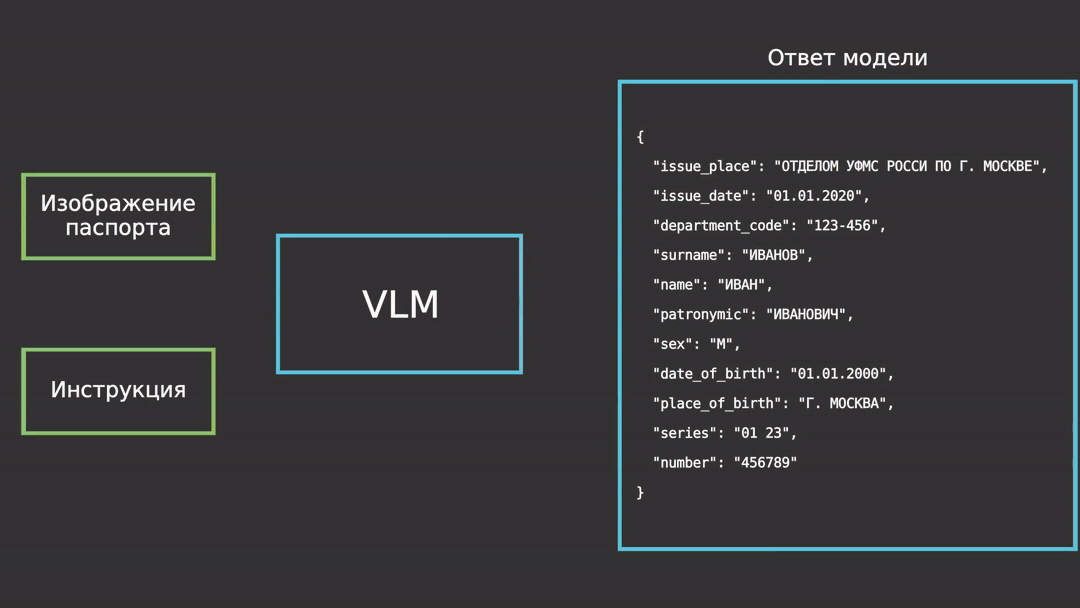
В эксперименте использованы изображения основного разворота внутреннего паспорта РФ. Исходная модель – Qwen3.5-9B, дообученная с помощью LoRA для извлечения полей напрямую из изображения. На вход она получает изображение и инструкцию, а возвращает структурированный JSON с распознанными значениями полей
Ошибки в ответе модели оцениваются на двух уровнях:
-
на уровне поля ответ считается ошибочным, если его значение не совпало с эталоном.
-
на уровне документа достаточно одной ошибки в любом из одиннадцати полей, чтобы весь паспорт считался распознанным неверно.
Поэтому доля ошибочных документов и доля ошибочных полей различаются. В одном паспорте может быть одна ошибка, в другом – несколько.
От вероятностей токенов к оценке поля
При генерации ответа модель вычисляет распределение вероятностей для каждого следующего токена. Даже короткая фамилия вроде «ИВАНОВ» может состоять из нескольких токенов, и у каждого будет своё распределение.
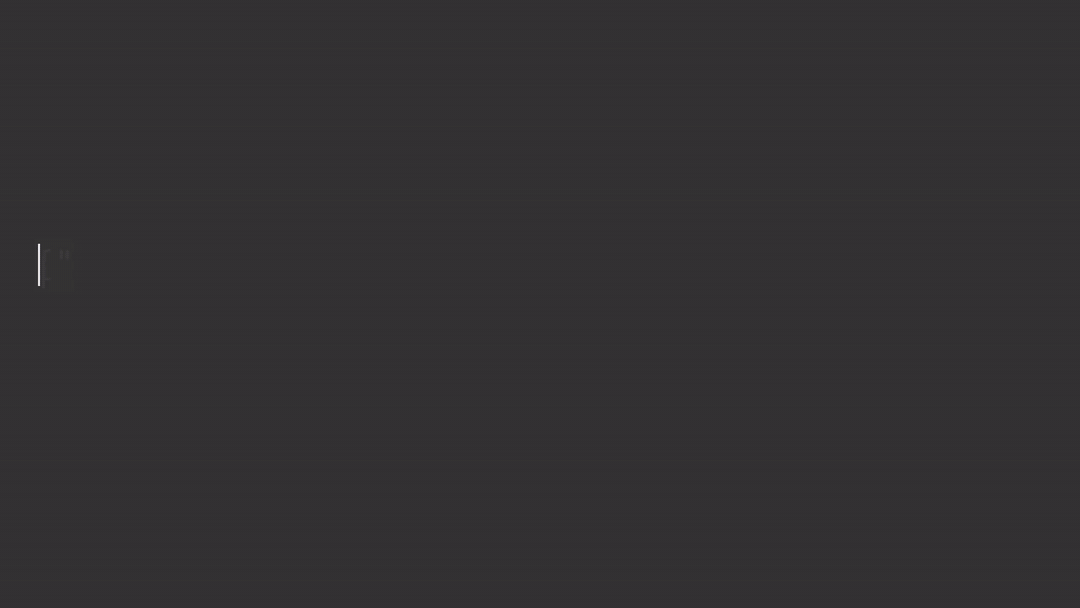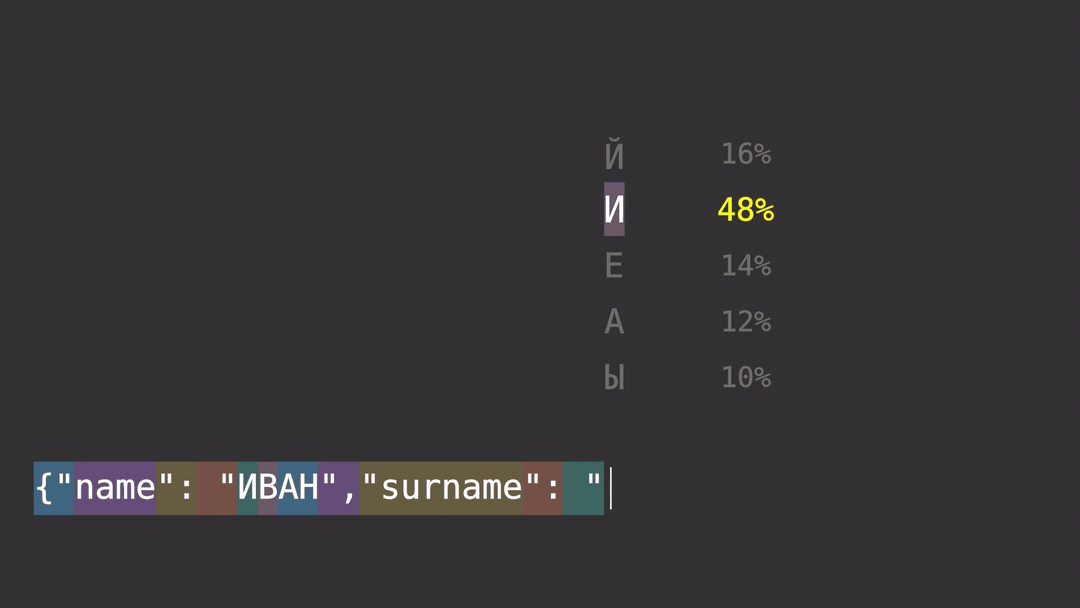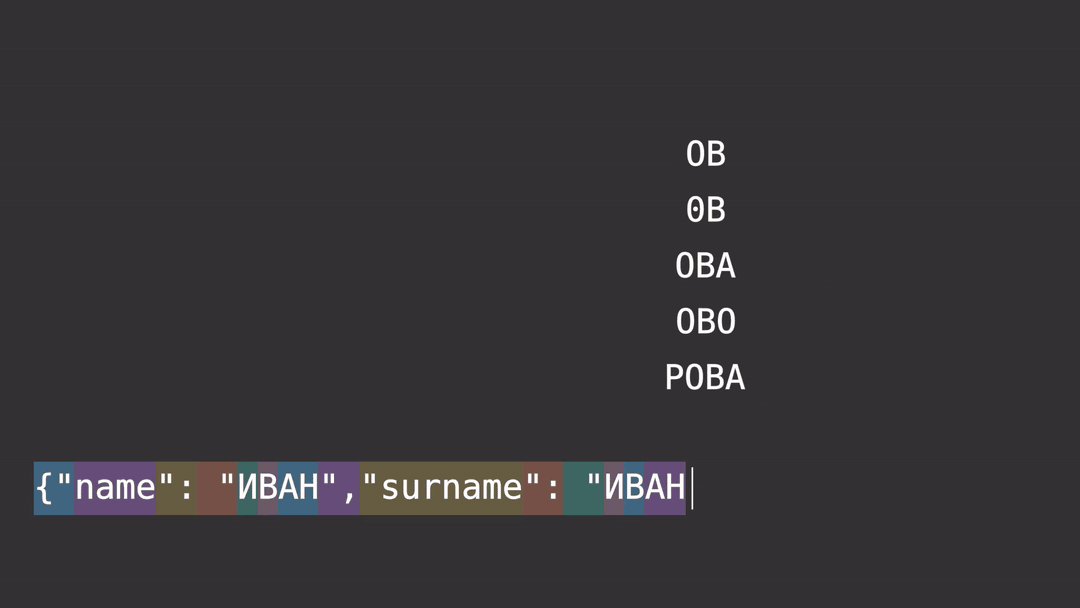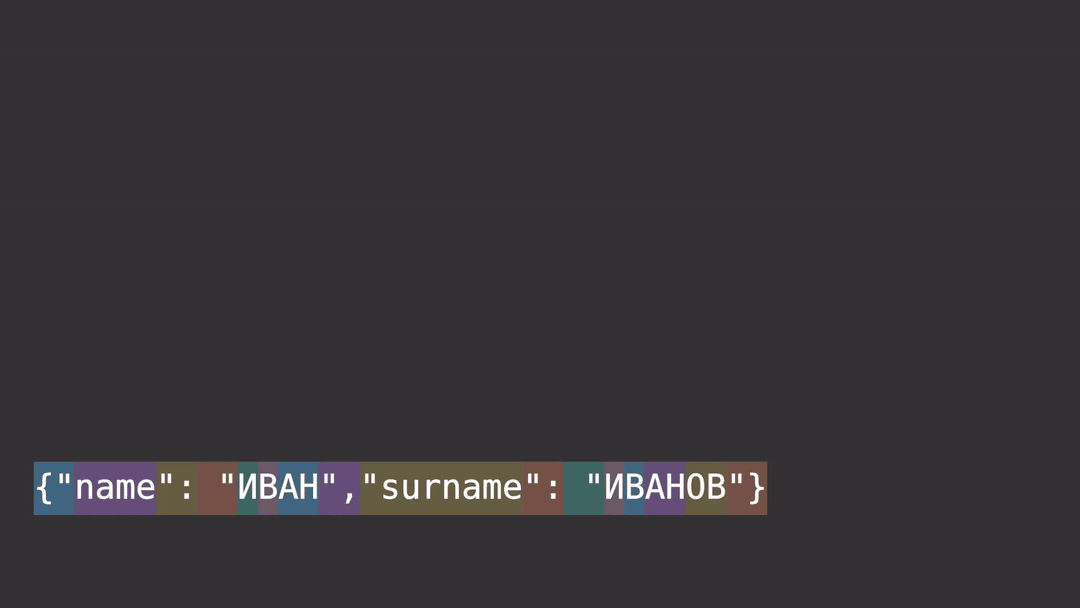
Наша задача – на основе вероятностей токенов, составляющих распознанное поле, оценить вероятность его правильного распознавания. Полученный показатель уверенности должен отражать фактическую долю правильных ответов: например, среди полей с оценкой около 0.8 примерно 80% должны быть распознаны верно, а с оценкой около 0.3 – примерно 30%. Насколько оценки соответствуют этим долям, мы отдельно проверим после калибровки.
Эксперимент
Исходные документы были разделены на три непересекающиеся части: train для обучения классификатора, calibration для калибровки вероятностей и test для итоговой оценки.
Базовая модель распознаёт исходные изображения достаточно хорошо: около 98% полей и 90% документов целиком. Ошибочных примеров мало, а распределения вероятностей токенов получаются остроконечными – топ-1 токен почти всегда забирает под 99% вероятности. Чтобы получить больше примеров ошибок, мы добавили контролируемые искажения к изображениям из train и calibration. Их интенсивность подбирали так, чтобы модель обычно распознавала правильно от семи до десяти полей из одиннадцати. Test оставили без синтетических искажений, чтобы проверить подход на реальных данных.
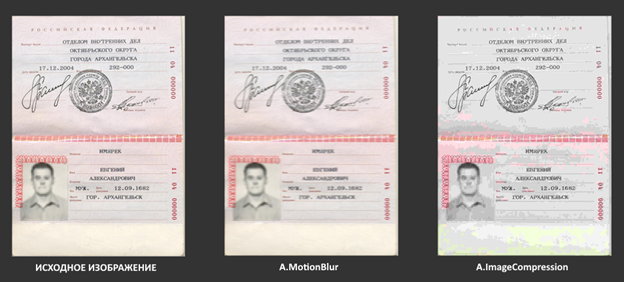
После применения искажений мы заново распознавали документы и сравнивали полученные значения с эталоном. При этом один и тот же фильтр может испортить фамилию в одном паспорте и никак не повлиять на другой.
Изменение точности распознавания различных полей тоже получалось не одинаковым. Например, при увеличении blur_range у albumentations.MotionBlur точность по полю «пол» почти не менялась, а фамилия и место рождения распознавались заметно хуже. Это довод в пользу отдельных моделей классификации для разных полей, но в текущем базовом варианте используется один общий классификатор.
|
Название поля |
Значение параметра blur_range |
|||||
|
7 |
9 |
11 |
13 |
15 |
17 |
|
|
Фамилия |
0.98 |
0.96 |
0.90 |
0.83 |
0.72 |
0.51 |
|
Пол |
1.00 |
1.00 |
1.00 |
1.00 |
1.00 |
1.00 |
|
Место рождения |
0.99 |
0.95 |
0.89 |
0.81 |
0.67 |
0.50 |
Для каждого извлечённого поля мы сохраняли вероятности пяти наиболее вероятных токенов на каждом шаге генерации и рассчитывали по ним агрегированные признаки. Мы исходили из гипотезы, что ошибки распознавания могут сопровождаться снижением вероятности выбранных токенов или усилением конкуренции между вариантами продолжения. Поэтому нам было важно описать и общую уверенность при генерации поля, и отдельные сомнительные токены.
Признаки, которые мы использовали:
-
length_tokens – длина в токенах.
-
min_prob – минимальная вероятность среди всех ТОП-1 токенов.
-
mean_prob – среднее арифметическое вероятностей ТОП-1 токенов.
-
std_logprob – стандартное отклонение логарифмов вероятностей ТОП-1 токенов.
-
q10_logprob – 10-й процентиль логарифмов вероятностей ТОП-1 токенов.
-
min_margin_probs – минимальный разрыв (margin) между вероятностями ТОП-1 и ТОП-2 токенов.
-
mean_top5_entropy – средняя энтропия распределения вероятностей, рассчитанная по ТОП-5 логарифмам вероятностей каждого токена.
-
max_top5_entropy – максимальная энтропия распределения вероятностей, рассчитанная по ТОП-5 логарифмам вероятностей каждого токена.
Скрытый текст
Формула расчёта энтропии распределения вероятностей.
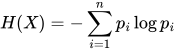
 – вероятность
 -го токена из распределения ответов модели;
 – значение энтропии распределения.
Значение энтропии близкое к 0 означает, что распределение сосредоточено в одной точке. В контексте языковых моделей это означает, что вероятность одного конкретного токена несоизмеримо выше вероятностей всех остальных. Модель практически «уверена» в своем выборе, что делает генерацию детерминированной и предсказуемой. Большие значения энтропии, наоборот, указывают на то, что распределение «размыто» и сразу несколько разных токенов имеют сопоставимый шанс стать продолжением ответа.
Соответственно, для конкретного ответа модели средняя энтропия распределения вероятностей рассчитывалась как:
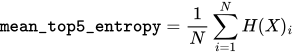
 – значение энтропии для
 -й позиции токена в ответе модели;
 – количество токенов в ответе модели.
а максимальная как:
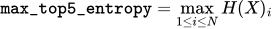
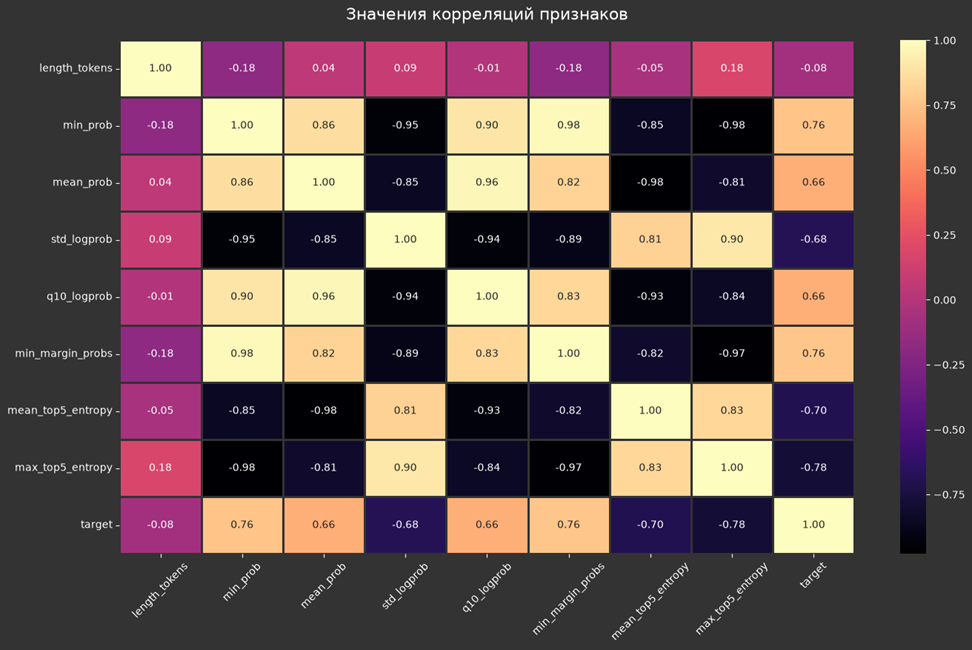
Корреляции рассчитываемых признаков согласуются с гипотезой: более высокие вероятности выбранных токенов чаще сопутствуют правильному распознаванию, а высокая энтропия – ошибкам. Длина поля почти не связана с целевой переменной. Некоторые признаки сильно коррелируют друг с другом, поэтому матрица помогает понять их поведение, но сама по себе не выбирает лучший признак.
На рассчитанных признаках мы обучили бинарный классификатор на основе градиентного бустинга. Класс 1 соответствует правильному полю, класс 0 – ошибочному. Поэтому выход классификатора трактуется как вероятность правильного распознавания, то есть чем она ниже, тем вероятнее поле должно попасть на ручную проверку.
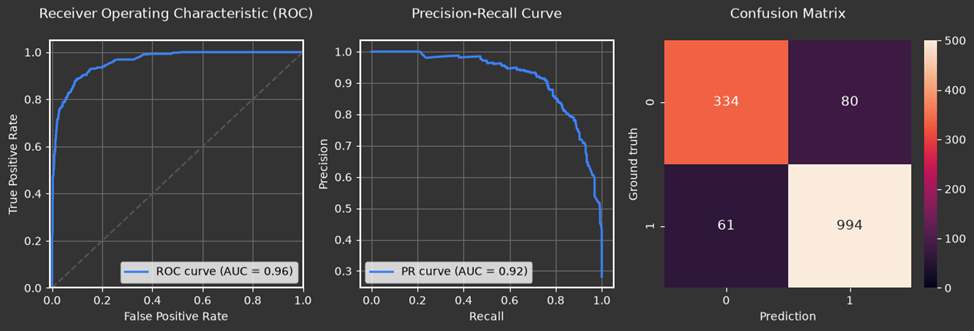
На train классификатор получил ROC AUC около 0.96 и PR AUC около 0.92 для положительного класса, то есть верного распознавания. При пороге 0.5 он правильно определил 994 корректных поля из 1055 и 334 ошибочных поля из 414.
Калибровка
Классификатор позволяет упорядочить поля по риску ошибки. Но нам хотелось, чтобы его оценки отвечали и на исходный запрос заказчиков – насколько можно доверять результату распознавания. Хорошее ранжирование само по себе не означает, что среди полей с оценкой 0.9 действительно 90% распознаны правильно. Поэтому следующим шагом мы откалибровали вероятности.
Для исправления вероятностей использовалась отдельная calibration-часть и CalibratedClassifierCV из scikit-learn. Базовый классификатор на этом этапе не переобучался. Калибратор учился преобразовывать его выходные оценки так, чтобы они лучше соответствовали наблюдаемой доле правильно распознанных полей.
Цель калибровки – сделать оценки интерпретируемыми: например, среди достаточно большого числа полей с оценкой около 0.8 примерно 80% должны быть правильными. Риск ошибки для такой группы тогда составляет около 0.2. При этом отдельное поле может оказаться как верным, так и ошибочным.
Калибровка особенно нужна, если система принимает решение по фиксированному порогу или если требуется оценить остаточную долю ошибок среди автоматически принятых документов. Когда задача сводится только к выбору верхних 10% самых подозрительных примеров, качество ранжирования важнее абсолютных вероятностей.
Проверка на реальных данных
После калибровки мы проверили подход на независимой test-части без синтетических искажений. Нам было важно понять, сможет ли классификатор, обученный на примерах с искусственными искажениями, находить ошибки на исходных изображениях документов.
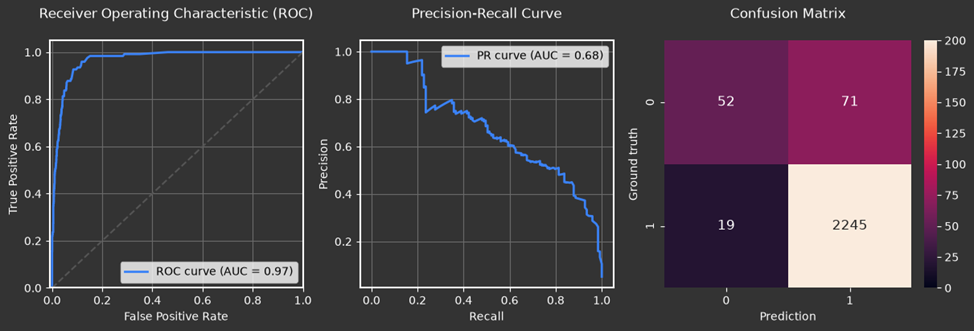
На уровне полей тестовая выборка содержит 2387 примеров, из которых 123 ошибочны. При пороге 0.5 классификатор относит к классу 0 и отправляет на проверку 71 поле. Ошибка действительно есть в 52 из них.
|
Показатель |
Значение |
|
Доля полей, отправленных на проверку |
3.0% |
|
Доля обнаруженных ошибок |
42.3% |
|
Ошибки среди отправленных на проверку |
73.2% |
|
Ошибки среди автоматически принятых полей |
3.1% |
|
ROC AUC |
≈ 0.97 |
|
PR AUC для класса ошибки |
≈ 0.68 |
Такой порог даёт небольшой объём проверки: 73.2% отправленных полей действительно содержат ошибку. При этом находятся лишь 42.3% всех ошибок. В рабочей системе порог стоит выбирать исходя из доступного объёма проверки и допустимой доли пропущенных ошибок.
Проверка калибровки
Теперь проверим, насколько значения confidence соответствуют фактической доле правильных ответов на тестовой выборке. Для этого разобьём оценки на интервалы и в каждом сравним среднюю предсказанную вероятность правильного распознавания с долей действительно верных полей. У идеально откалиброванной модели точки на таком графике лежат на диагонали.
Чтобы выразить это расхождение одним числом, используем Expected Calibration Error (ECE). Эта метрика усредняет абсолютную разницу между двумя величинами по всем интервалам с учётом числа полей в каждом.
Формула расчёта метрики:
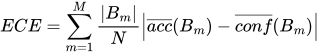
 – количество интервалов разбиения вероятностей (бины);
 – общее количество предсказаний;
 – количество предсказаний в m интервале;
 – средняя точность предсказаний в
 интервале;
 – средняя уверенность предсказаний в
 интервале.
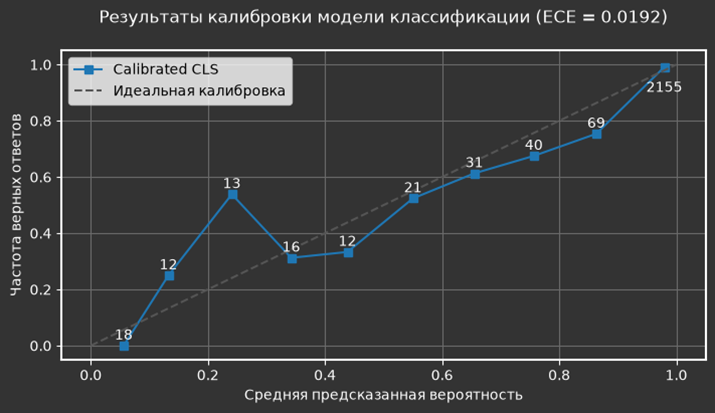
На тестовой части ECE составила 0.0192. Чем ближе значение к нулю, тем меньше среднее расхождение между оценкой модели и наблюдаемой долей правильных ответов. При этом небольшое общее значение ECE не означает, что оценки одинаково точны во всех диапазонах confidence: расхождения в отдельных интервалах видны на калибровочной кривой.
Сколько ошибок находит ручная проверка
Метрики классификатора не показывают напрямую, сколько ошибок может найти оператор при ручной проверке документов, поскольку в реальном процессе на такую проверку есть ограниченный бюджет. Допустим, оператор может просмотреть только 20% входящих документов. Тогда важно понять, сколько ошибок окажется в выбранной части потока.
Для оценки эффективности распределения ресурсов при ручной верификации авторы оригинальной статьи используют специализированная метрику – Error Capture at Review Budget (ECARB). Она сравнивает отбор по оценке риска со случайным выбором при том же бюджете.
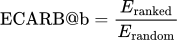
 – количество найденных ошибок при ранжировании;
 – ожидаемое количество ошибок при случайном выборе.
Скрытый текст
Пример расчёта. Пусть имеется  документов с предсказаниями,
 из которых являются ошибочными. Пусть бюджет проверки
 , так что количество проверяемых документов
 . Случайный рецензент, проверяющий 30 из 100 предсказаний, обнаружит ошибку в:
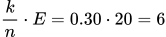
случаях. Предположим, что 30 прогнозов с наименьшей уверенностью содержат 15 из 20 ошибок.
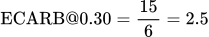
Иными словами, при одинаковых затратах усилий со стороны проверяющего метод проверки, основанный на оценке уверенности, позволяет выявить в 2.5 раза больше ошибок, чем метод случайной выборки.
Оценка зависимости метрики ECARB от величины выделенного бюджета на проверку результатов модели выполнялась по следующему алгоритму:
-
Оценка риска на уровне полей: для каждого извлеченного текстового поля на изображении рассчитывается вероятность его ошибочного распознавания.
-
Агрегация до уровня документа: риск документа определяется как максимальный риск среди его полей.
-
Ранжирование: документы сортируется по убыванию вероятности ошибки (т. е. от наиболее ненадежных прогнозов к наиболее уверенным).
-
Верификация: для каждого заданного шага бюджета из верхней части ранжированного списка отбирается соответствующий топ документов, которые классифицируются как ошибочно распознанные.
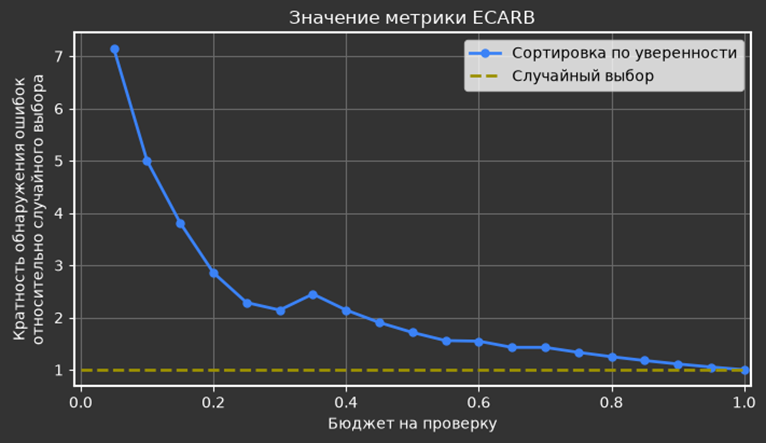
Зафиксировав бюджет на ручную проверку на уровне  (ориентируясь на допускаемые 10% ошибок распознавания базовой моделью на уровне документов) значение метрики составило
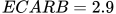 . Иными словами, проверка пятой части документов, выбранных по оценке риска, находит в 2.9 раза больше ошибочных паспортов, чем случайная проверка такого же объёма.
Выводы
Мы начали с вопроса заказчиков: можно ли получать вместе с результатом распознавания оценку уверенности, чтобы выбирать документы для ручной проверки? Эксперимент показал, что вероятности токенов могут стать основой такой оценки. Хотя сами по себе они не отражают правильность распознавания, рассчитанные по ним признаки помогают классификатору находить ошибочные поля.
При этом текущий подход рано считать окончательным. В текущем бейзлайне есть большое количество допущений и точек для улучшения итоговых показателей, например:
-
обучение классификаторов для каждого отдельного поля документа, потому что, очевидно, устойчивость полей к различного рода искажениям разная. Например, для поля «пол» модель стабильно сохранят корректное предсказание даже при сильном уровне искажений.
-
увеличение объёма синтетических данных за счёт применения к изображению не одного набора аугментаций, а нескольких, и приближение таких искажений к реальному входящему распределению документов.
-
модели классификации на последовательностях, с помощью которых можно проводить классификацию на основе всех порождаемых распределений токенов ответов по полям, например, использование RNN и Transformers.
-
модель определения confidence документа, заменяя определение уверенности в ошибке документа как максимальную уверенность в ошибке конкретного поля.
Конечно, такой подход не позволяет обнаруживать все ошибки, возникающие в ответах LLM. Это обусловлено целевой функцией, на которую оптимизируются авторегрессионные языковые модели, из-за чего они склонны к избыточной уверенности в своих ответах. Но даже если вероятность токена нельзя напрямую назвать уверенностью в правильности поля, её можно использовать для увеличения полноты выявления ошибок распознавания по сравнению со случайным отбором документов.
Автор: thunderpede

