


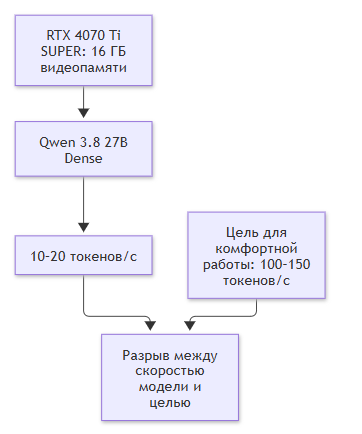
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
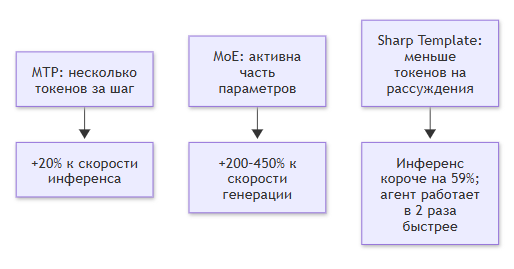
Но недавно я наткнулся на 2 модели: Tiel-Coder-35B-A3B-GGUF-MTP (заточена на кодинг) и Cyber-Tiel-Coder-35B-A3B-GGUF-MTP (abliterated-модель без цензуры, которая не отказывается писать эксплойты и проводить активные взломы всего, что ни попросишь). И вот чем они ещё примечательны? Во-первых, в них используется технология MTP (Multi-Token Prediction), позволяющая LLM предсказывать сразу несколько следующих токенов вместо одного, что даёт прирост скорости инференса на 20%. Во-вторых, используется архитектура MoE (Mixture of Experts), которая позволяет получить качество большой модели, выполняя для каждого токена вычисления только с частью её параметров. Прирост скорости генерации токенов составляет +200-450%. В-третьих, это Sharp Template, то есть оптимизированный Chat Template (Jinja) с системным промптом, который заставляет LLM тратить меньше токенов на рассуждения и ответы, не теряя при этом необходимой информации. Он сокращает инференс на 59%, что в итоге ускоряет работу кодинг-агента в 2 раза.
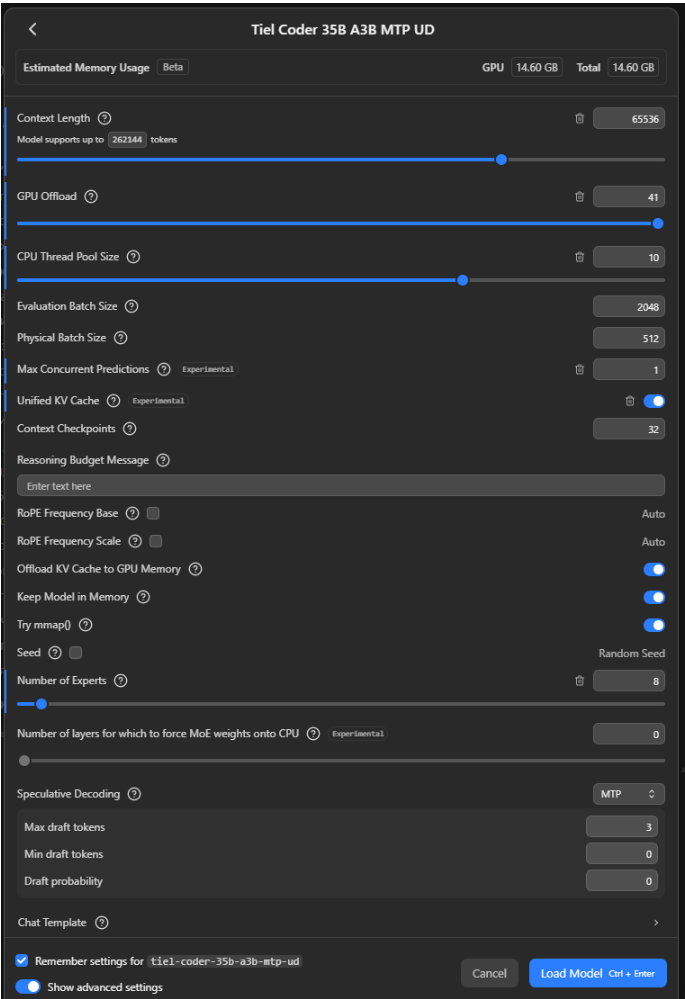
По итогу я на своей видеокарте запускаю следующие версии этих моделей: Cyber-Tiel-Coder-35B-A3B-MTP-UD-Q2_K_XL.gguf и Tiel-Coder-35B-A3B-MTP-UD-Q2_K_XL.gguf, а параметры запуска выглядят вот так:
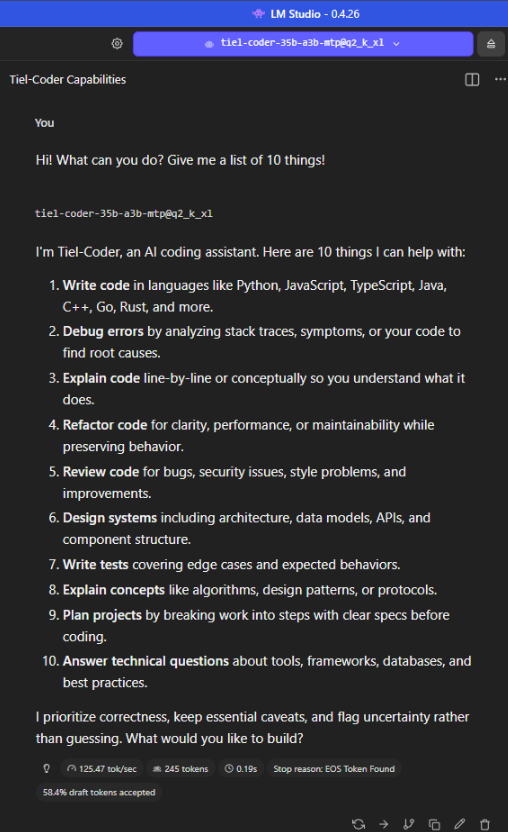
В итоге получаю скорость 125 токенов в секунду!
Это очень хорошее начало, но если вы заметили, то контекстное окно всего 65535 токенов, и для агентной работы при кодинге этого маловато. По этой причине я использую 3 подхода.
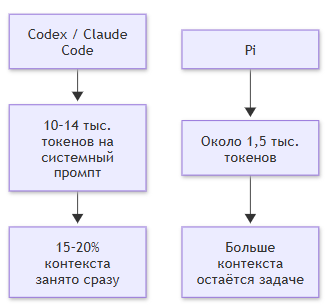
Во-первых, я не использую тяжёлые кодинг-агенты, такие как Codex или Claude Code, потому что они сразу из коробки при минимальном обращении съедают от 10 до 14 тыс. токенов на системный промпт и т. д. То есть 15-20% контекста отъедается сразу, и притом локальные модели легче теряют контекст, а такие большие системные инструкции ещё сильнее отвлекают их от задачи, которую формулирует пользователь. Я использую кодинг-агента Pi, для его работы требуется 1,5 тыс. токенов, и это в 10 раз меньше, чем у Codex или Claude Code, что ощутимо влияет на возможности и качество работы на локальной видеокарте пользователя. Вот конфигурационный файл от Pi, чтобы добавить эти 2 модели, которые будут крутиться у вас на видеокарте: ~/.pi/agent/models.json
{
  "providers": {
    "lmstudio": {
      "baseUrl": "http://ВАШ_ЛОКАЛЬНЫЙ_IP:1234/v1",
      "api": "openai-completions",
      "apiKey": "lmstudio",
      "models": [
        { "id": "peculiar-ragdoll/tiel-coder-35b-a3b-mtp@q2_k_xl" ,
          "contextWindow": 65536,
          "maxTokens": 32768,
          "input": ["text", "image"]
       },
        { "id": "peculiar-ragdoll/cyber-tiel-coder-35b-a3b-mtp" ,
          "contextWindow": 65536,
          "maxTokens": 32768,
          "input": ["text", "image"]
       }
     ]
   }
  }
}
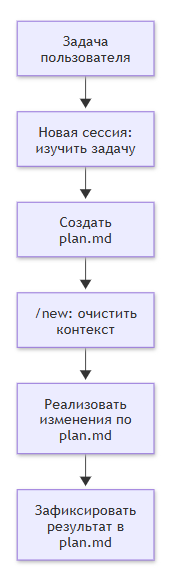
Во-вторых, я никогда не прошу кодинг-агента пытаться сделать крупное изменение в коде напрямую. Я начинаю новую сессию командой ‘/new’ и прошу кодинг-агента написать файл plan.md, который будет описывать, что надо изменить в коде, чтобы реализовать поставленную мной задачу. Таким образом, мне хватает контекстного окна в 65535 токенов, так как, по сути, я задачу разбиваю на две фазы: планирование и реализацию. В итоге, если задача не слишком крупная, после создания plan.md я очищаю контекстное окно кодинг-агента командой ‘/new’ и прошу его внести правки в код на основе plan.md и по завершении работы в plan.md зафиксировать результаты.
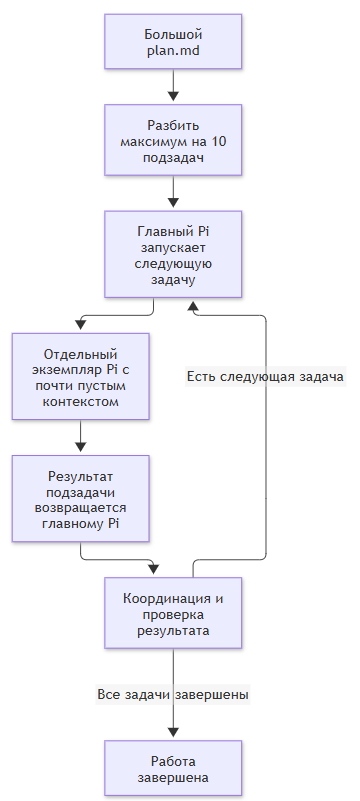
В-третьих, для очень больших plan.md я использую свой SKILL под названием subtask4llm-pi, который разбивает задачу не более чем на 10 подзадач и выполняет их последовательно. При этом каждая подзадача запускается в отдельном экземпляре кодинг-агента, куда передаётся только то, что относится к подзадаче, а его контекстное окно размером 65535 токенов будет почти пустым. Результаты работы подзадач стекаются в главный экземпляр Pi и не переполняют его главное контекстное окно, которое занимается координацией, планированием и проверкой. Скилл вы можете установить командой “npx skills add https://github.com/evgenyigumnov/subtask4llm –skill subtask4llm-pi”. Также есть версия для Codex – subtask4llm-codex. Кстати, если у кого есть желание добавить поддержку Claude или чем-то ещё помочь, то шлите пул-реквесты https://github.com/evgenyigumnov/subtask4llm
В-четвертых, я использую подход Роберта Мартина, автора книги “Чистый код”, который недавно заявил, что перестал читать код, который генерируют кодинг-агенты. И этого он добился, загнав LLM в жесткие рамки. Используя эти рамки, можно нивелировать то, что используемые модели сильно ужаты до уровня UD-Q2_K_XL. То есть они допускают больше ошибок, чем 4-, 6- или 8-битные модели. И чтобы создать эти рамки, я предлагаю использовать AGENTS.md, который контролирует размер каждого создаваемого файла, заставляет писать юнит-тесты, четко формулирует декомпозицию и ответственность в коде, ну и в итоге требует прогона тестов. Так как на локальной видюхе мы не платим за каждый токен, то мы безболезненно переживем пару лишних итераций, когда модель увидит свои ошибки и исправит их. Вот базовый пример файла AGENTS.md для этого:
# AGENTS.md

## Правила написания кода

- Максимальный размер одного файла с кодом - 300-500 строк. Если файл становится больше, выполняй декомпозицию.
- Главный принцип - одна связная ответственность на модуль.
- Не жертвуй логической связностью или читаемостью кода ради соблюдения произвольных ограничений на количество строк.
- Разделяй файлы исходя из их функционального назначения, а не только по количеству строк.
- Все функции должны быть покрыты unit-тестами.
- При добавлении или изменении функциональности, а также при исправлении ошибок обязательно добавляй соответствующие unit-тесты.

## Проверка перед сдачей

- Все тесты и сборка должны проходить без ошибок и предупреждений.
- Не ослабляй проверки и не удаляй тесты ради успешного прохождения тестирования.

## Главное правило

**Никогда не коммить изменения без прямой просьбы пользователя.**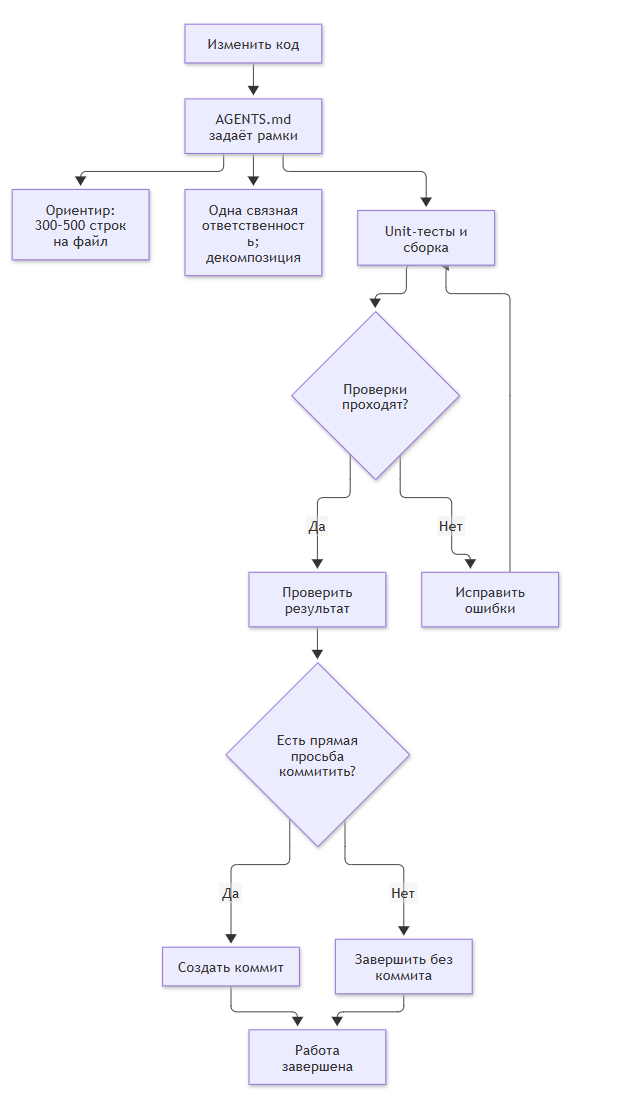
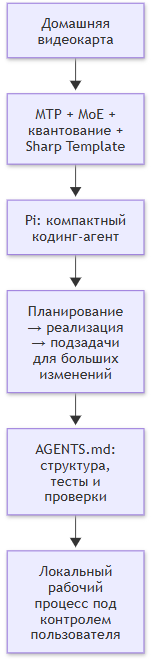
В итоге у нас произошёл синергетический эффект, или, можно сказать, даже эмерджентность. MTP + Квантование + MoE + AGENTS.md (Чистый код) + Sharp Template + Pi agent + subtask4llm skill + plan.md = рабочий процесс с кодинг-агентом, запущенный на вашей домашней видеокарте. Теперь ваши исходники под вашим контролем, и на них не наложат свои грязные лапы крупные корпорации! И ещё можно запустить abliterated-модель для White Hat-хакинга и не мучиться постоянными отказами от проприетарных моделей, когда пытаешься что-то там взломать.
Автор: igumnov

