


У искусственного интеллекта нет даты рождения и изобретателя. ИИ — это путь, длинною в 100 лет. Математическая модель нейрона появилась в 1943 году, термин «искусственный интеллект» — в 1955-м, трансформер — в 2017-м, ChatGPT — в 2022-м. Между ними две «зимы», десятилетия забвения и споры о приоритете, которые не утихают до сих пор.
Как создали ИИ: короткий ответ
Современные нейросети собраны из пяти давних идей:
-
Математическая модель нейрона (1943) — нейрон можно описать как функцию, которая суммирует входы и срабатывает при превышении порога.
-
Обучение по примерам (1950-е) — веса связей не задают вручную, а подбирают по данным.
-
Многослойность (1960-е) — несколько слоёв позволяют выражать сложные зависимости.
-
Обратное распространение ошибки (1970-е — 1986) — способ эффективно обучать многослойные сети.
-
Механизм внимания (2014–2017) — модель сама выбирает, на какие части входа смотреть.
Идеи долго не работали вместе, потому что не хватало данных, вычислительной мощности и архитектуры, которая хорошо масштабируется. Все три появились между 2009 и 2020 годами: ImageNet дал данные, игровые видеокарты — вычисления, трансформер — архитектуру.
1943–1956: идея и название
Нейрон как логическая функция
В 1943 году нейрофизиолог Уоррен Мак-Каллок и логик Уолтер Питтс опубликовали статью «Логическое исчисление идей, относящихся к нервной активности». Они показали, что упрощённый нейрон — элемент, который суммирует входные сигналы и срабатывает при превышении порога, — может реализовать логические операции. Сеть таких элементов в принципе способна вычислить любую логическую функцию. Обучения в этой модели ещё не было: веса задавались вручную.
Тест Тьюринга
В 1950 году Алан Тьюринг опубликовал статью «Вычислительные машины и разум» и предложил «игру в имитацию». Это не проверка «разума»: Тьюринг уходил от неразрешимого вопроса «может ли машина мыслить» к проверяемому — можно ли отличить её ответы от человеческих.
Дартмутский семинар
Термин «искусственный интеллект» Джон Маккарти ввёл в заявке на летний семинар, поданной в 1955 году. Сам семинар прошел летом 1956 года в Дартмутском колледже, его организовали Маккарти, Марвин Минский, Натаниэль Рочестер и Клод Шеннон. Именно Дартмут принято считать основанием ИИ как научной дисциплины.
Авторы заявки были оптимистами: они полагали, что значительного прогресса в том, чтобы научить машины использовать язык и решать задачи, можно добиться за одно лето работы группы учёных. Этот оптимизм ещё не раз обернется разочарованием.
1957–1971: перцептрон и первые глубокие сети
Перцептрон Розенблатта
Психолог Фрэнк Розенблатт разработал перцептрон в 1957 году и представил публике в 1958-м. Главное отличие от модели Мак-Каллока и Питтса — обучение: перцептрон сам подстраивал веса по примерам, исправляя ошибки.
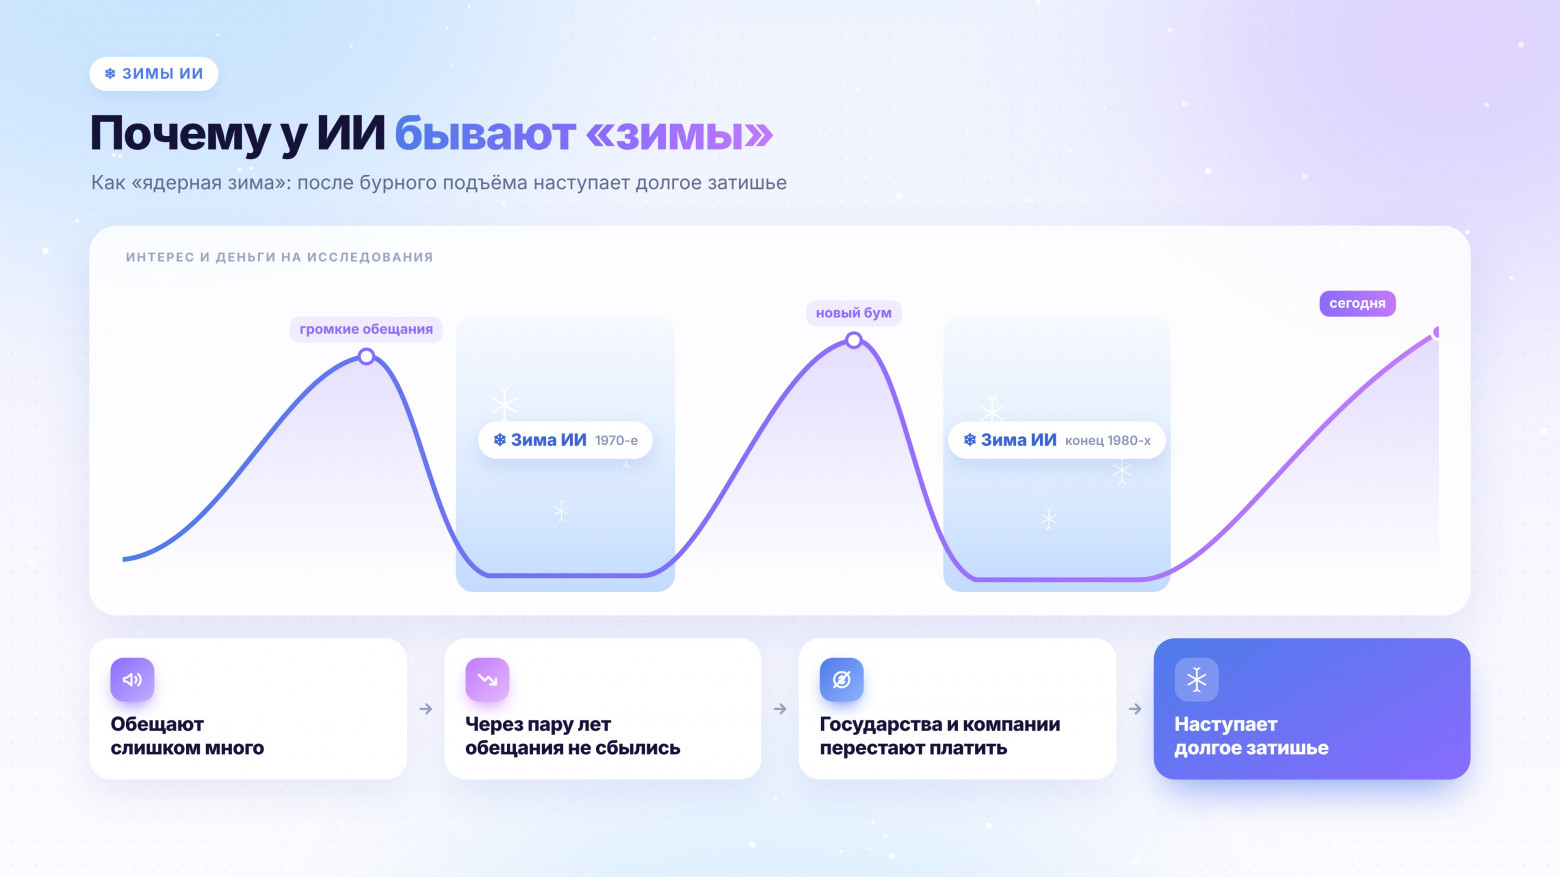
Реакция прессы стала классическим примером завышенных ожиданий. New York Times писала, что флот ожидает от электронного «эмбриона» способности ходить, говорить, видеть, писать, воспроизводить себя и осознавать своё существование. Из таких обещаний позже вырастут «зимы».
Глубокое обучение в Киеве
В 1965 году советские учёные Алексей Ивахненко и Валентин Лапа из Института кибернетики в Киеве опубликовали одни из первых работающих алгоритмов обучения многослойных сетей. Их метод группового учёта аргументов (МГУА) наращивал сеть слой за слоем и обучал каждый слой регрессией, отбрасывая неудачные элементы. В статье 1971 года Ивахненко описал сеть из восьми слоёв.
Высокую оценку этой работе дал Юрген Шмидхубер в обзоре истории глубокого обучения, где осторожно назвал её, возможно, первыми системами глубокого обучения. Оговорка: Шмидхубер известен активной позицией в спорах о приоритете, поэтому корректнее говорить «одни из первых».
Теорема Колмогорова — Арнольда
В 1956–1957 годах Андрей Колмогоров и Владимир Арнольд доказали, что любую непрерывную функцию многих переменных можно представить через суперпозицию функций одной переменной и сложение. Связь этой теоремы с нейросетями десятилетиями оспаривалась: в 1989 году Федерико Джироси и Томазо Поджо писали, что для практики она нерелевантна, а в 1991-м Вера Куркова им возражала. В 2024 году на основе теоремы предложили архитектуру KAN — сети Колмогорова — Арнольда, так что спор получил продолжение.
ELIZA и эффект очеловечивания
В 1966 году Джозеф Вейценбаум из MIT написал программу ELIZA, которая в роли психотерапевта переформулировала фразы пользователя в вопросы. Понимания там не было, только подстановка по шаблонам. Но люди делились с программой личным и приписывали ей сочувствие. Вейценбаум, напуганный этим, стал одним из первых критиков очеловечивания машин. Через 60 лет его предупреждение снова актуально.
1969–1993: две зимы
Первая зима
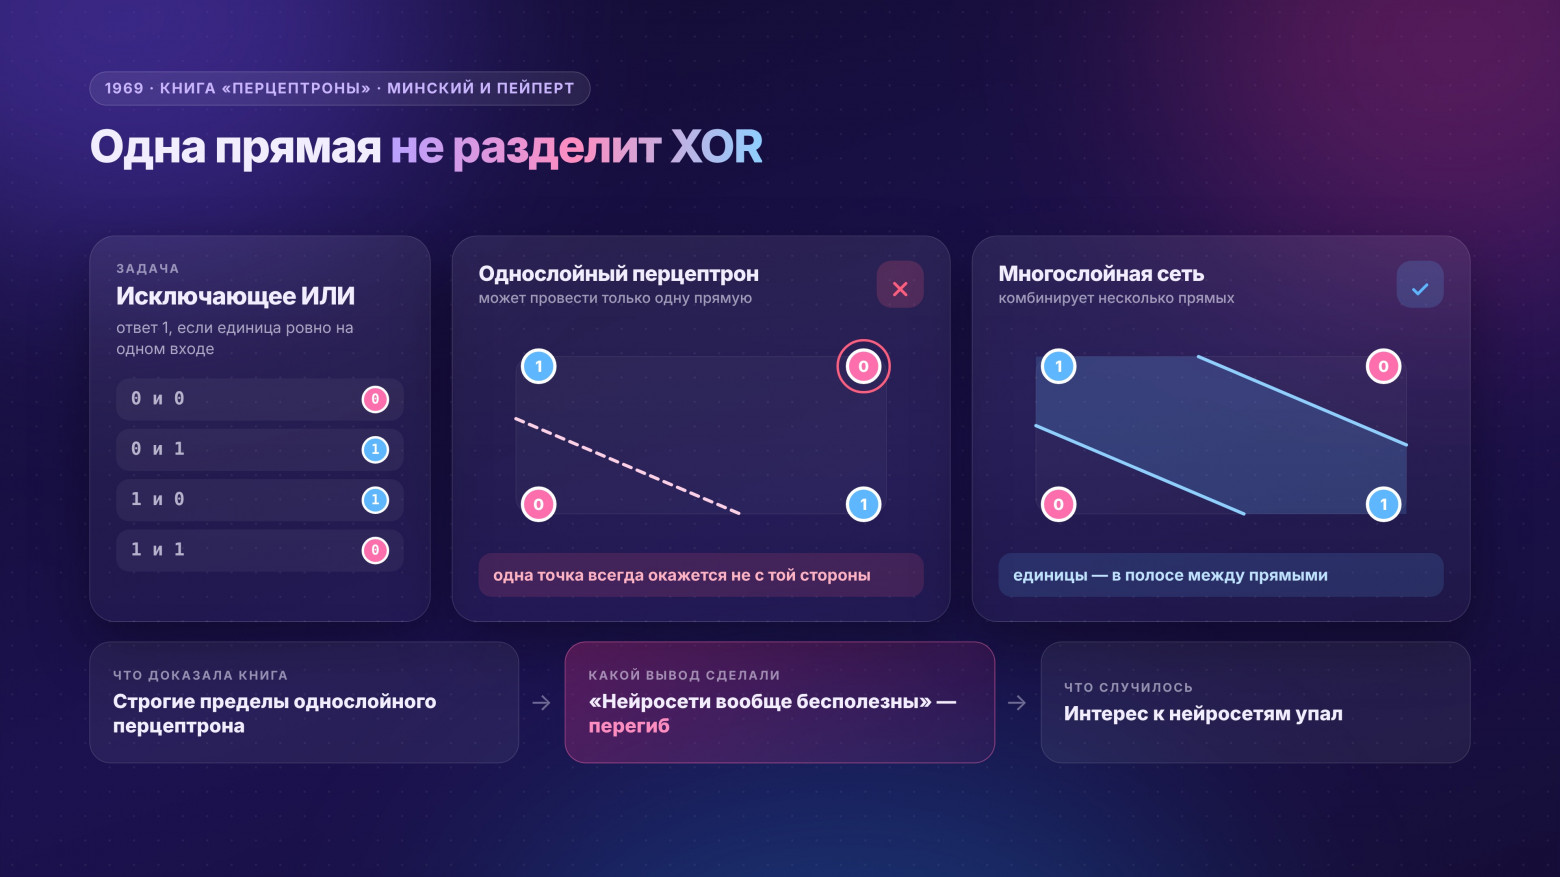
В 1969 году Минский и Сеймур Пейперт выпустили книгу «Перцептроны». Они строго показали пределы однослойного перцептрона: например, он не может вычислить функцию «исключающее ИЛИ». Книга не доказывала бесполезность нейросетей вообще — многослойные сети задачу XOR решают, — но из неё сделали более жёсткий вывод, и интерес к нейросетям упал.
Обратное распространение и вторая зима
В 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс опубликовали в Nature статью, которая сделала популярным метод обратного распространения ошибки. Он позволяет эффективно вычислить, как каждый вес многослойной сети влияет на итоговую ошибку, и поправить его. Многослойные сети снова стало возможно обучать.
Приоритет метода спорный: обратный режим автоматического дифференцирования описал Сеппо Линнайнмаа в 1970 году, применение к нейросетям предлагал Пол Вербос в 1974-м. Корректная формулировка — метод популяризировали в 1986 году.
Вторая зима (около 1987–1993 годов) пришла с другой стороны. В 1980-х бизнес вкладывался в экспертные системы — программы с вручную записанными правилами. Они оказались дорогими в поддержке и хрупкими, а рынок специализированных LISP-машин рухнул, когда обычные рабочие станции стали мощнее.
1997–2016: победы машин и прорыв глубокого обучения
Deep Blue
В 1996 году Гарри Каспаров выиграл у компьютера IBM Deep Blue со счётом 4:2, а в 1997-м проиграл матч-реванш 2,5:3,5. Важная деталь: Deep Blue не был нейросетью. Это специализированное оборудование для перебора позиций и оценочные функции, составленные с участием гроссмейстеров. Победа показала силу вычислений, но не обучения.
ImageNet: ставка на данные
Проект ImageNet команда Фэй-Фэй Ли начала в 2007 году и представила в 2009-м. Это около 14 млн фотографий, размеченных по категориям вручную через сервис микрозаданий Amazon Mechanical Turk. Проект было трудно финансировать: компьютерное зрение того времени интересовалось алгоритмами, а не данными.
На базе ImageNet в 2010–2017 годах проводилось соревнование ILSVRC. Ошибка лучших систем (доля случаев, когда верный ответ не попал в пять первых вариантов) составляла 28% в 2010 году и 26% в 2011-м.
AlexNet
30 сентября 2012 года команда Алекса Крижевского, Ильи Суцкевера и Джеффри Хинтона показала ошибку 15,3% против 26,2% у ближайшего конкурента. Сеть из пяти свёрточных и трёх полносвязных слоёв с примерно 60 млн параметров обучали пять-шесть дней на двух игровых видеокартах NVIDIA GTX 580 по 3 ГБ. Разделить сеть на две карты пришлось вынужденно: памяти одной не хватало.
AlexNet не была ни первой нейросетью, ни первой свёрточной сетью: свёрточная архитектура известна с 1980–1990-х годов. Новым стало сочетание масштаба данных, обучения на GPU и нескольких технических приёмов — функции активации ReLU и метода dropout против переобучения. К 2014 году сеть GoogLeNet снизила ошибку до 6,7%.
AlphaGo
В марте 2016 года система AlphaGo от DeepMind победила одного из сильнейших игроков в го Ли Седоля со счётом 4:1. Ход 37 во второй партии система оценила как крайне маловероятный для человека — примерно один шанс из 10 000, — и именно он оказался сильным. В четвёртой партии Ли победил благодаря своему неожиданному ходу 78. В отличие от Deep Blue, AlphaGo сочетала нейросети с обучением на собственных партиях.
2017: трансформер
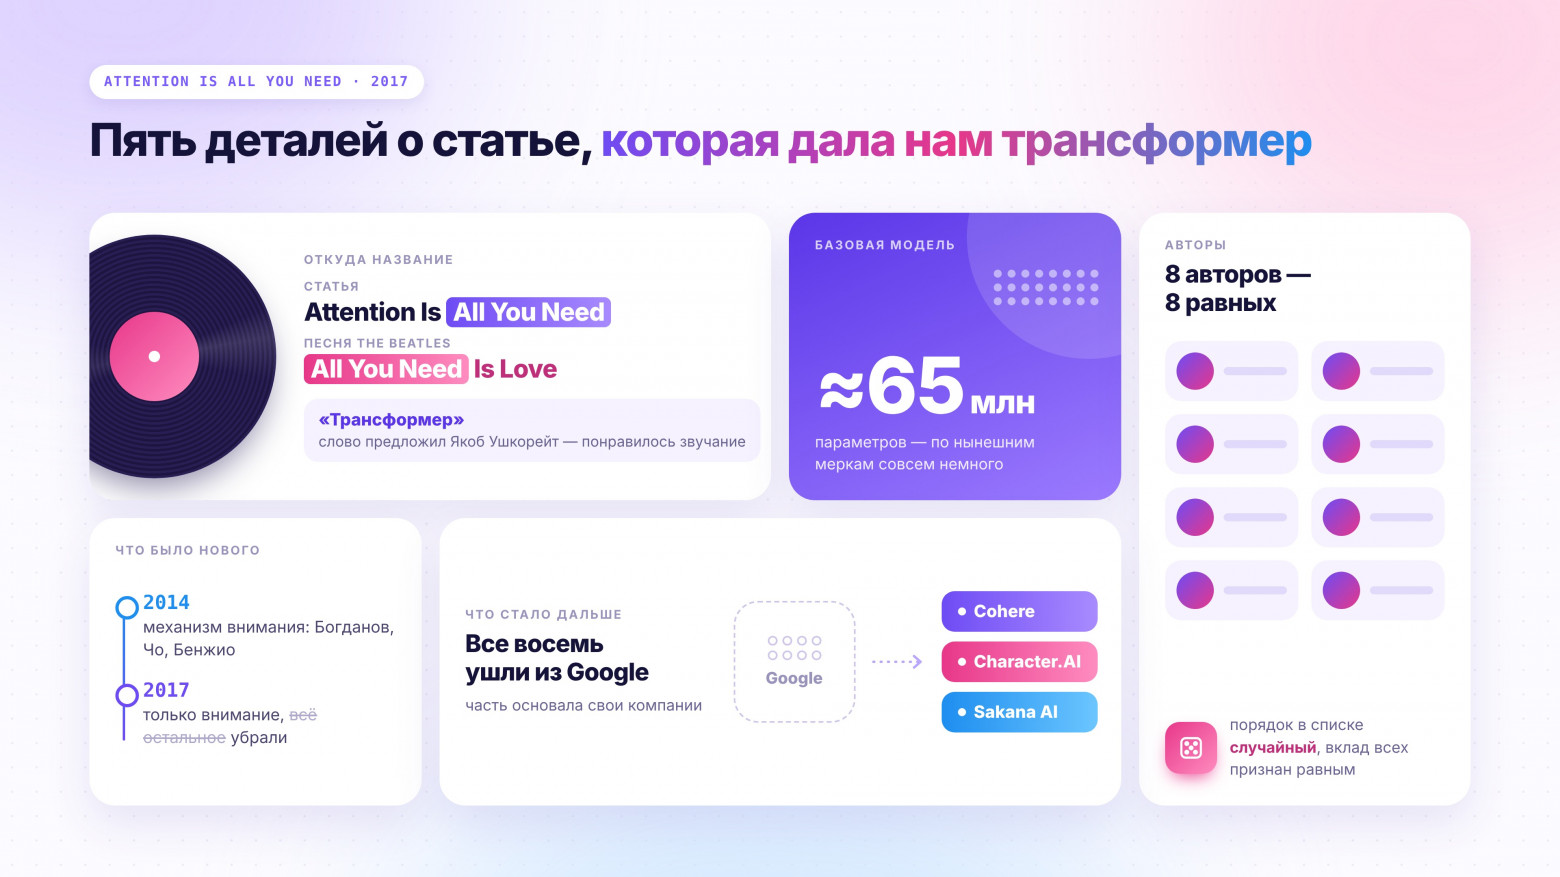
12 июня 2017 года восемь исследователей Google опубликовали статью «Attention Is All You Need». Они предложили для машинного перевода архитектуру, которая отказалась от рекуррентных сетей, обрабатывавших текст последовательно, слово за словом. Вместо этого каждый элемент последовательности через механизм внимания напрямую «смотрит» на все остальные.
Ключевое практическое следствие — параллельность. Рекуррентную сеть нельзя эффективно распараллелить: каждый шаг ждёт предыдущего. Трансформер обрабатывает всю последовательность сразу, поэтому хорошо ложится на GPU и масштабируется.
2018–2022: предобучение и законы масштабирования
GPT и BERT
В 2018 году OpenAI (GPT) и Google (BERT) показали, что трансформер, предобученный на большом массиве сырого текста и затем дообученный под задачу, превосходит специализированные модели. Так сложилась схема, на которой строятся все современные языковые модели.
Законы масштабирования
В 2020 году исследователи OpenAI показали, что качество языковой модели улучшается плавно и предсказуемо — по степенному закону — с ростом размера модели, объёма данных и вычислений. Это превратило обучение моделей из исследования в инженерную задачу: можно заранее оценить, какой результат даст бюджет.
В 2022 году работа DeepMind о модели Chinchilla уточнила картину: многие большие модели недообучены на данных, и при фиксированном бюджете выгоднее модель поменьше, но обученная на большем объёме текста.
Здесь уместно вспомнить эссе Ричарда Саттона «Горький урок» 2019 года: за 70 лет исследований ИИ общие методы, которые масштабируются с ростом вычислений, раз за разом побеждали подходы, основанные на знаниях, вложенных человеком.
Обучение на оценках людей
Предобученная модель хорошо продолжает текст, но плохо выполняет просьбы. В 2022 году OpenAI представила InstructGPT: модель дообучили на примерах выполнения инструкций, а затем с помощью обучения с подкреплением на оценках людей (RLHF). Небольшая модель с RLHF понравилась людям больше, чем GPT-3 в 100 раз крупнее. Этот подход подготовил появление ChatGPT.
2022–2025: ChatGPT и рассуждающие модели
ChatGPT
30 ноября 2022 года OpenAI выпустила ChatGPT как исследовательский предварительный продукт. Технически это была дообученная модель серии GPT-3.5 с RLHF, но формат диалога сделал её доступной всем. Цифру «100 млн пользователей за два месяца» повторяют многие, но это оценка сторонних аналитиков, а не официальные данные компании.
Рассуждающие модели
В сентябре 2024 года OpenAI представила o1 — модель, обученную с помощью обучения с подкреплением «думать» перед ответом: строить длинную цепочку рассуждений и проверять промежуточные шаги. Появился новый ресурс масштабирования: вычисления в момент ответа. Раньше качество модели наращивали почти исключительно на этапе обучения.
В январе 2025 года DeepSeek выпустила модель R1 с сопоставимым поведением и опубликовала рецепт обучения, а веса — под открытой лицензией MIT. R1 не была первой рассуждающей моделью, но стала первой открытой моделью такого уровня.
Как устроена современная нейросеть: четыре этапа обучения
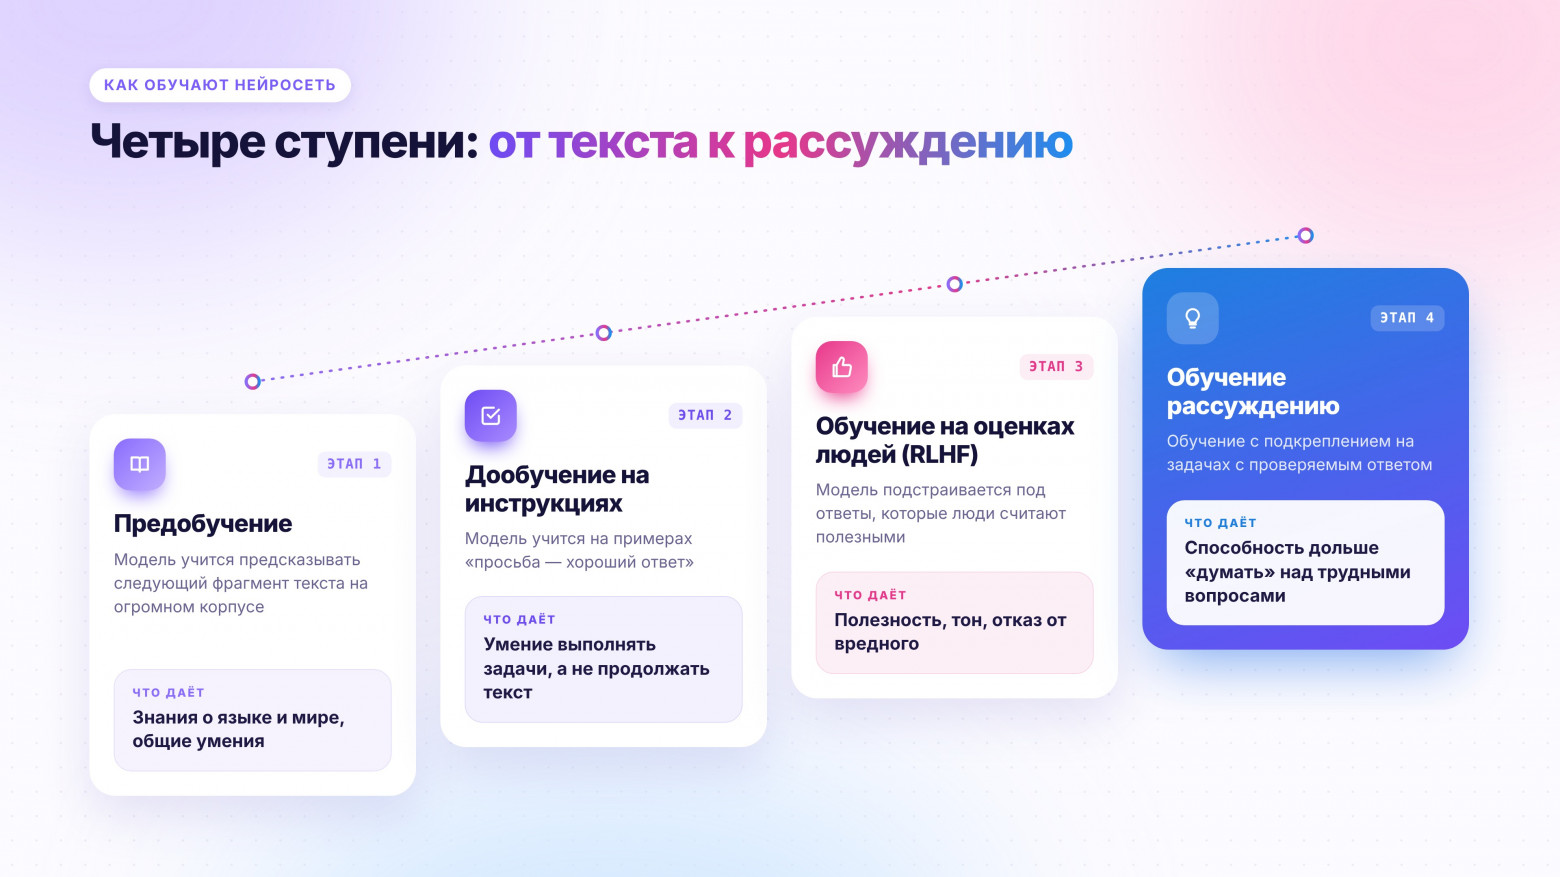
Из этой схемы следует практический вывод: модель знает мир только до даты окончания предобучения и может уверенно ошибаться в фактах. Рассуждение повышает точность на задачах с проверяемым ответом — математике, коде, логике, — но не заменяет проверку фактов.
Где мы сейчас: ноябрь 2026 года
С 2012 года масштаб моделей вырос от 60 млн параметров у AlexNet до сотен миллиардов у моделей 2020–2022 годов. Для современных моделей разработчики число параметров обычно не раскрывают. Актуальные флагманы:
-
OpenAI — семейство GPT-6: с 7 октября 2026 года в ChatGPT работает GPT-6 Sol на платных тарифах и GPT-6 Luna на бесплатном.
-
Anthropic — Claude Opus 5.5 и Sonnet 5.5, вышли в сентябре 2026 года.
-
Google — Gemini 4 Argon, доступна с 13 октября 2026 года, а приложение Gemini, по данным Alphabet, превысило миллиард пользователей в месяц.
-
DeepSeek — DeepSeek V4 Pro и V4.1 Flash с открытыми весами под лицензией MIT.
Все они — потомки одних и тех же пяти идей: нейрона Мак-Каллока и Питтса, обучения Розенблатта, многослойности, обратного распространения и внимания.
Частые ошибки
Распространённые заблуждения об истории ИИ и их уточнения.
«ИИ появился в 2022 году»
ИИ — исследовательская область с 1950-х годов. ChatGPT сделал её массовой, но опирался на 70 лет работ.
«Книга Минского убила нейросети»
Книга показала пределы однослойного перцептрона. Первую зиму усилили отчёты ALPAC и Лайтхилла и завышенные обещания самих исследователей.
«Обратное распространение придумали в 1986 году»
В 1986 году метод популяризировали. Более ранние работы — Линнайнмаа (1970) и Вербос (1974), приоритет оспаривается.
«AlexNet изобрела свёрточные сети»
Свёрточные сети известны с 1980–1990-х годов. Новыми стали масштаб данных, обучение на GPU, ReLU и dropout.
«Deep Blue был нейросетью»
Deep Blue побеждал за счёт специализированного оборудования, перебора и оценочных функций, составленных людьми.
«ChatGPT набрал 100 млн пользователей за два месяца»
Это оценка сторонних аналитиков, а не официальные данные OpenAI.
«У GPT-4 больше триллиона параметров»
OpenAI размер модели не раскрывала. Все такие цифры — неофициальные оценки.
Частые вопросы
Кто создал искусственный интеллект?
Одного создателя нет. Модель нейрона предложили Мак-Каллок и Питтс (1943), термин ввёл Джон Маккарти (1955), перцептрон создал Фрэнк Розенблатт (1957), обратное распространение популяризировали Румельхарт, Хинтон и Уильямс (1986), трансформер предложили восемь исследователей Google (2017).
Когда появился искусственный интеллект?
Основанием ИИ как научной дисциплины считают Дартмутский семинар 1956 года. Сам термин появился в заявке на семинар в 1955 году.
Что такое «зимы ИИ»?
Периоды резкого сокращения финансирования и интереса к ИИ после несбывшихся обещаний. Первая длилась примерно с 1974 по 1980 год, вторая — примерно с 1987 по 1993 год.
Почему нейросети заработали только в 2010-х?
Не хватало трёх условий: больших размеченных данных, дешёвых вычислений (игровые видеокарты) и архитектуры, которая хорошо масштабируется.
Как устроен ChatGPT?
Это трансформер, прошедший четыре этапа обучения: предобучение на большом корпусе текста, дообучение на инструкциях, обучение на оценках людей (RLHF) и в новых версиях — обучение рассуждению.
Заключение
ИИ создавали больше 80 лет, и его история — это история идей, которые опережали свои возможности. Модель нейрона появилась в 1943 году, обучение — в 1950-х, многослойные сети — в 1960-х, обратное распространение — к 1986-му. Но работать вместе они начали только тогда, когда появились данные (ImageNet), вычисления (GPU) и масштабируемая архитектура (трансформер). Дальше всё решил масштаб: законы масштабирования, обучение на оценках людей и рассуждение превратили языковые модели в инструмент, которым пользуются сотни миллионов людей. Работайте с потоками этих идей без VPN и зарубежной карты: ChatGPT, Claude, Gemini.
Автор: SpeShuAI

