


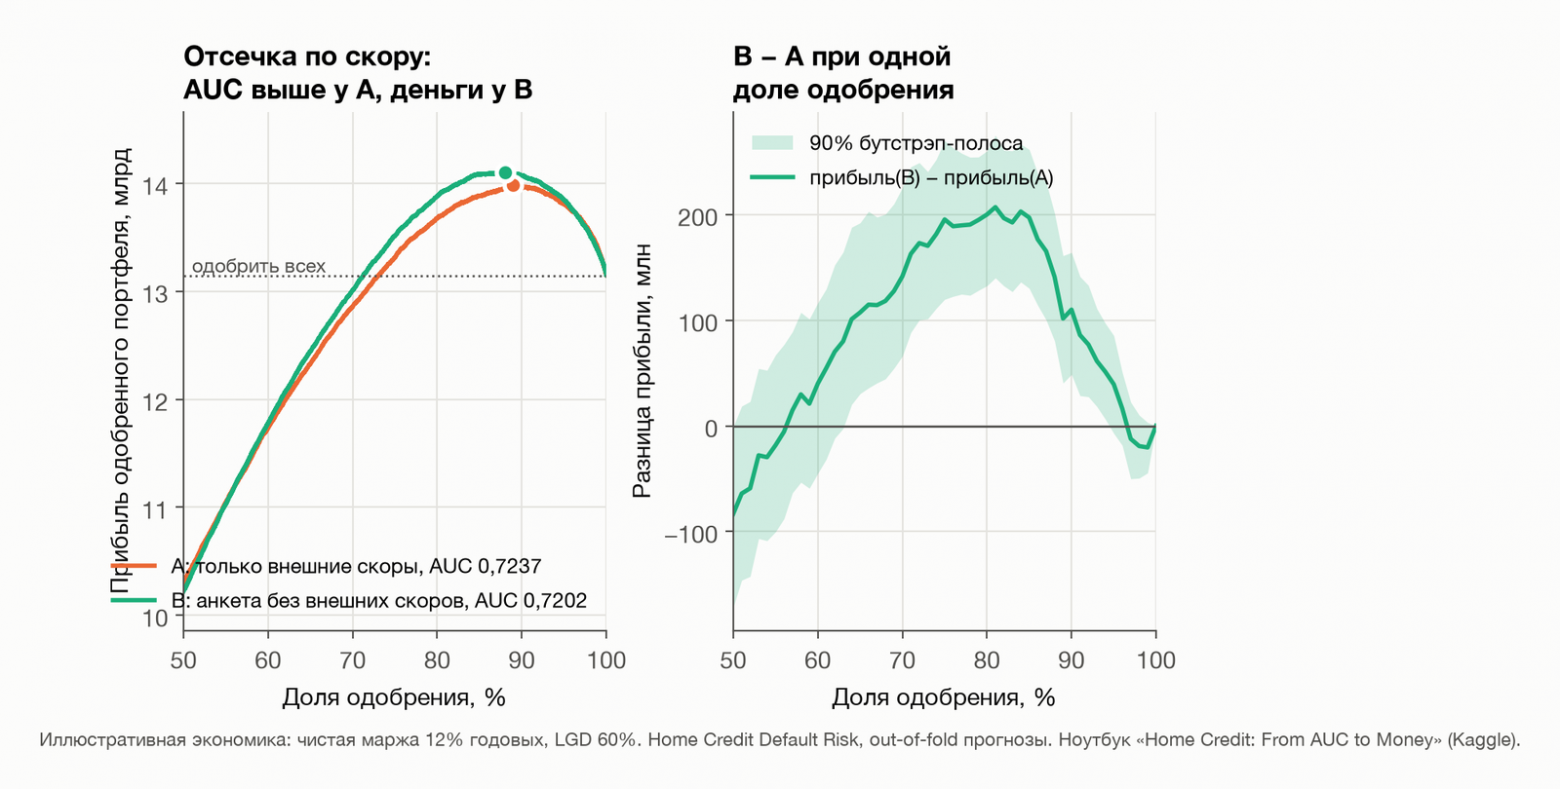
Две модели кредитного скоринга на открытых данных Home Credit. У модели A AUC выше, у модели B — ниже. При обычной отсечке «одобряем лучшие x %» B зарабатывает на 113 млн больше, и это не шум: B впереди в 200 из 200 бутстрэп-выборок. Как только решение принимается по каждому кредиту — откалиброванная PD × сумма × срок, — разрыв исчезает, а обе модели зарабатывают больше, чем при любой отсечке по скору. Ниже — почему так, сколько это стоит и что из этого следует для того, кто подписывает кредитную политику.
Я руковожу розничными кредитными рисками. В этой работе кредиты не одобряют «по AUC». Вопрос всегда один: где поставить отсечку и сколько заработает одобренный портфель. Весь код — в ноутбуке Home Credit: From AUC to Money — Cutoff Economics на Kaggle. Он самодостаточен: три модели обучаются внутри за несколько минут на CPU, экономические параметры лежат в одной ячейке, их можно поменять и перезапустить.
Сокращения. AUC (area under the ROC curve) — площадь под ROC-кривой, метрика качества ранжирования; Джини = 2·AUC − 1. PD (probability of default) — вероятность дефолта. LGD (loss given default) — доля потерь при дефолте. EAD (exposure at default) — сумма под риском, здесь сумма кредита. OOF (out-of-fold) — прогнозы на отложенных фолдах кросс-валидации. ДИ — доверительный интервал. п. п. — процентные пункты.
Данные и три модели
application_train.csv из соревнования Home Credit Default Risk: 307 511 заявок, доля целевого события 8,07 %. Три модели LightGBM на одних и тех же пяти стратифицированных фолдах, прогнозы OOF:
-
полная — 124 признака: поля анкеты и четыре отношения (срок = сумма / аннуитет, кредит / доход, аннуитет / доход, цена товара / кредит), AUC 0,7680;
-
A, «только внешние скоры» — три поля
EXT_SOURCE_1..3, самые сильные признаки соревнования, AUC 0,7237; -
B, «без внешних скоров» — все остальные 121 признак: сумма, аннуитет, срок, доход, возраст, занятость, документы, регион; AUC 0,7202.
Разница AUC между A и B — 0,0035 в пользу A (бутстрэп по заявкам, 90 % ДИ разницы B − A от −0,0072 до −0,0001). Разница маленькая, но знак устойчив по сидам обучения, и AUC, взвешенная суммой кредита, тоже предпочитает A: 0,7238 против 0,7145. По любой метрике ранжирования A лучше.
Экономика одного кредита
Модель намеренно простая и целиком иллюстративная — ни у какого банка параметры не взяты. Ставка 24 % годовых, стоимость фондирования 10 %, операционные расходы 2 %, итого чистая маржа m = 12 % годовых; LGD 60 %. Хороший кредит амортизируется до нуля, средний остаток — половина суммы, поэтому приносит m · EAD · T / 2. Плохой теряет LGD · EAD. Срок T — сумма, делённая на аннуитет, ограничен 6–60 месяцами; медиана 20 месяцев.
MARGIN = 0.24 - 0.10 - 0.02                      # ставка − фондирование − опер. расходы
LGD    = 0.60
EAD  = df["AMT_CREDIT"].values
TERM = (df["AMT_CREDIT"] / df["AMT_ANNUITY"]).fillna(20).clip(6, 60).values / 12   # лет

good = MARGIN * EAD * TERM / 2                   # доход, если кредит хороший
bad  = LGD * EAD                                 # потеря, если плохой
realised = np.where(y == 1, -bad, good)          # что кредит заработал бы, если одобрить
Из формулы следует точка безубыточности по PD для каждого кредита: PD < (m·T/2) / (m·T/2 + LGD). Медиана — 14,3 %, у 90 % кредитов — от 7,4 до 22,4 %. Порог зависит от срока: длинный кредит выдерживает более высокую PD. Это и есть ключ ко всей истории.
Если одобрить всех, портфель заработает 13,14 млрд в единицах датасета — 7,14 % от объёма выдач.
Результат: отсечка по скору
При каждой доле одобрения модель одобряет заявки с лучшим скором, прибыль считается по фактическим исходам. Это картинка в начале статьи.
B зарабатывает больше. В максимуме кривой разница +113 млн (90 % ДИ от +54 до +173 млн). Поточечно нижняя граница 90 % бутстрэп-полосы выше нуля на долях одобрения от 64 до 94 % — там, где лежат все разумные отсечки. Ниже 60 % одобрения модели идут вровень или A чуть впереди. При «привычных» 70 % одобрения B впереди на 151 млн (13,01 против 12,86 млрд).
Масштаб честно: 113 млн — это 0,8 % прибыли портфеля. Немного. Но это деньги, которые AUC записала бы в минус.
Почему AUC — не цель
AUC — вероятность того, что случайный плохой клиент получит скор хуже случайного хорошего. Она усредняет по всем порогам и считает всех клиентов равными.
Решение кредитора устроено иначе. Порог один или несколько по сегментам, поэтому важно ранжирование около него, а не везде. Клиенты не равны: отказ хорошему теряет его процентный доход, одобрение плохому теряет долю тела, обе величины пропорциональны сумме, а доход — ещё и сроку. Чтобы поставить отсечку по экономике, нужна вероятность, а не ранг, — а AUC к калибровке слепа. Цель — максимум прибыли одобренного портфеля при заданном аппетите к риску и капитале (последние два здесь за скобками).
Калибровка: скор → PD
LightGBM на log-loss обычно близок к откалиброванному, но «близок» надо проверять. На OOF-скорах полной модели — изотоническая регрессия и Platt scaling (логистическая регрессия на логите скора) с кросс-фитом: калибратор учится на четырёх фолдах и применяется к пятому, так что PD тоже остаётся OOF.
Сырые скоры уже хороши: ECE (expected calibration error, ожидаемая ошибка калибровки) по 20 бинам — 0,0035; изотоника доводит её до 0,0010, средняя PD 8,07 % против наблюдаемых 8,07 %. AUC при этом почти не меняется (0,7680 → 0,7674). В этом и проблема: по AUC не видно, верна ли PD.
Где оптимальная отсечка
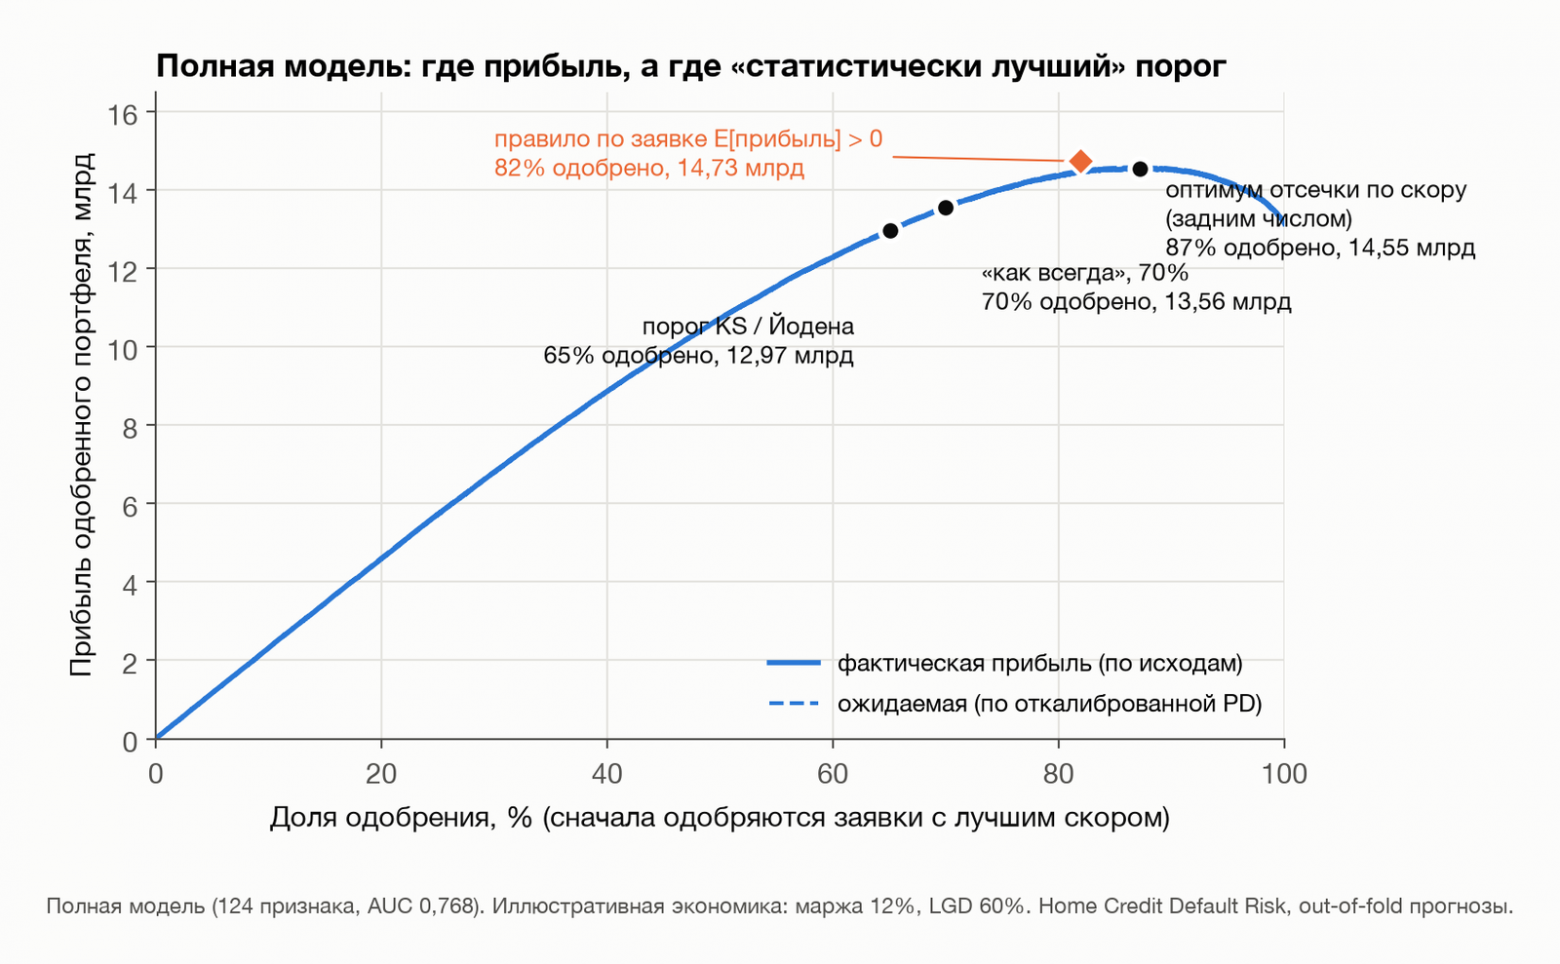
На полной модели: при каждой доле одобрения берём заявки с лучшим скором и суммируем фактическую прибыль, рядом — ожидаемую по откалиброванной PD.
|
Политика |
Одобрено |
Прибыль, млрд |
К оптимуму, млрд |
|---|---|---|---|
|
одобрить всех |
100 % |
13,14 |
−1,40 |
|
«по привычке», 70 % |
70 % |
13,56 |
−0,99 |
|
порог KS (Колмогорова — Смирнова) / Йодена, максимум разделения |
65,1 % |
12,97 |
−1,57 |
|
оптимальная единая отсечка (задним числом) |
87,2 % |
14,55 |
0 |
|
правило по заявке: E[прибыль] > 0 |
82,0 % |
14,73 |
+0,19 |
Фактическая и ожидаемая кривые почти совпадают — откалиброванной PD можно планировать, а не только ранжировать. Порог, который лучше всего разделяет хороших и плохих, одобряет сильно меньше, чем нужно для прибыли: разделение и деньги — разные цели, отказ хорошему стоит всей его маржи. Кривая плоская у вершины: несколько пунктов доли одобрения около оптимума стоят мало, отсечка далеко от него — много.
Главное — последняя строка. Единая отсечка «задним числом» подобрана на тех же данных и льстит себе. Правило E[прибыль] > 0 не использует исходы оцениваемых кредитов — только их OOF-PD, сумму и срок — и всё равно обыгрывает её на 0,19 млрд. Та же модель, другое правило решения.
expected = (1 - pd_oof) * good - pd_oof * bad   # ожидаемая прибыль кредита
approve  = expected > 0                          # правило по заявке
Та же AUC, неверная PD
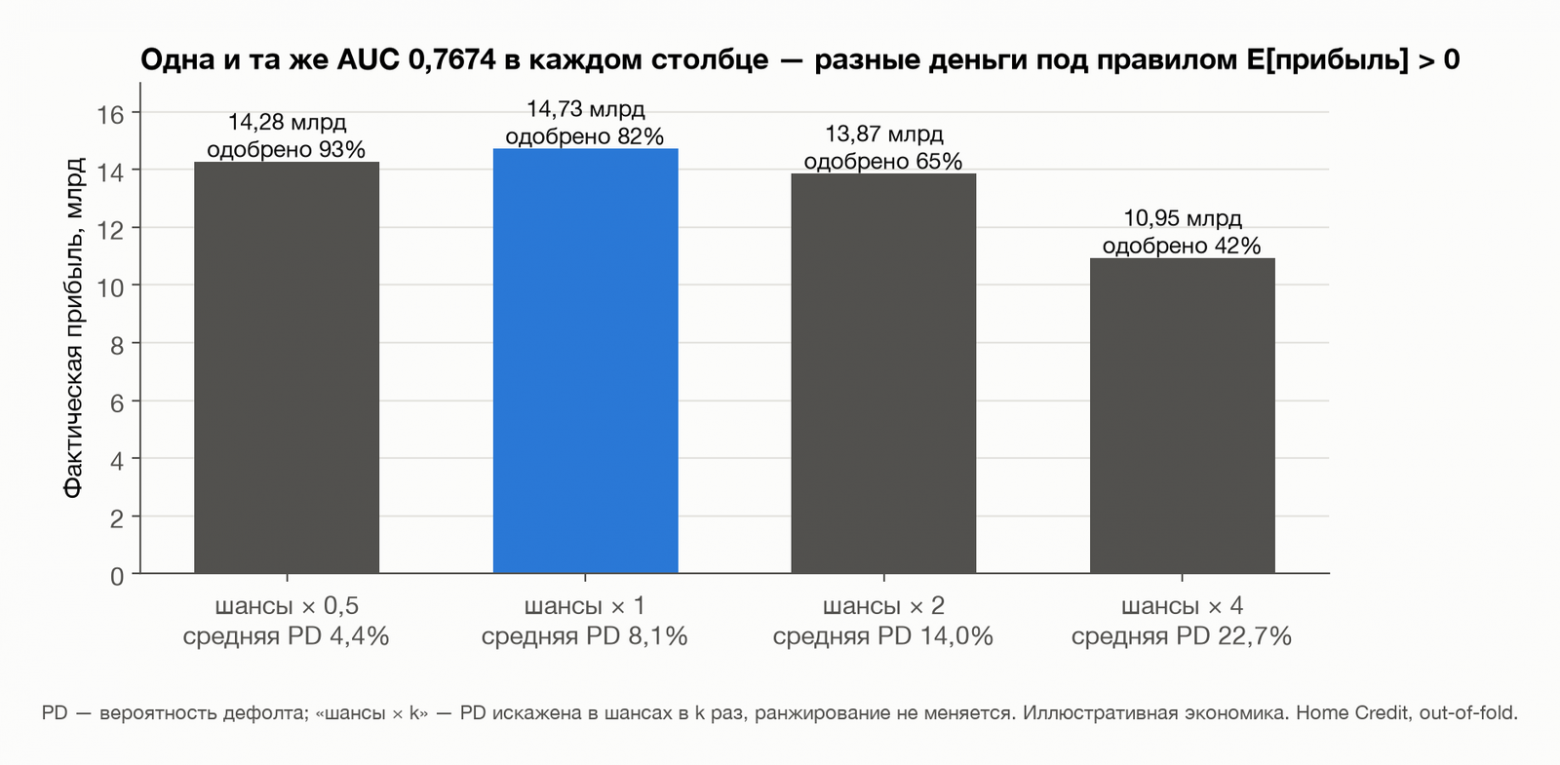
AUC не меняется при любом монотонном преобразовании скора. PD, смещённая в шансах в константу раз, имеет ровно ту же AUC. Так бывает после обучения с перевзвешиванием классов (scale_pos_weight, is_unbalance), которое забыли откатить, или после сдвига потока заявок. Правило, которое использует уровень PD, начинает работать с неверными числами.
|
PD в правиле |
AUC |
Средняя PD |
Одобрено |
Прибыль, млрд |
К откалиброванной, млрд |
|---|---|---|---|---|---|
|
шансы × 0,5 |
0,7674 |
4,4 % |
93,2 % |
14,28 |
−0,45 |
|
шансы × 1 |
0,7674 |
8,1 % |
82,0 % |
14,73 |
0 |
|
шансы × 2 |
0,7674 |
14,0 % |
64,6 % |
13,87 |
−0,86 |
|
шансы × 4 |
0,7674 |
22,7 % |
42,4 % |
10,95 |
−3,79 |
Одна AUC в каждой строке, разные деньги. Калибровка — то, что превращает ранжирование в решение. Отдельный разбор — в ноутбуке Home Credit: PD Calibration — AUC Is Not Enough.
Чувствительность: LGD ±10 п. п., маржа ±5 п. п.
LGD и маржа точно не известны никогда: взыскание дрейфует, фондирование идёт за ключевой ставкой.
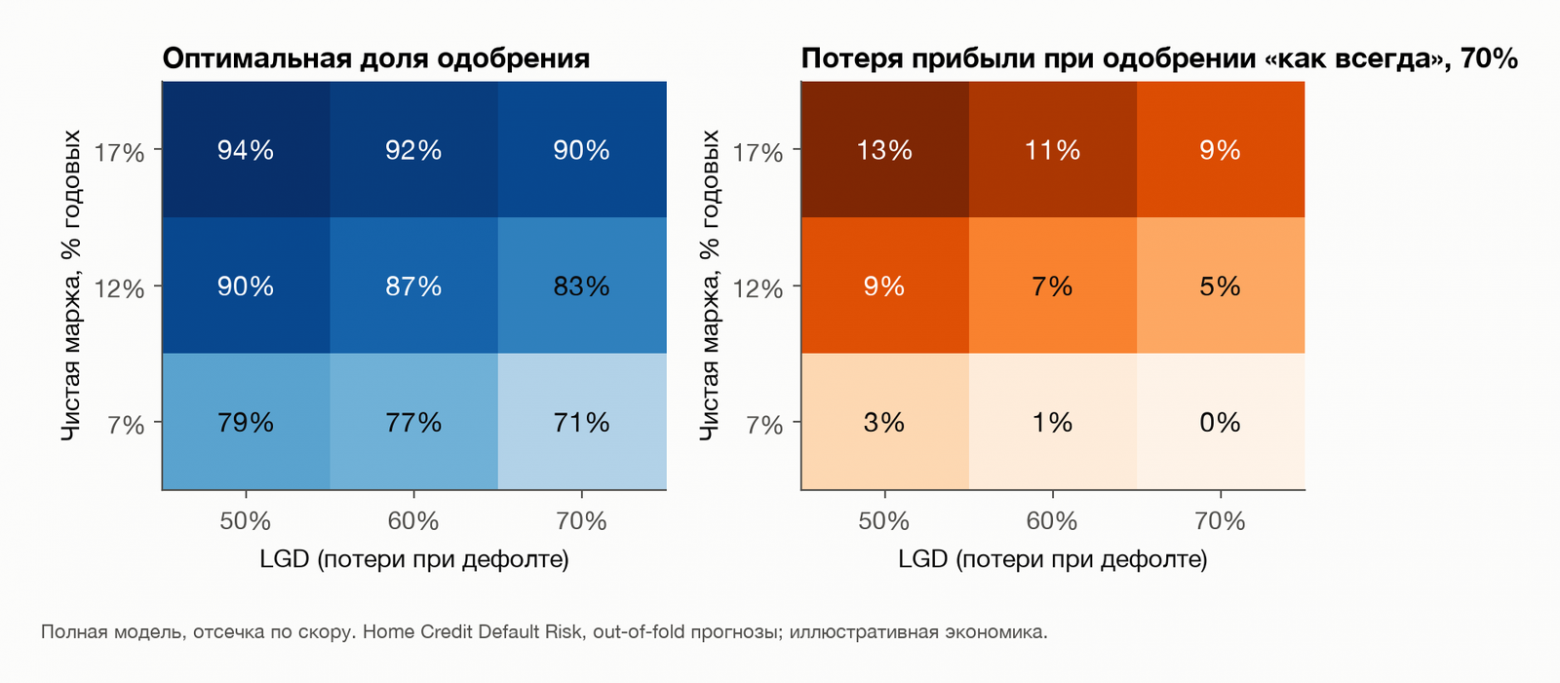
Оптимальная доля одобрения двигается вместе с экономикой: ±10 п. п. LGD сдвигают её между 83 и 90 %, ±5 п. п. маржи — между 77 и 92 %. Привычные 70 % теряют от 0 до 13 % оптимальной прибыли и дёшевы только там, где случайно оказались у оптимума. Отсечку пересчитывают, когда меняются фондирование или взыскание, а не наследуют от прошлогоднего кредитного комитета.
Откуда у B лишние деньги
При одной доле одобрения две модели одобряют в основном одних и тех же людей. Деньги делаются на swap set — кредитах, которые одна модель одобрила, а другая отклонила. При 88 % одобрения (оптимум B) это 17 % заявок — по построению поровну у каждой модели.
|
Группа |
Кредитов |
Доля плохих |
Средняя сумма |
Средний срок, мес. |
Доход, если хороший, % суммы |
Прибыль, млн |
|---|---|---|---|---|---|---|
|
одобрили обе |
244 549 |
4,9 % |
624 730 |
22,1 |
11,1 % |
+14 213 |
|
одобрила только A |
26 122 |
17,2 % |
490 988 |
18,5 |
9,2 % |
−259 |
|
одобрила только B |
26 122 |
17,8 % |
525 021 |
21,2 |
10,6 % |
−114 |
Обе группы «только одна модель» при такой доле одобрения убыточны, но B теряет меньше. Плохих у неё даже чуть больше; зато её лишние кредиты длиннее и крупнее и приносят больше, когда оказываются хорошими.
Механизм виден по срокам.
|
Срок, мес. |
Кредитов |
Доля плохих |
Средний скор A |
Средний скор B |
AUC A |
AUC B |
|---|---|---|---|---|---|---|
|
8–16 |
76 903 |
8,9 % |
8,7 % |
8,8 % |
0,7292 |
0,7495 |
|
16–20 |
80 220 |
7,8 % |
8,2 % |
7,9 % |
0,7192 |
0,7186 |
|
20–27 |
73 609 |
9,0 % |
8,2 % |
8,9 % |
0,7314 |
0,7261 |
|
27–45 |
76 779 |
6,6 % |
7,2 % |
6,5 % |
0,7040 |
0,6581 |
Внутри полос срока B ранжирует не лучше A, на самых длинных кредитах — заметно хуже. Её преимущество — между полосами. Длинные кредиты реже уходят в дефолт. B видит срок — он есть среди её признаков — и ставит им скор по фактической частоте; A длинные переоценивает, а полосу 20–27 месяцев недооценивает. Срок — множитель дохода, и AUC его не видит.
Когда разрыв исчезает
Переведём обе модели на правило по заявке: откалибруем скор каждой (кросс-фит изотоники) и одобрим, если E[прибыль] > 0.
|
Модель |
AUC |
Лучшая отсечка по скору (задним числом), млрд |
Правило по заявке, млрд |
Одобрено по правилу |
|---|---|---|---|---|
|
A: только внешние скоры |
0,7237 |
13,986 |
14,265 |
83,1 % |
|
B: без внешних скоров |
0,7202 |
14,099 |
14,258 |
82,5 % |
|
полная модель |
0,7680 |
14,547 |
14,733 |
82,0 % |
Разница между A и B исчезает: 14,265 против 14,258 млрд. Как только правило само учитывает срок, лучшее ранжирование A и знание срока у B гасят друг друга. Обе модели зарабатывают больше, чем при своей лучшей отсечке по скору: A — на 0,28 млрд, B — на 0,16. Полная модель бьёт обеих — больше информации по-прежнему выигрывает.
Поэтому заголовок верен только наполовину, и это главное. Модель с AUC ниже выиграла не потому, что ниже AUC лучше, а потому, что правило решения было слепым к сроку, а она — нет. Смена правила на той же модели принесла больше, чем вся разница между моделями.
Что из этого следует для руководителя риска
-
Челленджера принимать в деньгах и под тем правилом, которое реально запускается. Отчёт о новой модели — это кривая прибыли с бутстрэп-полосой в рабочем диапазоне одобрения и swap set: какие кредиты переходят из рук в руки и сколько они приносят. Прирост Джини — вторая строка, не первая.
-
Сначала правило решения, потом модель. Здесь замена модели A на B при отсечке по скору дала +0,11 млрд, а переход от отсечки к правилу по заявке на той же модели A — +0,28. Если отсечка не видит сумму и срок, деньги теряются на любой модели.
-
Калибровку мониторить так же, как ранжирование. Сдвиг PD вдвое в шансах не виден по Джини и стоит здесь 0,86 млрд. В регулярный мониторинг — график надёжности (предсказанная PD против наблюдаемой частоты) по свежим поколениям, а не только Джини и PSI.
-
Отсечку пересчитывать при движении фондирования и взыскания. ±5 п. п. маржи сдвигают оптимум на 15 п. п. одобрения. Когда меняется ключевая ставка, вопрос «где теперь отсечка» должен звучать на ближайшем кредитном комитете.
-
Точку максимального разделения (KS) не использовать как политику. Она отвечает на вопрос «где модель лучше всего отличает плохих», а не «где портфель больше всего зарабатывает». Здесь между ними 22 п. п. одобрения и 1,57 млрд.
Ограничения
Экономические параметры иллюстративные; предоплат, дисконтирования, комиссий, капитала и стоимости фондирования плохого кредита во время взыскания нет. TARGET в Home Credit — трудности с ранними платежами, а не полный дефолт; это поглощает LGD. Для револьверных продуктов (около 10 % строк) «срок» — лишь прокси. Ранняя остановка на том же фолде делает OOF AUC чуть оптимистичной; процедура одна для всех трёх моделей. Бутстрэп — по заявкам при фиксированных моделях, случайность обучения в полосу не входит. Данные и метод — настоящие; параметры меняются в одной ячейке ноутбука.
Продолжение — про дрейф потока заявок и пересчёт отсечки: Home Credit: PSI, Drift and Re-setting the Cutoff.
Ссылки. Соревнование Home Credit Default Risk. D. J. Hand, Measuring classifier performance: a coherent alternative to the area under the ROC curve, Machine Learning, 2009. T. Verbraken, C. Bravo, R. Weber, B. Baesens, Development and application of consumer credit scoring models using profit-based classification measures, EJOR, 2014. scikit-learn, Probability calibration. Мои ноутбуки и датасеты — kaggle.com/truenikita, сайт — ageev.dev.
Автор: big_ageev

