


ИИ выполнил задачу, но при просмотре изменений разработчик нашёл в решении лишнюю работу. Она могла остаться незамеченной: по его оценке, сама по себе эта проверка не вызвала бы ощутимого замедления игры.
На Reddit CTO студии PH3, пишущий под ником DuranteA, рассказал, как поручил ИИ-агенту распознавать последовательность действий для нового достижения. Агент корректно реализовал функциональные требования и проверил их, но добавил обход до 11 000 игровых сущностей на каждом кадре симуляции. По словам разработчика, ту же задачу можно было решить небольшим дополнением к существующей обработке и временным хранением максимум пяти элементов.
Автор оценил, что проверка потребляла бы как минимум в сто раз больше процессорного времени, чем требовалось. Речь об отдельном участке, а не о замедлении всей игры. После короткого объяснения агент смог реализовать более экономичный вариант.
Название модели и игры, код и воспроизводимые замеры в посте не приведены. Перед нами рассказ участника, а не независимый бенчмарк. Как именно агент проверял требования, автор тоже не уточняет. Для разбора здесь важен сам вопрос: сколько работы выполняет решение, которое даёт нужный результат?
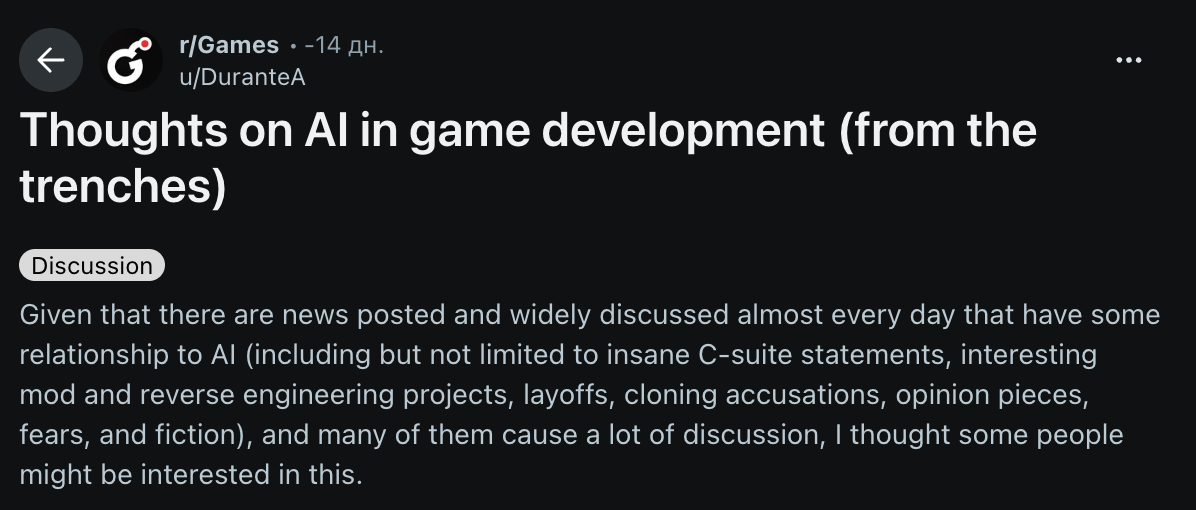
Как и следовало ожидать, агент правильно реализовал функциональные требования и протестировал их. Однако при просмотре изменений я заметил, что он добавил полный перебор примерно до 11 000 игровых сущностей на каждом кадре симуляции, чтобы проверять условия достижения. Того же результата можно было добиться с чуть более продуманной интеграцией: небольшим расширением существующего этапа обработки и дополнительным временным хранилищем максимум для пяти элементов. Это не было бы заметно при игровом тестировании: хотя, по моей оценке, такой вариант потреблял бы как минимум в 100 раз больше процессорного времени, чем необходимо, само по себе этого всё ещё недостаточно, чтобы существенно замедлить игру до заметного уровня. Но представьте, что то же самое повторяется в нескольких десятках функций и решений по реализации, — и замедление станет заметным.
Зелёная галочка отвечает только на свой вопрос
Допустим, тест проверяет выдачу достижения. Игрок выполнил нужные действия, игра засчитала результат. Тест прошёл.
Можно добавить обратную проверку: игрок выполнил не все действия, достижение не выдали. Ещё один успешный тест. Но среди этих проверок по-прежнему нет вопроса, сколько раз программа перебирала данные, прежде чем принять решение.
Функциональные проверки нужны, но сами по себе не устанавливают предел затрат на выполнение. При оценке сгенерированного патча этот предел приходится проверять отдельно.
Патч с реализацией, проверками и подробным объяснением легко принять за законченную работу. Если возражение касается производительности, придётся показать, какую цену платит остальная система и почему этих затрат можно избежать.
На это требуется больше знания проекта, чем на чтение одной функции. Откуда берутся данные? Кто уже их обработал? Что изменилось с прошлого вызова? Можно ли доверять накопленному состоянию после загрузки сохранения? Самые важные ответы могут находиться совсем не в тех файлах, которые агент изменил.
Маленькая функция с большим расписанием
Разберём условный пример, не относящийся к игре из поста. Если функция обходит 5 000 объектов 60 раз в секунду, получается 300 000 посещений объектов за секунду. По этой цифре нельзя вычислить потерянные кадры: неизвестны ни содержимое проверки, ни устройство данных, ни железо. Зато понятно, что смотреть только на длину функции бессмысленно.
Одинаковый цикл при загрузке уровня и в каждом обновлении симуляции имеет совершенно разную цену. Ревью небольшого изменения поэтому полезно начинать на шаг раньше: с места вызова.
При этом полный обход не обязательно плох. Для редкой операции он может быть самым простым и надёжным решением. Попытка заменить его системой событий приносит свои расходы: нужно восстанавливать состояние, учитывать повторные события, следить за порядком обработки. Иногда эта сложность обойдётся дороже сэкономленных операций.
Хорошее замечание на ревью должно объяснять, почему выбранный способ не подходит именно здесь. Универсальное «перепиши на события» способно породить следующий патч, который тоже придётся разбирать.
Сто раз быстрее внутри одной функции
Крупный коэффициент легко прочитать как характеристику всей программы. Между тем для игрока важны абсолютное время и место работы в общем процессе. Покажем разницу на условных числах, которые ничего не сообщают о производительности игры PH3.
-
Представим, что последовательная обработка одного обновления занимает 10 миллисекунд. Из них 0,1 миллисекунды уходит на нашу проверку. Мы ускорили только её ровно в сто раз: теперь она требует 0,001 миллисекунды. Общее время сократилось с 10 до 9,901 миллисекунды, то есть на 0,99%. В отчёте об отдельной функции можно честно написать «100x», но вся обработка стала быстрее примерно на один процент.
-
Теперь предположим, что такая же проверка занимала пять миллисекунд из десяти. После того же ускорения всего обновления потребуется 5,05 миллисекунды. Выигрыш уже почти двукратный. Коэффициент оптимизации одинаковый, итог для программы совершенно разный.
Поэтому рядом с «во сколько раз» нужно спрашивать «сколько времени». И ещё: на каком устройстве, в какой сцене, при каком количестве объектов. Один большой коэффициент не позволяет решить, насколько срочно исправление.
Для ориентира: при 60 обновлениях в секунду между ними проходит примерно 16,67 миллисекунды. Это арифметика целевой частоты, а не универсальный лимит для одной функции. В реальном движке работа может распределяться между потоками, CPU и GPU, а частота симуляции может отличаться от частоты вывода изображения. Складывать времена любых участков и объявлять полученную сумму временем кадра нельзя.
Но для ревью достаточно более простого наблюдения: запас производительности конечен. Если новая функция расходует его, стоит понимать, что именно она покупает за это время. Иногда это простота реализации, которую команда сознательно выбирает. Иногда — повторный расчёт того, что уже известно.
Почему одного среднего значения мало
Допустим, профилировщик показал приемлемое среднее время проверки. Что в этот момент происходило в игре? Игрок шёл по пустому коридору или вошёл в область с большим количеством объектов? Сколько было активных сущностей, а сколько всего загруженных? Выполнялась ли проверка после получения достижения?
Без этих условий число сложно использовать при следующем изменении. Через месяц сцена вырастет, и сравнить результаты будет не с чем.
Разумный минимум для такого участка выглядит приземлённо: сохранить воспроизводимую сцену, записать число вызовов и проверить время на обычной и более тяжёлой нагрузке. Сравнивать старую и новую версии следует в одинаковых условиях. Если измерение шумит сильнее предполагаемого выигрыша, вывод об ускорении пока делать рано.
Важно посмотреть и на отдельные длинные обновления. Среднее по минуте способно скрыть редкую задержку: остальные вызовы прошли быстро и сгладили её в итоговом числе. Для игрока эта задержка всё равно произошла. Понадобится выяснить, совпала ли она с проверяемой функцией или с другой работой, прежде чем приписывать ей причину.
Такое измерение даёт ревьюеру возможность сказать не просто «цикл подозрительный», а «при таких условиях он вызывается столько-то раз и занимает столько-то времени». Вторую формулировку проще проверить, оспорить или принять. Она полезна даже тогда, когда выяснится, что оптимизация пока не нужна.
Быстрая проверка тоже может ошибаться
Вернёмся к предложению не перебирать мир заново, а хранить небольшой объём промежуточных данных. В общем случае это означает, что система должна помнить существенные события. Она тратит меньше времени на повторный поиск, но теперь отвечает за правильность своей памяти.
Представим условное достижение за подбор трёх разных предметов. Самое очевидное решение: при подборе записывать идентификатор предмета, затем проверять количество уникальных записей. На обычном прохождении всё понятно. Интереснее посмотреть, что происходит вокруг него.
Игрок подобрал два предмета, сохранился и вышел. При следующем запуске прогресс нужно откуда-то восстановить. Если записи жили только в оперативной памяти, система забудет первые два подбора. Если прогресс загружается отдельно от состояния мира, нужно убедиться, что они относятся к одному сохранению.
Другая ситуация: обработчик дважды получил уведомление об одном предмете. Простой счётчик может выдать достижение раньше времени. Набор уникальных идентификаторов защитит от такого повтора, но только если идентификатор действительно обозначает нужную сущность по правилам достижения.
Третья: игрок загрузил старое сохранение. Должен ли прогресс откатиться вместе с миром? Ответ зависит от дизайна: достижение может учитывать одну попытку, всю кампанию или всё время игры в аккаунте. Ни скорость выполнения, ни успешная компиляция не помогут выбрать правильное правило.
Наконец, при повторном запуске уровня старые обработчики могут остаться зарегистрированными. Тогда новое событие попадёт сразу в несколько мест. Это уже вопрос жизненного цикла объектов: когда создаётся проверка, когда отключается и что сохраняет между запусками.
Все эти ситуации вымышленные и не описывают реализацию PH3. Они показывают, почему замена полного обхода на накопление состояния требует новых проверок. Сократить работу процессора иногда легко. Убедиться, что сокращение ничего не потеряло, сложнее.
Когда останавливать секундомер
Если использовать агентов в команде, стоит заранее договориться, когда считать работу сделанной.
Если остановить секундомер на первом работающем варианте, дальнейшее ревью окажется за пределами расчёта. Там же останутся исправления, повторные тесты и попытки понять решение через месяц. Получится прекрасная скорость производства патчей и неизвестная скорость выпуска продукта.
Полезнее считать весь путь до принятого изменения. Сколько заняла постановка задачи, сколько пришлось проверять, сколько раз переделывать? Удалось ли сохранить понятную структуру проекта? Может ли другой разработчик продолжить работу без повторного расследования?
Время проверки следует учитывать наравне со временем написания кода, даже если проверяет другой человек. Иначе автор изменения быстро закрывает задачи, а ревьюер не успевает разбирать допущения в каждом патче. Число подготовленных изменений растёт, но они ждут приёмки.
Чей час удалось сэкономить
Возьмём условную задачу: раньше реализация занимала два часа, проверка — ещё полчаса. Всего два с половиной часа работы команды.
С агентом подготовка запроса и получение патча заняли полчаса. Если на проверку и исправления потребовался ещё час, итог составит полтора часа. Экономия есть: час на задачу. Если же проверка с исправлениями заняла два часа, общего выигрыша уже нет, хотя готовый код появился в четыре раза быстрее.
Это не прогноз окупаемости и не оценка конкретной модели. Такой расчёт просто оставляет в поле зрения обе стороны работы. Причём человеко-часы и календарное время могут расходиться: полчаса ревью у занятого специалиста иногда приходится ждать до завтра.
Для пробного внедрения полезно выбрать несколько сопоставимых задач, а не единственную удачную. Отдельно записать время автора и ревьюера, число возвратов и то, удалось ли принять изменение. Сложность задач и знакомство исполнителя с проектом тоже имеют значение: без этого различия легко приписать агенту то, что объясняется другой работой.
Цель такой проверки — понять, какие задачи уже можно отдавать инструменту и где нужен более подробный план до генерации. Возможно, хорошо пойдут локальные изменения с понятными входами и выходами. Возможно, именно ваш проект потребует больше подготовки. Это предстоит выяснить на собственных условиях, а не принять из чужой красивой демонстрации.
Разработчику кажется, что быстрее. А секундомеру?
У разговора о сэкономленном времени есть неприятная особенность: человек не может одновременно выполнить одну и ту же незнакомую задачу двумя способами. Закончив с агентом, он сравнивает затраченное время с представлением о том, сколько потратил бы сам. Убедительное ощущение — ещё не контрольный замер.
В исследовании METR от 10 июля 2025 года участвовали 16 опытных разработчиков, работавших в знакомых им open-source-проектах. Они предложили 246 реальных задач: исправления ошибок, новые функции и рефакторинг. Для каждой задачи случайно определяли, разрешено ли использовать ИИ. Сравнивали время выполнения, а не количество сгенерированного кода.
В этой выборке задачи с разрешённым ИИ заняли на 19% больше времени. При этом после эксперимента разработчики оценивали его влияние как ускорение примерно на 20%. Расхождение возникло не между обещанием продавца и мнением скептика: участники уже выполнили работу и всё равно иначе оценивали её длительность относительно варианта без ИИ.
Это не означает, что разработчики намеренно приукрасили результат. Исследование показывает расхождение оценки и измерения, но не позволяет по одному этому факту установить мотивы каждого человека.
Границы вывода здесь существенны. Шестнадцать разработчиков не представляют все команды, а знакомый большой репозиторий — не то же самое, что первый прототип или работа в незнакомом стеке. Измерялись инструменты начала 2025 года. Переносить 19% на сегодняшние модели, всех программистов или кейс PH3 нельзя.
История получила продолжение. В обновлении от 24 февраля 2026 года METR сообщила, что повторный эксперимент даёт ненадёжный сигнал о текущем влиянии ИИ на производительность. Всё больше разработчиков не хотели участвовать, если ради этого требовалось часть задач выполнять без ИИ. Сами задачи тоже стали отбирать: некоторые не попадали в эксперимент именно потому, что участники рассчитывали особенно сильно выиграть от помощи агента.
Добавились другие ограничения. Оплата участия стала ниже, что могло повлиять на состав выборки. При параллельной работе нескольких агентов участникам было трудно точно распределять затраченное время по задачам. METR сочла эти проблемы достаточно серьёзными, чтобы менять дизайн исследования.
Поэтому из обновления нельзя честно вынести определённый процент нынешнего ускорения. Но и результат 2025 года оно не превращает в вечный закон о бесполезности ИИ. Получить новую сопоставимую оценку оказалось сложнее, чем снова раздать задачи и включить секундомер.
Как не подстроить свой эксперимент под любимый ответ
Для команды это повод заранее записать правила пробного внедрения. Не обязательно устраивать научное исследование на каждую подписку. Достаточно понимать, в каких местах собственное сравнение легче всего обманет нас.
Первое место — выбор задач. Если агенту отдать только привычные небольшие исправления, а в группу «без ИИ» сложить аварии и незнакомую архитектуру, разница во времени почти ничего не скажет об инструменте. Обратный перекос тоже возможен: попробовать агента исключительно там, где человек уже застрял, и объявить его медленным. Это примеры возможных ошибок внутреннего сравнения, а не описание того, как работали участники METR.
Второе — повторное решение. Допустим, сначала разработчик разбирает ошибку сам, а затем просит агента исправить её по готовому объяснению. Второй заход получает найденную причину, проверенные предположения и знание тупиков. Такое упражнение полезно для проверки генерации патча, но плохо отвечает на вопрос, кто быстрее нашёл бы решение с нуля. Для сравнения полного процесса нужны разные, достаточно похожие задачи, а различия между ними всё равно придётся учитывать.
Третье — работа, которая исчезла из отчёта. Условный агент готовит патч двадцать минут; человек в это время отвечает на сообщения, затем пятнадцать минут проверяет результат. Здесь есть и календарная длительность, и занятость разработчика. Если записать только пятнадцать минут, потеряется ожидание. Если записать всё время как непрерывную работу человека, потеряется возможность заниматься другим делом. Лучше сохранить обе величины, чем смешать их в одно эффектное «ускорение».
Наконец, нужно решить, что делать с неудачными попытками. Если пять задач удалось закончить с агентом, а шестую пришлось бросить и переписать вручную, её время тоже относится к опыту внедрения. Отчёт только об удачных патчах отвечает на вопрос «как быстро бывает при успехе». Руководителю, который распределяет работу следующей недели, нужна ещё и цена неудачи.
Такой разбор не выдаст универсального победителя. Зато позволит отделить несколько разных результатов: код появился быстрее; разработчик потратил меньше собственного времени; изменение раньше приняли; работа стала приятнее. Все четыре могут быть ценными, но подставлять одно вместо другого в расчёте экономии нельзя.
До покупки подписки
У подписки есть цена, у тарифа есть лимиты, у модели есть длина контекста. Эти характеристики удобно сравнивать. А сколько времени понадобится вашему коллеге, чтобы принять результат, на странице покупки не написано.
Перед покупкой подписки для команды полезно выбрать типовую задачу и договориться о критериях приёмки. Например: изменение проходит существующие тесты, не добавляет необоснованной работы в часто вызываемом участке и понятно человеку, который будет его сопровождать.
Такой пробный запуск может показать, что инструмент действительно снимает рутину. Может обнаружить и другую картину: написать стало быстрее, а принять результат труднее. Обе полезнее обещания окупить подписку за счёт количества сгенерированных строк.
Участие опытного разработчика тоже нужно закладывать в расчёт. Если ему выделили время только на беглый просмотр, наличие этого человека в команде ещё не означает, что результат проверен.
Если используете ИИ-сервисы для работы с кодом, с оплатой или продлением подписки поможет Raketa Pay.
Выпустить сейчас или переделать
Вопрос «кто написал этот код?» вряд ли исчезнет. Но для конкретного изменения рядом с ним нужны более скучные вопросы: где оно выполняется, как часто, на каких данных и кто проверил эти предположения. На них должен отвечать и человек, и агент.
Представим, что до релиза день, функция ведёт себя правильно, а её лишняя работа укладывается в текущий бюджет производительности. Ревьюер просит переделать реализацию, автор предлагает выпустить её сейчас и вернуться к оптимизации позже. Срочная переделка требует повторной проверки; отложенная рискует остаться в проекте надолго.
РАБОТАЕТ — НЕ ТРОГАЙ.
У решения «оптимизируем потом» могут быть разумные основания. Например, команда измерила нагрузку на целевом устройстве, запас достаточный, а переделка затрагивает сохранения, которые не успеют проверить. Но тогда «потом» полезно превратить в конкретное условие возврата к задаче: рост сцены, новая целевая платформа или превышение согласованного времени обработки. Само наличие записи в трекере не создаёт времени на исправление.
Ревьюер тоже должен обосновать срочность. Если претензия сводится к тому, что функцию можно написать красивее, это один разговор. Если она регулярно делает ненужную работу, которая будет расти вместе с контентом, — другой. Даже во втором случае стоит сопоставить цену исправления сейчас с риском изменения перед выпуском.
От такой конкретики спор становится менее удобным: уже нельзя закончить его словами «преждевременная оптимизация» или «технический долг». Придётся назвать нагрузку, допустимое время и последствия решения. Зато после этого у команды появится основание принять патч или вернуть его автору.
Кто-то назовёт задержку релиза из-за такого участка перфекционизмом. Кто-то увидит в принятом патче разрешение приносить следующие точно так же. Обе позиции понятны. Команде всё равно придётся решить, какой риск она готова принять.
Автор: Vadim_01R

