


При жадном выборе следующего токена (T = 0) рассуждающая модель DeepSeek-R1-Distill-Qwen-1.5B (1.78 млрд параметров в формате BF16) часто застревает в повторной перепроверке уже найденных шагов внутри <think>...</think>, исчерпывая бюджет вплоть до предела 32 768 токенов. Даже при рекомендованном сэмплировании (T = 0.6, top_p = 0.95) в математике и программировании сохраняется заметная доля незавершённых ответов. Можно ли снизить число незавершённых рассуждений малой статической поправкой к самим весам — без дообучения, без штрафа за повторы и без изменения кода инференса?
Настоящая работа переносит метод SGNE-CC (Spherical Gated Norm-preserving Edit, Column-Constrained), ранее проверенный на гибридной Qwen3.5-0.8B (DOI: 10.5281/zenodo.24235218, dna-weight-editing), на чистый трансформер другого семейства (DeepSeek-R1-Distill-Qwen-1.5B) в виде SGNE-CC v2 и сокращает объём правки почти на порядок — с 1 984 столбцов (802 + 1 182) и одной строки ворот до 205 столбцов mlp.down_proj (0.0177% параметров). Исходная и исправленная модели сравниваются при бюджете до 32 768 новых токенов на пяти бенчмарках (MATH-500, MBPP, HumanEval, ARC-Challenge, BBH Logic, всего 1 054 задачи) при двух общих для обеих моделей температурах — T = 0 и T = 0.6 (исправленная модель дополнительно оценена при T = 0.3).
1. Геометрия поправки: 205 столбцов mlp.down_proj
Прежде чем вносить правку, мы проверили, где именно внутри модели замыкается цикл самокопирования и какие матрицы можно менять без ухудшения обычного текста.
Асимметрия голов внимания. Сопоставление всех 336 голов (28 слоёв × 12 голов) на 32 зацикленных и 32 штатно завершённых математических трассах (64 задачи MATH-500) выявляет резкую локализацию: все 12 голов с наибольшим ростом внимания к собственным повторам (+29 … +67 п.п.) лежат в первой группе KV Group 0 (H0–H5). В голове L23 H04 внимание к условию задачи падает с 31% до 0.3% (примерно в 100 раз), а у четырёх ведущих голов (L23 H04, L19 H03, L19 H05, L14 H03) доля внимания к повторам достигает 67–83%. При этом в предварительных пробах составные вмешательства, затрагивавшие входные ворота gate_proj и выходную проекцию, снижали совпадение следующего токена на обычном тексте с 99% до 78%, поэтому слои внимания, нормировки, gate_proj и up_proj оставлены нетронутыми.
Отбор 205 столбцов и нормосохраняющий (сферический) поворот. В блоке SwiGLU вклад  -го столбца
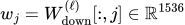 умножается на
 , поэтому столбец, у которого вход вентиля
 отрицателен в обычном тексте и положителен в повторе, фактически работает только во время повторов. По малому набору математических трасс (
6 + 6 при отборе пунктуационной группы и 8 + 6 при подборе размера; все 26 задач отдельно исключены в §2, а 554 задачи остальных четырёх бенчмарков в отборе не участвовали) отобраны две непересекающиеся группы:
-
Границы строк (
135столбцов, слоиL18–L27): активны на токенах с переводом строки (включаяnn) в повторе и подавлены внутри фраз и после</think>. -
Знаки препинания (
70столбцов, слоиL19–L27): активны на.,?,!внутри повторяющихся абзацев без переносов (средний вход вентиля+0.85против−1.41на обычной пунктуации и−1.81после</think>).
Каждый столбец поворачивается к единичному вектору закрытия рассуждения 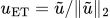 , где
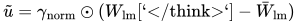 и
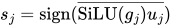 , с точным восстановлением исходной нормы
 перед округлением в
BF16:
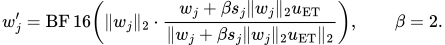
|
Параметр весовой поправки ( |
Исходная модель |
|
|---|---|---|
|
Всего параметров ( |
|
|
|
Изменённых столбцов |
|
|
|
Скаляров в области правки / изменившихся в |
|
|
|
Углы поворота / среднее отношение норм |
|
|
|
Изменения внимания, |
нет |
нет |

2. Математика (MATH-500 после исключения 26 задач отбора и 53 задач анализа голов)
Начинаем с области, в которой отбирались 205 столбцов: сначала проверяем, снижает ли поправка число незавершённых ответов при жадном выборе (T = 0) и при рекомендованном сэмплировании (T = 0.6), затем проверяем срез после исключения калибровочных и исследовательских задач и оцениваем температуру T = 0.3.
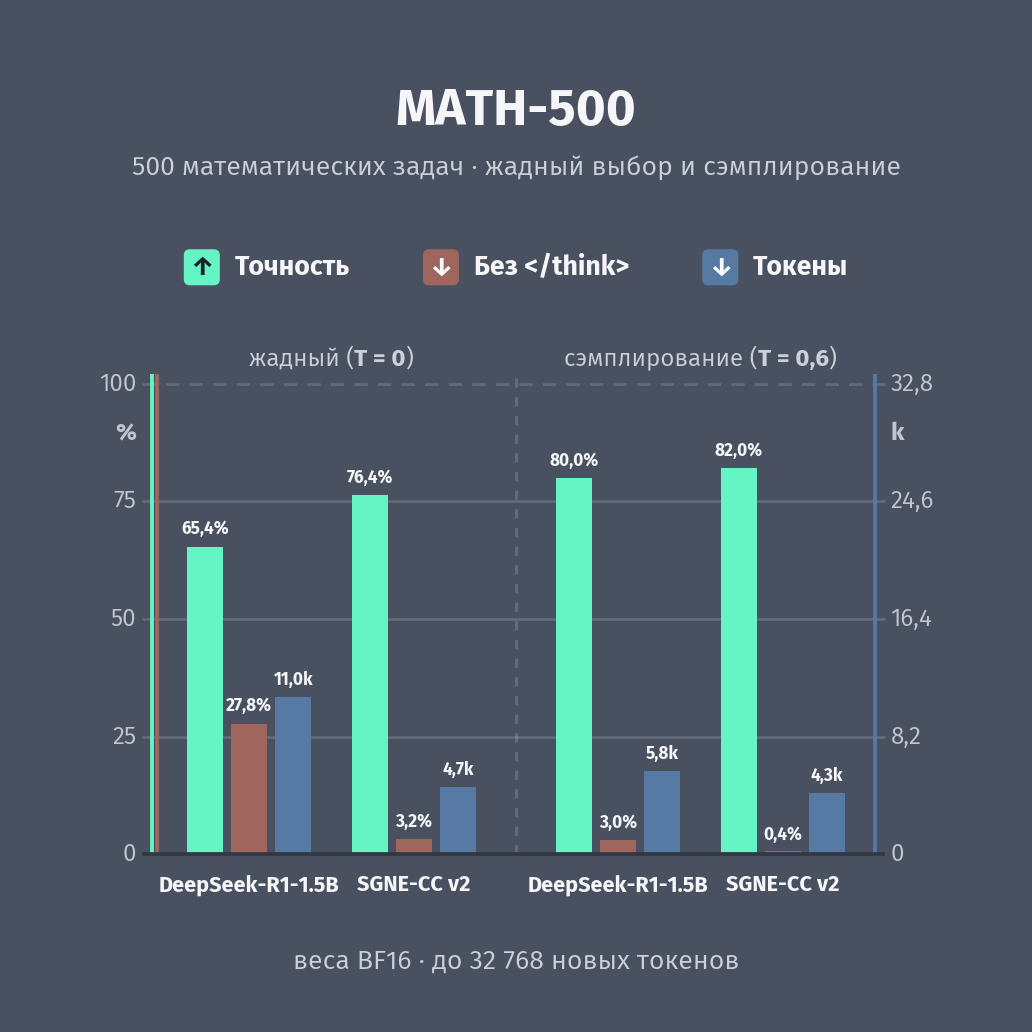
Рис. 1. При нулевой температуре поворот 205 столбцов снижает число незавершённых рассуждений на MATH-500 и перекрывает три четверти разрыва до стохастического сэмплирования. Полный набор MATH-500 (500 задач), vLLM 0.34.0, BF16, бюджет до 32 768 новых токенов, presence_penalty = 0. Ответам без закрывающего маркера </think> присваивается ноль.
При жадном выборе число ответов без </think> сократилось со 139 до 16, без EOS — также со 139 до 16 (у исправленной модели оба маркера одновременно отсутствуют в 12 ответах). Средняя длина сократилась с 11.0 до 4.7 тыс. токенов. Исправленная модель решила 74 задачи, на которых исходная ошибалась, и потеряла 19 прежних решений (точный критерий Мак-Немара, 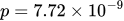 ). При
T = 0.6 число верных ответов выросло с 400 до 410, но это различие статистически незначимо (+33 / −23,  ); число ответов без
</think> снизилось с 15 до 2, средняя длина — с 5.8 до 4.3 тыс. токенов.
Проверка исключения калибровочных и исследовательских задач.
-
Без
26задач подбора столбцов (474задачиMATH-500): приT = 0точность растёт с310до363(+70 / −17,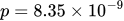 ); при
T = 0.6соотношение сохраняется ( ).
-
Дополнительное исключение
53задач из анализа голов внимания (421задача): из64задач раннего исследования голов (32 + 32в §1)53входили в те474задачи. На оставшихся421задаче результат сохраняется: приT = 0точность растёт с276до321(+60 / −15,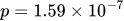 ), при
T = 0.6— с337до346(+29 / −20, ).
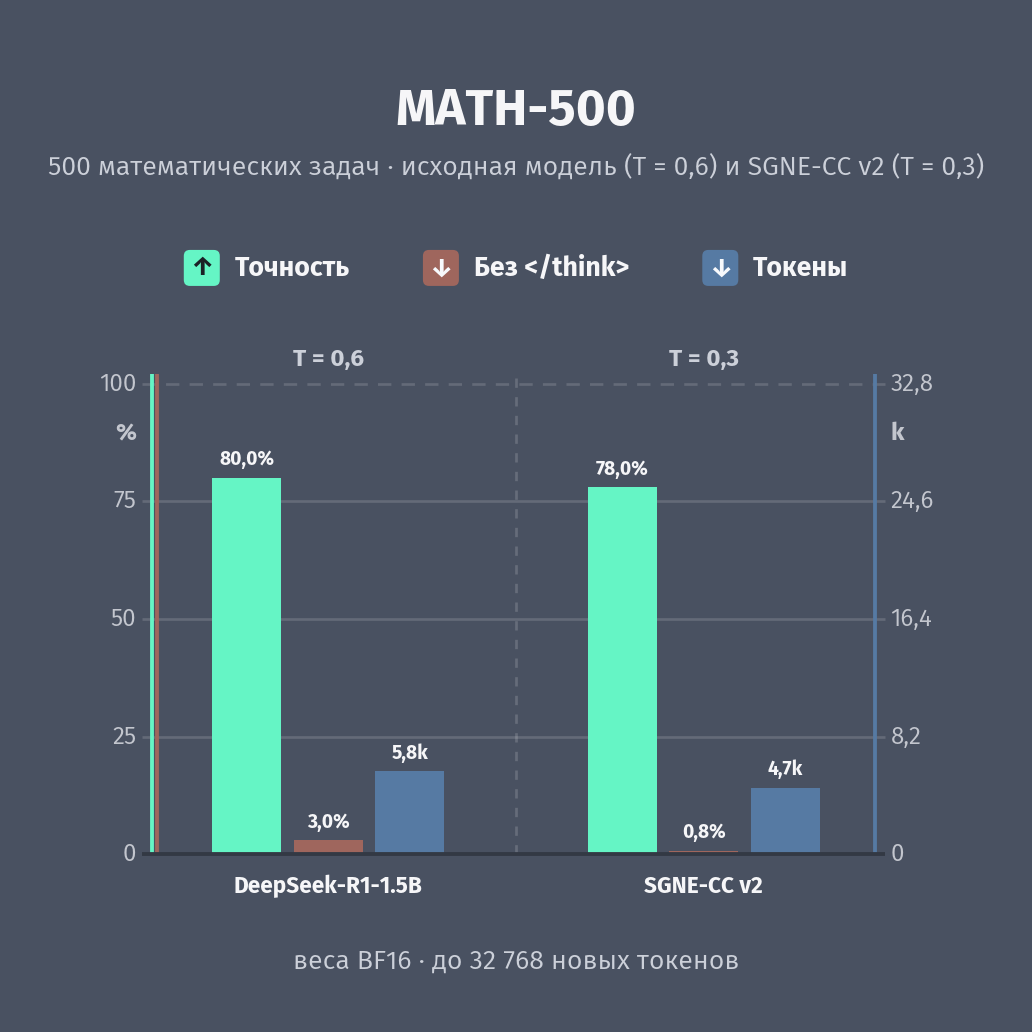
Рис. 2. Понижение температуры исправленной модели до T = 0.3 удерживает почти полное закрытие рассуждений, но не даёт преимущества по точности над исходной моделью при T = 0.6. Сопоставление двух режимов, различающихся одновременно весами и температурой (top_p = 0.95, seed = 42, 500 задач MATH-500; исходная модель при T = 0.3 не измерялась).
У исправленной модели незакрытыми остались 4 рассуждения при T = 0.3 и 2 при T = 0.6; у исходной модели при T = 0.6 их было 15. В паре «исправленная при 0.3 — исходная при 0.6» баланс верных решений составил +29 / −39 ( ; после исключения
26 задач подбора  ). Из двух температур исправленная модель решила больше задач
MATH-500 при 0.6.
3. Перенос на программирование (MBPP и HumanEval)
Оба кодовых набора в отборе 205 столбцов не участвовали. Здесь проверяется, сохраняется ли эффект при генерации исполняемого кода Python и не портит ли поворот столбцов синтаксис. В MBPP в тексте задачи показаны первые 3 проверки (assert), а оценщик исполняет весь test_list (3 проверки в 116 задачах, 4 в № 58, 223, 226, 5 в № 172 — показано 360, исполнено 365); в HumanEval решение проверяется на скрытом наборе модульных тестов test.
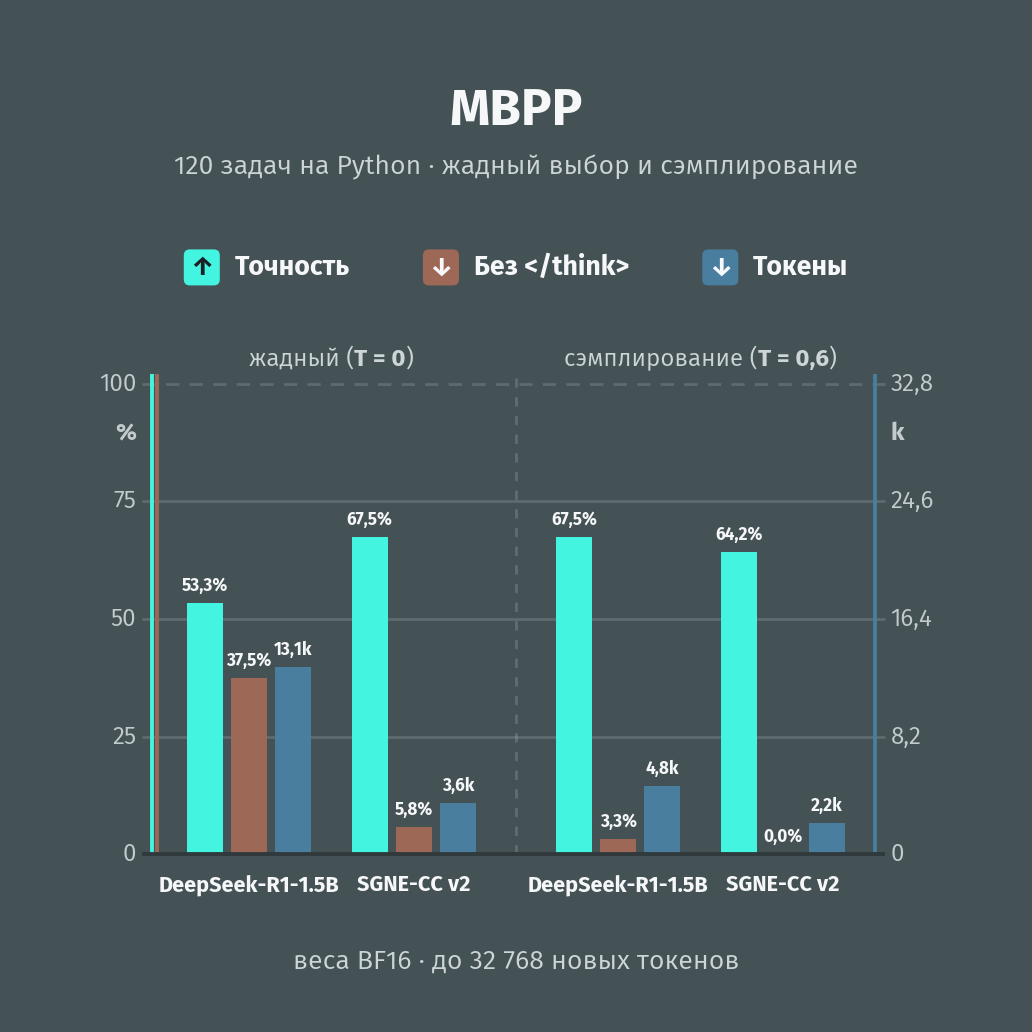
Рис. 3. На MBPP при T = 0 правка поднимает жадный режим до 81/120 — уровня исходной модели при T = 0.6 — при ответах в 3.7 раза короче, чем у исходной модели при T = 0 (и в 1.34 раза короче, чем у неё же при T = 0.6); при T = 0.6 исправленная модель решает на четыре задачи меньше (различие незначимо). 120 задач MBPP, исполнение в изолированной среде Python всего test_list, BF16, бюджет до 32 768 токенов.
При T = 0 число незакрытых ответов сократилось с 45 до 7. На 40 задачах исходная модель оставила рассуждение открытым, а исправленная его завершила. В 20 из этих случаев программа прошла проверки. По всем 120 задачам поправка дала 21 новое решение и 4 потери (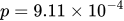 ). Средняя длина снизилась с
13.1 до 3.6 тыс. токенов (в 3.7 раза), а относительно исходной модели при T = 0.6 — в 1.34 раза. При T = 0.6 число незакрытых ответов снизилось с 4 до 0, средняя длина — с 4.8 до 2.2 тыс. токенов. Исходная модель решила 81 задачу, исправленная — 77 (+7 / −11,  ). Сравнение проведено при одном начальном значении генератора случайных чисел.
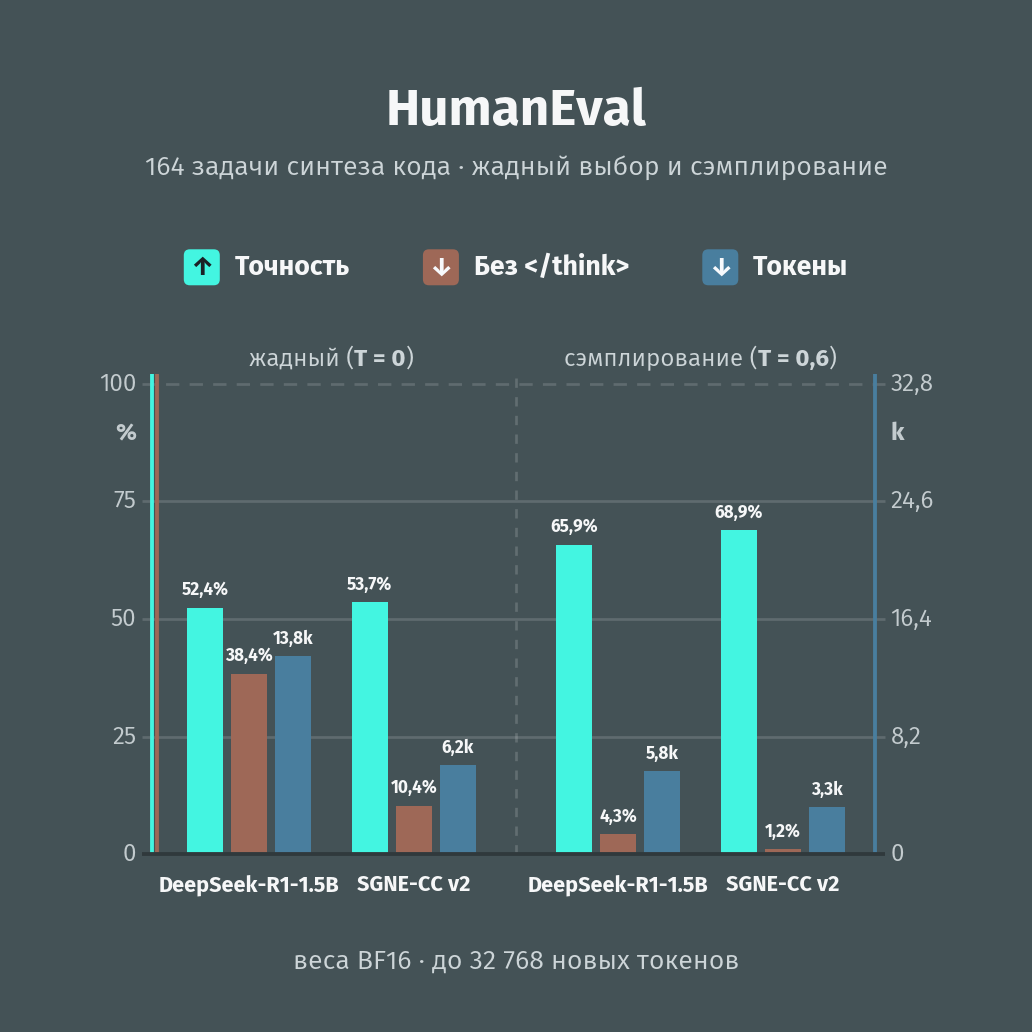
Рис. 4. На HumanEval поправка кратно снижает число незакрытых рассуждений и длину ответа в обоих режимах, но при T = 0 почти не увеличивает число пройденных скрытых тестов. 164 задачи HumanEval, проверка на скрытых модульных тестах test, BF16, бюджет до 32 768 токенов.
Другой характер ошибок при T = 0. В отличие от MBPP, на HumanEval число незакрытых ответов падает в 3.7 раза (63 → 17), а расход токенов — в 2.2 раза (13.8k → 6.2k), но парный баланс по тестам остаётся почти симметричным (+20 / −18,  ). Из
53 задач, где исходная модель оставляла ответ без </think>, а SGNE-CC v2 его закрыла, в 49 случаях извлечённый код синтаксически разбирается, в 3 случаях программа не извлечена и в 1 (индекс 75) допущена синтаксическая ошибка; синтаксически корректный код сам по себе не означает прохождения скрытых тестов, и общий баланс остаётся +20 / −18. При T = 0.6 поправка удерживает положительный баланс (+16 / −11,  ) при сокращении длины в
1.8 раза (5.8k → 3.3k).
4. Перенос на научный вывод и логику (ARC-Challenge и BBH Logic)
Наконец, проверяем задачи без числовых выкладок и без кода, не участвовавшие в отборе столбцов: научные вопросы с выбором ответа и многошаговые логические задачи.
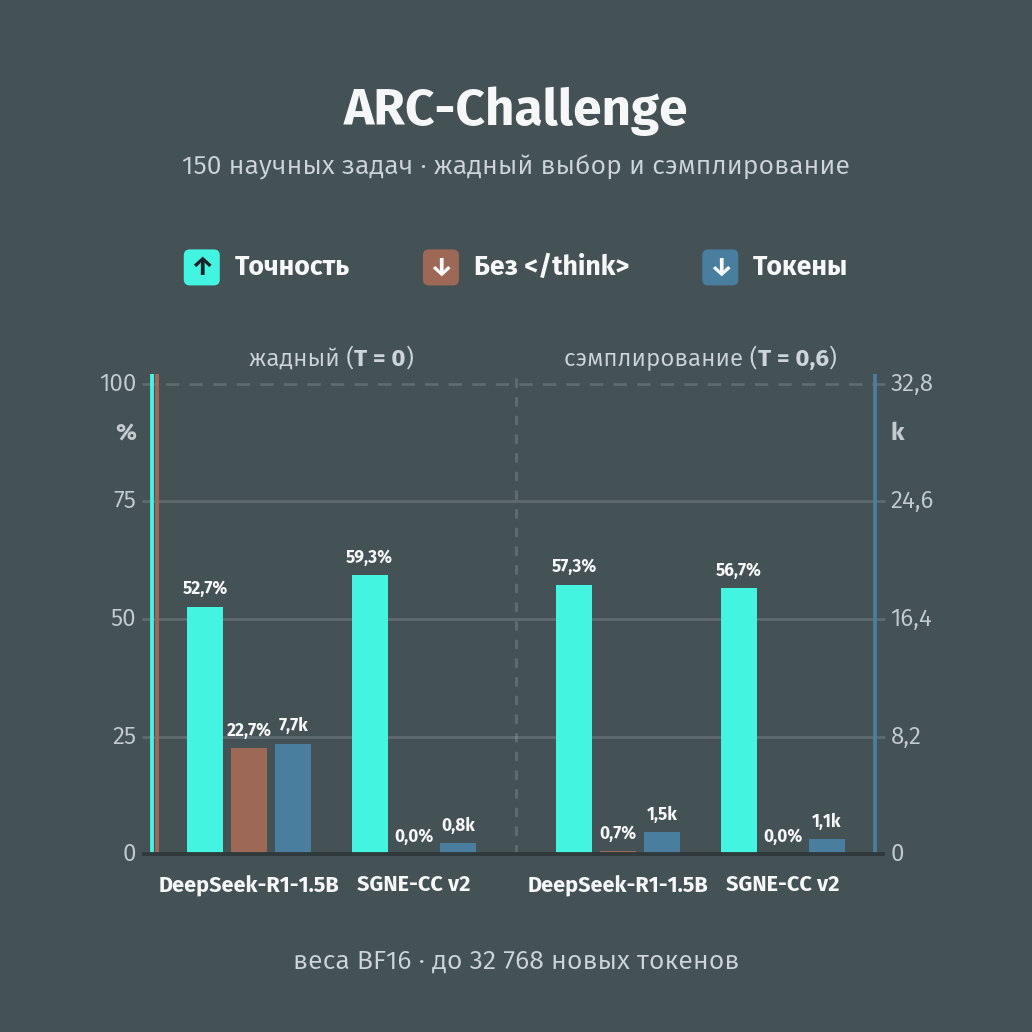
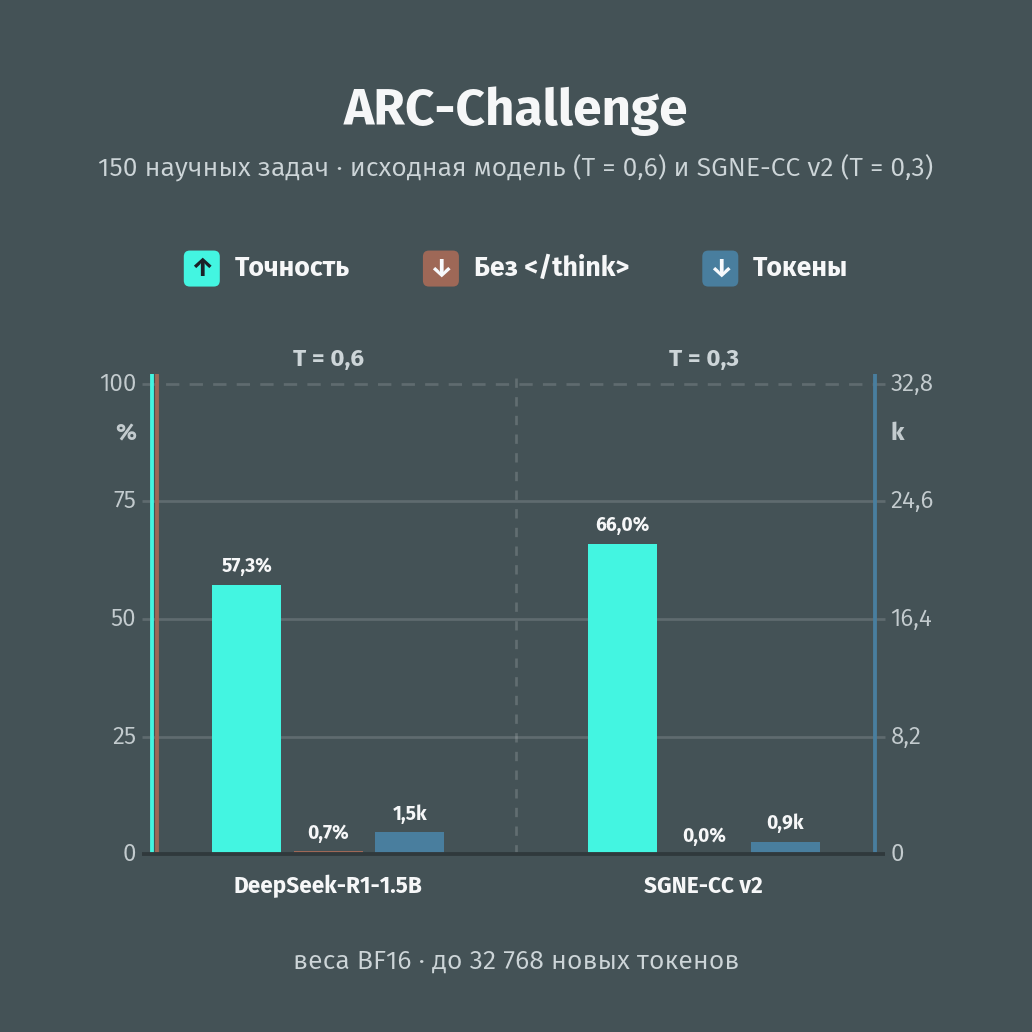
Рис. 5–6. На ARC-Challenge поправка полностью устраняет незакрытые рассуждения во всех режимах и почти в десять раз сокращает жадный вывод; наибольшая точность среди протестированных конфигураций достигается при T = 0.3. 150 задач ARC-Challenge, BF16, бюджет до 32 768 токенов. Оценщик сначала ищет букву в рамке boxed{}, а затем распознаёт другие формы записи (87 из 89 верных ответов SGNE-CC v2 при T = 0 и все 85 при T = 0.6 зачтены без распознанной буквы в рамке).
На ARC-Challenge все 150 ответов SGNE-CC v2 закрывают блок <think> в каждом из трёх режимов. При T = 0 это сокращает среднюю длину в 9.8 раза при положительном, но статистически незначимом сдвиге (+28 / −18,  ); при
T = 0.6 точность исходной и исправленной моделей практически совпадает (+18 / −19,  ). Сравнение температур (
T = 0.3). В отличие от MATH-500, на коротких научных вопросах при T = 0.3 SGNE-CC v2 набирает 99/150 против 86/150 у исходной модели при T = 0.6 (+31 / −18,  ) при средней длине менее тысячи токенов (исходная модель при
T = 0.3 не измерялась).
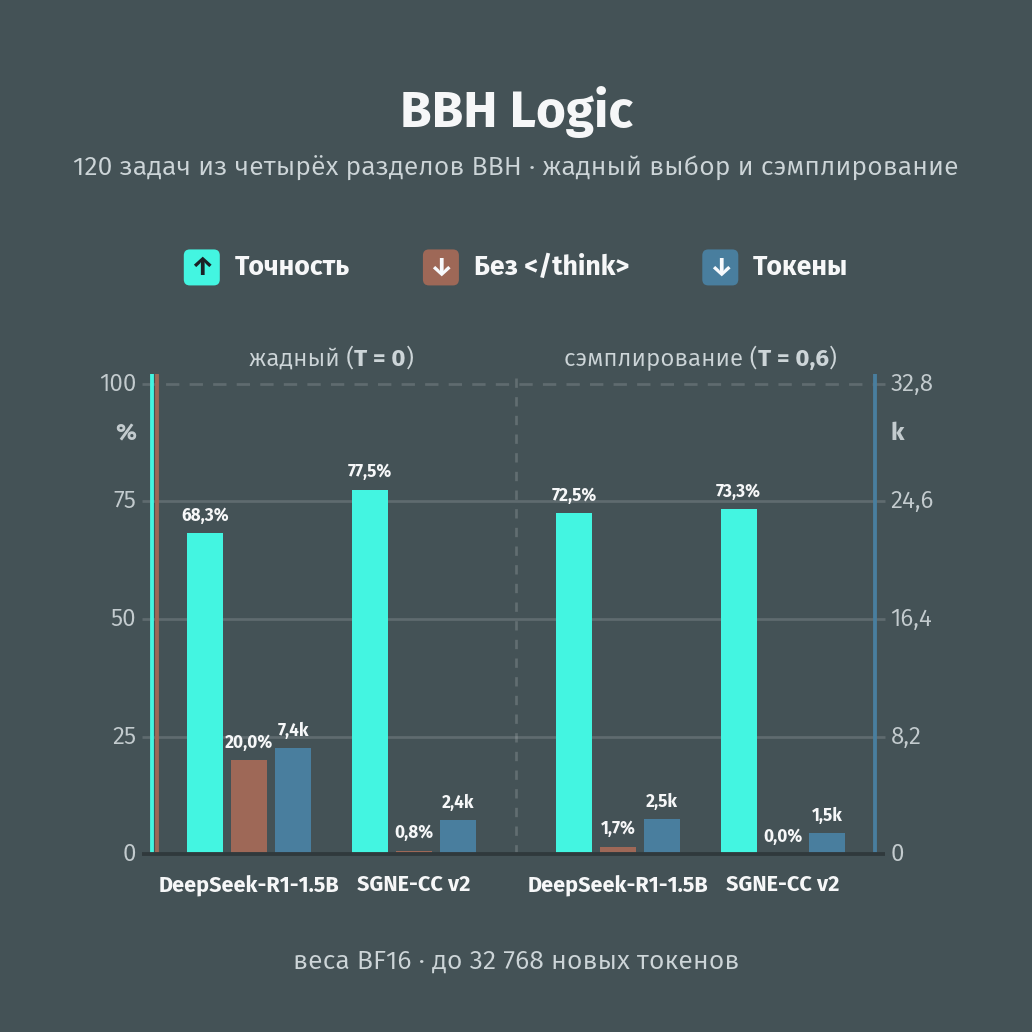
Рис. 7. На BBH Logic жадный вывод с поправкой SGNE-CC v2 повышает долю верных ответов до уровня 93/120 (против 82/120 у исходной модели в жадном режиме и 87/120 у неё же при T = 0.6). 120 задач из четырёх разделов BBH, BF16, бюджет до 32 768 токенов.
На BBH Logic исходная модель в жадном режиме оставляет без </think> пятую часть ответов (24/120), тогда как SGNE-CC v2 — лишь один, сокращает длину в 3.1 раза (7.4k → 2.4k) и даёт в жадной паре 82 → 93 (+23 / −12,  ); относительно исходной модели при
T = 0.6 это 87 → 93 (+22 / −16,  ). При
T = 0.6 точность остаётся на прежнем уровне (+18 / −17,  ), незакрытых рассуждений нет, а расход токенов снижается на
40%.
5. Сравнение с предыдущей работой, границы метода, сводка и воспроизводимость
5.1. Перенос между архитектурами: сравнение с предыдущей работой на Qwen3.5-0.8B
В нашей первой работе (DOI: 10.5281/zenodo.24235218, dna-weight-editing) метод SGNE-CC (v1) был разработан для гибридной модели Qwen3.5-0.8B, где 75% слоёв составляют рекуррентные блоки GatedDeltaNet. Сопоставление двух работ показывает, что сферический поворот выходных столбцов переносится на чистый трансформер и требует кратно меньшей правки (при этом у двух работ разные режимы штрафа за повторы и правила оценки математического ответа, а влияние одного лишь размера модели из этого сравнения архитектур не выделено):
|
Характеристика ( |
|
|
|---|---|---|
|
Тип архитектуры и размер |
Гибрид ( |
Чистый трансформер ( |
|
Объём поправки |
|
|
|
Макс. отклонение нормы столбца в |
|
|
|
|
|
|
|
|
|
|
|
Сэмплирование ( |
|
|
*В карточке Qwen3.5-0.8B штатный режим сэмплирования включает presence_penalty = 1.5, тогда как для DeepSeek-R1-Distill-Qwen-1.5B все прогоны выполнены без штрафа (presence_penalty = 0).
Перенос на чистый трансформер показывает, что метод SGNE-CC не требует рекуррентных блоков GatedDeltaNet: доля изменённых параметров сократилась в 15 раз (с 0.270% до 0.0177%), а максимальное отклонение нормы столбца в BF16 уменьшилось в 5.5 раза (с 0.1625% до 0.0295%).
5.2. Границы метода и наблюдаемые издержки
-
Потерянные решения. В сводной выборке из
1 054задач приT = 0на166новых верных решений приходится71потерянный ранее верный ответ. Поштучный разбор этих71потерь показывает, что в18случаях исправленная модель закрыла рассуждение раньше исходной, в38— позже, а в15оставила его открытым; одной позиции маркера</think>недостаточно для причинного объяснения отдельной ошибки. -
Повторные маркеры
</think>. После первого закрытия в тексте окончательного ответаSGNE-CC v2иногда порождает повторный служебный маркер</think>:84случая приT = 0и83приT = 0.6против0приT = 0и3приT = 0.6(BBHиндексы16и22,MBPPиндекс55) у исходной модели. -
Общая точность при случайном выборе токенов. При
T = 0.6разница в точности по1 054задачам статистически незначима (+92 / −81, ): при сэмплировании поправка проявляется прежде всего как сокращение длины (
−33.6%) и снятие остаточных незакрытых ответов (29 → 4; выходы на потолок поEOS—30 → 4).
5.3. Заключение
Сферический поворот 205 выходных столбцов mlp.down_proj (0.0177% параметров) без градиентного обучения и без изменения кода декодера существенно сокращает число незавершённых рассуждений в чистом трансформере DeepSeek-R1-Distill-Qwen-1.5B. При жадном выборе (T = 0) число верных ответов выросло с 638 до 733 из 1 054 (+9.0 п.п., 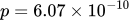 ), а число ответов без
</think> снизилось с 305 до 41 (без EOS: 300 → 38) при сокращении средней длины с 10.8k до 4.0k токенов. При T = 0.6 общая точность составила 72.3% у базы и 73.3% у SGNE-CC v2 (p = 0.4472), при снижении средней длины на 33.6% и сокращении ответов без </think> с 29 до 4.
5.4. Сводная таблица по всем 1 054 задачам (BF16, бюджет до 32 768 токенов)
В ячейках указаны точность, разбивка на три исхода (верно / ошибка после </think> / без </think>) и средняя длина в тысячах токенов; seed = 42 при T = 0.6, вероятности  вычислены точным двусторонним тестом Мак-Немара.
|
Набор ( |
Режим |
Исходная модель: Точн. ( |
|
Приобретено / потеряно и |
|---|---|---|---|---|
|
MATH-500 ( |
Жадный ( |
|
|
|
|
MATH-500 ( |
Сэмплирование ( |
|
|
|
|
MBPP ( |
Жадный ( |
|
|
|
|
MBPP ( |
Сэмплирование ( |
|
|
|
|
HumanEval ( |
Жадный ( |
|
|
|
|
HumanEval ( |
Сэмплирование ( |
|
|
|
|
ARC-Challenge ( |
Жадный ( |
|
|
|
|
ARC-Challenge ( |
Сэмплирование ( |
|
|
|
|
BBH Logic ( |
Жадный ( |
|
|
|
|
BBH Logic ( |
Сэмплирование ( |
|
|
|
|
Все ( |
Жадный ( |
|
|
|
|
Все ( |
Сэмплирование ( |
|
|
|

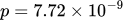

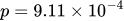


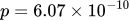

(Суммарно по четырём нематематическим наборам при T = 0: 311 → 351 из 554,  ; сокращение средней длины по всей выборке —
63.1% при T = 0 и 33.6% при T = 0.6.)
5.5. Протокол генерации, лицензии и независимая воспроизводимость (SHA-256)
-
Бюджет
32 768токенов и316продолжений: все25прогонов (5 270ответов) исполнены вBF16наvLLM 0.34.0приpresence_penalty = 0. Целевой бюджет составлял32 768новых токенов; для316возобновлённых жадных ответов исходной модели (T = 0) исходный текст повторно токенизировали и выделяли24 576токенов продолжения (в одном случае —BBH Logic, индекс11,8 193 + 24 576— сумма при исполнении составила32 769). Полеtotal_tokensсверено повторной токенизацией всего сохранённого текста (446точных совпадений,4 771с разницей1токен,53с разницей2токена; счётчики шагов возобновлённой генерации сохранены отдельно в сертификате). -
Веса, наборы данных и лицензии: см.
DATASETS_AND_LICENSES.md. Исходные тексты условийMATH-500в публичном репозитории не перераспространяются (вместо них приложеныdatasets/math500_ids_manifest.jsonиtraces/math500_per_item_results.jsonс построчными оценками иtext_sha256). Базовая модельdeepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B(model.safetensors,SHA-256: 58858233513d76b8703e72eed6ce16807b523328188e13329257fb9594462945), поправкаFINAL_SGNE_CC_V2_205_PATCH.npz(SHA-256: 6f435a63eb306047fe55353b7a911d32a17dd999efa65f082dd1d7c3779a0b2c), сертификатSHA256_AND_METRICS_CERTIFICATE.jsonи манифестSHA256_MANIFEST.json(42/42совпадающихSHA-256). -
Команды проверки целостности и наложения поправки из корня репозитория:
# Требует: numpy
python3 verification/verify_repo_integrity.py

# Требует: numpy, torch, safetensors
python3 patch/apply_sgne_cc_v2_205_to_safetensors.py
    --base-dir /path/to/DeepSeek-R1-Distill-Qwen-1.5B
    --patch    patch/FINAL_SGNE_CC_V2_205_PATCH.npz
    --out-dir  /path/to/DeepSeek-R1-Distill-Qwen-1.5B-SGNE-CC-v2
Примечание: работа выполнена в сотрудничестве с ИИ — как в самом исследовании, так и в подготовке кода, графиков и текста. Полную ответственность за выводы несёт автор, а все числа и замеры проверяются локально по открытой поправке, трассам и скриптам на процессоре.
Статья, поправка и трассы (GitHub) · Релиз v2.0.0 (.npz) · Архив DOI (Zenodo)
Код, весовая поправка и текст автора открыты под лицензией Apache-2.0; сторонние данные и базовые веса сохраняют исходные лицензии.
Автор: igorzhuk

Советуем прочесть:
 ROC‑AUC 1,000 против 0,500: Как я совместил мультиплексирование и HTTP-2-профиль трафика 05.11.2026 В нашем тестовом стенде p95 latency снизилась с 579 до 108 мс, а Random Forest…
 Учёт трат, который не бросаешь через неделю: Telegram‑бот, которому хватает «продукты 500» 22.10.2026 Признаюсь сразу: учёт расходов у меня умирал пять раз. Таблица в Google…
 Вороны справляются с визуальной задачей на движение в два раза быстрее, чем люди и обезьяны 15.11.2026 Вороны в эксперименте с классической визуальной задачей справились с ней примерно в два раза…
 Новый метод Concertina позволил уменьшить нейросеть Qwen3-4B в два раза для запуска на слабом железе 17.11.2026 Исследователи предложили способ сжать большую языковую модель почти вдвое и…
 Затестил Kimi AI, Qwen, DeepSeek и Grok на работе с текстами. Делюсь результатами 07.11.2026 Нейросеть получает статью на редактуру и возвращает гладкий текст, в…
