


Привет! Я Андрей Непряхин — директор департамента разработки в AGIMA.
Представим ситуацию. Пользователь просит AI-помощника оформить возврат платежа за заказ. Модель разбирает свободный текст, находит заказ, выбирает причину и вызывает API. Через 30 секунд оркестратор получает timeout. Что делать дальше: повторить запрос, спросить статус операции или передать случай человеку?
Если вся логика спрятана в одном prompt и одном agent loop, ответ приходится угадывать вместе с моделью. Первый вызов мог не дойти до API, мог завершиться успешно без ответа, а мог зависнуть после частичной записи. Слепой повтор способен создать второй возврат. Отказ от повтора оставит первый запрос в неопределённом состоянии.
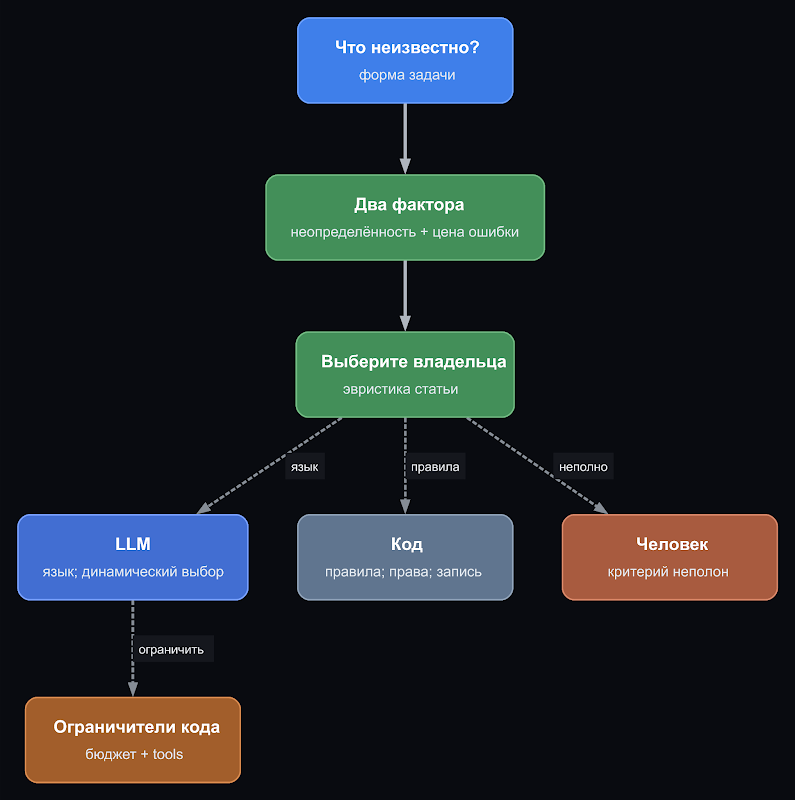
Выберите архитектуру по форме задачи
Соблазнительный простой ход — отдать весь процесс одному prompt и одному agent loop. Он экономит первые строки кода, но сразу смешивает интерпретацию, проверку прав и внешний эффект. Вместо такой лестницы «workflow, а потом agent» я считаю полезнее рассматривать их как разные ветви архитектуры.
В engineering guide Anthropic workflow — заранее заданный кодом путь, а agent — процесс, где модель выбирает шаги и инструменты. Авторы рекомендуют начинать с простейшего достаточного решения и учитывать задержку и стоимость агентной сложности. Это опыт поставщика моделей, не универсальный benchmark.
Перед выбором задайте четыре вопроса:
-
Насколько неоднозначен вход? Свободный текст требует интерпретации; проверка лимита, расчёт и переход статуса обычно имеют точные правила.
-
Можно ли формально проверить результат? JSON-схема проверит типы и обязательные поля, но не уместность компенсации.
-
Известен ли маршрут заранее? Если каждый запрос проходит
classify → validate → approve → execute, маршрут уже существует. Если число шагов зависит от найденных данных, допустим ограниченный agent loop. -
Какова цена ошибочного действия? Черновик можно удалить; платёж, публикация, изменение доступа или запись в CRM оставляют внешний след.
Из этих вопросов у меня получается рабочее распределение:
|
Задача |
Основной исполнитель |
Причина |
|
Классифицировать свободный текст |
LLM |
Граница классов зависит от языка и контекста |
|
Посчитать цену или лимит |
Код |
Формула известна и должна воспроизводиться |
|
Выбрать следующий исследовательский шаг |
Agent loop с лимитами |
Маршрут зависит от промежуточного результата |
|
Проверить права |
Код по доверенному контексту |
Модель не должна назначать себе полномочия |
|
Подтвердить рискованное исключение |
Человек |
Формальный критерий неполон, цена ошибки высока |
|
Выполнить запись |
Код через явный контракт |
Нужны idempotency, аудит и разбор неизвестного исхода |
Таблица не выбирает архитектуру автоматически: она помогает назвать источник неопределённости. Если неоднозначен только текст на входе, автономный агент добавит состояния при уже известном маршруте.
Отдельная граница нужна после ответа модели. Structured output проверяет форму, но внутри формально валидного tool-call всё ещё может оказаться опасный аргумент. Поэтому перед side effect код повторно проверяет схему и инспектирует аргументы как текст; для необратимых действий к этому добавляется подтверждение человека.
Пусть модель вернёт proposal, а не выполнит действие
Удобная граница проходит по объекту-предложению. Модель преобразует контекст в ограниченную структуру, но эта структура ещё ничего не меняет:
from dataclasses import dataclass
from decimal import Decimal
from typing import Literal

@dataclass(frozen=True)
class RefundProposal:
    order_id: str
    reason: Literal["duplicate", "quality", "delivery", "other"]
    amount: Decimal
    confidence: float
    evidence_ids: tuple[str, ...]
После получения RefundProposal детерминированный контур заново загружает заказ, сверяет сумму, статус и права вызывающей стороны. confidence помогает маршрутизации, но не отменяет бизнес-правило. Его порог нельзя брать из документации или назначать «на глаз»: порог калибруют на размеченных данных под требуемый баланс precision и recall. В нашем детекторе порог 0,2 по калибровке давал precision 1,0, тогда как 0,5 терял около половины recall. Это результат конкретной выборки, а не переносимый порог. evidence_ids ссылаются на уже доступные системе записи; свободный текст модели нельзя считать доказательством.
Исполнение можно собрать как последовательность явных гейтов:
def handle_refund(command, actor, store, payments):
    proposal = llm.propose_refund(command.text, command.context)

    validate_schema(proposal)
    order = store.get_order(proposal.order_id)
    validate_business_rules(proposal, order)
    require_permission(actor, "refund", order.account_id)

    if needs_human_approval(proposal, order):
        return queue_for_review(command.id, proposal)

    # Сохраните operation_id до первого внешнего вызова:
    # иначе рестарт между вызовом API и записью разорвёт связь с операцией.
    operation_id = stable_operation_id(command.id, "refund")
    store.save_operation_id(command.id, operation_id)
    return execute_with_reconciliation(
        operation_id=operation_id,
        request=build_refund_request(proposal, order),
        client=payments,
    )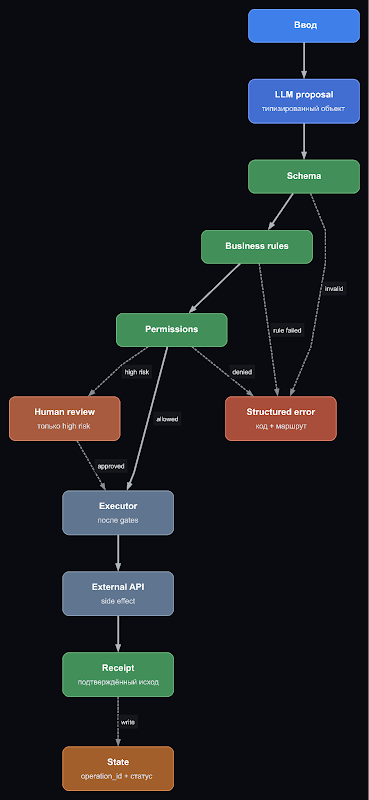
LLM формирует proposal, а gates определяют, может ли он вызвать внешний эффект.
Это не готовая библиотека и не гарантия безопасности. Пример фиксирует владельцев решений: модель отвечает за предложение, код — за схему, факты, права и side effect, человек — за заранее названный класс исключений.
Именно здесь появляется инженерский выигрыш от разделения: контракт можно тестировать по частям. Для propose_refund нужны датасет и оценка смысла. Для validate_business_rules подходят обычные unit-тесты. Для execute_with_reconciliation нужны интеграционные тесты с обрывом соединения и повторной доставкой событий. Одна итоговая метрика не покажет, где именно возникла ошибка.
Retry начинается с вопроса «что успело произойти?»
Правило «при ошибке повторить три раза» годится для части чтений, но опасно для записи. RFC 9110 разрешает автоматически повторять idempotent request после сбоя соединения. Non-idempotent request можно повторять лишь тогда, когда клиент знает, что операция в этих условиях идемпотентна, либо может доказать, что исходный запрос не применён.
Поэтому timeout стоит разделять хотя бы на четыре исхода:
-
запрос не был отправлен: допустим обычный retry;
-
удалённая система вернула подтверждённый отказ: retry зависит от класса ошибки;
-
запрос отправлен, но ответ потерян: исход неизвестен, сначала нужен read-back или reconciliation;
-
частичный ответ уже отдан потребителю: автоматически повторять нельзя, даже если есть idempotency key.
Последний случай особенно важен для стриминга. В нашем шлюзе провайдер мог открыть HTTP 200, отдать первые байты и через несколько секунд оборвать поток. До первого байта мы повторяем запрос на той же модели, затем перебираем запасные модели из реестра. После первого байта не повторяем: клиент получает явный обрыв.
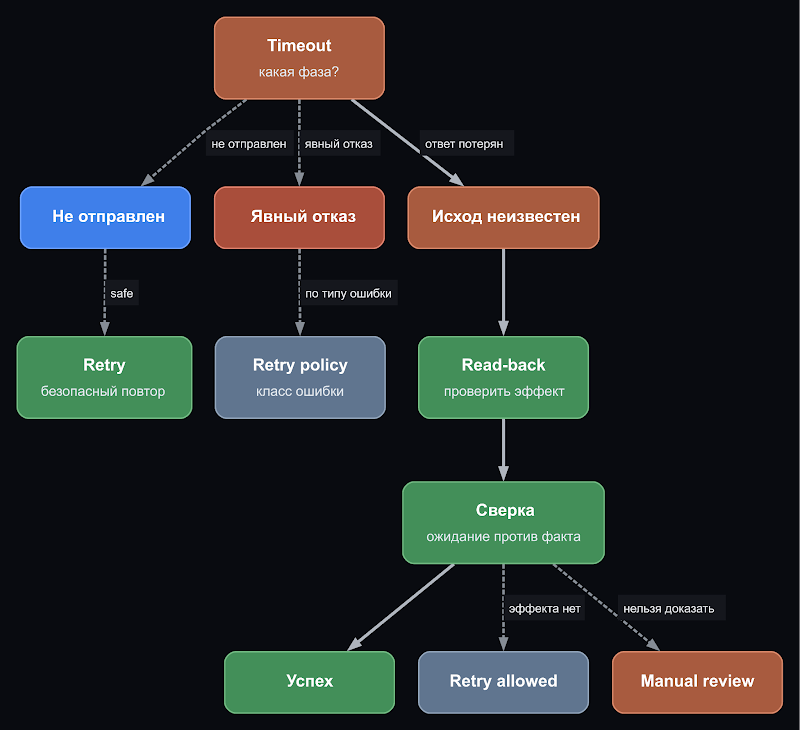
Timeout сам по себе не разрешает retry: при неизвестном исходе сначала read-back и reconciliation.
Поле idempotency_key помогает только вместе с контрактом принимающего API. Нужно знать срок хранения ключа, область уникальности, поведение при том же ключе и другом теле, а также формат ответа на повтор. Само наличие поля не создаёт exactly-once semantics.
Минимальная state machine для записи может выглядеть так:
proposed
↓
validated
↓
executing
├─→ succeeded
├─→ failed_safe_to_retry ─→ retry_allowed
└─→ outcome_unknown ─→ reconciling
├─→ succeeded
├─→ retry_allowed
└─→ manual_review
В production это должны быть реальные сохранённые состояния, из которых после рестарта восстанавливаются operation_id, номер попытки и последний подтверждённый переход.
Temporal различает таймауты ожидания старта, выполнения и общего времени, а heartbeat хранит прогресс долгой Activity для следующей попытки. Это пример конкретного продукта; переносимый вывод — фаза сбоя и наблюдаемый прогресс важнее слова timeout.
Состояние и трасса должны пережить agent loop
Модель может по-разному объяснить один вход; операционный журнал обязан оставаться однозначным. На практике первыми стоит завести два отдельных поля: «что решила модель» и «что сделала система». У нас именно это разделение помогло понять, что в первой итерации inline-блокировок 90 из 99 блокировок были ложными и приходились на системные промпты кодинг-агентов: одной итоговой метрики для диагностики не хватало.
Для каждого запуска полезно сохранять:
-
run_id,operation_id, родительский запрос и номер попытки; -
версии prompt, модели, tool schema и policy;
-
хеш или безопасную копию proposal;
-
результаты каждого gate с кодом причины;
-
переходы состояния, tool request и подтверждённый response;
-
финальный receipt либо статус
outcome_unknown.
Сырые пользовательские тексты, токены доступа и персональные данные нельзя бездумно отправлять в observability-систему. В нашем случае журнал содержит версии модели, адаптера, политики и правил, вердикт, применённое действие, reason code, correlation id и латентность этапов. Для текста сохраняем маскированный preview; полный текст хранится за отдельным правом под шифрованием и аудитом. В SIEM текст попадает только при подтверждённом отсутствии персональных данных, иначе — перечень найденных типов.
Трасса отвечает дежурному инженеру: какую версию prompt использовали, почему gate пропустил действие, дошёл ли запрос до внешнего API, совпал ли read-back с ожидаемым эффектом. Если ответ восстанавливают из рассуждения модели, надёжного операционного состояния нет.
Для agent loop нужны бюджеты шагов, времени и инструментов. Каждый вызов завершайте машинно читаемым исходом: continue, complete, needs_input, blocked_by_policy или failed.
Разведите eval, release gate, runtime gate и monitoring
Проверка LLM-компонента до релиза и контроль одного опасного действия решают разные задачи. Полезно развести четыре контура — это предлагаемый здесь engineering framework, а не официальная taxonomy NIST:
-
Offline eval сравнивает версии на зафиксированном наборе атак и benign-контролей по классам: совпал ли вердикт с ожидаемым, заполняет ли модель proposal, не ухудшает ли редкие классы. Catch-rate только по уже заблокированным запросам для этого недостаточен.
-
Release gate решает, можно ли выпустить конкретную комбинацию model, prompt, tools и policy. В нашем детекторе новая версия проходит четыре проверки: слепые зоны, precision на реальной переписке, forgetting на перифразах и red team. Порог и список обязательных тестов версионируются вместе с артефактом.
-
Runtime gate проверяет текущий proposal, права, лимиты и состояние внешней системы перед действием.
-
Monitoring ищет сдвиг после релиза: рост outcome_unknown, доли fail-open, 5xx upstream, очереди сканов, повторов, ручных разборов и расхождений при reconciliation. Для нашего контура рабочие ориентиры — менее 1% ложных блокировок деловой переписки и не более двух минут до алерта; это локальные SLO, а не универсальные нормы.
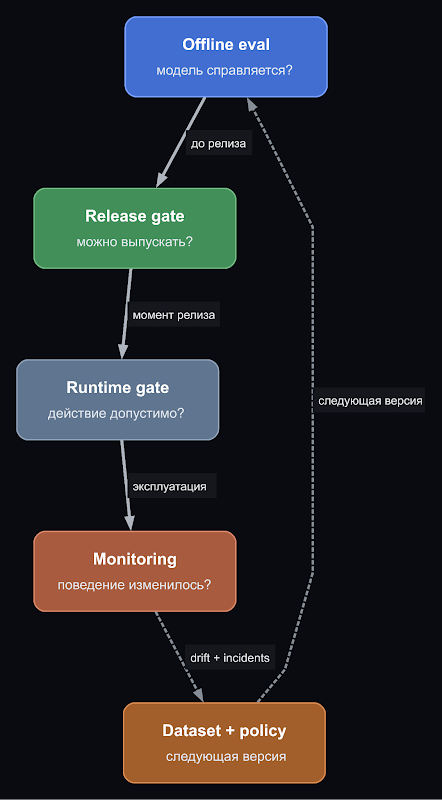
Четыре контура отвечают на разные вопросы и возвращают наблюдения в следующую версию.
NIST Generative AI Profile разделяет управление рисками, измерение и наблюдение на протяжении жизненного цикла, включая тестирование до deployment и мониторинг после него. Документ не предписывает приведённую четырёхчастную архитектуру и не задаёт универсальные пороги.
Человек в контуре нужен не по принципу «AI надо перепроверять». Осмысленный триггер соединяет две величины: формальный критерий неполон и ошибка дорого стоит. Для низкорискового черновика ручное подтверждение каждого шага создаст очередь без заметной пользы. Более того, проверяющий сам становится источником false-positive fatigue: одобрение, которое всегда заканчивается нажатием «Да», создаёт ложное ощущение контроля. Для необратимой операции даже высокая уверенность модели не заменит права и явное одобрение. Чем выше цена ошибки, тем ближе точка подтверждения должна быть к side effect, а не к началу пайплайна.
Запишите в контракте, что именно видит reviewer: исходный запрос, proposal, подтверждённые факты, сработавшие правила и ожидаемый side effect. Кнопка «Одобрить» рядом с красивым объяснением модели маскирует риск, если человек не видит проверяемых оснований.
Как это выглядит в живом LLM-шлюзе
Наш минимальный маршрут устроен так: запрос → скан слотов с помощью regex, NER и модели → policy engine формирует вердикт → режим ключа решает, применять ли его → обратимая токенизация чувствительных фрагментов → upstream → скан стримингового ответа с holdback → регидрация → журнал инцидента. В журнале «вердикт» и «применённое действие» остаются разными полями.
Границы компонентов выбраны по проверяемости. Форматные персональные данные отданы regex, имена и организации — NER, семантика атак — модели. При пересечении спанов regex имеет приоритет. Права, квоты, расчёты, idempotency и решение применять ли вердикт модель не получает — см. таблицу выше.
Одна из неудачных итераций — инспектор tool-call, который блокировал вызовы только по имени инструмента. На живом трафике он вырезал запуск субагента и удаление временного файла, потому что названия выглядели опасно. После отката безусловную блокировку оставили только для катастрофических аргументов, а эвристику по имени подчинили режиму ключа. В режиме наблюдения она лишь записывает событие.
Переносите one-shot в пайплайн по одному риску за раз
Вместо полной перестройки я бы начал с участка, где ошибка уже создаёт дорогой или плохо диагностируемый результат. Так простой one-shot получает контролируемые границы по одному риску за раз.
-
Перечислите все внешние записи, отправки и изменения прав. Вынесите их из model loop в отдельные функции.
-
Введите typed proposal и запретите модели передавать в executor произвольные аргументы.
-
Добавьте schema, business и permission gates. Для каждого отказа задайте reason code и следующий маршрут.
-
Сохраните state machine и стабильный
operation_idдо первого вызова внешнего API. -
Разделите
failedиoutcome_unknown; реализуйте read-back там, где API позволяет проверить эффект. -
Соберите offline eval для вероятностной части и обычные тесты для детерминированных правил.
-
После этого проверьте, осталась ли задача, где следующий шаг нельзя задать заранее. Только для неё добавляйте ограниченный agent loop.
Последний пункт защищает от ложной автономности. Если модель всегда вызывает одни и те же три инструмента в одном порядке, это workflow с лишней недетерминированностью. Если исследовательский путь меняется после каждого результата, агент может быть оправдан — при лимитах, наблюдаемом состоянии и безопасной границе side effects.
Перед релизом проверьте:
-
может ли один и тот же запрос создать два внешних эффекта;
-
что произойдёт после рестарта между записью и сохранением ответа;
-
какой компонент проверяет права по доверенным данным;
-
как система отличает безопасный retry от неизвестного исхода;
-
какие решения требуют человека и какие данные он видит;
-
можно ли воспроизвести ошибку без рассуждений модели;
-
что делает система, если проверяющий компонент недоступен: fail-open или fail-closed, и кто владеет этим решением.
У нас эта политика задаётся по классу операции: для необратимых действий — fail-closed, для чтения — fail-open. Компромисс между coverage и безопасностью должен быть записан заранее, а не придуман дежурным во время инцидента.
Если бы я начинал заново, первым делом завёл бы два поля — «что решила модель» и «что сделала система» — и детерминированный журнал состояний с кодами причин. Модель имеет право предлагать, код имеет право делать, а между ними должна оставаться строка в логе, которую инженер сможет понять через месяц без самой модели.
Что получаем в итоге
Практический результат такого пути — проверяемая граница ответственности. В инциденте команда может увидеть, что предложила модель, какое правило принял код, кто разрешил действие и какой эффект подтвердил внешний сервис. LLM остаётся в части с неопределённостью, а production-контур получает наблюдаемое состояние и управляемые отказы. Это не обещание абсолютной надёжности: точные контракты, риски и границы human review всегда зависят от конкретного API и действия.
Об авторе
Андрей Непряхин — директор департамента разработки AGIMA
Подписывайтесь на мой ТГ‑канал: @cto_neuro
Что еще почитать:
AGIMA: DLP для LLM. Как обезличивать запросы и не ломать поиск по сотрудникам
AGIMA: SOLID в реальном мире. ISP без микроинтерфейсов
AGIMA: Дообучение детектора промпт-инъекций
Автор: nepryakhin

