


Это продолжение моей статьи «Число vCPU ничего не говорит: как я считал, нужен ли свой ASR-сервер вместо Deepgram». Читать первую часть не обязательно, всё нужное я коротко перескажу.
Вечером в день публикации первой статьи в комментарии пришёл @pahaz. Оказалось, что в тот же день у него вышла статья «Транскрибация аудио в текст бесплатно и без облаков: почему мне не хватило одной модели», и он посоветовал добавить в сравнение Parakeet: сам он пришёл к каскаду GigaAM + Parakeet. Я прочитал его статью и это подтолкнуло меня на идею попробовать каскад и для онлайн транскрибации: T-one во время встречи делает быстро текст черновик разговора (с задержкой менее 2с превращает аудио в текст), а после встречи GigaAM вычитывает его, исправляет ошибки и делает чистовик.
Я загорелся идеей и уже через три дня у меня были готовы цифры замеров на своем тестовом стенде. Сама схема сработала, но два места меня удивили, и о них эта статья больше, чем о моделях:
-
эталон, по которому я считал качество, ошибался в каждом четвёртом спорном месте и подыгрывал моделям, из которых был собран;
-
каскад «вторая модель правит термины», который у @pahaz давал минус 5 п.п. WER, на моих созвонах в лучшем случае ничего не дал, а в худшем добавил 7 п.п.
Коротко о первой части
В первой части я выбирал движок для живых субтитров и формировании текста из аудио в онлайн, в созвоне 121 (один на один) преимущественно на русском языке. Главной причиной экспериментов для меня был вопрос – можно ли уйти с облачного Deepgram на свой сервер без видеокарты. Главный вывод был в первой статье был про железо: Xeon 2013 года без AVX2 держит в 6–8 раз меньше живых дорожек, чем современный процессор с похожим числом vCPU. Моя машина B (6 vCPU Xeon E5-2680 v2, 11 ГБ RAM) держит две встречи одновременно: T-one отдаёт фразу через 1,08 с (p50) и 1,2 с (p95) после паузы.
Там же остался хвост, с которого начинается эта статья. T-one не ставит пунктуацию и по словам уступает и облаку, и GigaAM, а GigaAM работает только по готовой записи. Последняя фраза выводов звучала так: «для чистового текста после встречи нужна другая модель». Эту модель я и ставлю в свой каскад транскрибаций и подготовки чистовика текста по встрече.
Что изменилось с первой части
Задача осталась той же: звонок в браузере, дорожки участников приходят на сервер раздельно, поэтому диаризация не нужна. Требования из первой части я тоже оставил:
-
фраза в субтитрах не позже 2 с (p95);
-
предсказуемая цена часа;
-
аудио не покидает сервер в России.
Добавилось одно требование: после встречи нужен итоговый текст с пунктуацией, который не стыдно отправить, по качеству не хуже облака. Я продолжаю гореть идеей сделать сервис для встреч один на один с расшифровкой в моменте и качественным доком по итогу, и в итоговом тексте важнее всего суммы, сроки и имена.
Методику я тоже поменял. Слабые места первой части я сам перечислял в оговорках, это прежде всего эталон, которым там служил Deepgram и как я посчитал у меня было мало живых рабочих созвонов для теста – в этот раз я их добавил и вычитал до эталона:
|
Первая часть |
Эта часть |
|
|
Данные |
51 с колл-центра из пакета T-one и 29 мин коучинговой сессии |
4 записи рабочих созвонов, 2 ч 21 мин, 14 970 слов |
|
Эталон |
согласие движков на образце, текст Deepgram nova-3 на сессии |
согласованный текст трёх систем с ручной правкой терминов, плюс выборочное прослушивание |
|
Движки |
T-one, GigaAM-v3, Vosk, Deepgram nova-2 и nova-3 |
T-one (greedy и KenLM), GigaAM-v3 e2e, Parakeet TDT 0.6B v3, Deepgram nova-3 |
|
Метрики |
WER |
WER, WERx, ошибки в числах, точность терминов, и пунктуации |
|
Вопрос |
что тянет CPU в реальном времени |
как поделить работу между двумя моделями и сколько это стоит |
Почему одной модели мало
У меня две модели, и каждая хороша в своём.
T-one потоковая. Фраза приходит примерно через секунду после паузы, но без пунктуации, а на живой рабочей речи с WER около 22%, то есть ошибка примерно в каждом пятом слове.
GigaAM-v3 e2e среди того, что я пробовал, лучшая по качеству и сама ставит пунктуацию. Но она пакетная: ей нужен весь кусок звука сразу.
В первой части я сравнивал их как альтернативы. У @pahaz две модели работают вместе, но обе в пакетном режиме. Здесь у моделей разные роли и разное время работы: T-one пишет черновик во время звонка, GigaAM после звонка делает чистовик.
Как это устроено
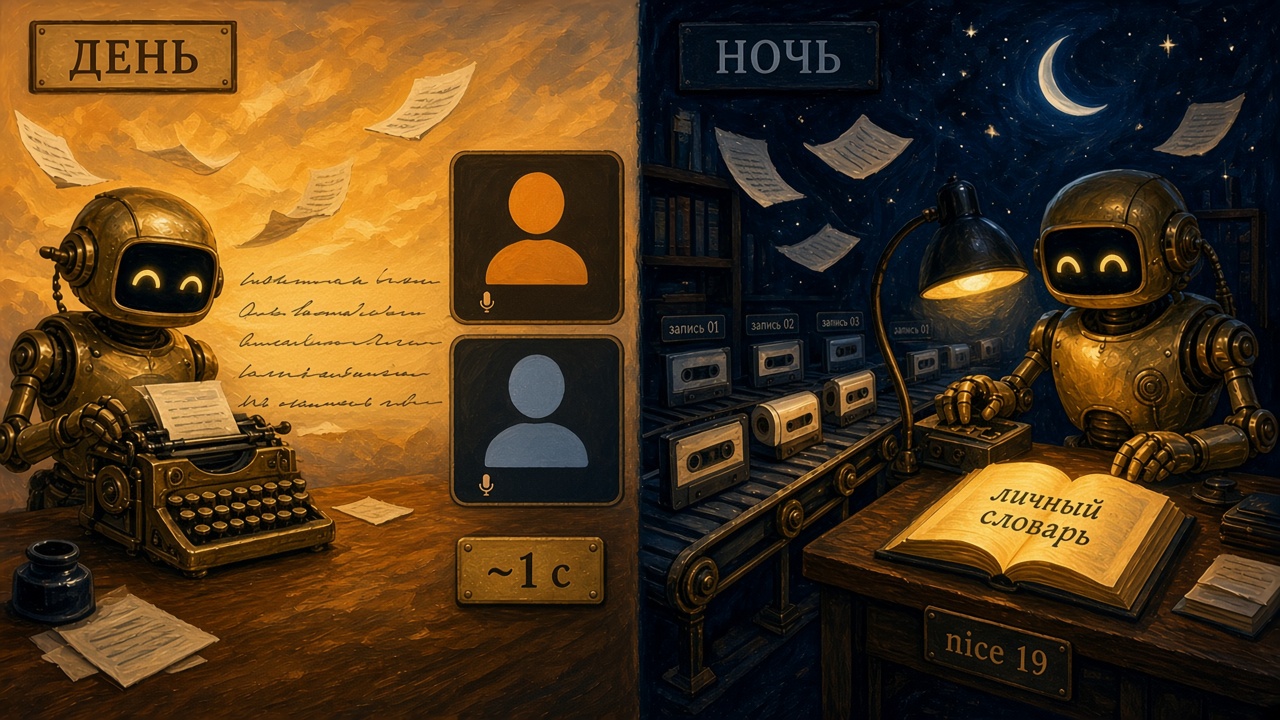
Три решения, к которым я пришёл по ходу замеров (подробности ниже):
-
Черновик и чистовик лежат в одной карточке встречи, и пользователь видит, что текст «уточнился». Чистовик меняет от 17 до 26% текста, такое трудно не заметить, и интерфейс должен это объяснять.
-
Чистовик стоит в очереди с низким приоритетом. Живые субтитры важнее.
-
Словарь терминов у каждого пользователя свой. И я допускаю, что тут можно пополнять спорными словами свой словарь через специальный интерфейс.
Стенд и методика
Железо. Та же машина B: 6 vCPU Xeon E5-2680 v2 (2013 год, только AVX, без AVX2 и FMA), 11 ГБ RAM. В день замера соседи по хосту забирали 5–20% процессора (steal), и пакетные проходы шли на 30–40% медленнее, чем 18.10 на той же машине.
Данные. Четыре записи моих рабочих созвонов:
|
Запись |
Длительность |
|
разговор один на один |
25 мин |
|
разговор один на один |
34 мин |
|
обсуждение процесса с командой |
59 мин |
|
дейли на 15+ человек |
23 мин |
|
всего |
2 ч 21 мин, 14 970 слов |
Дорожек две: мой микрофон и системный звук. Качество я считал по смешанной дорожке. Эталон размечен репликами примерно по 20 секунд, и если голоса пересекаются, честно развести такую реплику по дорожкам нельзя: текст уезжает не туда.
Метрики.
-
WER после нормализации: числа приводятся к одному виду, «ё» заменяется на «е», порядковые числительные тоже нормализуются.
-
WERx, то есть WER по звучанию: латиница переводится в кириллицу так, как слышится, например Cloud-MD = «клауд эм ди». Без этого модель, которая написала термин кириллицей, получает ошибку за правильно услышанное слово.
-
Ошибки в числах, точность терминов, пунктуации против эталона.
Эталон: главная оговорка этой статьи
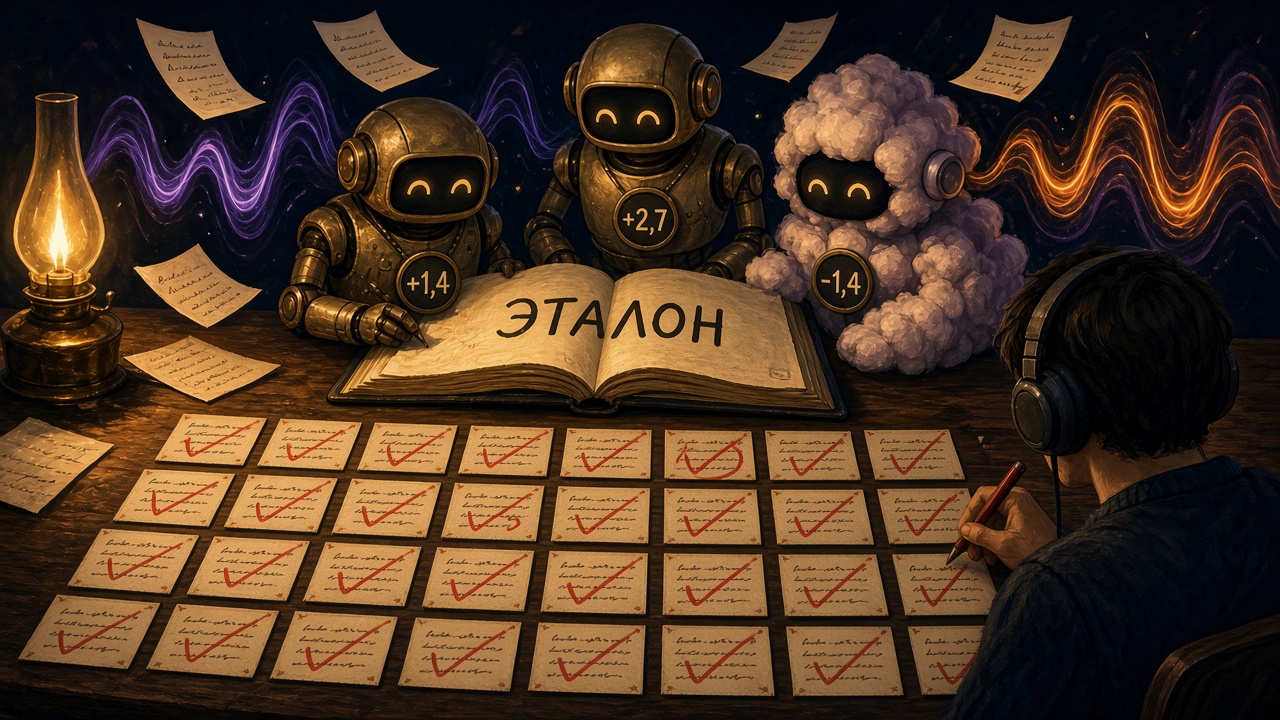
Эталона, вычитанного человеком, на 2 ч 21 мин у меня нет. Этот эталон собран как согласованный текст трёх систем: GigaAM-v3 e2e с каскадом Parakeet, Whisper large-v3-turbo и Whisper large-v3. Термины я поправил руками.
У такого эталона есть очевидная проблема: GigaAM входит в число его источников. Значит, её WER будет занижен, а отрыв от Deepgram завышен.
Сколько стоит эта проблема в цифрах, я проверил прослушиванием. Взял запись с самым надёжным эталоном (один на один, 25 мин, в источниках все три модели). В ней 517 мест, где хотя бы один движок разошёлся с эталоном. Из них я переслушал случайные 40, а заодно 29 мест, которые составитель эталона сам пометил как спорные.
Результат:
-
эталон ошибся в 10 местах из 40, то есть в 25% (95% ДИ 14–40%);
-
на всю запись это примерно 129 ошибок (73–208), собственный WER эталона около 4,5% (2,6–7,3%);
-
в 14 из 29 спорных мест первый вариант составителя оказался верным. Правка эталона по этим местам сдвинула WER всех движков всего на 0,1–0,2 п.п.
Дальше я пересчитал WER каждого движка. Если в каком-то месте прав был движок, а не эталон, ошибку движку засчитали зря, и её надо вычесть. Если движок повторил ошибку эталона, ошибку ему не засчитали, и её надо добавить.
|
Движок |
WER против эталона, % |
Поправка, п.п. |
После поправки, % |
|
Deepgram nova-3 |
15,9 |
−1,4 |
14,5 |
|
GigaAM-v3 e2e |
13,5 |
+1,4 |
14,9 |
|
T-one + KenLM |
21,7 |
+0,5 |
22,2 |
|
Parakeet v3 |
21,1 |
+2,7 |
23,8 |
Вышло ровно то, что следовало из состава эталона. Модели-источники (GigaAM и Parakeet) получили поправку вверх, Deepgram вниз. После поправки GigaAM и Deepgram на этой записи равны в пределах погрешности: каждая поправка посчитана по 2–6 местам, и погрешность у неё ±1,5 п.п. и больше. Отрыв T-one от обоих, около 7–8 п.п., остался на месте.
Остальные три записи собраны из двух моделей, а не из трёх, и перекос в пользу GigaAM там, скорее всего, не меньше. Поэтому дальше я держусь простого правила: сводная таблица по четырём записям считается «против согласованного эталона», а выводы о GigaAM против облака я делаю только по переслушанной записи.
Результаты
Качество: сводная таблица
Смешанная дорожка, 4 записи, 14 970 слов, эталон согласованный (с оговоркой выше). В колонке «по записям» порядок такой: 1-на-1 25 мин / 1-на-1 34 мин / обсуждение 59 мин / дейли 23 мин.
|
Движок |
Роль |
WER, % |
По записям |
Ошибок в числах (из 262) |
точки / запятые |
|
GigaAM-v3 e2e fp32, 16 кГц |
чистовик |
11,0 |
13,4 / 9,0 / 9,6 / 16,2 |
17 |
87 / 90 |
|
то же + словарь из одного термина |
чистовик |
10,9 |
— / — / 9,2 / — |
17 |
87 / 90 |
|
Deepgram nova-3 (облако) |
контроль |
16,0 |
15,7 / 13,9 / 15,4 / 22,4 |
32 |
79 / 81 |
|
T-one + KenLM |
черновик |
21,8 |
21,7 / 19,4 / 21,7 / 27,4 |
34 |
— |
|
T-one greedy |
черновик |
23,3 |
24,1 / 20,0 / 23,2 / 29,6 |
37 |
— |
|
Parakeet TDT 0.6B v3 int8 |
вторая модель каскада |
22,8 |
21,1 / 21,1 / 22,5 / 30,0 |
38 |
71 / 76 |
Что я из неё вынес:
-
Отрыв GigaAM от Deepgram здесь получился из-за эталона. На переслушанной записи они равны (14,9 против 14,5). Правильная формулировка такая: чистовик на своём сервере догоняет облако. Обгоняет ли он его, эта таблица не доказывает.
-
Числа. Чистовик ошибается в них вдвое реже черновика и облака: 17 ошибок против 32–34 из 262. Для итогов встречи, где важны суммы и сроки, это для меня самая важная строка таблицы.
-
Дейли хуже всех записей у всех движков, на 6–7 п.п.: 15+ человек, перебивания, плохие микрофоны.
-
KenLM к T-one стабильно даёт минус 1,5 п.п. На коучинговой записи из первой части было минус 0,9–1,7.
-
Рабочая речь тяжелее коучинговой. На записи из первой части (эталоном там был Deepgram) WER T-one был 10,6–11,2%. Здесь, с терминами и групповыми созвонами, 21,8%.
Что увидит пользователь, когда черновик заменится чистовиком
Мне было важно понять, сколько текста поменяется у человека на глазах и не станет ли от этого хуже.
|
Запись |
Исправлено |
Испорчено |
Меняется текста |
|
1-на-1, 25 мин |
11,1% |
1,8% |
18,4% |
|
1-на-1, 34 мин |
11,1% |
1,1% |
16,6% |
|
обсуждение, 59 мин |
12,4% |
1,3% |
20,6% |
|
дейли, 23 мин |
13,4% |
2,6% |
25,9% |
|
всего |
11,9% |
1,5% |
17–26% |
«Испорчено» — это слова, в которых черновик был прав, а чистовик ошибся. На каждую такую порчу приходится почти восемь исправлений. Поэтому я заменяю черновик целиком и не пытаюсь склеить из двух текстов лучшие куски.
Для сравнения: на коучинговой записи 16.10 чистовик исправил 6,6% слов, испортил 1,6% и поменял 11,8% текста. Чем тяжелее речь, тем больше чистовик переписывает.
Отсюда же требование к интерфейсу. Если без предупреждения поменять пятую часть текста, это выглядит как сбой. Резко поменять такую часть текста может быть не понятно пользователю в моменте – поэтому тут как решение – подсветить места в документе что на что изменилось.
Каскад «вторая модель правит латиницу»: отрицательный результат
GigaAM плохо пишет англицизмы и термины, поэтому тот же звук распознаётся ещё и Parakeet, а из Parakeet берётся только слово на латинице, если по звучанию оно похоже на фрагмент GigaAM (порог похожести 0,4). На смешанной русско-английской речи это дало минус 5 п.п. WER.
На моих четырёх записях вышло так:
|
Вариант |
Замен по записям |
WER, % |
|
только GigaAM |
— |
11,0 |
|
каскад, только латиница |
4 / 1 / 46 / 12 |
11,1 |
|
каскад без требования латиницы |
— |
18,3 |
С латиницей каскад ничего не дал. Без требования латиницы он заметно вредит.
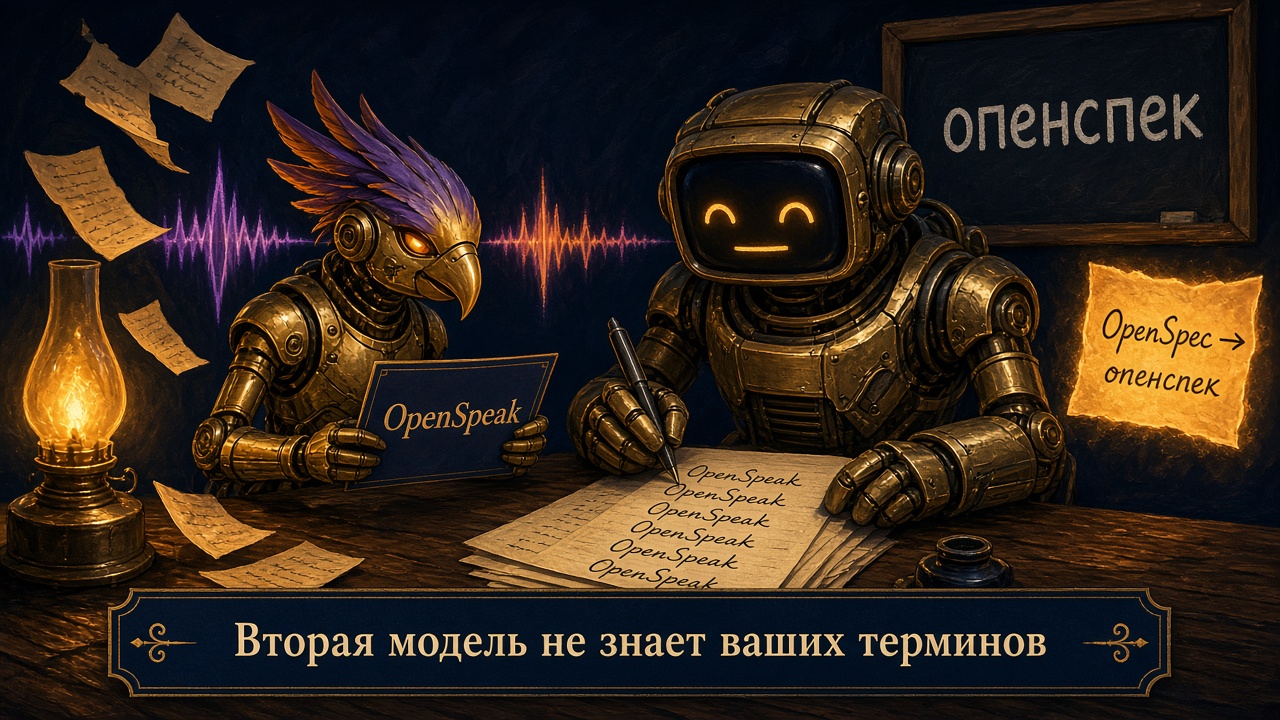
Почему так, показывает одно слово. У меня в аудио было обсуждение процесса работы с «OpenSpec» и слово «OpenSpec» звучит 38 раз. GigaAM 26 раз пишет его кириллицей, «опенспек», и на слух это верно. Parakeet 18 раз пишет «OpenSpeak», и каскад честно переносит эту ошибку в чистовик: в итоге 17 раз «OpenSpeak» и ни одного «OpenSpec». Deepgram угадал написание 2 раза. Вторая модель знает термины пользователя ровно так же плохо, как и первая.
Сработала вещь куда проще: личный словарь поверх чистовика, без второй модели. Термин переводится в кириллический ключ по звучанию («OpenSpec» → «опенспек»). Слово чистовика с тем же ключом и падежным хвостом до трёх букв заменяется на термин. Словарь из одного слова дал 27 правильных «OpenSpec» из 38 вместо нуля, а WER этой записи снизился с 9,6 до 9,2. Вторую модель держать не нужно, так что по ресурсам это ничего не стоит.
Есть и минус: при замене теряется окончание, и получается «в OpenSpec» вместо «в опенспеке». Для поиска по расшифровке это удобно, а читать такое странновато.
Возможно, дело в характере речи: если в замере была смешанная русско-английская речь, а у меня рабочие созвоны на русском с отдельными терминами на английском. Там, где английского много, каскад вполне может работать.
Скорость: что помещается на одной машине
|
Что |
Скорость на машине B |
|
|
T-one + KenLM, офлайн |
RTF 0,33 |
5,5 ГБ |
|
GigaAM-v3 e2e fp32, 16 кГц |
21 мин на час записи |
1,6 ГБ |
|
Parakeet v3 int8 |
39 мин на час |
1,3 ГБ |
|
Живые субтитры (из первой части) |
2 встречи на машину, фраза p50 1,08 / p95 1,2 с |
0,5 ГБ |
Отдельный сюрприз: Parakeet на русском на этом процессоре почти вдвое медленнее GigaAM (39 минут на час записи против 21), на ноутбучном i9 наоборот. Поколение процессора снова решает, как и в первой части.
Главный вопрос раздела: можно ли гонять чистовик на той же машине, где идут живые звонки, и не испортить субтитры? Я запускал 2 живые встречи (4 потока T-one через сервис) и параллельно чистовик GigaAM int8 на nice 19, по 10 минут на сценарий, два раза в разные дни.
|
Сценарий |
Тик T-one p95, 18.10 (steal ~1%) |
Тик p95, 20.10 (steal 15–33%) |
Отставание фразы p50 / p95 |
Чистовик |
|
только субтитры |
202 мс |
399 мс |
1,08 / 1,20 с |
— |
|
+ чистовик на все ядра |
258 мс |
320 мс |
1,08 / 1,20 с |
40 мин на час (18.10) |
|
+ чистовик на 2 потока |
363 мс |
507 мс |
1,08–1,11 / 1,20 с |
31–38 мин на час |
Что я вижу в этой таблице:
-
Отставание фразы не изменилось ни в одном сценарии и ни в один из дней. Фраза приходит по паузе, и запаса до 2 секунд хватает даже при тике 500 мс.
-
Тик p95 на общем хосте шумный. В период тестирования соседи по серверу забирали до трети процессора, и сценарий «только субтитры» оказался хуже, чем «с чистовиком». Сравнивать тик можно только внутри одного дня.
-
Ограничение чистовика двумя потоками оба раза сделало тик хуже, чем запуск на все ядра. Моя гипотеза, пока не проверенная: два потока ORT у GigaAM дольше держат те же ядра, что и потоки T-one, а на всех ядрах проход быстрее заканчивается. Практический вывод от этого: ограничивать чистовик потоками на такой машине незачем и можно оставлять работу с чистовиком на ночь.
Чистовик можно гонять между звонками на той же машине, но ночью удобнее: на машине B ночь (14 ч) — это около 40 часов встреч. Либо выстроить в очередь на чистовую обработку в течении дня.
Деньги
Цены примерные на октябрь 2026, по курсу ЦБ. Deepgram nova-3 для русского (monolingual) тарифицирует каждый канал отдельно.
|
Сценарий в облаке |
$ за час встречи |
₽ за час |
|
Стриминг, 2 дорожки, промо $0,0048/мин |
0,58 |
47,7 |
|
Стриминг, 2 дорожки, обычная цена $0,0077/мин |
0,92 |
76,6 |
|
Только итог по записи, 2 дорожки, $0,0043/мин |
0,52 |
42,8 |
|
Только итог по смешанной записи, $0,0043/мин |
0,26 |
21,4 |
Свой сервер с T-one и GigaAM стоит фиксированных денег: как пример расчета – взят Timeweb 8 vCPU / 12 ГБ за 2 790 ₽ в месяц.
-
Против стриминга Deepgram сервер окупается примерно с 59 часов встреч в месяц по промо-цене и с 36 по обычной. В первой части выходило 57 и 36 часов? но там сдвиг в моменте из -за сдвига курса валют.
-
Если в облаке делать только итоговый текст по записи, без живых субтитров, порог выше: около 65 часов при двух дорожках и около 130 при смешанной записи.
-
Ёмкость машины B: живые субтитры для 2 встреч одновременно, чистовик примерно на 40 часов встреч за ночь. Порог окупаемости по ёмкости машина проходит, но при росте упрётся в живые потоки, чистовик её не ограничивает.
-
На современном CPU с AVX2 та же конфигурация держит в 6–8 раз больше живых потоков (это из первой части). Пороги окупаемости от этого не меняются, растёт потолок.
В расчёт не вошли разработка и поддержка, резервный сервер (он удваивает пороги) и хранение записей.
Грабли
-
Эталон, собранный моделями, хвалит свои модели-источники. Перед тем как верить красивой цифре, посмотрите, из чего собран эталон. Пятнадцати минут прослушивания выборки мне хватило, чтобы «GigaAM лучше облака» превратилось в «GigaAM наравне с облаком».
-
Длинные реплики эталона нельзя честно развести по дорожкам. При пересечении голосов текст попадает не туда, поэтому считать пришлось по смешанной дорожке.
-
Вторая модель не знает ваших терминов. Каскад переносит её ошибку («OpenSpeak»). Без требования латиницы каскад ещё и добавляет 7 п.п. WER.
-
Чистовик меняет 17–26% текста. Интерфейс должен показывать, что текст уточнился, иначе это выглядит как сбой.
-
Steal соседей по хосту съедает до трети скорости пакетного прохода. Смотрите колонку st в vmstat перед замером, я наступил на это второй раз.
-
Parakeet на русском не быстрее GigaAM на старом CPU (39 против 21 минуты на час записи). На ноутбуке с i9 было наоборот.
Что я бы посоветовал
Если вам нужны и живые субтитры, и нормальный итоговый текст на русском:
-
Делите работу по времени. Потоковая модель пишет черновик во время звонка, пакетная переписывает его после. Черновик заменяйте целиком, не склеивайте: при соотношении восемь исправлений к одной порче склейка не окупится.
-
Не ограничивайте чистовик потоками на слабой машине. Ставьте nice 19 и по возможности переносите его на ночь. Живые субтитры от соседства с ним не страдают, отставание фразы осталось 1,08–1,20 с.
-
Термины чините личным словарём, а не второй моделью. Если речь в основном русская, а термины одиночные, вторая модель повторяет ту же ошибку другими буквами.
-
Не верьте эталону, собранному из нескольких моделей, пока не переслушали выборку. Сорок случайных мест хватило, чтобы увидеть перекос в 1,5–3 п.п. в пользу моделей-источников.
-
Считайте отдельно ошибки в числах. Средний WER их не показывает, а в итогах встречи цена ошибки в сумме или сроке выше, чем в любом другом слове.
-
Свой сервер имеет смысл примерно с 36–59 часов встреч в месяц или если аудио обязано оставаться в России. При меньшем объёме дешевле и проще облако.
Вопрос к читателям
На сколько Вам было бы интересно проводить 1-2-1 созвон с онлайн транскрибацией в моменте?
Если вы проводите 1-2-1 и к вам пришел сотрудник который много всего рассказывает или это Ваш 1-2-1 с вашим руководителем который накидывает Вам сразу с десяток поручений в диалоге – то как вы фиксируете все услышанное?
Все числа получены прогонами stt-lab на узле B. Код стенда: GitHub, GitVerse.
Автор: Denizen24

