


Меня зовут Анастасия, я руководитель направления ИТ-комплаенса в РГС. Перед каждым циклом планирования мне нужно разбирать и оценивать сотни задач, чтобы определить, какие из них требуют внимания в первую очередь. На это обычно уходила целая рабочая неделя, и я решила поискать способ упростить этот процесс, чтобы освободить время для более сложной экспертной работы. В итоге мне удалось автоматизировать часть рутины с помощью ИИ, и в этой статье я как раз хочу поделится, как, не имея бюджета на разработку и навыков программирования, я сократила время разбора задач с пяти рабочих дней до двух.
Пятьсот задач и один эксперт
Перед каждым циклом планирования команды разработки собирают сотни задач, и каждую оценивают по нескольким критериям, чтобы решить, что брать в работу первым. Один из критериев — ИТ-комплаенс: насколько реализация задачи в информационной инфраструктуре помогает компании соблюдать требования законодательства. Пропустить важную задачу значит рискнуть штрафом, переоценить неважную значит отнять место в плане у нужной доработки.
Процедура приоритизации только стартовала, и в пилоте участвовали всего два «поезда», то есть два крупных направления разработки. Уже первый цикл принёс около 500 задач, и их разбор занял целую рабочую неделю единственного эксперта направления. В это время стояли задачи, ради которых комплаенс существует: анализ новых задач для выставления и реализации требований, сопровождение сложных проектов.
А впереди было подключение остальных поездов. Если ничего не менять, оценка задач заняла бы большую часть квартала, а расширить команду под пиковую нагрузку возможности не было. Фильтр по ключевым словам в данном случае не работает: формулировки слишком разные у разных команд, и искать нужно не слова, а смысл.
Первая идея была скромной: научить ИИ хотя бы отделять задачи, которые эксперту нужно посмотреть, от тех, что можно пропустить. Не заменить эксперта, а снять с него рутину. Забегая вперёд: получилось больше, чем задумывалось.
Шаг №1: проверить гипотезу за минимальную цену
Логика оценки критерия приоритизации всегда неизменны: прочитать описание задачи, сравнить с критериями, поставить цифру, закрыть задачу. Ровно это может делать языковая модель. Но сначала идею нужно было проверить, причём максимально дёшево.
Я сделала обезличенную выгрузку задач и отдала её нескольким внешним моделям вместе с инструкцией по критериям. С первого раза не получилось, но после нескольких итераций по изменению промпта и инструкции, модели начали давать стабильный результат.
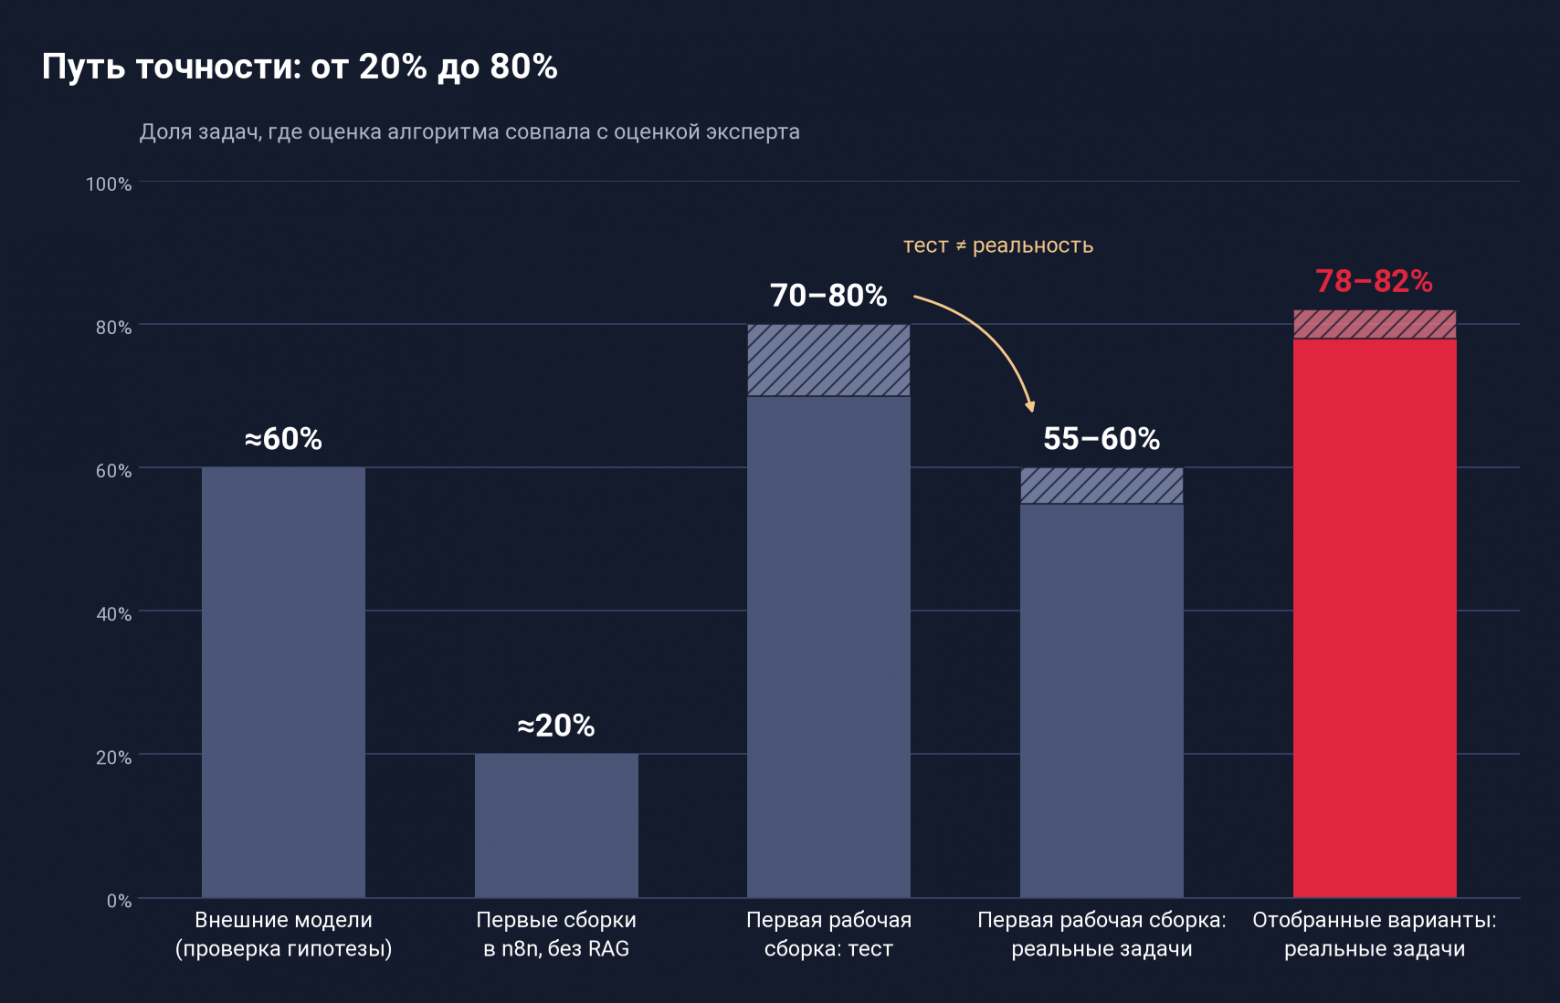
Затем я сравнила оценки моделей со своими экспертными оценками. Стартовая точность составила около 60%, а ошибки чаще шли в сторону завышения. Это было год назад, на самом старте поиска решений. Для моей задачи это был ключевой вывод: модель-перестраховщик может надёжно отсеивать то, что точно не требует внимания эксперта, и вручную останется разобрать малую часть задач. Оценки обратно в систему можно было загрузить скриптом через администратора.
Для старта это был обнадёживающий вывод: модель скорее перестрахуется, чем пропустит важное. Значит, её можно использовать хотя бы как фильтр, а это уже экономия времени эксперта. Но результат можно попробовать улучшить.
Шаг №2: локальный ИИ и автоматизация
У первого варианта было три слабых места:
-
Ручная работа. Подготовка выгрузок, передача модели, сбор ответов съедали часть экономии.
-
Обезличивание. Вместе с деталями терялась часть смысла, и это влияло на точность.
-
Зависимость от внешних сервисов. Инструмент в любой момент может перестать работать в России, а ресурсов на срочный поиск альтернативы нет.
Оставалось два пути: корпоративное решение или локальная модель на ноутбуке. С корпоративным сходу не сложилось, и я пошла по второму. Локальная модель работает прямо на компьютере: данные никуда не уходят, и она не зависит от внешних сервисов. Но ресурсы ноутбука ограничены, задачи приходится подавать порциями, и не любой ноутбук справится. Значит, нужен оркестратор, который будет управлять процессом.
Получилось собрать набор инструментов для моего решения:
-
n8n в роли оркестратора. Это визуальный конструктор, где процесс собирается из готовых блоков, и достаточно минимальных навыков программирования.
-
LM Studio и Ollama для запуска локальных моделей. В итоге я осталась на Ollama.
Возможно, есть более элегантное решение, но для старта и спасения себя этот набор подошёл как нельзя лучше: бесплатно, доступно, понятно неспециалисту.
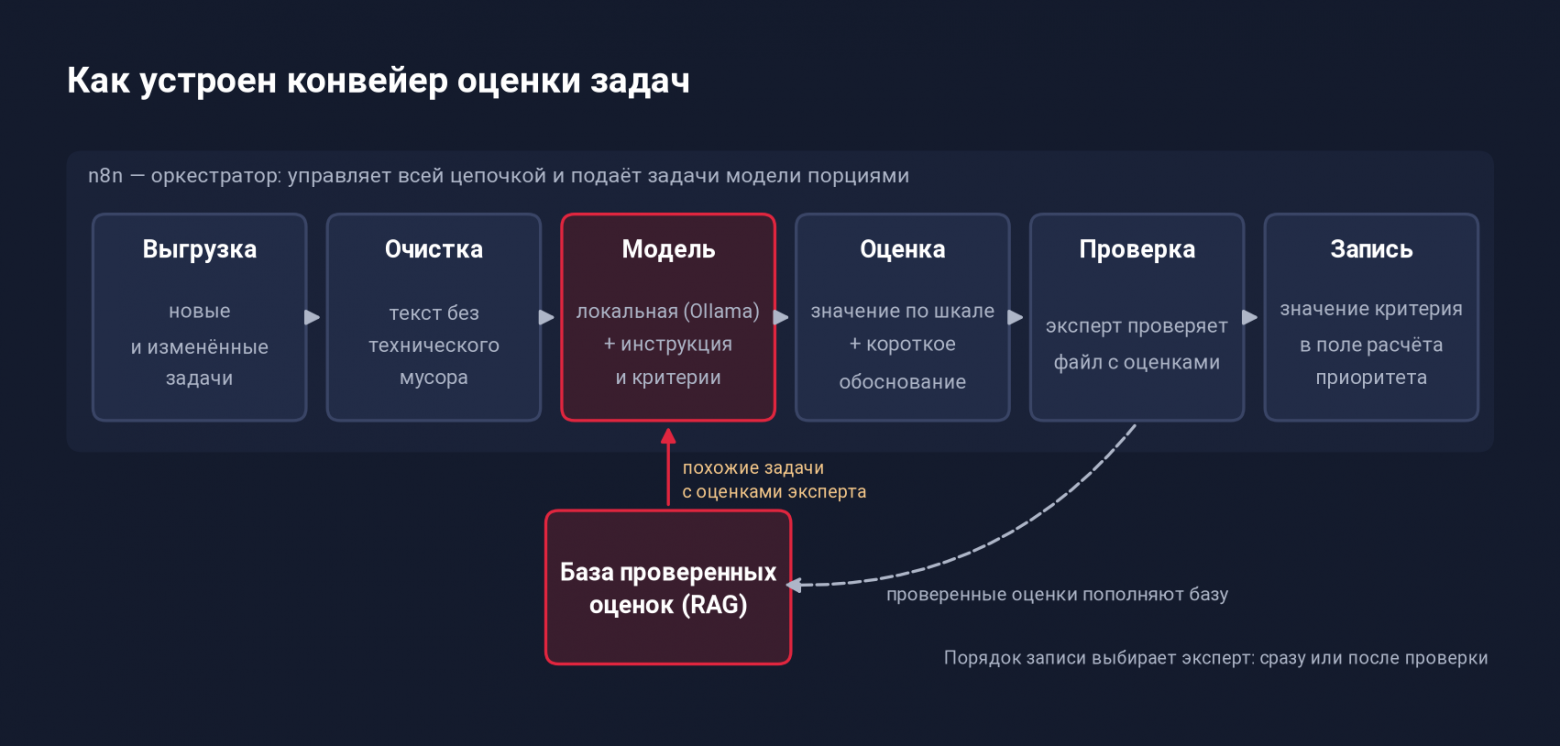
Конвейер устроен так: выгрузка задач, очистка текста от технического мусора, передача модели вместе с инструкцией, ответ в строгом формате (уровень по шкале оценок и короткое обоснование), сохранение результата.
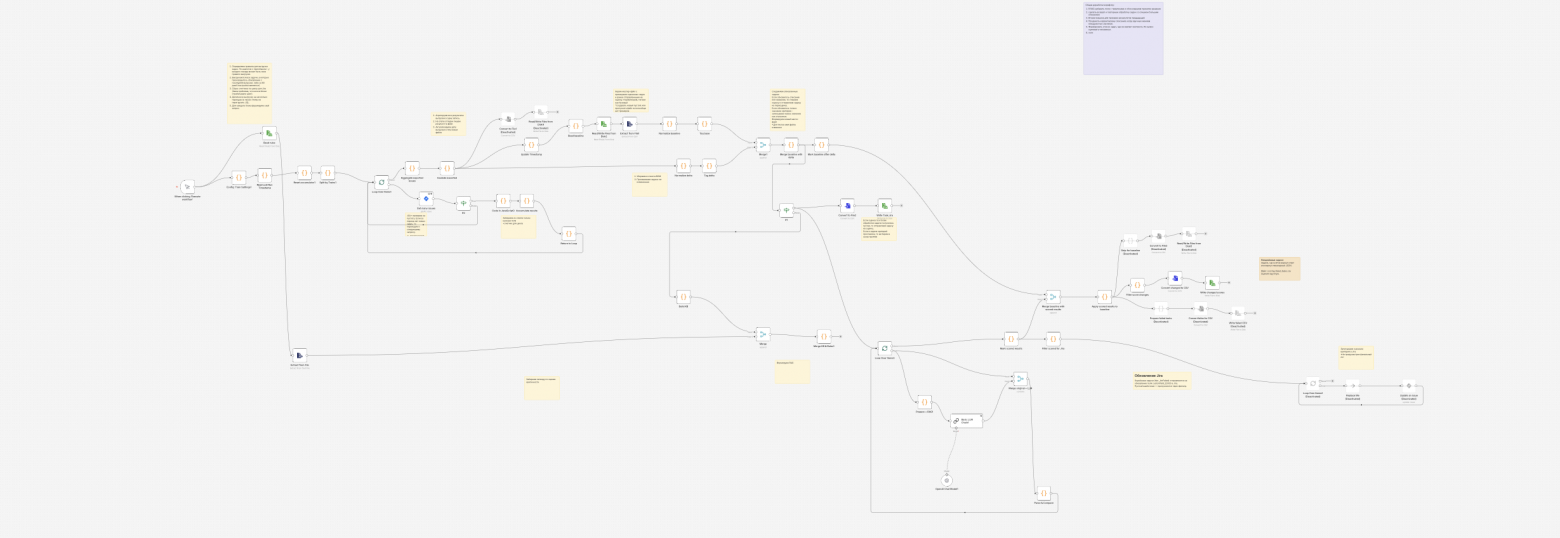
На схеме все выглядит аккуратно, а так в реальности выглядит самая простая сборка в n8n.
Ключевой элемент — база проверенных оценок (RAG). Получив задачу, модель находит похожие задачи, которые я уже оценила, и опирается на них. Проще говоря, она не угадывает, а смотрит, как похожие случаи оценивал эксперт.
Как проверить, что ИИ не ошибаетсяк
Вариантов сборок для автоматизации становилось всё больше, и нужна была система, которая позволит честно их сравнить. Использовать для этого ИИ избыточно: сравнить оценки и посчитать доли может обычная программа. Её я и написала с помощью ИИ (так быстрее). Программа сопоставляет оценки сразу нескольких алгоритмов с экспертными и считает четыре показателя:
-
Точное попадание: доля задач с той же оценкой, что у эксперта.
-
Попадание с допуском: ошибка не больше одной ступени шкалы.
-
Отсеивание лишнего: не пропускает ли алгоритм важные задачи и не отправляет ли эксперту лишние.
-
Куда смещаются ошибки: завышение означает лишнюю проверку, занижение — риск пропуска.
Так разговор «кажется, стало лучше» превратился в конкретные цифры.
От 20% до 80%
Первые сборки в n8n дали грустные 20% точности: базы проверенных оценок ещё не было. Дальше были модификации подбора примеров из базы, доработка промпта и подбор локальных моделей. Слишком тяжёлые модели намертво вешали ноутбук.
Первая хорошая рабочая сборка на моделях Qwen и GPT-oss давала 70–80% точности на тестовой выборке и обрабатывала 500 задач примерно за 12 часов. Однако на реальных задачах она даёт 55–60%: в живом потоке больше новых формулировок и систем, а также задач поездов, которые только подключаются к приоритизации.
Дальше появились варианты развития алгоритма:
-
несколько оценок от разных моделей или от одной модели с разными параметрами;
-
дополнительные знания;
-
обогащённые знания: встроенные в алгоритм или подключаемые через MCP.
Критерий отбора был простым: если при подключении новых поездов точность варианта проседала, он отметался. Выжившие варианты работают дольше стартовой сборки, но дают 78–82% точности на реальных данных, а ошибки в сторону завышения и занижения теперь уравновешены. В итоге получилось больше, чем задумывалось: вместо фильтра для эксперта — алгоритм, который сразу проставляет нужные значения, а эксперт их проверяет по необходимости. Время компьютера дешевле времени эксперта: чем точнее алгоритм, тем меньше ручной проверки.
Процесс и результаты
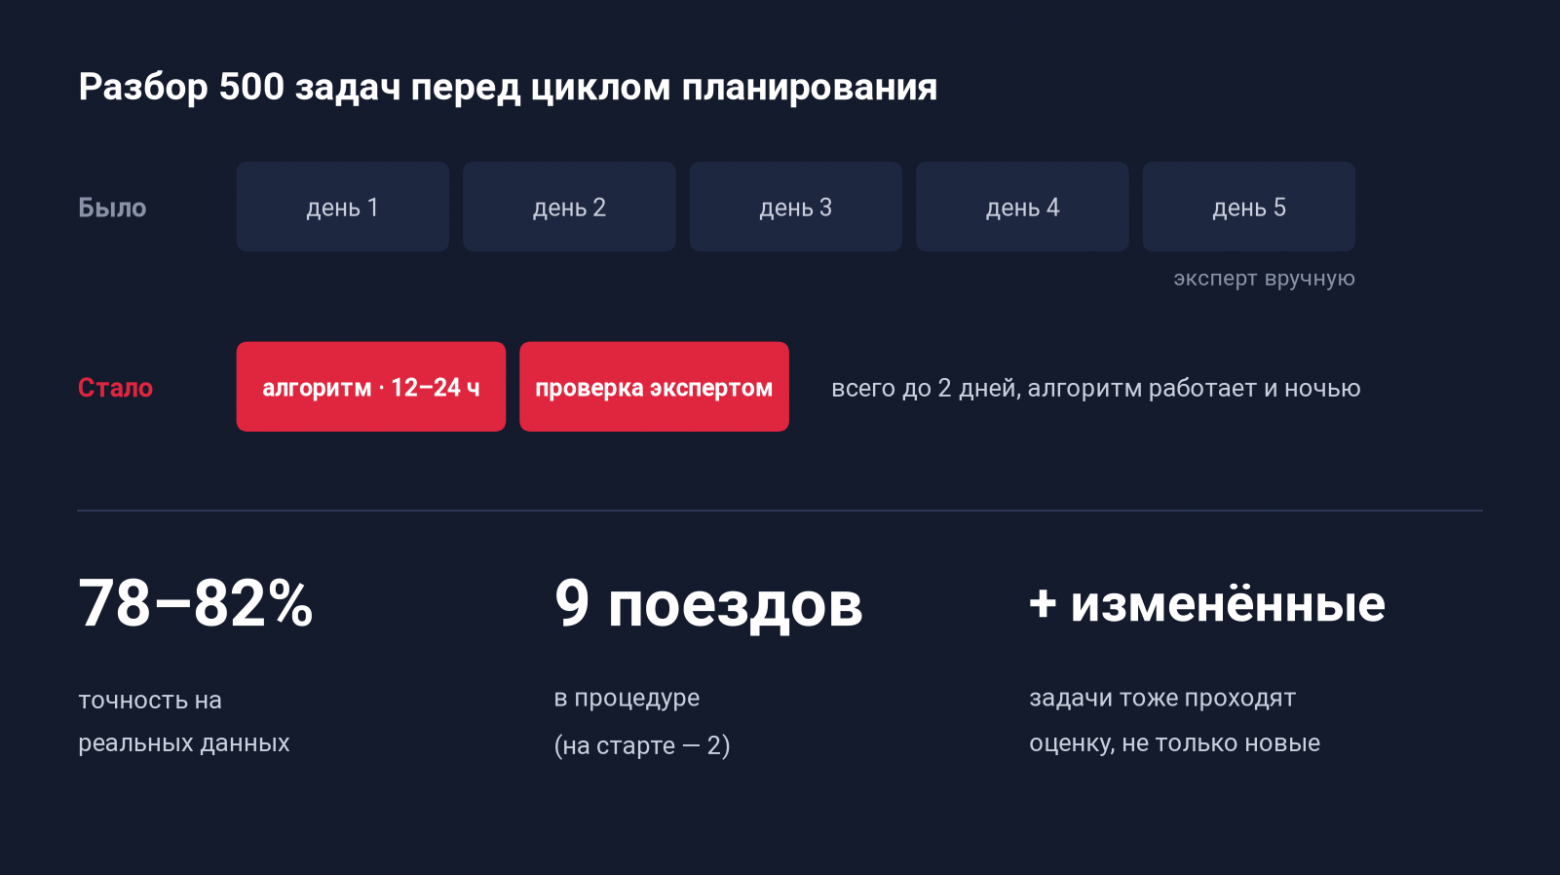
Было: вручную оценивались только новые задачи, и на 500 задач уходила неделя. Изменённые задачи повторно не проверялись, на это не хватало времени.
Стало: система приоритизации сменилась, но процесс выжил. Алгоритм сам выгружает новые задачи и задачи с изменённым описанием до начала реализации, проставляет оценки, отдаёт файл на проверку и записывает значение критерия в поле для расчёта приоритета. Записать значения можно сразу или после проверки, решает эксперт.
Итоги:
-
Время: 12–24 часа работы алгоритма на 500 задач, вместе с проверкой два дня вместо недели.
-
Точность: 78–82% на реальных данных.
-
Охват: оцениваются и изменённые задачи.
-
Масштаб: было два поезда, сейчас девять, и процесс справляется.
-
Стоимость: бесплатные инструменты, без ресурсов разработки.
Что дальше
Точность 80% для локального решения — хороший и стабильный результат, на нём я остановлюсь и буду периодически проверять, не снижается ли точность. Настало время вернуться к корпоративным инструментам, чтобы процесс не зависел ни от ноутбука, ни от одного эксперта. Корпоративный экземпляр алгоритма уже есть. Пока он работает в ограниченном режиме, но даёт сопоставимую точность в шесть раз быстрее. Осталось снять ограничения для полноценного использования всех функций.
Сам подход «прочитать, сопоставить с правилами, оценить» подходит многим операционным процессам, и другие функции могут переиспользовать этот опыт. Похожий процесс уже запускается в тестовом режиме на ИИ.
ИИ не заменил эксперта, но изменил его роль: вместо того чтобы проставлять цифры, эксперт управляет процессом и принимает решения там, где они действительно нужны.
Автор: Anastasiya_Bars

