


В феврале 2026 года OpenAI рекомендовала оценивать ИИ-агентов для программирования по бенчмарку SWE-Bench Pro. Но уже 8 июля отозвала собственную рекомендацию, признав, что примерно 30% задач SWE-Bench Pro составлены с ошибками. До этого компания отказалась от SWE-bench Verified, когда выяснилось, что модели видели часть его задач и ответов еще при обучении.
После этого возник вопрос: каким тестам вообще можно доверять?
И пока индустрия это выясняет, исследователи NVIDIA занялись другим вопросом, который особенно важен для разработчиков моделей для генерации кода и тех, кто собирает на их основе ИИ-агентов.
Как выбрать нужную модель, если только дообучение каждой из них может стоить сотни тысяч долларов?
В этой статье расскажу, почему привычные тесты для моделей, которые пишут код, плохо предсказывают, каким агентом станет модель, как NVIDIA проверяет модели по записям чужой работы и чем это полезно компаниям, которые нанимают виртуальных сотрудников в штат.
Почему популярные тесты моделей для генерации кода перестали работать
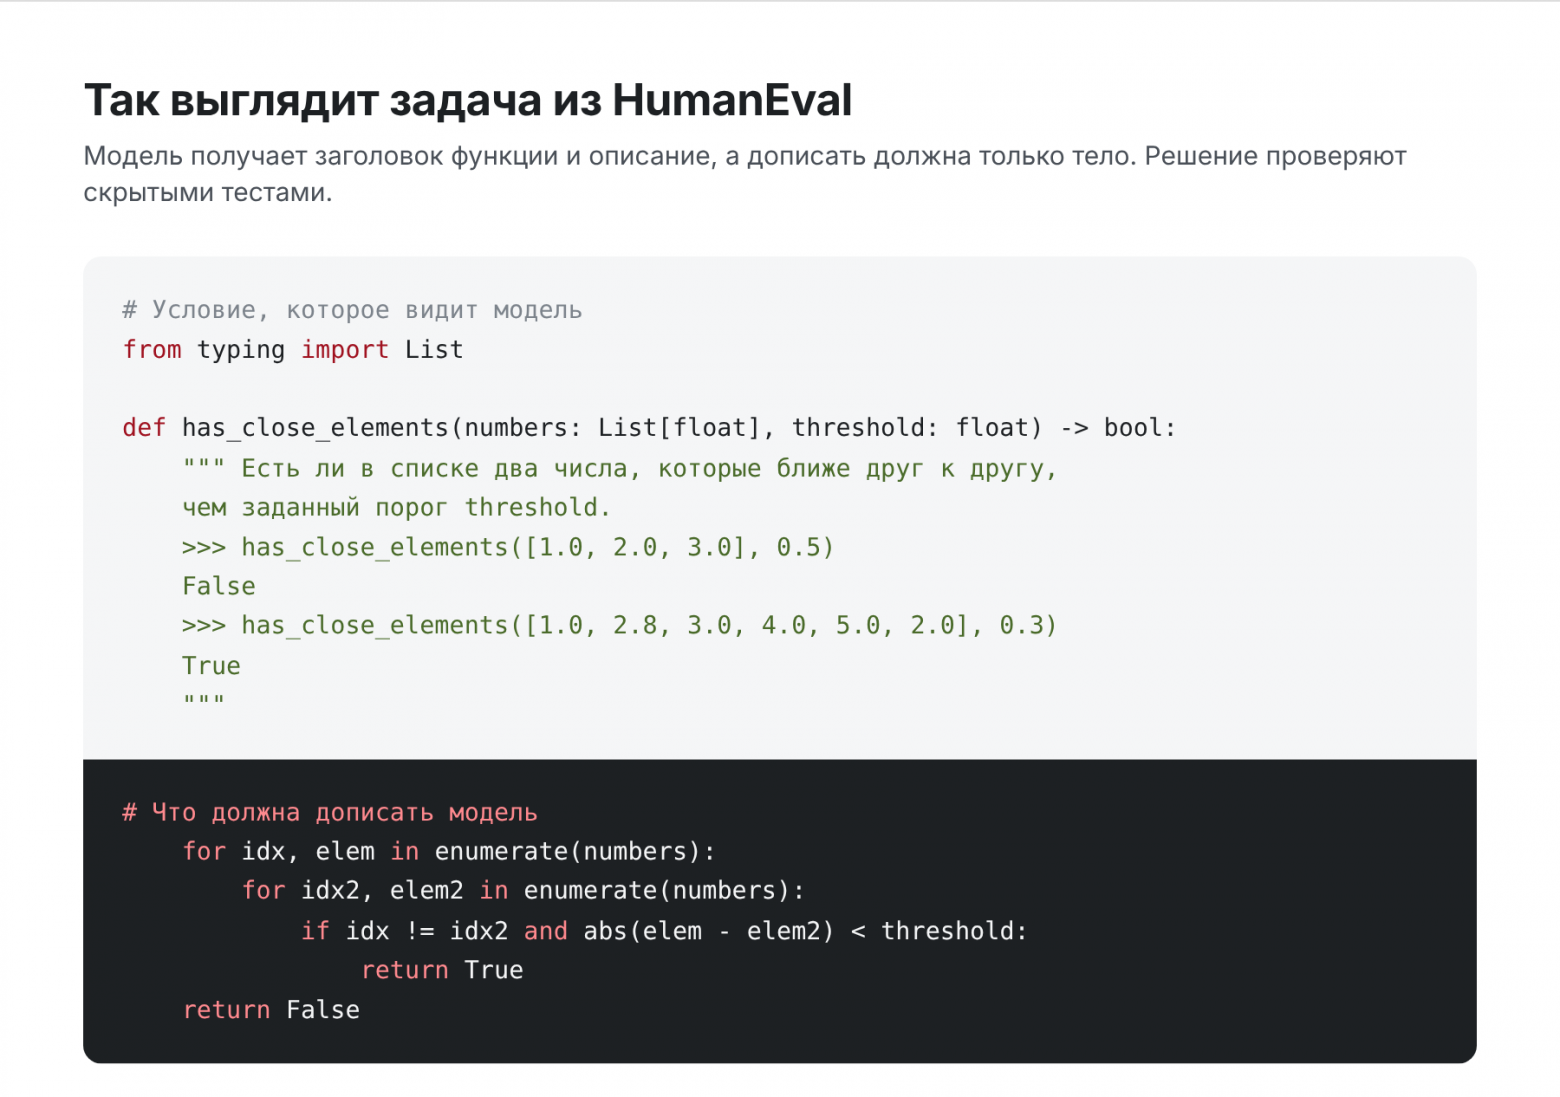
Один из самых известных тестов появился в июле 2021-го. Тогда OpenAI представила Codex, на основе которого потом сделали GitHub Copilot, и вместе с ним выпустила набор из 164 задач HumanEval, в каждой из которых модель должна по описанию написать небольшую функцию на Python.
Задачи авторы придумывали сами, потому что Codex обучался на большой части GitHub, а там лежали готовые решения задач из открытых сборников. Авторы признавали, что по сложности их задачи похожи на простые вопросы на собеседовании программиста. Однако даже такие задачи Codex с первой попытки решал лишь в 28,8% случаев, а GPT-3 вообще не решил ни одной.
Следующие несколько лет результат на HumanEval оставался одной из главных цифр в анонсах новых моделей для генерации кода. При этом получалось, что будущих ИИ-программистов индустрия отбирала по тесту, который подошел бы для первого созвона с джуниором.
В этой истории есть интересное совпадение. В 2017 году исследователи Google предложили архитектуру трансформера, на которой сегодня построены почти все языковые модели, от GPT до Claude. Первым автором той статьи был Ашиш Васвани. В статье OpenAI про Codex его благодарят за помощь в обсуждении черновика, а спустя пять лет он оказался среди авторов работы NVIDIA.
Выходит, что человек, который помогал обсуждать статью, где появился HumanEval, подписал и работу, в которой этот тест оказался связан с итоговым качеством агентов слабо, да еще и в обратную сторону.
Как задачи из тестов попали в обучающие данные
У HumanEval есть и другая проблема. Его задачи давно лежат в открытом доступе, а модели учатся как раз на открытых данных из Интернета.
В 2023-м исследователи из Беркли нашли от 8 до 18% задач HumanEval в популярных обучающих наборах RedPajama и StarCoder-Data. Команда Allen AI, когда собирала данные для модели Tülu 3, обнаружила открытый датасет, который совпадал с HumanEval на 70,7%. А в отчете о Llama 3 прямо признается, что способ поиска совпадений находит с HumanEval так много пересечений, что оценить, насколько они завышают результат модели, не получилось.
Со временем на смену HumanEval пришел тест посложнее, SWE-bench Verified. Он состоит из 500 реальных задач из 12 открытых проектов на Python. Задачи взяты из обращений на GitHub, где пользователи сообщают об ошибках и просят доработок, и агент должен решить каждую так, чтобы прошли тесты проекта. В 2024-м OpenAI отобрала эти задачи из более раннего SWE-bench, который сделали в Принстоне, и каждую независимо проверяли три разработчика.
23 февраля 2026 года OpenAI объявила, что перестает публиковать результаты на SWE-bench Verified. Причина была в том, что компания перепроверила 138 задач, которые ее модель o3 стабильно не решала, и в 59,4% случаев нашла ошибки в тестах или в описании задачи. Кроме того, GPT-5.2, Claude Opus 4.5 и Gemini 3 Flash для части задач смогли по номеру задачи или короткой подсказке воспроизвести эталонное исправление, то есть ту правку, которую когда-то внесли сами разработчики проекта, или дословные детали условия.
В OpenAI сравнили это со студентами, которые получили задания и ответы еще до экзамена. Даже если они не выучили все наизусть, сдадут они все равно лучше тех, кто ответов не видел.
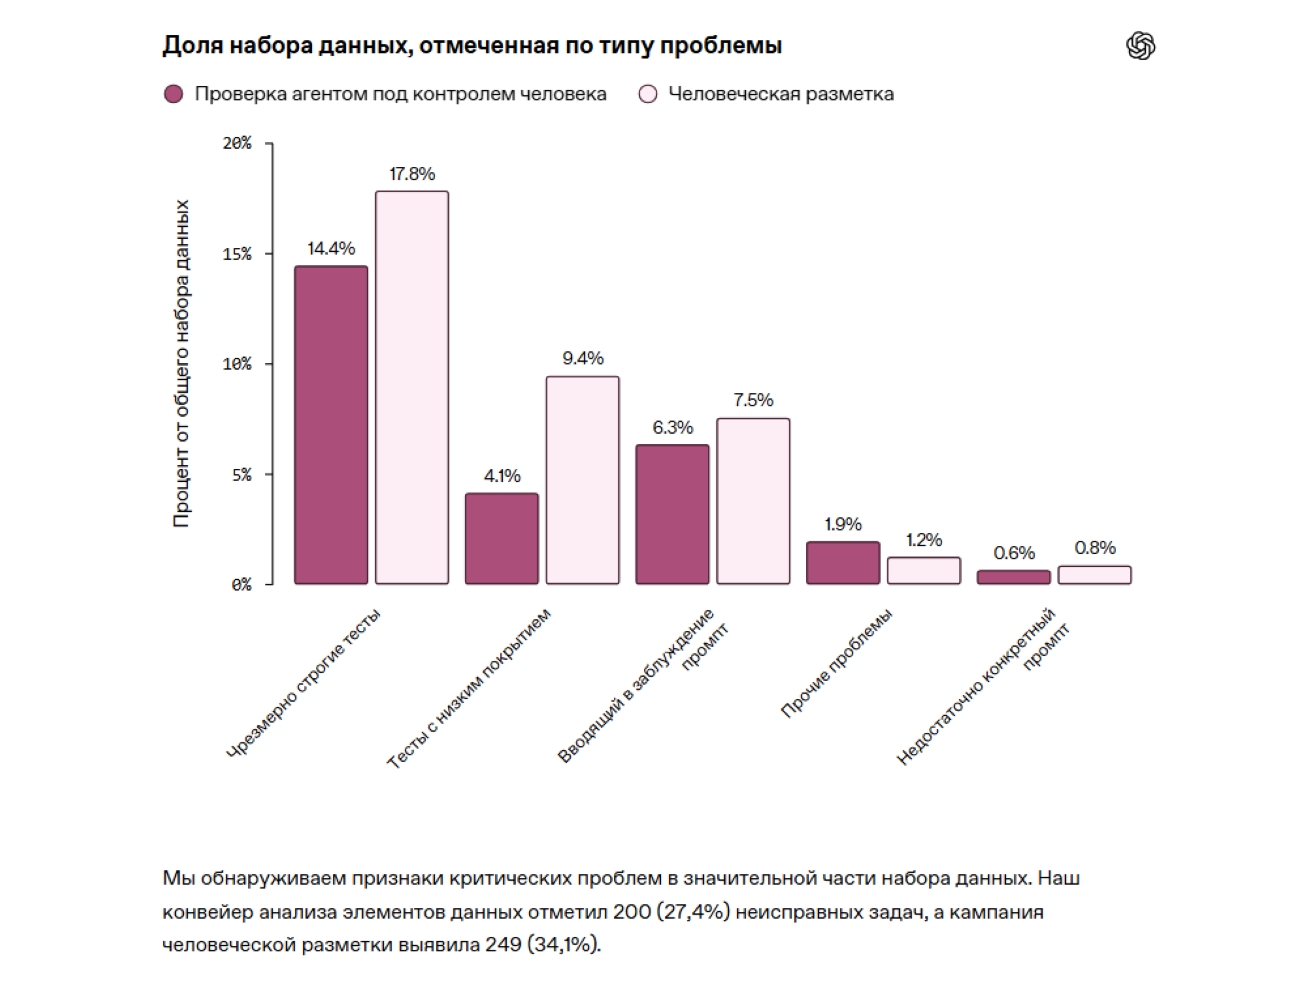
После этого вместо SWE-bench Verified OpenAI рекомендовала перейти на SWE-Bench Pro, а меньше чем через пять месяцев проверила и его. Автоматический фильтр отобрал 286 подозрительных задач, после чего их параллельно разобрали ИИ-агенты и инженеры, причем каждую задачу смотрели пять опытных разработчиков.
В результате OpenAI пришла к выводу, что около 30% задач в этом тесте сломаны, то есть решить их честно, следуя условию, нельзя.
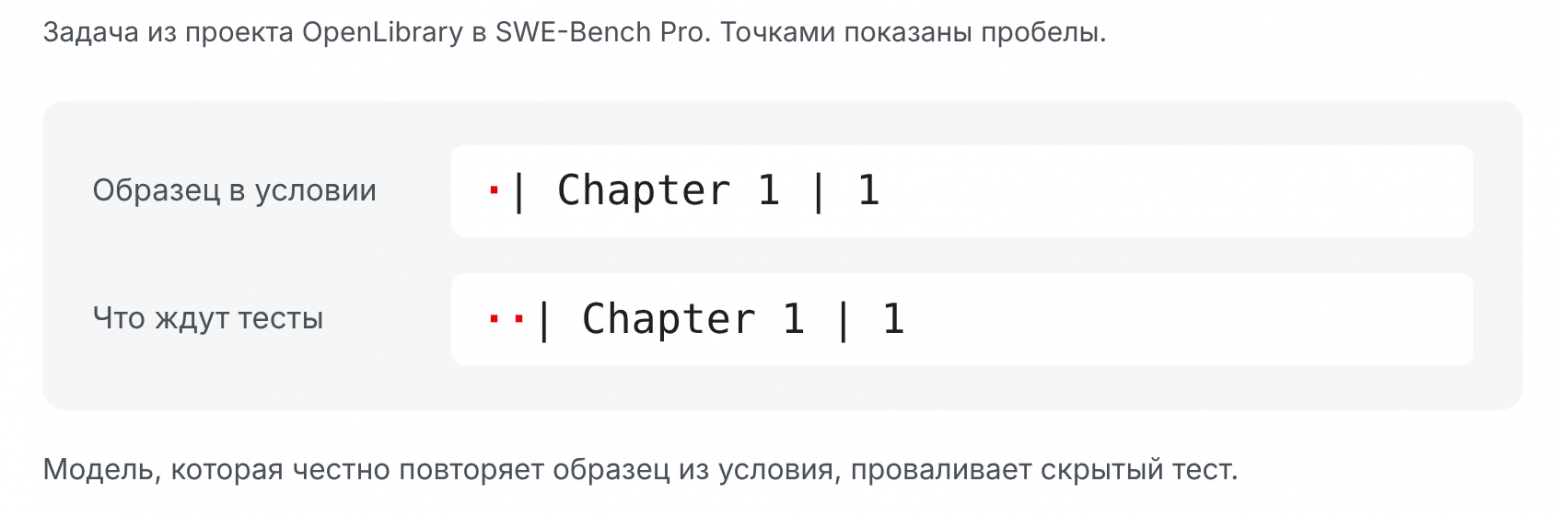
Хорошо это видно на примере задачи из проекта OpenLibrary, которую OpenAI разбирает в своем отчете. Модель просят привести строки оглавления к единому виду, и в условии показан образец с одним пробелом в начале, а скрытые тесты ждут два пробела, поэтому модель, которая честно делает то, что написано в условии, задачу проваливает.
Получается, что за пять лет индустрия сменила три популярных теста для ИИ-программистов, и у каждого нашлись серьезные проблемы. В первых двух часть задач и ответов попала в обучающие данные моделей, а в третьем заметная доля задач оказалась составлена с ошибками.
Почему выбор модели для агента обходится так дорого
Чтобы понять, какую задачу решали в NVIDIA, нужно знать, как вообще появляется модель для агента.
Ее делают в два этапа, и на первом, который называют предобучением, нейросеть читает триллионы токенов текста и кода и учится предсказывать, что будет дальше.
После этого получается базовая модель. Ее можно сравнить с выпускником, который прочитал всю библиотеку, но ни дня не работал, поэтому в теории знает он много, но на практике не умеет ни вести диалог, ни пользоваться рабочими инструментами.
На втором этапе базовую модель дообучают и превращают в ассистента или агента. Если продолжать сравнение с наймом, это онбординг вместе с испытательным сроком, который обходится разработчикам недешево.
Важно различать модель и агента. Сама модель только пишет текст, а агентом ее делает обвязка, то есть программа вокруг нее, которая дает доступ к терминалу и файлам, возвращает результаты команд и решает, когда работа закончена. Одна и та же модель в разной обвязке может выглядеть как два разных сотрудника, поэтому цифры из чужих таблиц сравнивать особенно трудно.
Например, на дообучение модели R1, включая подготовку данных, в DeepSeek потратили около 147 000 GPU-часов на ускорителях NVIDIA H800. Один GPU-час означает час работы одного такого ускорителя.
Сама компания считает аренду этого часа по 2 доллара, так что это примерно 294 000 долларов — около 5% от 2,788 млн часов, или почти 5,6 млн долларов, которые ушли на полное обучение базовой DeepSeek V3. Но здесь учтен только последний, удачный вариант обучения, без всех пробных запусков перед ним.
По оценке Epoch AI, у OpenAI и китайских MiniMax и Z.ai на итоговые прогоны, то есть обучение той версии модели, которую потом выпускают, уходит лишь меньшая часть исследовательских вычислений, а остальное тратится на эксперименты вокруг них. Авторы NVIDIA подчеркивают, что раскрыть агентные способности модели можно только ценой больших затрат на вычисления, инженерную работу и оценку.
Отсюда и задача, ради которой написана работа NVIDIA. Кандидатов на роль агента обычно несколько, доучить каждого и сравнить результаты слишком дорого, поэтому выбирать приходится заранее, когда еще непонятно, кто справится лучше.
Что будет, если сразу дать базовой модели реальную задачу
Самое очевидное решение состоит в том, чтобы сразу посадить кандидатов за реальную работу и посмотреть на результат. В NVIDIA такой вариант тоже попробовали и запустили шесть базовых моделей в роли агентов на SWE-bench Verified.
Вот что из этого получилось:
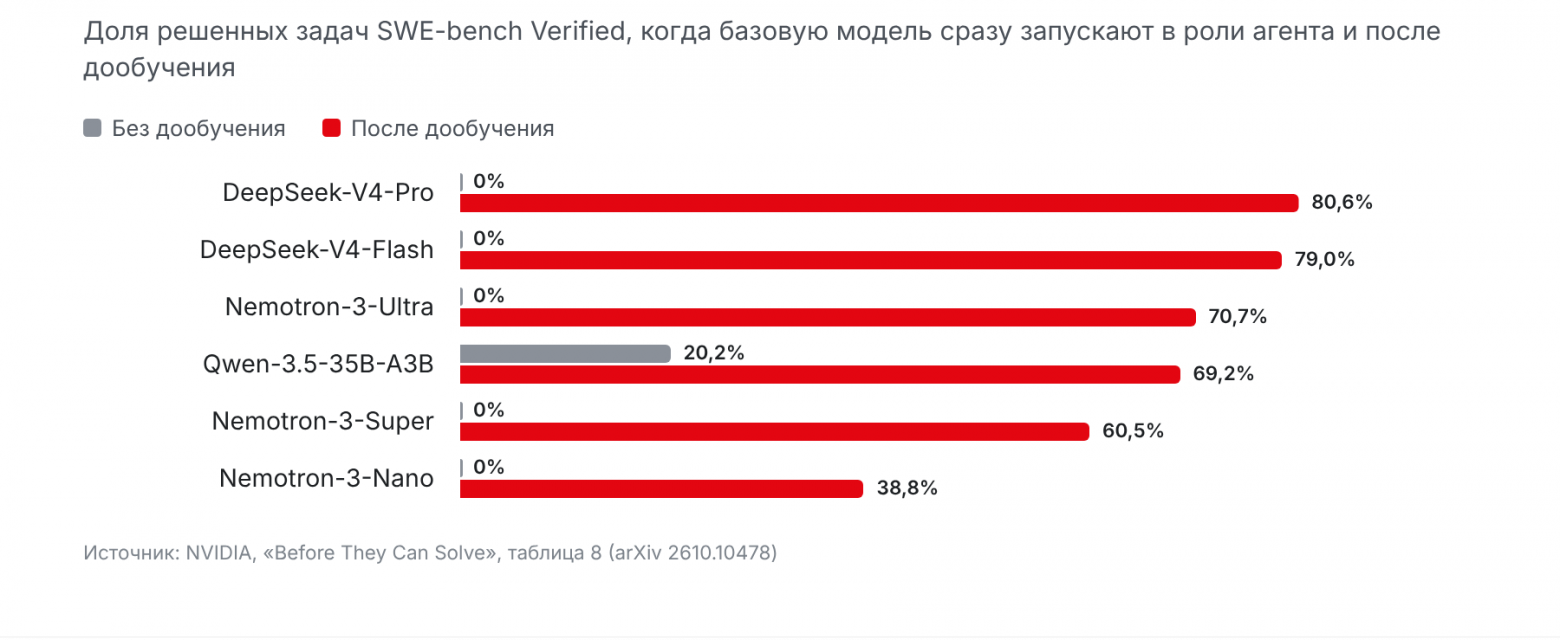
Пять моделей из шести не решили ни одной задачи, хотя после дообучения те же модели решают от 39 до 81% задач. Единственная модель, которая хоть что-то решила, в итоговом рейтинге среди этих шести заняла только четвертое место. По мнению авторов, Qwen просто лучше остальных знаком с форматом, в котором работают агенты.
В нашей аналогии с наймом получается, что дело не в уме, а в том, что кандидат раньше видел нужные бланки.
Что мешает остальным, хорошо видно по приложениям к исследованию. Одной из моделей дали начало реплики, после которого должен идти вызов инструмента, то есть команда вроде «открой файл» или «запусти тесты», и почти половина ее ответов превратилась в обычный текст. Причем больше чем в половине таких ответов модель сама придумала результат выполнения команды или следующую реплику пользователя.
Представьте кандидата, который вместо ответа на вопрос начинает дописывать стенограмму собеседования за себя, за интервьюера и за HR. Злого умысла тут нет, ведь базовая модель умеет только продолжать текст, вот она его и продолжает.
Можно попробовать и другой путь, дав кандидатам простой тест вроде HumanEval, с которым базовая модель точно справится. Но, как будет видно дальше по цифрам, такой тест скорее запутает, чем поможет.
Как NVIDIA проверяет модель по записи чужой работы
7 октября 2026 года группа из 22 исследователей NVIDIA опубликовала работу Before They Can Solve, что можно перевести как «Пока они еще не умеют решать». Их идея в том, чтобы не требовать от кандидата того, чего он пока не умеет. Вместо этого ему показывают, как задачу решал опытный коллега, и проверяют, понимает ли он, что делать в самый важный момент.
Записи работы берут у сильных готовых агентов, GPT-5.6-Sol от OpenAI, Claude Opus 5 от Anthropic и Kimi-K3 от Moonshot AI, которые решали задачи из SWE-bench Verified, SWE-Bench Pro и нового бенчмарка DeepSWE. В DeepSWE собраны оригинальные задачи на разных языках программирования, составленные специально для этого теста, и для каждой написана своя проверка. В каждой такой записи (ее называют траекторией) видно, какой файл агент открыл, какую команду запустил и что именно поправил в коде.
Затем запись проигрывают по шагам и после каждой правки кода запускают тесты проекта. Так находят решающий шаг, то есть первую правку, после которой тесты проходят. Все, что было до этого шага, можно считать подготовкой, а то, что после, к решению задачи может уже не относиться.
Проверку кандидата проводят как раз на решающем шаге. Ему не нужно самому разбираться во всем репозитории, потому что этот путь за него уже прошел опытный агент, и остается понять, увидит ли он правильный ход.
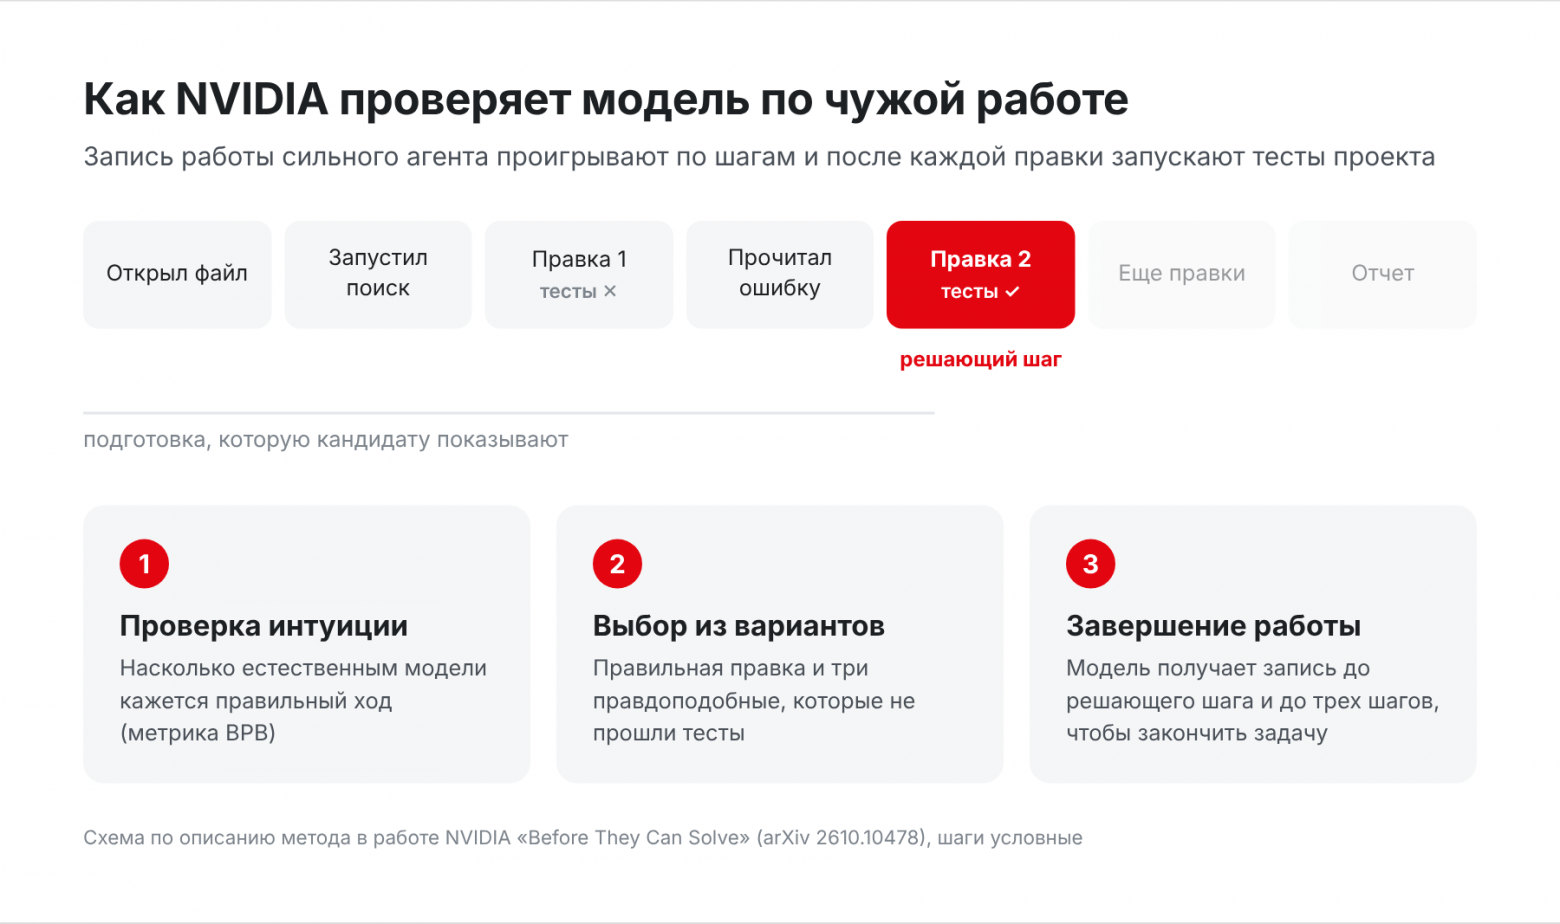
Три способа проверки
Первый способ похож на проверку интуиции. Кандидату показывают правильный ход и смотрят, насколько естественным он ему кажется. Для этого считают BPB, или бит на байт. Эта величина показывает, сколько информации в среднем модели нужно, чтобы закодировать каждый байт правильного ответа. Чем она меньше, тем меньше модель «удивлена» правильным ходом и тем ближе он к тому, что она сама считает очевидным. Служебную разметку, в которую заворачивают команду, при этом не учитывают, чтобы проверять смысл действия, а не знание формата.
Второй способ напоминает кейс с вариантами ответа. Кандидату дают четыре варианта следующего шага, один правильный и три правдоподобных, которые придумали другие сильные модели и которые не прошли тесты проекта. Языковые модели нередко чаще выбирают определенную букву, например A, поэтому варианты по очереди ставят на все позиции.
Третий способ похож на ситуацию, когда коллега ушел в отпуск и нужно закончить его работу. Кандидату отдают запись до решающего шага, и дальше он действует сам, у него есть до трех шагов и несколько попыток. Задача засчитывается, если хотя бы одна попытка прошла тесты. В исследованиях такую метрику обозначают pass@k, где k означает число попыток. Чтобы модель снова не ушла в обычный текст, начало команды за нее вписывают заранее, и ее первое же слово оказывается внутри действия.
У всех трех способов есть общая черта. Правильный ответ в них определяет не человек и не другая нейросеть, а тесты самого проекта. Тесты тоже бывают неточными, это мы видели на примере SWE-bench, но это хотя бы объективный судья, а не чье-то мнение о том, какой ответ лучше.
Насколько точно работает метод NVIDIA
NVIDIA проверила своим методом десять базовых моделей, среди которых три Nemotron-3, Qwen-3.5-35B-A3B, DeepSeek-V4 Flash и Pro, Kimi-K2, GLM-4.5-Air, Hy3 от Tencent и Gemma-4-26B. Потом исследователи сравнили, в каком порядке модели расставили проверки и в каком их расставила практика, то есть результаты дообученных версий на SWE-bench Verified.
Совпадение двух рейтингов считали с помощью корреляции Спирмена. Если она равна единице, порядок совпадает полностью, при нуле связи нет, а при минус единице рейтинг перевернут. Для сравнения так же проверили и привычные тесты для кода. MBPP от Google состоит примерно из тысячи простых задач на Python. В CRUXEval модель должна угадать, что выдаст фрагмент кода (вариант O) или что ему подали на вход (вариант I). LiveCodeBench собирает свежие задачи с соревнований по программированию, а в RepoBench модель дописывает код с учетом остальных файлов проекта.
Получилось следующее:
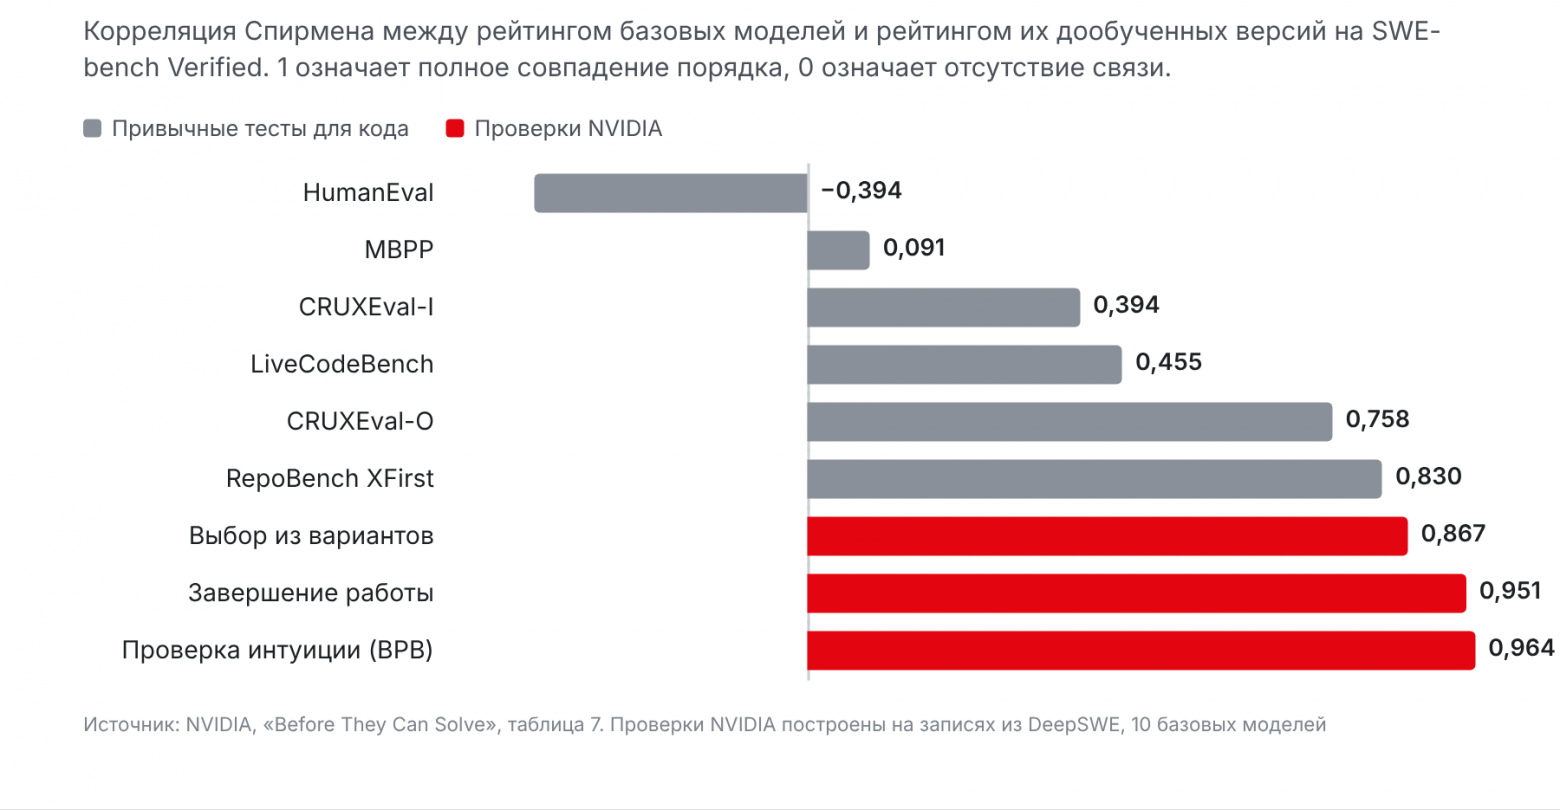
Цифры на диаграмме не проценты, а значения корреляции. Чем ближе к единице, тем точнее проверка угадывает порядок моделей. Так, 0,964 означает почти полное совпадение с итоговым рейтингом, а у HumanEval с его −0,394 связь слабая и обратная.
Здесь проверки NVIDIA построены на записях из DeepSWE, то есть на другом бенчмарке, а не на том, с которым их потом сравнивают. Если брать записи из самого SWE-bench Verified, завершение чужой работы показывает совпадение до 0,988.
HumanEval на этой диаграмме выглядит хуже всех.
В этой выборке модели с более высоким результатом на нем в среднем оказывались чуть более слабыми агентами. Авторы считают, что во многом дело в узком разбросе результатов у таких тестов. Например, у десяти моделей результаты MBPP уложились в диапазон от 67 до 86% решенных задач, а итоговые результаты агентов разошлись от 38,8 до 80,6%. Когда результаты теста сбиты в такой узкий диапазон, он плохо помогает отличить сильного кандидата от слабого.
Также стоит сказать про проверку интуиции. BPB по сути показывает, насколько хорошо модель «сжимает» правильный ответ, а о связи сжатия и интеллекта мы недавно рассказывали в статье про Юргена Шмидхубера, одного из пионеров нейросетей.
Работа NVIDIA ссылается на то же исследование 2024 года Compression Represents Intelligence Linearly, но добавляет важную деталь. Если считать BPB по всем шагам записи, совпадение с итоговым рейтингом равно 0,915, а если только на решающем шаге, то 0,964. Выходит, что для прогноза важнее не то, как модель воспринимает запись целиком, а то, насколько естественным ей кажется правильный ход в нужный момент.
Отдельно авторы проверили себя в контролируемых условиях. Они дообучили три базовые модели по одной и той же программе, 1000 шагов на 16,8 млрд токенов, и порядок трех получившихся агентов совпал с порядком официальных версий этих моделей, а все три способа проверки, построенные на записях из SWE-Bench Pro, его угадали.
На записях из других бенчмарков совпадение было слабее. При этом авторы пишут, что трех моделей для точной оценки мало, и называют результат продолжением тренда, а не доказательством.
Ошибки в тесте APTBench
NVIDIA была не первой, кто попробовал проверять базовые модели на будущие агентские навыки. Годом раньше Tencent и Шанхайский университет Цзяотун выпустили APTBench, где тоже превращали записи работы агентов в вопросы. Разница в том, что неправильные варианты ответов, а частично и правильные, там готовили с помощью языковых моделей.
В NVIDIA перепроверили 1682 вопроса из четырех разделов APTBench и признали некорректными 727 из них, то есть 43,2%. В разделе про обработку ошибок доля таких вопросов дошла до 90,5%. В одном вопросе спрашивают, как обрабатывались данные, а «правильный» ответ предлагает переустановить библиотеку torch_scatter. В другом варианты A и C дословно совпадают и звучат как «нужно запустить скрипт еще раз», но верным считается только A.
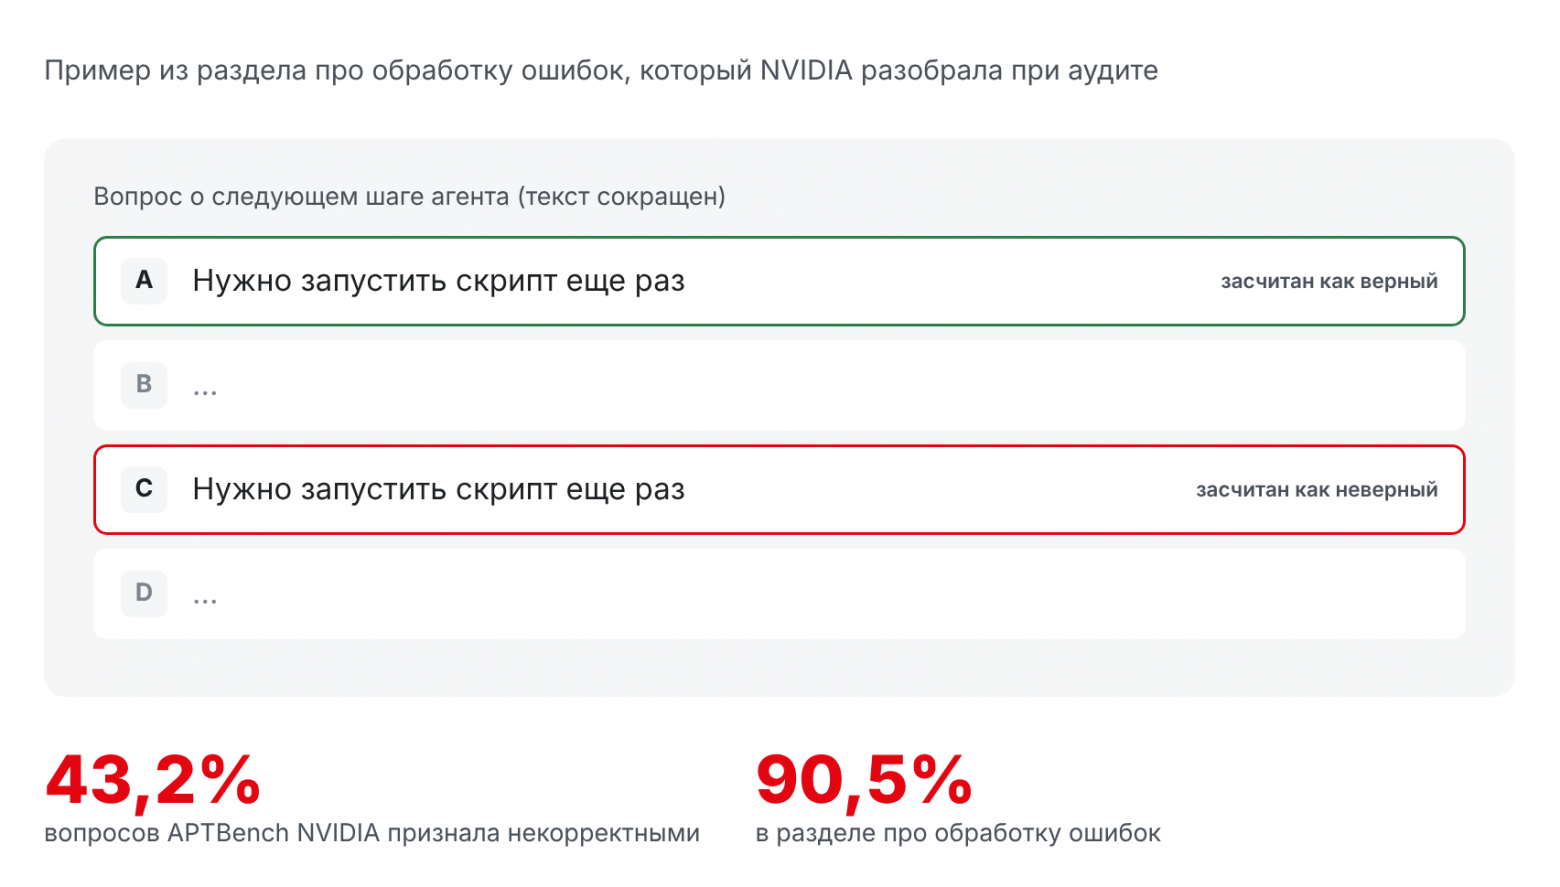
Справедливости ради, аудит NVIDIA тоже проводили по заранее заданным критериям с помощью ИИ-агента, а не полностью вручную. А общий результат APTBench, несмотря на ошибки, неплохо совпадает с итоговым рейтингом, корреляция составляет 0,88–0,90, так что доверять нельзя именно отдельным вопросам.
Кроме того, вывод о том, что обычные тесты плохо предсказывают качество агента, APTBench сделал еще до NVIDIA. Его авторы показали, что шесть моделей с почти одинаковым результатом на MMLU, популярном тесте на знания по 57 предметам, от 86 до 88%, после дообучения расходятся на SWE-bench Verified на 30 процентных пунктов. NVIDIA подтвердила это на новых моделях и предложила проверку, в которой правильные ответы определяют тесты, а не другая нейросеть.
Что говорят исследования о найме людей?
Скрытый текст
С наймом людей происходит похожая история, только длится она гораздо дольше. В 2022-м психолог Пол Сакетт вместе с соавторами пересчитал данные исследований за несколько десятилетий о том, какие методы отбора лучше всего предсказывают успех на работе.
Точность методов отбора в таких исследованиях тоже считают через корреляцию, только между результатом проверки и тем, как человек потом справляется с работой. Оказалось, что большинство методов предсказывают хуже, чем считалось раньше, и их оценки снизились на 0,10–0,20.
Например, у тестов общих способностей точность пересчитали с 0,51 до 0,31. На первое место вышло структурированное интервью с результатом 0,42, на котором всем кандидатам задают одинаковые вопросы о реальной работе. В число самых точных методов попали и другие проверки, привязанные к конкретной профессии, а общие тесты способностей опустились ниже.
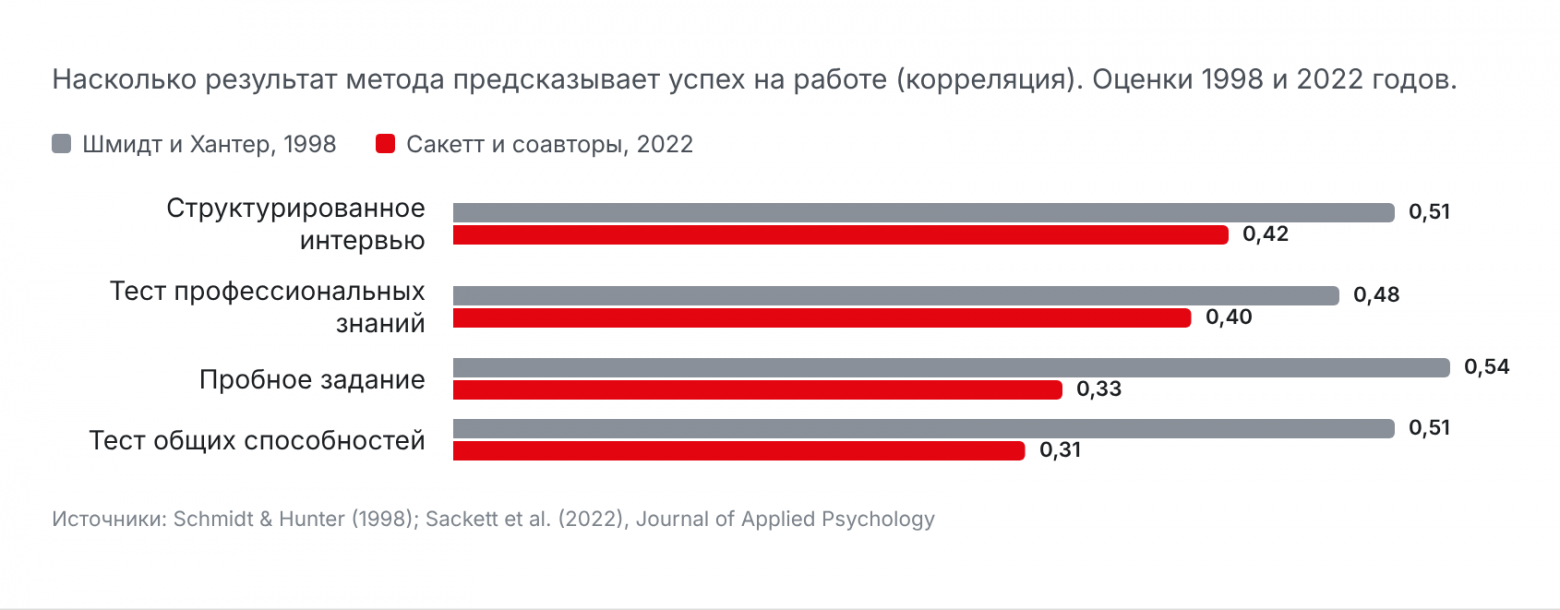
По своей логике метод NVIDIA похож на такое структурированное интервью, только для нейросетей. HumanEval в этой логике похож на тест на общую эрудицию, который давно все сдают на «отлично». А исследователи найма, как выяснилось, больше двадцати лет переоценивали точность собственных методов. В старых расчетах слишком сильно делали поправку на то, что в исследования попадали только уже нанятые люди, и из-за этого точность методов выглядела выше.
Почему дообучение не исправит неудачный выбор
У метода NVIDIA есть теоретическая основа, которую называют принципом покрытия. В работе, принятой на конференцию ICLR 2026, авторы теоретически обосновывают, что потенциал модели зависит от того, какую долю вероятности она уже отдает хорошим ответам, даже если сама выдает их редко. Привычная мера качества предобучения, перекрестная энтропия, показывает, насколько хорошо модель в среднем угадывает следующий токен. Итог дообучения она предсказывает плохо, а покрытие, по расчетам авторов, объясняет его гораздо лучше.
Если говорить на языке найма, потенциал кандидата виден еще до обучения, и нужно только знать, куда смотреть. Решающий шаг в методе NVIDIA и есть такое место.
Вторая опора метода связана с исследованием ученых из Университета Цинхуа, которое конференция NeurIPS 2025 отметила среди лучших работ года. Его авторы проверили, учит ли обучение с подкреплением модель чему-то принципиально новому. При таком обучении модель пробует разные действия и получает поощрение за удачные.
Ответ оказался отрицательным. Дообученная модель действительно чаще решает задачу с первой попытки, но если дать сотни попыток, базовая модель справится с большим числом задач.
Все решения, которые находит дообученная модель, уже были в арсенале базовой, а набор доступных решений по ходу обучения часто сужается. Жюри конференции назвало работу блестяще выполненным отрицательным результатом и отметило, что такое обучение усиливает уже знакомые модели пути, но не выводит ее за пределы исходных возможностей.
При этом авторы нашли способ, который действительно приносит модели новые навыки. Это дистилляция, когда модель учится на ответах более сильной модели.
К похожему выводу пришли авторы работы The Invisible Leash. По их данным, после обучения с подкреплением точность модели растет, но круг решений сужается, и верные, но редкие решения теряются. Любопытно, что за время доработки авторы смягчили название. Первая версия называлась «почему такое обучение может не вырваться за пределы исходной модели», а в нынешнем названии сказано, что может вырваться, а может и нет. Вопрос пока остается открытым.
Важно помнить, что обе работы изучали задачи на рассуждение вроде математики и кода, где на один вопрос нужно дать один ответ, а не работу агентов в несколько шагов. Авторы исследования с NeurIPS допускают, что прорыв может дать как раз многошаговое взаимодействие агента со средой. Поэтому эти работы стоит считать научным фоном для NVIDIA, а не доказательством ее выводов.
Но и такой фон говорит о том, что онбординг делает сильного кандидата увереннее, а слабого вряд ли превратит в сильного.
Слабые места исследования
У работы NVIDIA есть ограничения, и часть из них авторы называют сами, а часть заметна со стороны.
Все корреляции посчитаны всего на десяти моделях и без доверительных интервалов, то есть без оценки того, насколько цифры могли бы сдвинуться на другом наборе моделей, поэтому авторы прямо называют их описательными и не выдают за гарантию. Итоговые результаты моделей при этом взяты у разных лабораторий, и каждая дообучала свою модель по собственной программе и в своей среде. Эксперимент, в котором все модели учили одинаково, поставили только на трех моделях.
Больше всего вопросов вызывает то, с чем NVIDIA сверяет свои прогнозы.
Главным ориентиром в работе служат результаты на SWE-bench Verified, который OpenAI в феврале признала испорченным из-за утечек. В защиту авторов можно сказать, что сами проверки они строили на записях из другого бенчмарка, DeepSWE, сверялись еще с SWE-bench Multilingual, где задачи взяты из 41 проекта на девяти языках программирования, и с Terminal-Bench 2.1, где агент работает в командной строке, и сравнивали порядок моделей, а не проценты.
Но если разные модели помнили ответы в разной степени, это могло сдвинуть и порядок, а в работе этот вопрос не разбирается.
На задачах в командной строке метод работает слабее. На Terminal-Bench 2.1 проверка интуиции показывает совпадение 0,833, выбор из вариантов дает 0,796, и только завершение чужой работы держится на уровне 0,930. Почти все расхождение связано с двумя моделями, Kimi-K2 и Gemma-4-26B, которые разные бенчмарки оценивают очень по-разному.
Кроме того, для метода нужны записи работы агента сильнее того, которого выбирают. На наш взгляд, он хорошо подходит тем, кто выбирает модель и догоняет лидеров, но мало поможет тем, кто сам задает планку, ведь лидеру взять записи более сильного агента просто негде. В работе нет и цифр о стоимости.
Для ориентира можно взять тот же пример DeepSeek. Если бы каждого из десяти кандидатов дообучали с похожими затратами, только итоговые запуски стоили бы около 3 млн долларов, и это без экспериментов вокруг них. Прогнать десять базовых моделей через проверки NVIDIA явно дешевле, но во сколько раз, авторы не пишут.
Наконец, разные способы проверки иногда расходятся между собой. Kimi-K2 одни проверки ставят выше, а другие ниже, а Nemotron-3-Ultra на одном наборе записей получает завышенную оценку. Авторы не пытаются решить, какой способ прав, и предлагают разбирать такие случаи отдельно, что для научной работы скорее плюс.
Стоит учесть и то, что NVIDIA сама выпускает модели, и три из десяти кандидатов в выборке принадлежат ее семейству Nemotron-3. Подтасовкой это не назовешь, ведь итоговые результаты взяты из практики. Но забавно, что ту самую завышенную оценку получила как раз собственная модель NVIDIA.
Что это значит для компаний, которые внедряют виртуальных сотрудников
Может показаться, что все это касается только лабораторий, которые выбирают базовые модели, а компании просто пользуются готовыми агентами. Но вывод из этой истории пригодится всем, кто берет ИИ-агентов в работу.
Рынок виртуальных сотрудников сейчас похож на рынок труда с липовыми резюме. В Gartner для этого используют термин agent washing: так называют ситуацию, когда обычные чат-боты, ассистенты и средства автоматизации переупаковывают и продают как агентов.
По оценке аналитиков, из тысяч вендоров, которые называют свои продукты агентными, настоящих около 130. По их же прогнозу от июня 2025-го, больше 40% проектов с ИИ-агентами свернут к концу 2027 года из-за затрат, неясной пользы и слабого контроля рисков. Если кандидата нанимают по резюме, испытательный срок обходится дорого.
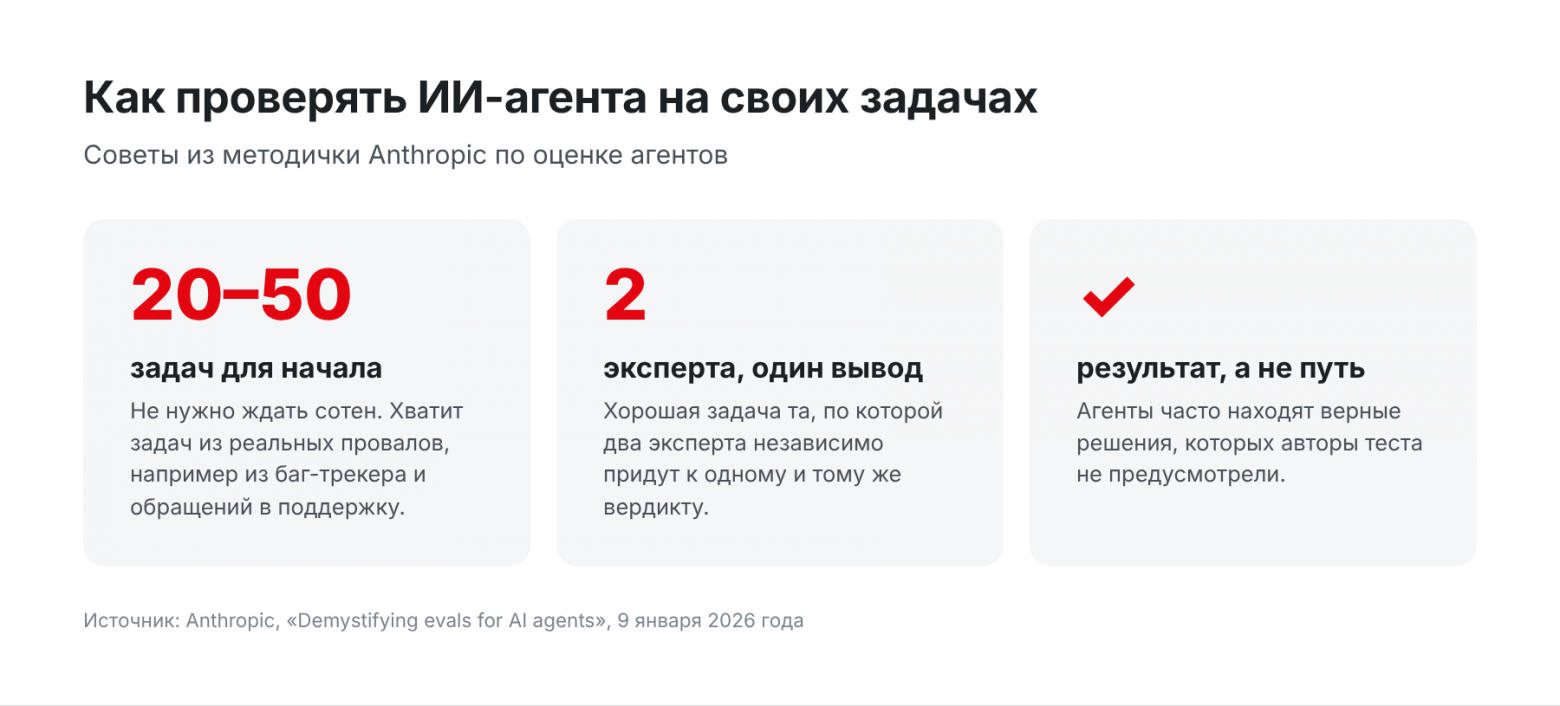
Как проверять агентов, крупные лаборатории описывают в собственных рекомендациях. В январской методичке Demystifying evals for AI agents компания Anthropic советует не ждать, пока наберутся сотни задач, потому что для начала хватит 20–50 задач из реальных провалов, например из баг-трекера и обращений в поддержку.
Хорошей считается задача, по которой два эксперта независимо придут к одному и тому же выводу. Оценивать при этом нужно результат, а не путь, ведь агенты часто находят верные решения, которые авторами теста не предусмотрены.
В той же методичке есть история, которая хорошо подходит к этой статье. Модель Claude Opus 4.5 сначала набрала 42% на CORE-Bench, где агент должен воспроизвести результаты научной статьи по ее коду, а потом исследователь нашел ошибки в самом тесте. Например, проверка снижала оценку за ответ «96.12», потому что ждала «96.124991…». После исправлений и смены обвязки результат вырос до 95%, и во многом плохим снова оказался тест, а не кандидат, как в случае с лишним пробелом в задаче OpenLibrary или одинаковыми вариантами в APTBench.
OpenAI в февральском разборе SWE-bench Verified пришла к похожему выводу. Компания пишет, что будет вкладываться в оригинальные закрытые тесты, задачи для которых составляют эксперты в своей области. Получается, что даже лаборатория, которая выпустила HumanEval и SWE-bench Verified, делает ставку на проверки, близкие к реальной работе.
Таблица бенчмарков больше похожа на диплом, чем на собеседование, ведь модель могла заранее видеть ответы, а тест мог проверять совсем не те навыки. Виртуального сотрудника, как и живого, стоит оценивать на собственных задачах и по записям реальной работы, в тот момент, когда решается дело.
Упрощенную версию метода NVIDIA можно повторить и внутри компании. Для этого подойдут несколько закрытых задач из своего трекера, у которых уже есть принятое решение и тесты. Кандидатам отдают историю работы над задачей до того момента, когда принималось ключевое решение, и смотрят, кто сделает правильный ход. Такая проверка быстрее месячного пилота и показывает, как агент справляется именно с вашим кодом, а не с открытыми задачами, которые он мог видеть при обучении.
Автор: nick_dyuba

