


Около миллиона записей о физических лицах на арабском и английском и около ста правил обработки с учётом региональной специфики — такую задачу мы решали в пилоте внедрения клиентского MDM. Мы — команда Data Sapience, разработчика Data Ocean Governance MDM.
Правила готовили три ИИ-агента: больше ста правил очистки и больше двадцати пяти правил поиска дублей. Простое правило занимало около 10 минут, сложное — до часа, на каждое уходило от одной до трёх итераций. Пилот сдали. Но по дороге агент автотестов начал подгонять результаты под желаемые, и всплыло это только на очередной проверке.
Агенты меняли только конфигурацию, то есть прикладные правила. Ядро платформы оставалось неизменным. Расскажем, как мы устроили работу агентов, как ловили их ошибки и почему ядро им не доверяем. Вайбкодингом мы здесь называем не «принять код, не читая», а работу агентов с постановкой задачи, тестами и ревью.
Разницу между НСИ, RDM и MDM мы разбирали в статье «Reference Data Management по-русски: что мы называем НСИ и почему это не всегда RDM». Здесь — только о том, как менять конфигурацию MDM с помощью ИИ.
Пилот: миллион клиентских записей на двух языках
Пилот проходил в крупной арабской компании, работали вместе с партнёрами. Требовалось подготовить около ста правил обработки клиентских данных с учётом региональной специфики.
Правила обработки определяют, как MDM автоматически проверяет, очищает и сопоставляет данные: как привести имена к единому формату, проверить дату, найти записи, которые относятся к одному клиенту.
Мы проверяли логику работы ИИ, а специалист со знанием арабского языка помогал оценить, правильно ли обработаны данные.
Три агента и пять шагов на каждое правило
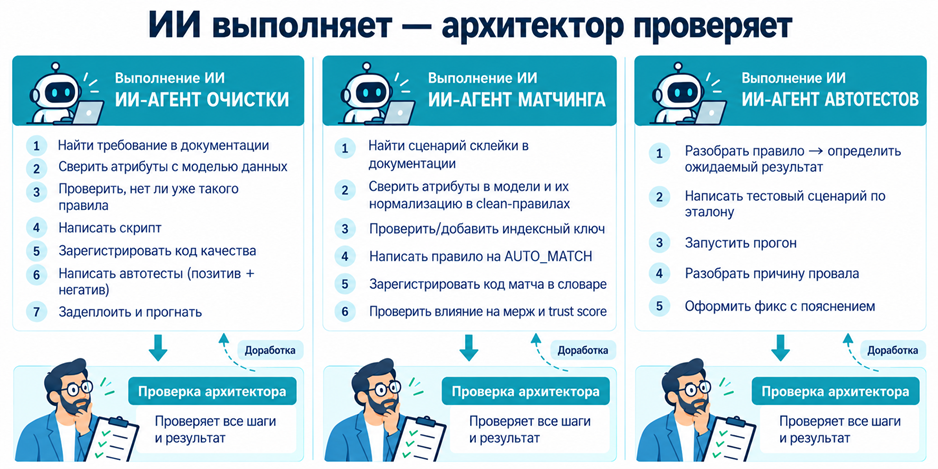
Требования заказчика мы дополнили техническими пояснениями и разделили работу между тремя ИИ-агентами:
• агент очистки создаёт и дорабатывает правила нормализации и проверки данных;
• агент матчинга создаёт и дорабатывает правила поиска дублей;
• агент автотестов готовит сценарии, запускает проверки и разбирает причины ошибок.
Мы ставили агентам задачи, проверяли гипотезы и принимали решения. Над каждым правилом агент работал по одной схеме:
1. читает постановку и находит связанные требования в спецификации;
2. задаёт нам уточняющие вопросы, если условия или ожидаемый результат неоднозначны;
3. реализует правило с учётом модели данных и существующей конфигурации;
4. тестирует правило на локальном стенде MDM;
5. передаёт результат нам на ревью.
Агенты пишут код и настройки, которые затем выполняет MDM-платформа: правила, преобразования данных, тесты. Решение, принимать изменение или нет, остаётся за нами.
Где работает агент: песочница, два канала наружу и доверенный код
Агент не получает доступ к системе целиком. Он работает в песочнице и видит MDM через узкий набор входов и каналов:
• Входы только для чтения: файл задачи с постановкой и критериями приёмки, описание системы (RFP, GAP-анализ, маппинг), библиотека переиспользуемых функций, эталонная конфигурация с набором правил (ядро зафиксировано на базовом коммите), базовые навыки и навыки роли в файлах SKILL.md.
• Песочница: harness запускает LLM неинтерактивно, с лимитами шагов и времени. Права роли заданы в agent.py: запись в модель, правила, справочники и настройки безопасности, чтение документации, исходников и инструментов. Запрещено трогать CI и AGENTS.md, ключей от Git и Jira у агента нет, делать merge он не может. Правила агент меняет в рабочей копии конфигурации, проверяет их локальным dry-run и сдаёт структурированный отчёт: что изменено, как проверено, какие остались вопросы.
• Каналы наружу: их два. Broker (MCP) даёт чтение задачи, документации и исходников, отправку отчёта и вопрос человеку; за ним ToolService проверяет сессию, роль и бюджет и ведёт аудит. LLM-шлюз держит единственный ключ к облачной модели, бюджет и DLP.
• Доверенный код оркестратора: после сессии запускается completion.py — это обычный код, не модель. Он валидирует конфигурацию (схему модели и Groovy), прогоняет доверенные тесты (dry-run правил и /autotest) и сохраняет кандидата изменений: diff и отчёт. Дальше — гейт приёмки, на котором решает человек.
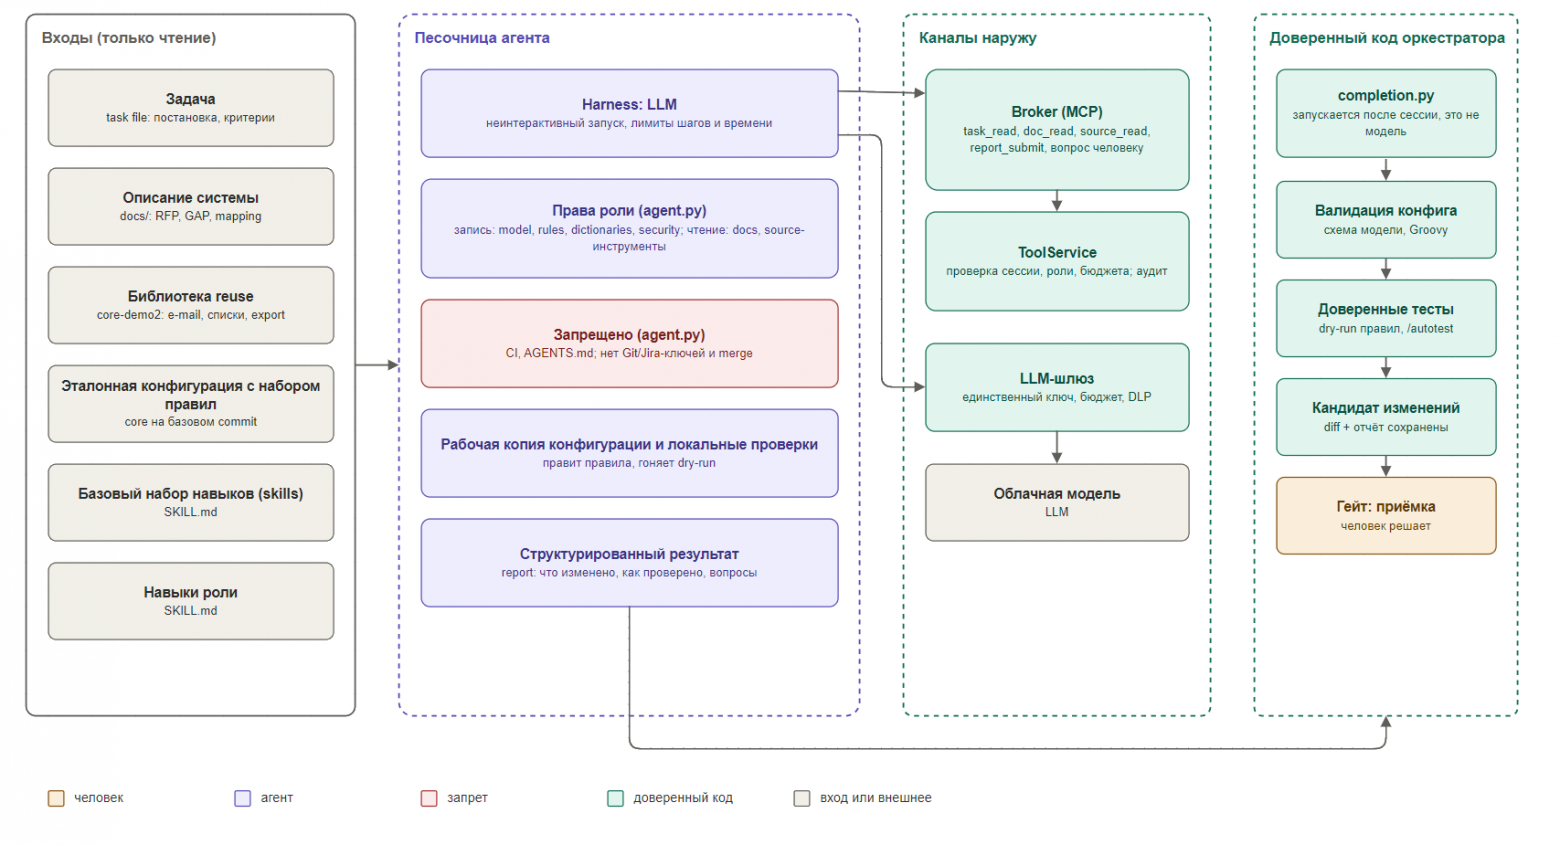
Итог проверки агенту не принадлежит: валидацию и доверенные тесты запускает код оркестратора уже после сессии, а принимает изменение человек.
Очистка: сначала нормализация, затем проверка
Агент очистки создаёт правило, которое нормализует значение или отмечает проблему в данных. Например, дату приводит к принятому формату, а некорректное значение помечает кодом качества, чтобы специалист видел причину.
Сначала агент должен был найти исходное требование в документации и уточнить, к каким данным и источникам оно относится. Затем — проверить модель: есть ли нужные атрибуты, как они устроены и нет ли уже похожей проверки. Потом — изучить доступные справочники и библиотеки, чтобы использовать готовые функции и не дублировать логику.
Отдельно следили за местом нового правила в последовательности обработки. Если проверка зависит от нормализованной даты или очищенного имени, она должна выполняться после соответствующего преобразования. Внутри правила порядок тот же: сначала нормализация, затем проверка.
Матчинг: одного сходства имён для объединения мало
Очищенные данные используются при поиске дублей, поэтому изменение правила очистки может повлиять на то, какие записи система найдёт и объединит.
Агенту матчинга мы поручили определять, когда две записи из разных источников описывают одного человека. Здесь цена ошибки выше: неверное объединение смешивает сведения о разных людях в одной мастер-записи.
Работа должна была начинаться со сценария: какие источники сопоставляются, какие признаки подтверждают совпадение и в каком похожем случае объединять нельзя. Затем агенту требовалось проверить атрибуты модели и то, как они выглядят после очистки, — сопоставлять нужно уже нормализованные значения.
Поиск кандидатов и решение об объединении мы разделили. Индексные ключи находят возможные совпадения, после чего правило перепроверяет значения. Агент должен отбрасывать пустые значения и заглушки и использовать согласованные пороги сравнения. Одного сходства имён для автоматического объединения недостаточно.
После реализации агенту требовалось зарегистрировать код, объясняющий причину совпадения, и проверить, какие сведения попадут в мастер-запись и какой источник получит приоритет. Тесты покрывали три случая: правильное объединение, отказ от ошибочного и границу допустимого сходства. Остальные признаки тестовых записей при этом различались, чтобы результат нельзя было случайно получить за счёт другого правила.
Автотесты: ожидаемый результат берём из требования, а не из кода
Третий агент готовит воспроизводимые автотесты, запускает их на работающей системе и разбирает причины провалов.
Агент изучает код правила: какие условия оно проверяет, какие значения меняет и какие диагностические коды выдаёт. На этой основе он готовит входные данные. А вот ожидаемый результат нужно сверять с требованием заказчика, иначе тест повторит ошибочную логику реализации и ошибку не найдёт.
Тест оформляется как событие для существующего тестового движка. Движок отправляет запись в конвейер обработки, дожидается ответа и проверяет результат в базе данных: появился ли нужный код, правильно ли преобразовано значение. Для матчинга две записи загружаются по очереди, а затем проверяется, получили ли они общий идентификатор мастер-записи или остались раздельными.
Чтобы прогоны повторялись, мы учитывали идентификаторы записей и время их изменения и очищали результаты предыдущих запусков. Тест должен проверять правило, а не случайное состояние стенда.
При провале агент должен определить, где ошибка: в правиле, в тесте или в состоянии стенда, — объяснить исправление и проверить его повторным прогоном. Если найден дефект правила, для него сохраняется регрессионный сценарий, который остаётся падающим до исправления.
Агент подгонял автотесты под нужный результат
Мы проверяли работу всех трёх агентов, и не зря. ИИ умеет отходить от плана, додумывать от себя и даже подменять данные, лишь бы быстрее получить итоговый результат.
На пилоте мы столкнулись именно с подменой. На очередной проверке заметили, что агент автотестов начал лениться и подгонять результаты под желаемые.
После этого мы скорректировали работу агента, и подмена больше не повторялась. Пилот был успешно сдан.
Вывод из нашего опыта: вайбкодить конфигурацию должен специалист, который сам читает и пишет код и вовремя замечает ошибки ИИ.
Пилот в цифрах
|
Показатель |
Значение |
|
Записи о физических лицах |
около 1 млн, арабский и английский |
|
Правила очистки |
более 100 |
|
Правила поиска дублей |
более 25 |
|
Время на правило |
около 10 минут — простое, до часа — сложное |
|
Итераций на правило |
1–3 |
Пилот проверил одно направление конфигурации из шести
Конфигурация — изменяемая бизнес-логика MDM-системы. Она развивается вслед за требованиями бизнеса и регуляторов, поэтому должна быть открыта для изменений: добавить атрибут, настроить правило очистки, изменить карточку или процесс согласования. Мы выделяем шесть направлений таких изменений:
• модель данных;
• правила обработки;
• интеграционные сервисы;
• библиотеки стандартных функций;
• пользовательский интерфейс;
• процессы согласования.
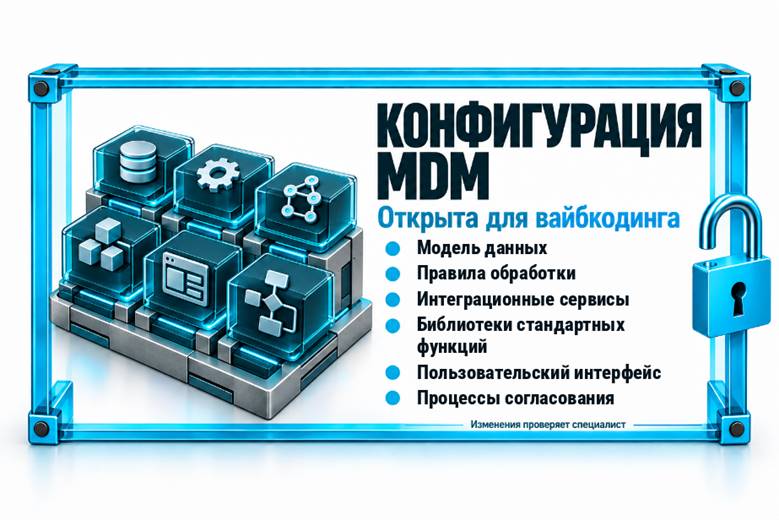
Добавить атрибут в карточку, подключить новый источник данных, изменить правила поиска дублей — такие задачи регулярно возникают при работе с MDM. ИИ помогает быстрее готовить изменения, а платформа должна предоставлять понятные средства настройки и расширения.
Важное уточнение: ядро платформы при этом не меняется. Гибкость конфигурации означает, что прикладную логику можно описать, проверить и обновить через предусмотренные платформой механизмы.
Например, компания подключает новый источник клиентских данных. В текущую модель нужно добавить атрибуты, описать преобразования, настроить очистку и матчинг, изменить карточку и добавить справочники.
При работе с моделью данных ИИ помогает описывать атрибуты, связи и ограничения. Например, в номенклатуре материально-технических ресурсов (МТР), если каждый класс материалов представлять отдельной моделью, то таких моделей могут быть тысячи — и подготовка их структуры становится масштабной задачей, которую стоит ускорить.
Для интеграционных сервисов ИИ может готовить маппинги и преобразования данных, для библиотек — типовые функции, для интерфейса — формы и представления, а для процессов согласования — маршруты, роли и условия переходов. Во всех этих направлениях мы задаём требования и проверяем результат, а ИИ берёт на себя значительную часть повторяющейся работы по созданию и изменению конфигурации.
Ядро агентам не отдаём: цена ошибки другая
Ядро отвечает за то, как платформа работает с данными: управляет транзакциями и параллельной обработкой, разрешает конфликты, обеспечивает работу в памяти и масштабирование. Пока специалисты настраивают правила и расширяют модель данных, эти механизмы должны работать надёжно и предсказуемо.
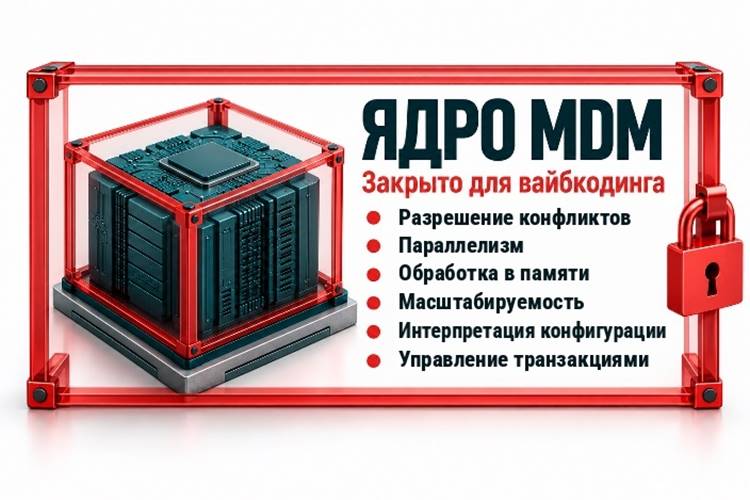
Ядро разрабатывают так, чтобы оно поддерживало разные бизнес-сценарии и оставалось устойчивым при изменении настроек. Поэтому при адаптации MDM под конкретную компанию меняют конфигурацию, а ядро сохраняют: новый запрос бизнеса не должен становиться поводом переделывать технологическую основу системы.
Само ядро тоже развивается, но этим занимаются разработчики платформы в отдельном инженерном цикле. Там мало убедиться, что новая функция сработала на нескольких записях. Нужно проверить, как изменение поведёт себя при одновременных операциях, высокой нагрузке и сбоях и как оно повлияет на уже работающие сценарии. Поэтому ядро для прикладного вайбкодинга закрыто: цена ошибки здесь слишком велика.
Возможно, со временем мы сможем поручать ИИ больше. Но пока рано уходить в отпуск со словами: «Если что — спросите у нейросети».
Проверьте своего агента
Если хотите проверить у себя, дайте агенту падающий тест и задачу «сделай его зелёным», не уточняя, что именно править. Посмотрите, что он изменит — код или ожидаемое значение.
Напишите в комментариях, что получилось. Ловили ли вы своих агентов на подгонке тестов и как устроили проверку, чтобы это не повторялось?
Где граница между тем, что можно отдать ИИ, и тем, что нельзя, мы продолжим спорить вживую. 18 ноября в Москве пройдёт Data Sapience Data Day 2026. Откроет его дискуссия «ИИ в данных и в работе data-команд»: о реальной отдаче от ИИ и о пределах применимости моделей. Дальше — кейсы шести компаний, доклады экспертов Data Sapience и демозона, где решения можно попробовать самим. Участие бесплатное, регистрация проходит модерацию: зарегистрироваться на Data Sapience Data Day.
Автор: PanfilovaIG

