


Когда прототип автономного агента на базе LLM переводят из ноутбука в круглосуточный продакшен, привычные метрики качества ответов внезапно перестают коррелировать с выживаемостью системы. Одиночный вызов модели может выдавать блестящие рассуждения на эталонном бенчмарке, однако уже через четыре часа непрерывной работы цикл ломается от накопления незаметных дефектов среды: утечек оперативной памяти в буферах контекста, каскадных ошибок 429/503 на шлюзе провайдера, зацикливания вызовов инструментов или неидемпотентных побочных эффектов после аварийного перезапуска.
В эмпирическом исследовании MAST (arXiv:2503.13657) на материале более 1600 трасс многоагентного исполнения было показано, что значительная доля отказов возникает не из-за «слабости» базовой модели, а на стыке архитектуры рантайма, межролевого соглашательства и отсутствия детерминированной проверки границ. В этой статье мы разберём системную таксономию 10 производственных сбоев (F01–F10), открытый исполняемый хаос-бенчмарк без внешних зависимостей, а также нейро-символьный линтер и каузальный арбитр, которые команда EvoNova Labs открыла под лицензиями MIT и CC0-1.0 для воспроизводимой инженерной защиты агентных контуров.
Анатомия деградации длительных агентных циклов
Отказоустойчивость stateless-сервиса и круглосуточного автономного агента — две принципиально разные инженерные задачи. Обычный веб-сервис обрабатывает независимые HTTP-запросы, тогда как автономный агент удерживает длинную эволюционирующую траекторию состояния, опирается на внешние непредсказуемые инструменты (MCP-серверы, браузеры, SQL-базы, файловую систему) и сам генерирует следующий шаг исполнения. Если в одном из узлов возникает слабый дефект — например, парсер не очистил косвенную промпт-инъекцию или оркестратор повторно вызвал уже завершённую транзакцию после обрыва сети, — ошибка экспоненциально усиливается в последующих шагах.
Чтобы перевести обсуждение надёжности от общих советов к проверяемым инвариантам, мы сопоставили классификации MAST и OWASP Top 10 for Agentic Applications (2026) в единой матрице десяти критических режимов отказа (F01–F10) внутри открытого репозитория awesome-autonomous-agent-resilience. Для удобства навигации вся матрица сведена в компактную таблицу с указанием наблюдаемого симптома и базового инженерного контрмеханизма.
|
Код |
Класс отказа |
Типовой симптом в продакшене |
Инженерный инвариант защиты |
|---|---|---|---|
|
F01–F03 |
Деградация контекста, |
Потеря системного промпта, падение воркера, слив бюджета |
Скользящее окно с сохранённым инвариантом, трёxфазный Circuit Breaker и потолок шагов |
|
F04–F06 |
Соглашательство, инъекции и избыточные права |
Выдумка параметров, утечка секретов, несанкционированный |
Детерминированный верификатор и каузальный граф, изоляция данных, approval gate |
|
F07–F08 |
Внезапная смерть процесса и OOM-убийца |
Дублирование списаний/отправок, утечка RSS до |
Журнал намерений SQLite WAL ( |
|
F09–F10 |
Побег сгенерированного кода и галлюцинации оферт |
Обход песочницы через |
Статический AST-инспектор до исполнения и жёсткая схемная проверка политики |
Исполняемый хаос-бенчмарк F01–F10 без внешних зависимостей
Справочник паттернов без исполняемого кода быстро превращается в пассивное чтение. Поэтому в комплект benchmarks/README.md мы включили детерминированный CLI-харнесс на чистом Python 3.11+ (benchmarks/resilience_bench.py), который запускает все десять стресс-сценариев на локальной машине или внутри CI-пайплайна за доли секунды. Внутри модуля сразу поставляются две эталонные реализации: уязвимая обёртка NaiveBaselineAgent, моделирующая типичный «наивный» агентный цикл, и защищённый профиль HardenedReferenceAgent со встроенными инвариантами.
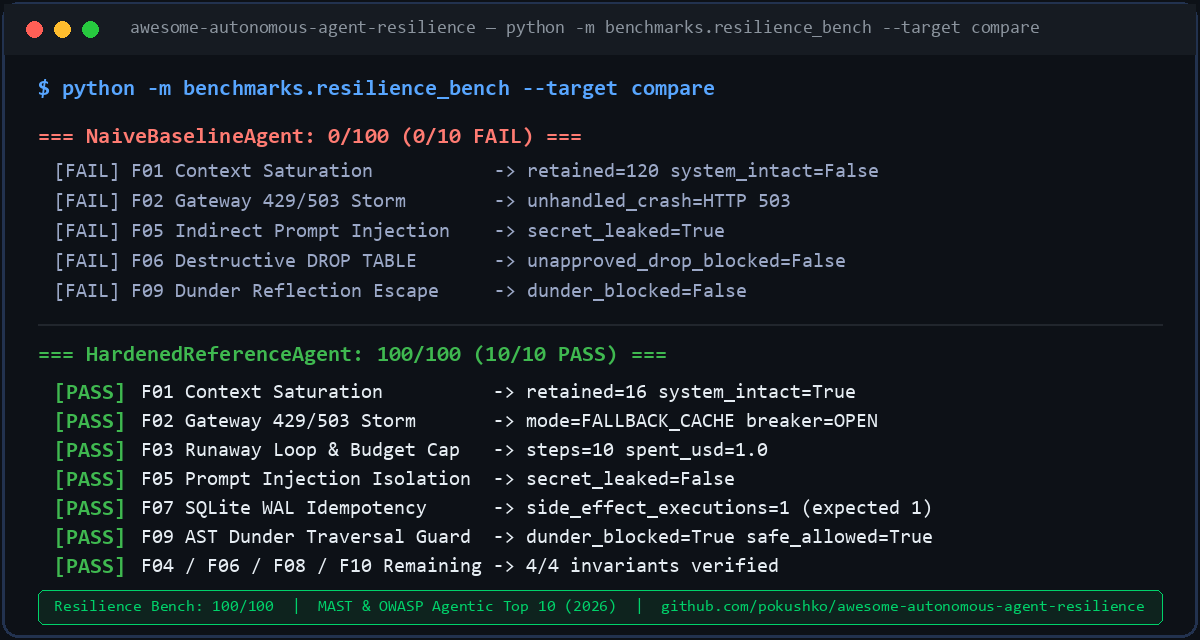
Ключевая ценность такого подхода заключается в том, что разработчик проверяет именно граничные отказы, которые почти никогда не попадают в классические eval-наборы на точность ответов. В сценарии F07 тест принудительно вызывает шаг повторного исполнения с тем же ключом идемпотентности на базе SQLite в режиме WAL и PRAGMA synchronous=FULL, убеждаясь, что реальный побочный эффект сработал строго 1.00 раз вместо двойной записи. В сценарии F09 инспектор разбирает абстрактное синтаксическое дерево (AST) фрагмента ().__class__.__base__.__subclasses__() ещё до запуска интерпретатора и блокирует проход по служебным dunder-атрибутам. Итоговый композитный балл устойчивости вычисляется тривиально как доля пройденных инвариантов в процентах:
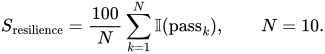
Команда запуска python -m benchmarks.resilience_bench --target compare --json report.json --badge badge.svg выдаёт структурированный отчёт в JSON и рендерит автономный SVG-бейдж с текущим счётом защиты, который можно встроить в CI любого Python-проекта. На нашем открытом контуре этот тест гоняется в GitHub Actions для Python 3.11 и 3.12 при каждом коммите наряду с еженедельным lychee-аудитом всех 160 ссылок индекса.
Нейро-символьный контроль научных текстов и формул Word OMML
Отдельный пласт производственных сбоев возникает тогда, когда мультиагентные системы готовят не программный код, а аналитические отчёты, технические спецификации, заявки на НИОКР и академические статьи. Авторы и редакции всё чаще сталкиваются с четырьмя «тихими» галлюцинациями LLM: несовпадением чисел одного и того же эксперимента в разных таблицах документа, появлением «осиротевших» процентов в аннотации и выводах без опоры в табличных строках, выдуманными или обрезанными идентификаторами DOI, а также порчей LaTeX-формул при переносе в Microsoft Word.
Чтобы закрыть эти дефекты детерминированно и без обращения к платным внешним нейромоделям, мы выделили открытый CLI-пакет sci-integrity-guard (sci-guard check, sci-guard omml). Модуль разбора таблиц TableConsistencyGuard нормализует названия сущностей и заголовки колонок с отбрасыванием единиц измерения в скобках (например, сопоставляя Accuracy (%) в таблице 1 и Accuracy в таблице 2) и контролирует расхождение значений в пределах настраиваемого допуска  . Одновременно алгоритм проверки текстовых якорей строит множество допустимых табличных величин и производных относительных изменений:
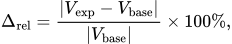
благодаря чему легитимные сравнительные проценты в аннотации и выводах проходят проверку чисто, а любые произвольно приписанные числа без табличной опоры мгновенно помечаются как ORPHANED_PROSE_METRIC.
Особое внимание в модуле CitationVerifier уделено регулярным выражениям и кэшируемой верификации библиографии. Классическая ошибка большинства самописных парсеров DOI состоит в том, что шаблон отбрасывает скобки или точку с запятой внутри идентификатора и разрушает реальные исторические ссылки издательств вроде 10.1175/1520-0469(1963)020<0130:DNF>2.0.CO;2. Наш экстрактор отслеживает парность скобок (), [], <> и очищает только непарную пунктуацию в конце предложения, после чего сверяет метаданные через CrossRef API с автоматическим резервным переходом на OpenAlex и проверкой пересечения токенов заголовка и фамилий авторов. Наконец, подсистема LatexToOmmlConverter отлавливает распространённую порчу Python-литералов вроде x0crac или x09imes вместо frac и times и компилирует формулы в валидный стандарт Word Office Math Markup Language (<m:oMath> и <m:oMathPara>), проверяя корректность XML через стандартный парсер.
from sci_integrity_guard import SciIntegrityGuard, latex_to_omml

guard = SciIntegrityGuard(tolerance=0.05)
report = guard.check_markdown(manuscript_text, verify_dois=False)
print("Passed:", report.passed, "Issues:", len(report.issues))

omml_xml = latex_to_omml(r"Delta G_{bind}^{0} = frac{alpha + beta}{2}", display=True)
Каузальная фильтрация Перла и модульный стек экосистемы
Даже идеальная проверка чисел и ссылок не спасает рассуждения агентов от логической подмены корреляции причинно-следственной связью — от парадокса Симпсона до ошибки коллайдера (парадокса Берксона). Для детерминированного контроля гипотез на уровне причинных структур мы открыли пакет evonova-causal-guard, реализующий направленные ациклические графы CausalDAG, мутацию графа оператором вмешательства  , точный алгоритм
d_separated (Bayes-Ball) и автоматический поиск минимальных множеств корректировки по бэкдор-критерию Перла. Архитектуру дополняет память TabuMemory на канонических SHA-256 отпечатках и коэффициенте Жаккара с TTL, которая физически не позволяет агентам повторно предлагать уже фальсифицированные утверждения в асинхронных дебатах DebateArbiter (Proposer → Skeptic → Judge).
Вокруг этого ядра собрана единая модульная инфраструктура под лицензией MIT без раскрытия каких-либо закрытых промышленных эвристик или корпоративных данных: agent-bunker отвечает за журнал намерений SQLite WAL, контроль RSS-памяти и трёxфазные выключатели; orchestration-engine обеспечивает беззависимую asyncio-оркестрацию волн DAG по алгоритму Кана; agent-security-sandbox перехватывает опасные импорты и обходы через AST-инспекцию; а agentic-vector-memory поддерживает эпизодическую память с экспоненциальным временным затуханием. Все публикации, научный препринт CERN Zenodo (10.5281/zenodo.23942797), зарегистрированные результаты интеллектуальной деятельности Роспатента и ФИПС, а также открытые репозитории объединены на едином портале EvoNova Labs.
Заключение
Опыт создания круглосуточных систем показывает, что надёжность автономного ИИ достигается не усложнением системного промпта, а строгим разделением ролей: нейросеть отвечает за генерацию гипотез и планов действий, а лёгкая детерминированная обвязка — за журналы восстановления, изоляцию кода, сверку чисел, валидацию DOI и каузальную топологию графа. Все рассмотренные инструменты (awesome-autonomous-agent-resilience вместе с хаос-бенчмарком, sci-integrity-guard, evonova-causal-guard и библиотеки рантайма) открыты на GitHub под пермиссивными лицензиями с набором автоматических тестов и готовы к встраиванию в ваши конвейеры. Будет интересно узнать в комментариях, с какими наиболее неочевидными сбоями длительных агентных циклов или ошибками генерации научных отчётов вы сталкивались на практике и какие дополнительные сценарии стоит добавить в открытую матрицу F01–F10.
Автор: pokushko

Советуем прочесть:
 Карпатый навайбкодил HackerTube за два часа. Я повторил это для Хабра — и вот что получилось 04.11.2026 Рекомендации YouTube настроены на время просмотра. Следующий ролик, на который…
 Как агенты изменили работу CV‑инженера: 5 сценариев из практики 11.11.2026 Первые программисты в буквальном смысле собирали программу руками: переключали кабели и…
 Финальный день INFOSTART A&PM EVENT 2026: ИИ в проектах и «Открытый микрофон» 14.11.2026 14 ноября в Санкт-Петербурге проходит заключительный день INFOSTART A&PM EVENT…
 Путь к агентам в low‑code платформах. Как low‑code‑конфигураторы корпоративных систем настраивают ИИ‑агенты… 06.11.2026 Low‑code обещает формы и отчёты «без программистов». То есть как без программистов……
 Glafira for Apache Kafka: открытый desktop-клиент на Rust, который даёт LLM читать кластер, но не трогать его 24.10.2026 Главное окно: дерево подключений слева, вкладка топика с таблицей сообщений…
