

Xiaomi разогнали 1T-модель до 1200 tok-s на стандартных GPU. AI-инфраструктура.. AI-инфраструктура. gpu.. AI-инфраструктура. gpu. inference.. AI-инфраструктура. gpu. inference. llm.. AI-инфраструктура. gpu. inference. llm. mimo.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь. искусственный интеллект.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь. искусственный интеллект. квантизация.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь. искусственный интеллект. квантизация. Машинное обучение.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь. искусственный интеллект. квантизация. Машинное обучение. Программирование.. AI-инфраструктура. gpu. inference. llm. mimo. speculative decoding. TileRT. xiaomi. Будущее здесь. искусственный интеллект. квантизация. Машинное обучение. Программирование. токены в секунду.

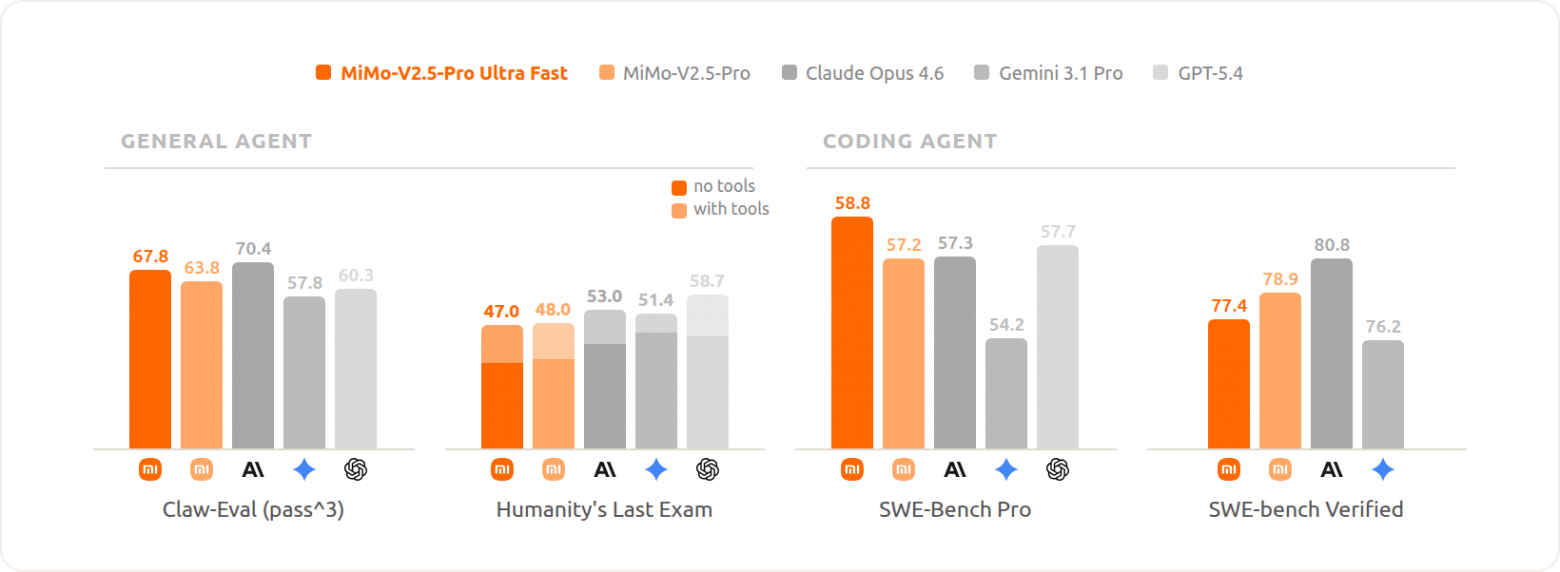
Китайские команды MiMo и TileRT опубликовали режим UltraSpeed для модели MiMo V2.5 Pro (1,02T параметров).

На одном 8-карточном сервере со стандартными GPU, до ~1200 токенов в секунду. Cerebras выдаёт похожие скорости на кастомном железе. Здесь обошлись без него.
Xiaomi разогнали 1T-модель до 1200 tok-s на стандартных GPU - 1

В кратце работает так:

  1. MoE-слои сжали с 16 до 4 бит: они занимают большую часть весов и хорошо переносят потерю точности, остальное оставили нетронутым

  2. Рядом с основной моделью запускается маленькая, которая угадывает сразу 8 токенов вперёд

  3. Основная проверяет их разом и принимает правильные

  4. В coding-сценариях угадывается ~6,3 токенов из 8

Похожий механизм Google применяет в Gemma 4.

На видео можно заценить скорость: 12 секунд против 6 минут на стандартных скоростях, к которым мы сейчас привыкли.

Русскоязычное сообщество про AI в разработке
Xiaomi разогнали 1T-модель до 1200 tok-s на стандартных GPU - 2

Друзья! Эту новость подготовила команда ТГК «AI for Devs» — канала, где мы рассказываем про AI-агентов, плагины для IDE, делимся практическими кейсами и свежими новостями из мира ИИ. Подписывайтесь, чтобы быть в курсе и ничего не упустить!

Автор: python_leader

Источник