


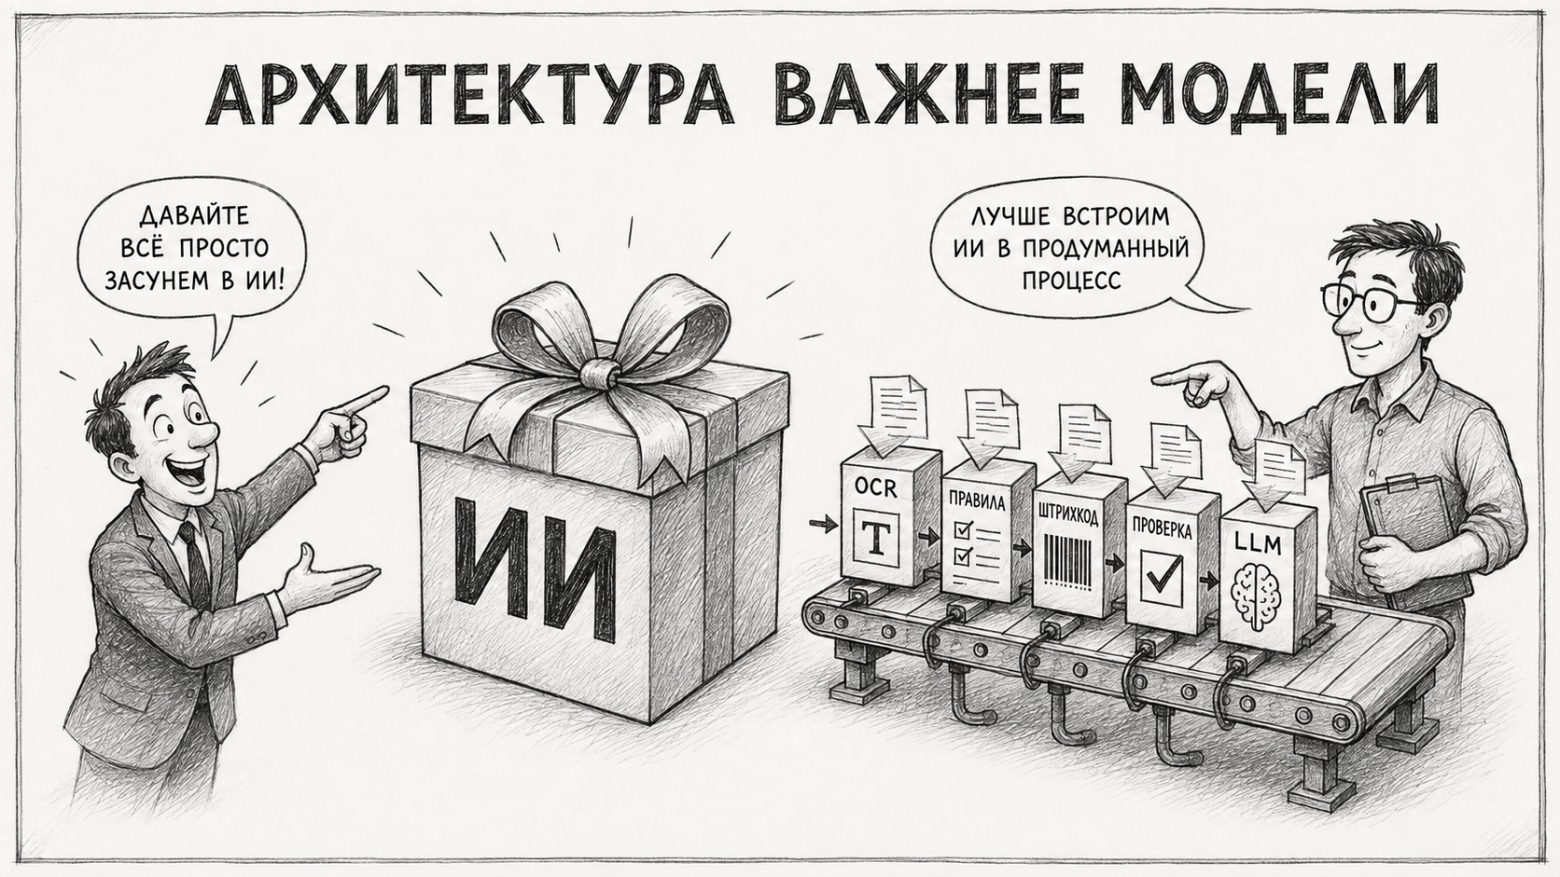
— В этом проекте нам надо хорошо распознавать документы.
— А что значит «хорошо»?
— Сейчас же везде ИИ. Я загружаю документ в чат, и он мне всё правильно отвечает. Нам надо так же для всех документов.
Такие диалоги я всё чаще слышу при обсуждении новых проектов.
А значит, вопрос «почему сложно сделать так же, как в чате — только для всех документов» — уже обыденность, и требует обсуждения.
Я много лет занимаюсь промышленными системами обработки и распознавания документов. Когда система «смогла» на одном документе, я стараюсь не очароваться этим. Я стараюсь думать, как это сделать потоком.
Современные модели ИИ действительно почти стирают грань между вопросом к текстовому документу и вопросом к изображению. Выглядит как магия.
Но надо разобраться, что делать с документами, когда магии не случилось. Попробую обобщить подходы к организации обработки потока документов и поразмышлять, о чем лучше не забывать, проектируя такой поток.
Пару слов о терминах. Разница между ними всё более размыта, но всё же обозначу, от чего отталкиваюсь в этой статье.
OCR (или классический OCR) — движки распознавания (например ABBYY, Tesseract и др.), которые используют для извлечения текста из изображения преобразование из пикселей в буквы и слова без понимания смысла извлекаемого текста.
Модели ИИ — обобщённое название инструментов LLM, VLM и их комбинаций, когда требуется противопоставление классическому OCR.
В целом в своей статье не разделяю VLM и LLM, но где это требуется по смыслу, я буду это делать.
Прототип и поток — разные вещи
Вернемся к документу и чату. Загрузили в чат для проверки 20 документов, в одном модель ошиблась. Выглядит не страшно — что такое 1 ошибка. А если документов 2000 — получается, ошибок уже будет около 100. В реальной системе количество ошибок не всегда можно предсказать по прототипу, но для упрощения будем считать, что частота ошибок постоянна. А когда документов ещё больше — уже получается полноценный поток ошибок рядом с основным потоком документов. С этими документами надо что-то делать. А для начала надо в принципе определить ошибочные документы. Ведь система не всегда может понять, что она ошиблась. Часть ошибок может обнаружиться в других системах, когда обработка документа уже считается завершенной. Кроме того, определить ошибку недостаточно, надо её исправить и довести обработку документа до конца. Вот так и получается, что почти всегда, проектируя систему обработки документов, надо думать и об обработке ошибок.
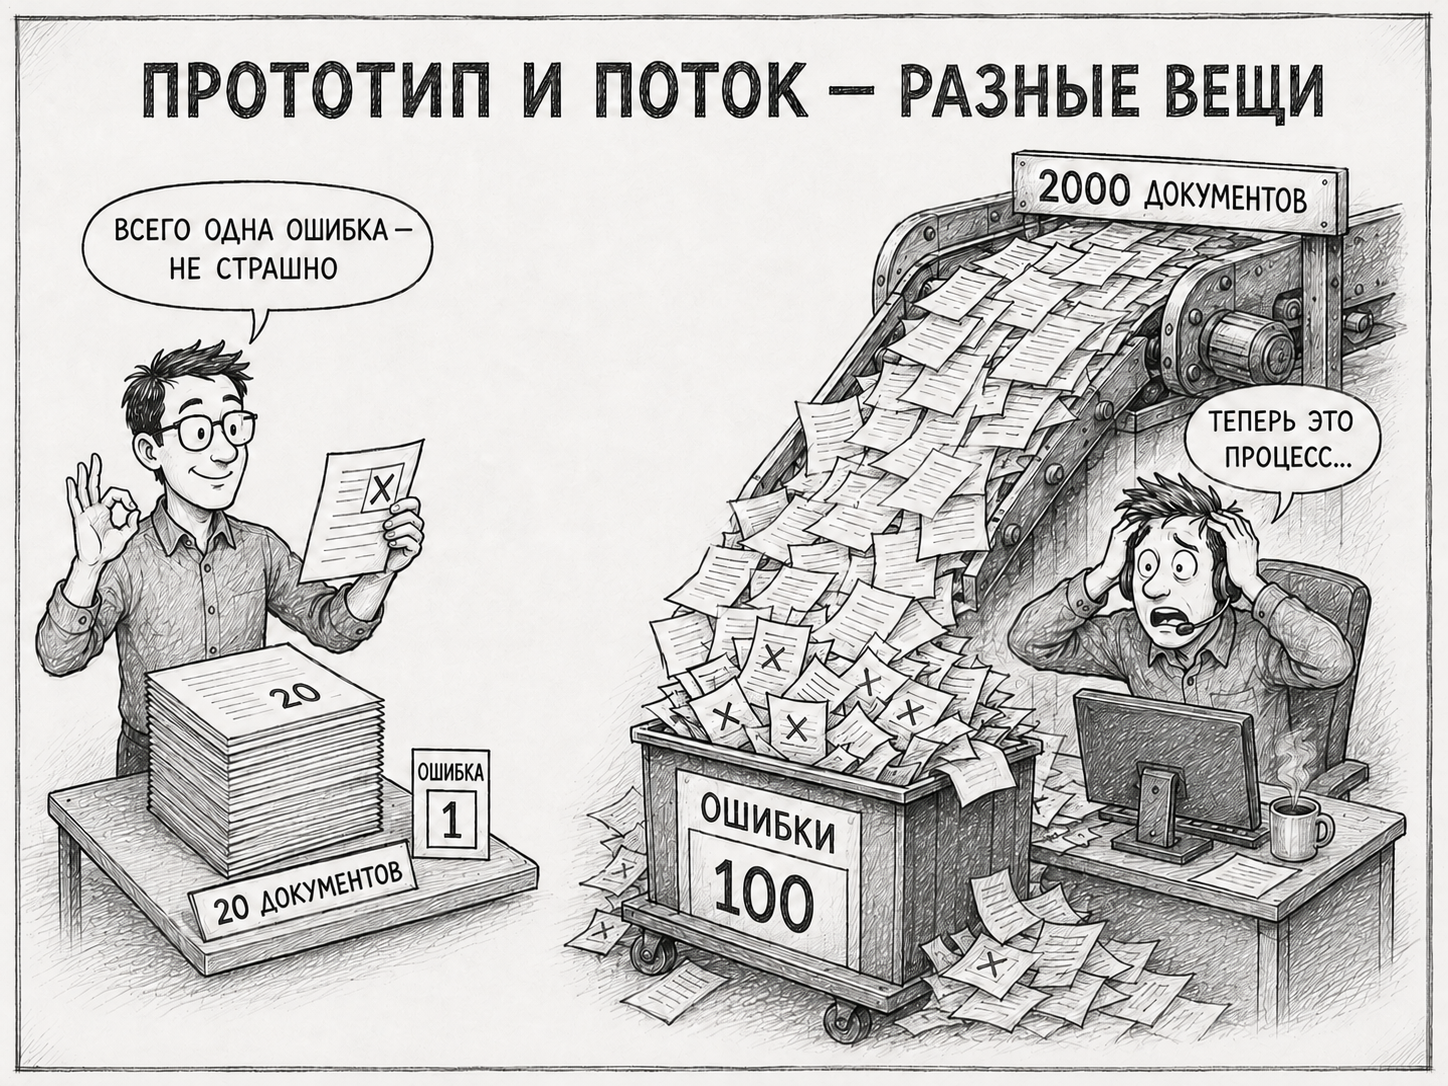
Но тут важно поговорить и о цене ошибки.
Не всегда надо тратить много сил и времени на исправление ошибок извлечения из документов атрибутов, которые ни на что в дальнейшем не влияют. А вот если ошибка влияет на платёж, юридически значимое действие или другой критичный процесс, нужен механизм контроля — автоматический или ручной. При этом проверку необязательно проводить на этапе распознавания: её можно встроить дальше в бизнес-процесс.
Простой пример — на документе есть ФИО и e-mail, эти атрибуты нужны для того, чтобы найти документ в системе электронного хранения. Система ошиблась в извлечении e-mail. Надо ли тратить время на анализ, повторение и способы контроля этой ошибки, если таких документов единицы и всё, к чему привела эта ошибка, — это поиск по ФИО вместо e-mail? И другая ситуация — некорректно определили номер документа и допустили ошибку в дальнейшем бизнес-процессе, неправильно подобрав путь дальнейшей обработки документа. В результате это может грозить штрафами и репутационными рисками — такую ошибку надо контролировать заранее.
Но иногда для того, чтобы понять, где ошибка, надо потратить много ресурсов на изменение процесса (например, включить расширенное логирование, сбор копий всего потока документов для анализа в дальнейшем, запуск процессов отладки и т. п.). Иногда проще и быстрее такие ошибки оставить на ручной разбор.
В зависимости от этого и надо заранее определить, какие ошибки требуют изменений в конвейере, а какие разумнее оставить для ручной обработки или отдельного сценария.
Перед OCR есть более важный вопрос
В моей практике задача практически никогда не заканчивается словами «нам просто надо получить распознанный документ». Данные всегда зачем-то нужны: найти запись, определить маршрут, проверить условие, принять решение, запустить следующий процесс.
Поэтому, приступая к задаче распознавания, стоит вначале разобраться, что бизнес собирается делать с данными из документа. Иногда заказчик приходит с документом и списком атрибутов:
«Вот они все тут есть на документе — давайте всё извлечём».
После анализа бизнес-процесса выясняется, что часть этих полей дальше нигде не используется. Например, в процессе надо передать данные для формирования ответа во внешнюю систему, и выясняется, что внешняя система не умеет обрабатывать атрибуты, которые заказчик просит извлечь. Технически на документе они есть, система их может извлечь, но тут как раз следует задать вопрос «Можно, а зачем?»
Ведь если мы решим их распознавать, за ними сразу тянется всё остальное: настройка, оценка качества, проверки, обработка ошибок, сопровождение.
В итоге мы тратим ресурсы на данные, которые никак не влияют на результат.
Так что к первому вопросу «Какова цена ошибки?» добавляется второй: «Какой измеримый результат даст автоматизация?»
И только после этого выбирать OCR, VLM, LLM и всё остальное. Иначе обоснование проекта довольно быстро сводится к фразе: «XXI век же на дворе». Аргумент хорош до того момента, пока рядом не появляются 2 цифры — стоимость автоматизации и ожидаемый эффект.
Иногда после такой оценки от автоматизации приходится отказываться или уменьшать объем автоматизации. Но лучше так, чем потратить силы и ресурсы на проект, который не принесет эффект.
Критерии при этом могут быть разные. Где-то важны трудозатраты, где-то скорость. Эффектом может быть и снижение ошибок или отсутствие штрафов.
Главное, чтобы результат можно было измерить и чтобы его одинаково понимали и бизнес, и ИТ.
Сколько интеллекта нужно документу?
Ответив на первые 2 базовых вопроса, можно пойти дальше к выбору технологии.
Сам факт, что модель может решить поставленную задачу, не означает, что именно её требуется использовать для решения задачи.
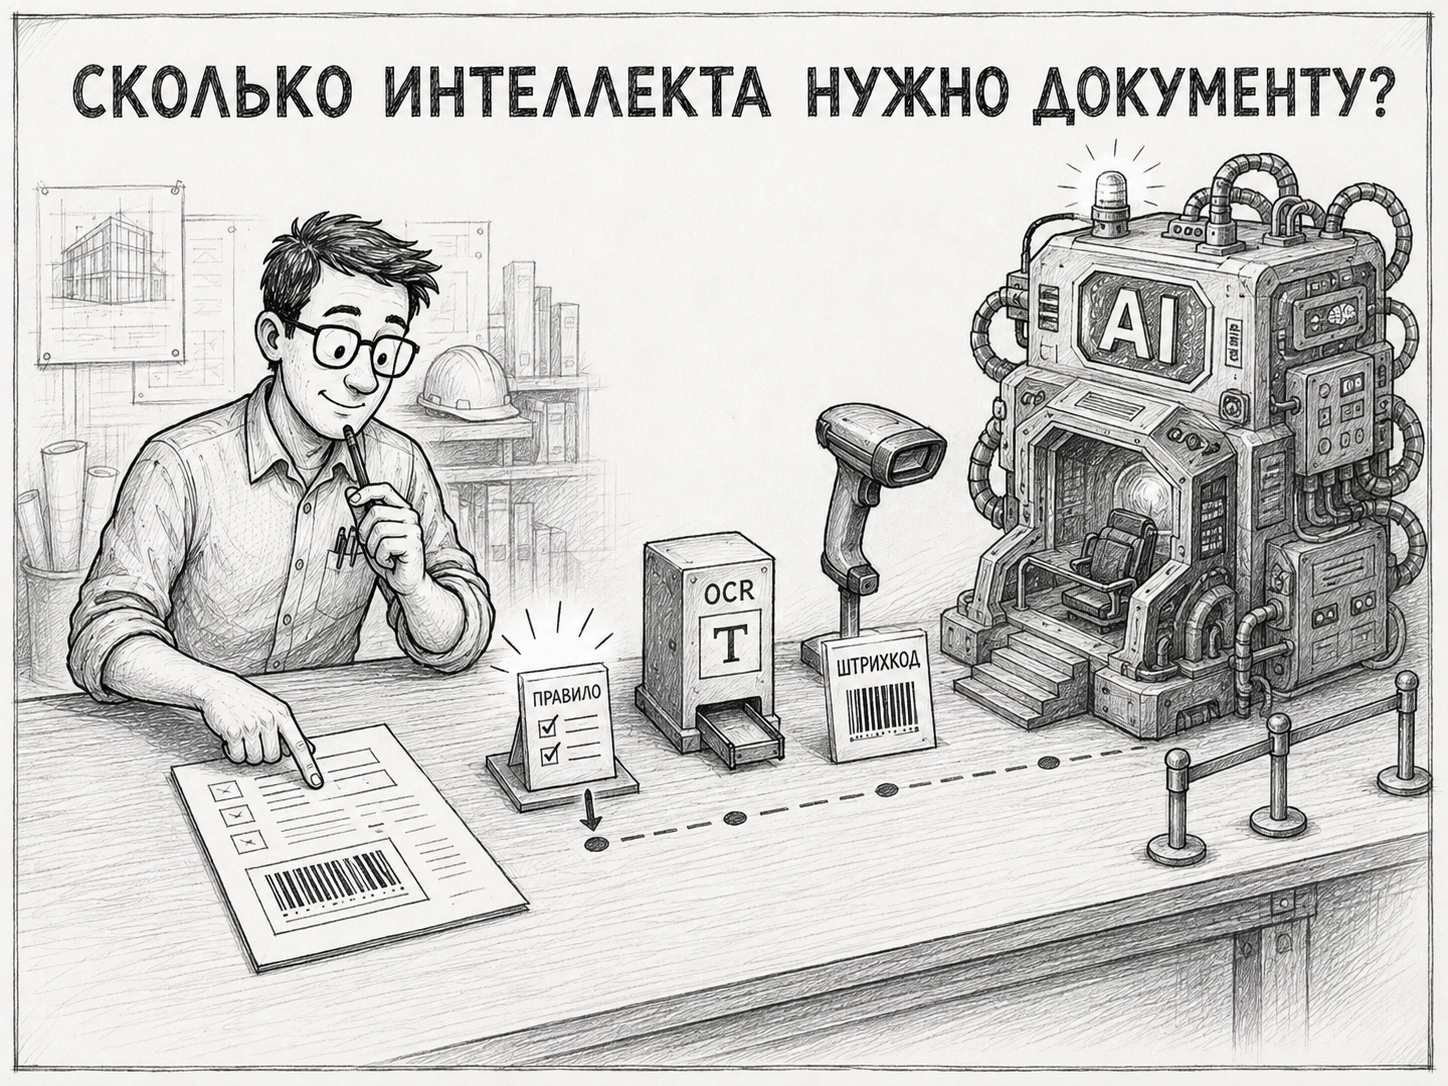
Простой пример — классификация документов. Можно передать модели текст документа или даже изображение — и попросить определить тип. Когда типов много, а документов мало, это может быть хорошей идеей. Ведь не надо тратить время на обучение классификатора для каждого типа. Но если всего 2 типа и есть формальный признак, по которому легко определить нужный, то лучше использовать классические инструменты.
И так на каждом этапе обработки — если задачу можно решить просто, не надо её решать сложно. Как бы банально это ни звучало, иногда проще разместить на документе штрихкод, чем конструировать связку VLM + LLM для разделения потока документов. И дело не только в архитектуре. На этапе прототипа любой дополнительный этап обработки практически незаметен, но в потоке время и стоимость каждой операции умножается на количество документов.
Не обязательно выбирать одно решение для всего потока документов. Где-то достаточно правил на основании OCR, где-то подойдет узкая ML-модель, а где-то не обойтись без LLM.
Классический OCR имеет свои ограничения
Если сложилось впечатление, что я призываю не использовать ИИ, это не так. У классических подходов к извлечению данных есть свои ограничения. В основном они строятся на заранее описанных алгоритмах и известных вариантах документов. Как только появляется неизвестный ранее пример документа или меняются правила формирования документов, требуется перенастраивать OCR.
Изменение алгоритмов и добавление новых шаблонов могут ухудшить обработку «старых» документов. Типичный сценарий: один документ починили, а общий процент распознавания упал. VLM в этом плане позволяют меньше зависеть от изменений форматов и жестких правил. А современные подходы к разработке ПО с использованием ИИ позволяют быстрее анализировать большие объемы документов и проверять гипотезы сразу на всём массиве документов. Также они позволяют быстрее менять код и алгоритмы. Практический эффект здесь не только в качестве OCR, но и в скорости внедрения изменений. Правда, к этому мы ещё вернемся, тут есть подводные камни.
Когда вместо просто модели надо строить систему
Фраза «мы используем ИИ для распознавания документа» ещё ничего не говорит об архитектуре решения. Например, может быть случай, когда в модель отправляют документ для извлечения текста или структуры, всю остальную логику извлечения атрибутов пишут алгоритмически. Или другой вариант, когда в модель отправляют документ и всю логику доверяют ей. Между этими вариантами есть множество комбинированных подходов, но сейчас не об этом. Речь о том, что даже когда всю логику можно было бы доверить ИИ, архитектурно рядом приходится добавлять другие блоки. Ведь почти всегда звучит вопрос от заказчика: «А насколько хорошо распознает система?» И вот на схеме уже появляется блок контроля качества. Эту задачу целиком пока модели не доверить. Возможно, когда-то в обозримом будущем, но пока приходится выбирать или комбинировать разные способы: справочники, математические проверки, эталонные значения из других систем или ручная валидация.
«А почему она решила именно так?»
Ещё один вопрос, который часто приходит от бизнеса и поддержки: «А почему она решила именно так?»
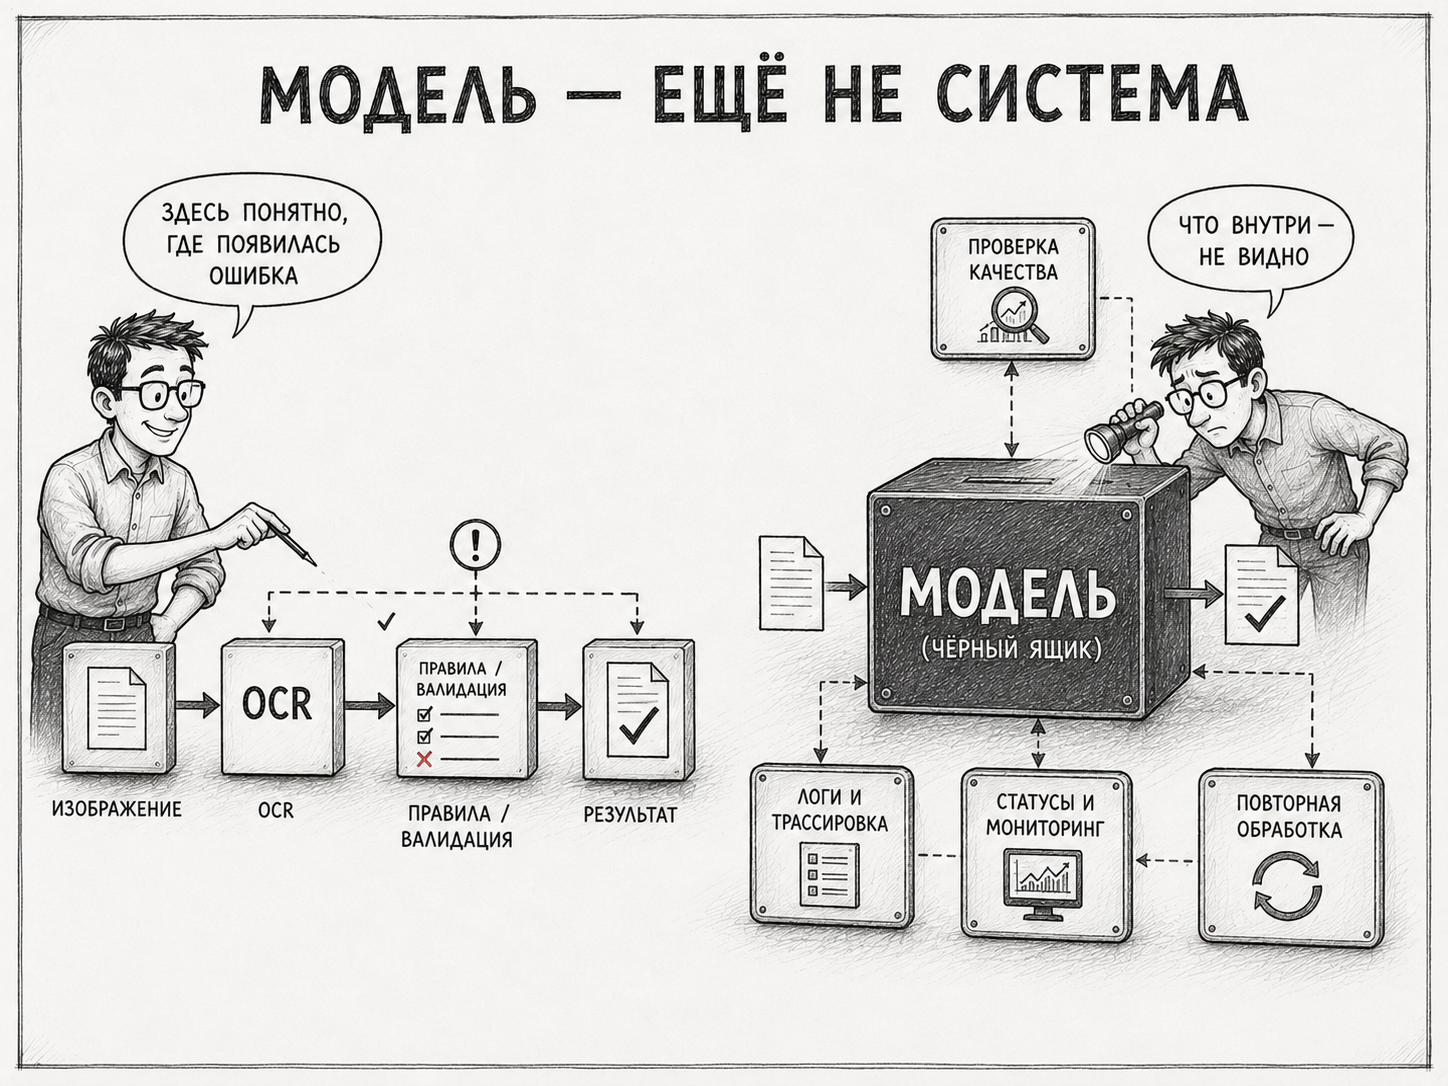
Даже с классическим OCR ответ не всегда очевиден. Там иногда 6 принимается за 8, 0 за О и т. д. Мы не знаем, почему внутри алгоритмов победил тот или иной вариант, но мы чётко видим цепочку обработки.
-
Вот исходное изображение.
-
Вот результат предобработки.
-
Вот что вернул OCR.
-
Вот что извлёк следующий этап.
-
Вот какое правило после этого сработало.
Администратор и разработчик достаточно гибко могут управлять системой в плане исправления алгоритмов, правил и т. п.
В случае с моделью на вход ей подаётся документ, на выходе — результат. Вся промежуточная логика работы скрыта внутри модели, точечно исправить что-то достаточно сложно, если вообще возможно.
А это значит, что лучше добавить ещё один блок архитектуры — контроль жизненного цикла документа. Его задача — дать больше информации о том, что происходит внутри системы с документом и обеспечить контроль за тем, что ничего не потеряно в процессе обработки. Надо иметь возможность повторно обработать документ, если модель не даёт нужный результат либо вне модели что-то пошло не так. Документы не должны «исчезать» внутри системы. Если мы передали в работу 100 документов, должно быть понятно, что произошло с каждым из них.
Найти ошибку недостаточно
Как говорил шеф в одном старом фильме: «Куй железо, не отходя от кассы». Ошибку мало обнаружить — её надо проанализировать и исправить. А для этого надо её повторить. И объяснение ошибки не является конечным бизнес-результатом. Надо иметь возможность повторно обработать тот же документ после исправления в системе. Это тоже требует отдельного блока от архитектора. Кстати, этот блок общий как для обработки моделью, так и для классических подходов. Но различие все-таки есть. Пока ещё есть вопросы к повторяемости результата при обработке документа моделями, этот риск надо заранее «обернуть» в дополнительные проверки. Если на этапе проектирования системы вы не задаете вопросы: «Что будем делать, если документ обработался неправильно?», «Как будем исправлять?», «Как доведем до результата?», — это повод их задать.
Когда дорабатывать становится слишком легко
Дальше я ступаю на тонкую грань общих требований к системам, а не только OCR-системам. Но они логически вытекают из вышеописанного, так что упомяну и их. Тем более выше уже вешал сюда «мостик» про минусы легкости изменений агентами разработки.
Напомню вначале про плюсы: быстро пишется код модулей, быстрее проверяются гипотезы, можно использовать разные алгоритмы и их комбинации при поиске атрибутов. Появился новый тип или вид документа — быстро добавили новое правило.
Теперь о минусах:
Появился ещё один вариант — ещё одно условие.
Потом ещё одно.
Когда новых типов документов становится много или обнаруживается большая вариативность форм, не проверенная заранее, условий становится много. В какой-то момент, без должной проработки, все это становится «комом» кода, который сложно воспринимать как единое целое и контролировать. А ещё хуже, когда эти изменения начинают противоречить друг другу. Заманчиво сделать локальную правку и получить быстрый результат, тем самым ещё усложнив код. Поэтому важно периодически делать ревизию маленьких правок и заменять их (по возможности) более общей правкой.
Для систем распознавания документов это особенно характерно: каждый новый тип документа или формат может принести свой набор ошибок.
Способность быстро меняться — «это база»
Ещё одна особенность, про которую надо помнить архитектору — модели сейчас меняются быстро. Решения, которые выбрали на старте проекта, могут поменяться (а то и несколько раз) за время работы над проектом. Рискованно строить архитектуру так, чтобы замена ключевого инструмента требовала переделывать всю систему.
С другой стороны, не надо торопиться все менять, как только вышла новая версия компонента системы. И это не только про этап нового проекта. Для продуктивной системы подход тот же.
Менять компонент надо только тогда, когда польза от замены превысит накладные расходы на внедрение. Задача архитектора тут «базовая» — сделать систему легко модифицируемой.
Архитектура важнее модели
По мере развития моделей задача распознавания становится все более доступной. Сейчас готовых инструментов все больше, строить свою технологию извлечения с нуля не требуется. Порог входа для различных команд ниже. Плавно меняется и задача специалистов и команд, которые занимаются обработкой документов. Хорошо знать конкретный OCR-движок и уметь его настраивать по-прежнему полезно, но этого уже недостаточно. Команде надо понимать весь процесс целиком: зачем извлекаются данные, какая в этом ценность для бизнеса, какие могут быть ошибки, где нужен дополнительный контроль, какие задачи вообще стоит автоматизировать и какие инструменты для этого использовать.
Для этого нужен большой инструментарий: системы потокового сканирования, классические инструменты OCR, VLM, LLM, справочные системы и т. п. Комбинируя эти инструменты, можно под конкретную задачу собрать подходящее решение, а не натягивать все задачи под возможности одной технологии. Фокус уходит с вопроса «Как это распознать?» в сторону вопроса «Как правильно решить эту задачу?». Появление ИИ-моделей не отменило предыдущие технологии, а заметно расширило набор доступных инструментов для решения задач. Задача архитектора не должна ограничиваться выбором лучшей модели (хотя задача, безусловно, важная), а должна заключаться в подборе оптимального набора инструментов для достижения бизнес-эффекта.
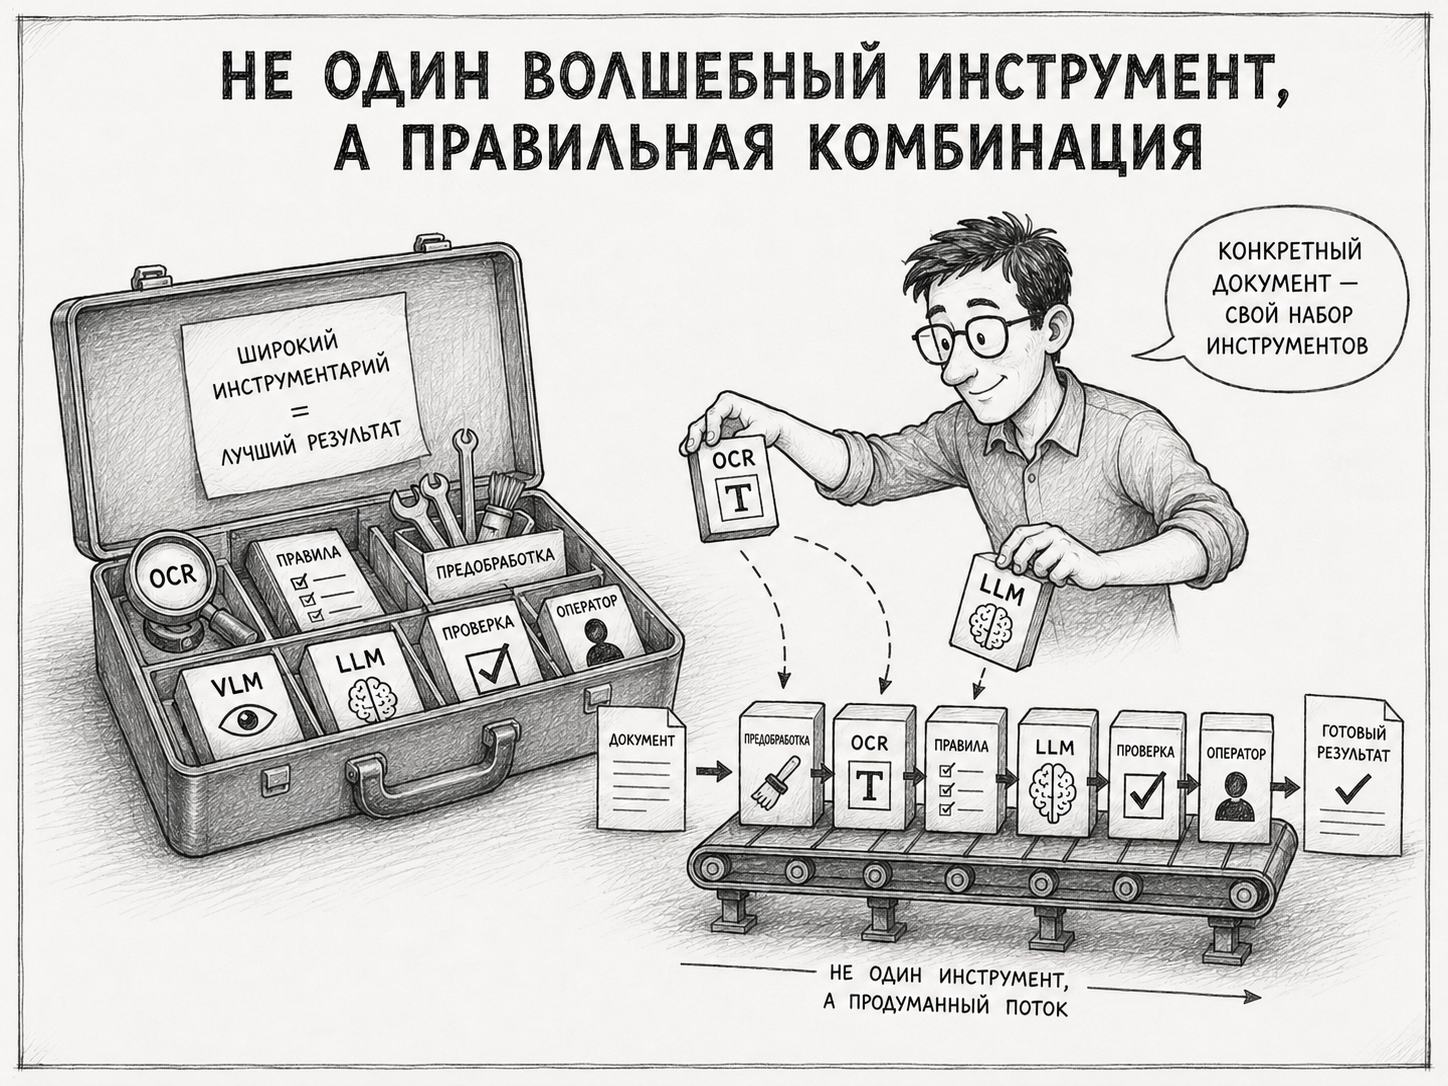
Поэтому новый проект стоит начинать не с поиска самой мощной модели, а с вопроса:
«Какой бизнес-эффект принесёт эта автоматизация?»
Если у вас есть идеи или уже проверенные подходы к оценке эффективности решений — поделитесь ими в комментариях. С интересом почитаю.
Конструктивная критика приветствуется.
Автор: LugySpb

