


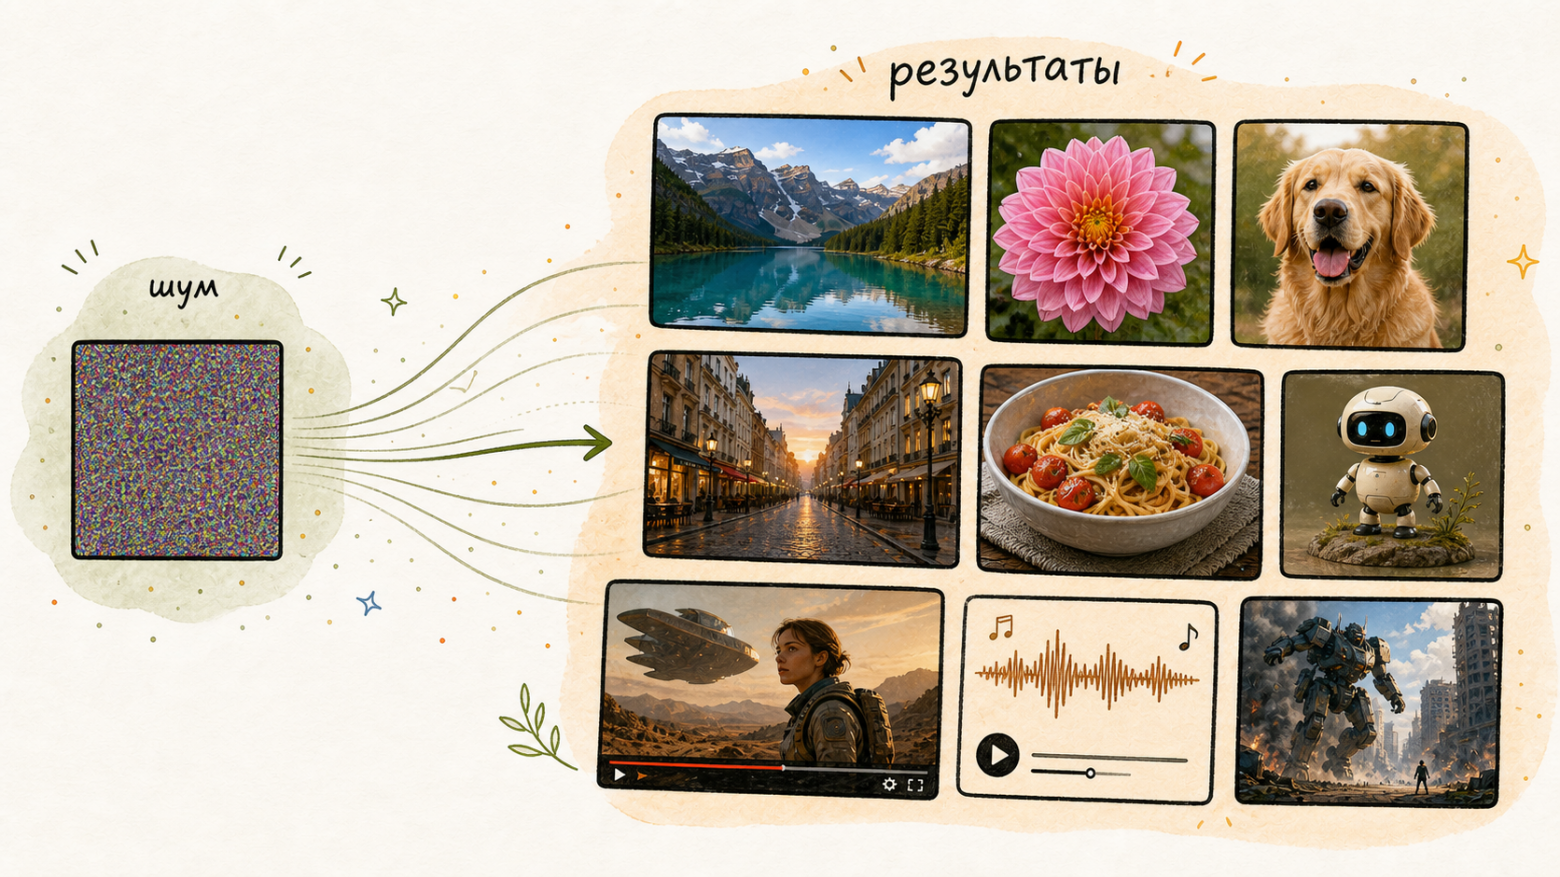
Flow Matching — современный подход генеративного моделирования. Основная идея — научить модель постепенно превращать простое распределение, например, случайный шум, в сложные данные — изображения, видео, звук, 3D-сцены или действия робота.
В рамках статьи разберём устройство Flow Matching’а: как задаётся путь от шума к данным, чему учится модель и как после обучения из случайного шума появляется новый объект. Обсудим главный недостаток подхода — медленная генерация (чтобы получить один объект, нужно выполнить много последовательных шагов).
Один из способов его решения — дистилляция. Мы заменим многошаговый процесс генератором, который за одно вычисление нейронной сети произведёт нам нужные картинки.
Однако такую модель нельзя просто обучить регрессией по принципу: «Вот — вход, вот — правильный ответ». Мы разберём, почему это так и как из задачи дистилляции естественным образом возникает минимаксная постановка: две модели начинают играть друг с другом, а результатом игры становится качественная генеративная модель!
Сферы применения
Flow Matching сегодня — один из ключевых подходов в современных генеративных моделях, «равный» диффузионным моделям (в каком-то смысле считается, что это одно и то же).
Известные примеры применения — Stable Diffusion 3.5, FLUX.2 и Kandinsky от Сбера. Эти модели способны превращать текстовое описание в новое изображение — от реалистичной фотографии до сложной фантастической сцены.

Но изображениями применение Flow Matching’а не ограничивается. С его помощью можно генерировать и более сложные объекты — например, видео вместе со звуком. MiniMax H3 получает текстовое описание сцены и постепенно превращает случайный шум не просто в одну картинку, а в целую последовательность кадров и соответствующий ей звук.
Но генеративные модели идут ещё дальше: сегодня они умеют создавать уже не отдельные изображения или видео, а целые интерактивные миры, с которыми можно взаимодействовать в реальном времени. Например, семейство Genie от Google DeepMind позволяет сгенерировать виртуальное окружение из изображения или текстового описания, а затем исследовать его, управляя персонажем. Получается, можно придумать игру и почти сразу оказаться внутри неё!
Определение
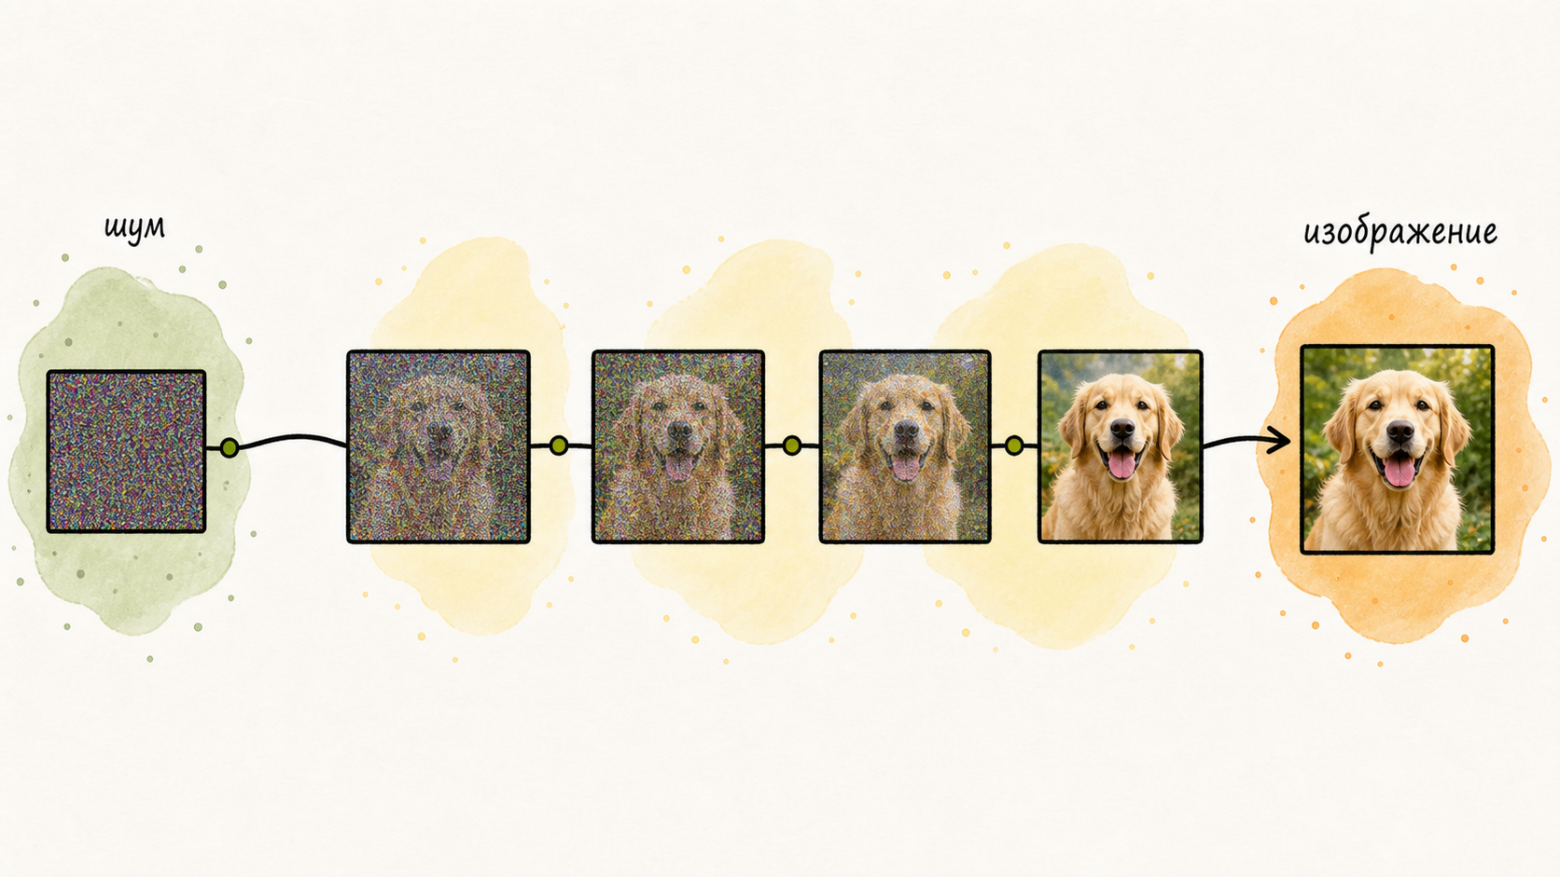
Flow Matching — один из современных подходов генерации изображений, видео, звука. Его основная идея очень похожа на интуитивное «расшумление»: мы начинаем со случайного шума и постепенно превращаем его в осмысленный объект — например, в чёткое изображение.
Формально у нас есть настоящие данные  . Это могут быть, например, реальные изображения из интернета. Мы хотим научиться порождать новые объекты, которые похожи на данные из этого распределения, но не являются простым копированием обучающих примеров. То есть мы хотим выучить распределение картинок по набору примеров из него.
С другой стороны, нам нужно распределение, из которого легко начинать генерацию. Обычно для этого берут стандартное нормальное распределение: 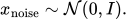 Из него легко семплировать случайные точки, поэтому оно обычно выступает начальным шумом.
Как происходит переход от шума к данным с помощью непрерывного времени  ? В момент
 мы находимся в шуме:
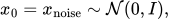 а в момент
 хотим оказаться в данных:
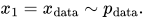
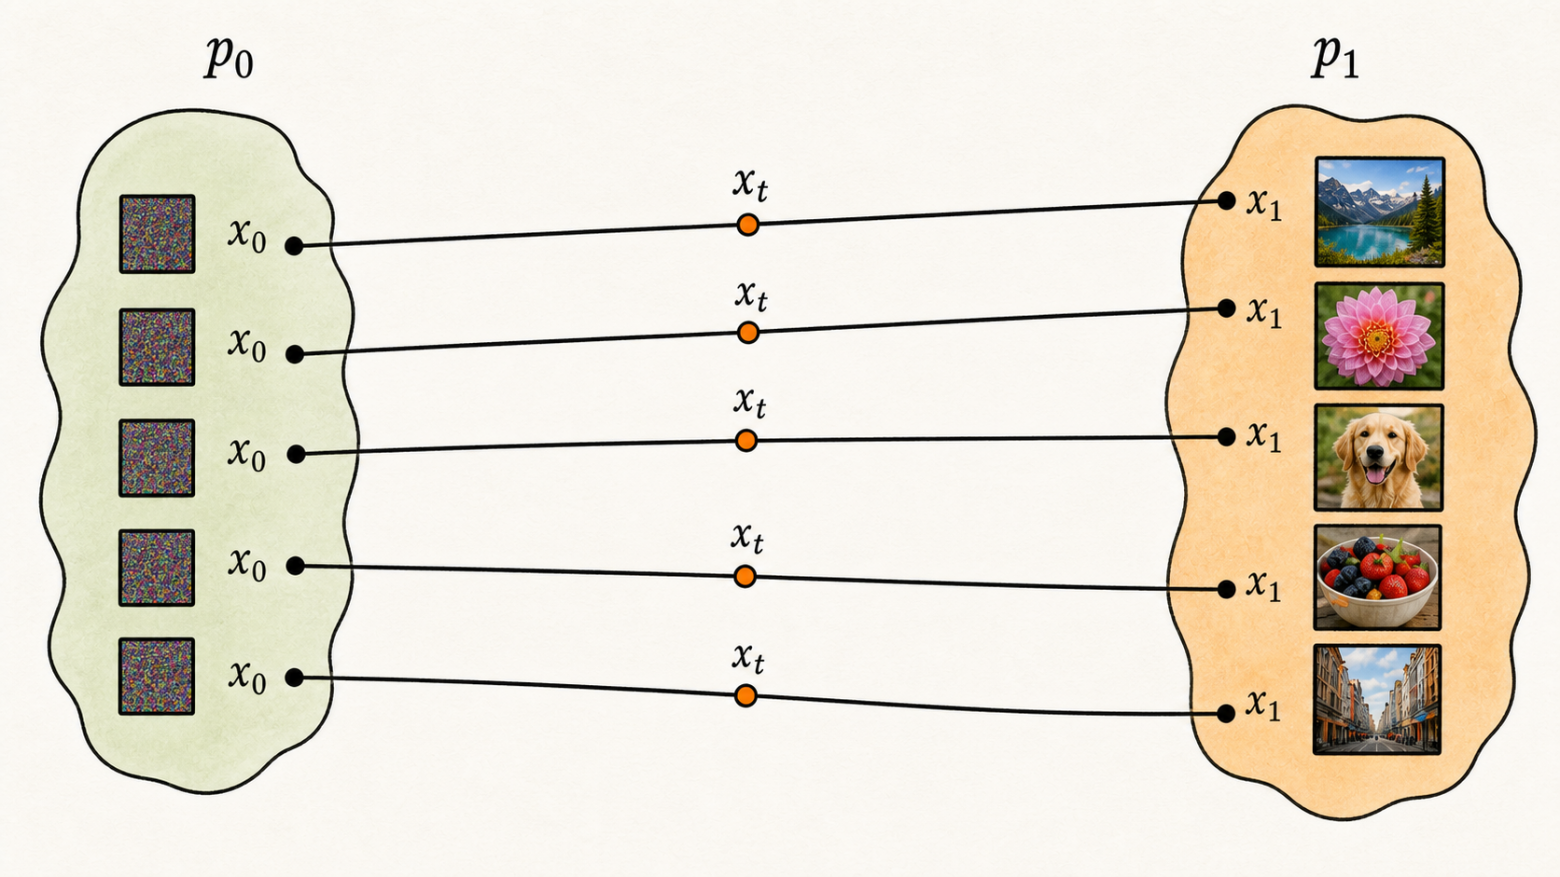
Можно представить, что каждая точка движется во времени: сначала она выглядит как случайный шум, а затем становится настоящим изображением.
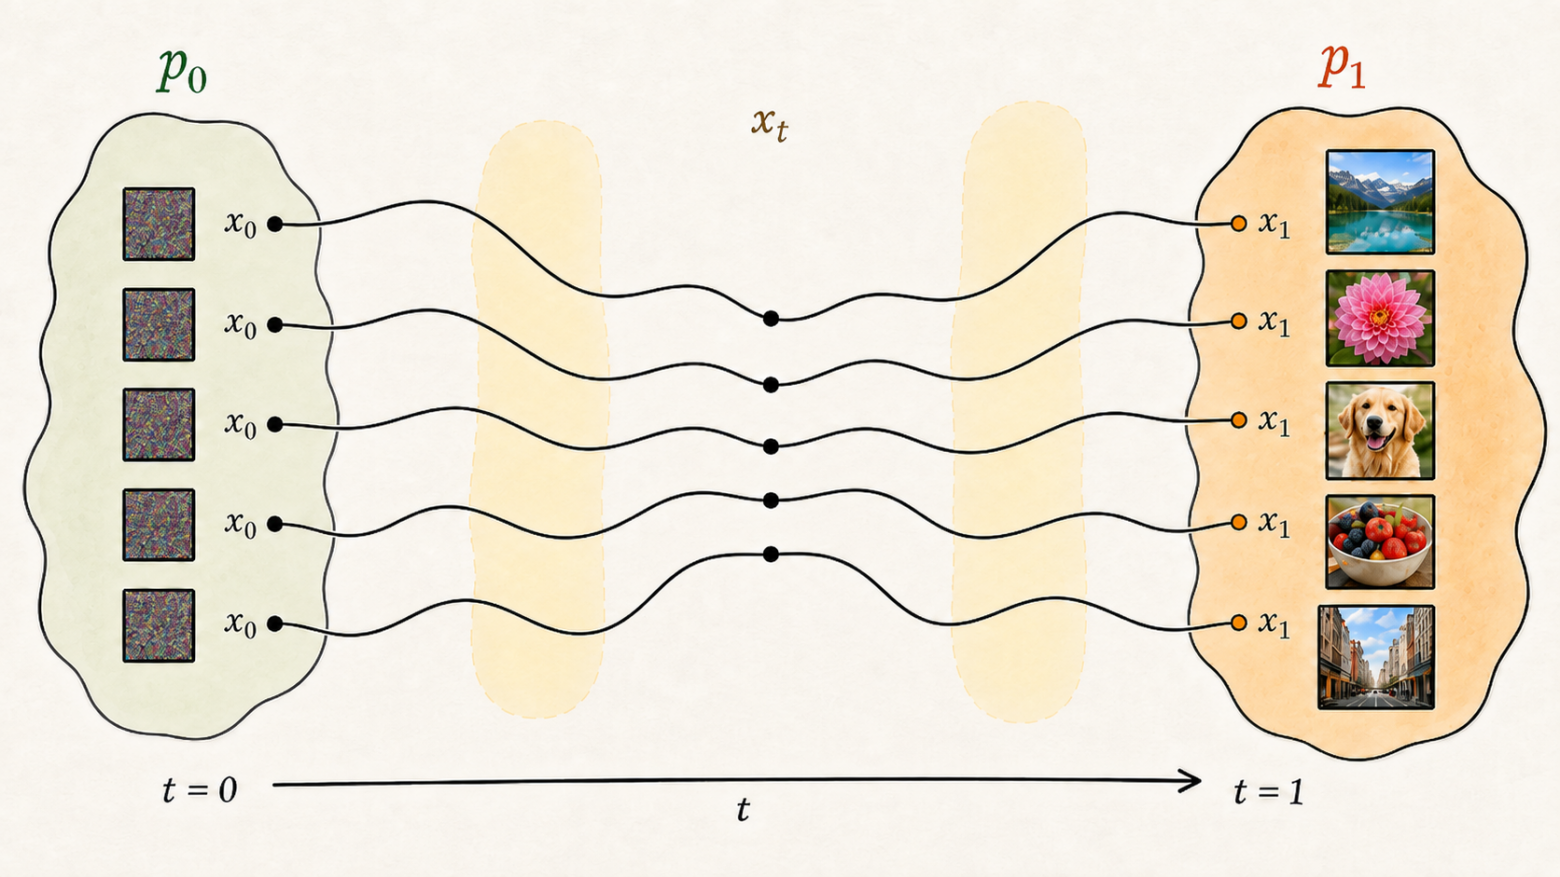
На рисунке выше мы работаем в одномерном пространстве (по вертикали — координата, по горизонтали — время), либо в двумерном пространстве (шум — слева, картинки — справа, и мы движемся в этом двумерном пространстве во времени).
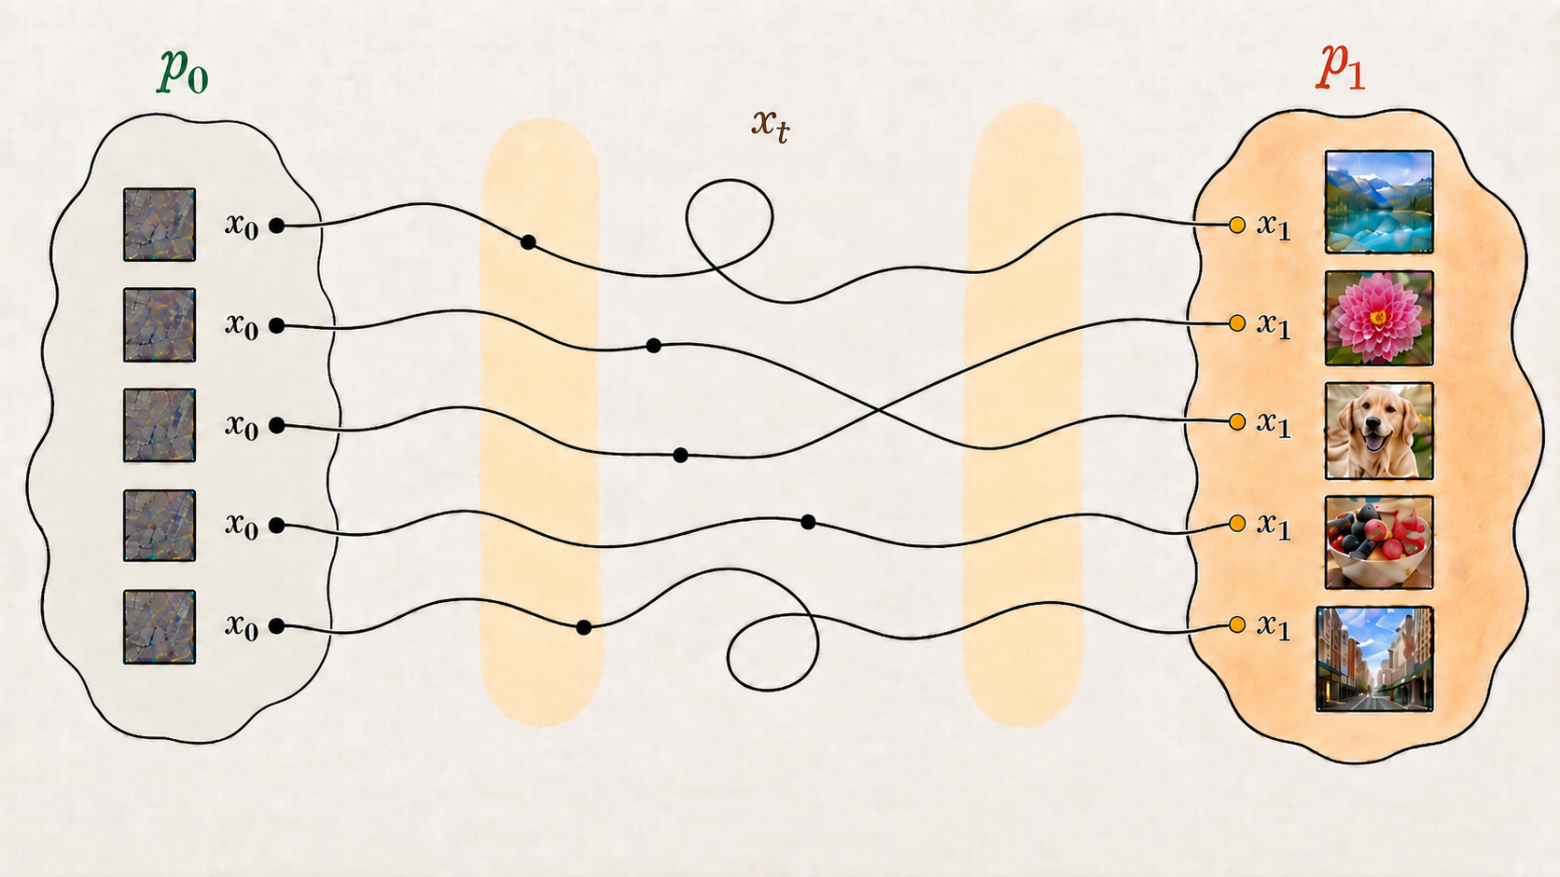
Но для двумерного пространства траектории могут быть и другие, например, петли:
Самый простой способ соединить шум  и объект
 во времени — провести между ними прямую линию:
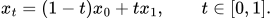
При  эта формула даёт
 , то есть шум. При
 она определяет
 , то есть объект из данных. А при промежуточных значениях времени
 точка находится где-то между шумом и изображением.
Скорость движения вдоль такой прямой траектории постоянна и равна:
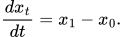
То есть здесь направление движения (вектор скорости) — вектор от начального шума к конечному объекту.
Траектории точек (или частиц) могут быть совершенно разными. Вместо предварительного знания конечной точки  или точки на траектории (что кажется очень сложным, потому что нужно сопоставлять точки из шума с реальными картинками) попробуем описать само движение. Для этого удобно использовать векторное поле.
Векторное поле  говорит нам, куда и с какой скоростью нужно двигаться из точки
 в момент времени
 . Например, если сейчас мы находимся в точке
 , то поле
 показывает направление следующего шага.
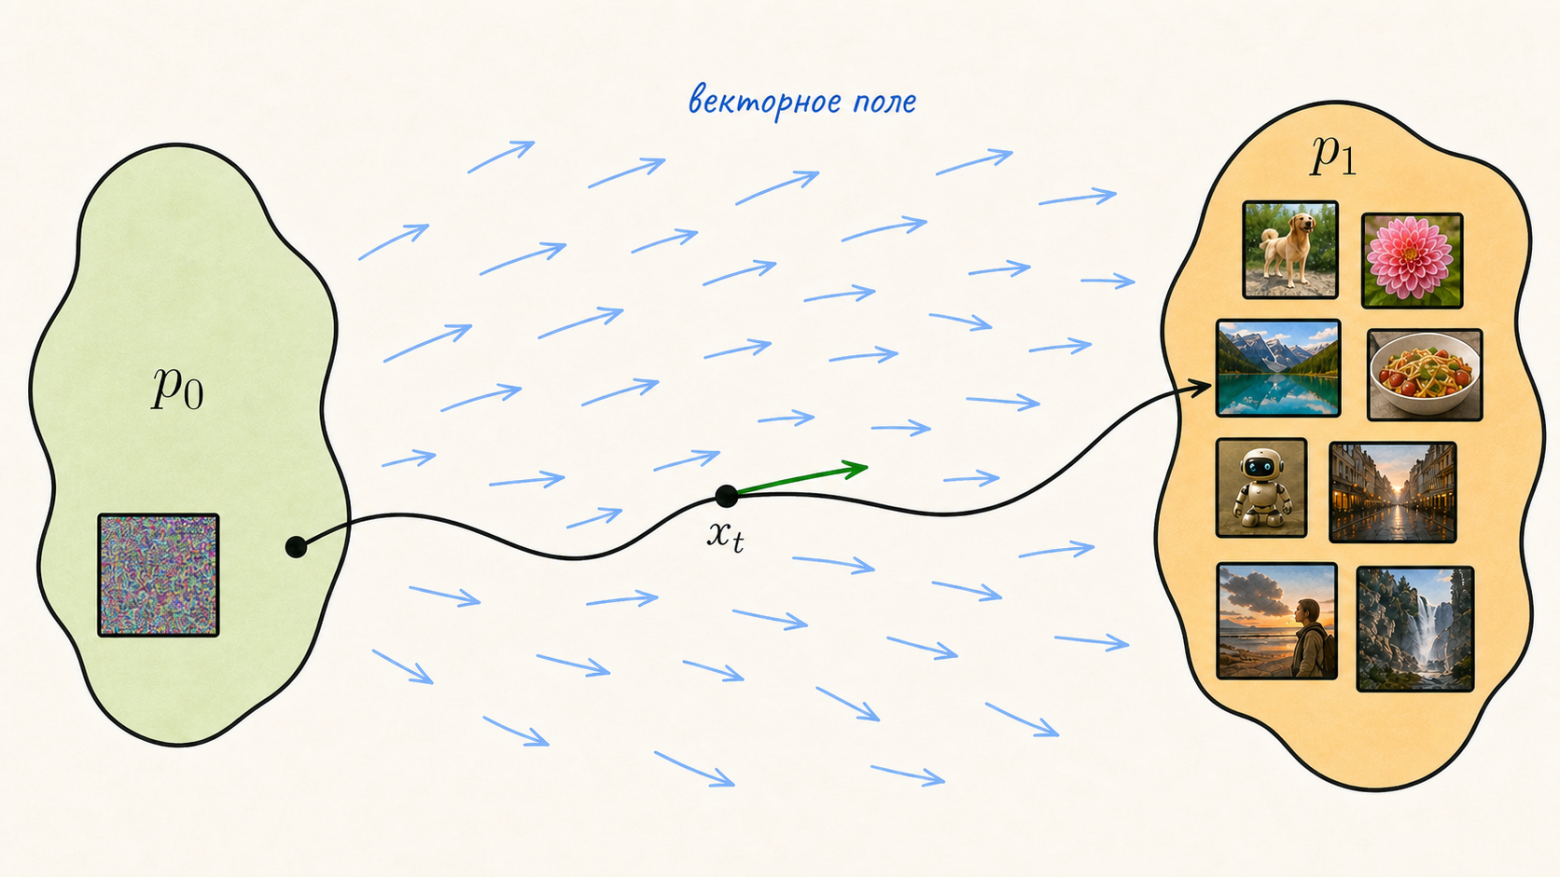
На этой и следующей визуализациях векторы короче, чем они есть, потому что удобно брать далёкие  и
 . В таком случае
 будет большим и сложным для отображения. Тогда мы будем «домножать» векторы на некоторое
 .
Если сделать небольшой шаг по времени  — новое положение точки можно записать так:

Следовательно, мы берём текущую точку  , смотрим на скорость, которую предсказывает поле, и немного передвигаемся в этом направлении.
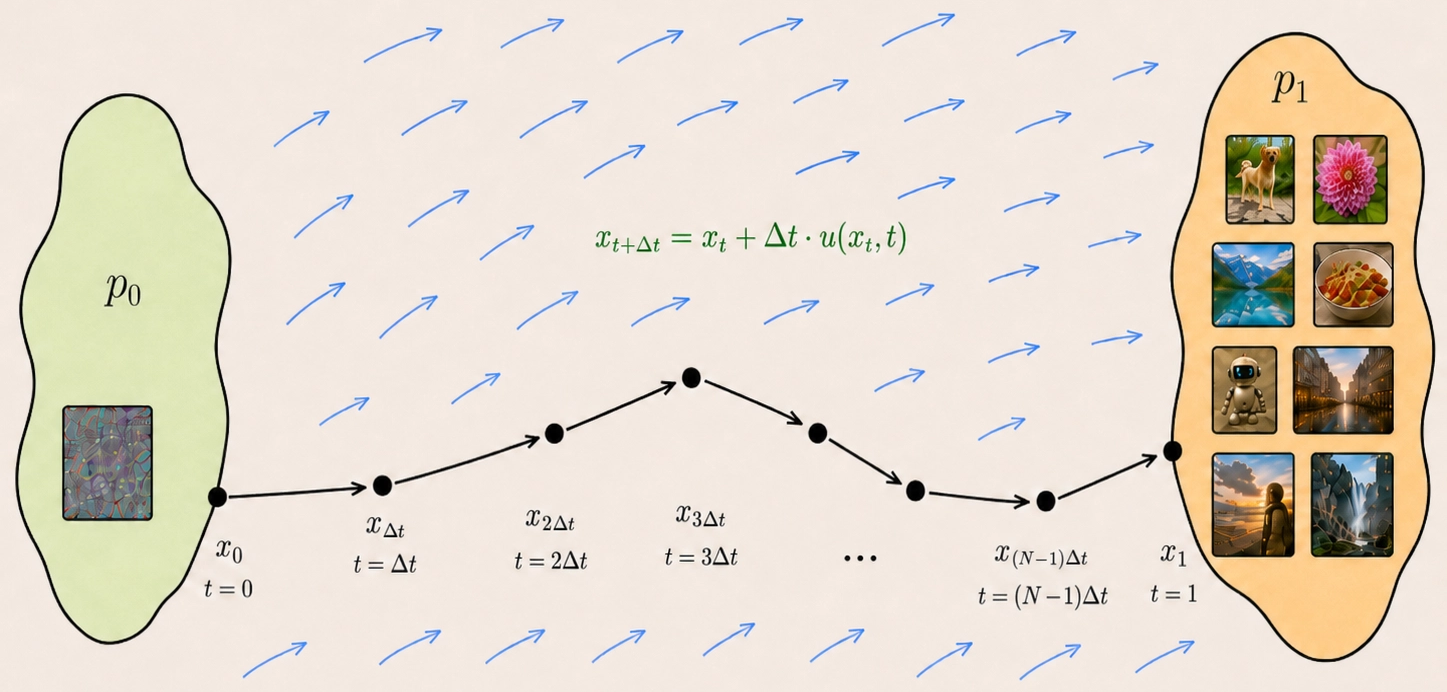
Итак, задачу генерации можно сформулировать так: необходимо обучить нейросеть  , которая приближает правильное векторное поле. После этого мы можем взять случайный шум
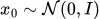 и постепенно двигать его по этому векторному полю от
 до
 . Если поле обучено хорошо, то в конце этого движения мы получим реалистичное изображение.
В математике для формального обозначения движения по вектору скорости используют обыкновенные дифференциальные уравнения (ordinary differential equations – ODE). Мы говорим, что хотим найти  , зная
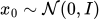 и закон
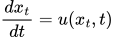 . Имеем начальную точку и закон скорости, значит, можем получить конечную точку, просто проинтегрировав
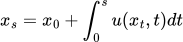 и
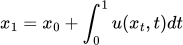 , где
 известен. Это мы и аппроксимируем через маленькие шаги
 .
Если мы для генерации траектории каждый раз будем вычислять  — мы не получим траектории, которые в определённый момент времени пересекутся и отойдут друг от друга. Дело в том, что при пересечении мы получим одинаковый
 , и далее обе траектории пойдут по
 , то есть уже не разъединятся.
Таким образом, мы избавились от необходимости описывать, какие начальные и конечные точки принадлежат траекториям. Достаточно знать скорость в каждой точке.
Обучение
Вернёмся к простой конструкции с прямыми траекториями. Возьмём пару объектов  , где
 — случайный шум, а
 — реальное изображение. Между ними можно провести прямую траекторию:

Мы можем соединить все  со всеми
 прямыми траекториями (каждый с каждым). В таком случае для текущего
 бесконечное число пар
 задаёт прямую траекторию, проходящую через
 . То есть промежуточная точка появляется из разных пар: шумы
 могли двигаться к различным изображениям
 и в какой-то момент оказаться примерно в одном и том же месте, имея скорости
 .
Итоговую скорость  можно получить, если усреднить все скорости, которые проходят через точку
 в момент времени
 . То есть мы можем выразить глобальную скорость
 через среднее локальных скоростей
 по всем парам
 .
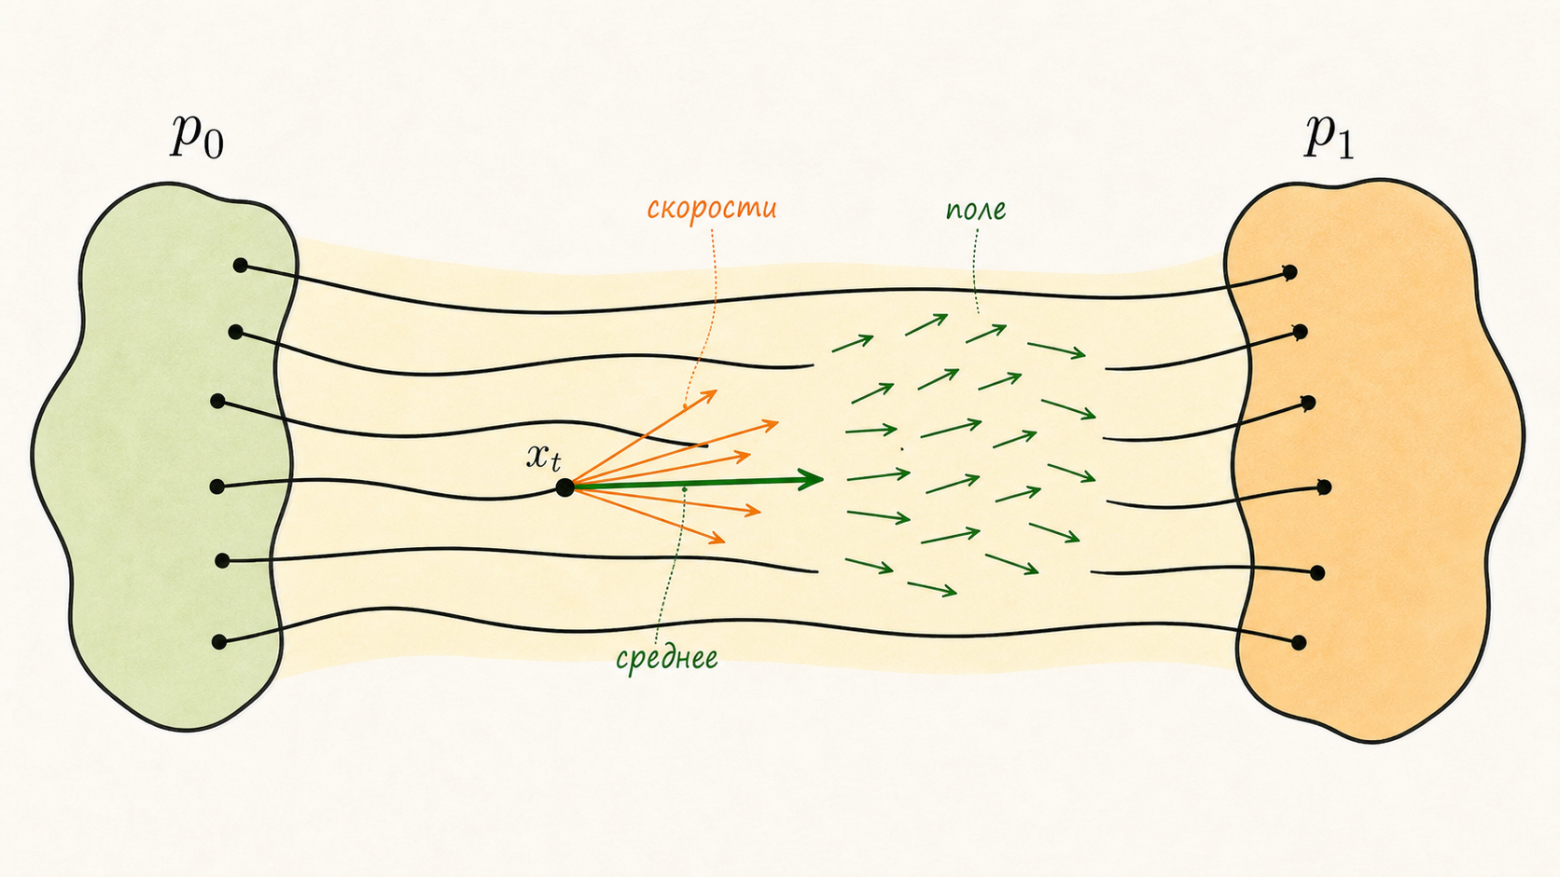
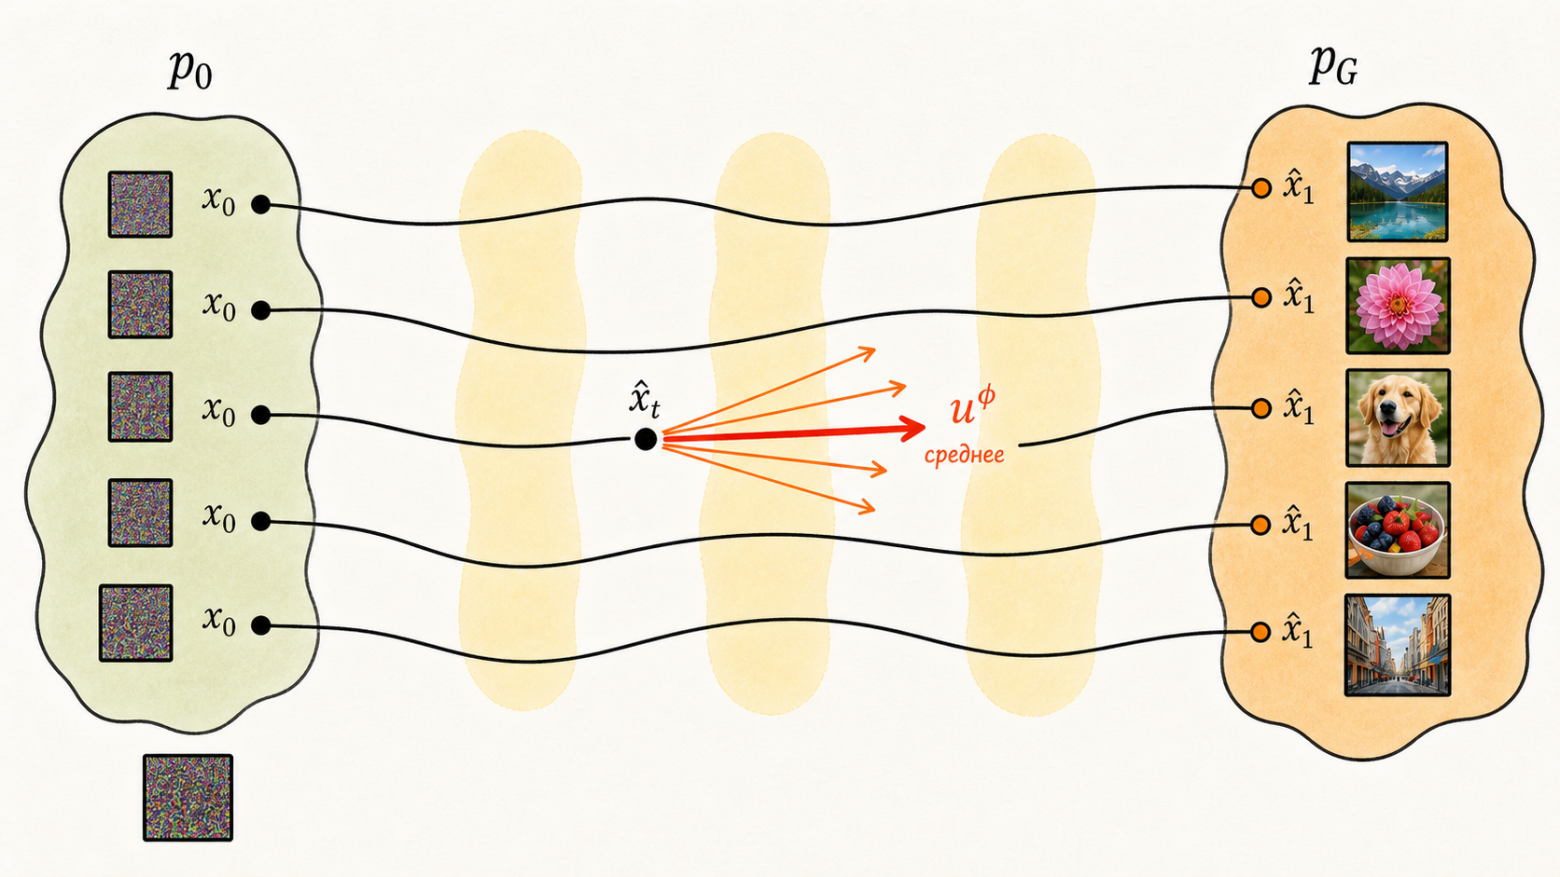
Итак, Flow Matching показывает, что нужно предсказывать среднюю скорость всех частиц, которые проходят через эту точку в данный момент времени, чтобы получить скорость для искомых траекторий. Формально это записывается через условное матожидание:
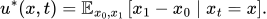
Условное математическое ожидание
Математическое ожидание — обобщение понятия среднего элементов. Но элементов может быть бесконечно много. Как и в нашем случае :)
Условное математическое ожидание — среднее элементов, полученных при каких-то условиях. К примеру, если мы хотим найти среднюю продолжительность сна перед сессией, то сессия — это условие.
Формула выше означает следующее: мы смотрим на все пары  , для которых промежуточная точка
 оказалась равна
 , берём их скорости
 и усредняем. Получившееся среднее направление и есть правильное векторное поле в точке
 и времени
 . Его мы и будем использовать для семплирования.
Здесь время  фиксировано: мы усредняем по парам
 , которые в этот момент проходят через точку
 , а не по разным моментам времени.
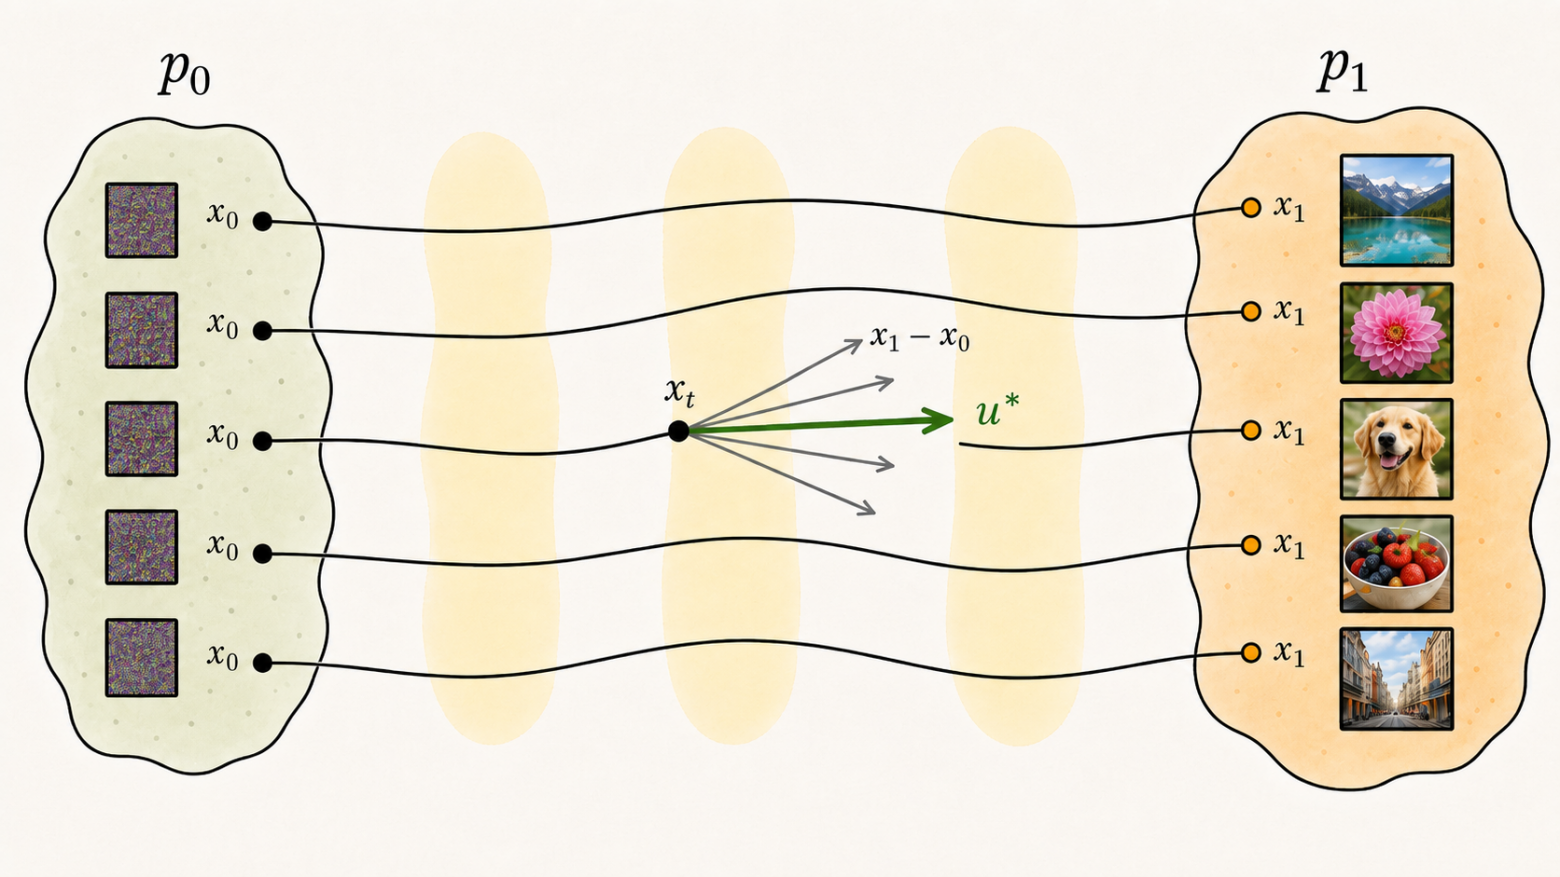
Прямые траектории при соединении  с
 и конечные траектории при семплировании — не одно и то же. Просто нам достаточно учить не все скорости, проходящие через текущую точку, а их среднее.
Почему можно брать именно среднее? Интуитивно, нас интересует не судьба одной конкретной частицы, а то, как меняется всё распределение точек. Если через одну область пространства проходит много частиц с разными скоростями, то общее движение плотности определяется их средним потоком. Поэтому для генерации достаточно выучить не каждую отдельную траекторию, а усреднённое векторное поле  .
На практике мы обучаем нейросеть  приближать поле. Для этого семплируем пару
 , выбираем случайное время
 , строим промежуточную точку
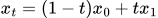 и просим модель по
 предсказать скорость

Получается обычная задача регрессии:
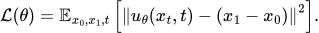
Минимум этой MSE-задачи при каждом фиксированном времени  как раз и равен условному среднему:

Условное среднее
Покажем, что минимум MSE-задачи равен условному среднему.
Распишем наш лосс как математическое ожидание от условного математического ожидания (вынесем  ):
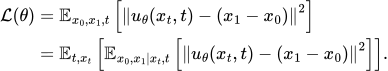
Отдельно обозначим  как условное среднее
 . Мы хотим показать, что
 как раз выучит
 .
Распишем отдельно то, что стоит под математическим ожиданием:
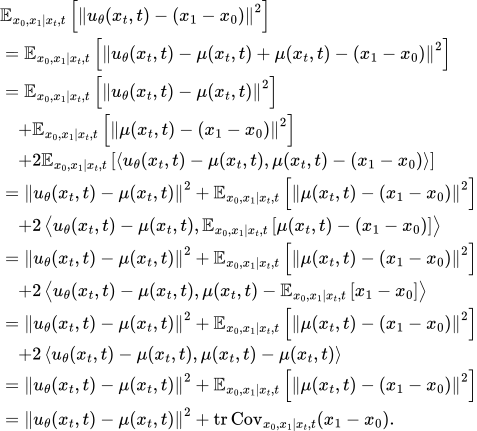
В итоге получим, что оптимум у  равен
 , так как второе слагаемое не зависит от
 . Что мы и хотели доказать.
Именно поэтому Flow Matching можно обучать просто: мы сами строим промежуточные точки  и знаем целевую скорость
 для каждой обучающей пары.
В следующих трёх скрытых блоках можно посмотреть примеры траекторий Flow Matching’а на задаче перевода одного нормального распределения в два, а также подробнее почитать про интуицию метода.
Перевод одной гауссианы в две
Рассмотрим пример с отображением одного нормального распределения в смесь двух нормальных распределений. Для начала визуализируем семплы из  и
 , а также промежуточные семплы
 , которые были получены как
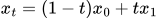
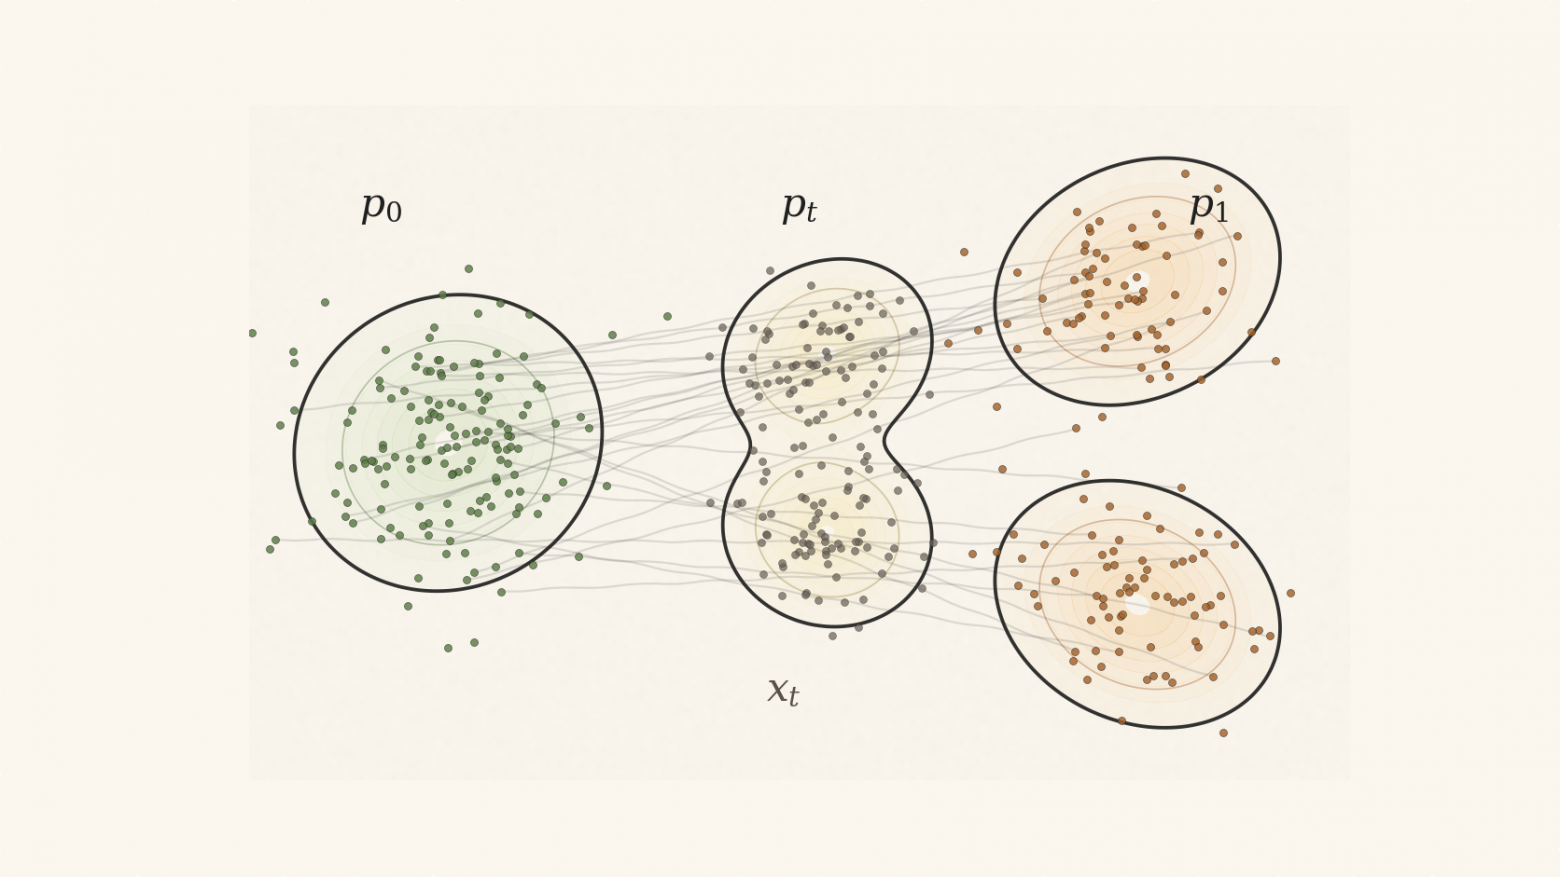
Для каждой промежуточной точки мы можем найти  и
 , которые её породили, и соответствующую скорость
 (на рисунке для удобства восприятия мы ужали векторы по длине).

Итоговая скорость в момент времени  для точки
 — среднее среди скоростей
 , для которых
 (для удобства восприятия векторы мы ужали по длине).

Появление средней скорости
Представим, что в момент времени  мы смотрим на некоторую точку
 . Она могла появиться из разных пар
 . Для каждой такой пары есть своя скорость
 Можно сказать, что она получена применением некоторой силы, толчка. Поэтому в одной и той же точке
 может быть не одна «правильная сила», а целое распределение возможных сил.
Теперь вместо того, чтобы сразу заменять все эти силы на среднюю, будем прикладывать их по одной. На очень маленьком промежутке времени  случайно выберем одну скорость из условного распределения:
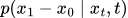
и сдвинем точку:
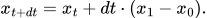
Почему такая процедура сохраняет правильное распределение? Потому что в исходном процессе происходит ровно то же самое, если смотреть только на точку  . Среди всех частиц, которые оказались в
 в момент времени
 , скорости распределены по тому же условному закону:
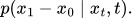
Значит, если мы выбираем скорость из этого распределения, то за маленький шаг  получаем такой же локальный перенос частиц, как и в исходном процессе с прямыми траекториями (где мы соединяли
 и
 и шли линейно от
 к
 ).
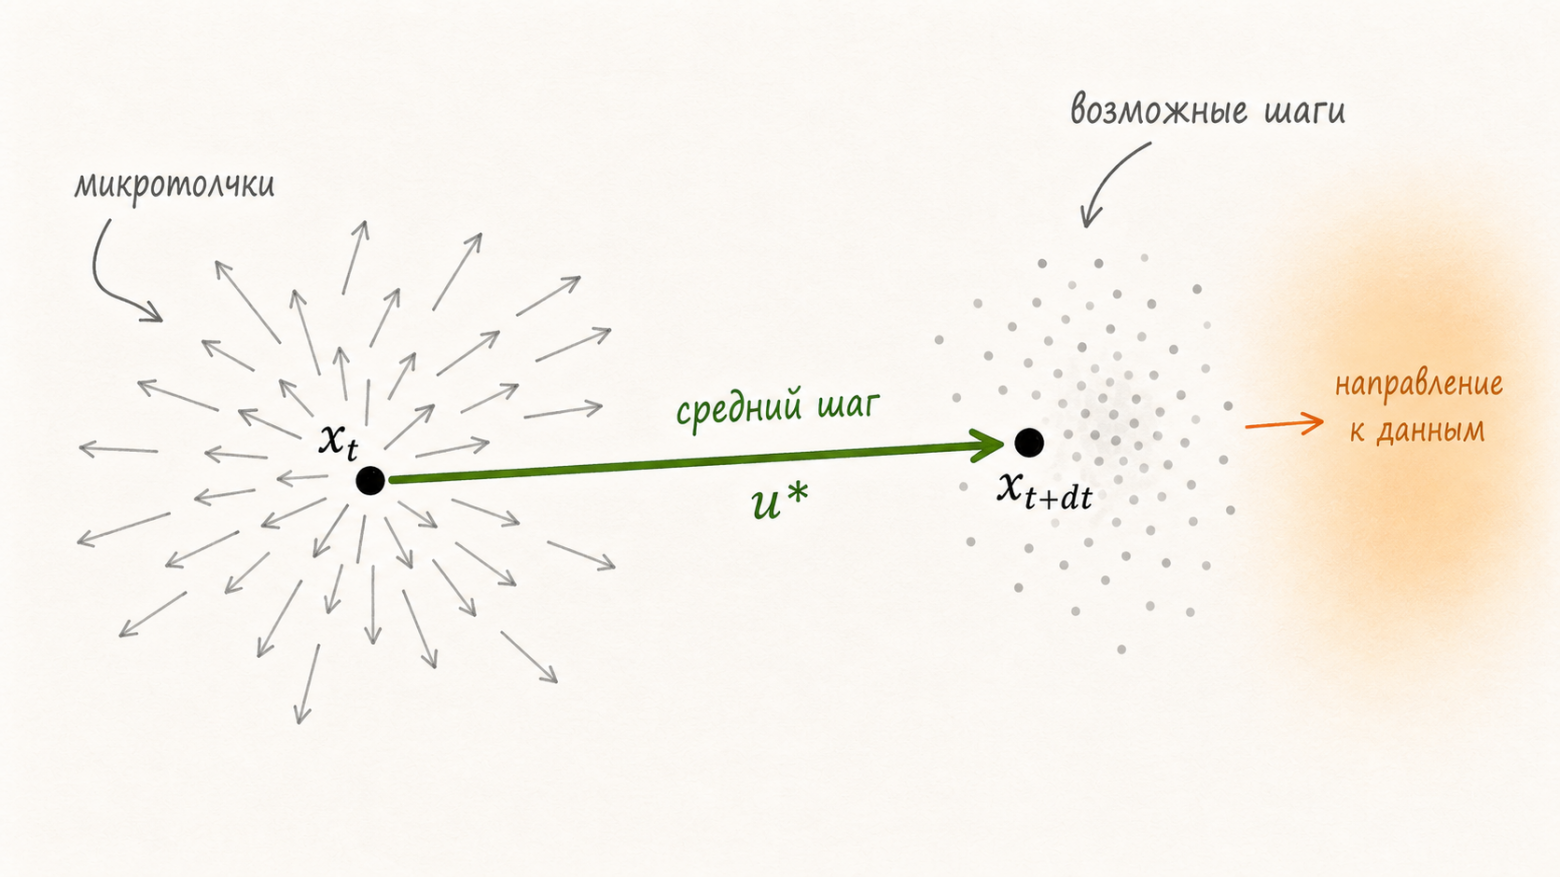
Теперь разобьём маленький промежуток времени  на множество микропромежутков времени
 . На каждом микрошаге мы можем выбрать одну из возможных скоростей из
 . Но отдельный сдвиг очень мал, потому что он умножается на
 . Поэтому за каждый конкретный микрошаг мы почти не сдвигаемся,
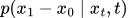 не меняется, а за множество таких шагов мы в итоге сдвинемся на среднее направление всех этих скоростей, умноженное на
 .
Иными словами, если в точке  на частицу действует много возможных сил, то на бесконечно малом масштабе их можно заменить одной средней силой:

Именно это среднее поле и нужно выучить модели. Оно не пытается восстановить конкретную пару  , а описывает средний поток частиц, который переносит всё распределение шума к распределению данных.
Механическая аналогия
Эту идею можно представить с помощью механической аналогии. Пусть каждая пара  задаёт один «удар по мячу»: футболист стоит в точке
 , ворота находятся в точке
 , и мяч летит от футболиста к воротам по прямой траектории:
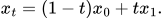
Скорость такого мяча постоянна и равна:

Причём футболисты не знают, в какие конкретно ворота они должны попадать, поэтому каждый бьёт в каждые ворота.
Теперь посмотрим на некоторую точку  в момент времени
 . Через неё могут пролетать мячи, запущенные из разных
 в разные
 . Поэтому в одной и той же точке
 мы можем увидеть много различных скоростей: один мяч летит чуть левее, другой — чуть правее, третий — почти прямо.
Представим, что в точке  находится тяжёлое подвижное заграждение. Когда через него пролетают мячи, они слегка его толкают. Каждый отдельный толчок очень маленький: за короткое время
 заграждение успевает сдвинуться только на величину порядка
 . Поэтому один случайный удар почти не меняет его положения.

Но если за это маленькое время через точку проходит много мячей с разными скоростями, то суммарный эффект определяется не одной конкретной скоростью, а средним направлением всех этих микротолчков. То есть заграждение будет двигаться так, как если бы на него действовала средняя скорость всех мячей, пролетающих через точку  в момент
 (если бы «запульнули» все мячи сразу).
Именно эта средняя скорость и задаёт поле Flow Matching’а:

То есть модель не пытается понять, какой именно мяч сейчас пролетел через точку  . Вместо этого она учится предсказывать средний толчок от всех возможных мячей, которые могли оказаться в точке в данный момент времени. Такое усреднённое движение и переносит всё распределение шума к распределению данных.
Алгоритм
На каждой итерации мы берём случайный шум  , случайный объект из данных
 и случайное время
 . Затем строим промежуточную точку
 на прямой между шумом и объектом и просим модель предсказать её скорость. На практике всё то же самое делается сразу для целого батча объектов, поэтому алгоритм ниже записан в батчевой форме.
-
⚙️ Алгоритм: Обучение Flow Matching-модели
-
Вход: Семплы из распределения
 (возможность семплировать), модель векторного поля
 , оптимизатор для параметров
 , количество итераций
 , размер батча

-
Результат: Обученное поле

-
Для
 до
 :
-
Семплируем батч шумов, объектов и времён:

-
Строим промежуточные точки:
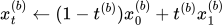
-
Считаем целевые скорости прямых траекторий:

-
Считаем среднюю ошибку предсказания скорости по батчу:
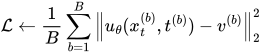
-
Обновляем параметры
 шагом оптимизатора по

-
После обучения у нас есть модель  , которая приближает среднее поле скоростей. Теперь мы можем использовать её для генерации новых объектов.
Идея семплирования следующая — мы стартуем из случайного шума:
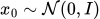
И постепенно двигаем точку по выученному векторному полю от времени  до времени
 . Если разбить отрезок
 на
 маленьких шагов, то один шаг движения можно записать так:
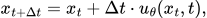
Где:

То есть на каждом шаге модель говорит нам, в каком направлении нужно немного сдвинуть текущую точку. После  таких шагов мы получаем финальный объект
 , который должен быть похож на данные. Если нужно сгенерировать множество объектов, тот же цикл обычно выполняется параллельно для батча начальных шумов.
-
⚙️ Алгоритм: Семплирование с помощью Flow Matching’а
-
Вход: Обученное поле скоростей
 , количество шагов семплирования

-
Результат: Сгенерированный объект

-
Семплируем начальный шум:

-
Задаём размер шага по времени:

-
Для
 до

-
Текущее время:

-
Предсказываем скорость в текущей точке:
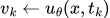
-
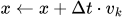
Делаем маленький шаг по полю:
-
-

Здесь используется самый простой численный метод — метод Эйлера. Он буквально повторяет нашу интуицию: посмотреть на текущую скорость, сделать маленький шаг в этом направлении, затем снова посмотреть на скорость и снова сделать шаг. Чем больше  , тем точнее мы следуем выученному полю, но тем медленнее становится генерация.
В следующем скрытом блоке представлен формальный вывод Flow Matching’а через пробные функции, а также разбор уравнения непрерывности. Это позволит перейти от интуиции к математическому пониманию метода.
Формальный вывод
Итак, давайте более формально с помощью пробных функций покажем, почему Flow Matching учит именно поле:

И почему, начиная с  и двигаясь по
 , мы получим то же самое распределение у
 , как если бы мы просто семплировали его как
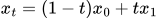 .
Рассмотрим случайный процесс:

Где:

Для каждой конкретной пары  скорость вдоль прямой траектории равна:
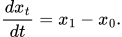
Пусть  — плотность распределения промежуточных точек
 в момент времени
 . Мы хотим понять, как она меняется со временем.
Возьмём произвольную гладкую пробную функцию с компактным носителем:

Тогда для фиксированного  :
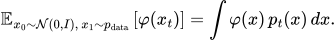
Продифференцируем это ожидание по времени:
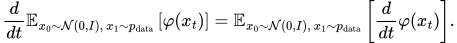
По правилу цепочки:
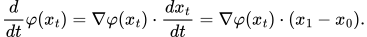
Значит:
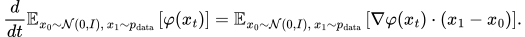
Теперь используем условное математическое ожидание по текущей точке  :
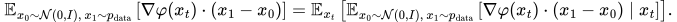
Так как  зависит только от
 , её можно вынести из внутреннего условного ожидания:
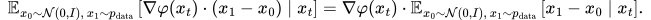
Введём среднее поле скоростей:
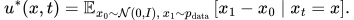
Тогда:
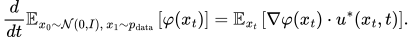
Переходим к интегралу по плотности  и получаем:
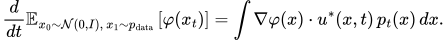
Теперь проинтегрируем по частям. Так как  имеет компактный носитель, граничные члены исчезают (на бесконечности они равны 0):
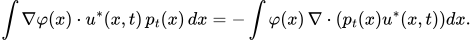
С другой стороны:
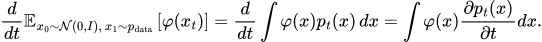
Значит:

Или:
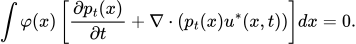
Это верно для любой пробной функции  , следовательно, мы получаем уравнение непрерывности для плотности
 :
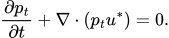
Итак, мы показали — плотности  из прямых траекторий:
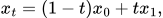
Удовлетворяют уравнению непрерывности с полем  .
Но почему можно двигаться по среднему полю?
Рассмотрим новый процесс генерации. Возьмём начальную точку:
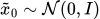
И будем двигать её по ODE:
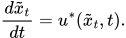
Пусть  — плотность распределения случайной величины
 .
Теперь отдельно покажем, что эта плотность  тоже удовлетворяет уравнению непрерывности.
Снова возьмем гладкую пробную функцию  :

Продифференцируем это ожидание по времени:

По правилу цепочки:
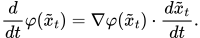
Так как  движется по ODE:

Получаем:

Теперь перепишем это ожидание как интеграл по плотности  :
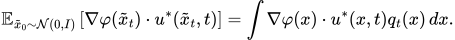
Интегрируем по частям:

С другой стороны:
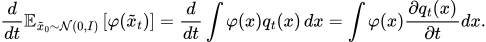
Значит:
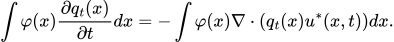
Или:
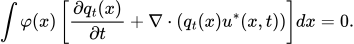
Так как это верно для любой пробной функции  , получаем уравнение непрерывности для плотности
 :
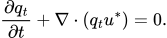
Теперь сравним два процесса. Для исходных прямых траекторий мы получили:
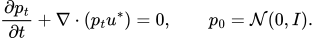
А для движения по среднему полю:
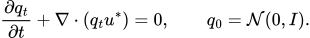
Это одно и то же уравнение с одинаковым начальным условием. При этом, в уравнении явно показывается изменение плотности  по текущим
 и
 . Значит, если его решение единственно, то:

для всех  .
Зачем нужна единственность решения уравнения
Рассмотрим одномерное поле  . Из точки
 существуют разные решения. Можно навсегда остаться в нуле
 , а можно начать двигаться
 .
Более того, можно некоторое время стоять, а затем начать движение
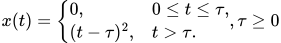
Все эти траектории имеют одну и ту же начальную точку  и удовлетворяют одинаковому полю. Причина в том, что функция
 не является локально липшицевой в окрестности точки
 .
На практике наш сетап удовлетворяет условию единственности (можно вывести из теоремы Коши — Липшица), примем это за факт не будем к нему возвращаться далее в статье 🙂
Именно это и объясняет, почему можно двигаться по среднему полю. Мы не просто «на глаз» заменили разные скорости на среднюю. Мы показали, что исходный процесс с прямыми траекториями и новый процесс, который движется по ODE, порождают одну и ту же эволюцию плотности:
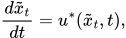
Интуитивно это означает, что в одной точке  в момент времени
 разные частицы могут иметь различные скорости. Одни летят левее, другие — правее. Одни быстрее, другие — медленнее. Но изменение плотности зависит не от индивидуальной скорости каждой частицы, а от суммарного потока массы через эту точку. Он равен:
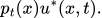
Поэтому Flow Matching учит макроскопическое поле скоростей  , а не отдельные траектории между конкретными парами
 . Двигаясь по этому среднему полю из шума, мы получаем ту же эволюцию распределений, что и при движении всех обучающих пар по прямым траекториям.
Итак, первая часть про обучение Flow Matching завершена. Мы показали, что суть Flow Matching’а — выучивание средних скоростей. Самое время обновить чай и перейти ко второй части — дистилляции в одношаговый генератор! 😇
Мотивация
Итак, мы разобрали, что такое Flow Matching. Давайте посмотрим, почему его не очень удобно использовать на практике 😢
После обучения Flow Matching-модели генерация требует нескольких шагов. Мы стартуем из шума:
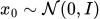
И численно движемся по выученному полю  от
 до
 :
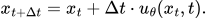
Чтобы получить качественное изображение, обычно нужно сделать много маленьких шагов. Например, если взять:

То на отрезке  получится
 шагов. То есть
 обращений к нейросети для генерации одного изображения. А это очень много.
Здесь возникают две основные проблемы:
-
Вычислительная стоимость. Каждый шаг требует отдельного запуска нейросети. Даже если один проход модели работает быстро — десятки или сотни проходов могут сделать генерацию слишком медленной для практического использования.
-
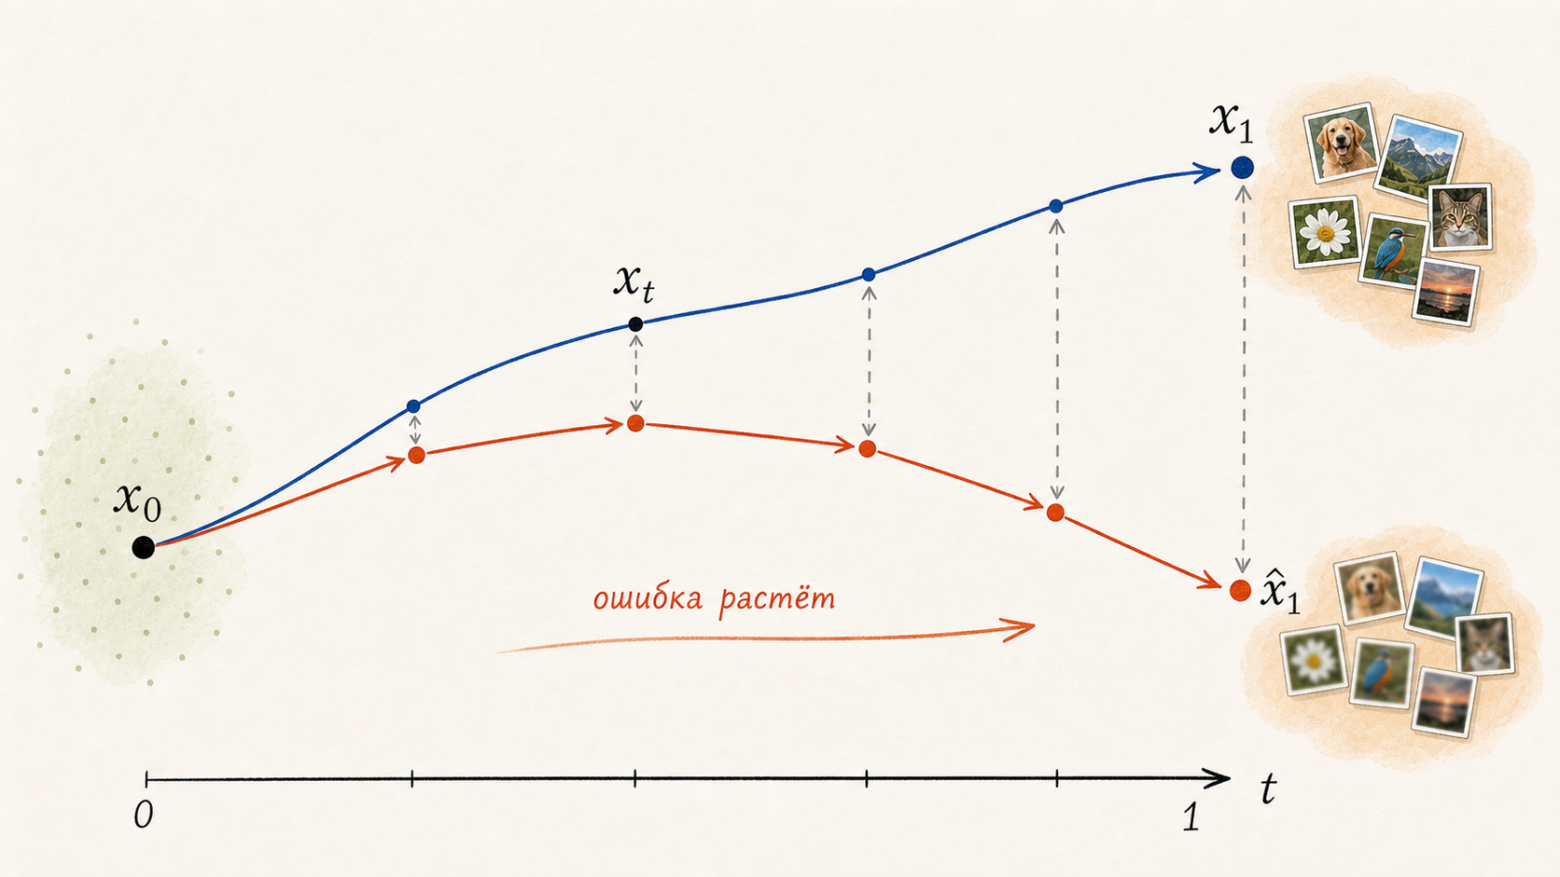
Ошибка дискретизации. В идеале мы хотели бы двигаться по непрерывной траектории. Но на практике мы делаем конечные шаги размера
 . Если шаг слишком большой, траектория может заметно отклоняться от той, которую задаёт непрерывное поле. Это может ухудшать качество сгенерированного изображения.
Дистилляция
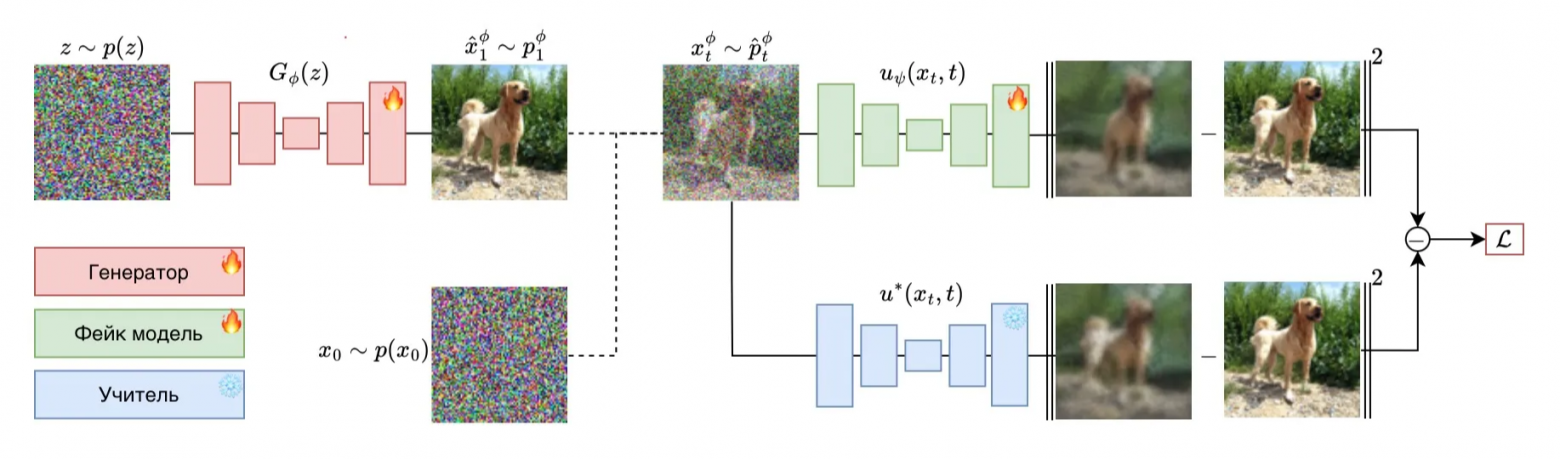
Отсюда возникает идея — научить отдельную модель, которая будет сразу выучивать генерацию картинок. То есть мы хотим обучить генератор  сразу строить финальный объект:

Такой подход называется дистилляцией: мы используем обученную многошаговую Flow Matching-модель как учителя и пытаемся передать её поведение более быстрой одношаговой модели-генератору.
Обычно под дистилляцией понимают обучение маленькой модели по выходам большой, но мы имеем в виду обучение одношагового генератора (сама модель-генератор может быть больше модели учителя).

Важное уточнение — мы не хотим выучить отображение из  в
 , которое бы повторяло предсказание Flow Matching’а. У нас
 — отдельный генератор со своим латентным пространством
 , не связанным с
 (может иметь даже другую размерность). На самом деле мы сделаем что-то похожее на GAN, дискриминатор которого имеет определённый вид и некоторую стохастичность из-за
 .
Есть и другие методы, например, consistency models, которые ставят своей задачей выучить генератор  повторять
 , полученный по
 , двигаясь по
 или
 , но это уже тема для отдельного поста 🙂.
Построение поля по сгенерированным картинкам
Теперь мы хотим заменить многошаговое движение по Flow Matching-полю одним прямым переходом от шума к изображению.
Для этого построим генератор:
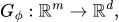
Он получает на вход латентный шум (его размерность может отличаться от размерности исходного пространства  и
 ):
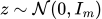
И сразу выдаёт объект в пространстве данных:
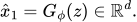
Здесь  — размерность латентного шума генератора, а
 — размерность данных. Например, если мы генерируем изображение размером
 , то
 , а размерность
 можно выбрать отдельно.
Во время генерации нам нужен только один запуск генератора: мы семплируем  , считаем
 и сразу получаем изображение. Но для его обучения нужно построить вспомогательное поле, как и для Flow Matching’а.
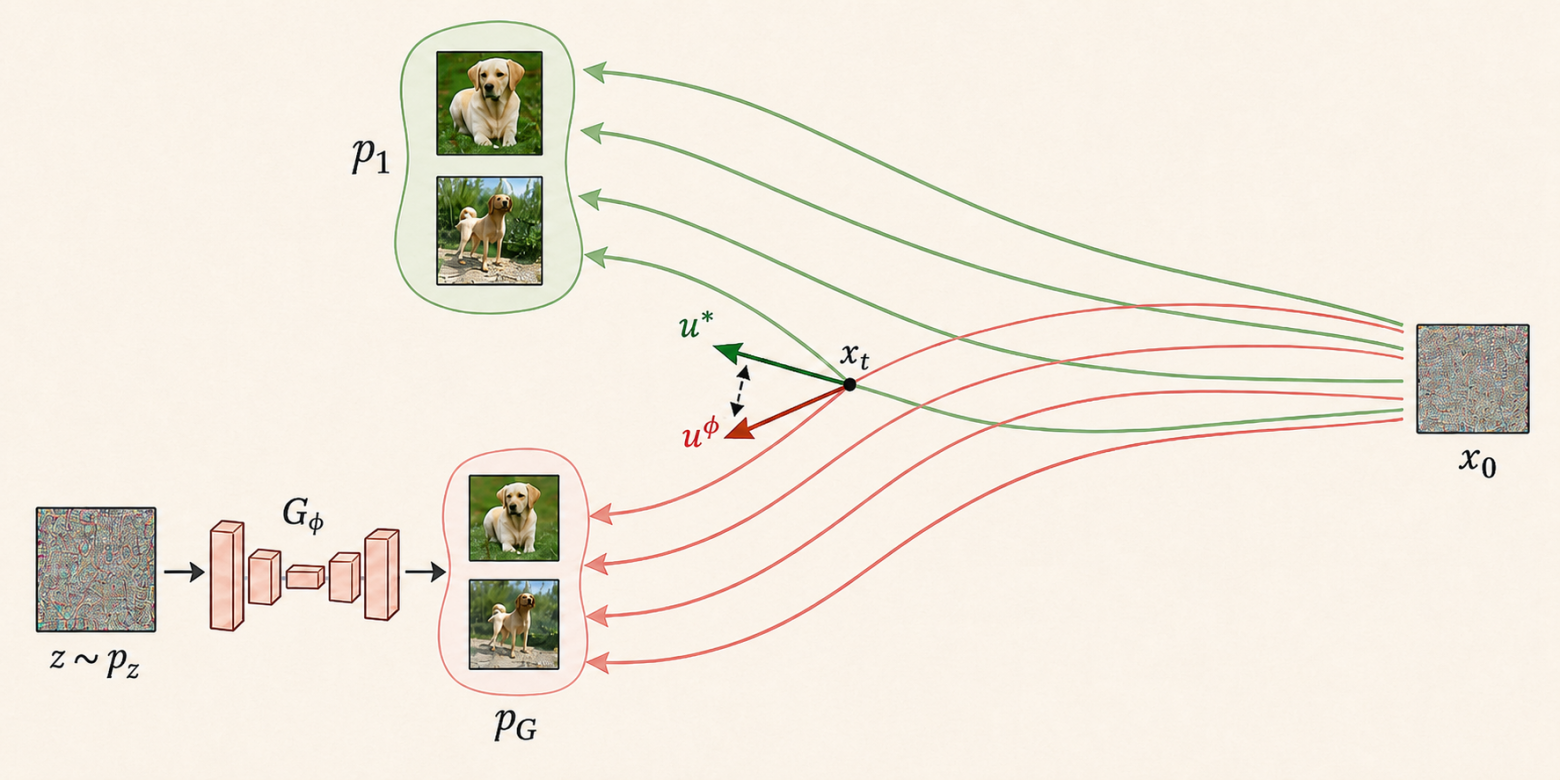
Идея следующая — траектории поля, полученного по генератору, должны быть похожи на настоящие Flow Matching-траектории (которые мы получили по полю, построенному из реальных данных). Тогда генерации и исходные картинки совпадут.
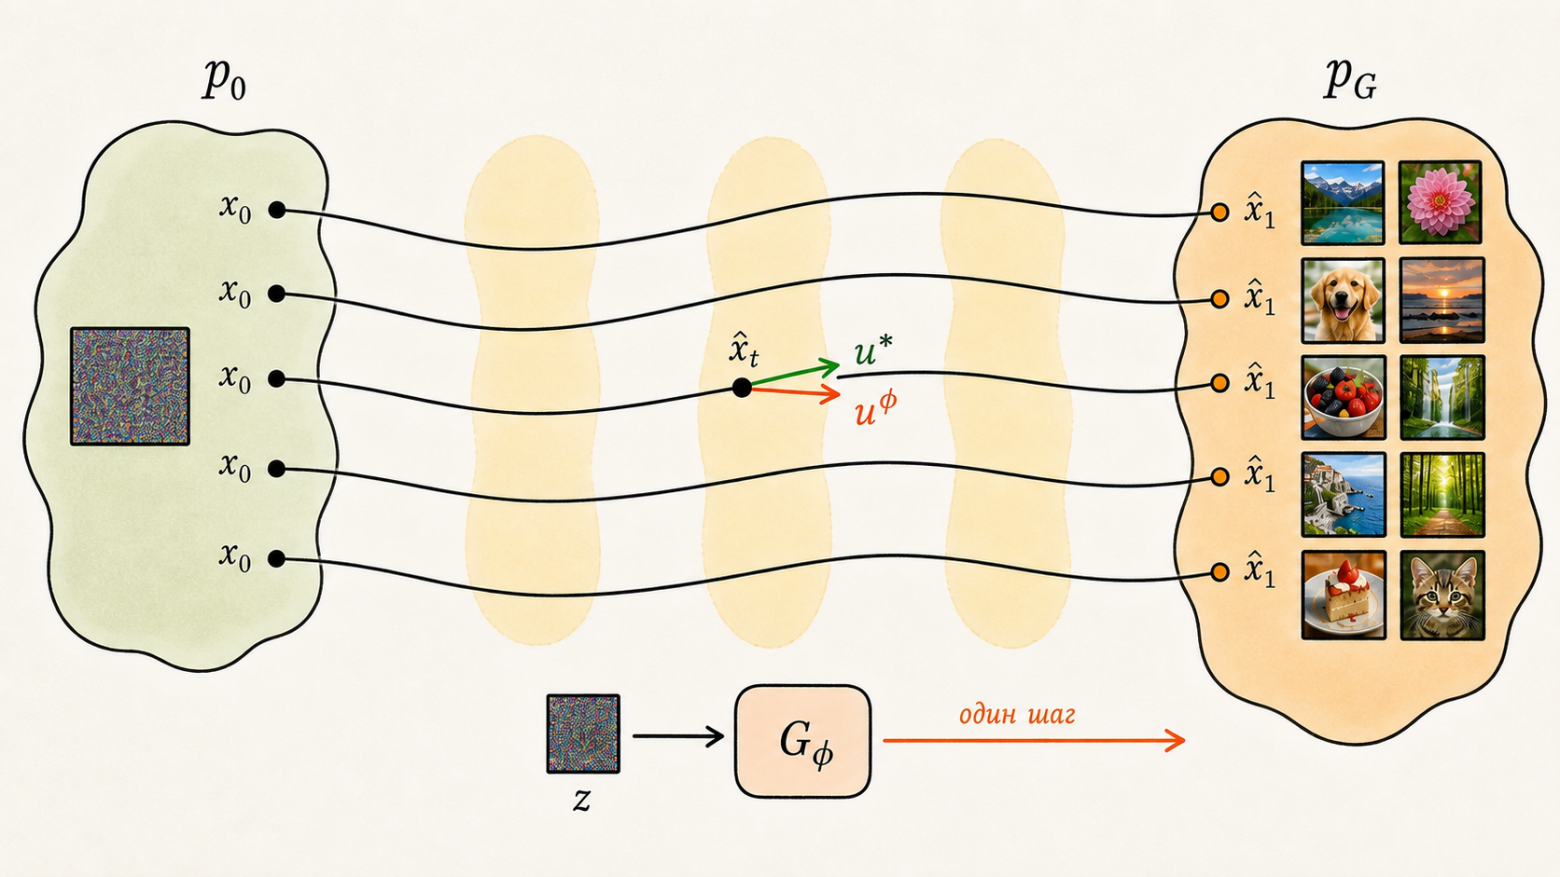
Начнём с построения поля для сгенерированных картинок. Повторим (практически) вывод, который мы делали для Flow Matching’а, но для сгенерированных изображений, не реальных. Для этого семплируем два независимых шума:

Шум  подаётся в генератор и задаёт сгенерированный объект:
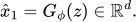
А независимый шум  используется как начальная точка траектории в пространстве данных. Между
 и
 строим прямую:
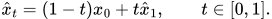
Так как и  , и
 лежат в
 , вся траектория
 тоже находится в пространстве данных:

Скорость вдоль этой прямой равна:
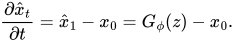
💡 Важно:  и
 — разные шумы.
Шум  живёт в латентном пространстве
 и нужен генератору для финальной точки
 . Шум
 живёт в пространстве данных
 и нужен для Flow Matching-траектории от стандартного шума к распределению генератора.
Поэтому при  мы имеем обычный шум в пространстве данных:

А при  получаем объект из генератора:

Теперь у сгенерированных траекторий тоже есть своё среднее поле скоростей. В одной и той же точке  в момент времени
 могут проходить разные траектории — они построены из различных пар
 . Поэтому определим поле генератора как условное среднее:
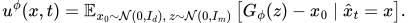
Оно описывает, как в среднем движутся точки, если мы берём независимый шум  , сгенерированный объект
 , а затем соединяем их прямой траекторией.
То есть мы строим поле Flow Matching’а, но не на реальных данных, а на сгенерированных.
Лосс дистилляции
С другой стороны, у нас уже есть поле учителя  , заранее обученное с помощью Flow Matching’а. Оно описывает правильное движение от шума к настоящим данным.
Поэтому цель у нас — подобрать генератор  так, чтобы поле его траекторий
 совпадало с полем учителя
 . Формально это можно записать так:
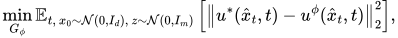
Где:
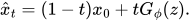
То есть мы семплируем  по сгенерированным изображениям и учим приближать поля (скорости) в точке. При этом реальные картинки нам не нужны, достаточно предобученной модели Flow Matching’а — предобученного поля.
Мы хотим обучить генератор так, чтобы его поле совпадало с полем на реальных данных. Еще мы знаем, что распределения в начальный момент времени  и
 совпадают (это просто гауссианы). Тогда совпадут и траектории, по которым мы движемся, и сгенерированные по ним изображения (обсудили в формальном выводе Flow Matching).
Но это пока идеальная математическая цель. На практике поле  неизвестно явно, потому что оно само является условным средним по траекториям генератора. Поэтому теперь нам нужно придумать, как приблизить цель и получить удобный алгоритм обучения! 😉
Как вычислять лосс дистилляции (делать tractable)
В предыдущем разделе мы получили идеальную цель дистилляции:

Где:

А поле генератора определяется как условное среднее:

Проблема в том, что  нельзя посчитать напрямую. Это условное математическое ожидание скорости по всем парам
 или, эквивалентно,
 , траектории через точку
 в момент времени
 . Поэтому нам нужен способ приблизить это поле.
Для этого введём дополнительную Flow Matching-модель  . Её задача — учиться предсказывать скорость траекторий генератора
 , чтобы использовать эту модель для вычисления лосса.
То есть  обучается, как и Flow Matching-модель, только вместо настоящих данных
 мы используем сгенерированные объекты:

При фиксированном генераторе  модель
 можно обучать обычной MSE-регрессией:
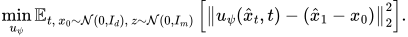
Как и раньше, минимум MSE соответствует условному среднему, поэтому в оптимуме получаем:
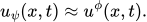
Такую модель  мы будем называть фейк-моделью — она обучена на сгенерированных (фейковых) данных.
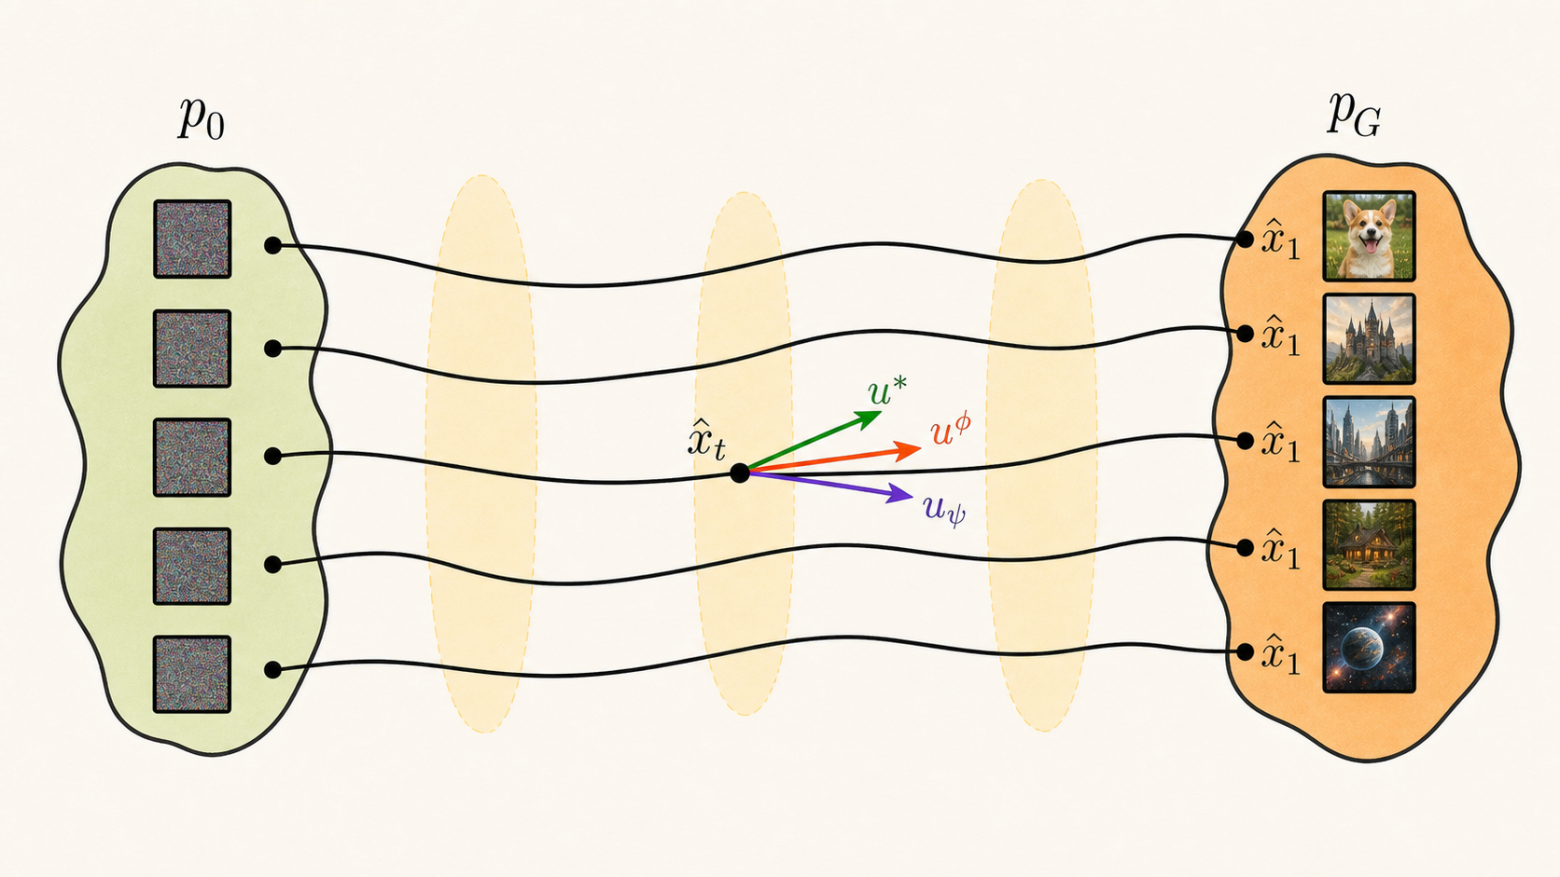
💡 Здесь важно не перепутать три разных поля:

— это фиксированное поле учителя, полученное из настоящих данных (мы выучили его заранее с помощью Flow Matching-лосса);

— истинное условное среднее поле траекторий генератора (его невозможно вычислить, потому что нам нужно посчитать матож по бесконечному числу семплов);

— обучаемая фейк-модель, которая приближает  .
Выпишем отдельно текущие обозначения. К ним можно будет возвращаться при необходимости 😇
|
Обозначение |
Смысл |
|---|---|
|
|
шум в пространстве данных, |
|
|
настоящий объект из данных, |
|
|
промежуточная точка между |
|
|
поле реальных данных или поле учителя, предобученное с помощью Flow Matching’а ( |
|
|
латентный шум генератора, |
|
|
объект, сгенерированный одношаговым генератором |
|
|
промежуточная точка между |
|
|
истинное среднее поле траекторий генератора (матож, который нельзя просто получить) |
|
|
вспомогательная фейк-модель, приближающая |

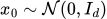


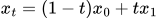


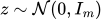


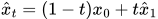


Теперь возникает идея: если  приближает поле генератора — можно сравнивать его с полем учителя
 . То есть мы хотим, чтобы поле генератора стало ближе к полю учителя. Поэтому генератор должен менять свои выходы так, чтобы траектории от
 к
 имели такое же среднее поле скоростей, как у учителя.
Тут и появляется игра  и
 — первый учит поле, созданное вторым, а второй меняется в зависимости от того, что выучил первый. Можно записать игру между генератором
 и вспомогательным полем
 :

То есть сначала фейк-модель  максимизирует значение внутри, и как только получается оптимум, мы делаем небольшой шаг оптимизации по
 . То есть
 должен оптимизировать некоторый максимум по
 .
Мы видим, что в новой игре  также учится по лоссу Flow Matching’а на сгенерированных данных:
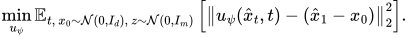
Потому что первый аргумент не зависит от  и
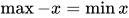 .
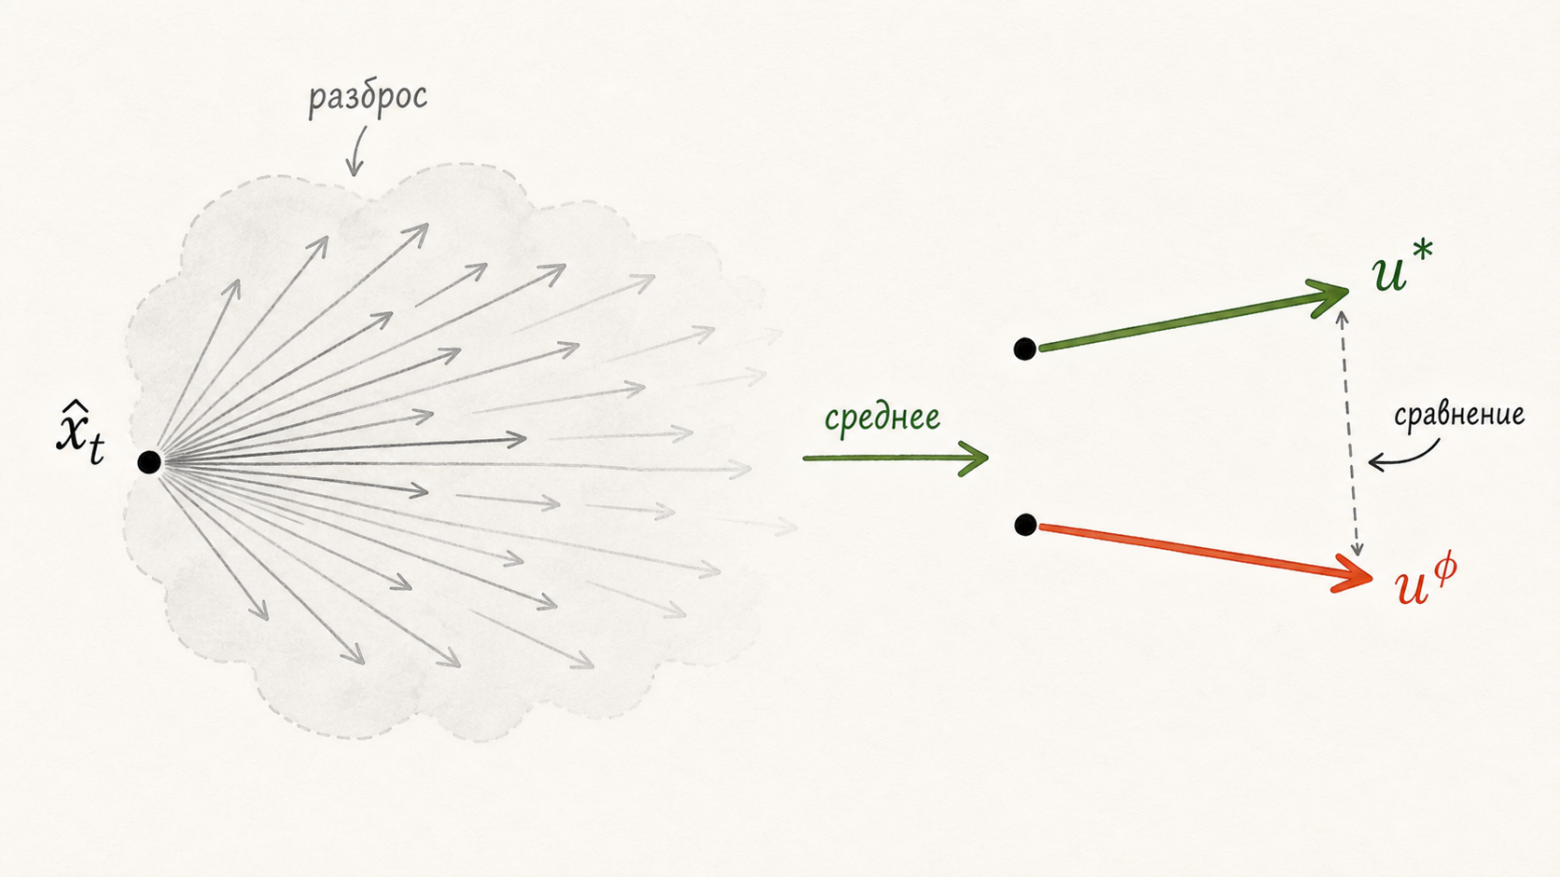
В полученной игре первое слагаемое сравнивает текущую скорость траектории генератора с полем учителя  . Второе слагаемое вычитает ошибку лучшего поля, которое может быть выучено на траекториях самого генератора.
Интуитивно это убирает из лосса ту часть ошибки, которая связана с разбросом скорости из разных траекторий, и оставляет различие между средним полем генератора и учителя. Давайте узнаем, почему это так — см. следующие два скрытых блока.
Сравнение минимаксной целью средних полей
Если вспомогательная фейк-модель  идеально выучила поле генератора — минимаксная цель действительно превращается в «выучивание»:
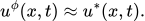
Зафиксируем точку  и время
 . Обозначим скорость траектории генератора через:

Тогда поле генератора — условное среднее этой скорости:
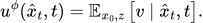
Для любого вектора  верно стандартное разложение MSE (мы уже делали это, когда показывали, почему при использовании MSE мы выучиваем условное среднее):
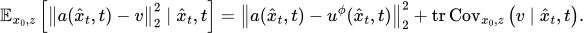
Теперь подставим вместо  поле учителя
 :
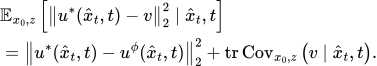
А теперь — вместо  идеальное вспомогательное поле. Если
 обучено идеально:

Поэтому:
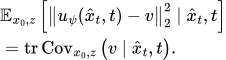
Вычтем второе равенство из первого. Дисперсионные члены сократятся:
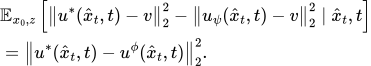
Теперь возьмём ожидание по всем  ,
 и
 . Получим:
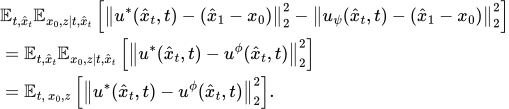
Поэтому такая разность двух MSE-ошибок является удобным способом обучать генератор. Она заставляет каждую отдельную скорость  совпадать не
 , а условные средние поля:
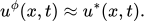
Это важно: отдельные траектории генератора могут быть разными, но их средний поток должен совпадать с потоком учителя.
Линеаризация
Теперь покажем другой способ получить тот же минимаксный лосс. Этот вывод основан на приёме линеаризации (linearization trick), который используется в нашей статье RealUID.
Напомним, что идеальная цель дистилляции состоит в согласовании двух средних полей:

Где:
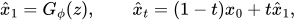
А поле генератора равно:
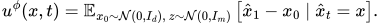
Проблема в том, что здесь стоит разность с условным математическим ожиданием  . Напрямую считать и дифференцировать такое выражение нельзя — нужно бесконечное число раз семплировать.
Запишем разность полей в другой форме. Так как  при фиксированных
 и
 является константой, имеем:
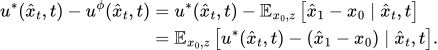
Обозначим:

Тогда разность средних полей можно записать как:
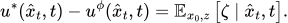
Значит, внутри идеальной цели стоит выражение вида:

Теперь используем простое тождество (приём линеаризации):
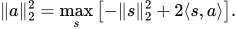
Максимум достигается при  , поэтому и слева, и справа производная по
 равна
 (
 для выражения справа). Равенство значений и производных по
 показывают, что мы можем эквивалентно подставлять выражение справа вместо выражения слева при подсчете градиентов.
Применим это тождество к:
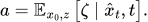
Тогда:
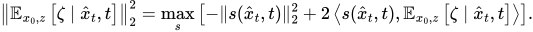
Так как  зависит только от
 и
 , его можно внести внутрь условного ожидания:

Теперь в выражении больше нет нормы от условного математического ожидания. Мы заменили её на максимум по вспомогательной функции  , а внутри ожидания осталось линейное выражение по
 . Именно поэтому этот шаг называется приёмом линеаризации.
Параметризуем вспомогательную функцию через дополнительную нейросеть  :
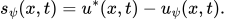
Тогда в оптимуме  должен приближать:

Значит,  должен приближать поле генератора
 .
Подставим:
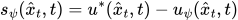
И:

В максимизируемое выражение. Получаем:
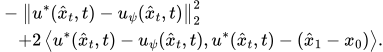
Это выражение можно упростить алгеброй. Для краткости обозначим:
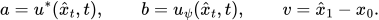
Тогда:
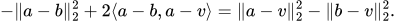
Возвращаемся к исходным обозначениям, получаем:
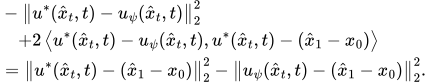
В итоге вместо:

Получаем минимаксную задачу:
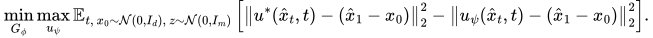
Это и есть удобный лосс дистилляции. Он эквивалентен согласованию средних полей, но при этом записан через обычные MSE-ошибки к конкретной скорости

Роль  следующая: он выучивает среднее поле текущего генератора. После этого генератор меняется так, чтобы оно приблизилось к полю учителя
 .

Алгоритм обучения
Теперь соберём всё в практический алгоритм обучения.
У нас есть три модели:
-
Предобученное поле учителя
 , полученное обычным Flow Matching’ом;
-
Одношаговый генератор
 , который мы хотим обучить;
-
Вспомогательное поле
 , которое приближает среднее поле текущего генератора.
Шаг 1: обновляем вспомогательное поле
Здесь мы хотим обновлять только параметры  . Генератор
 используется только для получения текущих сгенерированных объектов, но сам генератор на этом шаге не обновляется.
Семплируем:
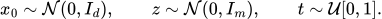
Затем строим:

Скорость прямой траектории генератора равна:

Теперь обучаем  предсказывать эту скорость:
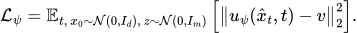
Это MSE-регрессия. Поэтому при достаточно хорошем обучении фейк-модель  приближает условное среднее поле генератора:

Делаем такие шаги обновления несколько раз.
Шаг 2: обновляем генератор
Здесь мы хотим обновлять только параметры генератора  . Поля
 и
 используются как фиксированные функции.
Семплируем:
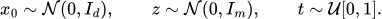
Теперь считаем выход генератора без stop-gradient:
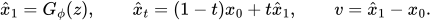
После этого минимизируем лосс генератора:
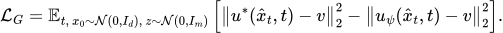
Интуитивно этот шаг меняет генератор так, чтобы среднее поле его траекторий стало ближе к полю учителя  .
Теперь посмотрим на псевдокод (в батчевой форме), чтобы ещё лучше закрепить материал 😎
-
⚙️ Алгоритм: Дистилляция Flow Matching’а в одношаговый генератор
-
Вход: Предобученное поле учителя
 , генератор
 , вспомогательное поле
 , оптимизаторы для
 и
 , количество итераций
 , количество шагов обновления
 на один шаг генератора
 , размер батча

-
Результат: Одношаговый генератор

-
Для
 до

-
Шаг 1: обновляем вспомогательное поле

-
На этом шаге обновляем только

-
Для
 до

-
Семплируем батч:
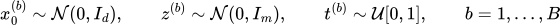
-
Считаем выход генератора со stop-gradient:
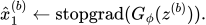
-
Строим промежуточные точки:
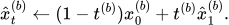
-
Целевые скорости:
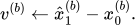
-
Считаем средний лосс для
 по батчу:
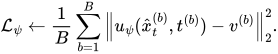
-
Обновляем
 шагом оптимизатора по

-
-
Шаг 2: обновляем генератор

-
На этом шаге обновляем только
 Поля
 и
 используются как фиксированные функции Важно: не используем
torch.no_grad()для и
 или
.detach()для .
-
Семплируем батч:
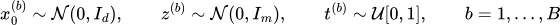
-
Считаем выход генератора без stop-gradient:
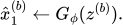
-
Строим промежуточные точки:

-
Целевые скорости текущих траекторий генератора:
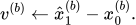
-
Считаем средний лосс генератора по батчу:
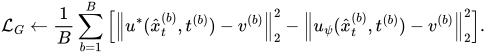
-
Обновляем
 шагом оптимизатора по

-
После обучения для генерации больше не нужны ни поле учителя  , ни вспомогательное поле
 . Мы просто семплируем латентный шум:
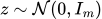
И один раз применяем генератор:

Так многошаговая Flow Matching-генерация заменяется одним шагом.
Следующий скрытый блок — подробный практический алгоритм дистилляции.
Обучение на практике
Рассмотрим нюансы при обучении.
Поле учителя  во время дистилляции не обучается. Оно уже знает, как правильно переносить шум в распределение данных. Поэтому мы один раз переводим его в режим
eval и замораживаем параметры для скорости:
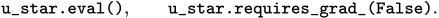
Однако здесь есть важная тонкость. Заморозить параметры модели — не то же самое, что запретить градиент через её вход. При обновлении генератора параметры  не должны меняться, но градиент должен проходить через значение
 к точке
 , потому что
 зависит от выхода генератора
 .
Поэтому при обновлении генератора нельзя считать  внутри
torch.no_grad() и применять .detach()для  .
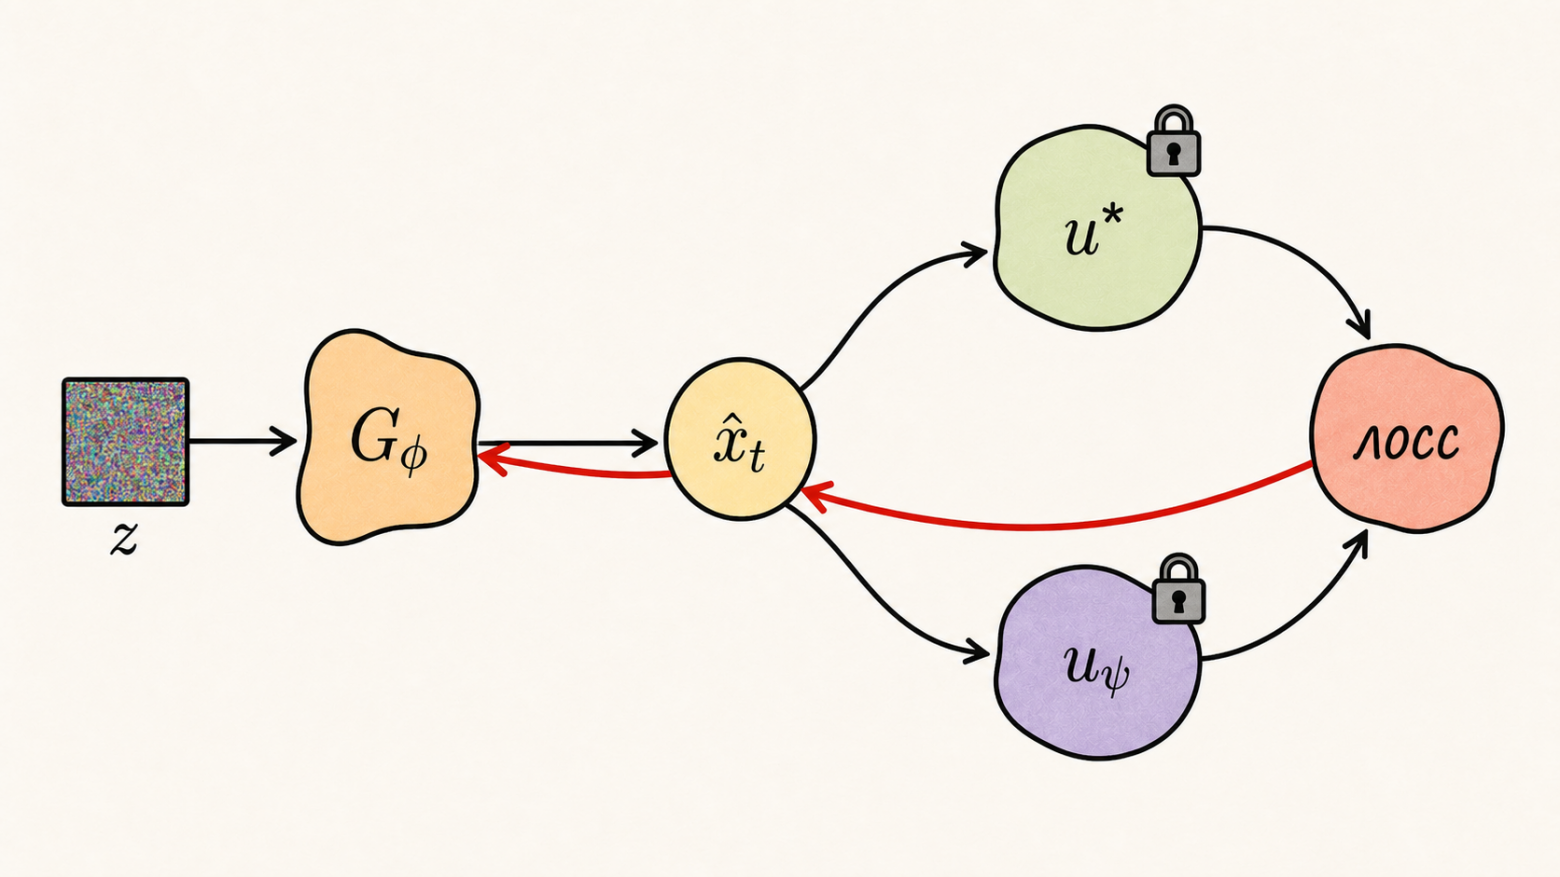
💡 Частая ошибка: при обновлении генератора нельзя использовать torch.no_grad() для вычисления  и
 или применять
.detach()для  . Параметры этих моделей заморожены, но градиент должен проходить через их вход
 к генератору
 .
В практическом коде величины ниже обычно являются батчами. Например, для изображений  ,
 ,
 и
 имеют форму
 , а время
 удобно хранить в форме
 , чтобы оно автоматически broadcast’илось по каналам и пикселям.
Ещё раз приведем алгоритм обучения, но с более подробным техническим описанием.
Шаг 1: обновляем вспомогательное поле
Здесь мы хотим обновлять параметры  . Генератор
 используется только для получения текущих сгенерированных объектов, но сам генератор на этом шаге не обновляется.
Поэтому:
-
 переводим в режим
trainи разрешаем градиенты по его параметрам; -
 переводим в режим
evalи замораживаем параметры; -
выход генератора
 считаем со stop-gradient, например, через
torch.no_grad()или.detach(); -
 на этом шаге не используем.
Семплируем:
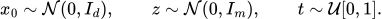
Затем строим:

Скорость прямой траектории генератора равна:

Теперь обучаем  предсказывать скорость:
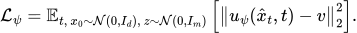
Это обычная MSE-регрессия. Поэтому при достаточно хорошем обучении  приближает условное среднее поле генератора:
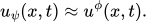
Шаг 2: обновляем генератор
Здесь мы хотим обновлять только параметры генератора  . Поля
 и
 используются как фиксированные функции.
Поэтому:
-
 переводим в режим
trainи разрешаем градиенты по его параметрам; -
 оставляем в режиме
evalс замороженными параметрами; -
 переводим в режим
evalи замораживаем его параметры; -
не используем
torch.no_grad()вокруг и
 ;
-
не делаем
 ;
-
проводим градиент через
 ,
 ,
 ,
 и далее в параметры
 .
Семплируем:

Теперь считаем выход генератора без stop-gradient:
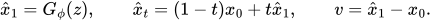
После этого минимизируем лосс генератора:
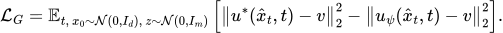
Интуитивно этот шаг меняет генератор так, чтобы среднее поле его траекторий стало ближе к полю учителя  .
-
⚙️ Алгоритм: Дистилляция Flow Matching’а в одношаговый генератор
-
Вход: Предобученное поле учителя
 , генератор
 , вспомогательное поле
 , оптимизаторы для
 и
 , количество итераций
 , количество шагов обновления
 на один шаг генератора
 , размер батча

-
Результат: Одношаговый генератор

-
Переводим
 в режим
evalЗамораживаем параметры
 :
requires_grad_(False) -
Для
 до

-
Шаг 1: обновляем вспомогательное поле

-
На этом шаге обновляем только
 Переводим
 в режим
trainРазрешаем градиенты для
 :
requires_grad_(True)Переводим
 в режим
evalЗамораживаем параметры
 :
requires_grad_(False) -
Для
 до

-
Семплируем батч:

-
Считаем выход генератора со stop-gradient:

-
Строим промежуточные точки:
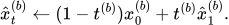
-
Целевые скорости:
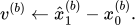
-
Считаем средний лосс для
 по батчу:
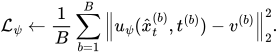
-
Обновляем
 шагом оптимизатора по

-
-
Шаг 2: обновляем генератор

-
На этом шаге обновляем только
 Поля
 и
 используются как фиксированные функции Важно: не используем
torch.no_grad()для и

-
Переводим
 в режим
trainРазрешаем градиенты для
 :
requires_grad_(True)Переводим в режим
evalЗамораживаем параметры :
requires_grad_(False) остаётся в режиме
evalи с замороженными параметрами -
Семплируем батч:

-
Считаем выход генератора без stop-gradient:
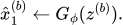
-
Строим промежуточные точки:
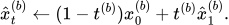
-
Целевые скорости текущих траекторий генератора:
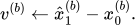
-
Считаем средний лосс генератора по батчу:
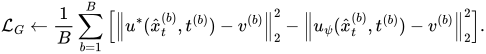
-
Обновляем
 шагом оптимизатора по

-
После обучения для генерации больше не нужны ни поле учителя  , ни вспомогательное поле
 . Мы просто семплируем латентный шум:
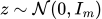
И один раз применяем генератор:

Так, многошаговая Flow Matching-генерация заменяется одним шагом.
Ура, мы на финишной прямой! Мы рассмотрели, что такое Flow Matching и как его дистиллировать. Осталось только обсудить детали обучения и посмотреть на результаты! 😎
Пара деталей
Перечислим несколько деталей, которые важны для стабильного обучения.
Что применимо и для обучения, и для дистилляции Flow Matching’а:
-
EMA
На практике мы не просто учим модель, мы сохраняем EMA-версию и уже используем её.
EMA-версия модели — скользящее среднее по параметрам модели. Из-за того, что обучение происходит нестабильно, мы берём среднее последних весов модели.
Это стандартная практика в связке с Adam/AdamW, которая дат стабильность и сильный прирост к качеству. Для начала можно взять EMA = 0.999-0.9999.
-
Gradient clipping
Ещё одна техника — обрезка значений градиентов. Это заметно улучшает стабильность обучения и является стандартом. Норму градиента для начала можно ограничить единицей.
-
Warmup
lr у моделей можно брать не фиксированным, а начинать с нуля и потихоньку повышать до фиксированного значения, чтобы обучение как разогналось и стабилизировалось.
Warmup можно использовать для обеих моделей и выравнивать число warmup шагов из-за  , чтобы они закончили его одновременно.
Warmup можно поставить, например, на 5000 шагов обучения. У основной модели базовый lr = 2e-4.
-
Dropout
Можно представить, что на каждом шаге обучения мы случайно «выключаем» часть нейронов. Поэтому модель должна решать задачу другим набором нейронов и не привыкать к одному пути вычислений. Это работает как регуляризация и помогает бороться с переобучением.
Позже мы обсудим, почему это может не сработать при оптимизации  .
Dropout для начала можно поставить 0.0-0.2.
-
Реализация U-Net
Модель U-Net (которую мы использовали в статье RealUID) можно взять из torchcfm. В этом репозитории понятный код, есть веса предобученных моделей для разных задач.
Подробнее про U-Net можно почитать тут.
Специфичные детали для дистилляции:
-
Параметризация генератора
Если латентный шум имеет ту же размерность, что и данные, то есть  , генератор удобно параметризовать как
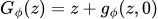 или
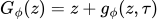 , где
 — нейросеть той же архитектуры, что и поле Flow Matching’а
 , и
 может быть любым. В этом случае
 инициализируем весами предобученной Flow Matching-модели.
Если же  — такая остаточная форма
 уже не подходит напрямую, потому что
 и
 живут в пространствах разной размерности. В этом случае генератор — отображение
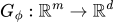 .
-
Инициализация вспомогательного поля
Вспомогательное поле  удобно инициализировать весами предобученного поля учителя
 . В начале обучения генератор ещё «плохой», поэтому такая инициализация может сделать оптимизацию более стабильной.
Генератор также можно инициализировать весами  .
-
Оптимизаторы
Для обеих сетей можно использовать Adam/AdamW. Для вспомогательного поля  часто полезно отключить первый момент, то есть взять Adam с
 . Для генератора
 — применять Adam с
 . Такая настройка используется в минимаксных задачах, где одна модель играет роль критика или вспомогательного поля.
Интуиция следующая:  — momentum, то есть некоторая инерция при оптимизации. И так как внешняя игра очень сильно меняет внутреннюю, то эта инерция будет мешать, то есть модель Flow Matching не успеет за генератором.
Также рекомендуется для начала отключать dropout для вспомогательного поля  — это замедляет обучение модели.
-
Несколько шагов
 на один шаг генератора
На практике полезно делать несколько обновлений  на один шаг генератора. Рабочее соотношение:
 . То есть сначала
 раз обновляем
 , а затем один раз обновляем
 . Это помогает вспомогательному полю лучше отслеживать текущее распределение траекторий генератора.
Также вместе с K можно адаптировать lr у  . Вместе с
 это позволит
 успевать учиться за генератором.
-
Низкая скорость обучения генератора
Стоит ставить lr у генератора поменьше (например, 3e-5), иначе он будет учиться нестабильно из-за сложности лосса.
При этом lr у фейк-модели можно брать как 3e-5, так и 2e-4. Остальные гиперпараметры можно взять стандартные.
-
Заморозка моделей и stop-gradient
Очень важно правильно управлять градиентами. Когда мы обновляем  , генератор
 используется только для получения текущих сгенерированных объектов. Поэтому на этом шаге параметры генератора не обновляются:
G_phi.eval(), G_phi.requires_grad_(False). Выход генератора можно считать со stop-gradient:  .
Например, в PyTorch это можно сделать через torch.no_grad() или .detach(). Когда мы обновляем генератор  , наоборот, параметры
 и
 замораживаются:
u_psi.eval(), u_psi.requires_grad_(False), u_star.eval(), u_star.requires_grad_(False).
Но здесь нельзя использовать torch.no_grad() вокруг  и
 и делать
x_t_hat.detach(). Причина следующая: параметры  и
 не должны обновляться, но градиенту нужно проходить через их вход
 , потому что
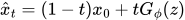 зависит от генератора. Если остановить этот градиент, генератор не получит правильный обучающий сигнал.
-
Постоянная фиксация учителя
Предобученное поле  во время всей дистилляции остаётся в режиме
eval и не обновляется. Оно играет роль фиксированного учителя, который задаёт правильное направление движения от шума к данным.
Результаты обучения
Рассмотрим результаты обучения и дистилляции Flow Matching-модели на датасете CIFAR-10 — картинки размером 32 х 32 пикселя. Всего есть 10 разных классов — самолёты, машины, птицы и др.
Чтобы проверить, насколько дистилляция работает хорошо, мы будем использовать метрику FID (Fréchet Inception Distance) — она сравнивает набор фото с набором сгенерированных картинок. Чем наборы картинок ближе, тем лучше.
FID-метрика
Сначала по каждому изображению  из предобученной нейросети (например, Inception-v3) извлекаются числовые признаки
 . Затем мы смотрим на эти признаки как на семплированные из многомерного нормального распределения. При этом, признаки реальных и сгенерированных картинок семплируются из двух разных нормальных распределений:
 и
 .
Для двух нормальных распределений мы знаем метрику: 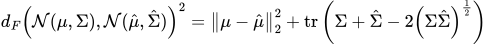 .
Среднее и матрицу ковариаций распределения можно оценить по семплам:  — среднее семплов, матрица ковариации — через
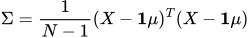 .
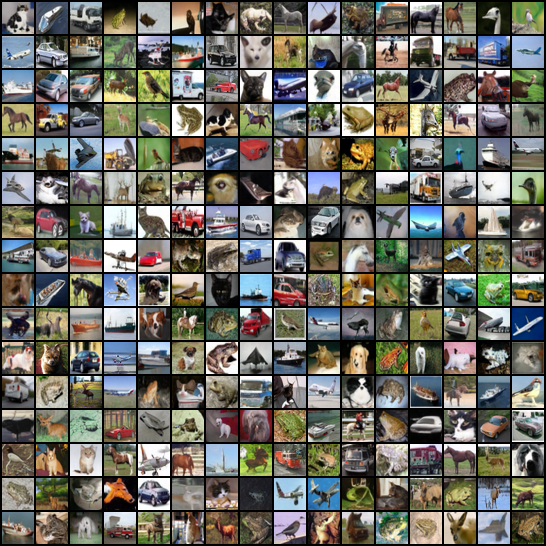
В статье RealUID FID для Flow Matching’а мы получили равным 3.57 на 100 шагах генерации, при этом после дистилляции FID уменьшился до 2.58. То есть мы не только в несколько раз ускоряем генерацию (1 шаг вместо 100), но и улучшаем её качество.
Мы сгенерировали несколько примеров из дистиллированной модели на CIFAR-10, чтобы увидеть результат:
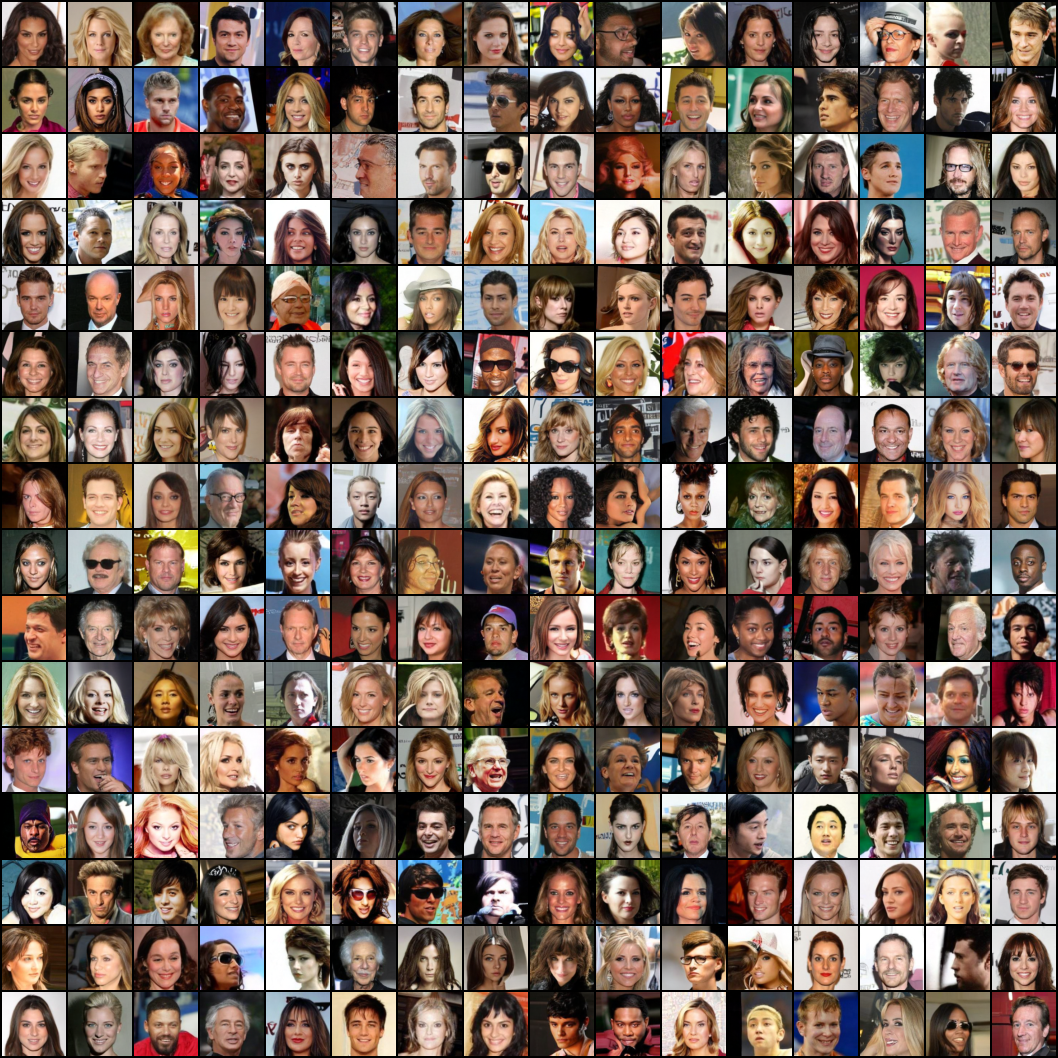
Также приведём примеры генерации лиц на датасете CelebA размером 64 х 64:
Заключение
Итак, в этом статье мы разобрали, как устроен Flow Matching — переход от шума к данным с помощью векторного поля скоростей.
Мы обсудили практический недостаток: генерация требует численного интегрирования — чтобы получить одно изображение, нужно много раз произвести вычисления.
И, наконец, мы рассмотрели идею дистилляции: заменить многошаговую генерацию одним запуском отдельного генератора  , который обучается с помощью
 игры. В итоге мы не только ускорили генерацию, но и улучшили качество картинок.
Полезные ссылки
-
Статья про Flow Matching.
-
Статья про ошибку, которую минимизирует Flow Matching.
-
TorchCFM — реализация Flow Matching’а.
-
GAN как min-max игра.
-
RealUID, code — наша статья про универсальный метод дистилляции с реальными данными + код к ней.
-
Consistency models, FACM, DuMo, MeanFlow, π-Flow, LADD — другие методы дистилляции и генерации в один или несколько шагов.
-
Rectified Flows — иной способ ускорить генерацию Flow Matching’а.
-
Diffusion Meets Flow Matching — пост про связь диффузионных моделей и flow matching’а.
-
DDPM, Score-Based Generative Modeling through Stochastic Differential Equations — про диффузионные модели (сильно связаны с Flow Matching’ом).
-
VAE, LVAE, VDVAE, NCSN, Deep Unsupervised Learning using Nonequilibrium Thermodynamics, Variational Diffusion Models, Latent Diffusion, NFDM — для лучшего понимания диффузионных моделей (три взгляда на них — variational, score и flow).
-
Статья про continuous normalizing flows (может помочь лучше понять Flow Matching).
-
Лекции BayesGroup по continuous normalizing flows и диффузионным моделям.
-
The Annotated Transformer — для лучшего понимания устройства используемых моделей.
-
nn.labml.ai — для понимания реализации различных методов машинного обучения, в том числе — U-Net, Stable Diffusion.
Полезные ссылки на посты DeepSchool
Автор: tixonmavrin

