


Всем привет! На связи Александр Милоградский, отвечаю за R&D в направлении рекомендательных технологий Т-Банка. Расскажу о нашем новом вкладе в open source — библиотеке для нейросетевого ранжирования scikit-rank.
Сейчас scikit-rank — обертка нескольких нейросетевых моделей в формат scikit-learn-моделей, которую мы сделали для удобства адаптации нейросетевых моделей в прикладных задачах и командах. А еще scikit-rank приняли на основную международную конференцию по рекомендательным системам ACM RecSys 2026 в США в Demo track. Но обо всем по порядку. Погнали!
Как мы пришли к scikit-rank
В рекомендательных системах классически пока еще есть две основные фазы. Первая: отобрать сотни-тысячи объектов кандидатов для рекомендаций какой-то легкой моделью. Вторая часть называется ранжированием и часто выполняется с помощью обычного градиентного бустинга (Lightgbm или CatBoost).
В некоторых задачах зачастую RecSys-инженеры только и занимаются обучением градиентных бустингов, что в некотором виде может даже не сильно отличаться от классического ML на табличных данных.
Пару лет назад я узнал про новомодное направление по замене бустингов на нейросети по докладам и постам Кирилла Хрыльченко. Кирилл рассказывал про DCN v2. Звучало очень привлекательно: качество растет при масштабировании по данным, можно более гибко моделировать признаки через эмбеддинги и даже в каких-то реальных тестах DCN v2 выигрывало градиентный бустинг.
Мы попробовали в одной прикладной RecSys-задаче воспроизвести DCN v2 и протестировать ее против продакшен-алгоритма, но на имплементацию понадобилось много времени. В первом A/B-тесте мы проиграли продовой модели, что нас немного обескуражило. Подсобравшись, во второй раз мы добавили дополнительные признаки в виде векторных представлений и получили серый тест. На этом наша вера закончилась, и мы вернулись к другим продуктовым задачам.
Позже у меня неоднократно возникало желание попробовать нейросетевые модели ранжирования как для прикладных задач, так и для соревнований. Задача на интеграцию нейромодели была для меня из разряда «high effort, low confidence, questionable impact». Много усилий уходило, чтобы переписать процессинг численных фичей, обработку категориальных фичей, цикл обучения нейросети, инференс самой модели. Обычно это все надо было делать с нуля при уже работающем пайплайне с градиентным бустингом, где многое из этого делается под капотом метода fit.
Низкая уверенность в успехе нейросетевых моделей была связана с тем, что их внедрение требует больше вложений разработку и эксперименты, чем использование классических подходов на основе бустингов. При этом алгоритмы градиентного бустинга предоставляют гибкую и удобную обработку числовых и категориальных признаков, поэтому часто становятся естественным подходом первого выбора.
К тому же был собственный опыт и данные от других коллег, что у них ничего не получилось. А соревнования по RecSys стабильно продолжали выигрываться через CatBoost. Отсюда же и вытекала неуверенность в потенциальном улучшении от внедрения нейросетевой модели. Ситуация осложнялась тем, что хороший гайдлайн по внедрению нейроранкеров найти сложно, большую часть можно было почерпнуть только из докладов или небольшого числа статей.
Чтобы побороть эти проблемы, мы вновь инвестировали время в исследования и провели масштабный анализ существующих решений, опыта других команд. На первых итерациях результаты оставались неудовлетворительными, но постепенная работа с обработкой признаков, функциями потерь и алгоритмами для обучения позволила найти эффективные схемы. В последующих экспериментах нейроранкеры показали хорошие результаты и во многих проектах превзошли первоначальные ожидания. Дальше возник вопрос: как масштабировать этот опыт на другие команды? Многие из них уже использовали бустинговые решения и накопили значительную кодовую базу вокруг них. Чтобы упростить внедрение нейроранкеров, нам нужен был инструмент, максимально похожий на то, с чем команды уже работали.
Мы пришли к разработке библиотеки scikit-rank со scikit-learn-совместимым интерфейсом и привычными методами fit и predict. Одна из основных задач библиотеки — дать продуктовым командам возможность пробовать нейросетевые модели в существующих пайплайнах с минимальными изменениями кода.
На наш взгляд, наша библиотека может поменять ситуацию с внедрением нейросетевой модели и сделать его «low effort, high confidence, potential impact». Мы верим, что это поможет увеличить adoption нейросетевых моделей для ранжирования в рекомендательных системах в командах, которые не готовы тратить много времени на «попробовать DCN».
Для публикации статьи на международной конференции мы сравнили scikit-rank с другими существующими аналогами: FuxiCTR и DeepCTR.
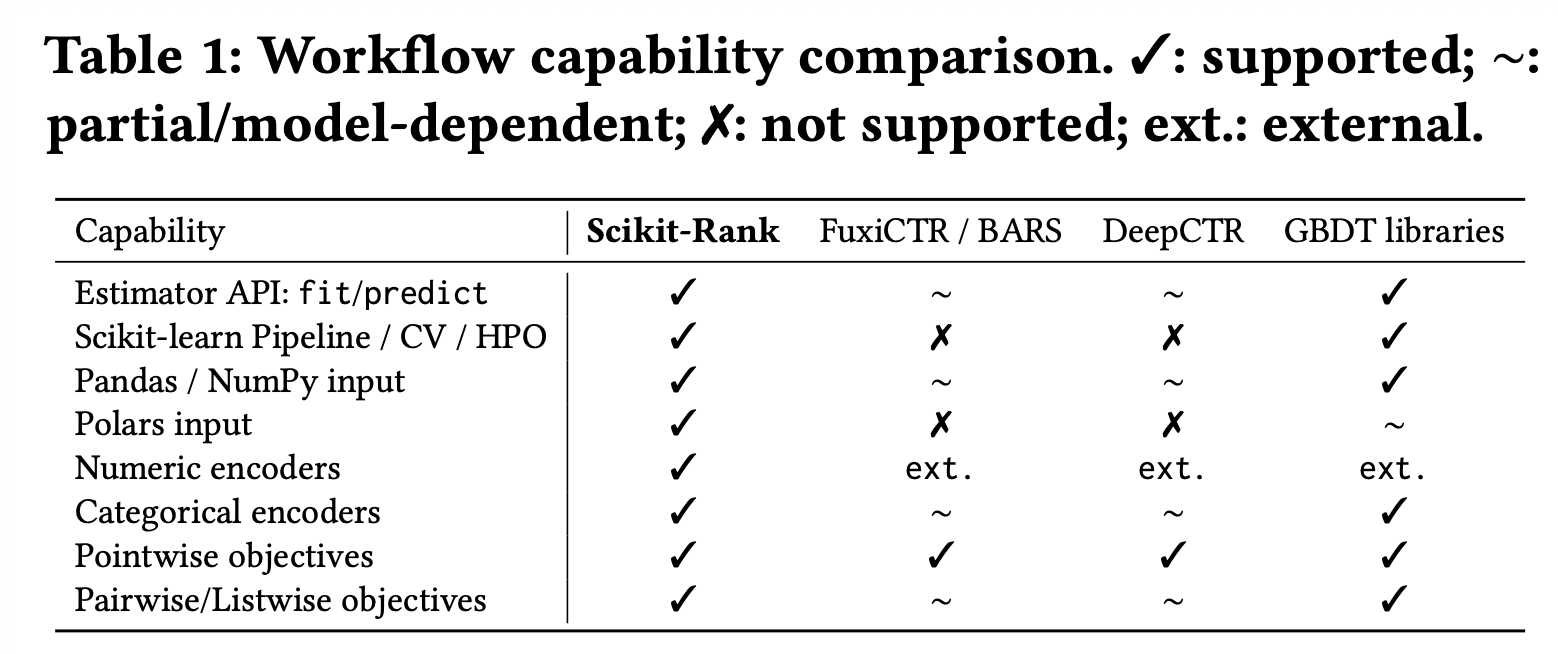
Популярные фреймворки с имплементацией нейросетевых моделей для ранжирования не поддерживают fit/predict-парадигму, не поддерживают polars и преобразование данных для численных и категориальных признаков. Мы решили это исправить и реализовали основный необходимый функционал в своей библиотеке.
Как попробовать scikit-rank
Мы постарались сделать использование scikit-rank максимально простым. Сначала устанавливаем библиотеку, например через pip install scikit-rank. Дальше можно пробовать запускать. Вот пример из README.md для задачи классификации на игрушечном примере:
import polars as pl
from scikit_rank import DCNClassifier

X = pl.DataFrame({"num": [0.1, 1.2, -0.3], "cat": ["a", "b", "a"]})
y = [0, 1, 0]

clf = DCNClassifier(
    hidden_units=[256, 128],
    cross_layers=3,
    epochs=10,
    batch_size=1024,
    num_features=["num"],
    cat_features=["cat"],
    random_state=0,
)
clf.fit(X, y)

proba = clf.predict_proba(X)   # (n_samples, n_classes)
labels = clf.predict(X)
В качестве входных данных можно передать numpy, pandas или polars.
У нас есть реализация DCNRegressor и DCNRanker. Для задачи ранжирования, аналогично моделям градиентного бустинга, необходимо передать группы, внутри которых модель должна учиться ранжировать:
from scikit_rank import DCNRanker

ranker = DCNRanker(
    loss="listwise",
    hidden_units=[256, 128],
    cross_layers=3,
    epochs=10,
    num_features=["num"],
    cat_features=["cat"],
    random_state=0,
)
ranker.fit(train_df, y="click", group="impression_id")
scores = ranker.predict(test_df)   # higher score = ranked higher
В качестве ранжирующих лоссов у нас поддерживаются BPR, LambdaRank, ListMLE, CORAL и другие.
Важно, что для нас архитектура модели вроде DCN v2 или FinalNet и используемый лосс LambdaRank — это просто комбинируемые компоненты ML-модели. И хоть в оригинальной статье про DCN v2 использовался LogLoss, как и пишут авторы, сама по себе DCN v2 «loss-function agnostic». Поэтому в рамках scikit-rank у нас можно комбинировать разные компоненты между собой.
Кроме DCN v2, в нашей библиотеке есть поддержка таких моделей, как FinalNet, FinalMLP, Destine и даже TabM.
Что происходит внутри scikit-rank
Кроме стандартного обучения модели, внутри методов fit/predict заложен процессинг данных. Сначала заполняются пропуски нулями или медианой, а потом опционально может быть выполнена стандартная или квантильная нормализация. Далее могут применяться различные энкодеры.
Собрали пример, чтобы проиллюстрировать основные возможности.
model = DCNRanker(
    num_features=["price", "popularity"],
    normalize_numeric="standard",
    num_encoder="ple:embedding_dim=16",
    ple_n_bins=32,

    cat_features=["category", "device_type"],
    cat_encoder="per_feature",
    embedding_dim=16,

    multihash_features=["user_id", "item_id"],
    multihash_encoder=(
        "multihash:cardinality=100000;n_hashes=2;embedding_dim=16"
    ),
)
Признаки разделяются на численные и категориальные. К численным признакам можно применить нормализацию и некоторые преобразования. Например, num_encoder="ple:embedding_dim=16" применит Piecewise Linear Encoding. Для категориальных признаков можно как выучить обычные эмбеддинги для каждого значения (per_feature), так и сделать multi_hash-представления, которые задаются параметрами cardinality, n_hashes, embedding_dim. Важно, что выбранный энкодер будет применен для всех признаков своего типа.
Дальше запускается стандартный цикл обучения на PyTorch. Модель может обучаться на CPU или GPU с CUDA, а через Hugging Face Accelerate доступны mixed precision, накопление градиентов и распределенное обучение на нескольких GPU. Предсказания также можно считать на GPU — перенос модели и батчей на устройство библиотека берет на себя.
Тестирование scikit-rank на открытых и внутренних данных
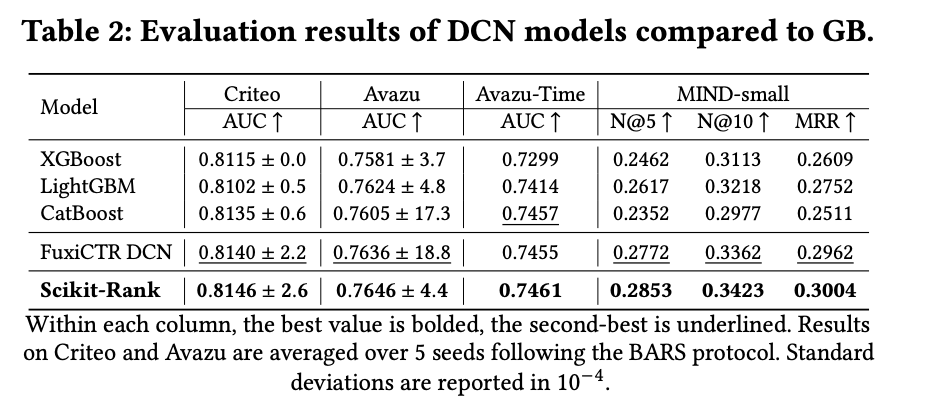
Мы проверили нашу библиотеку на открытых и внутренних данных Т-Банка. На открытых данных эксперименты провели по открытому бенчмарку BARS. В нем сравниваются различные CTR-подходы по метрикам качества.
Сначала мы позапускали градиентные бустинги, а потом протестировали версию DCN из популярного фреймворка FuxiCTR. Результаты показали, что наша реализация воспроизводит качество модели DCN из FuxiCTR, а на MIND-small может даже превосходить ее за счет более гибкой настройки процессинга признаков и лоссов.
Мы проверили библиотеку на трех внутренних задачах и получили приросты по метрикам в районе 3—7% в офлайн-качестве. А один из продуктов успели протестировать в онлайн-тесте против градиентного бустинга и получили такие же +4—7% приростов по бизнес-метрикам.
Заключение
Мы написали scikit-rank, чтобы снизить сложность адаптации нейросетевых моделей ранжирования. Вся логика с препроцессингом, кодированием признаков, обучением модели и построением инференса уже реализована. Пользователю остается только определить ее через параметры.
Мы надеемся, что библиотека будет полезна для инженеров и исследователей, которые давно хотели переехать с пайплайнов на градиентных бустингах на модные нейросети, но пока так и не дошли до этого. Теперь, если у вас есть пайплайны в scikit-learn формате, можно попробовать нейросетевые модели с современной логикой внутри.
Автор: Nemexur

