


Меня зовут Павел, я старший разработчик ML-платформы в Авито и последние полтора года занимаюсь MLOps.
На прошедшей Kuber Conf от АОТ я выступал с докладом про нашу платформу распределённого обучения, а теперь решил сделать на его основе статью для вас. Если вам комфортнее воспринимать такие материалы в формате видео — держите.
Под катом — о становлении нашей ML-платформы, распределённых вычислениях, реализации инфраструктуры и других полезных вещах. И главное — что это нам дало и чем может быть полезно вам.
ML-платформа Авито. Как всё начиналось
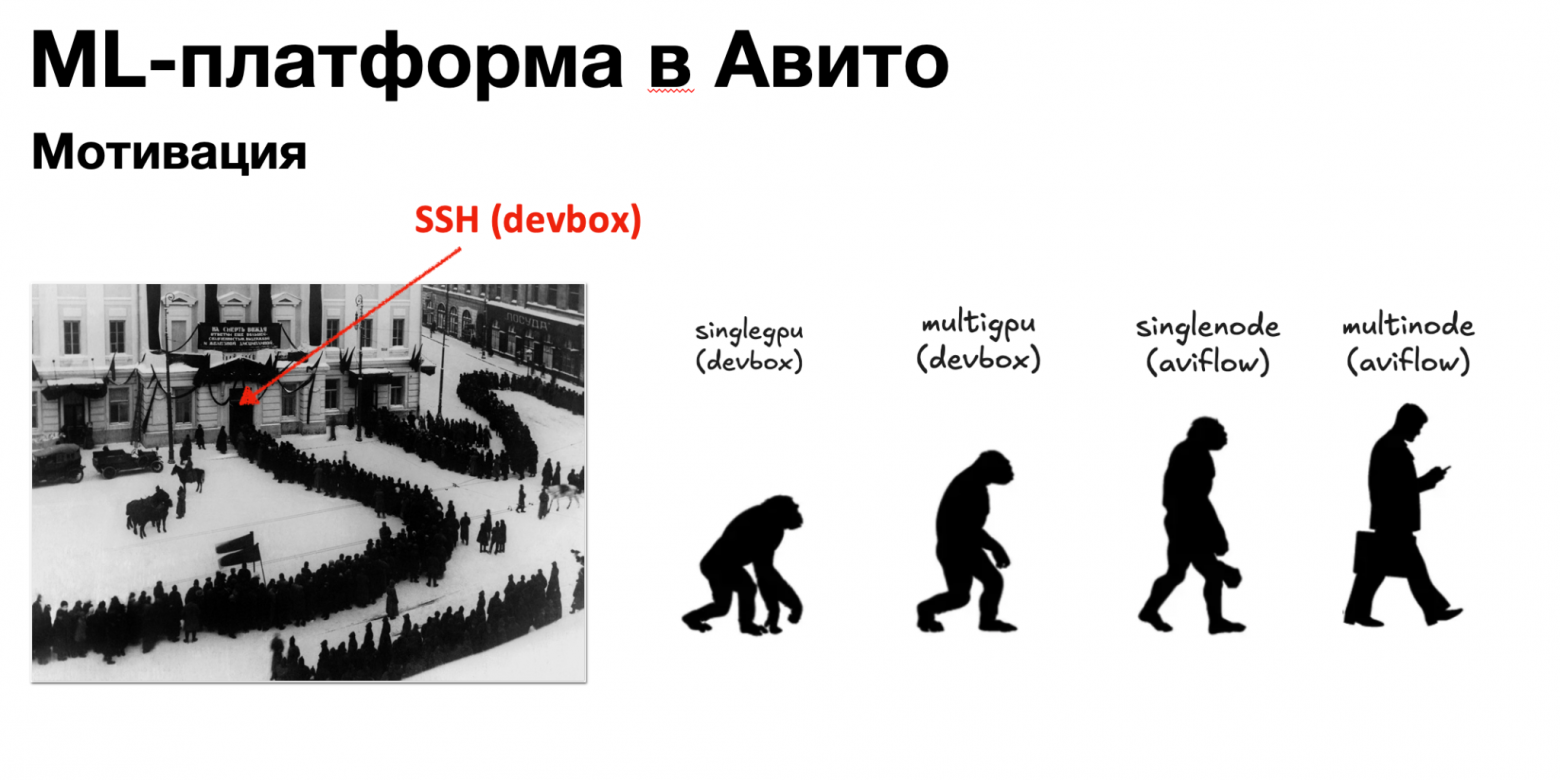
В те времена, когда в Авито работало не так много дата-сайентистов, они использовали разнородные инструменты. Главным из них был так называемый DevBox — выделенная машина, на которую специалист заходил по SSH, делал свои дата-сайентистские дела, обучал модели, собирал датасеты и прочее. Время шло, число спецов росло (равно как и отделов), и мы не придумали ничего лучше, как добавить ко всему этому ещё и LLM. У неё была своя специфика в плане инструментария, и в целом жизнь она не сильно облегчила.
Так началась эволюция нашего пути — от обычного доступа к машинам по SSH, когда коллеги полностью блокировали их и выполняли задачи вручную, до нашей полноценной cloud-native-платформы, которую мы назвали Aviflow.
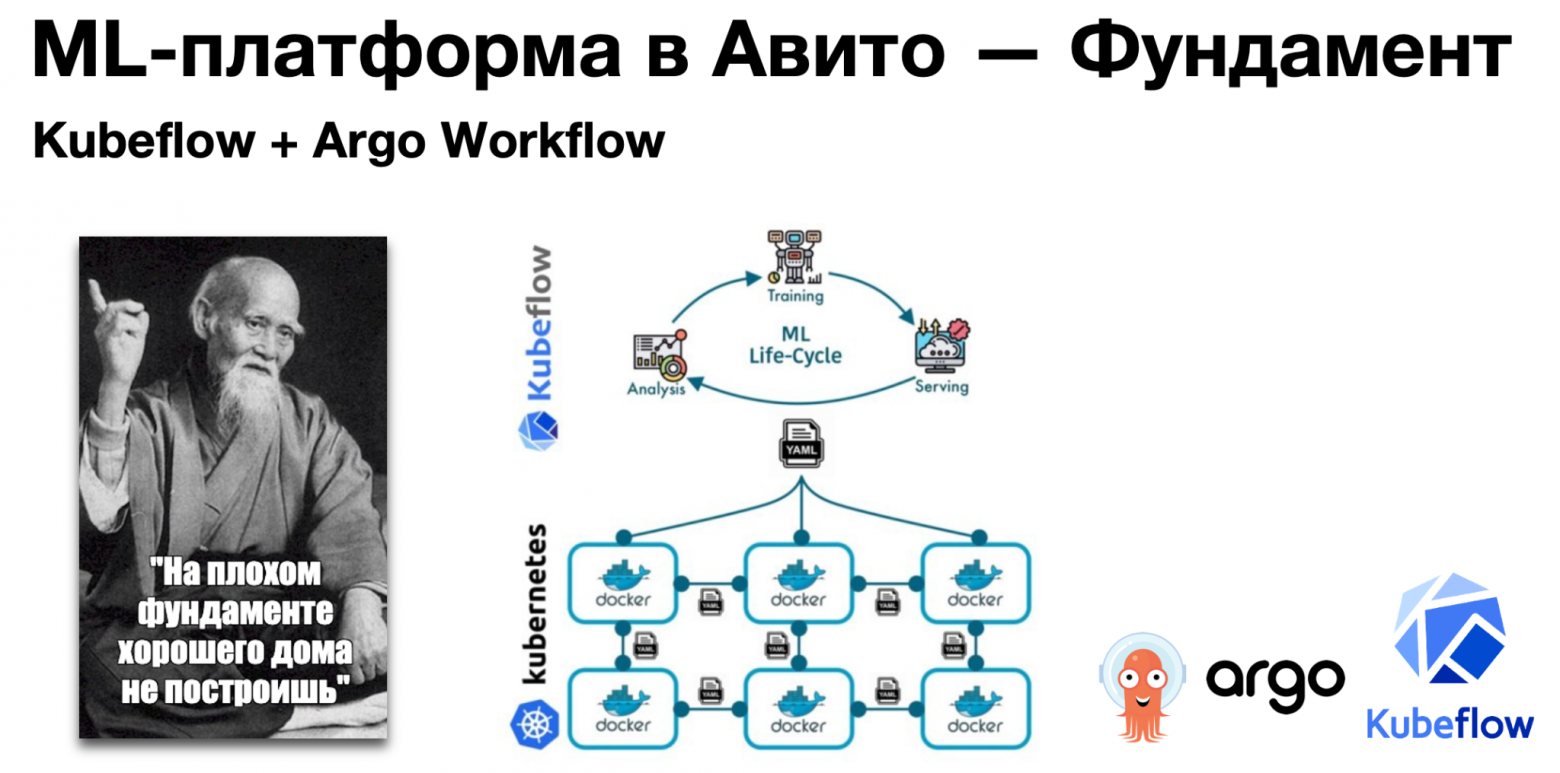
Разрабатывать её мы начали не с нуля — под капотом опенсорс, а именно Kubeflow, платформа, состоящая из множества сервисов и позволяющая зациклить всю разработку дата-сайентиста в одном месте. Тут он может и что-то анализировать, и обучать свои модели, сервить их, нарезать дата-сеты, в общем, всё, что душе угодно. Одна из главных сущностей Kubeflow — пайплайн, запуск, включающий в себя некоторое количество произвольных компонентов (де-факто это код, обёрнутый в контейер). Всем этим делом управляет Argo Workflow, мы выбрали Argo из-за наличия хорошей экспертизы по нему внутри Авито.
В общем, мы прокачали Kubeflow и на его базе получили нашу Aviflow. Кроме очевидных доработок (исправления найденных багов и более быстрого внесения фичей от сообщества) мы интегрировали и свои сервисы — Trisigma, наша A/B-шница, и Vault, а ещё написали свои notebook-и и подключили DWH и IDE. Есть отчёты, куда ж без них. И главное — распределённые вычисления.
Что такое распределённые вычисления и в чём их польза
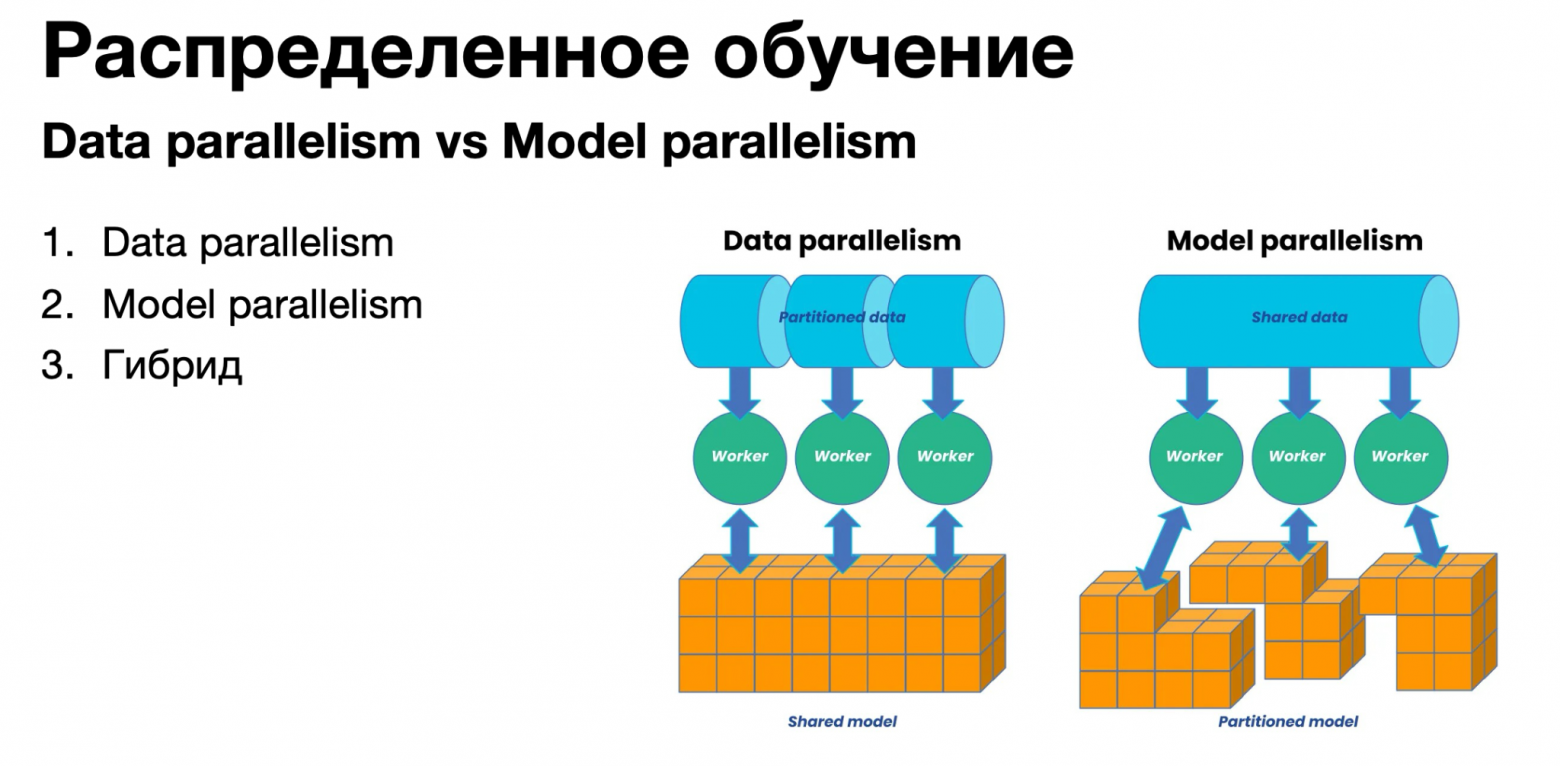
Есть две основных парадигмы вычислений и их гибридные вариации. Если речь идёт о распределённых, то тут кто-то что-то распределяет. В обучении есть данные и модель, и в парадигме распределённых вычислений мы копируем модель на каждый вычислительный узел (далее — воркер). В итоге у каждого воркера находится одинаковая копия модели. Затем мы даём воркерам кусок данных — и во время вычислений воркеры синкуются, чтобы выдать нам итоговую модель с конечными весами.
Ещё есть второй тип — параллелизм модели. Здесь мы оставляем данные и не как константу, а одинаковыми для всех воркеров. Но у каждого воркера при этом уже есть свой кусок модели, а модель — это куда более сложная сущность, нежели дата-сет. Так что можем получить несколько вариаций — например, распределённый градиент, или параметры. А иногда и градиент, и параметры.
Запускаем HPC — узлы, сеть и файловая система
HPC — наш высокопроизводительный вычислитель, своего рода суперкомпьютер.
Тут понадобится небольшая предыстория. Когда мы вообще стартовали всё это в Авито, то встали перед выбором. Либо строим свой HPC сами (нанимаем специалистов, создаём инфраструктуру и прочее), либо просто вливаем бюджет и используем облачные вычисления. Проанализировав все вводные, решили всё же пойти своим путём, для чего надо было сходить в отдел закупок и составить, собственно, список закупок по трём основным направлениям — узлы, сеть и файловая система (распределённая).
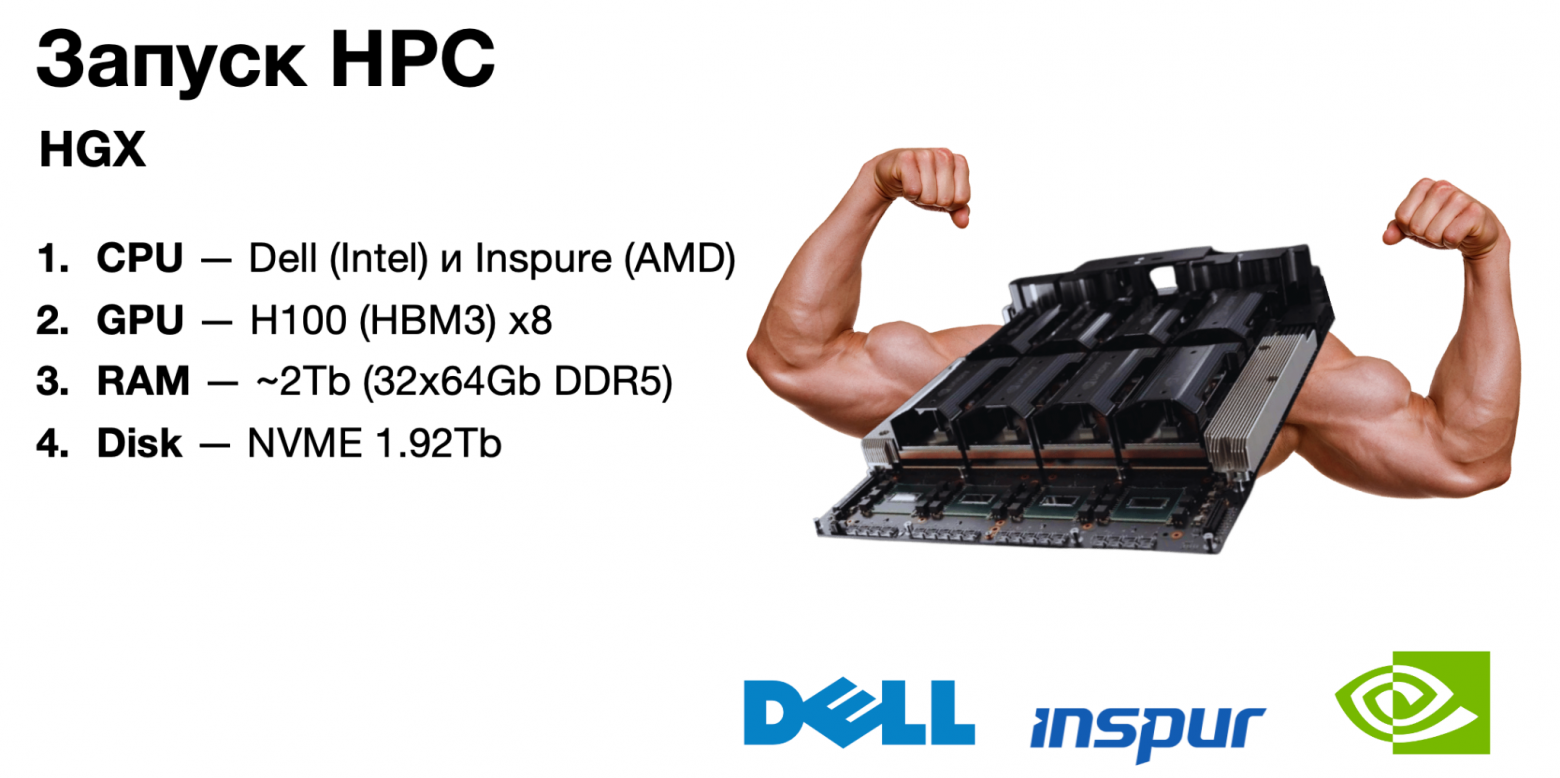
С узлами всё довольно банально — HGX от Dell и Inspur. С сетью поинтереснее — Infini Band вместо Ethernet. Infini Band у нас тут представлен в двух вариациях — высокоскоростной NDR для вычислений и менее скоростной HDR для данных. Оба соединены в одну коробочку, идёт по одному NDR-коннектору и HDR-коннектору на узел. Топология кластера — Fat Tree.
Файловая система — последний компонент нашего HPC. Мы выбрали BeeGFS как довольно хорошее и надёжное решение. Развернуто это все на серверах Lenovo с парой улучшений, мы, задублировали метадата-сервер, чтобы улучшить отказоустойчивость. А ещё задублировали и каждую storage-ноду, в рамках каждой ноды поднятая файловая система zfs, всё обёрнуто с помощью buddy group.
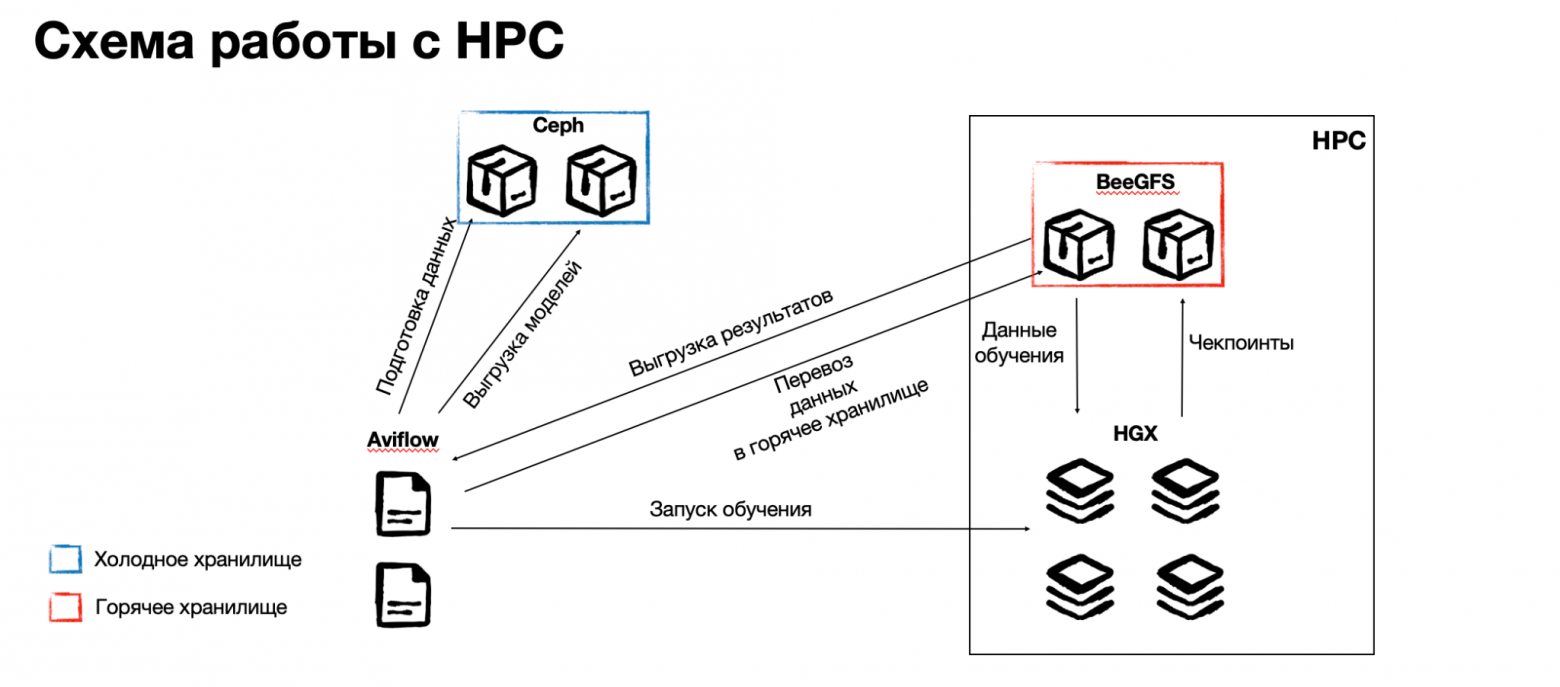
Вот как всё это выглядит для пользователя Aviflow, который хочет обучить LLM.
Ему надо подготовить дата-сет и сложить его в наше холодное хранилище (ceph), затем выгрузить его в BeeGFS (горячее хранилище). И через Aviflow мы запускаем обучение, во время которого узлы HGX получают данные от BeeGFS, пишут на него чекпоинты, а мы уже со стороны Aviflow преносим из BeeGFS те, которые посчитаем нужными для дальнейшего использования.
Для того чтобы всё это стабильно и надёжно работало, нужно правильно выбрать и настроить оркестратор.
Какой взять оркестратор
Мы выбирали между Slurm, K8S и гибридными решениями. Штука в том, что мы изначально наняли специалистов, которые хороши в Slurm и не очень знакомы с K8S. А инженеров по HPC на рынке не так чтобы много, причём большинство из них работают как раз со Slurm.
Отсюда сразу жёсткая вилка — или будем делать стандартное решение HPC на Slurm, или пойдём новым путём и сделаем решение на k8s. К слову, это ложится в картину мира всего Авито, потому что мы ходим внутри компании развивать k8s-экспертизу. Так что решили делать на k8s. Перфоманс-сравнение было почти аналогичным, но конкретно в нашем случае была ещё пара пунктов «За» — наша платформа уже использует k8s, так что всё будет довольно нативно, а ещё k8s — это более современная история, в которой чаще появляется что-то новое, в том числе заточенное под LLM. Нам было это важно, к тому же мы получили возможность из коробки использовать в рамках одного механизма и инференс, и обучение.
Выбираем планировщик
Сразу после выбора кубера мы задались вопросом — а подойдёт ли нам для наших задач стандартный шедуллер? Начали изучать рынок, решения, которые используют другие компании, и написали собственные требования к планировщику.
-
Поддержка Gang Sheduling. У нас распределённая задача — а это несколько узлов. Значит, мы должны или выкатывать задачу полностью, или вообще не выкатывать. Ведь если выкатить наполовину и у нас забьётся кластер, то задача не запустится.
-
Приоритизация. У нас в Авито, как и в большинстве компаний, есть разные контуры с разными зонами ответственности и критичностью — prod / dev / test / эксперименты и прочее. Так что важно, чтобы планировщик умел вытеснять низкоприоритетные нагрузки.
-
Очереди. Хочется, чтобы архитектура выглядела так, чтобы были очереди, которые можно навешивать на команды. Очереди тут являются своего рода агрегатами для ресурсов, доступные в рамках каждой команды. В очередях можно конфигурировать квоты, доступы и другое.
-
Гарантии и шаринг ресурсов. Это нужно для того, чтобы продовые нагрузки работали на все 100% и их никогда не вытесняли. Тут мы прописываем команде чёткую гарантию — «Вы используете 10 GPU, не больше и не меньше». Тут же про шаринг ресурсов — если одна команда каким-то образом использовала свои капасити, а вторая — нет, то можно взять их из второй команды и докинуть в первую. Что, к слову, улучшает утилизацию всего кластера. Но тут важен механизм вытеснения, чтобы не получилось, что при нарушении гарантий другой командой ваша нагрузка была вытеснена.
В общем, такие четыре требования. Мы рассматривали параллельно три планировщика — Kueue, YuniKorn и Volcano. Планировщик из коробки мы сразу вычеркнули из списка, так как он не подходил под требования.
Что с этими тремя. Volcano — решение от HUAWEI, Kueue и YuniKorn — больше коммьюнити-решения. Мы накатили каждый из них на свои сервера и проанализировали, как всё работает и есть ли сложности с интеграциями. В итоге остановились на Kueue, он показался нам самым простым и подходил под наши задачи. Единственный минус — это довольно свежий опенсорс со своими детскими болезнями: были баги, какие-то коммиты приходилось довносить руками, в общем, классика.
Менеджер задач: Kubeflow Training Operator
Итак, планировщик есть, дело за менеджером, который будет управлять задачами, упаковывать их в CRD и взаимодействовать с ними.
Первый вариант — Kubeflow Training Operator, нативная интеграция. Хоть и не является частью самой платформы Kubeflow, но это тоже детище её создателей. Так что сразу плюс — простота интеграции.
Ещё рассматривали Ray, это более более сложный инструмент, который может в себе содержать куда больше, чем просто запуск обучения. Этот менеджер сам задаёт свой Ray-кластер со своими хэд-нодами. Можно запускать инференсы, обучение, да, но в целом всё довольно громоздко.
Так что выбрали Kubeflow Training Operator. И полностью подходит, и простой.
Как у нас всё работает
Для запуска нагрузки есть четыре типа ресурсов:
-
TrainJob — обертка JobSet от Kubeflow Training Operator с адаптированным интерфейсом
-
JobSet — абстракция над множествами Job
-
Job — обычные джобы из kubernetes
-
Pod — сам воркер, на котором и будет вычисляться нагрузка.
Job — агрегат для наших подов. JobSet — агрегат для Job. Полезен при желании инициализировать какую-то модель, возможно, сделать простенькую предобработку, которую не хочется выносить в большой громоздкий пайплайн. То же касается и предобработки экспорта результата — можно задать несколько джоб, и связи между ними, допустим, что какая-то джоба должна выполниться после другой. Также JobSet позволяет конфигурировать сами джобы и предоставляет для этого интерфейс.
Создатели Kubeflow прописали TrainJob таким образом, что это де-факто обёртка над JobSet. Чтобы вам было не так просто использовать только его, разработчики пошли на это для разделения конфигурации на две части. Первую задаёт пользователь (TrainJob), а вот основную конфигурацию с основными параметрами, содержащими большое количество информации, они вынесли в так называемые рантаймы — TrainingRuntime (ресурс с неймспейсом) и ClusterTrainingRuntime (кластерный ресурс). Оба содержат конфигурацию JobSet-а, но имеют разный скоп (кластер, нейсмпейс), а пользователь задаёт какие-то более точечные параметры, например, значения переменных окружения, тег образа и прочее.
Разработчики внедряют в Kubeflow Training Operator новые концепции, например, доообучение, что тоже полезно при работе с LLM.
Сбор и доставка образов
Обучение LLM — дело непростое, и образы тут немаленькие. Наш образ вполне может весить несколько десятков гигабайт, так что важно уметь их быстро доставлять и разворачивать, чтобы запуск новых экспериментов не останавливался долгой инициализацией.
Для сборки мы используем TeamCity, в котором провели ряд оптимизаций.
Прежде всего — оптимизация самого развёртывания. Мы использовали Nydus и параллельное разархивирование pigz. Когда мы только скачиваем образ, мы уже начинаем его накатывать на наш контейнер, это всё происходит одновременно.
Кроме этого, оптимизировали и скачивание с помощью DragonFly OSS, что позволило нам реализовать p2p-скачивание. Информация об образах у нас хранится на самих узлах, и образы по p2p доставляются на нужный узел.
Инфраструктура GPU, сети и observability
В процессе распределённого обучения у нас используется GPU и Network Operator. Мы их не столько дорабатывали, сколько настроили. Они нужны для доставки и конфигурации драйверов, благодаря им можно не привязывать к узлу конкретные версии драйверов, а использовать разные.
Для работы с хранилищем используем CSI-драйвер (как для BeeGFS, так и для Ceph). Для BeeGFS, кстати, он доступен в двух вариациях: как удалённое подключение и как подключение через RDMA. Есть пара вебхуков — посредством Kyverno мы конфигурируем NDR И устанавливаем ulimit.
А вот какие у команды HPС есть инструменты observability, что всё это мониторить. DSGM exporter, классика жанра для отслеживания состояния GPU. United Fabric Manager для отслеживания Infini Band. Все остальные метрики мы смотрим через Node exporter.
Архитектура кластера
Этот вопрос разделил команду на два лагеря. Можно было решить задачу вот как.
-
Сделать основной кластер платформы Avifow, в который сразу установить HGX-тачки.
-
Сделать отдельные кластеры, которые отдельно и конфигурировать, чтобы они не задевали друг друга. Но при этом нельзя будет переиспользовать конфигурации, придётся дублировать.
Пока ещё к какому-то фиксированному решению мы не пришли, и на данный момент для более быстрого запуска побудем в одном кластере, чтобы переиспользовать архитектуру уже имеющегося Aviflow. А вот как целевое решение — пока прорабатываем возможность выноса в отдельный кластер, это куда безопаснее с точки зрения разработки (у нас были случаи, когда конфигурирование HPC уже задевало обычные машины).
Какие нам встретились проблемы
Куда же в рассказе про создание платформы без граблей. Вот парочка из них.
Как я писал выше, мы используем два типа Infini Band — NDR и HDR. Если это никак не учесть в Network Operator, то у нас может NDR-ная нагрузка пойти на HDR. Или наоборот. Чего не очень хочется. Так что тут надо конкретно прибивать deviceID в манифесте, чтобы трафик точно шёл по нужным интерфейсам.
apiVersion: sriovnetwork.openshift.io/v1
kind: SriovNetworkNodePolicy
...
spec:
  deviceType: netdevice
  externallyManaged: false
  isRdma: true
  linkType: ib
  nicSelector:
      deviceID: ‘1021’ #тут
      vendor: 15b3
А вот проблема, с которой мы посидели подольше.
Мы используем GPU- и network-операторы, но внутри них используются образы, собранные под ОС, отличную от используемой у нас. В Авито стандарт — это Debian, а вот производитель видеокарт использует Ubuntu и Red Hat. Так что нам пришлось вручную переделывать ряд docker-файлов и переписывать некоторые скрипты. Да, не самая сложная задача, но всё равно вручную это было делать не очень весело.
И последняя проблема, которую мы поймали во время активной эксплуатации нашего кластера. GPU Operator умеет определять ошибки на GPU, так называемые XID, и убирать карты из выдачи, делая их недоступными через device-plugin.
Сначала мы подумали, что это хорошее решение — оно позволит нам автоматически не выдавать сломанные карточки. Но выяснилось, что мы так реагируем на любые возникающие ошибки, включая случаи, когда пользователь сам не прав. Так что мы отключили этот механизм, а вместо него ввели свои белые списки для подобных ошибок. И уже статистическими методами анализируем, что мы считаем ошибкой, а что всё же нет. И если что-то считается именно ошибкой железа — карточка убирается.
Aviflow глазами пользователя
В нашу платформу распределённых вычислений есть три точки входа.
Первая — пайплайны Kubeflow, основная сущность, позволяющая запускать персистентные раны. Тут мы сделали свой компонент, который позволяет запускать всё точно так же, как и для менее специализированного обучения.
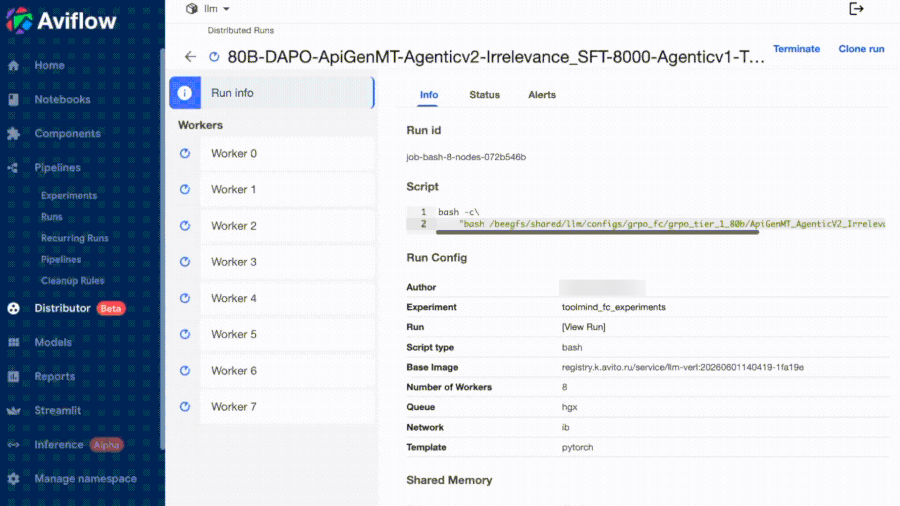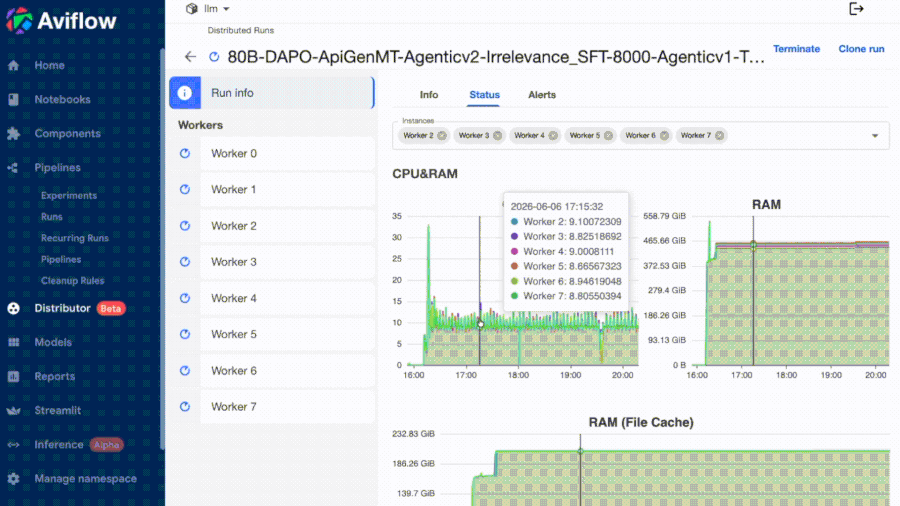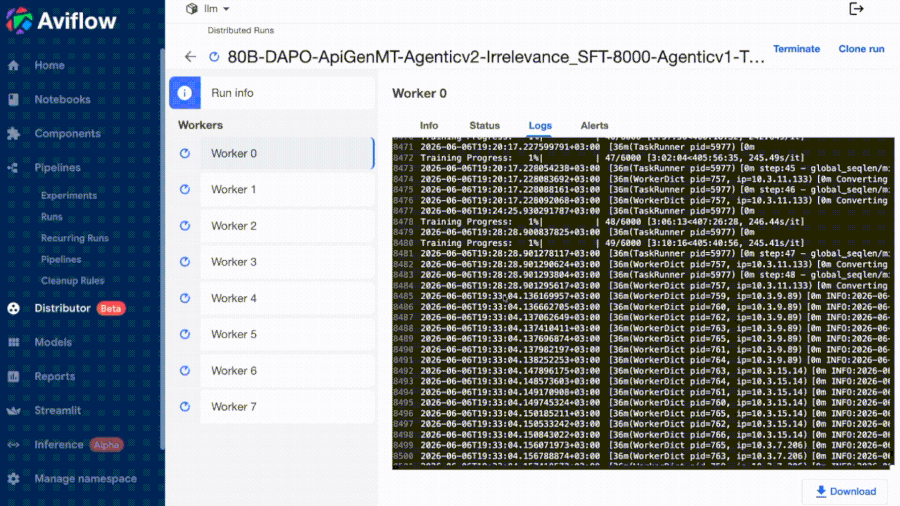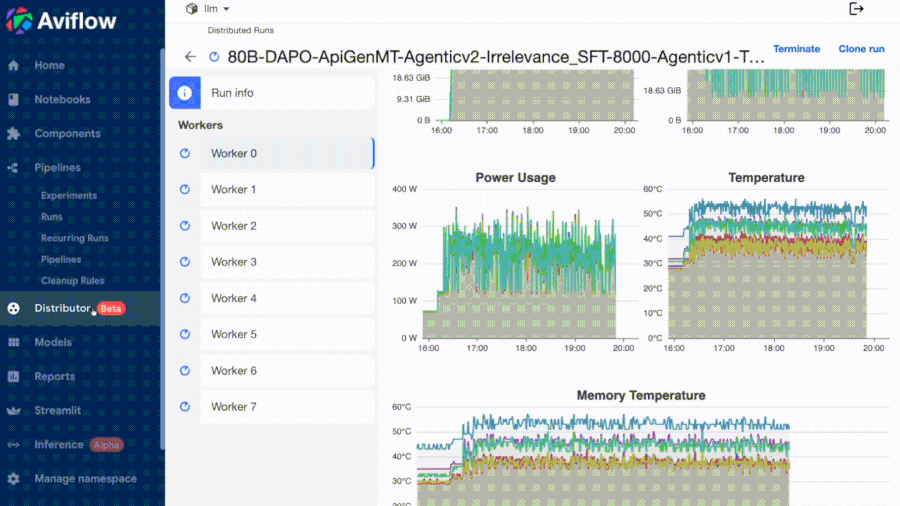
Вторая — отдельный сервис. Мы сделали его, чтобы дать пользователю новый UI и некоторые дополнительные возможности, не заложенные в пайплайнах (расширить observability для таких нагрузок, улучшить инструменты отладки и прочее).
Третья — дополнительно для наших notebook-ов написали SDK.
Вот кубики, составляющие пайплайн, с помощью изображённого графа они выполняются последовательно. Один из кубиков — наш распределённый компонент. Каждый кубик — не отдельный pod, их может быть несколько. Тут же на скрине вы видите и тот самый отдельный сервис из второго пункта (список задач с их данными).
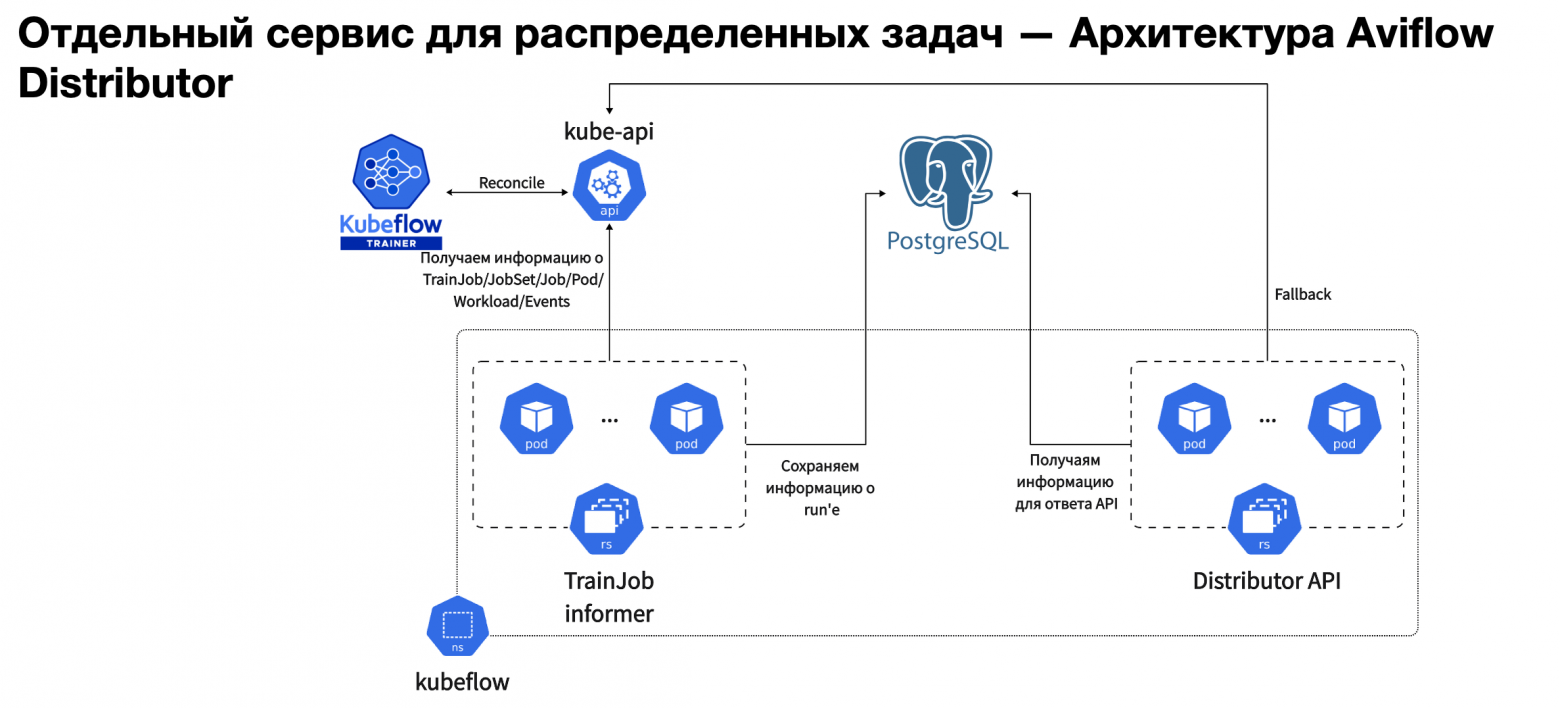
Архитектура довольно простая, на этапе MVP мы пока используем k8s как базу данных, сначала всё хранили в CRD, затем стали сохранять в Postgres. Но мы их чистим по TTL, так что на будущее решили сохранять их в какое-то более персистентное хранилище.
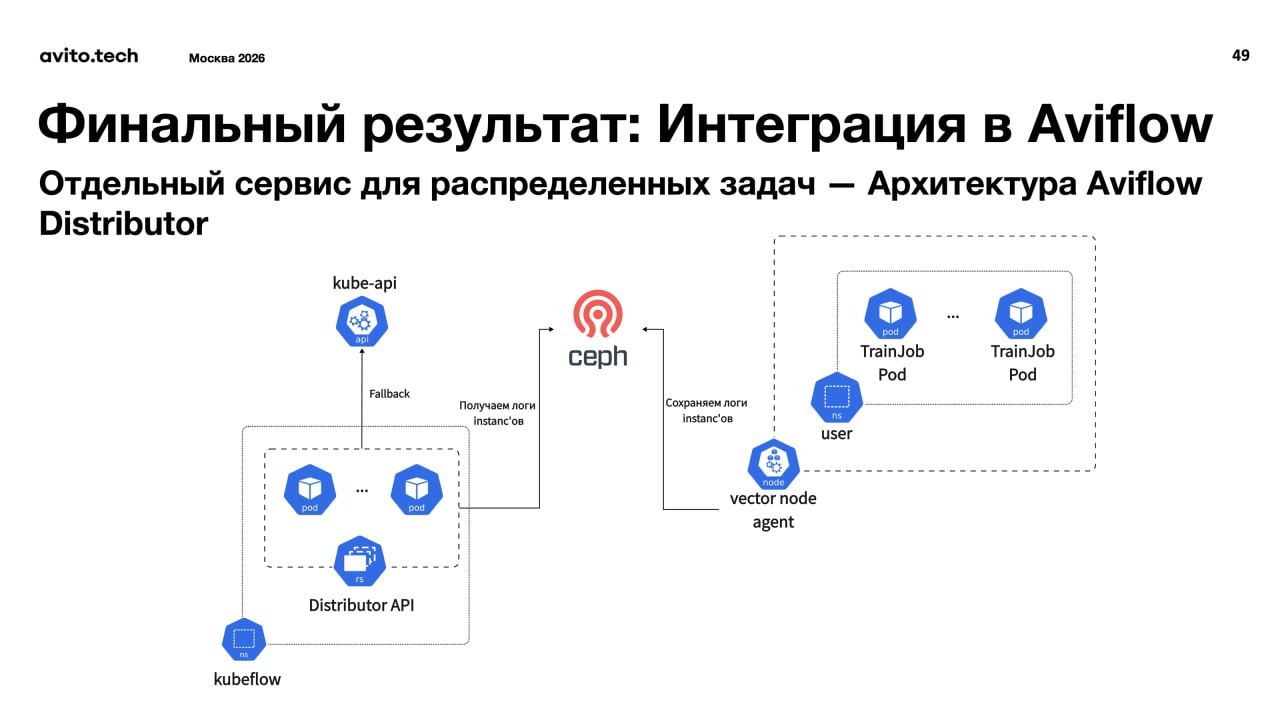
Что же про observability — в рамках нашего UI будут доступны ещё и графики. Grafana, логи, можно сделать отладочный контейнер для внутрикластерного дебага (своя утилита).
К чему мы пришли (и от чего ушли)
Как было — дата-сайентист должен был совмещать в себе супер-менеджера, который держит в голове кучу скриптов, гору пайплайнов и умеет всё это запускать руками. Ему надо сидеть в терминале, что-то самому искать и автоматизировать.
Как стало — теперь у нас есть cloud-native-платформа, где пользователь просто по клику задаёт конфигурацию и запускает задачу. Причём он не блокирует другим пользователям весь узел. Утилизация кластера выросла, порог входа для новых пользователей снизился — теперь просто объясняем новичкам принцип создания конфига, а дальше есть кнопка «Старт».
К нам пришла команда рекомендаций, у которых случился небольшой переезд, из-за чего число GPU в одной машине уменьшилось (они обучали на ней свой catboost). Мы провели исследование и сделали для них интеграцию в нашу платформу, написал компоненты. Теперь они обучаются как раньше, плюс получили новые возможности — могут использовать куда бóльшие датасеты.
Что дальше?
В планах — развивать UI, добавлять инструменты отладки и observability для распределённых джоб, дабы не хранить всё только в k8s. А ещё добавить инструменты для профилирования нагрузок и отладки, плюс наладить интеграции с нашими отчётами.
В процессе всей этой работы мы поняли ряд важных штук, которыми хотим с вами поделиться.
-
Раз 10 подумайте перед тем, как идти в самостоятельное обучение LLM. Прямо вот хорошо подумайте, насколько это вам нужно, насколько выгодно. Это комплексный вопрос, который требует больших затрат — как бюджета, так и спецов из разных областей. Мы вот решили, что пойдём в это.
-
Используйте cloud-native-подход, собирайте свои сервисы из маленьких кубиков.
-
Не бойтесь что-то добавлять и делать больше PoC.
-
Дорабатывайте opensource, это требуется любому большому проекту. Нужна интеграция с сервисами, надо фиксить баги и следить за ИБО.
-
Если вы хотите сами обучать LLM, будьте готовы к большей hardware-сложности и более частому вылету компонент. Логично, что GPU будет вылетать чаще, чем другие компоненты. Но для нас это всё равно стало довольно удивительным моментом (что настолько часто они будут вылетать именно по железным причинам).
Меньше двух недель осталось до новой конференции Kuber Conf от АОТ, записывайте в календарики — она пройдёт 22 октября.
Главная тема — инженерные задачи без привязки к конкретным облакам: практика эксплуатации Kubernetes, разбор инцидентов и обмен опытом.
Будем говорить о построении инфраструктуры вокруг K8s и о способах удержания падающего SLO. Программа и регистрация — по ссылке.
Автор: DRevan

