


Я хотел разработать собственный AI-процессор, нашёл openTPU, взял FPGA за ~$50 с 4 ГБ оперативной памяти, подключил её к обычному мини-ПК и запустил на ней большую языковую модель – и улетел в космос (в позитивном и дофаминовом смыслах).
Без NVIDIA. Без видеокарты. На открытой архитектуре, которая разработана при активном участии ИИ-агентов.
openTPU — открытый AI-ускоритель Felipe Sens Bonetto.
Мне стало интересно: а можно ли действительно взять такой проект с GitHub, загрузить его в физическую FPGA и запустить настоящий LLM-инференс?
По замерам автора проекта на такой же плате:
→ Qwen3-0.6B — 31 токен в секунду
→ Qwen3.5-2B — 12 токенов в секунду
→ LFM2.5-230M — 86 токенов в секунду
→ Qwen3.5-35B — модель на 35 млрд параметров на карте с 4 ГБ памяти, 4 токена в секунду
И всё это на FPGA, которой уже далеко не первый год.
🔧 Что я сделал:
→ Купил Xilinx Kintex-7 XC7K480T с 4 ГБ оперативной памяти на AliExpress (информация по плате: 1 и 2)
→ Подключил FPGA к MINISFORUM через PCIe
→ Собрал прошивку (bitstream) в Vivado
→ Настроил драйверы и PCIe DMA
→ Подготовил программное окружение
→ Загрузил реальные веса нейросетей
→ Запустил инференс, включая Qwen
И всё заработало!
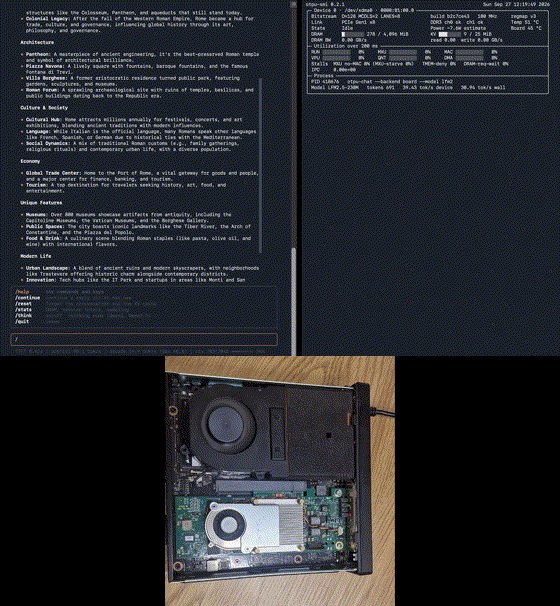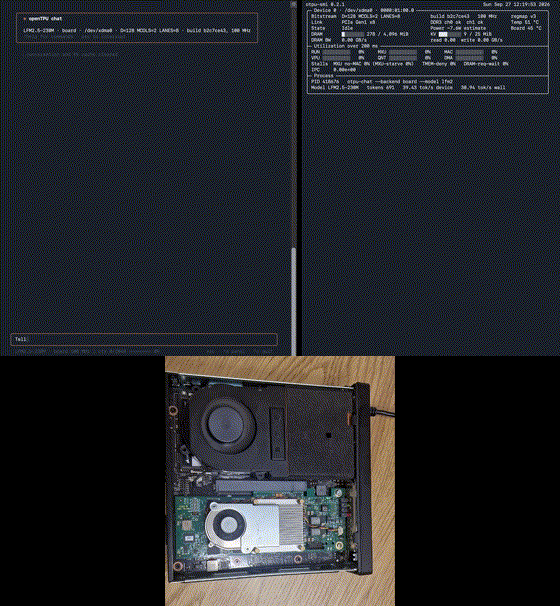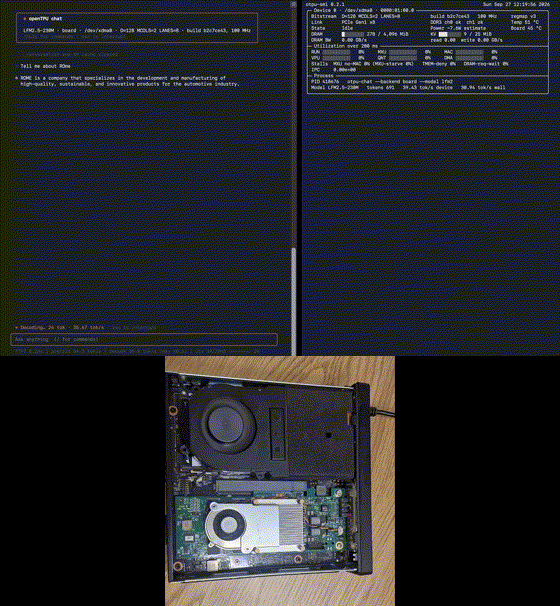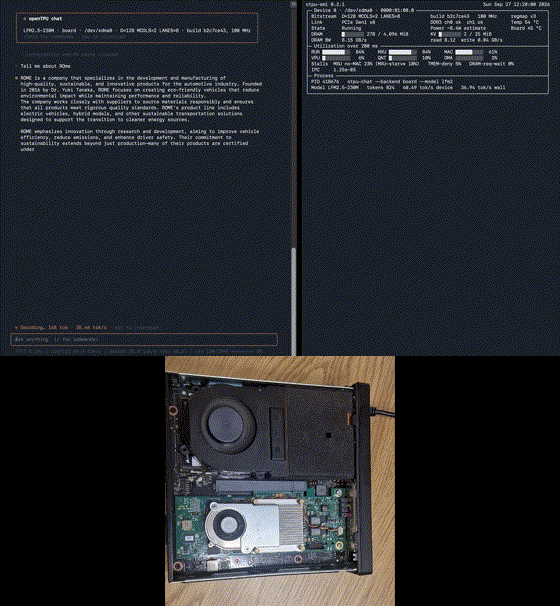
✅ FPGA успешно определяется системой
✅ PCIe DMA передаёт данные
✅ Подсистема памяти работает
✅ Тесты инструкций процессора проходят
✅ Языковая модель выполняет инференс на FPGA
💡 Почему это интереснее, чем просто запуск ещё одной нейросети?
Обычно мы воспринимаем GPU как готовую платформу: покупаем видеокарту, устанавливаем CUDA и запускаем модели.
Но что, если пойти в обратную сторону?
Не подбирать железо под нейросеть, а создавать собственное железо под конкретные вычисления нейросети.
Именно для этого разрабатывают специализированные AI-ускорители, в том числе TPU — процессоры, оптимизированные под операции машинного обучения.
Конечно, текущая плата пока не конкурент NVIDIA H100. И работающий прототип — это ещё далеко не серийный ASIC.
Но теперь можно не просто рассуждать о собственной архитектуре AI-процессора, а экспериментировать с ней на физическом оборудовании.
🔬 Над чем думаю дальше:
→ Более быстрая память и более мощная FPGA
→ Оценка архитектуры для собственного inference-чипа
Мы уже используем ИИ, чтобы писать программы. Теперь ИИ проектирует процессоры, на которых сам будет работать. Раньше свой AI-ускоритель был задачей Google и NVIDIA — сегодня прототип может собрать и испытать один инженер.
Во второй части покажу все результаты со своего стенда.
Отдельное спасибо Felipe Sens Bonetto за openTPU.
🔗 Оригинальный проект: https://github.com/FeSens/openTPU
Автор: T-PheniX

