


Meta* выпустила Muse Wonder и Muse Wonder Full – две новые модели, которые компания называет самыми мощными в своей истории. Их делали для «персональных и профессиональных» ИИ-агентов: такая модель помнит пользователя между диалогами, не останавливается при первой ошибке и доводит длинную задачу до конца. Muse Wonder уже доступна через Meta* Model API и в кодинг-агенте Muse Code. Muse Wonder Full пока только для подписчиков Muse Code.
Что за модель
Muse Wonder – следующая ступень после Muse Spark. Spark задумывали как лёгкую модель с низкой задержкой, а Wonder и Wonder Full крупнее и рассчитаны на сложные задачи вроде программирования. Meta* связывает рост качества с более крупными базовыми моделями и изменениями в претрейне и обучении с подкреплением. Внутреннее кодовое имя проекта – «Watermelon».
«Это настоящие frontier-модели».
– Александр Ванг
Как делятся модели:
-
Muse Wonder:
– доступна с 12 октября через Meta* Model API и Muse Code;
– скоро появится в приложении Muse, сначала у подписчиков;
– Meta* обещает использовать её для генерации артефактов и «процессов, требующих больше интеллекта». -
Muse Wonder Full:
– более мощная модель, доступная только подписчикам Muse Code;
– это отдельная модель, а не режим рассуждений Muse Wonder.
Технические параметры:
-
контекст около 1 млн токенов, как у Muse Spark 1.3;
-
вход: текст, изображения, видео и аудио;
-
выход: только текст;
-
обучение: гигаваттный дата-центр Prometheus в центральном Огайо.
Active Memory и Active Focus: две главные функции
Active Memory
Модель переносит важный контекст о пользователе из диалога в диалог и достаёт нужные детали, когда они пригождаются в задаче. Как объясняет компания, это избавляет от необходимости каждый раз заново рассказывать о своих предпочтениях и обстоятельствах. Исследовательница Кавья Коппарапу рассказала, что команда вложила много сил в то, чтобы модель помнила важное для пользователя днями, неделями и месяцами.
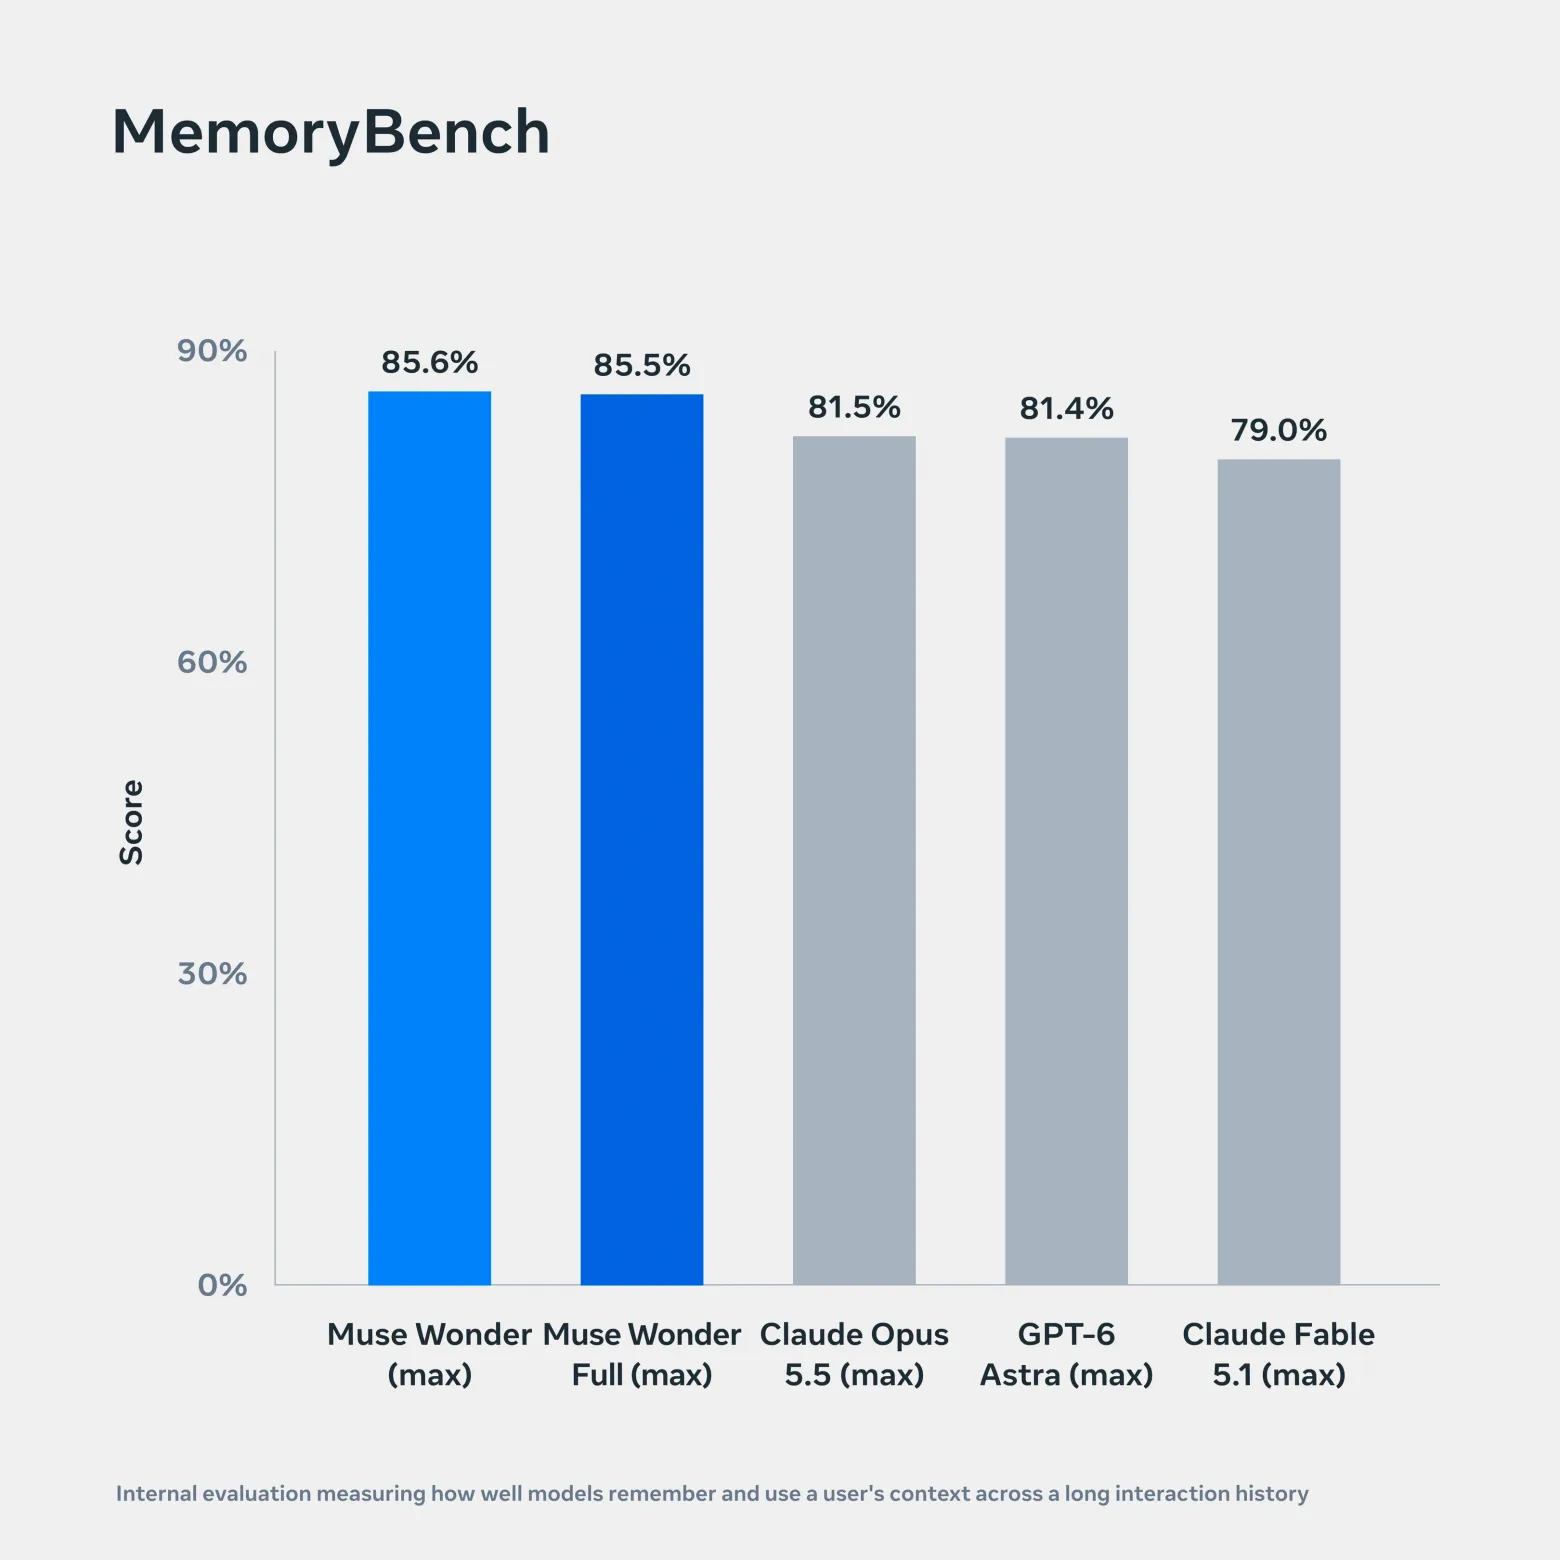
По результатам тестов Meta*, на бенчмарке MemoryBench (память и непрерывное обучение) Muse Wonder обходит Claude Fable, Claude Opus и GPT-6 Astra.
Active Focus
Это способность не бросать трудную задачу:
-
пробовать другие подходы;
-
обходить препятствия;
-
адаптироваться к новой информации;
-
уточнять непонятное;
-
спрашивать подтверждение перед важными действиями.
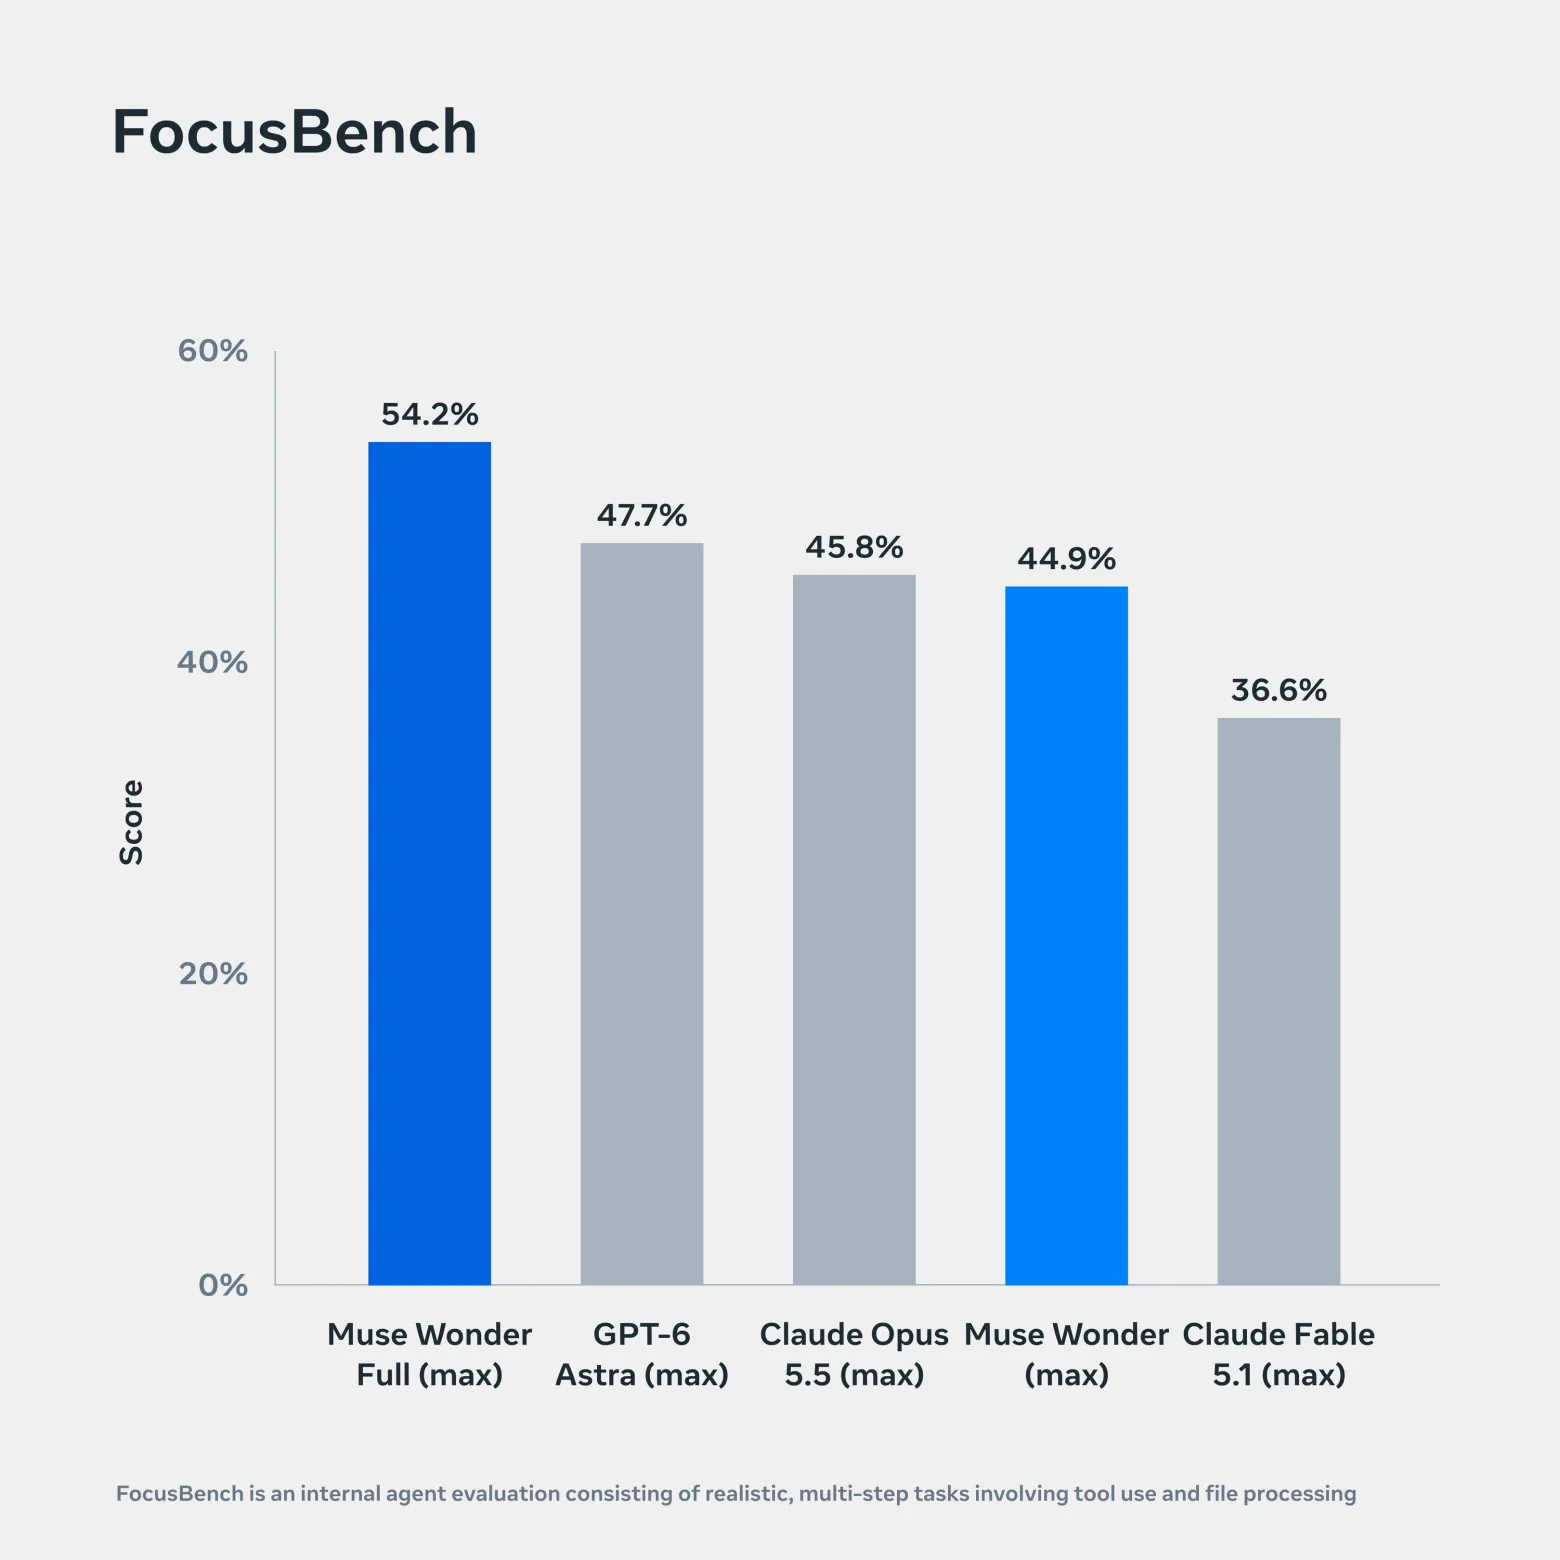
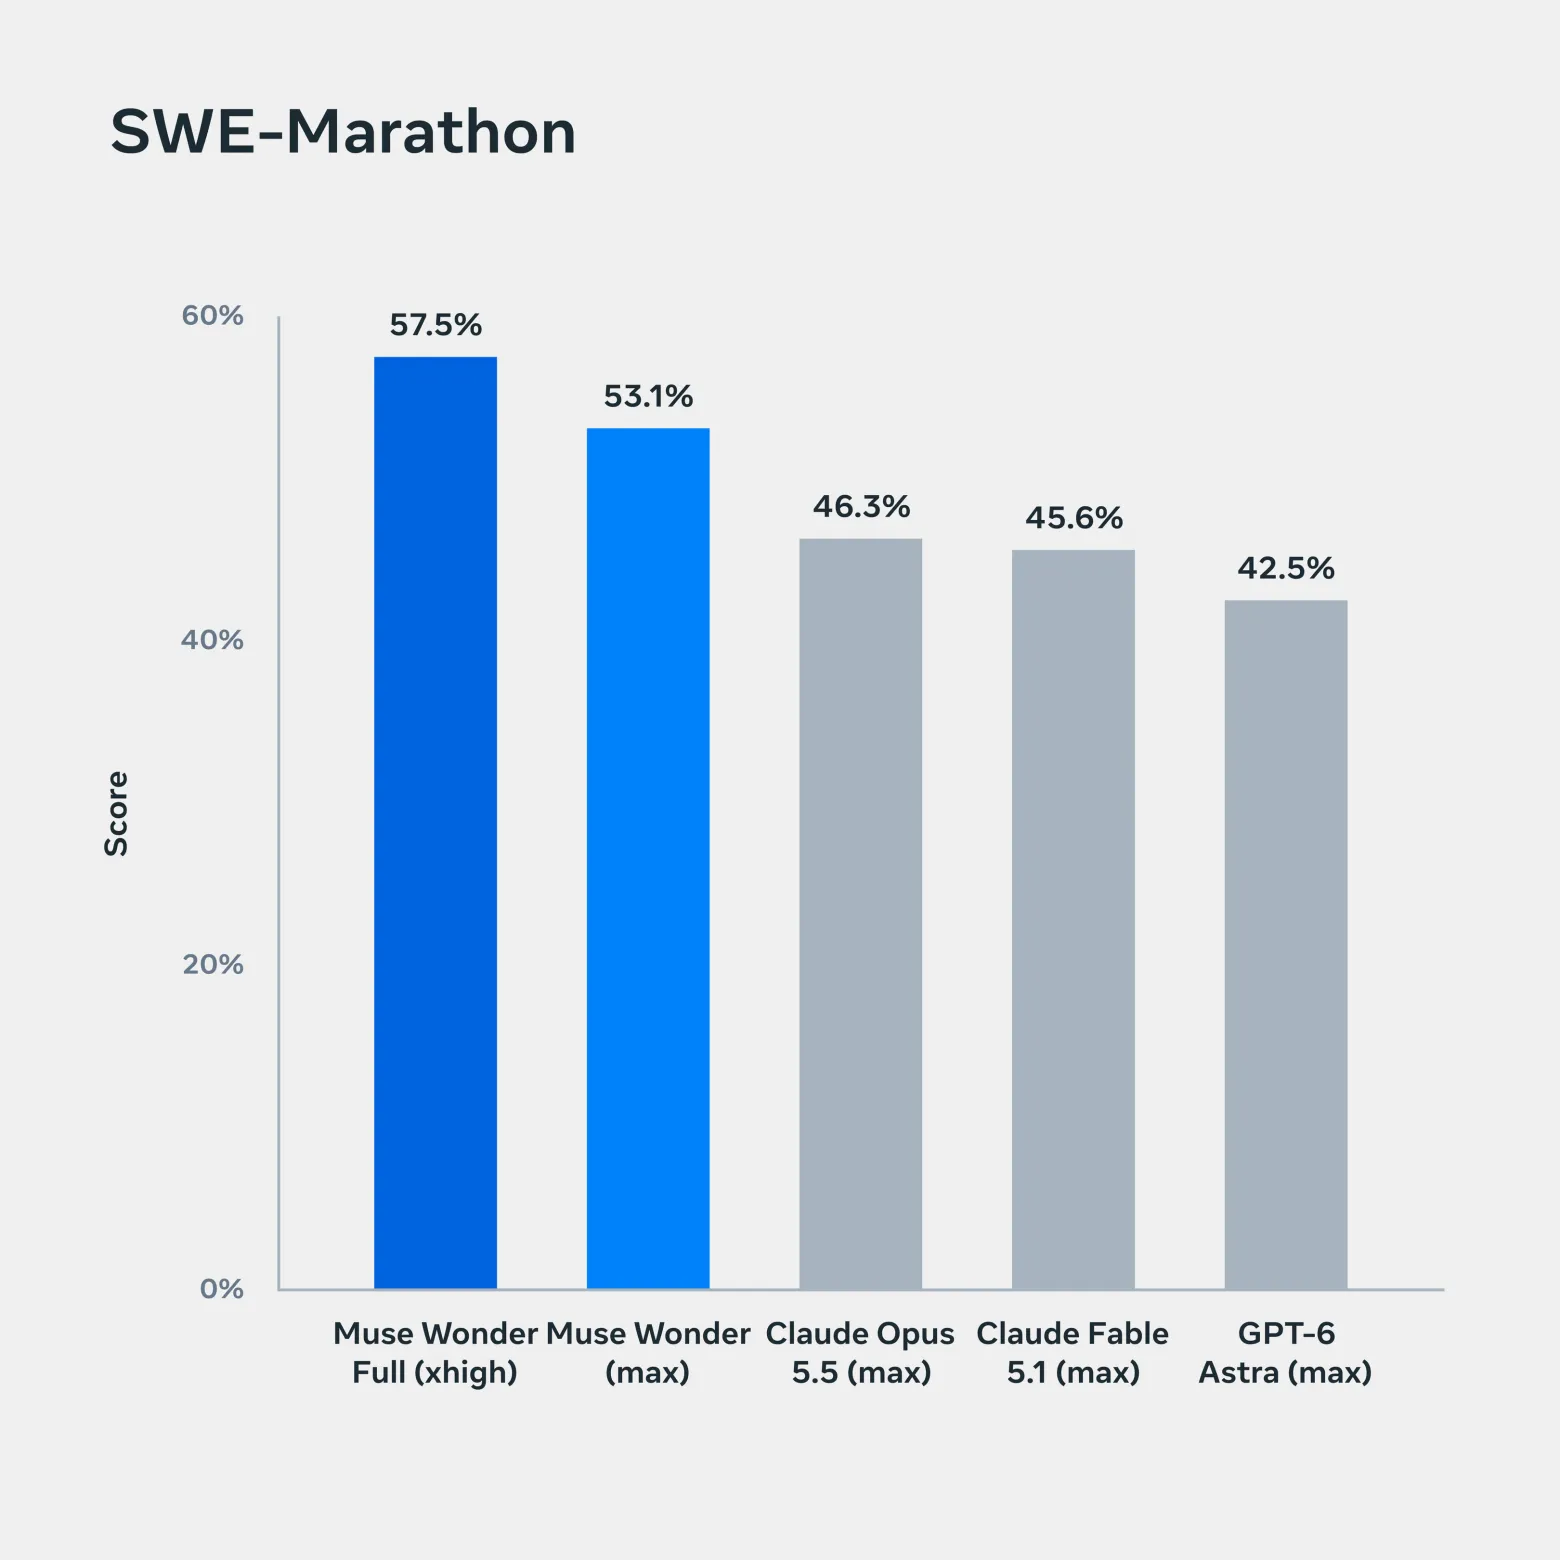
По словам Ванга, модель специально учили не застревать на препятствиях и не возвращаться к пользователю при каждой мелочи. Для проверки Meta* использует FocusBench (устойчивое усилие) и SWE-Marathon (долгие программные проекты).
Бенчмарки от Meta*: где Muse Wonder Full впереди, а где нет
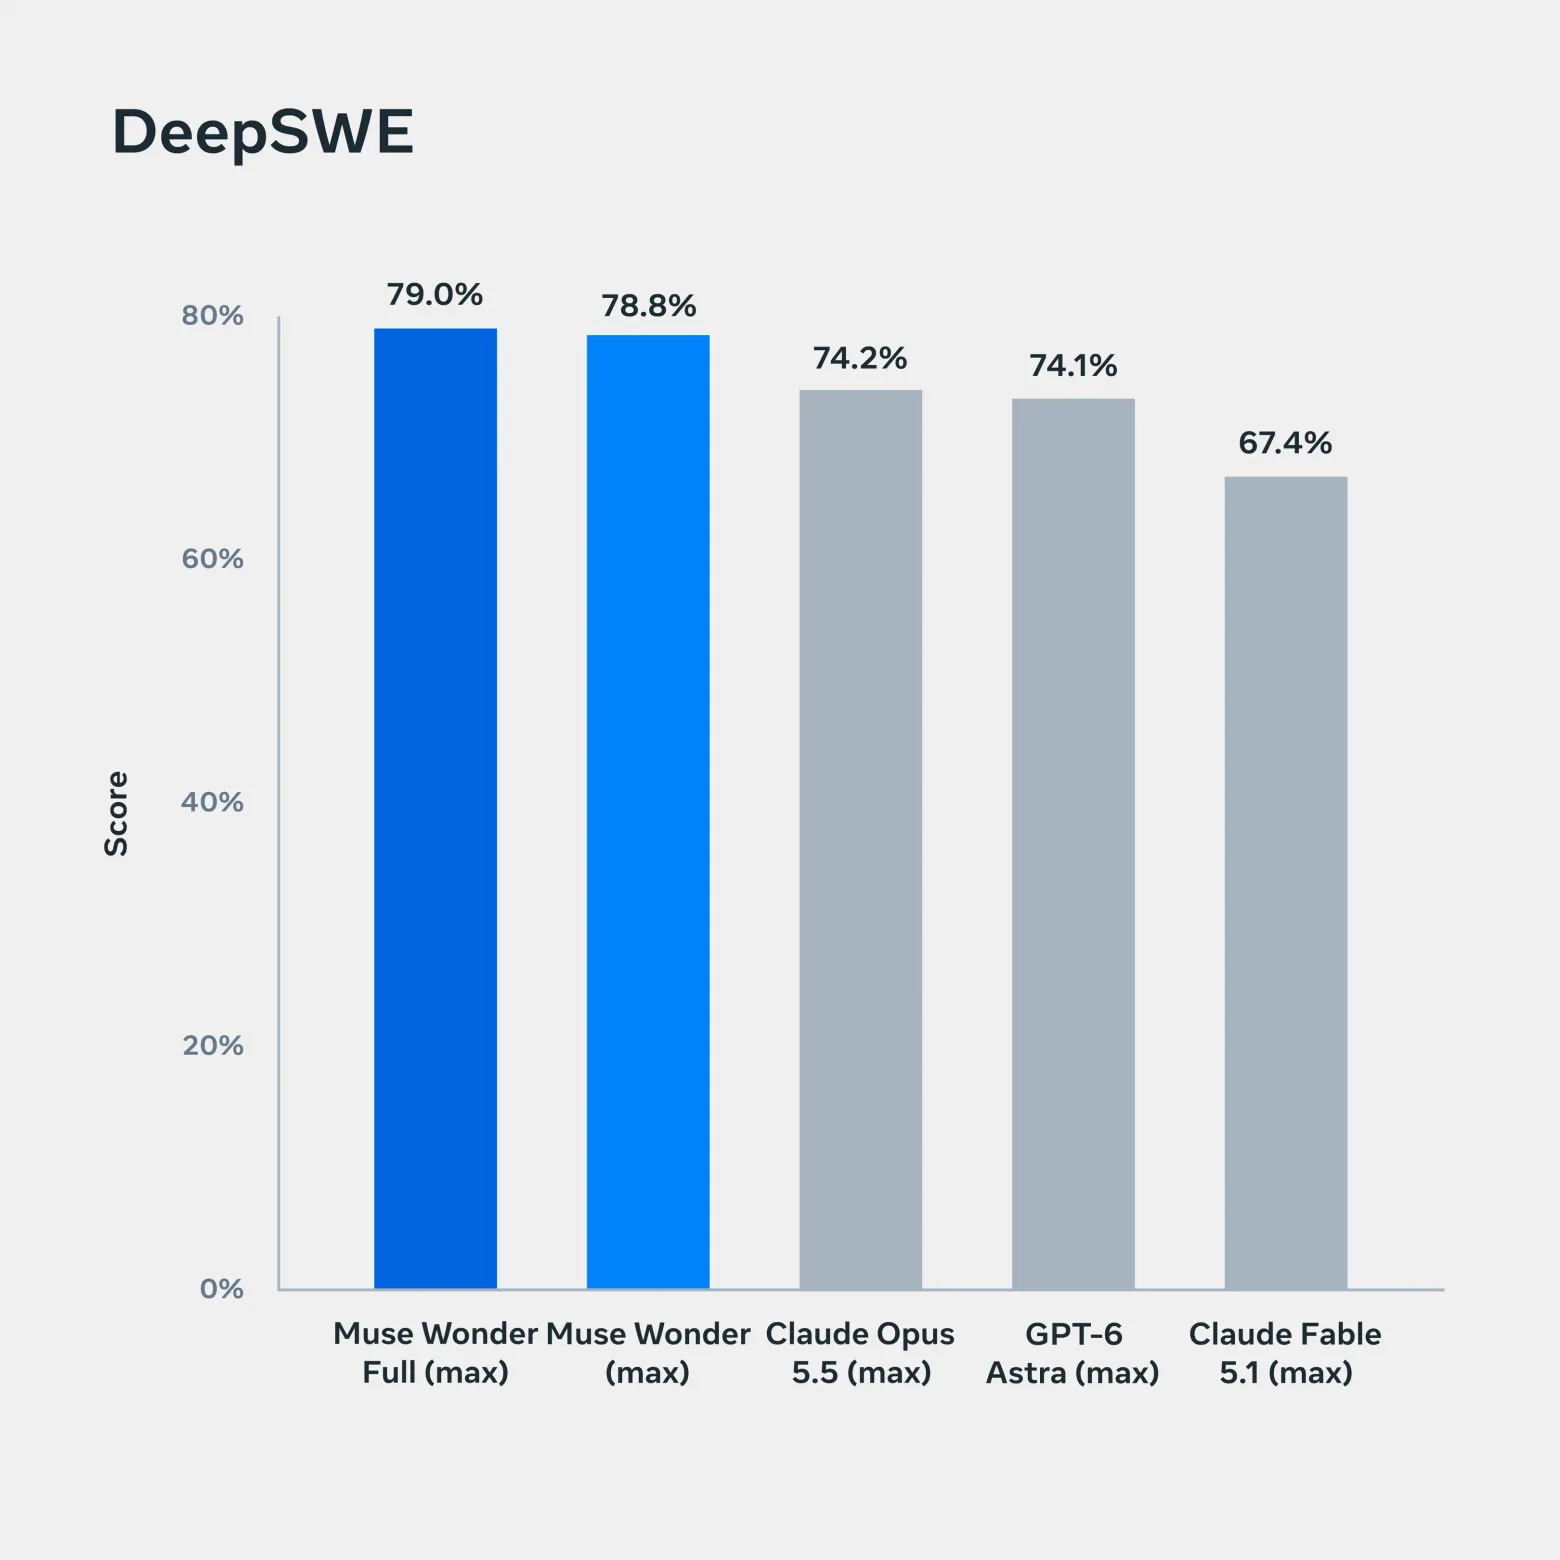
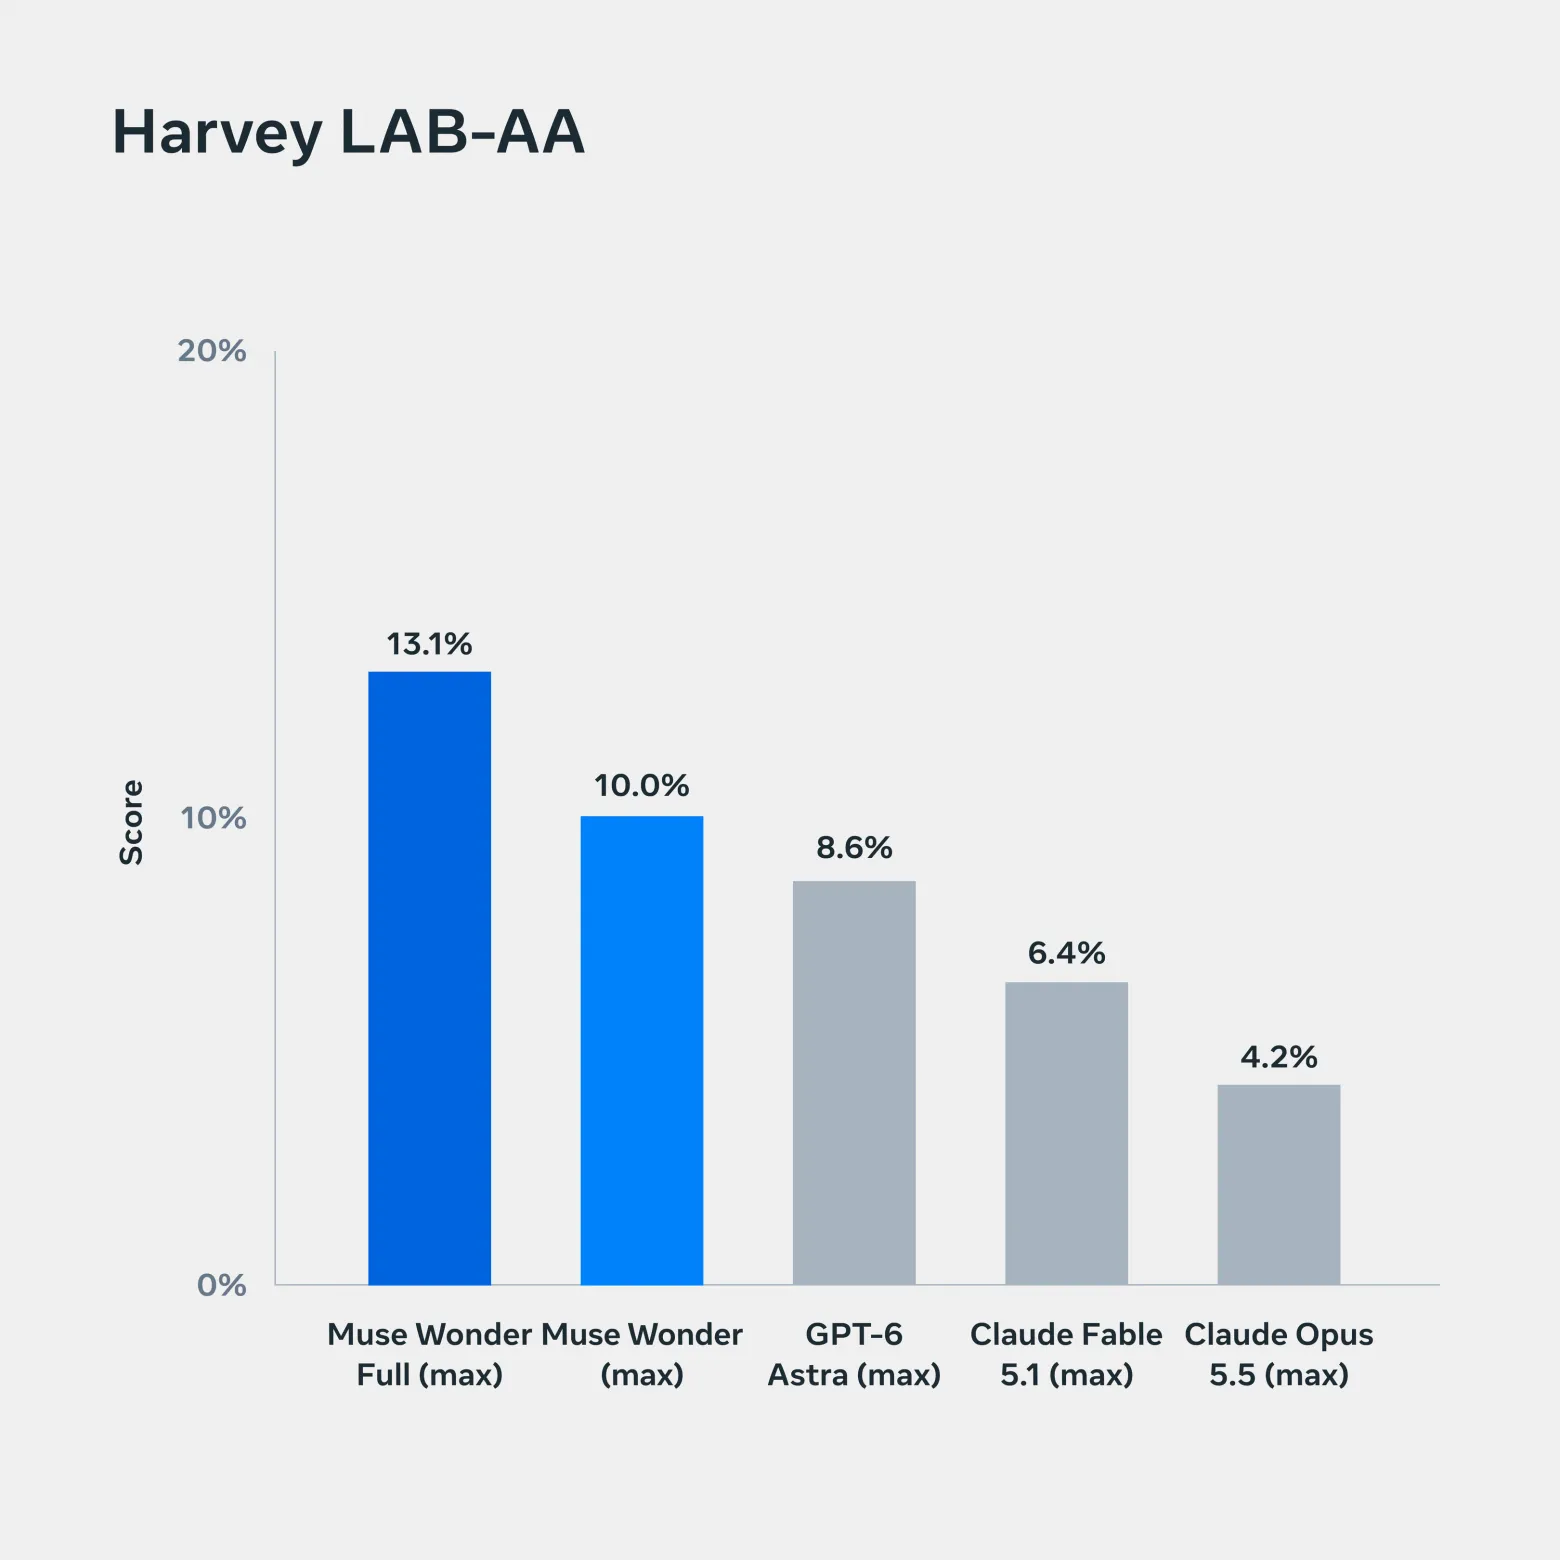
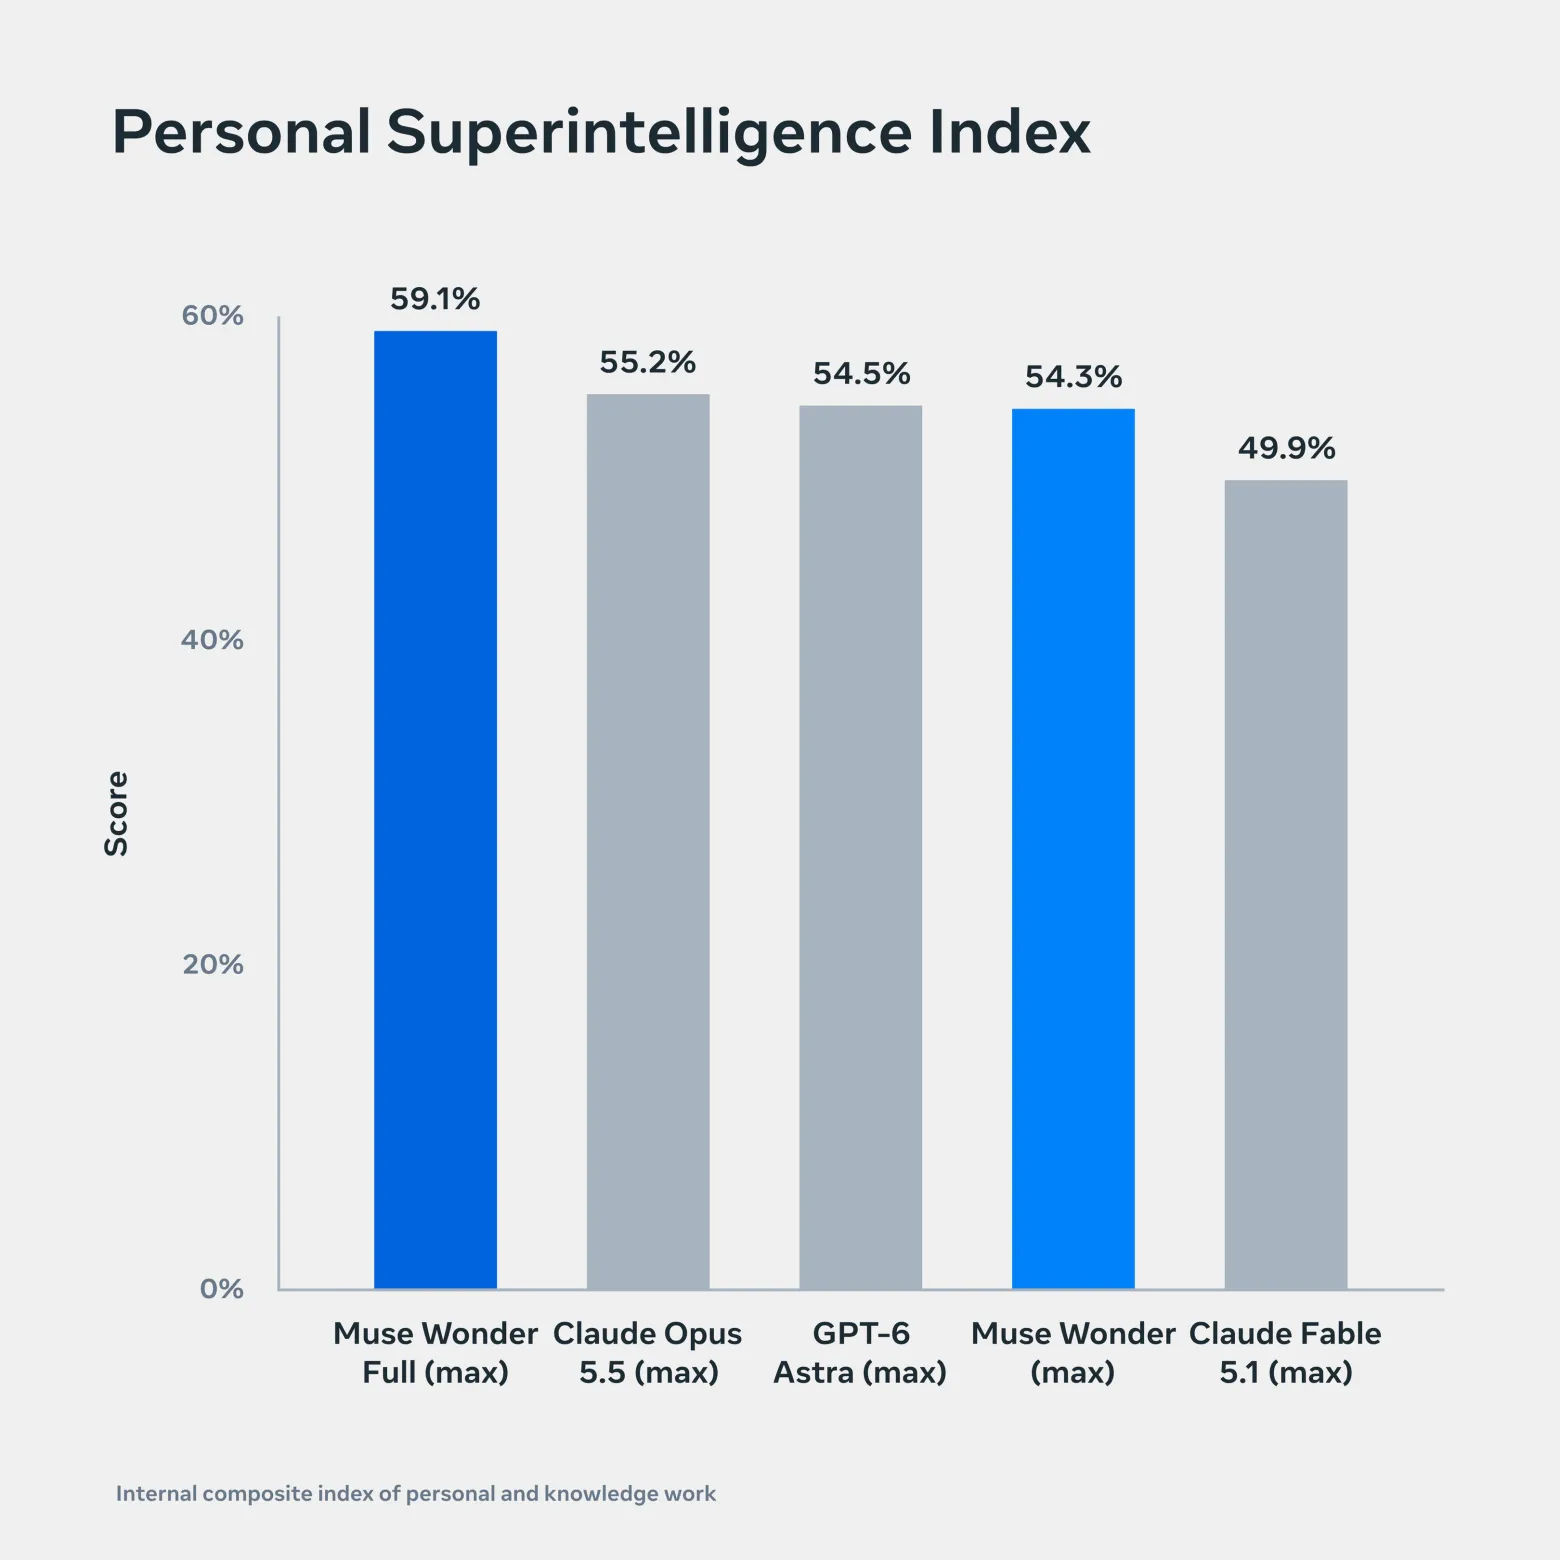
Meta* сравнивала свои модели с GPT-6 Astra, Claude Opus 5.5 и Claude Fable 5.1. Компания заявляет паритет или превосходство в агентных, кодинговых и профессиональных тестах.
|
Бенчмарк |
Muse Wonder Full |
Claude Opus 5.5 |
GPT-6 Astra |
|---|---|---|---|
|
SWE-Marathon |
57,5% |
46,3% |
42,5% |
|
DeepSWE v1.1 |
79% |
74,2% |
74,1% |
|
Harvey LAB-AA (юридические задачи) |
13,1 |
4,2 |
8,6 |
|
Personal Superintelligence Index (индекс самой Meta*) |
59,1 |
55,2 |
54,5 |
(Результаты Muse Wonder Full в тестах, опубликованных Meta*)
Где Muse Wonder Full не лидирует. Muse Wonder Full выигрывает не во всех тестах – Claude Opus 5.5 впереди в ProgramBench (70,5 против 50) и в Terminal-Bench (59,6% против 57,1%). Общий Intelligence Index у Opus тоже выше.
Остальные графики из анонса Meta*
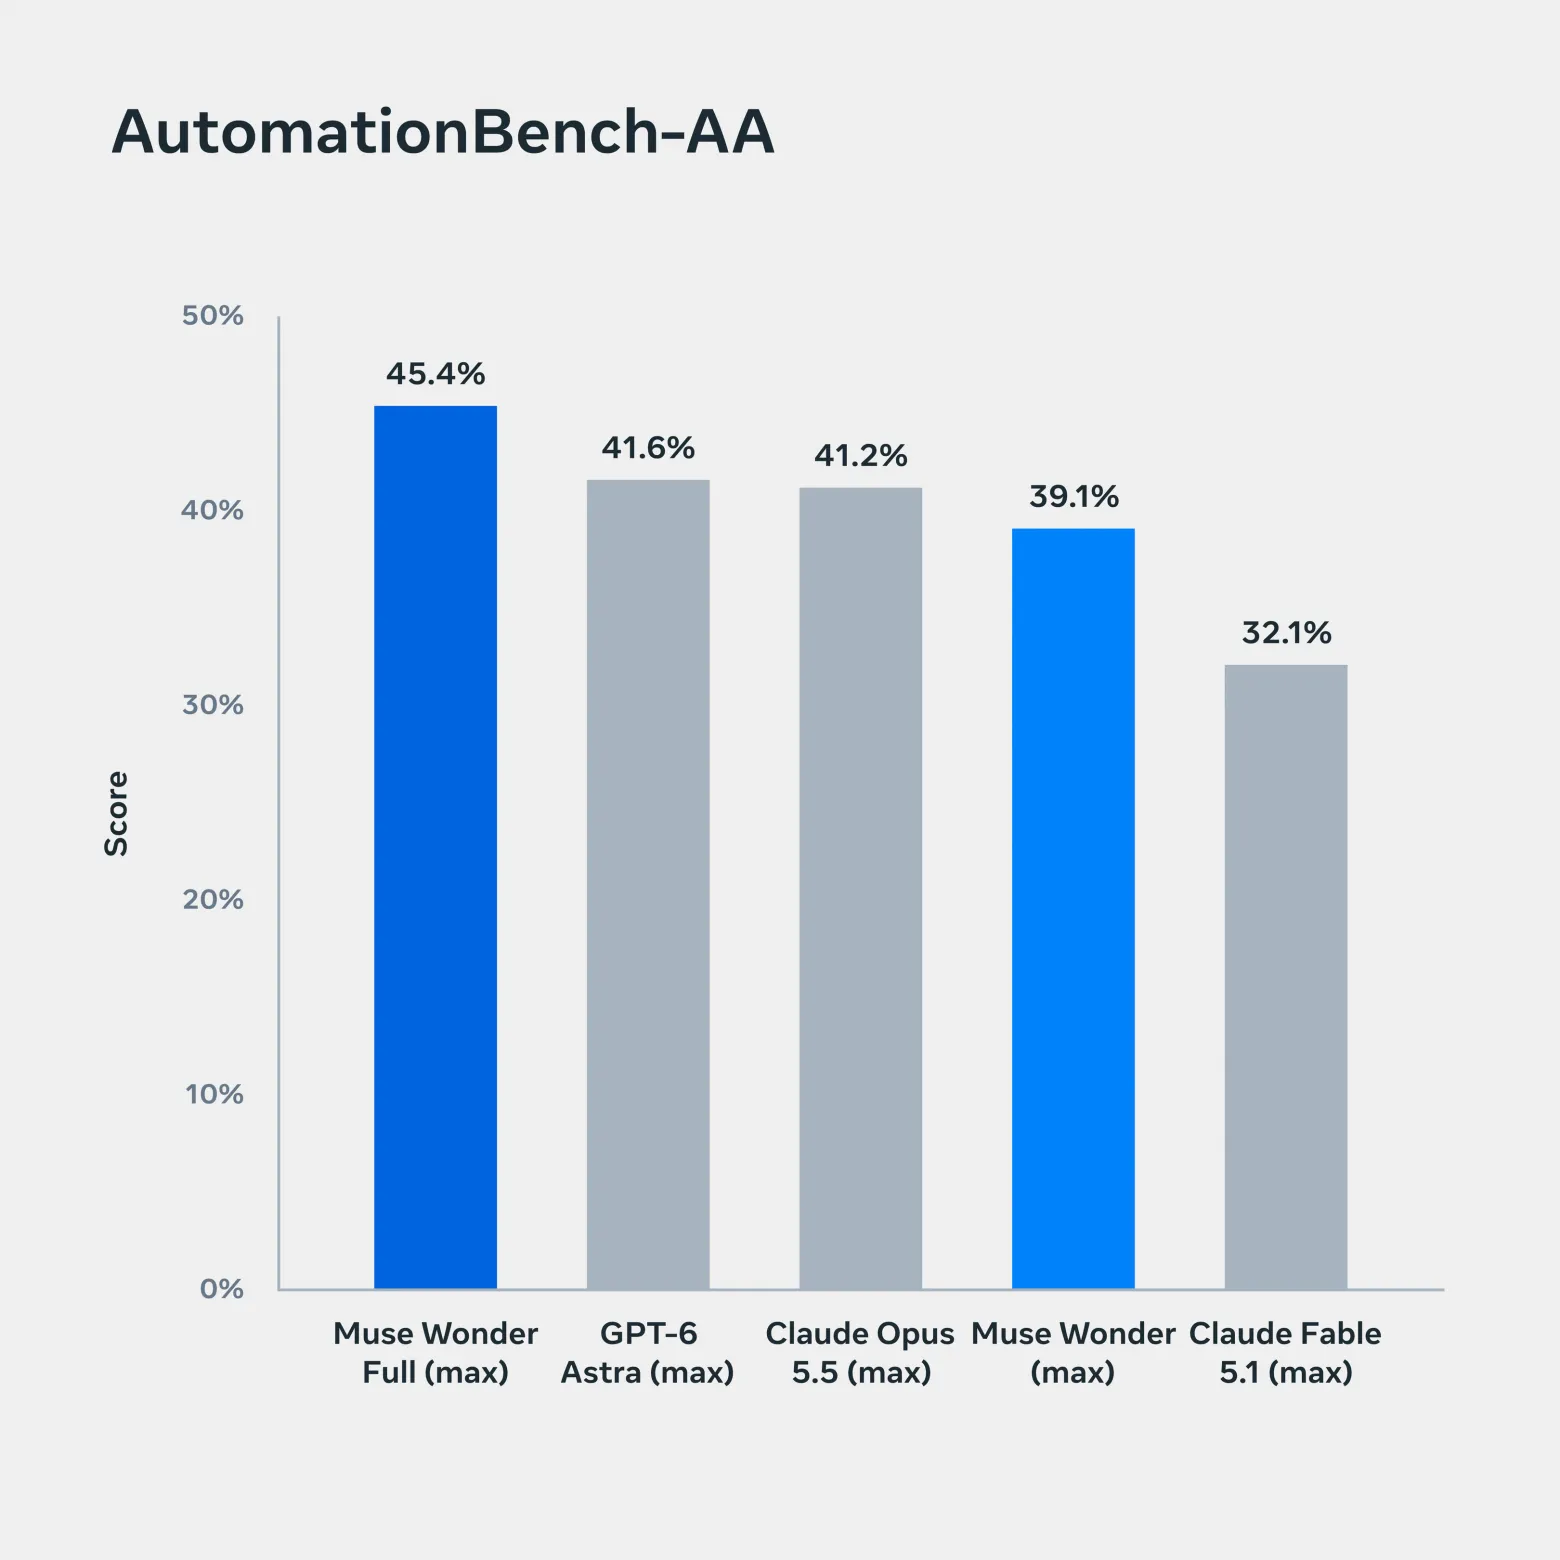
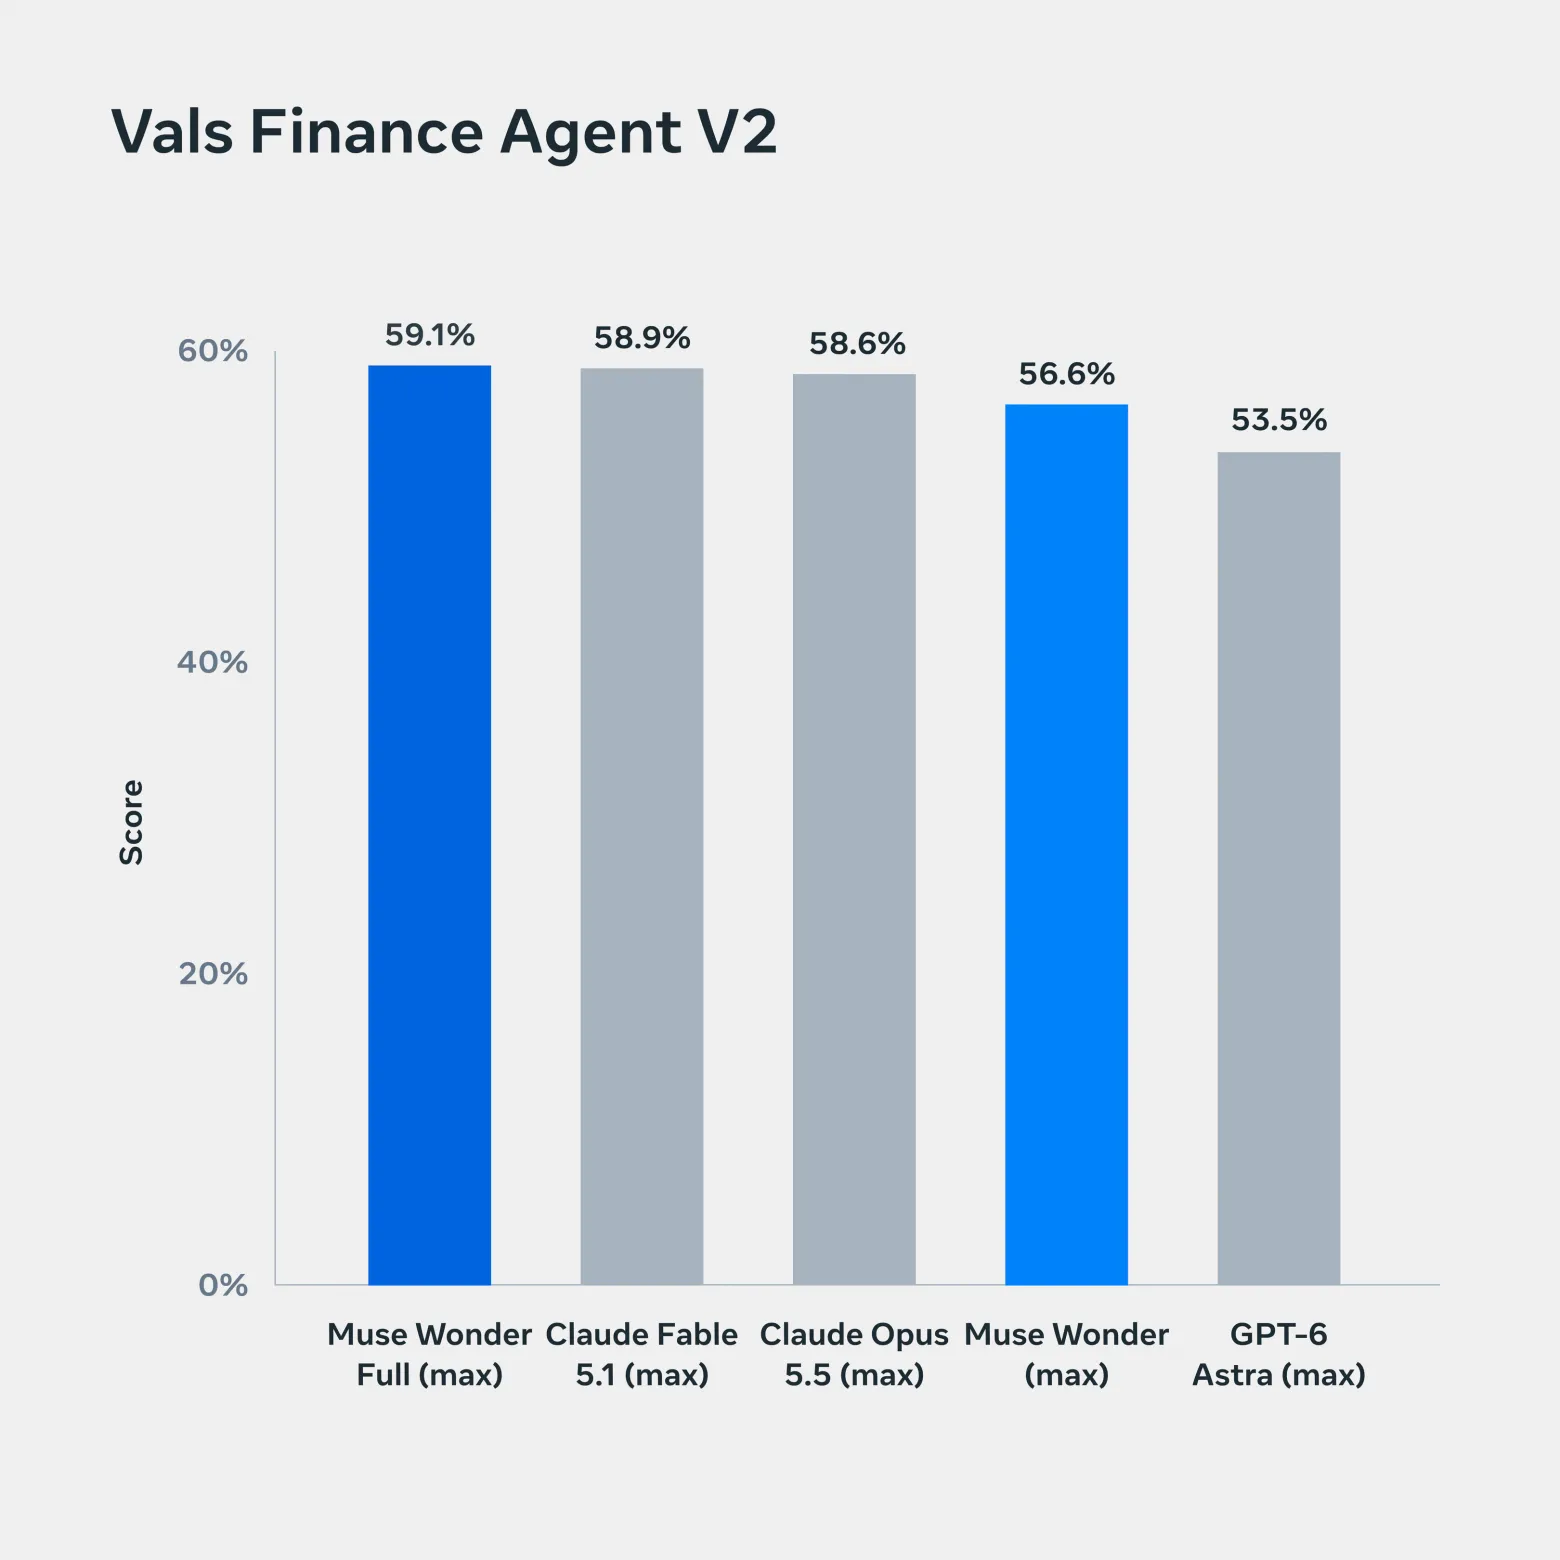
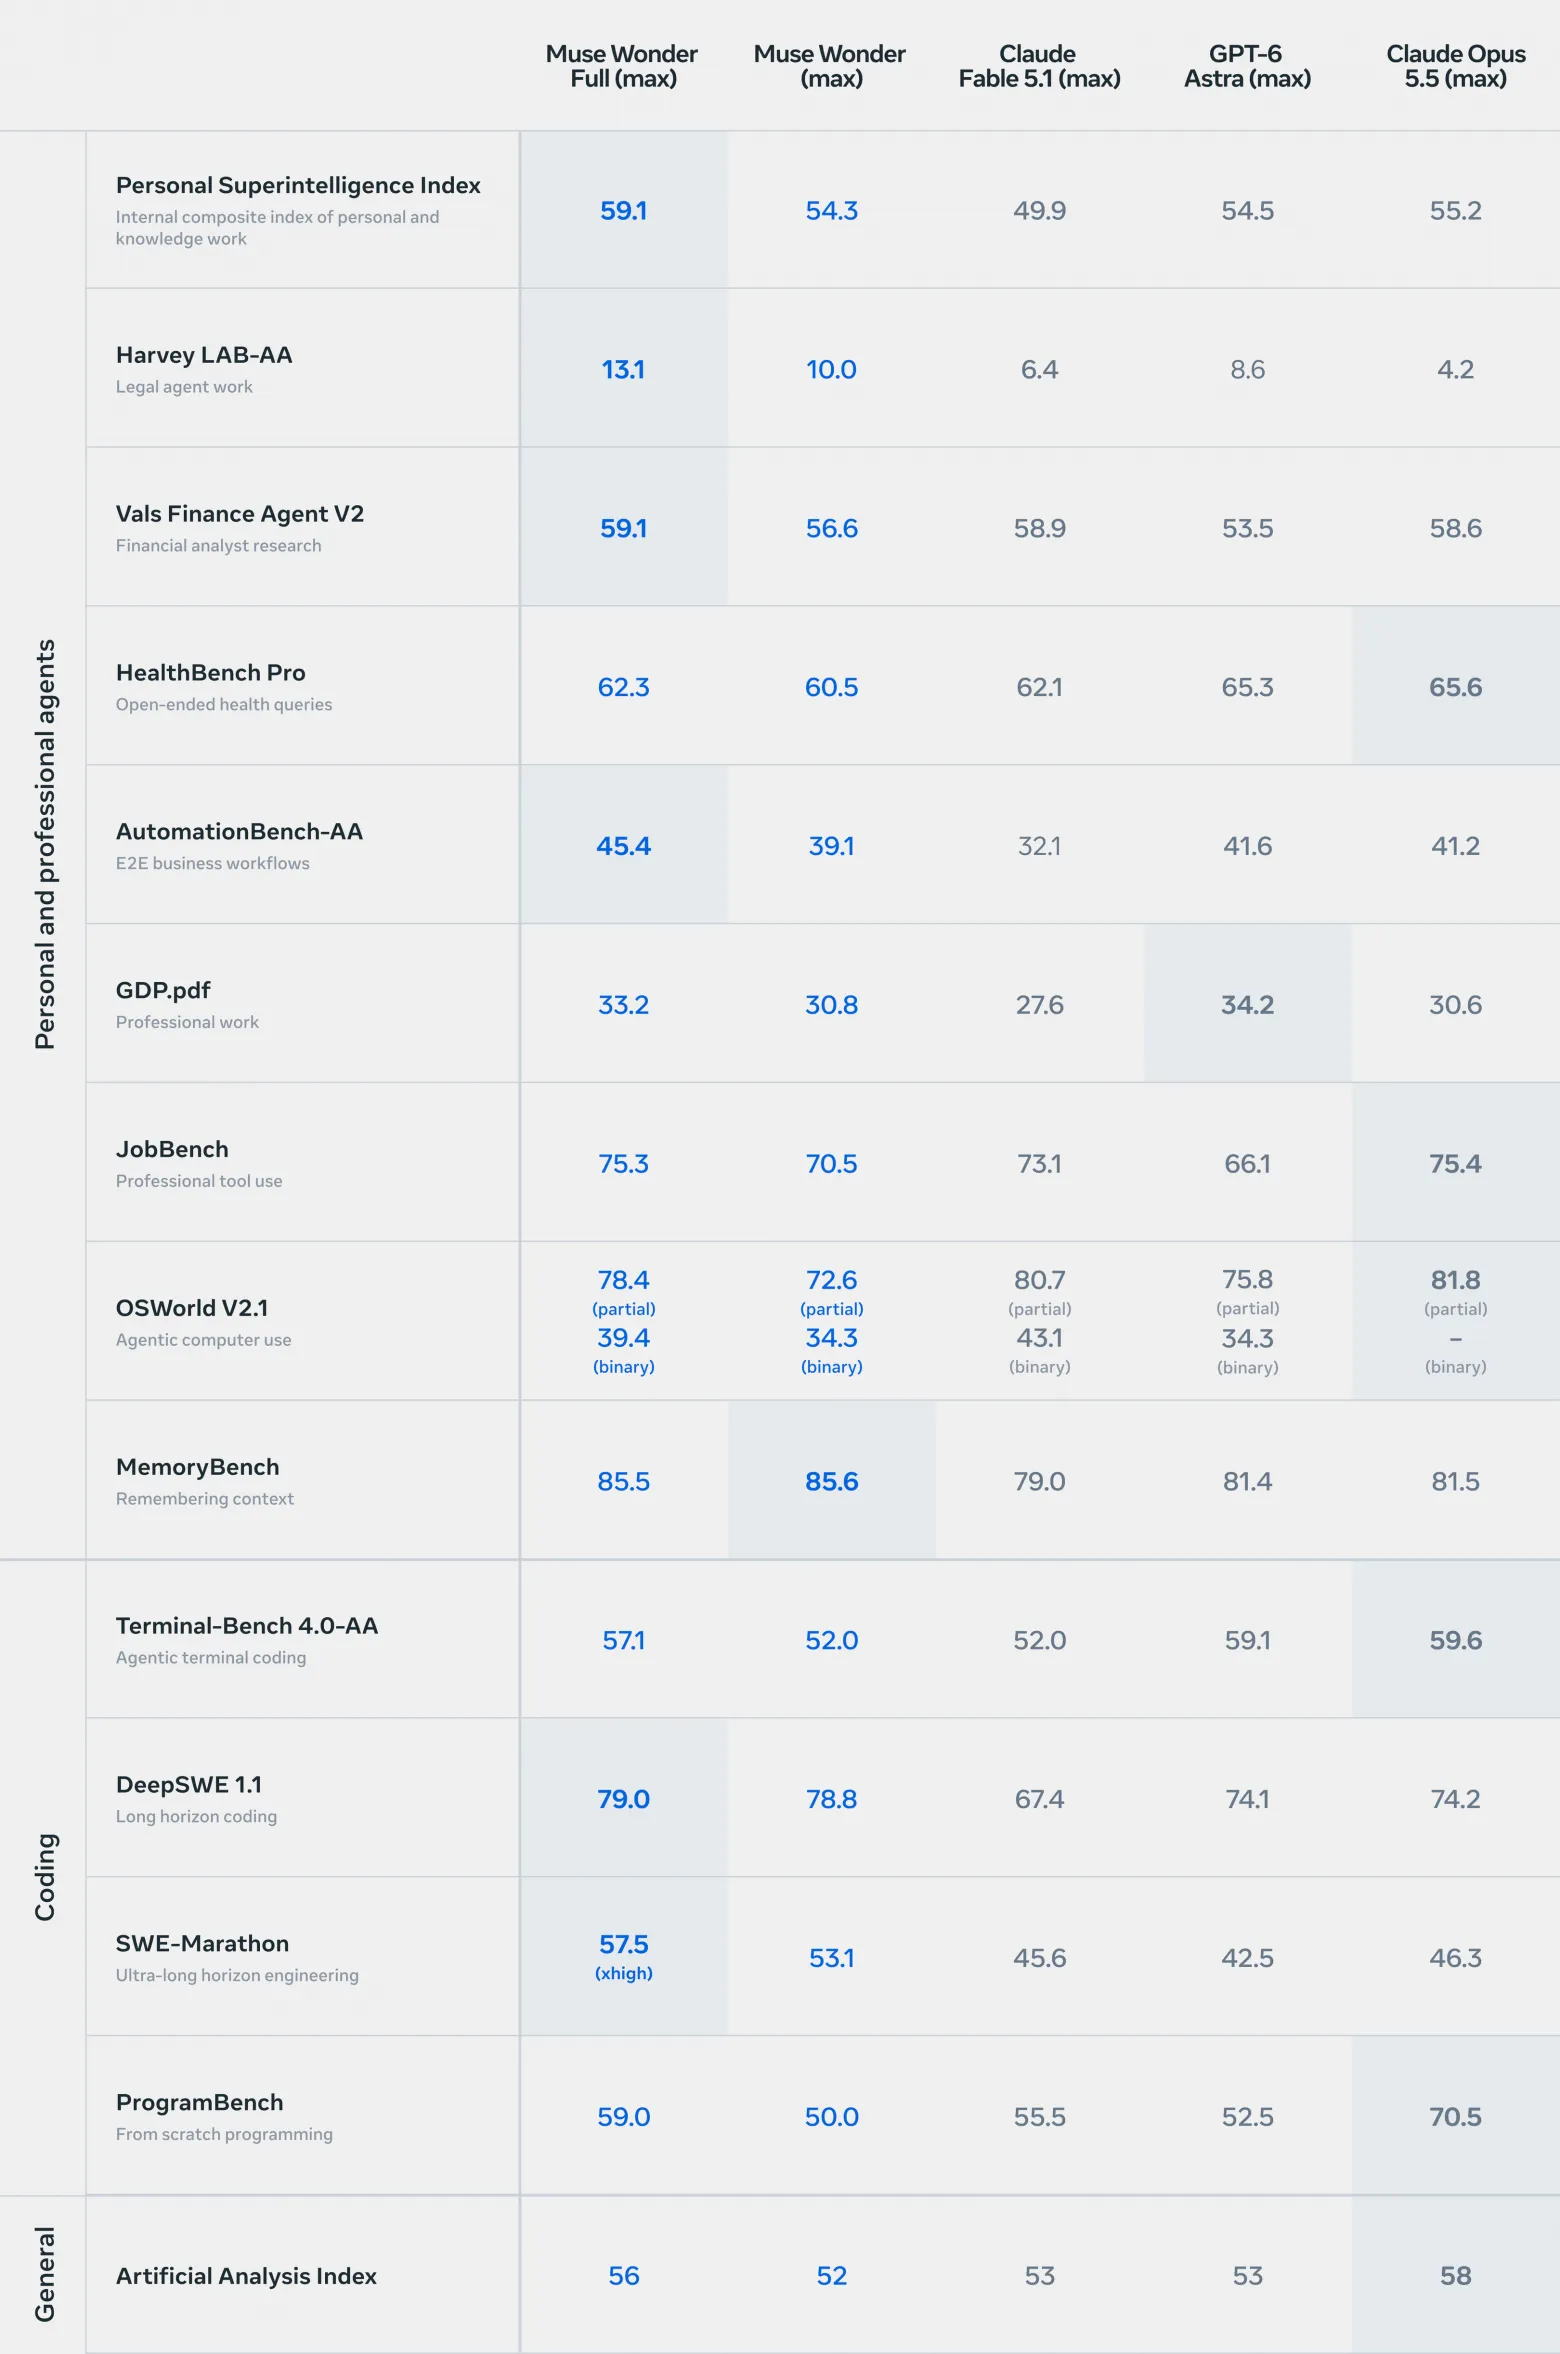
Независимый тест Artificial Analysis
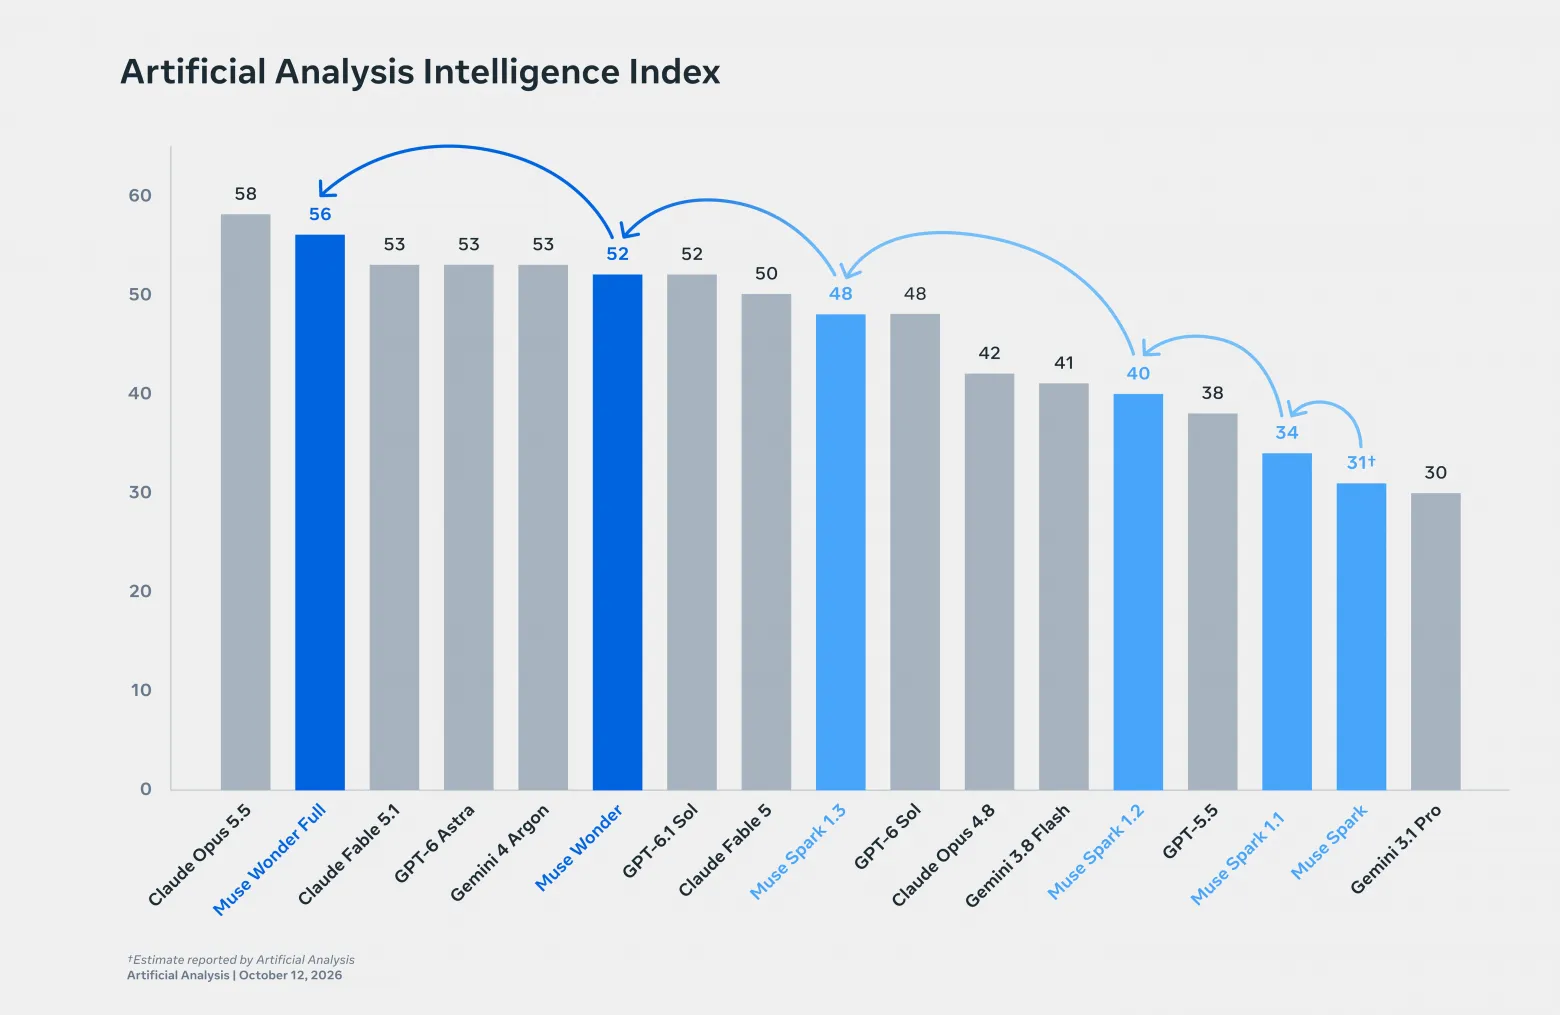
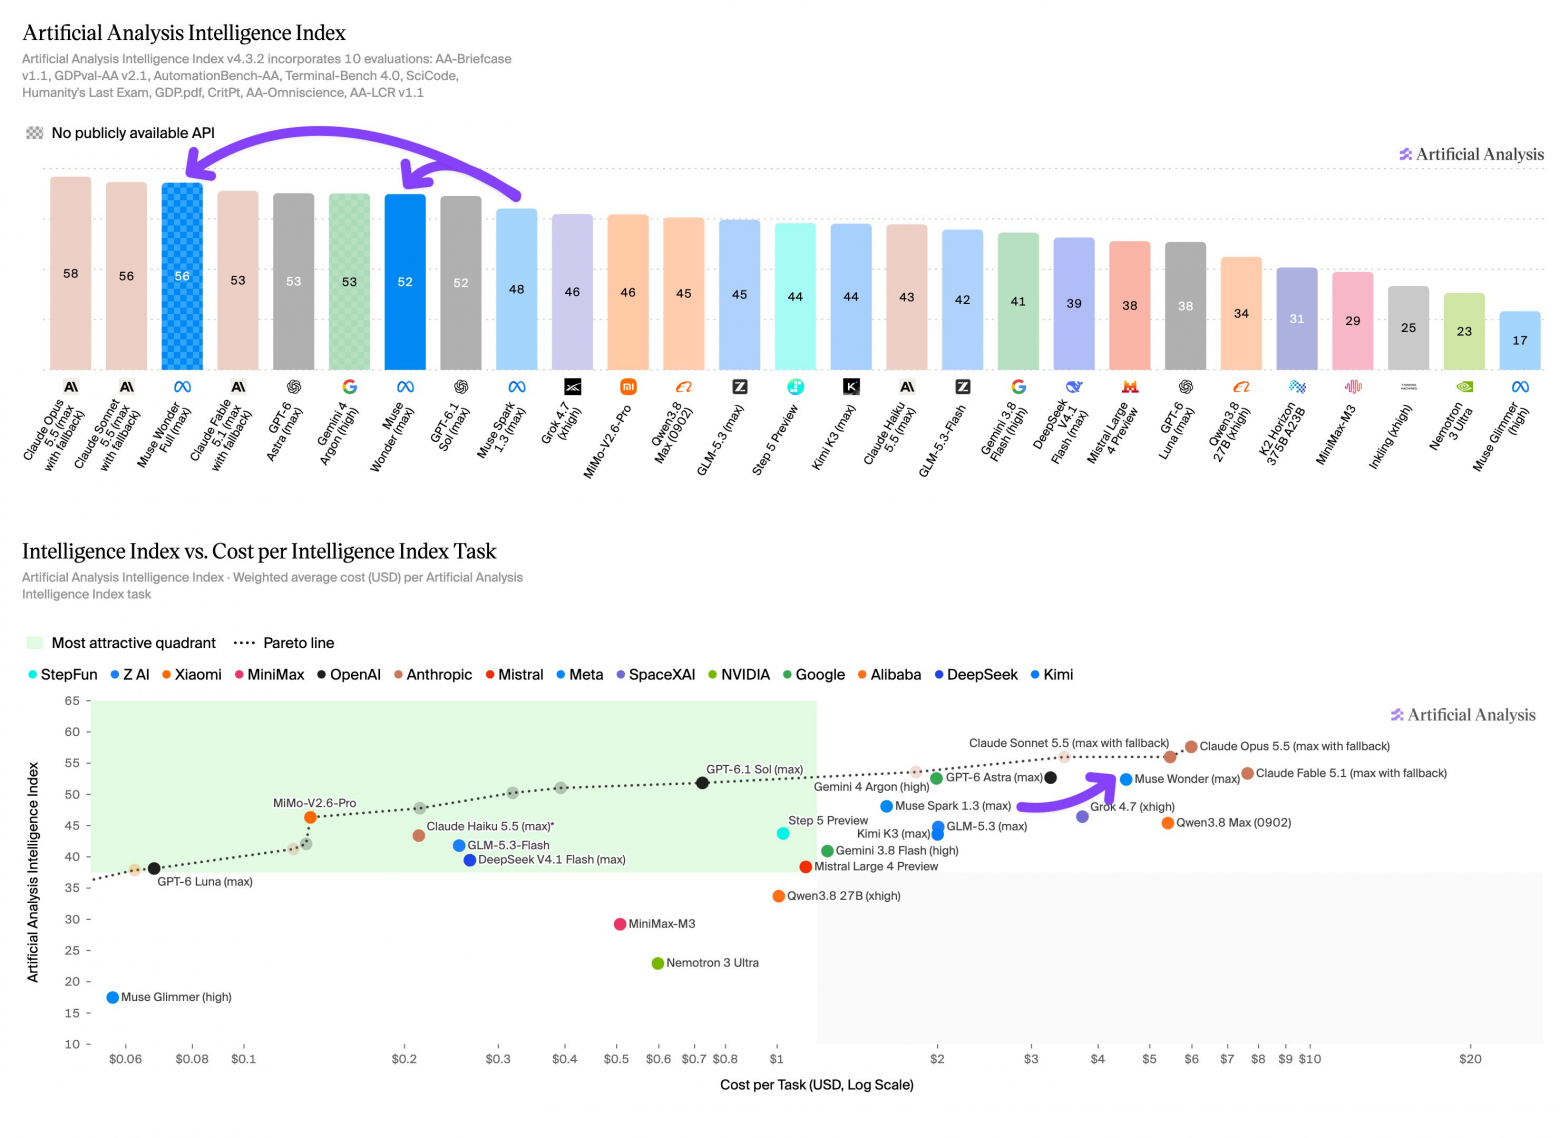
Цифры Meta* проверяет независимая компания Artificial Analysis. В её Intelligence Index v4.3 (десять тестов, от кода до агентной офисной работы) топ выглядит так:
-
Claude Opus 5.5 – 57,6
-
Muse Wonder Full – 55,8
-
Claude Fable 5.1 – 53,4
-
GPT-6 Astra – 52,7
-
Gemini 4 Argon – 52,6
-
Muse Wonder – 52,4
-
GPT-6.1 Sol – 51,8
Для сравнения, Muse Spark 1.3 набирал 48 баллов. По оценке Artificial Analysis, между релизами Muse Spark 1.3 и Muse Wonder прошло всего около шести недель.
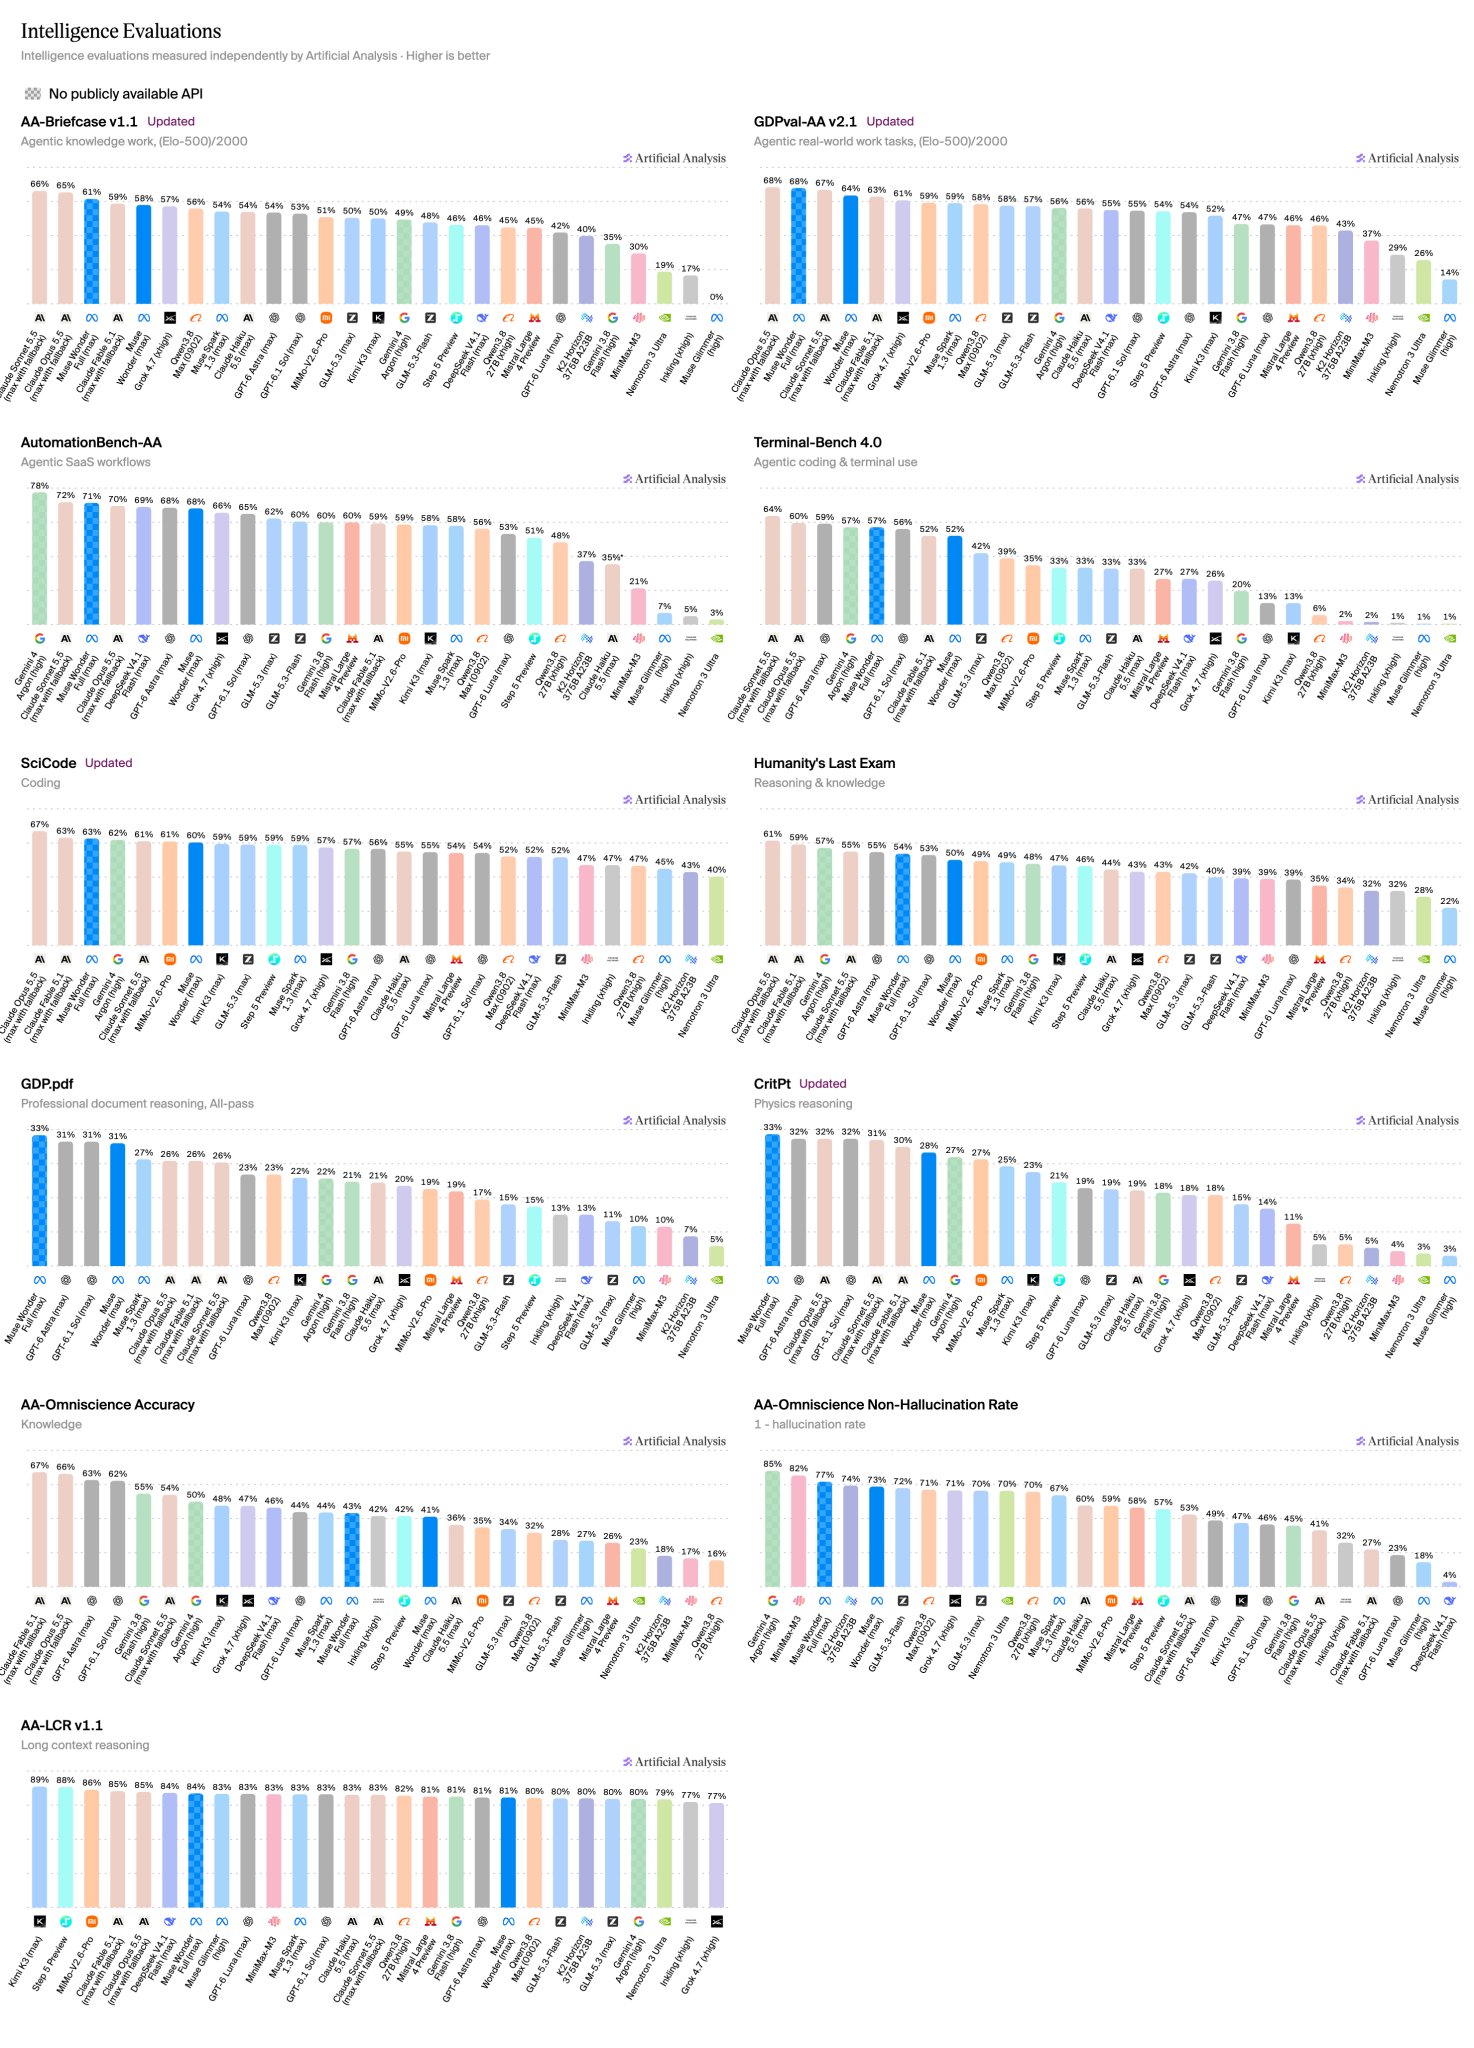
Muse Wonder Full улучшилась по сравнению с Muse Spark 1.3 во всех десяти тестах индекса – на 8 баллов.
Главное из разбора:
-
Агентные задачи выросли сильнее всего:
– Terminal-Bench 4.0: с 33% до 57%;
– GDPval-AA v2.1: +176 Elo (с 1681 до 1857);
– AA-Briefcase: +148 Elo (с 1581 до 1729). -
Muse Wonder прибавила 4 балла. Terminal-Bench 4.0 вырос с 33% до 52%, AutomationBench-AA – с 58% до 68%.
-
Топ-3 по шести из десяти тестов. Muse Wonder Full – первая в CritPt (33%) и GDP.pdf (33%), вторая в GDPval-AA v2.1, третья в AA-Briefcase, AutomationBench-AA (71%) и SciCode (63%).
-
Экономия токенов:
– обе модели тратят около 54 тыс. выходных токенов на задачу, на ~10% меньше, чем Muse Spark 1.3;
– это меньше, чем у Gemini 4 Argon и Claude Fable 5.1, но больше, чем у GPT-6.1 Sol и GPT-6 Astra;
– Muse Wonder Full расходует на 16% меньше входных токенов, чем Muse Wonder. -
Кодинг: в Coding Agents Index (в Muse Code, максимум рассуждений) Muse Wonder Full набрала 68. Столько же у Claude Code на Sonnet 5.5, у Opus 5.5 – 66, у Muse Wonder – 63, у Muse Code на Spark 1.3 – 54.
-
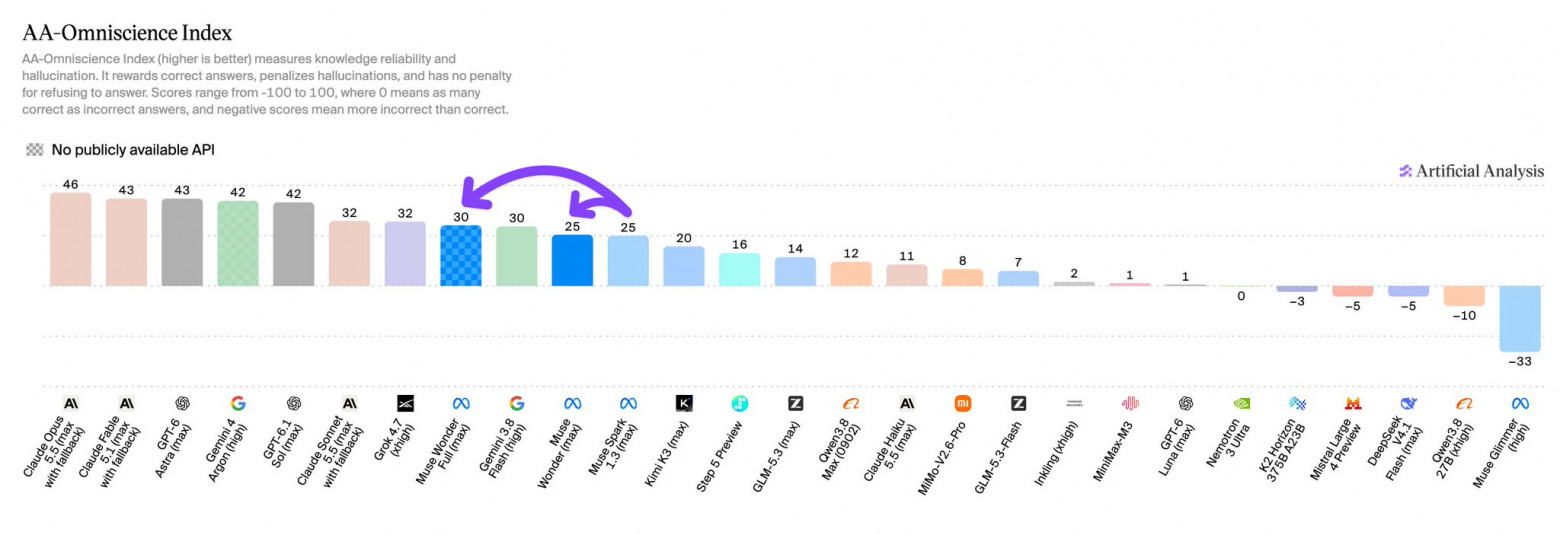
Слабое место – знания. В AA-Omniscience Muse Wonder Full набрала 30, Muse Wonder – 25 (как Spark 1.3). У Claude Opus 5.5 этот показатель 46, у GPT-6 Astra – 43. Зато уровень галлюцинаций у моделей очень низкий.
Бенчмаксинг
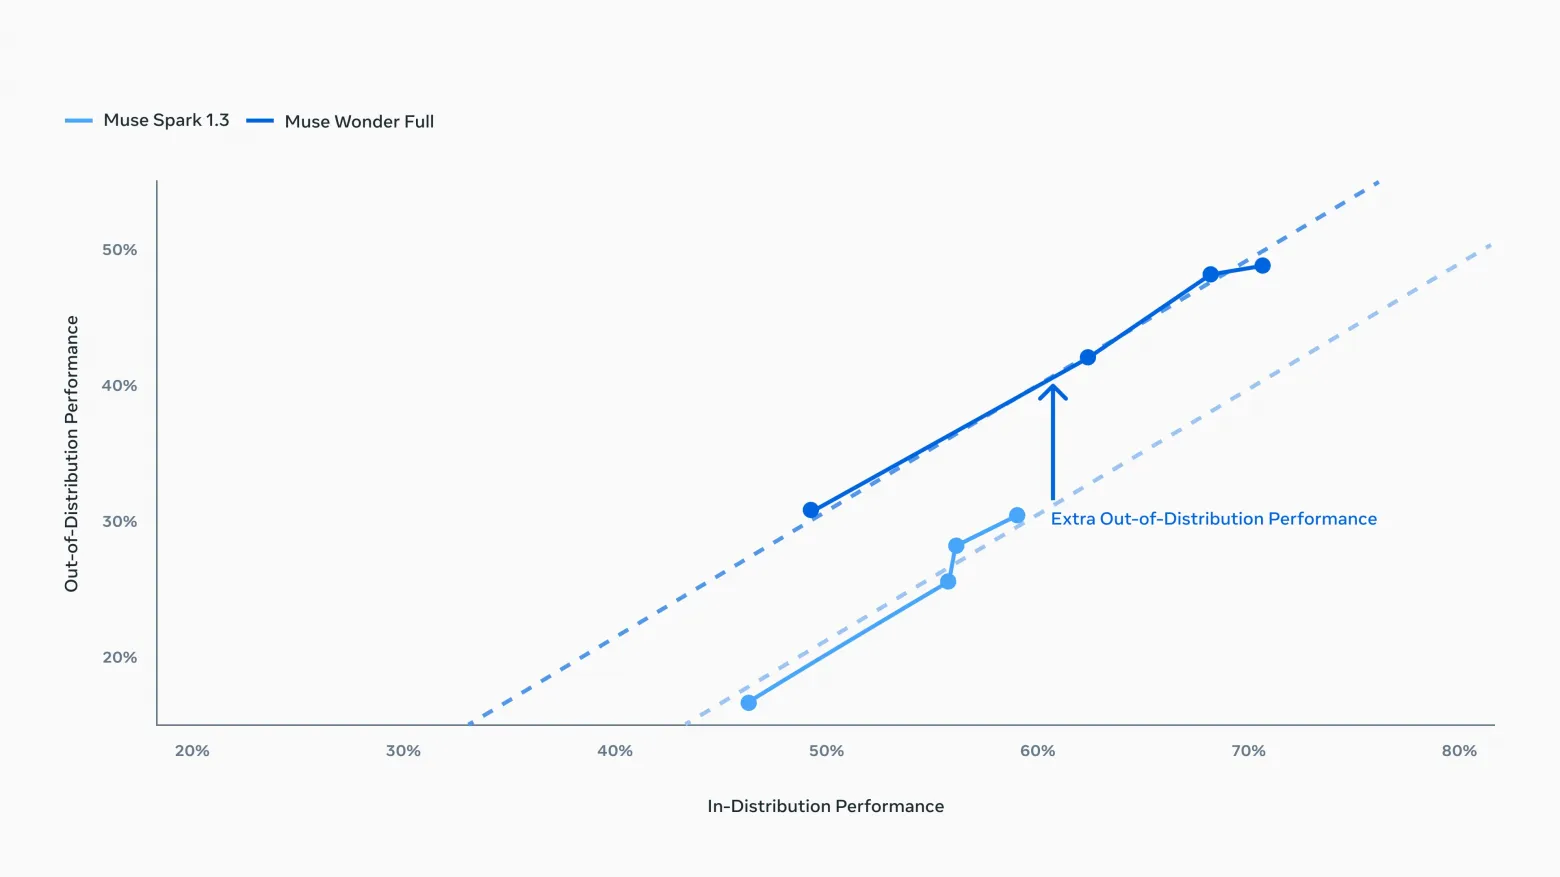
Meta* сама упоминает популярные претензии к бенчмаркам: модели с одинаковыми оценками иногда ведут себя очень по-разному на незнакомых задачах. Чтобы показать эту разницу, Meta* сравнила Muse Spark 1.3 и Muse Wonder Full:
-
по горизонтали – результат на задачах, под которые модель дообучали;
-
по вертикали – среднее на задачах, которые в дообучении не участвовали.
Muse Wonder Full на незнакомых задачах показывает результат лучше, чем предсказывает тренд Muse Spark 1.3. Meta* объясняет это тем, что база крупнее и сильнее, а такая база лучше переносит выигрыш после дообучения на новые задачи.
Открытые веса: пока нет
Веса Muse Wonder и Full не опубликованы. Планов открыть их не объявлено, но Ванг заявил, что компания по-прежнему привержена открытому исходному коду.
Meta* – деятельность компании запрещена в Российской Федерации.
Автор: Master_AI

