


Если вы интересуетесь темой ИИ и данных, то наверняка встречались с таким сервисом как HuggingFace – платформы и сообщества для разработчиков в сфере ИИ, этаким GitHub для ИИ. Она предоставляет централизованный и удобный хаб для обмена, поиска и совместной работы над открытыми моделями машинного обучения, наборами данных и приложениями.
Но она, мягко говоря, не самая удобная для пользователей, сразу понять как работать с сложным интерфейсом бывает сложно. Видишь 800 тысяч моделей, и чувствуешь примерно то же, что человек, который попал впервые на московский оптовый рынок в 1990е – все есть, ничего не понять, все смотрят тебя как на добычу, а с чего начать – нигде не написано. Через двадцать минут ты либо скачал не те датасеты, либо забросил это гиблое дело.
Проблема даже не в том, что HuggingFace сложный, тут больше нюанс что он требует уже понимать и знать платформу. Эта статья – легкий туториал по тому, как пользоваться HuggingFace, и как можно работать с данными и весами на нем, не заблудившись в трех соснах.
HuggingFace сейчас – не совсем платформа исключительно для ML-инженеров. Здесь лежат модели для текста, каринок, аудио и кода, датасеты, демо-приложения и целый зоопарк библиотек. Но это вам не GitHub – HuggingFace рос очень быстро, и платформа разрасталась быстрее, чем ее документация для новичков.
Карточки моделей предполагают, что ты уже знаешь, что такое квантизация, зачем нужен device_map и почему float16 — это не то же самое, что bfloat16. А если не знаешь — вон из батальона ML-инженеров.
Но мы пойдем немного другим путем, разберем что есть вообще, зачем нужна каждая вкладка, затем научимся читать карточку модели так, чтобы не скачать лишние 40 гигабайт. Затем разберем способы запуска – без кода и с кодом, плюс локальный запуск через GGUF и Ollama, если хочется всё под свой контроль.
Кстати, если возиться с локальной установкой и разбираться в квантизациях прямо сейчас не хочется, есть обходной путь: на BotHub открытые модели доступны через чат и OpenAI-совместимый API — без VPN и с оплатой российской картой. По реферальной ссылке дают 300 000 CAPS, так что можно потрогать то, о чём ниже пойдёт речь, ещё до того, как скачаешь первый гигабайт весов.
Что вообще есть на HuggingFace: вкладки
На HuggingFace главные вкладки — это Models, Datasets и Spaces.
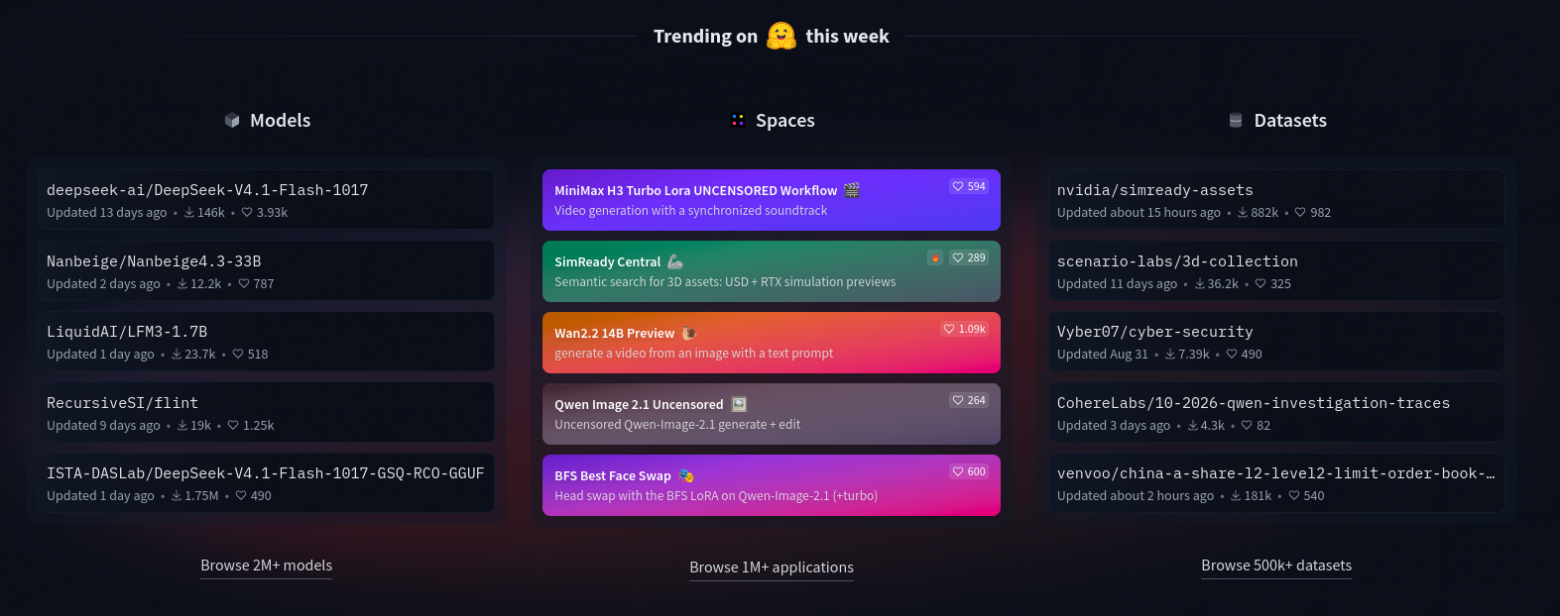
Models (huggingface.co/models) — репозиторий весов. Здесь лежат файлы, которые скачивают и запускают локально или через transformers: Llama, Qwen, Stable Diffusion, Whisper и ещё несколько миллионов чекпоинтов. Модель в этом разделе — набор тензоров и конфигурация, а не готовое приложение. Чтобы она заработала, нужен код, GPU или хотя бы pipeline из Python.
Datasets (huggingface.co/datasets) — хранилище данных для обучения и оценки. Здесь лежат текстовые корпуса, изображения, аудио и таблицы, которые подгружаются одной строкой load_dataset("name"). В этой статье мы эту вкладку не трогаем, ибо она нужна тем, кто собирается файнтюнить или строить свои бенчмарки, а не запускать готовые веса.
Spaces (huggingface.co/spaces) — запущенные демо. Каждый Space — это небольшое веб-приложение на Gradio, Streamlit или Docker, которое крутится на инфраструктуре HuggingFace и открывается в браузере без установки. Модель здесь уже загружена, веса скачаны, GPU выделен. Вы вводите текст или картинку, получаете результат и закрываете вкладку.
Дальше работаем в основном в Models: именно там выбирают, что скачивать и чем платить за железо. Spaces пригодятся, когда захочется потрогать модель до того, как тратить гигабайты на загрузку.
Как читать карточку модели, чтобы не скачать мусор
Давайте разберем карточку модели на конкретном примере – zai-org/GLM-5.3, одну из лучших среди открытых моделей, выпущенная в августе 2026 года.
Сверху вы видите теги: Text Generation, Transformers, Safetensors, English, Chinese, glm_moe_dsa, conversational. Первый тег — Task, то есть задача, под которую обучена модель. Text Generation означает, что модель порождает текст: отвечает на вопросы, дописывает код, ведёт диалог. Если вам нужна суммаризация или классификация, вы ищете другие теги, и от этого зависит, какой класс из библиотеки transformers вы будете загружать. Safetensors — это формат хранения весов, который пришёл на смену pytorch_model.bin и считается более безопасным и быстрым при загрузке. glm_moe_dsa — архитектурный тег, о нём ниже.
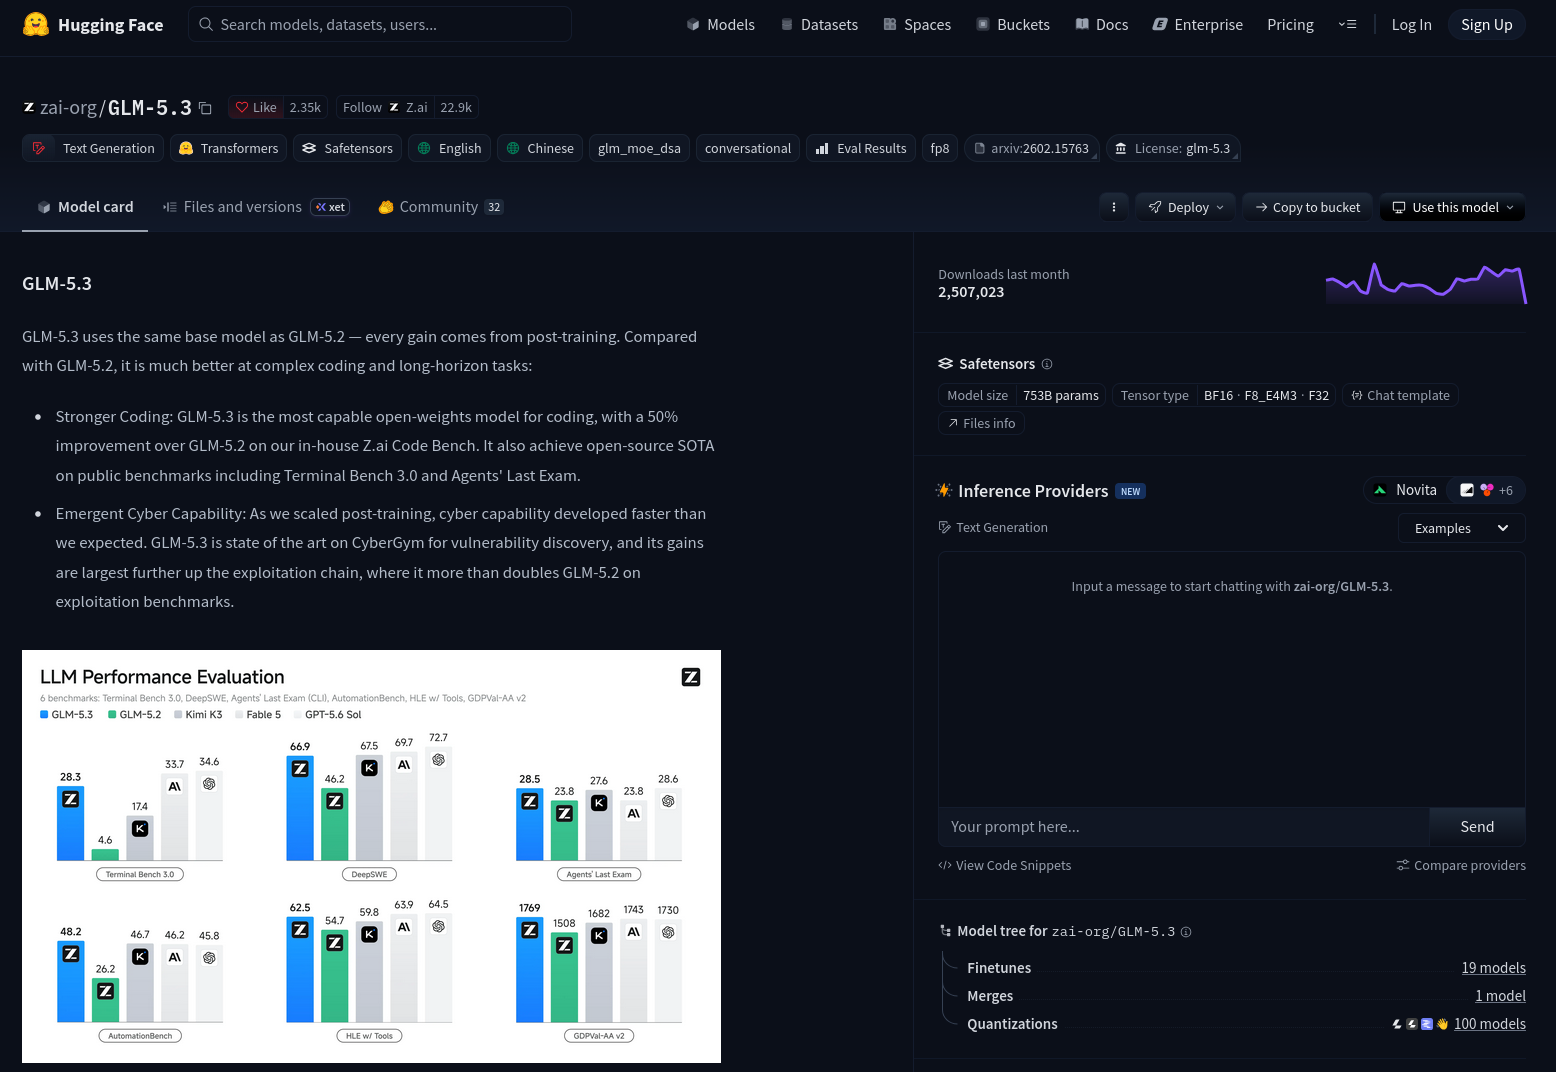
У GLM-5.3 тег License: glm-5.3 ведёт на отдельный документ, то есть на свою, кастомную лицензия Z.ai, которая разрешает коммерческое использование с оговорками (в частности, с пунктом о выручке в десять миллиардов долларов, после которого условия меняются).
Не менее важна и популярность модели. В данном примере на время написание статьи было Downloads last month: 2,507,023. Два с половиной миллиона скачиваний за месяц — это грубый, но работающий индикатор того, что модель не сломана и по ней есть ответы в обсуждениях. Если модель скачали пятьсот раз и в issues тишина, скорее всего, вы будете первым, кто наткнётся на баг. Но популярность ничего не говорит о том, подходит ли модель под вашу задачу.
Также важен размер модели. На скриншоте в блоке Safetensors можно увидеть строку Model size 753B params. Это общее число параметров модели, но модель использует архитектуру MoE (Mixture of Experts, смесь экспертов), где на каждом шаге генерации активируется только часть весов — около 40 миллиардов параметров. Именно поэтому 753-миллиардная модель в некоторых конфигурациях может работать быстрее, чем плотная модель сопоставимого размера. Но для локального запуска это всё равно означает, что вам понадобится не ноутбук, а сервер с большим объёмом памяти.
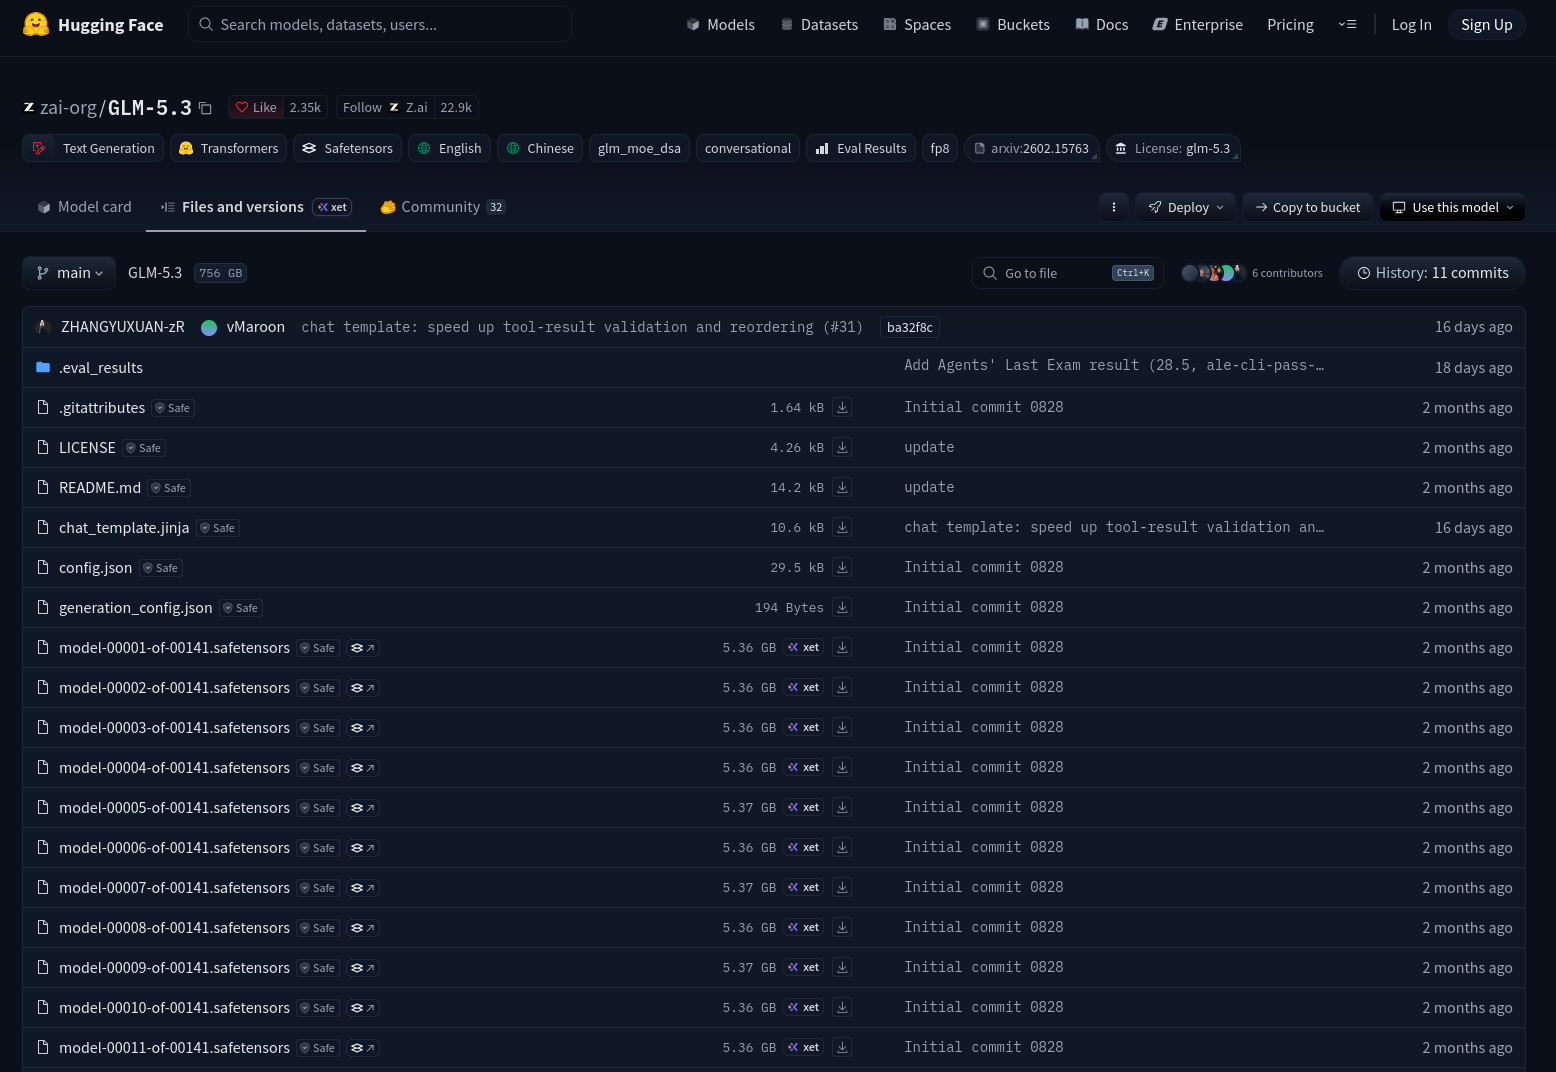
Изображение выше показывает вкладку Files and versions. Здесь видно, что веса разбиты на шарды — файлы model-00001-of-00141.safetensors и далее, каждый примерно по 5,36 ГБ. Всего таких файлов больше сотни, и общий размер снапшота превышает двести гигабайт. Если вы нажмёте «скачать» не глядя, вы получите именно эти двести гигабайт. Для локального запуска почти всегда нужна квантованная версия — та, где веса сжаты с потерей точности. На изображении 5, в выпадающем меню Use this model, есть отдельный пункт Browse Quantizations, который ведёт к версиям для llama.cpp, Ollama и LM Studio. Квант GLM-5.3 в формате GGUF может занимать уже не двести гигабайт, а 97, или даже меньше, в зависимости от уровня сжатия.
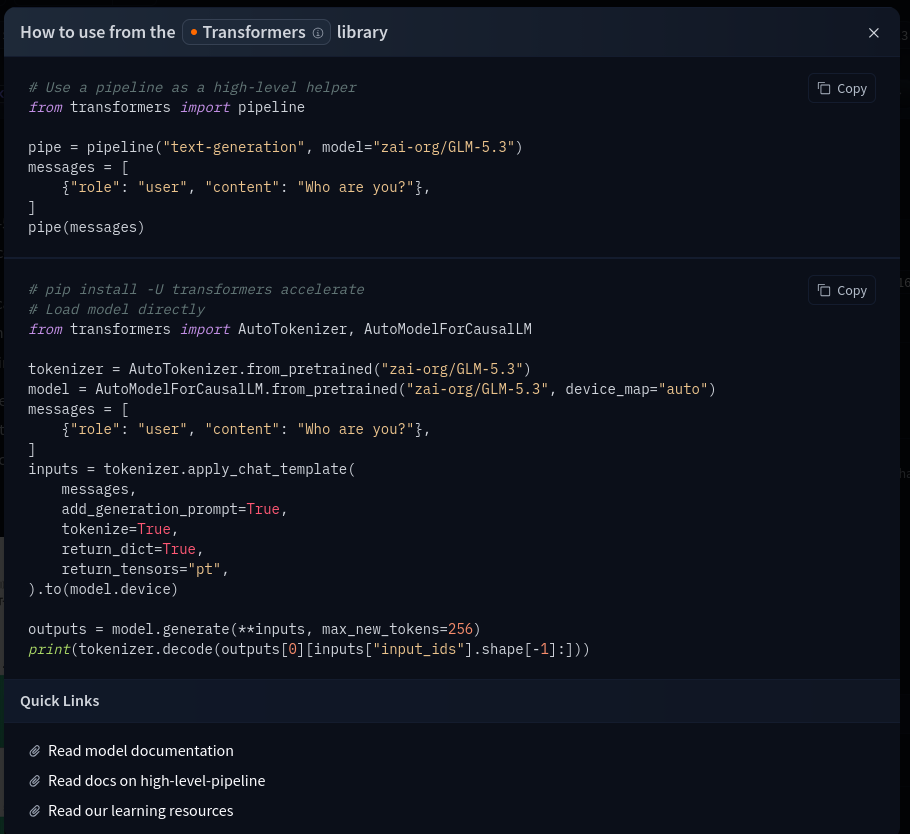
Этот скрин выше уже является модальным окно с кодом для transformers. Здесь показаны два подхода. Первый — высокоуровневый pipeline: две строки, и модель готова принимать сообщения в формате чата. Второй — более ручной, с AutoTokenizer и AutoModelForCausalLM, где вы сами управляете токенизацией и генерацией. Для старта достаточно pipeline, потому что он сам подтягивает нужный класс модели и токенизатор. Но перед запуском этого кода нужно ответить на предыдущие вопросы: влезет ли модель в вашу память, есть ли у вас GPU и устраивает ли вас лицензия.
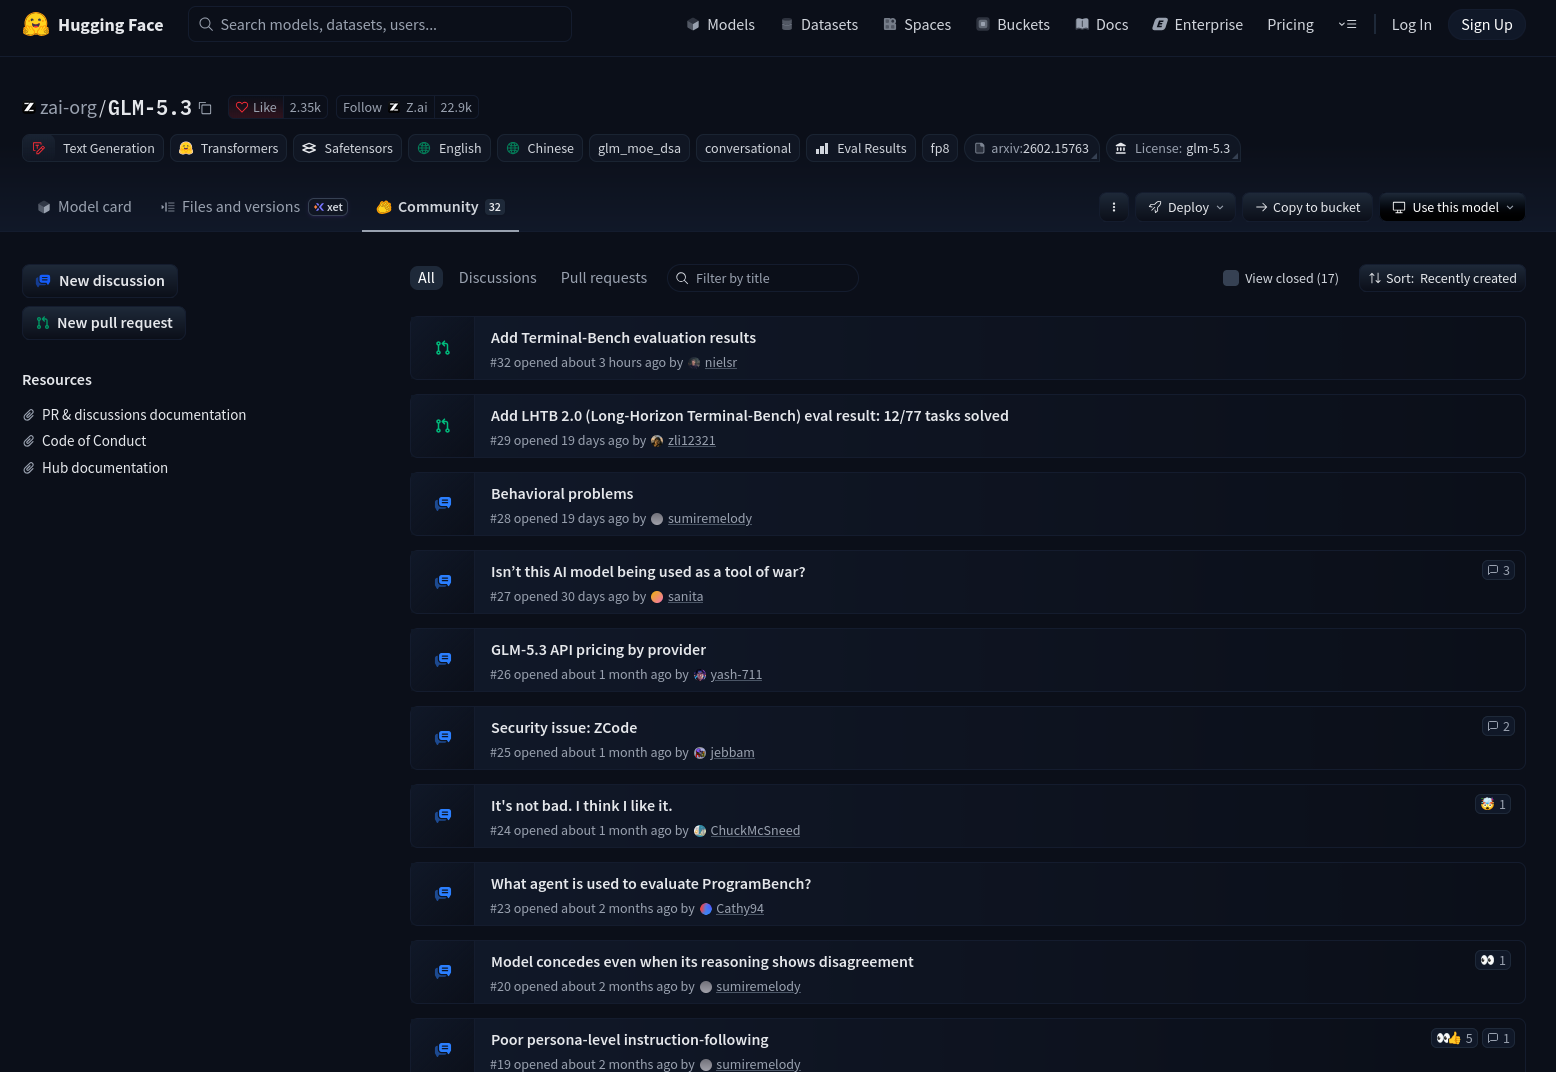
Следующее изображение (выше) — вкладка Community. Это необязательный, но полезный сигнал, ведь если в обсуждениях десятки тредов с вопросами о поведении модели, странностях в tool-calling или проблемах с длинным контекстом, вы получаете бесплатный список граблей, на которые уже наступили другие. У GLM-5.3 в community есть треды про поведение, про использование в качестве «инструмента войны» и про цены у разных провайдеров. Читать всё подряд не нужно, но пробежать заголовки стоит.
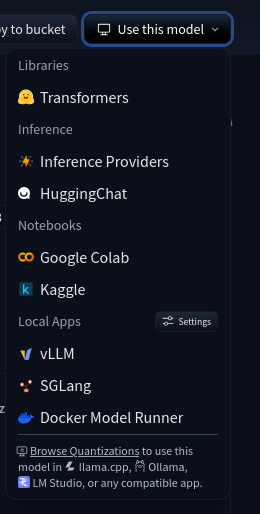
Ну и есть меню Use this model. Оно показывает, что одну и ту же модель можно запустить через Transformers, через Inference Providers (облачные API), через Google Colab или Kaggle, локально через vLLM, SGLang, Docker Model Runner или через квантованные сборки для Ollama и llama.cpp.
Простое правило, которое экономит первый вечер, это банально сначала отфильтровать модели по задаче, потом отсортировать по загрузкам, после проверить лицензию и размер. Если модель больше семи миллиардов параметров, а у вас не самая мощная машина, смотрите в сторону квантованных версий или облачных провайдеров.
Развилка первая: запустить без кода
Но вот если хотите запустить, так еще и без кода, на HuggingFace эту задачу решают две вещи. Первый — Spaces, второй — Inference API. Оба избавляют от установки зависимостей и возни с виртуальными окружениями, но устроены совершенно по-разному.
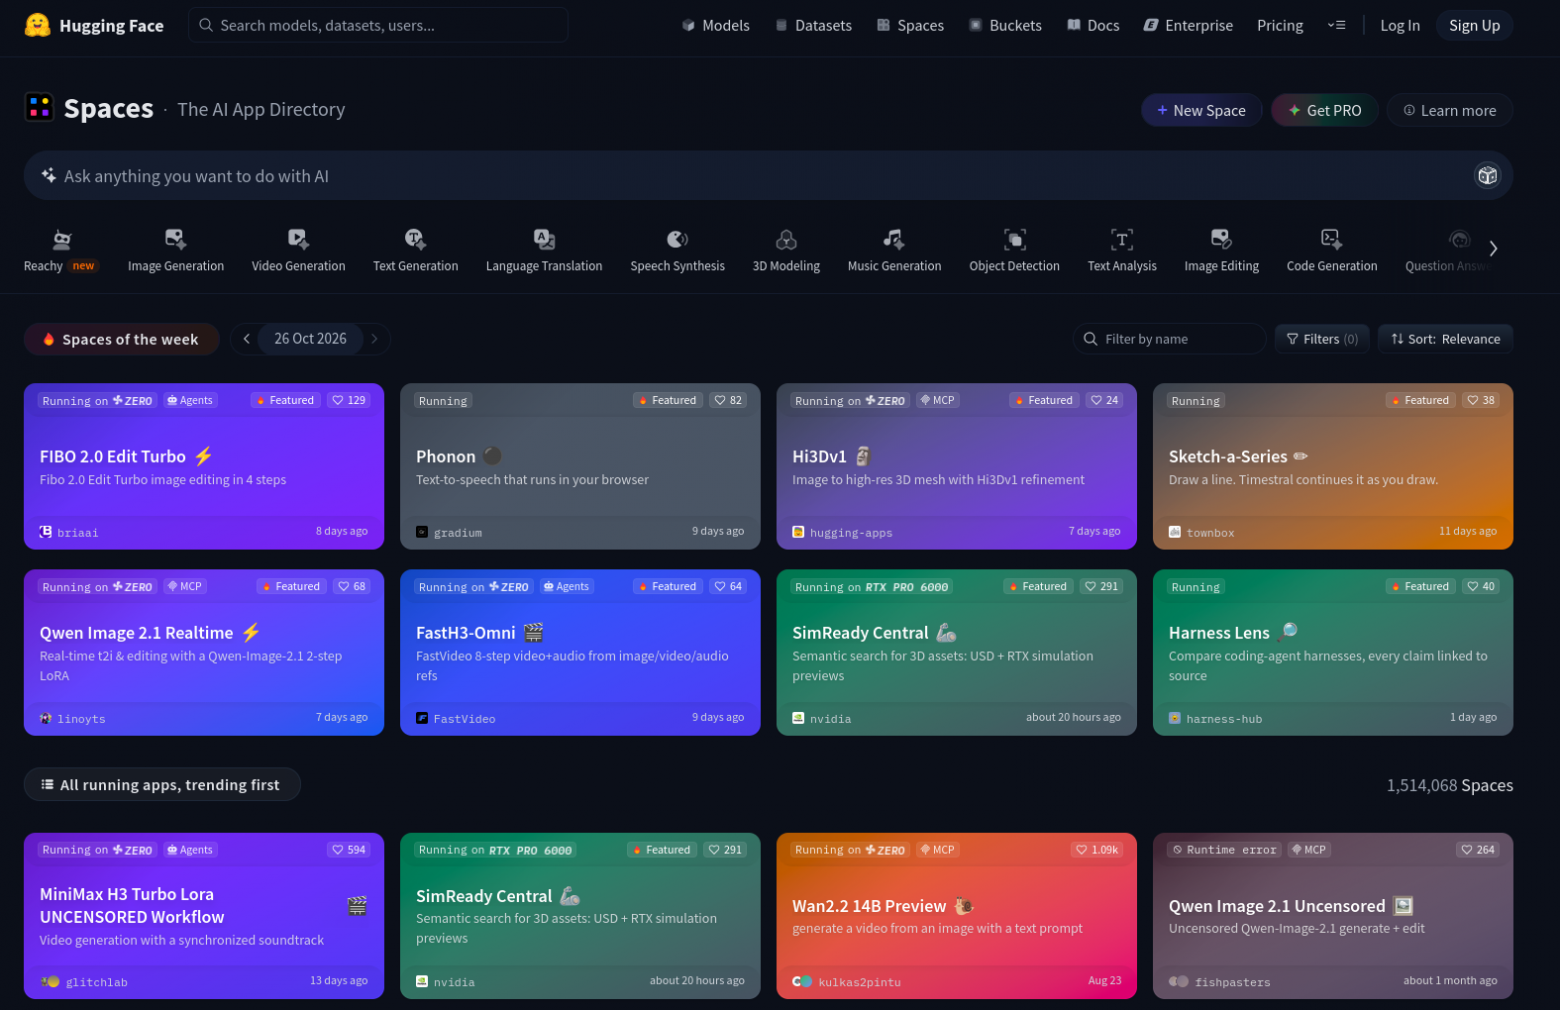
На скриншоте каталог Spaces. Здесь больше полутора миллионов приложений, и они разбиты по категориям, где-то генерация изображений, видео, текста, синтез речи, 3D-моделирование, анализ кода. Каждый Space — это Git-репозиторий с приложением на Gradio, Docker или Static SDK. Внутри уже загружены веса, выделен GPU или CPU, и всё это крутится на инфраструктуре HuggingFace. Вы открываете страницу в браузере, вводите запрос и получаете результат.
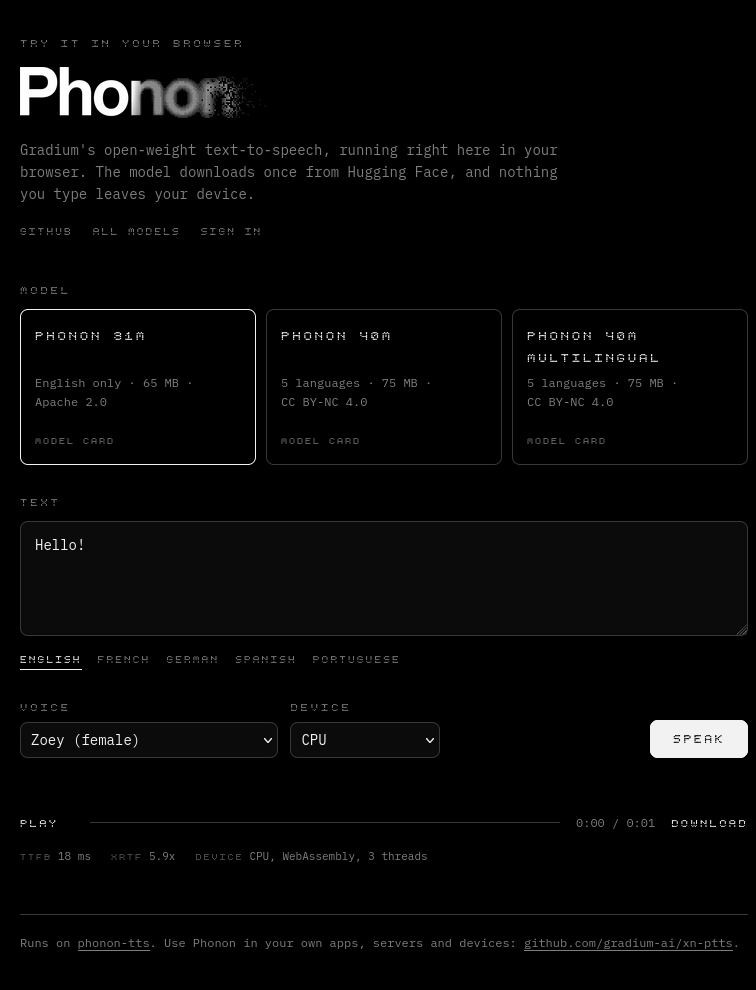
Возьмём конкретный пример — Phonon. Это семейство моделей для синтеза речи от французской компании Gradium, которое вышло в октябре 2026 года. Вверху три варианта модели: Phonon 31M (английский, 65 МБ, лицензия Apache 2.0), Phonon 40M (пять языков, 75 МБ, CC BY-NC 4.0) и Phonon 40M Multilingual (те же пять языков, но с расширенными настройками). Вы выбираете модель, вводите текст в поле, нажимаете Speak — и через пару секунд слышите голос. Внизу видно, как идёт загрузка: Downloading Phonon 31M: 1 of 65 MB. Модель скачивается один раз и дальше работает локально в вашем браузере. Под полем ввода есть выбор голоса (Zoey, female) и устройства (CPU). В самом низу — техническая строка: TTS - WRTF - DEVICE CPU, WebAssembly. WebAssembly — это бинарный формат, который выполняется в браузере с почти нативной скоростью; именно он позволяет Phonon работать без сервера и без Python. Inference-стек написан на Rust и скомпилирован в WebAssembly, поэтому модель запускается прямо в вашей вкладке.
Такие Spaces — лучший способ проверить, как модель звучит, выглядит или отвечает, до того как вы потратите время на установку. Правда есть нюанс – не все Spaces стабильны. Некоторые падают через неделю после публикации, некоторые работают только с VPN, некоторые требуют авторизации. Но для быстрой проверки вполне достаточно
Но есть второй инструмент — Inference API, который в документации теперь называется Inference Providers. Это способ вызвать модель по HTTP, вообще не открывая браузер. Вы отправляете POST-запрос на сервер HuggingFace, сервер сам загружает модель, прогоняет её через свои GPU и возвращает ответ. Веса не скачиваются, окружение не настраивается, нужен только токен.
Самый короткий пример — curl. Сначала получите токен на странице huggingface.co/settings/tokens и положите его в переменную окружения HF_TOKEN. Затем:
curl https://router.huggingface.co/v1/chat/completions
  -H "Authorization: Bearer $HF_TOKEN"
  -H "Content-Type: application/json"
  -d '{
    "model": "deepseek-ai/DeepSeek-V3-0324",
    "messages": [{"role": "user", "content": "Кто ты?"}]
  }'
Несколько строк, и модель отвечает. Кстати, эндпоинт router.huggingface.co/v1/chat/completions совместим с форматом OpenAI, поэтому тот же запрос можно отправить через библиотеку openai, просто поменяв base_url. Если предпочитаете Python и не хотите ставить лишние пакеты, есть huggingface_hub:
from huggingface_hub import InferenceClient
import os

client = InferenceClient(api_key=os.environ["HF_TOKEN"])
response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V3-0324",
    messages=[{"role": "user", "content": "Кто ты?"}]
)
print(response.choices[0].message.content)
InferenceClient — это официальный SDK, который сам выбирает лучшего провайдера из доступных для конкретной модели. Провайдеры — это партнёрские серверы (Novita, Cerebras, DeepInfra и другие), которые хостят модели и выставляют счёт за токены. У бесплатных аккаунтов есть лимит запросов в месяц; для продакшена нужен платный план или собственный эндпоинт.
Оба инструмента достаточно полезны и интересны, и вы вольны выбирать что вам нужно.
Локальный запуск: GGUF, Ollama, llama.cpp
А вот если хочется локально запустить на своей машине модель, то эти три слова будут вам попадаться постоянно.
GGUF (GPT-Generated Unified Format) — это формат файла, в котором лежат квантованные веса модели плюс метаданные: конфигурация, словарь токенизатора и всё остальное, что нужно для запуска. Раньше веса хранили в pytorch_model.bin или safetensors, но для локального инференса на CPU или слабой видеокарте нужен был формат, который умеет быстро читать сжатые тензоры. GGUF — это «single-file format», один файл, внутри которого и архитектура, и веса, и настройки. Его понимают llama.cpp, Ollama, LM Studio и ещё десяток обёрток.
Квантование в GGUF бывает разным. Q4_K_M — самый ходовой компромисс между размером и качеством, Q8_0 почти без потерь, но тяжелее, IQ3_M или Q3_K_S — для машин с малым объёмом памяти. На Хабре и в документации HuggingFace (раздел про квантизацию) есть таблицы с размерами, но практическое правило простое: если модель в Q4_K_M весит больше, чем у вас есть оперативной памяти, берите квант поагрессивнее или смотрите в сторону облачных провайдеров.
Ollama — это обёртка над llama.cpp, которая убирает всю возню со сборкой. Вы ставите приложение, открываете терминал и пишете одну команду. Синтаксис для моделей с HuggingFace выглядит так: ollama run hf.co/{username}/{repository}. Например, для квантованной Llama 3.2:
ollama run hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF
Если в репозитории несколько квантов, можно указать конкретный тег: ollama run hf.co/bartowski/Llama-3.2-3B-Instruct-GGUF:Q8_0. Ollama по умолчанию возьмёт Q4_K_M, если он есть в репозитории, а если нет — выберет разумный вариант из доступных. Это описано в документации HuggingFace по интеграции с Ollama. Работает на macOS, Linux и Windows. Внутри Ollama держит собственную сборку llama.cpp, которую обновляет вместе с релизами, так что вам не нужно ничего компилировать.
llama.cpp — это движок, на котором всё работает. Ollama его использует, но сам llama.cpp даёт больше контроля: можно выбрать бэкенд (CUDA, Vulkan, Metal, SYCL), настроить количество слоёв на GPU (-ngl), включить спекулятивное декодирование или запустить сервер с OpenAI-совместимым API. Сборка требует cmake и компилятора. Но это позволяет разыграться по полной, почти максимальный простор для оптимизаций.
Отдельная песня — гибридные архитектуры. Если модель использует нестандартную комбинацию слоёв (как Gemma 4 Hybrid или Zamba2), стоковый llama.cpp может не знать, что с ней делать, и упадёт с ошибкой unknown model architecture. Это может быть произойти потому, что архитектура появилась позже, чем последний релиз движка. Решение — либо взять патченную сборку от авторов модели, либо дождаться, пока поддержку добавят в upstream.
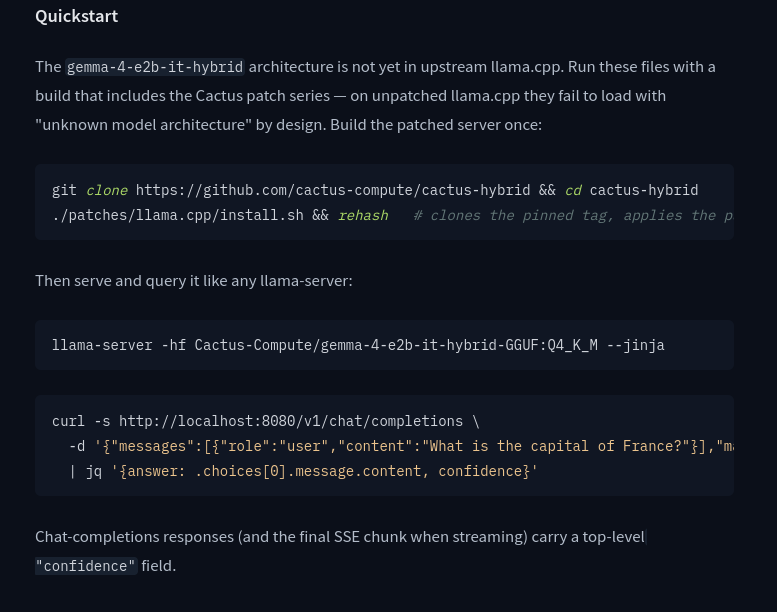
Например, для Gemma 4 E2B Hybrid в карточке модели прямо сказано: «Run these files with a build that includes the Cactus patch series — on unpatched llama.cpp they fail to load with “unknown model architecture” by design». Так что если видите такую ошибку, первым делом проверьте, не гибридная ли у вас архитектура и есть ли для неё патч.
Где новичок обычно спотыкается
Вот и все что стоит знать на первых порах. Безусловно, там еще много всего есть, но это уже темы для отдельных статей. А сейчас – время поговорить об ошибках.
Первое, что ломает планы, — скачивание full-precision вместо квантованной версии. Веса в float16 (половинная точность) занимают вдвое больше места, чем в float32, но для локального запуска даже этого мало. Модель на 7 миллиардов параметров в FP16 весит около 14 ГБ, а ее квантованный аналог Q4_K_M — примерно 4,1 ГБ, при этом деградация качества составляет всего +1.68% по метрике перплексии (perp Lexity — насколько модель «удивляется» тексту; чем ниже, тем лучше). Разница в размере в три с половиной раза при почти незаметной потере качества — кванты выигрывают по всем фронтам. Исключение — задачи, где важна абсолютная точность на уровне FP16, но для знакомства с моделью это не тот случай.
Второй капкан — параметр max_new_tokens. Если его не указать, модель будет генерировать до тех пор, пока не упрется в max_length из конфигурации генерации, а этот лимит может быть выставлен на 512 или 1024 токена. Вы ждете ответа, который должен был занять пять секунд, а проходит двадцать. Документация HuggingFace прямо рекомендует использовать max_new_tokens для контроля длины, а max_length оставить для обратной совместимости. Забыли выставить — получили генерацию на километр длиннее, чем нужно.
Следующая ошибка — скачать base-модель, когда нужна instruct-версия. Base-модель обучена предсказывать следующий токен на сыром тексте: она продолжает строку, а не отвечает на вопрос. Instruct-версия дообучена на инструкциях и диалогах, поэтому ведет себя как ассистент. Если вы дадите base-модели промпт «Кто ты?», она может выдать что-то вроде «Кто ты? — спросил он, входя в комнату», потому что для нее это начало рассказа, а не запрос к собеседнику. Проверяйте суффикс -Instruct или -Chat в названии репозитория.
Отдельная история — выбор по цифре из лидерборда. Бенчмарки вроде MMLU или HumanEval страдают от загрязнения данных, когда вопросы из тестовых наборов попадают в обучающие корпуса, и модель «запоминает» ответы, а не учится решать задачу.
И последнее — квант от анонима. Q2_K весит 2,7 ГБ против 4,1 ГБ у Q4_K_M, но перплексия растет на 15,3% вместо 1,68%, и руководства по квантизации прямо помечают Q2_K как «not recommended». Если модель «тупит» после скачивания сомнительного кванта, проблема может быть в кванте, а не в архитектуре. Берите Q4_K_M от известных команд вроде bartowski или TheBloke — у них есть репутация и обратная связь в комментариях.
Если возиться с зависимостями, квантами и device_map прямо сейчас не хочется, а попробовать открытые модели уже интересно, есть обходной путь: на BotHub доступны открытые модели через чат и OpenAI-совместимый API, без VPN и с оплатой российской картой. По реферальной ссылке дают 300 000 CAPS, так что можно потрогать то, о чем шла речь в статье, еще до скачивания первого гигабайта весов.
Заключение
HuggingFace — все еще похож на GitHub, но ИИ-сфера требует более сложный функционал. Платформа выросла до полутора миллионов Spaces и миллионов чекпоинтов, и документация не успевает за этим ростом. Но маршрут, который избавляет от слепого блуждания, на самом деле короткий. Фильтр по задаче, проверка карточки (лицензия, размер, формат), выбор между API и локальным запуском. После этого Hub перестает быть оптовым рынком из девяностых и становится тем, чем задумывался — рабочим инструментом, повторяющим схему использования GitHub.
Автор: DrArgentum

