


Обложка сгенерирована с помощью ИИ
Я студент РТУ МИРЭА, и мне показалась интересной эта тема, поэтому решил разобрать её подробно.
Статья получилась большой, поэтому я разбил её на две части. Это часть 1 из 2: что именно произошло в экспериментах MIT, что на самом деле лежит в диффе отредактированной модели и какая математика стоит за «вычитанием направления». Во второй части — почему правка лечит зацикливание, почему так нельзя добавить навык, связь с ROME и task arithmetic, как устроены веса Qwen, Gemma, Llama и MoE, риски и открытые вопросы.
2 ноября 2026 года четверо исследователей из MIT CSAIL — Rikiya Takehi, Jayden Teoh, Alex Zhang и Omar Khattab — выложили пост «Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights» [1]. Суть такая: фронтирная LLM (в посте она называется GPT-6 Astra) читает сырые веса чужой нейросети и правит их руками. Без градиентов, без обучения, иногда даже без единого прогона среды.
Чтобы не пересказывать заголовки, я сделал три вещи:
-
Прочитал сам пост и открытые логи экспериментов [2], включая манифест итоговой правки.
-
Скачал базовую Qwen3.5-0.8B и опубликованный отредактированный чекпойнт [3] и побитово сравнил их. Оказалось, что правка — это не просто «убрать направление»: коэффициент там ≈ 6, и знак компоненты переворачивается. Подробности ниже.
-
Вывел математику: почему такая правка вообще работает, почему она минимальна, почему она может вылечить зацикливание и почему не может «вложить» в модель отсутствующий навык.
Дальше в тексте помечаю, что к какому типу относится:
-
[Статья] — эмпирика авторов, цифры дословно из поста или логов;
-
[Доказано] — математический факт с выводом;
-
[Мой замер] — то, что я посчитал сам (код лежит рядом со статьёй);
-
[Модель/интерпретация] — мои допущения и игрушечные модели. Это не результаты.
Математика идёт в два слоя: сначала строгий вариант для тех, кто в теме, затем блок «Если по-простому» для тех, кто не хочет вникать.
Часть 1. Что случилось: три эксперимента
Эксперимент 8: Qwen3.5-0.8B, которая думала до упора
[Статья] Авторы взяли Qwen3.5-0.8B (24 слоя, около 0.8 млрд весов, режим thinking включён) и дали Astra задачу: «сделай модель лучше в математике, редактируя веса напрямую». Были жёсткие ограничения:
-
Python-сессия над весами, только CPU, не больше 300 запусков кода;
-
никакого обучения: запрещены backward, autograd, оптимизаторы и итеративная подгонка весов под лосс;
-
практические задачи: 7 469 из GSM8K train и 7 275 из MATH train. Тестовые бенчмарки Astra не видела;
-
бюджет прогонов модели: 10, 25 или 50 (три разных запуска). Один прогон — это генерация ответов на ≤512 задач или teacher-forced чтение ≤1 024 текстов с логпробами, скрытыми состояниями и активациями MLP;
-
save_editотклонял правки финальной нормы, эмбеддингов/выходного слоя и умножение целого тензора на константу.
Оценка: vLLM, temperature 0.6, top-p 0.95, top-k 20, presence penalty 1.5, до 32 768 новых токенов.
Astra начала с диагностики. Базовая модель зацикливается: из её первых 96 практических ответов 85 упёрлись в лимит 32 768 токенов. В карточке Qwen об этом есть отдельное предупреждение: модель склонна к thinking loops. Astra нашла направление в residual stream, которое MLP слоёв 15 и 19 записывают при зацикливании, и вычла его из 64 выходных столбцов down_proj в каждом из двух слоёв. Получилось 131 072 веса, 0.016 % модели.
|
Qwen3.5-0.8B |
MATH-500 |
GSM8K |
IFEval |
Упёрлись в лимит токенов (MATH-500) |
|---|---|---|---|---|
|
База |
7.9 |
13.8 |
21.0 |
93.0 |
|
Правка, 10 прогонов |
12.3 |
25.7 |
49.0 |
87.2 |
|
Правка, 25 прогонов |
14.1 |
25.1 |
39.9 |
86.4 |
|
Правка, 50 прогонов |
48.1 |
67.1 |
62.3 |
33.1 |
Из логов [2] видно, что в трёх запусках получились три разные правки:
-
10 прогонов: вычитание «направления повторов» из 30 выходных матриц (внимание и MLP) слоёв 8–22 по формуле
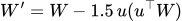 ;
-
25 прогонов: отключение головы внимания 7 в слое 15 (обнулены её 256 выходных столбцов);
-
50 прогонов: 64 столбца MLP в слоях 15 и 19.
На других бенчмарках у правки из 50 прогонов тоже рост: AMC23 0.5 → 23.4, Minerva 1.5 → 25.4, OlympiadBench 1.3 → 21.8, MMLU-Pro 40.3 → 45.5, GPQA Diamond 22.7 → 36.6.
Отдельно стоит отметить самопроверку Astra на 1 152 отложенных практических задачах [2, final_answer.md]: 579 «спасённых» задач против 5 регрессий, и 576 из 579 спасённых — это ответы, которые раньше обрывались по лимиту. Точность на ответах, которые и до правки доходили до конца, не изменилась. Запомним этот факт: к нему мы вернёмся во второй части статьи, когда будем разбирать петли.
Независимая проверка: Ahsen Khaliq (Hugging Face) пересобрал чекпойнт из логов со сверкой sha256 и перепрогнал полный MATH-500 (500 × 4 сэмпла) на H200. Вышло 51.0 %, лимит выбили 31.6 % ответов [3].
Эксперимент 4: машинка, которая не умела сдать назад
[Статья] Среда Kinetix, уровень «машинка и рампа». Чтобы перепрыгнуть красную полосу, машине нужно сначала откатиться назад и набрать разгон. Официальный PPO обучался 1 млрд шагов и застрял в локальном минимуме: едет прямо на рампу и глохнет. Успехов 0 из 256 эпизодов.
Сеть — официальный актор Kinetix: 679 → 128 (ReLU) → пять слоёв по 128 (tanh) → 16. Сверим число весов:
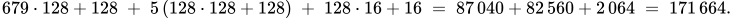
Совпадает с постом. Astra получила все веса, описание сцены и один записанный эпизод. Один ответ, без инструментов. Она изменила 3.5 % весов и добавила маленький обходной путь через несколько юнитов в каждом слое. Этот путь читает позицию и скорость машины, командует «назад, потом полный вперёд», а когда зелёное колесо проезжает красную полосу, отключается, и дальше машину ведёт исходная сеть. Итог: 1 024 из 1 024 успешных эпизодов.
Дополнительный эксперимент: Gemma 3 270M, где всё сломалось
[Статья] Тот же протокол применили к Gemma 3 270M IT. Модель примерно втрое меньше и почти не зацикливается: в лимит (здесь 8 192 токена, сэмплинг из карточки: T = 1.0, top-k 64, top-p 0.95) упираются только 8.5 % ответов. У Qwen таких 93 %.
|
Gemma 3 270M |
MATH-500 |
|---|---|
|
База |
6.8 |
|
5 прогонов |
7.0 |
|
10 прогонов |
7.6 |
|
25 прогонов |
7.7 |
|
50 прогонов |
7.0 |
Читая ошибки Gemma, Astra нашла обычные ошибки рассуждения: неверную арифметику и некорректные алгебраические шаги. Единого компонента, который можно было бы выключить, там не было. Правки получались мелкими (например, удвоить один нейрон, реагирующий на числа), и сама Astra оценила прирост как неустановленный. Вывод авторов: правка весов может убрать препятствие, за которым пряталась способность, но не может добавить способность, которой у модели нет.
Для полноты: в посте есть и «читающие» эксперименты. Astra по весам MLP 500→32→32→5 (17 253 веса — 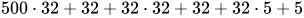 , сходится) угадывает игру, по весам диффузионки — рисуемую фигуру, в char-level трансформере без входного и выходного слоёв находит induction heads. Кроме того, она с нуля пишет сети для MinAtar и для го 9×9. Но дальше нас интересует именно механика правки, поэтому остальное оставлю за кадром.
Часть 2. Что на самом деле лежит в диффе (мой разбор чекпойнта)
[Мой замер] Опубликованный чекпойнт отличается от Qwen/Qwen3.5-0.8B ровно двумя тензорами [3]: layers.15.mlp.down_proj.weight и layers.19.mlp.down_proj.weight, оба формы  . Я посчитал
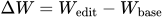 (код:
code/analyze_edit.py).
D = W2 - W                                   # 1024 x 3584
cols = (D.abs().sum(0) > 0).nonzero().flatten()   # какие столбцы тронуты
S = torch.linalg.svdvals(D[:, cols])          # спектр правки
U, _, _ = torch.linalg.svd(D[:, cols], full_matrices=False)
v = U[:, 0]                                   # направление правки
a = -(v @ D[:, cols]).dot(v @ W[:, cols]) / (v @ W[:, cols]).pow(2).sum()
Что получилось:
|
|
слой 15 |
слой 19 |
|---|---|---|
|
изменённых столбцов |
64 |
64 |
|
изменённых bf16-значений |
65 260 |
64 928 |
|
доля энергии |
0.999994 |
0.999991 |
|
|
5.6·10⁻⁴ |
6.4·10⁻⁴ |
|
подогнанный коэффициент |
6.0003 |
6.0002 |
|
относительная невязка такой модели |
0.23 % |
0.29 % |
|
|
0.106 |
0.081 |


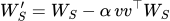
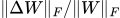
Почему 131 072 = 2 × 64 × 1 024, а изменённых значений 130 188: при округлении в bfloat16 часть элементов вернулась к прежнему значению. Это совпадает с манифестом из логов. Направления в двух слоях близки: 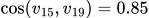 .
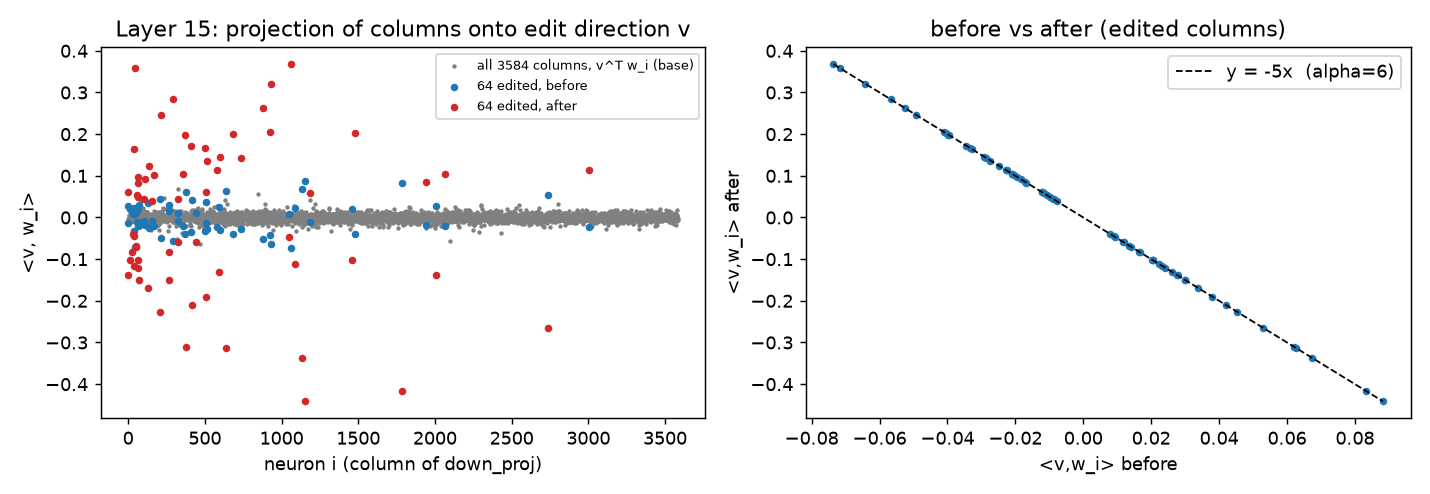
Рис. 1. Слой 15. Слева:  для всех 3 584 столбцов (серые), отдельно 64 изменённых до (синие) и после (красные) правки. Справа: «после» против «до» лежат на прямой
 .
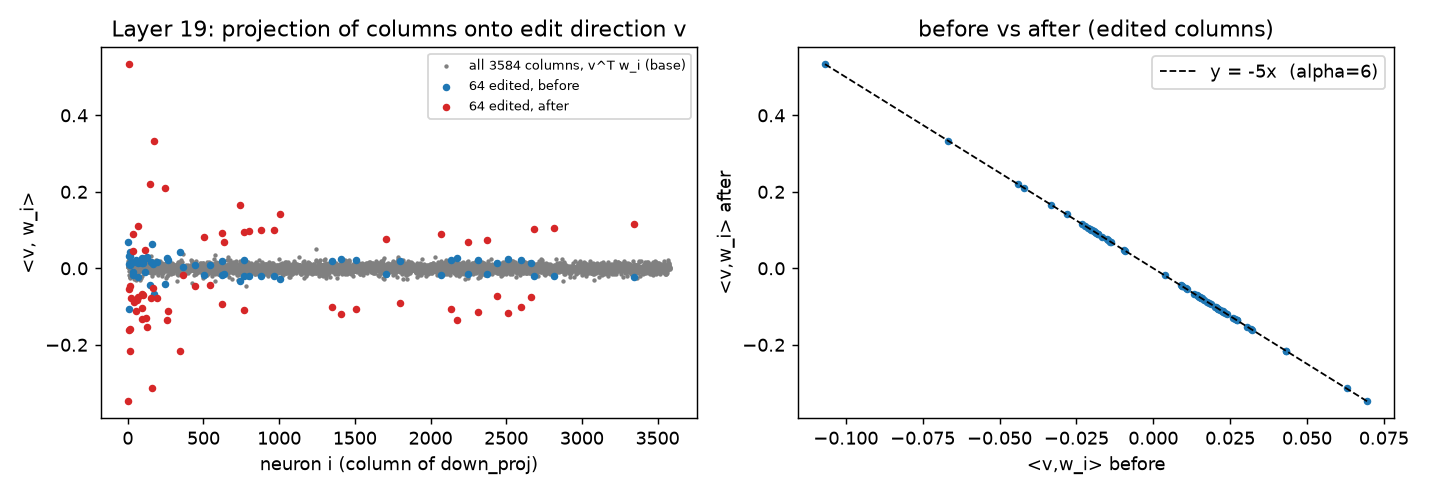
Рис. 2. То же для слоя 19.
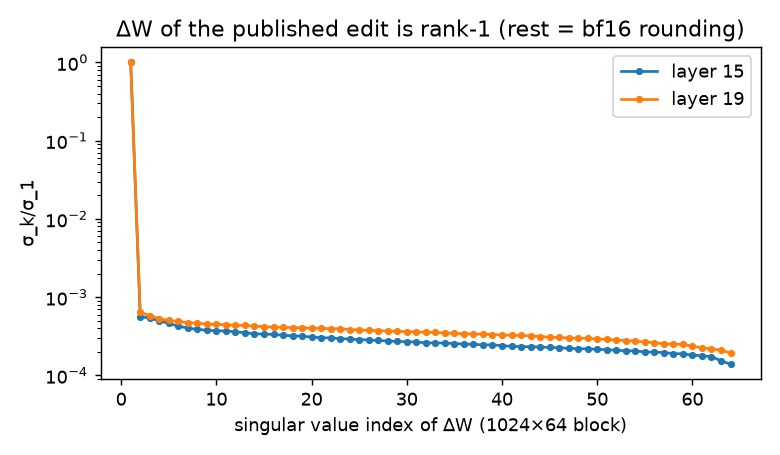
Рис. 3. Сингулярные числа  (блок 1024×64). Правка — чистый ранг 1, хвост на уровне 10⁻³·σ₁ даёт округление bf16.
Вывод из этих замеров [Мой замер + интерпретация]: на тронутых столбцах правка имеет вид
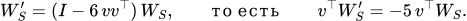
Это не «обнулить проекцию» (тогда было бы  ). Компонента вдоль
 переворачивается и усиливается в 5 раз. В посте и в README это описано словом «subtracted», и формально так и есть:
 вычтено. Но геометрически это сильнее абляции. Тронуты не самые «тяжёлые» нейроны: медианный ранг выбранных столбцов по норме — 2 560 из 3 584 для слоя 15 и 2 245 для слоя 19. Отбор шёл по тому, насколько столбец пишет в
 («the 64 output columns per layer … that write it most» [2]), а не по норме.
Часть 3. Как устроен трансформер с точки зрения правки весов
Чтобы понять, почему правка 64 столбцов в двух слоях вообще на что-то влияет, нужна одна картинка: как информация течёт через модель.
3.1. Residual stream: модель как сумма записей
[Доказано, следует из архитектуры] В Qwen, Llama и Gemma каждый слой не заменяет состояние токена, а прибавляет к нему поправку. Состояние  — вектор размерности
 (у Qwen3.5-0.8B
 ). Блок внимания и блок MLP читают его и дописывают свой результат:
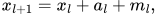
где  — выход внимания слоя
 ,
 — выход MLP. Если развернуть эту рекурсию от первого слоя до последнего
 , получится просто сумма:
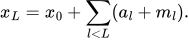
Здесь  — эмбеддинг токена. Отсюда следует главное свойство: если нас интересует, сколько «чего-то» лежит в состоянии вдоль направления
 , то это сумма вкладов всех блоков по отдельности,
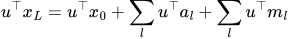 . Elhage и др. назвали этот вектор residual stream — общей шиной, в которую все пишут [4]. Оговорка: перед логитами стоит финальная RMSNorm. Она масштабирует весь вектор целиком, поэтому соотношения вкладов сохраняются, но абсолютные величины — нет.
Если по-простому: у каждого токена есть «рабочая тетрадь» из 1024 чисел. Каждый слой ничего в ней не стирает, а только дописывает свои заметки поверх. Итоговое состояние — это сумма всех заметок, поэтому вклад одного слоя можно рассматривать отдельно от остальных.
3.2. MLP: каждый нейрон пишет один фиксированный вектор
[Доказано] MLP в Qwen устроен как SwiGLU: 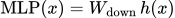 , где
 — вектор из
 активаций нейронов. Его считают из двух других матриц, gate и up:
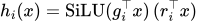 . Умножение матрицы на вектор — это сумма её столбцов с весами, поэтому
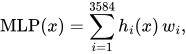
где  —
 -й столбец
down_proj. Получается, что нейрон  решает только насколько сильно записать (число
 зависит от входа), а что записать (вектор
 ) зашито в весах раз и навсегда. Geva и др. описали это как память «ключ → значение»: gate/up — ключи, столбцы down — значения [5, 6].
Если по-простому: у каждого из 3584 нейронов есть свой штамп — фиксированный вектор. Вход определяет только, насколько сильно его нажать. Если поменять столбец
down_proj, нейрон будет срабатывать на те же ситуации, но оставлять другой отпечаток. Поэтому Astra правила именно эти столбцы.
3.3. Поведение как направление
[Интерпретация, опирается на литературу] Гипотеза линейного представления говорит, что многие свойства, вроде «это отказ» или «сейчас я повторяюсь», кодируются направлением  в пространстве состояний [7]. Сила свойства — это проекция
 . На этом построены activation steering [8, 9], representation engineering [10] и самый близкий к нашему случаю результат: Arditi и др. показали, что отказы в чат-моделях опосредованы одним направлением, и если убрать его из весов, модель перестаёт отказывать [11]. Правка Astra — тот же приём, только направление — «зацикливание», и тронуты лишь 64 столбца в двух слоях.
Если по-простому: считается, что у модели есть «оси» для понятий. Если найти ось «я хожу по кругу» и запретить слоям туда писать, поведение меняется, а остальная модель остаётся как была.
Часть 4. Что делает «вычитание направления» и почему это минимальная правка
4.1. Проекция и ранг 1
[Доказано] Пусть  — единичный вектор направления (
 ),
 — матрица, которая пишет в поток (у нас — выбранные столбцы
down_proj). Классическая абляция:
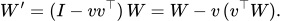
Матрица  — ортогональный проектор: она стирает у вектора компоненту вдоль
 и не трогает всё перпендикулярное. Проверка в одну строку:
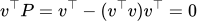 . Поэтому для любых активаций

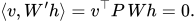
Слой после такой правки не может записать ничего вдоль  ни на каком промпте. Это объясняет, почему эффект переносится с математики на IFEval: правка не зависит от входа. Сама поправка
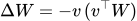 — произведение столбца на строку, то есть матрица ранга 1.
Если по-простому: мы берём каждый «штамп» нейрона и вырезаем из него одну конкретную составляющую. Остальное в штампе остаётся. Поскольку вырезается одно и то же направление у всех штампов, вся правка описывается одним вектором — это и есть «ранг 1».
4.2. Что на самом деле сделала Astra: α ≈ 6
[Мой замер] Дифф опубликованного чекпойнта из части 2 точно ложится не на  , а на
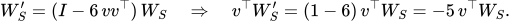
Здесь  — 64 выбранных столбца. Множитель
 — это то, во что превращается компонента вдоль
 : при
 она обнуляется, при
 отражается, при
 отражается и усиливается в 5 раз. Так что «вычли направление» — точное описание, но геометрически это не стирание, а разворот сигнала. И ещё одно следствие: матрица
 обратима (это не проектор), поэтому формально такая правка информацию не уничтожает.
Если по-простому: Astra не просто заглушила сигнал «повторяйся», а заставила эти нейроны кричать обратное — «не повторяйся» — в пять раз громче, чем раньше звучало исходное.
4.3. Почему именно такая правка — самая маленькая
[Доказано] Поставим вопрос: какую наименьшую по норме Фробениуса поправку  надо внести, чтобы проекция на
 стала равна
 ? Разложим
 на часть вдоль
 и перпендикулярную. Условие касается только первой части, поэтому она определена однозначно:
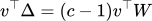 . Вторая часть на условие не влияет и лишь добавляет норму:
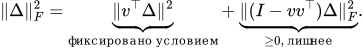
Минимум достигается, когда лишняя часть равна нулю, то есть 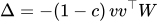 . Это ровно семейство
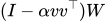 с
 , а у Astra
 . ∎
Если по-простому: если нужно изменить только «громкость по одной оси», любая правка в других осях — лишний шум. Самая аккуратная правка трогает ровно одну ось и ничего больше. Реальный дифф выглядит именно так: вся его энергия, 99.999 %, сидит в одном направлении.
4.4. Откуда 131 072
Нейрон пишет столбец длины  . В
config.json Qwen3.5-0.8B указано hidden_size 1024 и intermediate_size 3584. Значит, 2 слоя × 64 столбца × 1024 = 131 072 веса, или 64/3584 ≈ 1.8 % столбцов каждой из двух матриц и 0.016 % всей модели. Арифметика поста сходится точно. Выбирали не самые большие нейроны, а те, что сильнее всего пишут в  (см. часть 2 этой статьи).
Что дальше
Итак, в диффе лежит одна ось на двух слоях, и вдоль неё вклад MLP не обнуляется, а разворачивается с множителем −5. Этого хватило, чтобы доля ответов, упёршихся в лимит, упала с 93 % до 33.1 %, а MATH-500 вырос с 7.9 % до 48.1 %. И почти все «спасённые» задачи — те, что раньше просто обрывались. Но остаются три вопроса, на которые математика выше не отвечает:
-
почему поворот одной оси из 1024 меняет вероятность зацикливания на порядок, а не на проценты;
-
почему тот же приём не помог Gemma, и почему так в принципе нельзя «вложить» в модель отсутствующий навык, хотя машинке в Kinetix схему добавить удалось;
-
насколько это вообще новое — ведь ROME, refusal direction и task arithmetic правят веса похожим образом уже несколько лет.
Об этом — во второй части: там будет простая вероятностная модель петли, мой зонд по слоям, неравенство обработки данных и конструкция «обходного пути» для машинки.
Источники
-
Takehi R., Teoh J., Zhang A., Khattab O. Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights. MIT CSAIL, 2 Nov 2026. https://rikiyat.github.io/blog/weight-space-programming/
-
Логи экспериментов: https://github.com/RikiyaT/lm_understand-logs (каталог
exp8_math/) -
Отредактированный чекпойнт и независимая перепроверка: https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming
-
Elhage N. et al. A Mathematical Framework for Transformer Circuits. 2021. https://transformer-circuits.pub/2021/framework/index.html
-
Geva M. et al. Transformer Feed-Forward Layers Are Key-Value Memories. https://arxiv.org/abs/2012.14913
-
Geva M. et al. Transformer Feed-Forward Layers Build Predictions by Promoting Concepts in the Vocabulary Space. https://arxiv.org/abs/2203.14680
-
Park K., Choe Y. J., Veitch V. The Linear Representation Hypothesis and the Geometry of Large Language Models. https://arxiv.org/abs/2311.03658
-
Turner A. et al. Steering Language Models With Activation Engineering. https://arxiv.org/abs/2308.10248
-
Rimsky N. et al. Steering Llama 2 via Contrastive Activation Addition. https://arxiv.org/abs/2312.06681
-
Zou A. et al. Representation Engineering: A Top-Down Approach to AI Transparency. https://arxiv.org/abs/2310.01405
-
Arditi A. et al. Refusal in Language Models Is Mediated by a Single Direction. https://arxiv.org/abs/2406.11717
Автор: maxim_lomakin

