


С чего начинается внедрение искусственного интеллекта в компании?
ИТ-команда начинает подбирать GPU-серверы, бизнес рассматривает облачные модели, а разработчики собирают первый прототип. Через полгода выясняется, что выбранная модель не помещается в доступную видеопамять, облачная инфраструктура выходит за рамки бюджета, а закупленные ускорители не обеспечивают необходимую производительность под реальной нагрузкой.
Проблема не всегда связана с оборудованием или самой моделью, а чаще всего с последовательностью принятия решений: инфраструктуру начинают проектировать до того, как определены требования к будущему ИИ-сервису.
За последний год мы в Orion soft наблюдали разные сценарии внедрения ИИ в российских компаниях: от первых экспериментов до проектов, которые готовятся к промышленной эксплуатации у крупнейших заказчиков. Как разработчик инфраструктурного ПО, мы нередко подключаемся на этапе, когда бизнес-задача уже сформулирована, модель выбрана, а оборудование закуплено. Именно тогда становятся заметны архитектурные ограничения, заложенные на еще старте.
Меня зовут Никита Векессер, я отвечаю за развитие ИИ-продуктов в Orion soft. В этой статье разберем, какие решения необходимо принять до закупки вычислительных мощностей, как связаны прикладной, инфраструктурный и аппаратный уровни ИИ-системы, какие ошибки встречаются на практике и как оценить стоимость разных вариантов развертывания.
Также покажу наш подход к тестированию ИИ-сервисов на примере внутренней RAG-системы и поделюсь результатами испытаний нескольких GPU-конфигураций.
Для начала разберемся, зачем компании в России внедряют ИИ?
За последний год характер корпоративных ИИ-проектов заметно изменился. В 2025 году многие заказчики находились на стадии экспериментов: подключали облачные модели, тестировали отдельные гипотезы и пытались обосновать инвестиции в масштабирование. Основным препятствием часто становилось отсутствие измеримого бизнес-эффекта.
В 2026 году мы все чаще сталкиваемся с другой задачей: эксперимент внедрения уже проведен, технология показала свой потенциал на практике, теперь необходимо превратить прототип в устойчивый промышленный сервис. А это принципиально другой уровень требований к производительности, отказоустойчивости, безопасности и стоимости эксплуатации.
При этом мотивы внедрения ИИ различаются. По нашим наблюдениям, инициативы чаще всего возникают под влиянием трех факторов: регуляторных и стратегических требований, конкурентного давления рынка или инициатив внутренних команд.
1. Регуляторные и стратегические триггеры как драйвер рынка
Для государственного сектора одним из драйверов внедрения ИИ остается государственная политика в области развития технологий. В 2019 году была утверждена Национальная стратегия развития искусственного интеллекта, которая задала долгосрочные ориентиры для отрасли.
На практике мы видим, что для ряда государственных организаций внедрение ИИ становится частью целевых показателей цифровой трансформации. Это напрямую влияет на приоритеты бизнеса: организации важно не только получить технологический результат, но и выполнить установленные требования в заданные сроки и в рамках доступного бюджета. В таких условиях востребованы готовые решения, которые можно внедрить без длительного цикла собственной разработки и при необходимости тиражировать на другие подразделения или организации.
Однако здесь возникает важный вопрос: что именно можно считать успешным внедрением — выполнение формального показателя или реальное изменение эффективности процесса?
Эти цели не всегда совпадают. Поэтому еще до выбора продукта необходимо определить, какой именно результат организация рассчитывает получить и как будет оценивать его достижение.
2. Давление конкурентов
В коммерческом секторе мотивация другая. Компании рассматривают ИИ как инструмент повышения производительности и сохранения своей конкурентоспособности. Риск заключается не столько в том, что конкурент первым внедрит новую модель, сколько в том, что он раньше научится применять ее в конкретных бизнес-процессах: ускорять разработку, повышать качество клиентского сервиса или снижать операционные издержки.
Мы наблюдаем такие инициативы в финансовом секторе, промышленности, машиностроении и энергетике. Некоторые компании инвестируют в развитие ИИ-компетенций уже несколько лет, хотя далеко не всегда могут однозначно выделить экономический эффект именно от ИИ. Это закономерная сложность: на показатели бизнеса одновременно влияют автоматизация, изменение процессов, организационные решения и другие факторы.
Поэтому для корпоративного ИИ-проекта важно с самого начала определить измеримую метрику, на которую должна повлиять технология. Иначе даже успешное внедрение может остаться экспериментом, ценность которого трудно доказать.
3. Внутренние инициативы команд разработки и R&D
Еще один распространенный сценарий — внедрение ИИ по инициативе сотрудников.
Разработчики, аналитики, специалисты HR, бухгалтерии и других подразделений самостоятельно пробуют ИИ-инструменты. Например, сотрудник обнаруживает, что с помощью языковой модели может подготовить документ в несколько раз быстрее, чем раньше, хотя результат по-прежнему требует проверки.
Дальше инициатива может развиваться по-разному. Иногда инструмент остается персональным способом повышения продуктивности. В других случаях сотрудник делится опытом с коллегами, появляется инициативная группа, а затем — запрос на централизованное внедрение. В крупных организациях такие проекты часто переходят в R&D-подразделения, центры компетенций или департаменты цифровой трансформации.
Именно на этом этапе индивидуальный эксперимент превращается в корпоративную задачу. Необходимо определить владельца сервиса, требования к данным, интеграциям, инфраструктуре и безопасности. То, что успешно работает для одного сотрудника с платной подпиской на облачную модель, далеко не всегда можно без изменений масштабировать на сотни пользователей.
Что важно определить на старте внедрения ИИ?
Прежде чем выбирать модель, облачного провайдера или GPU-сервер, необходимо ответить на базовый вопрос: какую задачу должен решить ИИ и почему для нее выбран именно этот инструмент?
Ответ зависит от контекста.
В государственном секторе приоритетом может быть выполнение требований цифровой трансформации с минимальными затратами на внедрение. В этом случае разумно рассматривать готовые тиражируемые продукты, если они соответствуют функциональным и регуляторным требованиям.
Например, в медицинских организациях применяются готовые ИИ-сервисы, в том числе решения экосистемы «МосМедИИ». Такой подход позволяет использовать специализированную функциональность без необходимости самостоятельно разрабатывать модель и поддерживать всю инфраструктуру ее эксплуатации.
В коммерческой организации логика обычно строится вокруг эффективности конкретного процесса. Здесь полезно изучить опыт сопоставимых компаний, включая зарубежные практики, и определить, какие операции действительно можно улучшить с помощью ИИ. Но ориентироваться исключительно на чужой опыт недостаточно. Одинаковая технология в разных организациях может давать разный результат из-за различий в данных, процессах, нагрузке и требованиях к качеству.
Поэтому мы рекомендуем формулировать ИИ-инициативу как проверяемую гипотезу:
“Если внедрить ИИ на определенном этапе бизнес-процесса X, то показатель Y должен измениться на величину K”.
Например, если система помогает сотрудникам технической поддержки быстрее находить ответы в документации, можно измерять время обработки обращений, долю корректных ответов и количество эскалаций на следующую линию поддержки. Такая постановка задачи позволяет определить исходные показатели, целевой результат и критерии успешности пилота. Кроме того, она дает бизнесу понятную основу для принятия инвестиционного решения.
У ИИ-проектов есть особенность: одну и ту же задачу можно решить несколькими архитектурными способами.
Например, для корпоративного помощника можно использовать прямое обращение к LLM, RAG-архитектуру, агентную систему или комбинацию нескольких подходов. Даже изменение стратегии поиска, промта или используемой модели способно существенно повлиять на качество результата.
Поэтому на этапе R&D важно ограничить эксперимент по срокам и заранее определить критерии оценки. За выделенное время команда должна проверить несколько обоснованных вариантов и сравнить их по единым метрикам. Для генеративных систем это могут быть корректность ответа, полнота, соответствие источникам, задержка ответа и стоимость обработки запроса. Если ни один из вариантов не достигает целевого качества при приемлемых затратах, необходимо пересмотреть гипотезу, а не бесконечно увеличивать бюджет на инфраструктуру.
Главный результат начального этапа внедрения — это не работающая демонстрация, а подтверждение того, что выбранный сценарий имеет практическую ценность и технически реализуем в заданных ограничениях.
Уровни внедрения ИИ и типовые ошибки
Одна из наиболее дорогих ошибок — рассматривать разработку ИИ-сервиса, инфраструктуру и оборудование как независимые задачи.
Команда может собрать убедительный прототип на облачной модели, но при переходе в промышленную эксплуатацию обнаружить, что корпоративные требования не позволяют использовать внешний API. Или закупить мощные GPU-серверы, а затем выяснить, что выбранная архитектура не использует возможности межпроцессорных и межузловых соединений.
Чтобы избежать подобных ситуаций, мы разделяем ИИ-проект на три взаимосвязанных уровня.
Прикладной уровень — информационная система, которая решает бизнес-задачу. Это может быть собственная разработка, готовый продукт или решение подрядчика. Здесь определяются пользовательские сценарии, бизнес-логика, интеграции и требования к качеству модели.
Инфраструктурный уровень — среда, в которой работает приложение и его AI-компоненты. Она отвечает за развертывание, хранение данных, управление ресурсами, масштабирование, мониторинг, безопасность и выполнение требований к доступности сервиса.
Аппаратный уровень — серверы, CPU, RAM, GPU, системы хранения и сетевые соединения. Их характеристики определяют доступный объем вычислений, пропускную способность и ограничения при запуске моделей.
Эти уровни нельзя проектировать последовательно без обратной связи. Требования прикладной системы влияют на инфраструктуру, а ограничения оборудования — на выбор модели и архитектуры.
Например, для LLM важен не только объем видеопамяти, необходимый для размещения весов. При расчете ресурсов необходимо учитывать KV-cache, длину контекста, количество одновременных запросов, параметры инференса и возможное распределение модели между ускорителями. Если не учесть эти параметры заранее, модель может успешно запускаться на тестовом стенде, но не выдерживать реальную пользовательскую нагрузку.
Примеры частых ошибок из опыта заказчиков
Ошибка первая: закупили оборудование до определения задачи.
Компания выделила бюджет на ИИ и приобрела GPU-серверы с расчетом на будущие проекты. Но не назначила владельца инициативы, не сформулировала требования к сервисам и не подготовила инфраструктуру.
В результате оборудование может месяцами оставаться невостребованным.
Причина не в недостаточной производительности GPU, а в том, что закупка была проведена без понимания того, какие модели планируется запускать, кто будет ими пользоваться и как организовать эксплуатацию.
Ошибка вторая: арендовали облачную инфраструктуру без расчета нагрузки.
Команда развернула приложение в облаке, но при тестировании выяснилось, что выделенных ресурсов недостаточно. Конфигурацию расширили, после чего стоимость эксплуатации превысила бюджет проекта.
Такой сценарий особенно вероятен, если оценивать только стоимость виртуальной машины, не учитывая необходимое количество GPU, длительность их использования, хранение данных и дополнительные инфраструктурные расходы.
Для облачной модели также важно учитывать характер тарификации: оплата за выделенные мощности и оплата за фактическое потребление API — разные экономические модели.
Ошибка третья: приобрели дорогостоящие серверы, но не использовали их аппаратные возможности.
Мы сталкивались с конфигурациями, в которых сервер с 8 GPU и высокопроизводительными компонентами NVIDIA обходился примерно в 40 млн рублей. При этом выбранная схема виртуализации не позволяла в полной мере задействовать возможности аппаратных соединений, за которые компания фактически заплатила при закупке. В отдельных случаях разница в стоимости конфигурации достигала порядка 20 млн рублей на сервер.
Для распределенного обучения и инференса критичны не только характеристики отдельных ускорителей, но и пропускная способность соединений между ними. Если задача требует интенсивного обмена данными, недостаточно просто объединить несколько GPU в одну вычислительную систему.
Ошибка четвертая: не учли требования к сети при распределении модели.
Предположим, крупная модель не помещается на ускорителях одного сервера. Компания приобретает несколько серверов с двумя или четырьмя GPU и объединяет их обычной сетью Ethernet с пропускной способностью 10–20 Гбит/с.
В одном из наблюдавшихся нами сценариев такое решение привело к снижению производительности примерно на 90% относительно ожидаемого уровня. Причина — ограничения межузлового обмена при распределенных вычислениях. Если модель требует интенсивной синхронизации между ускорителями, пропускная способность сети и задержки передачи данных становятся критическими параметрами.
Это не означает, что Ethernet непригоден для ИИ-нагрузок. Но его характеристики должны соответствовать конкретной архитектуре и характеру обмена данными.
Все эти примеры объединяет одна общая проблема: оборудование, инфраструктуру и приложение проектировали отдельно, хотя их характеристики необходимо согласовывать еще до начала закупок.
Правильная последовательность принятия решений
Мы рекомендуем двигаться от требований прикладного сервиса к инфраструктуре, а не наоборот.
1. Определить задачу и сформулировать технические требования.
Необходимо описать пользовательские сценарии, интеграции с корпоративными системами, требования к качеству результата, безопасности, доступности и производительности.
Например, первые попытки создать внутреннюю RAG-систему для работы с документацией Orion soft не привели к ожидаемому результату. Несколько специалистов экспериментировали с разными подходами, но без единого технического задания и критериев оценки работа оставалась набором разрозненных исследований.
К системной разработке мы перешли после формализации требований.
2. Выбрать архитектурный подход и кандидатов на роль базовой модели.
На этом этапе необходимо определить, какие модели подходят для задачи, требуется ли RAG, какие данные будут использоваться и какие ограничения есть по качеству, лицензированию и размещению.
Не обязательно сразу выбирать единственную LLM. Практичнее сформировать короткий список моделей и проверить их на репрезентативном наборе задач.
3. Рассчитать предполагаемую нагрузку.
Важно оценить число пользователей, интенсивность обращений, длину входного и выходного контекста, допустимую задержку ответа и ожидаемую параллельность запросов.
Модель, которой достаточно одной NVIDIA H100 при единичных обращениях, под промышленной нагрузкой может потребовать значительно больше вычислительных ресурсов.
При этом потребность в GPU зависит не только от количества пользователей, но и от размера модели, режима инференса, параметров батчинга и целевого времени ответа.
4. Подобрать аппаратную конфигурацию.
Когда понятны модель и профиль нагрузки, можно оценить необходимый объем GPU-памяти, количество ускорителей, требования к CPU, RAM и сети.
Если модель планируется распределять между несколькими GPU или серверами, необходимо отдельно проверить требования к межускорительному и межузловому обмену.
5. Определить архитектуру инфраструктуры.
На основе функциональных и нефункциональных требований выбираются средства развертывания, оркестрации, хранения, мониторинга и управления вычислительными ресурсами.
Здесь необходимо учесть SLA, отказоустойчивость, безопасность, особенности масштабирования и эксплуатационные процессы.
При этом требования к инфраструктуре формируются уже на первом этапе. На заключительном шаге выбирается конкретная реализация, соответствующая этим требованиям и доступному оборудованию.
Итоговая последовательность выглядит так:
бизнес-задача → требования → архитектура и модель → профиль нагрузки → оборудование → инфраструктурная реализация
Это не исключает итераций. Если тестирование показывает, что выбранная модель слишком дорога в эксплуатации, может потребоваться пересмотреть ее размер, архитектуру сервиса или целевые показатели. Но такие изменения значительно дешевле выполнять до масштабной закупки оборудования.
Анатомия типового ИИ-проекта
Этот подход мы применяем и внутри Orion soft.
Сейчас несколько внутренних и внешних команд участвуют в разработке прикладного ИИ-сервиса для работы с технической документацией. Его задача — помогать пользователям находить релевантные ответы в большом массиве материалов.
Только документация по нашей системе виртуализации TheWirth насчитывает около 4000 страниц. Для такого объема недостаточно просто подключить языковую модель: необходимо организовать поиск по источникам, передачу релевантного контекста и контроль качества ответов. Поэтому мы выбрали RAG-архитектуру — Retrieval-Augmented Generation, или генерацию с дополнением контекстом из внешней базы знаний. Для проектирования системы выделили несколько логических слоев.
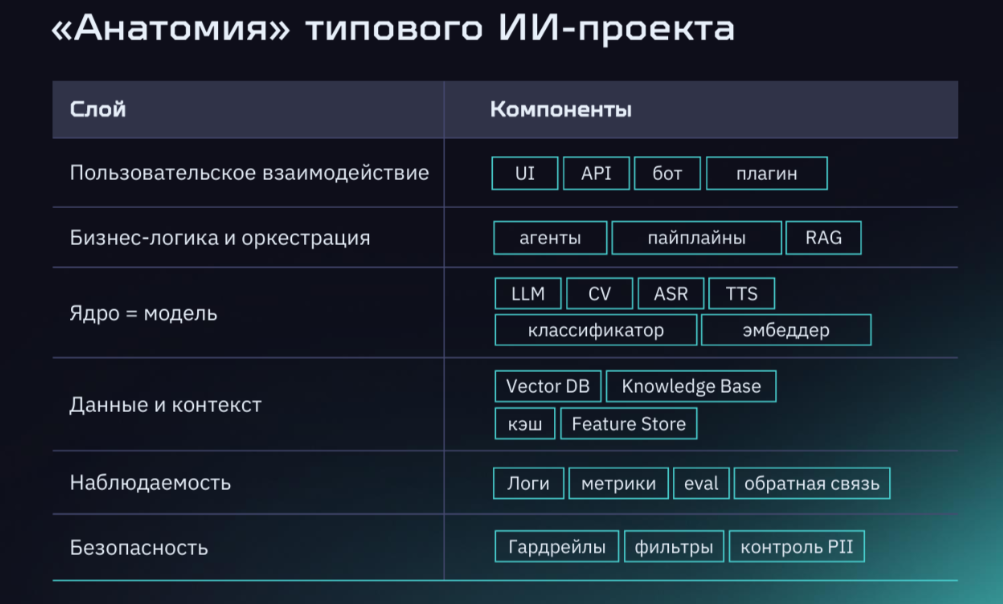
Пользовательское взаимодействие. Веб-интерфейс и интеграция с корпоративной базой знаний. Пользователь формулирует вопрос на естественном языке, а система должна вернуть ответ, основанный на технической документации.
Бизнес-логика и оркестрация. RAG-пайплайн, который принимает запрос, организует поиск по документам, формирует контекст и передает его языковой модели. На этом уровне определяются правила обработки запроса и последовательность вызовов компонентов.
Ядро системы — модели. В нашей архитектуре используются LLM, модель эмбеддингов и reranker. Эмбеддинги помогают находить семантически близкие фрагменты документации, reranker уточняет их релевантность, а LLM формирует итоговый ответ на основе отобранного контекста.
Данные и контекст. Векторная база данных, в которой хранятся представления фрагментов документации для семантического поиска. Качество работы RAG зависит не только от выбранной LLM, но и от подготовки документов, разбиения на фрагменты и стратегии извлечения контекста.
Наблюдаемость. Логи, метрики и инструменты оценки качества. Нам необходимо понимать, какие запросы система обрабатывает корректно, где возникают ошибки поиска и генерации, как меняется задержка ответа и какие компоненты требуют оптимизации.
Безопасность. Контроль взаимодействия с языковой моделью, защита чувствительных данных и проверка запросов. Для этого в разрабатываемую систему мы интегрировали StarGuard AI — продукт Orion soft для безопасной работы с LLM.
! Важно, что каждый слой влияет на итоговое качество. Например, если поисковый компонент не нашел нужный фрагмент документации, увеличение размера LLM само по себе не гарантирует корректный ответ. Поэтому оценивать необходимо не только модель, но и всю прикладную систему целиком.
Тестирование ИИ-инициативы
Один из самых сложных вопросов при разработке AI-сервиса — как объективно определить, что выбранное решение действительно подходит для задачи.
В классических информационных системах результат многих операций можно проверить по заранее заданным правилам. В генеративном ИИ один и тот же вопрос может иметь несколько корректных формулировок ответа, а внешне убедительный текст не всегда оказывается достоверным.
Поэтому мы решили использовать два взаимодополняющих подхода: экспертный бенчмарк и проверку полноты покрытия исходной документации.
Экспертный бенчмарк
Для внутренней RAG-системы мы сформировали набор сложных вопросов на основе опыта пресейл-команды и технической поддержки.
Нас интересуют не простые запросы вроде «как создать виртуальную машину», а реальные технические проблемы, с которыми заказчики обращаются на третью линию поддержки. В таких сценариях недостаточно получить связный ответ. Система должна правильно интерпретировать вопрос, найти релевантные материалы и сформулировать рекомендации, которые не противоречат документации.
Цена ошибки здесь значительно выше, чем у обычного корпоративного чат-бота. Некорректная инструкция может привести к нарушению работы инфраструктуры. Поэтому при оценке мы обращаем внимание на фактическую корректность, полноту, соответствие источникам и отсутствие вымышленных действий.
Экспертный бенчмарк позволяет сравнивать разные архитектуры, модели и реализации RAG на едином наборе задач.
Если над одним сервисом работают несколько команд или подрядчиков, такой подход помогает оценивать результаты по заранее согласованным критериям, а не по субъективному впечатлению от демонстрации.
Полнота тестирования
Однако даже успешное прохождение экспертного бенчмарка не означает, что система одинаково хорошо работает со всей документацией.
Для этого необходим второй уровень проверки — оценка полноты покрытия.
Мы формируем тестовые вопросы по исходному массиву документов и сопоставляем ответы системы с ожидаемыми результатами и фрагментами источников.
Часть этой работы можно автоматизировать: генерировать вопросы и эталонные ответы на основе документации, затем использовать их для проверки поиска и генерации. При этом автоматическая оценка не заменяет экспертную. Сгенерированные тесты тоже могут содержать ошибки, а корректность сложных технических инструкций требует отдельной проверки.
В результате мы получаем два набора испытаний. Первый показывает, насколько система справляется со сложными прикладными сценариями. Второй — насколько полно и стабильно она работает с исходной базой знаний.
Дополнительно необходимо пользовательское тестирование. Даже технически корректный сервис может оказаться неудобным: например, требовать слишком много действий для получения ответа или плохо вписываться в существующий рабочий процесс. Поэтому качество ИИ-системы — это не только точность модели. Это сочетание корректности, производительности, удобства и реальной применимости в бизнес-процессе.
Где запускать ИИ-решения и сколько это стоит?
После выбора архитектуры и оценки нагрузки возникает следующий вопрос: где разместить ИИ-сервис и сколько будет стоить его эксплуатация?
В Orion soft мы тестируем разные конфигурации GPU — от потребительских ускорителей до серверных NVIDIA H100. Это позволяет сравнивать варианты не только по паспортным характеристикам, но и на конкретных прикладных задачах.
В качестве примера рассмотрим RAG-систему, работающую с документацией объемом около 4000 страниц.
Для сравнения используем сценарий, в котором сотрудник отправляет один запрос примерно раз в пять минут. При этом важно учитывать, что приведенные результаты относятся к нашим тестовым конфигурациям и профилю нагрузки. Их нельзя автоматически переносить на другие модели и приложения.
Вариант 1: две игровые видеокарты RTX 4090 на ПК
Первый вариант — локальная конфигурация с двумя NVIDIA RTX 4090.
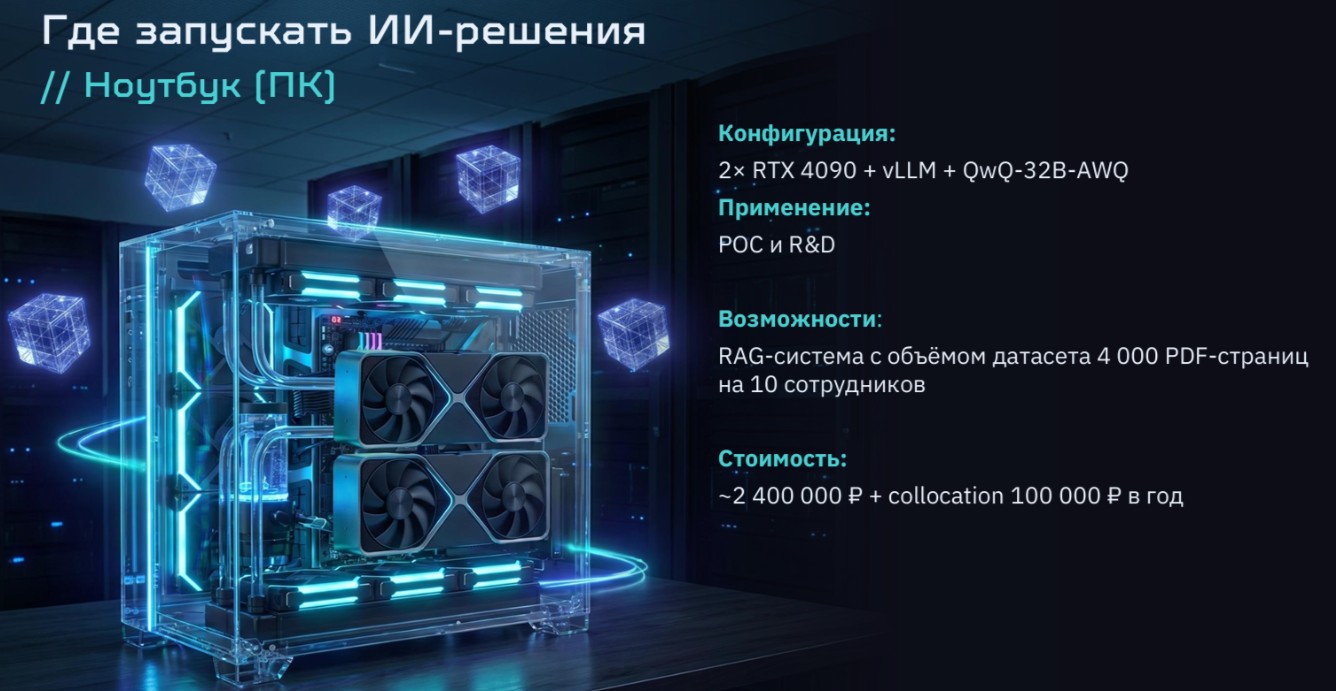
Подобные ускорители можно использовать как в рабочей станции, так и в специально собранном сервере. В нашем случае речь идет о серверной конфигурации с двумя процессорами, резервированием питания и двумя GPU. На таком оборудовании мы запускали RAG-систему с языковой моделью на 32 млрд параметров.
Это не универсальный минимальный размер модели для качественного RAG: требования зависят от сложности задачи, языка, качества поиска и допустимых ошибок. Однако для нашего сценария мы рассматривали именно такой класс моделей.
Система работала с документацией объемом около 4000 страниц и при выбранном профиле запросов обеспечивала обслуживание десяти сотрудников. Стоимость сборки серверной конфигурации составляла около 2,4 млн рублей, дополнительно — порядка 100 тыс. рублей в год на размещение оборудования. Если использовать потребительскую рабочую станцию, первоначальные затраты могут быть ниже — около 1 млн рублей для рассматриваемой конфигурации.
Этот вариант подходит для исследований, прототипирования и небольших внутренних сервисов. Но при переходе к промышленной эксплуатации необходимо отдельно оценивать надежность оборудования, охлаждение, обслуживание, резервирование и возможности масштабирования.
Вариант 2: аренда виртуальной машины с двумя RTX 4090 в облаке Второй вариант — аналогичная GPU-конфигурация, размещенная у облачного провайдера.
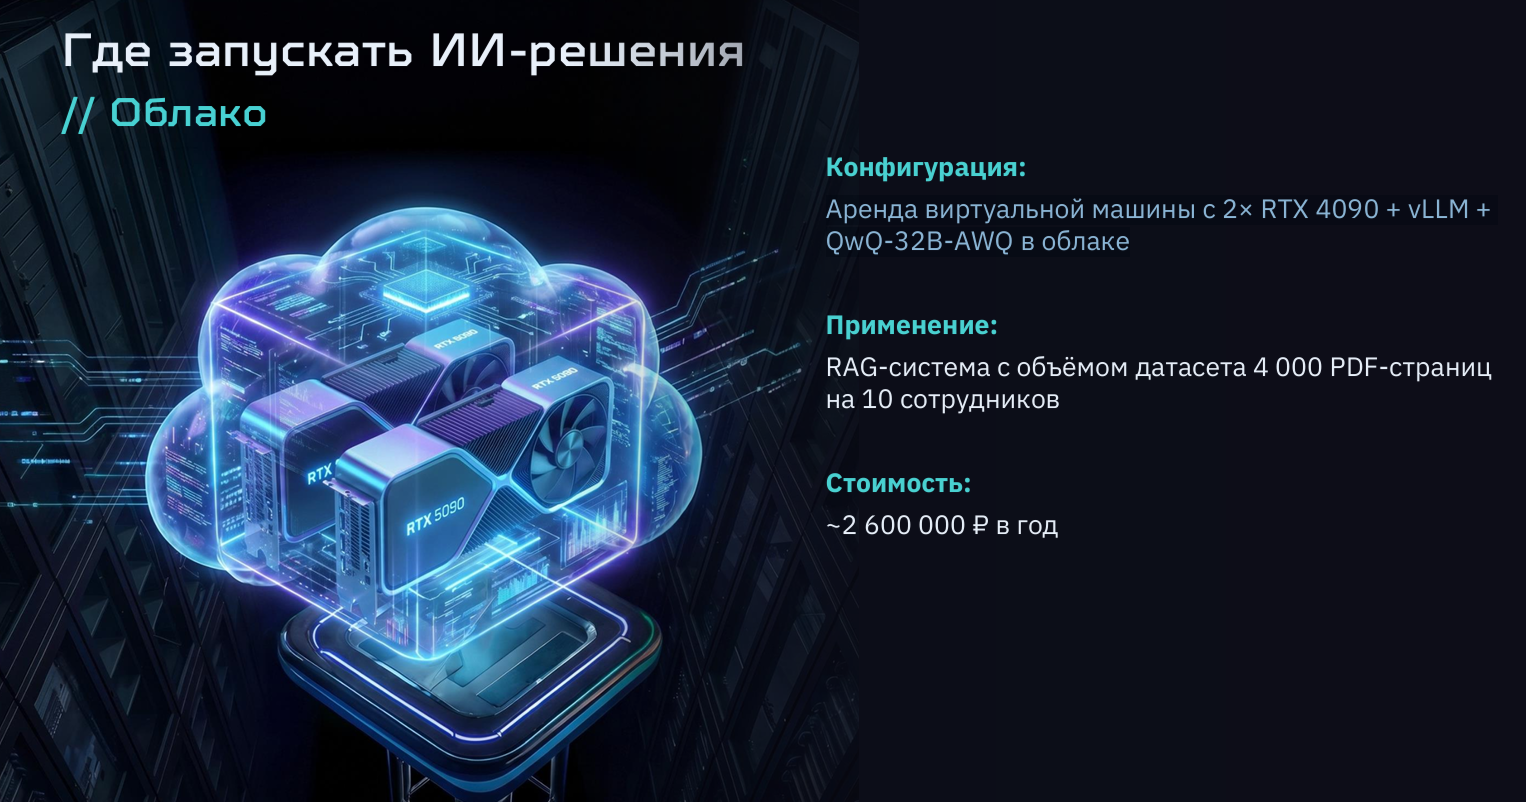
Ее преимущество — отсутствие первоначальной закупки оборудования. Команда может быстрее получить доступ к вычислительным ресурсам и начать эксперимент. Для сопоставимой конфигурации с двумя RTX 4090 мы получили ориентировочную стоимость аренды около 2,6 млн рублей в год.
В рамках рассматриваемого сценария на этих ресурсах можно развернуть RAG-систему с несколькими моделями, включая LLM на 32 млрд параметров, и обслуживать нагрузку десяти сотрудников.
С экономической точки зрения здесь важно сравнивать не только стоимость оборудования и годовой аренды.
Для собственной инфраструктуры необходимо учитывать капитальные затраты, амортизацию, размещение, электроэнергию, обслуживание и администрирование. Для облака — режим потребления ресурсов, условия тарификации и сопутствующие сервисы.
Поэтому облачный вариант может быть удобнее для пилотов и нерегулярных нагрузок, тогда как при длительной стабильной эксплуатации экономика требует отдельного расчета.
Вариант 3: две видеокарты H100 на своей площадке
Для более требовательных задач мы рассмотрели сервер с двумя NVIDIA H100.
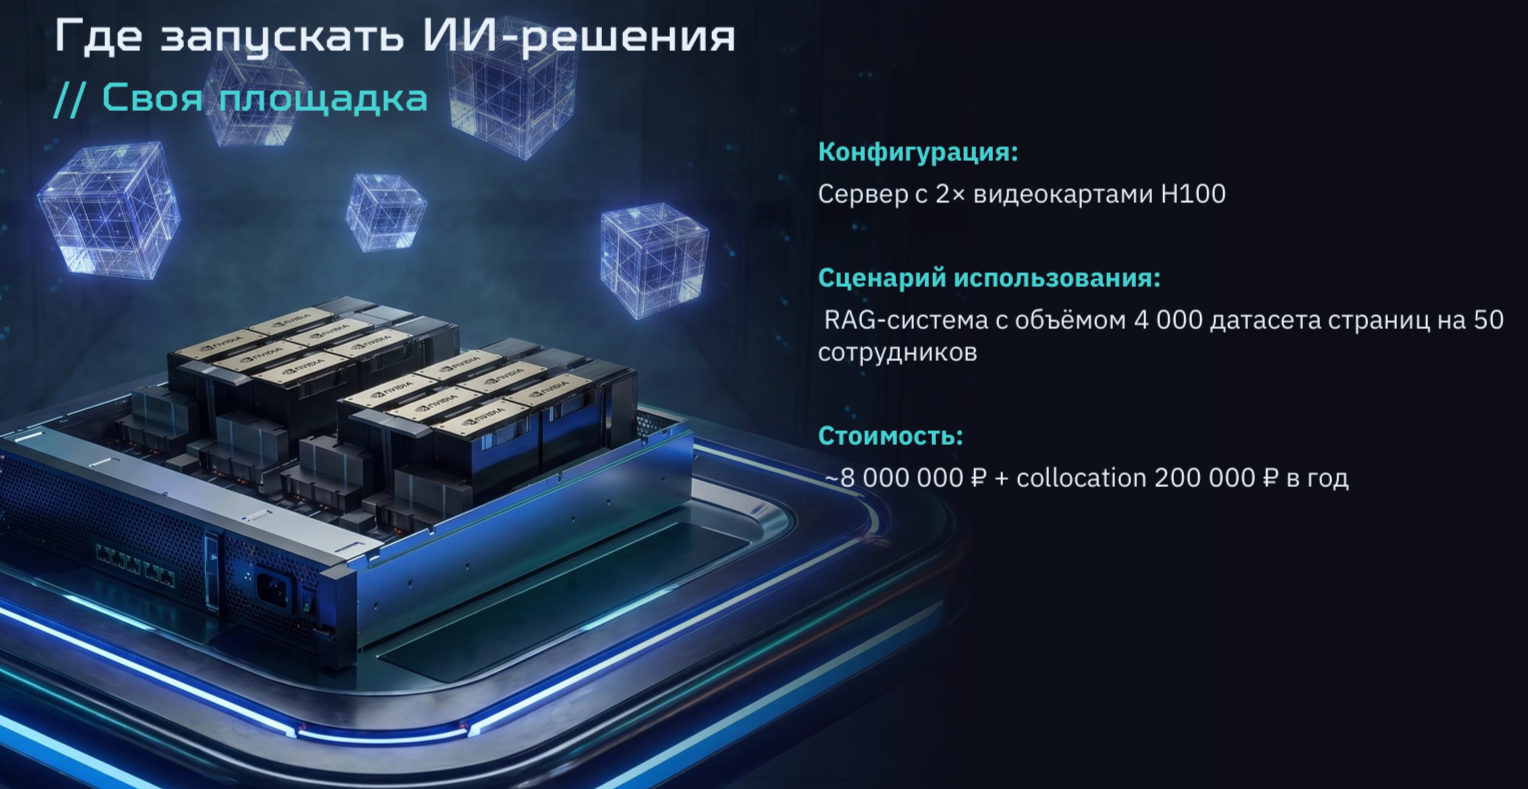
Это ускорители дата-центрового класса, рассчитанные на высокопроизводительные вычисления и работу с AI-нагрузками. В рассматриваемой конфигурации стоимость одной карты составляла порядка 3 млн рублей.
По результатам наших испытаний аналогичный RAG-сценарий на двух H100 обеспечивал обслуживание 50 пользователей при интенсивности один запрос примерно раз в пять минут. Это в пять раз больше, чем в конфигурации с двумя RTX 4090, при увеличении стоимости оборудования примерно в три раза. Стоимость сервера составляла около 8 млн рублей.
Дополнительно необходимо учитывать амортизацию и размещение — порядка 200 тыс. рублей в год в рассматриваемом расчете. Эти результаты показывают, почему при выборе GPU нельзя ориентироваться исключительно на цену ускорителя или объем видеопамяти. Для инференса имеют значение пропускная способность памяти, вычислительная производительность, поддерживаемые форматы вычислений, архитектура запуска модели и эффективность обработки параллельных запросов.
Однако соотношение производительности и стоимости будет меняться в зависимости от модели, длины контекста, параметров инференса и профиля нагрузки.
Вариант 4: гибридный сценарий — On-Premise + облако
На практике крупные организации редко ограничиваются единственным способом размещения ИИ. По нашим наблюдениям, зрелые инфраструктурные сценарии часто предполагают сочетание собственных вычислительных мощностей и облачных сервисов. Такой подход используем и мы в Orion soft. Для систем, обрабатывающих чувствительную корпоративную информацию, мы рассматриваем размещение в собственном контуре. Это касается, например, RAG-сервисов, интегрированных с ERP, «1С», системами документооборота и внутренними базами знаний.
Отдельное направление — ИИ-ассистенты и агенты, работающие с корпоративным контекстом. Они могут использовать данные встреч, транскрипции, задачи и информацию из внутренних систем, помогая сотрудникам находить нужные сведения и выполнять рутинные операции. В подобных сценариях особенно важны разграничение доступа, контроль передаваемых данных, аудит обращений и управление действиями агентов. Размещение модели внутри корпоративного контура позволяет контролировать инфраструктуру обработки данных, но само по себе не решает все задачи безопасности.
Для экспериментов, не связанных с передачей конфиденциальной информации, можно использовать облачные модели и API. Например, инструменты разработки на базе LLM, такие как Codex, или специализированные агенты могут применяться без необходимости сразу закупать собственные GPU-серверы.
Если задача находится на стадии проверки гипотезы, облачный API позволяет оценить ее перспективность с существенно меньшими первоначальными вложениями. В зависимости от модели и объема потребления стоимость такого эксперимента может составлять порядка 1000 долларов, а для отдельных небольших сценариев с использованием российских облачных провайдеров — существенно меньше. Но эти суммы относятся к разным конфигурациям и объемам использования, поэтому их нельзя напрямую сопоставлять со стоимостью полноценного собственного сервера.
Наиболее рациональный вариант определяется требованиями конкретного проекта: чувствительностью данных, профилем нагрузки, экономикой эксплуатации и необходимым уровнем контроля.
Гибридная архитектура позволяет использовать облако для экспериментов и переменных нагрузок, а собственную инфраструктуру — для тех сервисов, где это оправдано требованиями безопасности, производительности или долгосрочной стоимостью владения.
Вместо заключения
Наш опыт показывает, что наиболее важные решения при создании ИИ-инфраструктуры принимаются еще до закупки вычислительных ресурсов: при формулировании бизнес-гипотезы, выборе архитектуры, определении критериев качества и расчете нагрузки.
Чем раньше эти вопросы согласованы между бизнесом, разработкой и инфраструктурной командой, тем меньше вероятность, что после успешного пилота систему придется проектировать заново.
В следующей статье продолжим тему экономики ИИ-инфраструктуры и подробнее сравним облачное и локальное размещение моделей. Вместе с YADRO рассмотрим аппаратную составляющую On-Premise-инфраструктуры, а со стороны Orion soft разберем стоимость облачных сценариев и факторы, которые влияют на выбор заказчиков.
Автор: NVekesser

