


Всем привет! Эта статья является четвёртой в серии статей про основы глубокого обучения. В прошлых трёх частях я рассказал много интересного и полезного новичкам, так что рекомендую перечитать.
В этой части мы продолжим работу с нейронной сетью обработки естественного языка (NLP) и реализуем новую сеть, которая будет определять пропущенное слово по остатку фразы.
Какие мы имеем результаты с прошлой части?
В прошлой части мы создали двухслойную нейронную сеть классификации текста, обученную на отзывах на фильмы из кинопоиска. Здесь хочется немного поговорить о роли конкретных нейронов в итоговой модели. Как мы знаем нейронная сеть просто пытается реализовать функцию, которая будет как можно точнее описывать отношение между входными признаками и целевым значением. То есть находит корреляцию между входными и выходными данными.
С исследовательской точки зрения нам было бы интересно узнать какие языковые закономерности смогла выявить модель, а какие нет. Кажется очевидным, что в нашем случае модель должна хотя бы начать понимать, какое слово плохое или хорошее, так как именно это знание больше всего помогает понять эмоциональную окраску отзыва. Если мы хотим, чтобы модель выявила больше языковых закономерностей, то нам надо расширить сам датасет, использовать более сложную архитектуру самой сети и/или выбрать в качестве выходных данных что-то более сложное (например, угадать пропущенное слово).
Раньше мы всегда смотрели на работу нейронной сети в общем плане. Мы разбирали с вами, что каждый нейрон по сути просто часть одной большой функции, которую реализует сеть. Мы говорили про роль различных слоёв со своей функцией активации (для реализации нелинейных более сложных функций). А теперь давайте спустимся на уровень конкретных нейронов нашего скрытого слоя.
По сути, скрытые слои осуществляют группировку данных из предыдущего слоя в n групп. Каждый нейрон активируется с разной величиной, в зависимости от того принадлежат ли входные данные (точка данных) в его группу или нет. Способ группировки полезен если он способствует предсказанию целевого значения последующим слоям, а также он должен обнаруживать в данных искомую закономерность.
На высоком уровне две точки данных (два отзыва на фильмы) похожи, если принадлежат множеству одних и тех же групп (на практике у них будут близкие векторные представления). Два входа (слова) похожи, если тоже имеют близкие векторные представления слов, то есть схожие веса, связывающие их с разными скрытыми нейронами (то есть имеют приблизительно равные меры сходства с каждой группой).
Для нас слова, коррелирующие с похожими метками (положительный или негативный отзыв), будут иметь похожие веса, связывающие из с разными скрытыми нейронами. Это связано с тем, что нейронная сеть учится объединять их с похожими скрытыми нейронами (группы, которые они отделяют, имеют схожее влияние на результат и смысл), чтобы последний слой дал правильный прогноз. В более общем смысле нейрон имеет похожий смысл с другими нейронами в том же слое тогда и только тогда, когда имеет похожие значения весов, связывающих его со следующим и/или предыдущим слоем.
Теперь давайте напишем функцию, которая будет возвращать нам 50 наиболее похожих слов на заданное. Чтоб получить список весов для конкретного слова достаточно просто взять нужную строку в матрице весов. Чтобы получить наиболее похожие слова нам нужно как-то сравнить два векторных представления слов, я буду использовать в качестве метрики евклидовое расстояние между двумя точками.
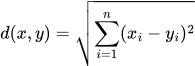
Сама реализация максимально проста, в качестве значения используем отрицательное расстояние, чтобы использовать метод most_common() объекта класса Counter.
from collections import Counter
import math

def similar(target='плохой'):
    target_index = word2index[target]
    print(f"Векторное представление слова: {weights_1[target_index]}")
    scores = Counter()
    for word, index in word2index.items():
        raw_difference = weights_1[index] - weights_1[target_index]
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(50)

print(similar())
После обучения нашей прошлой модели (чтобы использовать её матрицы весов и проверить, как она сгруппировала слова) и вызова этой функции имеем следующий результат:
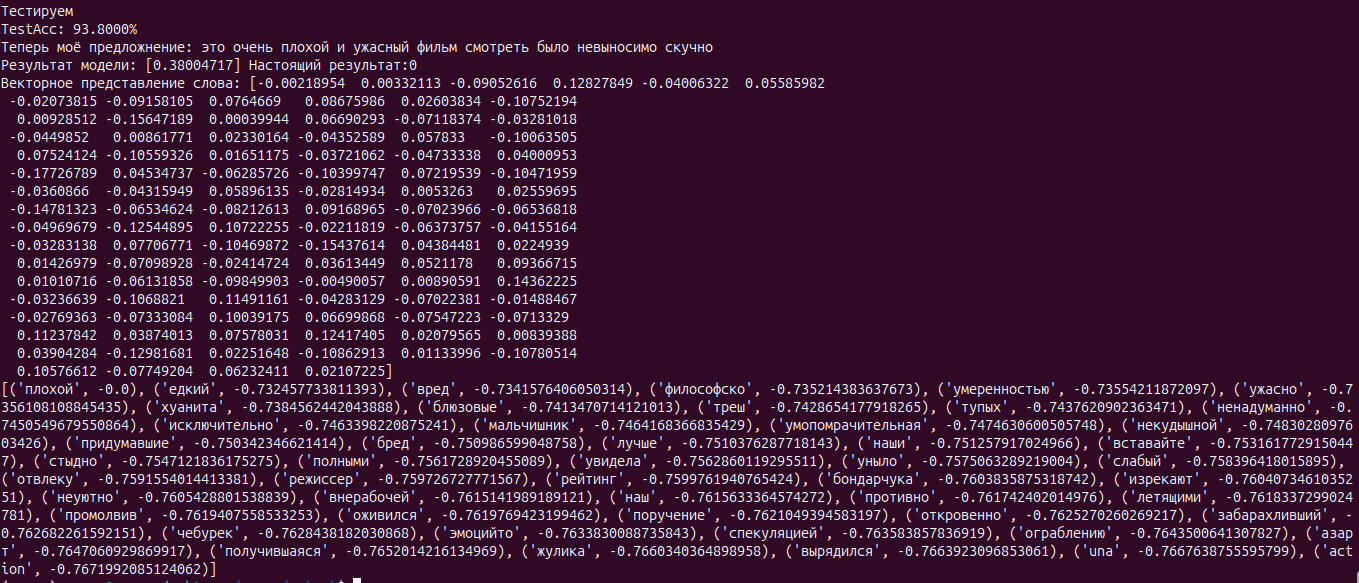
Наиболее похожим словом стало само это слово (векторное представление одно и то же ведь), а затем следуют слова со схожей полезностью, что и слово «плохой». Так же ожидаемо, что раз сеть возвращает всего две метки, то слова группируются согласно их положительной или отрицательной эмоциональной окраске.
Эта внутренняя группировка слов скрытыми слоями, которая выявляет дополнительные языковые закономерности называется обобщением корреляции. Сеть стремилась найти прямую корреляции между данными, но как логичный и побочный эффект изучила некоторые внутренние закономерности слов и языка, которые помогают ей правильно угадывать метку.
Конечно нельзя сказать, что модель научилась группировать именно плохие и хорошие слова, или что конкретный нейрон скрытого слоя отделяет слова на грубые и не грубые. На картинке выше мы видим, что в целом весь скрытый слой (то есть все нейроны этого слоя совместно) может группировать слова и предложения на плохие и хорошие.
Среди слов похожих на слово «плохой» есть слова «едкий», «вред», «треш», которые подтверждают, что сеть может определять не только эмоциональную окраску отзыва, а и научилась более универсальному свойству. Однако, среди схожих также есть слова «философско», «лучше» и «чебурек», которые уж точно не являются негативными (хотя для кого как).
Это ещё раз нам показывает модель в первую очередь ищет прямую корреляцию (цель получить правильный прогноз), а уже скрытые слои группируют слова по каким-то признакам, но они должны лишь выявить слова, которые больше всего влияют на выходную метку, а изучение эмоциональной окраски слов лишь побочный эффект и поэтому не абсолютно точный.
Если мы хотим заставить нейронную сеть изучить больше нюансов языка, то нужно дать ей входные и выходные данные, которые требуют этого понимания для прогнозирования метки. С этой целью мы реализуем нейронную сеть способную подбирать пропущенное слово.
Нейронная сеть для определения пропущенного слова
Выбрал именно эту задачу для нейронную сети, потому что мы можем использовать всё те же отзывы на фильмы, просто убирая одно слово из фразы (а также что угодно из интернета). Кроме того, способность точно подбирать недостающее слово требует глубокого понимания языка (так и обучают модели типа GPT и BERT).
Теперь давайте перепишем нейронную сеть из прошлой части для решения новой задачи. Во-первых, вместо предсказания единственной метки мы возьмём каждую фразу (из пяти слов, выбираем опорное и по два слова справа и слева от опорного), удалим одно слово и обучим нейросеть определять его по остатку фразы.
Во-вторых, воспользуемся отрицательным семплированием (negative sampling), которое поможет нам ускорить обучение сети. Потому что для предсказания каждого пропущенного слова нужно иметь по одной метке (идентификатору) для каждого возможного варианта, мы же будем случайным образом игнорировать большинство меток в каждом шаге процесса прямого распространения. Этот метод хорошо себя показывает на практике.
Таким образом нам не надо будет просчитывать вероятность каждого слова встать на место пропущенного, нам нужно просчитать вероятность слов только из некоторого подмножества всех слов.
Вначале мы всё также скачиваем датасет кинопоиска. Удаляем лишние символы и знаки препинания из датасета. Далее получаем список с отзывами и делим каждый отзыв на токены (размер токена у нас равен слову). Получаем список tokens, где элементами являются списки слов данного отзыва (в прошлый раз мы убирали повторы слов в отзыве, но сейчас нам важно знать какие слова были рядом с опорным).
Создаём объект счётчик, который представляет из себя по сути словарь с удобными методами. Далее передаём в словарь всех слов vocab слова в порядке возрастания частоты, также создаём словарь, который будет хранить слово(токен) и его идентификатор.
Далее создаём список input_dataset, в котором уже хранятся не списки слов отзывов, а их идентификаторы(удобная запись one_hot_encoding). И также создаём список всех слов из отзывов с повторениями, его мы будем использовать для получения случайных слов.
Задаём гиперпараметры, сеть у нас будет иметь 50 нейронов в скрытом слое и len(vocab) в выходном слое, negative — количество ложных слов, из которых будет выбирать наша сеть. Заполняем матрицу весов первого слоя рандомными числами от -0.1 до 0.1, а матрицу весов второго(выходного) слоя заполняем нулями, тут может показаться странным то, почему у нас матрица как бы транспонирована, ведь должно быть len(vocab) нейронов и у каждого по 50 весов, но для удобства дальнейших вычислений мы её заранее транспонируем.
Создаём целевой вектор, в котором нулевой элемент единица, а остальные 5 нули (мы будем всегда давать 6 слов на выбор модели и первым всегда верное пропущенное слово, а остальные случайные ложные).
Теперь приступаем к непосредственному обучению нейронной сети. Мы будем проходиться по каждому отзыву и по каждому слову (то есть каждое слово будет опорным и пропускаться рано или поздно) из этого отзыва, target_samples является списком с идентификаторами нашего опорного слова и 5 случайными ложными. Далее мы через срезы получаем идентификаторы слов рядом с опорным, до 2 слева и справа.
Выход layer_1 это просто векторное представление наших слова рядом с опорным, но mean не просто складывает строки матрицы, а делит на количество этих строк, мы это делаем сейчас, так как рядом с опорным, например, слева может не быть вообще слов и тогда будет всего два слова рядом. А таким образом мы усредняем значения для любой длины слов рядом, по которым нужно определить пропущенное слово.
В выходном слое мы просто считаем взвешенную сумму и применяем функцию активации, но считать мы будем значение не для всех слов, а только для наших 6, из которых мы предлагаем сети выбрать.
Переходим к обратному распространению, тут как обычно бинарная перекрестная энтропия для подсчета ошибки и sigmoid на выходном слое, дельта в таком случае равна результат минус истина, получили вектор из 6 дельт для 6 нейронов, которые считали значения для наших предложенных слов. Для первого слоя дельта равна взвешенной сумме дельт выходного слоя на веса.
Далее обновляем веса, тут всё как обычно. Для первого слоя вычитаем дельту умноженную на коэффициент из тех строк, в которых веса для входных слов. Умножать на сами эти слова (точнее из идентификаторы) не нужно, там всё равно единица только в одном месте, строку которую мы итак выбрали, а остальные не трогаем, типо уже домножили на ноль.
Для выходного слоя вычитаем дельту умноженную на выход первого слоя (для этого снова используем np.outer) и умноженную на коэффициент.
import numpy as np
np.random.seed(1)
from datasets import load_dataset
import pandas as pd
import re, math, random
random.seed(1)
from collections import Counter

dataset = load_dataset("blinoff/kinopoisk")
df = pd.DataFrame(dataset["train"])

def clean(text):
    text = text.replace("n", " ").replace("xa0", " ").lower()
    text = re.sub(r"[^а-яa-zsё]", "", text)
    text = re.sub(r"s+", " ", text)
    return text.strip()

raw_reviews = list(map(clean, df["content"].tolist()))#список с отзывами
tokens = list(map(lambda x: x.split(" "), raw_reviews))

wordcnt = Counter()
for sent in tokens:
    for word in sent:
        wordcnt[word] -= 1
vocab = list(map(lambda x:x[0], wordcnt.most_common())) #от самого редкого слова до самого частого

word2index = {}
for i, word in enumerate(vocab):
    word2index[word] = i

concatenated = list()
input_dataset = list()
for sent in tokens:
    sent_indices = list()
    for word in sent:
        sent_indices.append(word2index[word])
        concatenated.append(word2index[word])
    input_dataset.append(sent_indices)
concatenated = np.array(concatenated)

random.shuffle(input_dataset) # перемешаем наши отзывы
alpha, iterations, hidden_size, window, negative = (0.05, 2, 50, 2, 5)

weights_1 = np.random.rand(len(vocab), hidden_size) * 0.2 - 0.1
weights_2 = np.zeros((len(vocab), hidden_size))

layer_2_target = np.zeros(negative+1)
layer_2_target[0] = 1

def similar(target='плохой'):
    target_index = word2index[target]
    scores = Counter()
    for word, index in word2index.items():
        raw_difference = weights_1[index] - weights_1[target_index]
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(50)

def sigmoid(x):
    return 1/(1+np.exp(-x))

correct = 0
total = 0
for rev_i, review in enumerate(input_dataset*iterations):
    for target_i in range(len(review)):
        target_samples = [review[target_i]]+list(concatenated[(np.random.rand(negative)*len(concatenated)).astype('int')]) #выбираем одно истинное слово и 5 рандомных
        left_context = review[max(0, target_i-window):target_i] # слова слева от истинного слова, но не более размера скользящего окна
        right_context = review[target_i+1:min(len(review),target_i+window+1)] # слова справа
        if not left_context and not right_context: continue

        layer_1 = np.mean(weights_1[left_context+right_context], axis=0)
        layer_2 = sigmoid(layer_1.dot(weights_2[target_samples].T))
        layer_2_delta = layer_2 - layer_2_target
        layer_1_delta = np.dot(layer_2_delta, weights_2[target_samples])

        weights_1[left_context+right_context] -= alpha*layer_1_delta
        weights_2[target_samples] -= alpha*np.outer(layer_2_delta, layer_1)
        if np.argmax(layer_2) == 0: correct +=1
        total +=1

    if rev_i%250 == 0:
        print(f"Progress: {rev_i/float(len(input_dataset)*iterations):.4f} TrainAcc: {correct/total:.4f}")

print(similar())
В конце мы ведём подсчёт верно угаданных слов, вы можете также добавить проход по тестовому набору. В таком случае точность у вас будет больше, чем во время обучения, как сделано я для простоты.
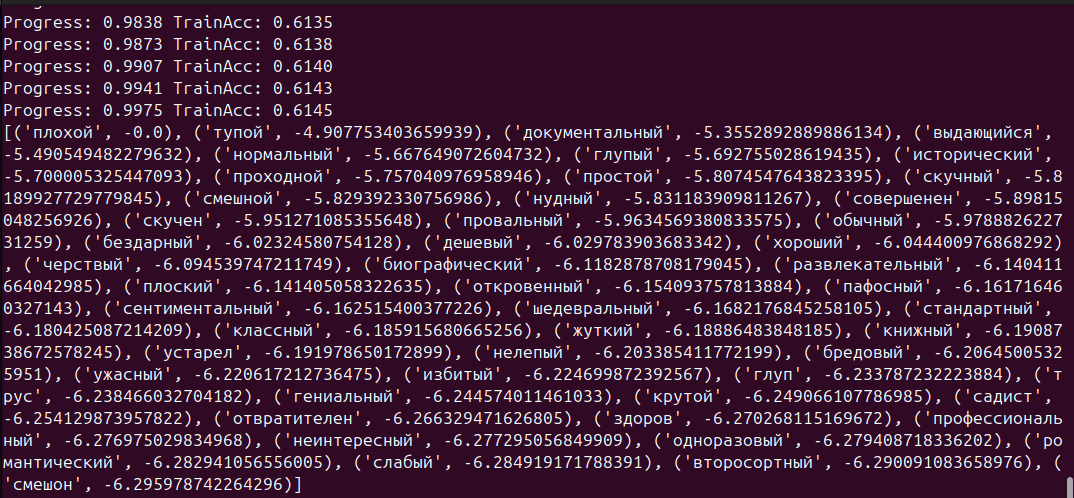
Из скриншота видно, что даже на небольшом датасете модель имеет точность свыше 61 процента на обучающем наборе данных во время обучения. Если пройтись по тестовому набору, то точность будет 70+, что очень неплохой результат.
Здесь я снова вывел, какие слова модель «считает похожими» на слово «плохой». В этот раз у нас были другие целевые значения (следовательно, и ошибки стали другими) и архитектура самой нейронной сети слегка изменилась, что повлекло за собой другую группировку слов (поменяли смысловую нагрузку весов). Ранее сеть группировала на основе эмоциональной окраски, а сейчас на основе взаимозаменяемости слов, в конечном счёте выходные нейроны начинают лучше откликаться на свою группу взаимозаменяемых слов (например, эмбеддинги слов “плохой”, “тупой”,”глупый” находятся близко к друг другу в векторном пространстве и нейронная сеть запомнила, что если встречает слова из этой группы, то скорее всего надо подставить слово “фильм”).
Таким образом, изменение входных или выходных данных, выбор способа измерения ошибки, архитектуры и методов регуляризации влияют на процесс обучения и на то, какие скрытые зависимости обнаружит сеть. Обычно все эти приёмы в совокупности называют функцией потерь.
Словесные аналогии
Интересным свойством нейронных сетей, который работают с человеческим текстом, является то, что раз слова представляются в виде векторов, значит мы можем вычитать или складывать слова и получать в результате другое слово (знаменитое выражение “король – мужчина + женщина ~= королева”).
Напишем функцию, которая и будет нам складывать и вычитать слова. В positive передаются слова, смыслы которых нужно сложить («ужасный» + «хороший»), а в negative — слово, смысл которого нужно вычесть («плохой»).
Первым делом посчитаем длину вектора (векторного представления) для каждого слова. По сути, это обычная теорема Пифагора (евклидова норма), обобщённая для многомерного пространства. На выходе получаем вектор длин. Далее приводим его к размеру матрицы len(vocab) на 1 (хотя могли использовать keepdims при суммировании) и считаем нормированные веса — делим веса каждого слова на длину его вектора, чтобы привести все векторы к единичной длине.
Далее создаём нулевое векторное представление (точка отсчёта нашего векторного пространства) и суммируем, а потом вычитаем вектора наших нормированных векторов слов. Теперь найдём ближайшие слова к получившемуся вектору.
def analogy(positive=["ужасный", "хороший"], negative=["плохой"]):
    norms = np.sqrt(np.sum(weights_1*weights_1, axis=1)) #считаем длину вектора векторного представления каждого слова
    norms.resize(norms.shape[0], 1)
    normed_weights = weights_1/norms
    query_vect = np.zeros(len(weights_1[0]))
    for word in positive:
        query_vect += normed_weights[word2index[word]]
    for word in negative:
        query_vect -= normed_weights[word2index[word]]

    scores = Counter()
    for word, index in word2index.items():
        raw_difference = normed_weights[index] - query_vect
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(10)

print(f"{similar()}nn")
print(f"{analogy()}n")
В результате получаем вполне осмысленный топ: «незабываемый», «замечательный», «удивительный» и «качественный». Вычитая «плохой» из «ужасного», нейросеть убрала негативную окраску, но сохранила эмоциональную силу слова. А когда мы прибавили слово «хороший», модель попала в область позитивных слов.
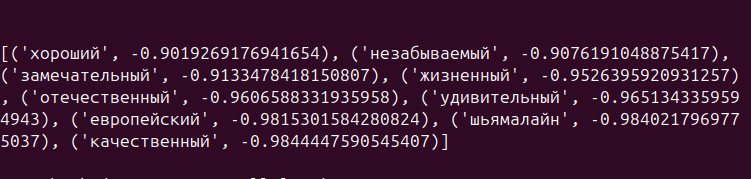
При этом на первом месте закономерно осталось само слово «хороший» (поскольку его вектор участвовал в сложении), а попадание в список таких слов, как «отечественный» или «шьямалайн», объясняется спецификой датасета — в отзывах на Кинопоиске они часто стоят в том же контексте перед словом «фильм».
На этом эта часть подходит к концу. Если у вас остались вопросы или вы нашли опечатки, то жду вас в комментариях.
Автор: PXI

