


Мой путь в агентскую разработку начался, как и у многих, с использования Claude Code. Но вот настал день, когда Антропики забанили аккаунт — и возникла необходимость переехать к другому провайдеру фронтирной LLM для разработки.
Я попробовал Kimi, как раз в этот момент вышла новая K3.1 Pro у них. И в целом опыт оказался положительным — не почувствовал что эта модель заметно хуже Opus 5.5 на моих задачах. Да, она заметно дороже — меньше лимитов в подписке. Но вот что точно не понравилось — Kimi Code малофункциональна и неудобна в сравнении с Claude Code (я использую расширения для VS Code, так что речь только про них). Пока я не нашёл достойных альтернативных харнесов, решил использовать Kimi с Claude Code. Это довольно просто — достаточно поменять API-эндпоинт и имена моделей в настройках.
Медленные проверки доступа агента к инструментам
Для агентской разработки в Claude Code я привык использовать режим Auto, в котором агенты получают разрешения на вызовы инструментов автоматически. Очень полезный и удобный режим, но в связке с Kimi он оказался узким горлышком.
Проблема проявляется следующим образом: просишь агента запустить тесты или git push, и Claude Code замирает на какое-то время, иногда на минуты! Основная модель уже написала ответ, но инструмент не запускается: внутри есть второй LLM-вызов, который решает, безопасно ли действие.
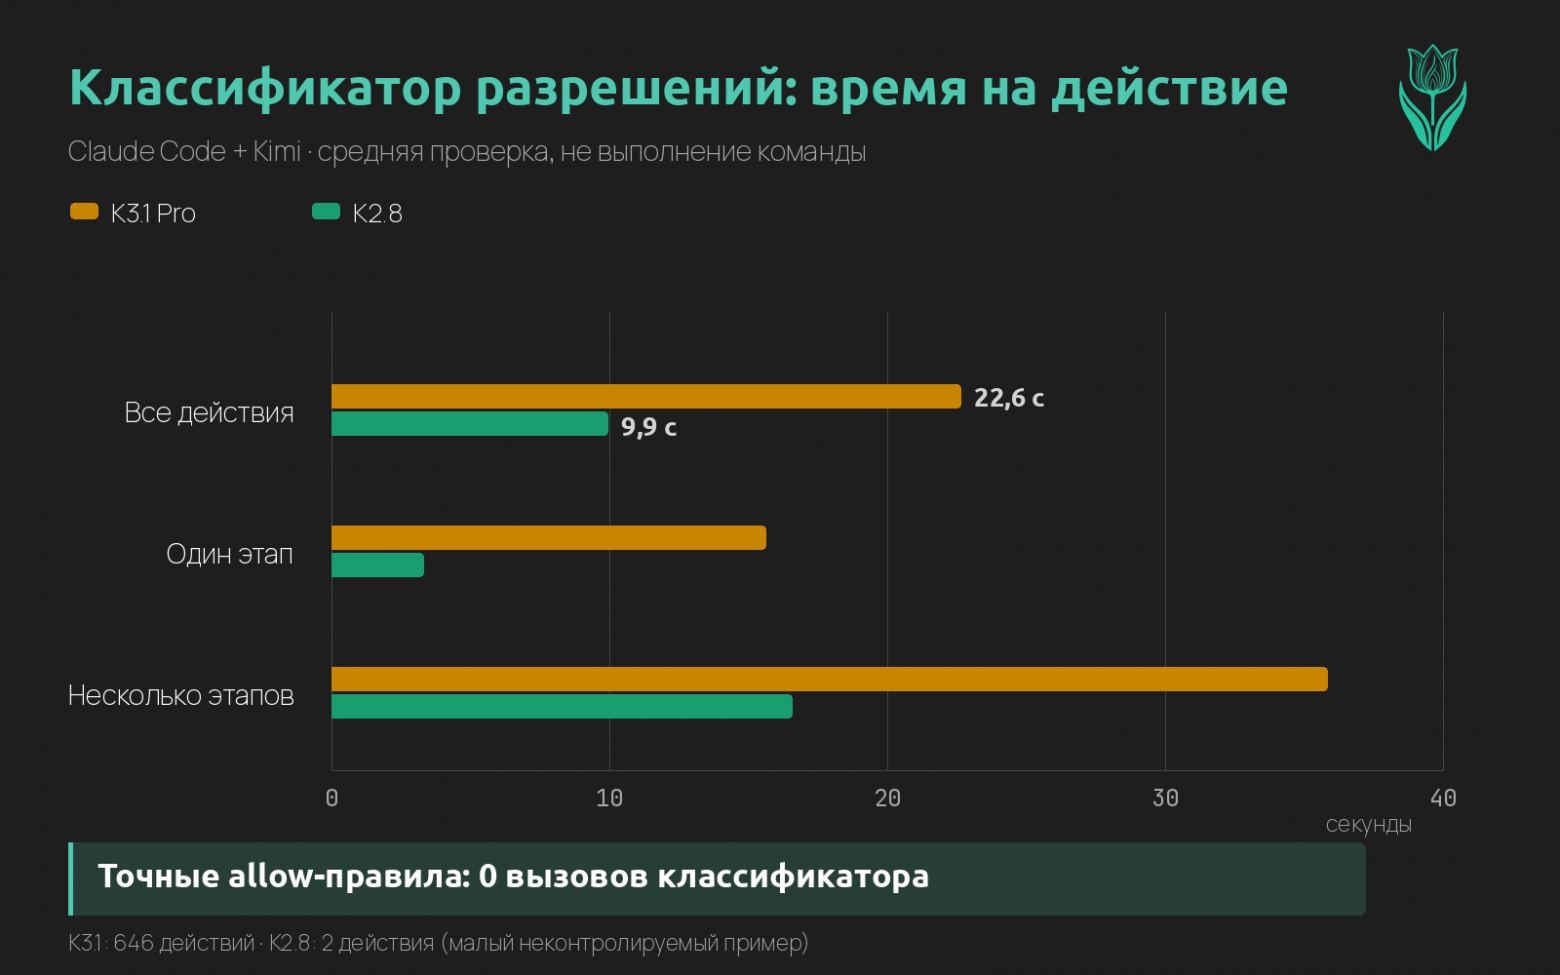
Я посмотрел логи двух своих больших задач с агентами и субагентами. На 646 действиях K3.1 Pro тратил в среднем 22,6 секунды только на проверку разрешения: 15,6 с для одноэтапной проверки и 35,8 с для многоэтапной. Встречались отмены на 120 секундах. По оценке для 30 субагентов, классификатор занял 23,8% их активного времени.
Причина не в том, что Kimi медленно пишет код (хотя скорость инференса у него действительно заметно меньше, чем у того же Opus 5.5). В авто-режиме Claude Code отправляет отдельному классификатору часть диалога и ожидаемое действие, а потом ждёт разрешения на запуск.
При этом у Антропика это реализовано в виде расширения протокола между харнесом и LLM — так называемый server-side review. В Kimi, а также у большинства других фронтирных LLM, это расширение не реализовано. Именно для этого в Claude Code есть режим совместимости — "CLAUDE_CODE_AUTO_MODE_SERVER": "0", в котором обращение к классификатору делается не через расширение протокола, а как отдельный запрос к LLM.
У Антропика server-side review хорошо оптимизировано — по-видимому работает в параллели с основной моделью, и поэтому каких-то больших задержек незаметно (также они не учитывают расходы на классификацию в квотах). А вот в случае с внешним классификатором, эти синхронные проверки становятся мощным замедляющим фактором — и заметной строкой расходов.
Решение
Эффективное исправление — введение явных разрешений доступа, по типу таких:
{
  "permissions": {
    "allow": [
      "Bash(python3 -I .agents/skills/quoll-design/scripts/fmt.py *)",
      "Bash(git push origin HEAD)"
    ]
  }
}
Я разделил разрешения на три категории. В первую вошли общие для всех проектов — у меня это операции с Git и gh. Не деструктивные. Такие разрешения имеет смысл добавить в глобальный ~/.claude/settings.json.
Во вторую категорию вошли проверки, характерные для конкретного проекта — например, вызовы компиляторов, линтеров, тестов и т.п. Их кладем в .claude/settings.json в репозитории. Claude Code автоматически объединяет локальные и глобальные списки разрешений.
В треью категорию я выделил команды, используемые во время релизов и других менеджмент-процедур. В моём процессе агент приготавливает список всех этих команд заранее, я добавляю точные правила с полными параметрами в .claude/settings.local.json — и после этого агент сможет быстро выполнить их все. Для редкого force-push можно просто перейти в Manual и один раз подтвердить действие.
Запросы к инструментам, которые попадают под правила, вообще не вызывают классификатор. Оставшиеся неизвестные действия я перевёл на kimi-for-coding (K2.8) через CLAUDE_CODE_AUTO_MODE_MODEL. На первых тестах проверки разрешений эта модель показала среднее время 9,9 с вместо 22,6 с у K3.1 pro — примерно в 2,3 раза быстрее (это не полноценный бенчмарк, но ориентироваться помогает).
Важно: permission rules — это защита от случайных деструктивных действий, а не граница безопасности. Агент может переписать ваши файлы и без Bash.
Вывод простой: не каждое разрешение требует второй LLM. Детерминированные правила быстрее, дешевле и предсказуемее, а модель стоит оставить для действительно неоднозначных случаев.
Посмотреть мою конфигурацию и release workflow можно в этом PR #34 в Quoll.
Напишите в комментариях, какую харнесс вы используете для разработки вместо Claude Code и с какими LLM!
Автор: wsnark

Советуем прочесть:
 Как я перестал пересказывать агенту проект каждое утро: память для Claude Code, Codex и других агентов 09.11.2026 Есть момент, знакомый всем, кто работает с ИИ-агентами дольше недели.…
 Разработчики ядра Linux планируют отменить требование об использовании тега «Assisted‑by» для ИИ 16.10.2026 В настоящее время патчи к ядру Linux, созданные при помощи инструментов искусственного интеллекта,…
 Организаторы главной литературной премии Франции исключили претендента за подозрение в использовании ИИ… 29.09.2026 Организаторы Гонкуровской премии — самой престижной литературной награды Франции — исключили одного из претендентов…
 Одна сессия Claude Code на нескольких машинах: что ломается, если просто синхронизировать папку 01.09.2026 У меня три рабочих места с пятью ОС: десктоп на…
 Если ваши разработчики используют Claude Code, вы еще не автоматизировали разработку 11.09.2026 Вдохновлено творчеством художника DDeesПредставьте, что в вашу команду взяли уверенного…
 Синхронизация Claude Code, месяц спустя: что ещё сломалось, когда машин стало две по-настоящему 28.09.2026 В первой статье я разбирал, почему ~/.claude нельзя просто положить…
 Claude Code в пентесте ТехВилла: где ИИ ускоряет работу, а где ошибается 27.08.2026 Автор статьи занимается пентестом в ТехВилле. Несколько месяцев он использовал…
 В МВД заявили о рисках для данных при использовании ChatGPT 09.11.2026 Накопление персональных данных в памяти ChatGPT создаёт риски для пользователей и может…
- Торвальдс использовал Claude Code для оптимизации ядра Linux. Код ускорил чтение в 23 раза, но не прошёл проверку 26.10.2026 Линус Торвальдс подключил Claude Code к работе над ядром Linux…
 5,75 миллиарда токенов за полгода: как я перестал жечь контекст в Claude Code 02.09.2026 Полгода назад я начал писать веб-лист персонажа для D&D 5e.…
