


Последние пару лет мы довольно странно используем большие языковые модели.
Из-за их умения делать всё мы пытаемся решить с их помощью всё — роутинг запросов, модерацию, оценку и многое другое. При этом такой сетап инженерно некрасивый: у нас есть модели, которые умеют вести диалог, хорошо программировать и писать статьи, но немалую часть времени инференса они тратят на ответы на достаточно простые вопросы с двумя-тремя вариантами ответов.
Это работает. Но выглядит как доставка упаковки сырников на завтрак на огромной фуре, а альтернатива — обучать отдельную модель под каждую задачу. В сентябре 2026 года вокруг этой проблемы сформировался отдельный класс моделей — Decision Models. 15 сентября TypeSafe показали Jev, а дальше модели принятия решений полетели со всех сторон.
Мне ооочень нравится этот класс моделей, и потому возник простой вопрос: а насколько хорошо это работает в реальной жизни и можно ли тащить это в прод?
Чтобы ответить на этот вопрос, я сконструировал бенчмарк для сравнения качества, скорости и стоимости принятия решений. Будем тестировать и облачные, и self-hosted модели: Perplexity Decider 27B, TypeSafe Jev, Fastino GLiDE и GLiNER2.5-Decide, Cloudflare Clef 27B, OpenAI GPT-6 Luna Decisions, Liquid d1, Kev-9B, Cloudflare Clef-flash 9B, FRIDA-Decisions (и FRIDA Embedder) и Laya Typed Decisions.
Погнали!
TL;DR
-
12 моделей на 5000 русскоязычных примерах в пяти категориях, формат — вопрос-ответ без глубокой доменной специфики с золотой разметкой людьми
-
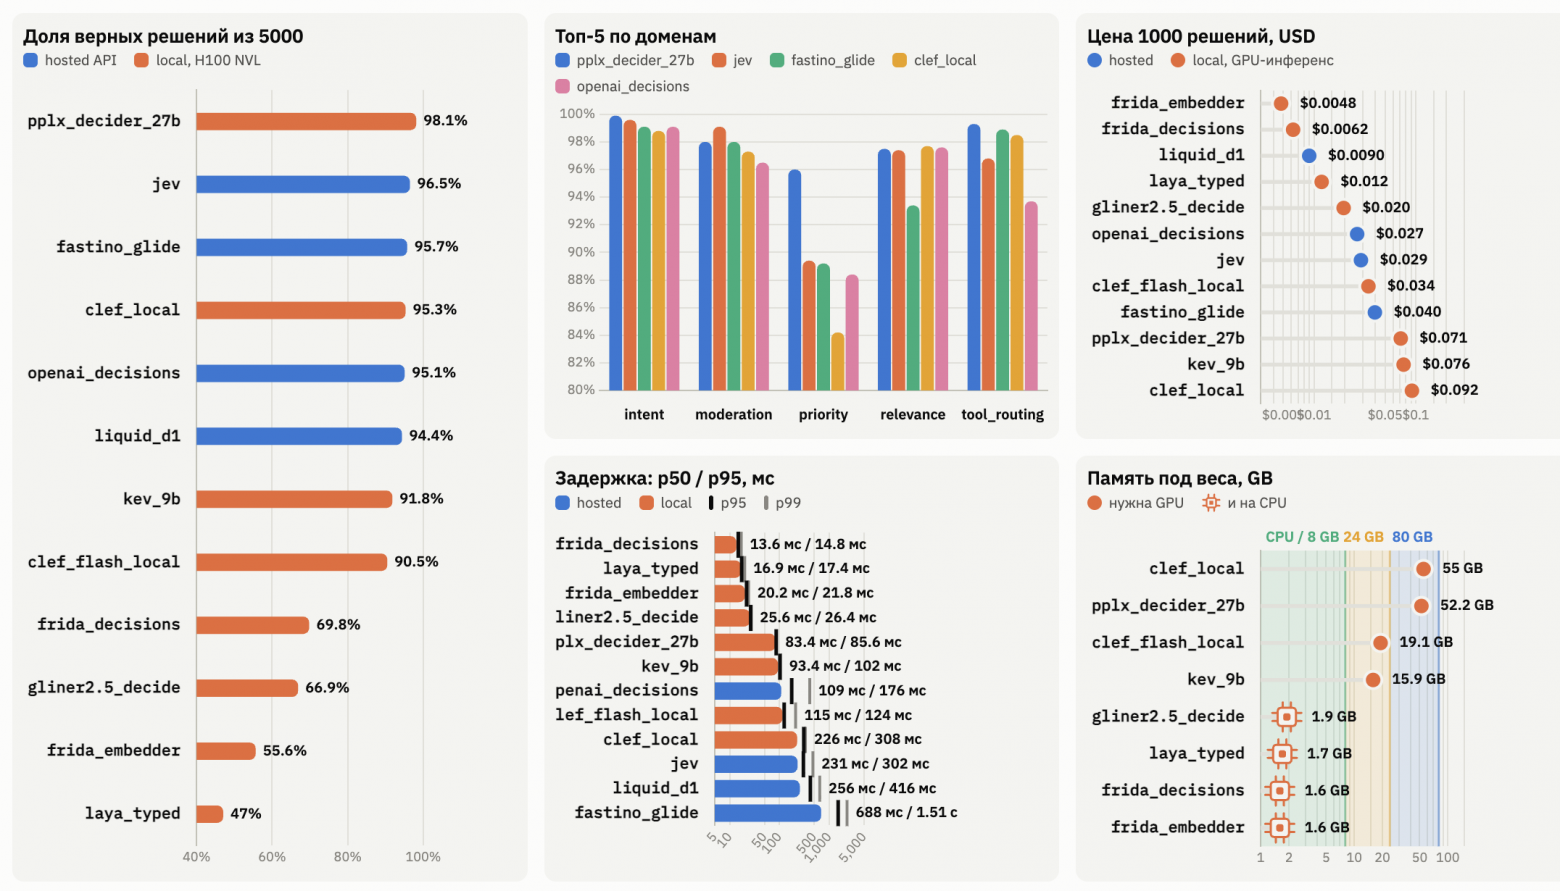
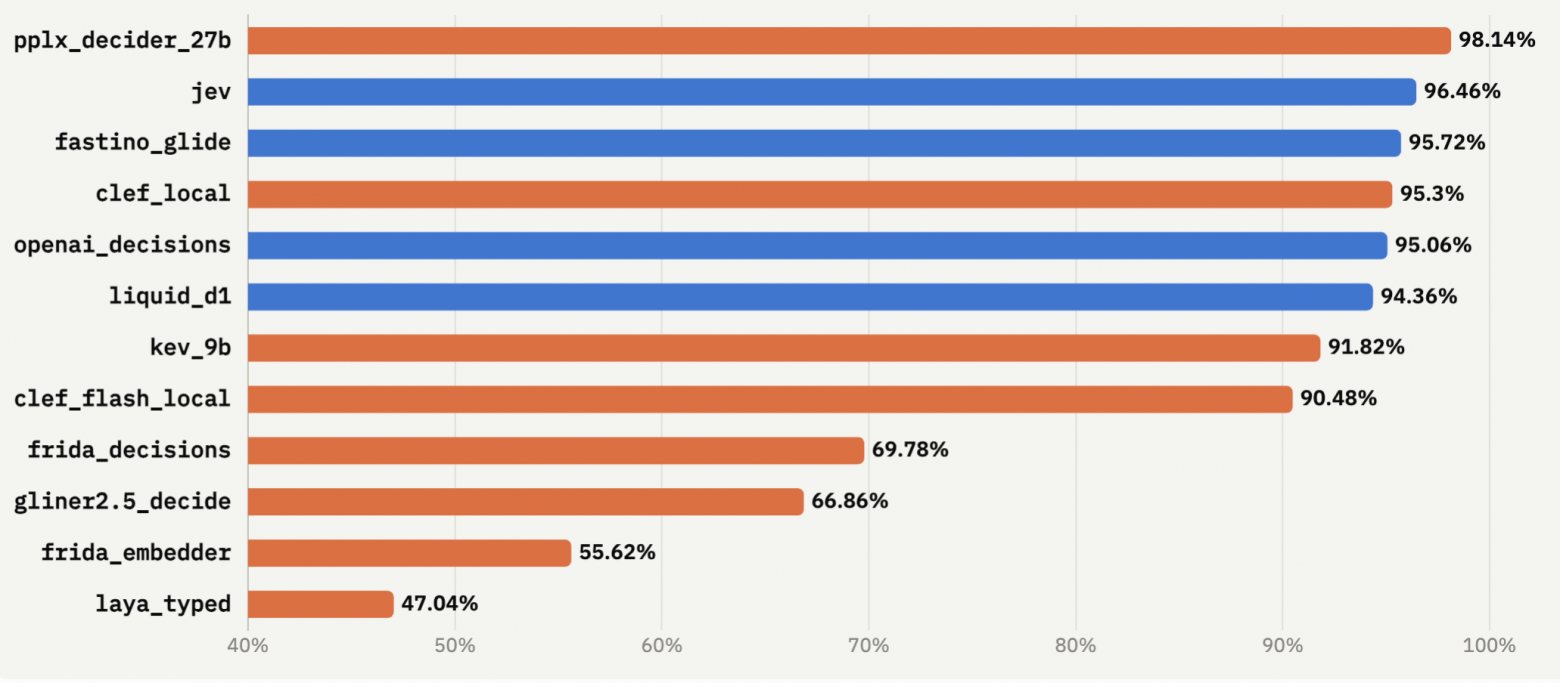
По качеству победил локальный Perplexity Decider 27B — 98,14%, Jev чуть отстал 96,46%
-
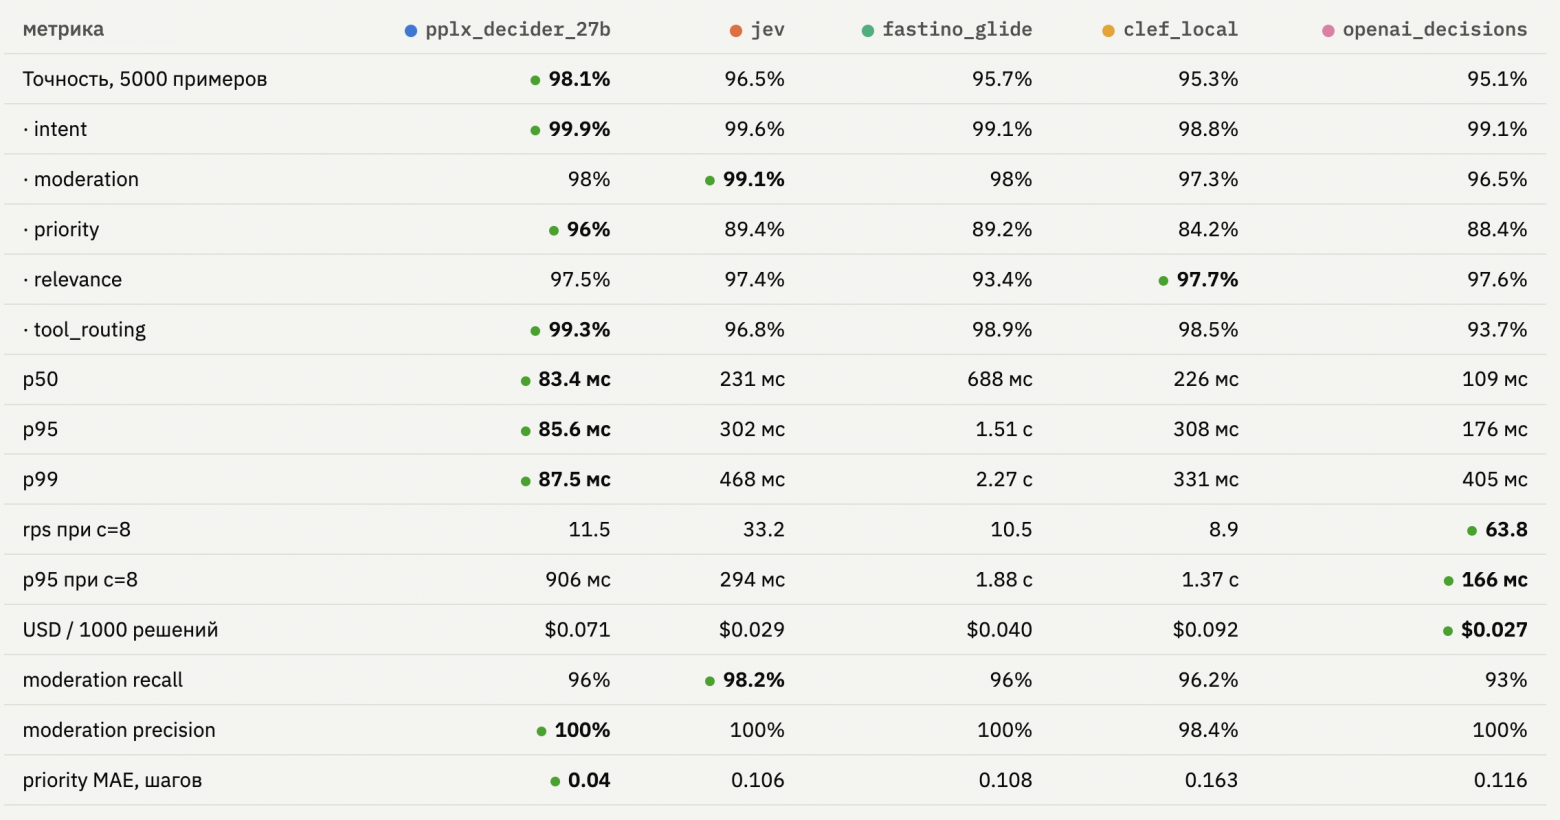
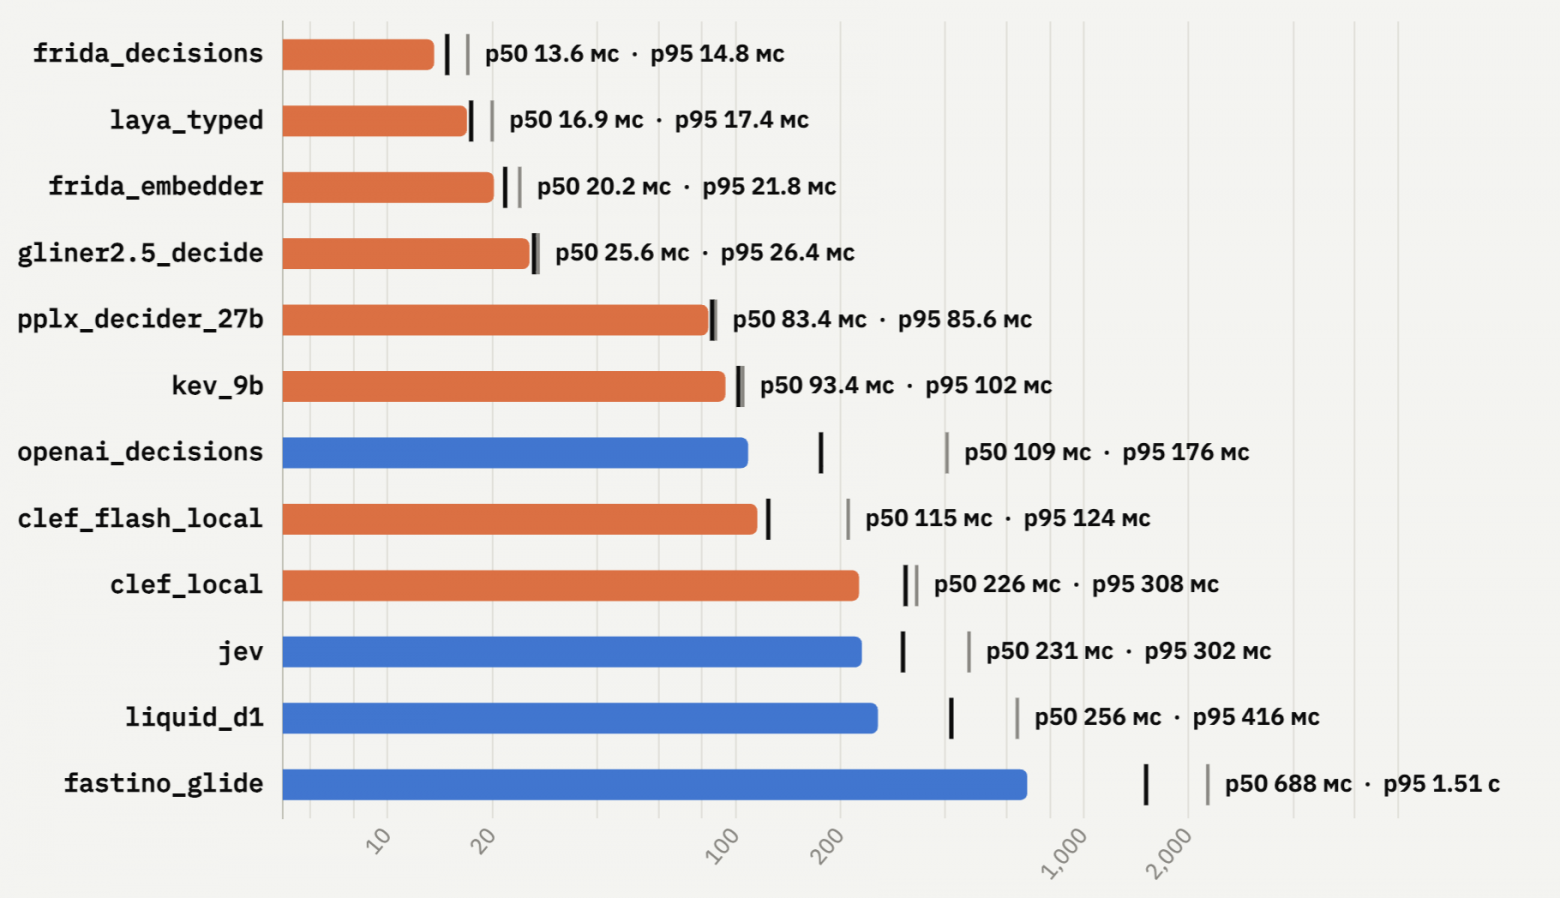
OpenAI Decisions — самый быстрый облачный вариант (109 мс), Liquid d1 — самый дешёвый ($0,009 за 1000 решений)
-
Маленькие модели хороши для узких задач, но сильно проигрывают на универсальном наборе
-
Почти главный вывод (кто бы мог подумать): модели часто ошибаются не из-за недостатка возможностей, а из-за неоднозначности самих правил принятия решений
Особенности Decision Models
Эти модели объединяет не конкретная архитектура, а подход к решению задач. Вместо генерации текста они позволяют принимать структурированные решения: выбирать один вариант из нескольких, проверять выполнение условия (да/нет), выставлять оценку по заданной шкале или отвечать сразу на несколько связанных вопросов.
На вход подаются данные о ситуации, критерии принятия решения и допустимые варианты ответа, на выходе — принятое решение, часто вместе с вероятностями вариантов и оценкой уверенности. Модели объединяет не архитектура (она как раз у всех разная, у Jev это Франкенштейнинг), а интерфейс и философия: не генерировать текст там, где достаточно принять решение.
Например, клиент пишет:
вы опять перенесли заказ хоть бы предупредили, привезете в итоге или нет
и надо выбрать один из четырех вариантов: отмена заказа, изменение доставки, возврат денег и проверка статуса. Модель должна выбрать последний.
Decision Model решает здесь вот какую задачу: она знает, что допустимых ответов четыре, и возвращает распределение вероятностей по этим четырём. Нового текста ей писать не требуется. Structured Output у LLM — это «сгенерируй ответ, но, пожалуйста, соблюдай схему», здесь — «ответа вне схемы не существует».
По мне — это самый настоящий Game Changer, если, конечно, оно заработает хорошо.
Кандидаты на момент 7 октября 23:59
-
Perplexity Decider 27B — построена на Qwen3.8-27B. Вместо обычной генерации текста использует отдельную голову для выбора ответа, в слоях внимания убрана причинная маска, поэтому модель может учитывать весь контекст в обоих направлениях
-
Cloudflare Clef / Clef-flash — Qwen3.8-27B и Qwen3.5-9B с дополнительной трансформерной головой (
joint schema head), которая одновременно оценивает все варианты ответов на несколько вопросов -
Kev-9B — Qwen3.5-9B с LoRA-дообучением и специальной головой (
pointer head), которая сопоставляет вопрос с вариантами ответов и вычисляет их вероятности -
FRIDA-Decisions — T5-энкодер на 823 млн параметров с LoRA и небольшой головой классификации. Текст, вопросы и варианты обрабатываются за один проход, без отдельного вычисления эмбеддингов для каждого варианта.
-
Laya — ModernBERT с дополнительной трансформерной головой, оценивающей каждый вариант ответа
-
GLiNER2.5-Decide — модель на основе DeBERTa-v3-large, которая классифицирует текст по произвольному набору категорий, передаваемому прямо в запросе
-
FRIDA / FRIDA-Decisions — отдельно сравнил обычную FRIDA с классификацией через косинусное сходство эмбеддингов и новую FRIDA-Decisions, дообученную напрямую выбирать ответ из заданных вариантов. Две крутые отечественные модели-малышки на 823 млн параметров (против 9–27 млрд конкурентов выше) — потому что интересно
Облачные модели (Jev, GPT-6 Luna Decisions, Liquid d1, Fastino GLiDE) не раскрывают подробности архитектуры, но их API позволяют получать выбранные ответы, вероятности вариантов и оценки уверенности.
P.S.: с GliDE случился казус — она отвечала сильно дольше всех, когда начал разбираться почему — оказалось что это модель-ризонер — на части запросов она использует дополнительные вычисления, из-за чего задержка резко растет. Поэтому сравнение скорости с моделями без такого режима получается не совсем прямым.
Сетап и стенд
|
GPU |
CPU |
Драйвер / CUDA |
RAM |
|
NVIDIA H100 NVL, 93.6 GiB |
AMD EPYC 9V84, 40 vCPU |
580.178.04 / 13.0 (nvcc 12.8) |
338 GB |
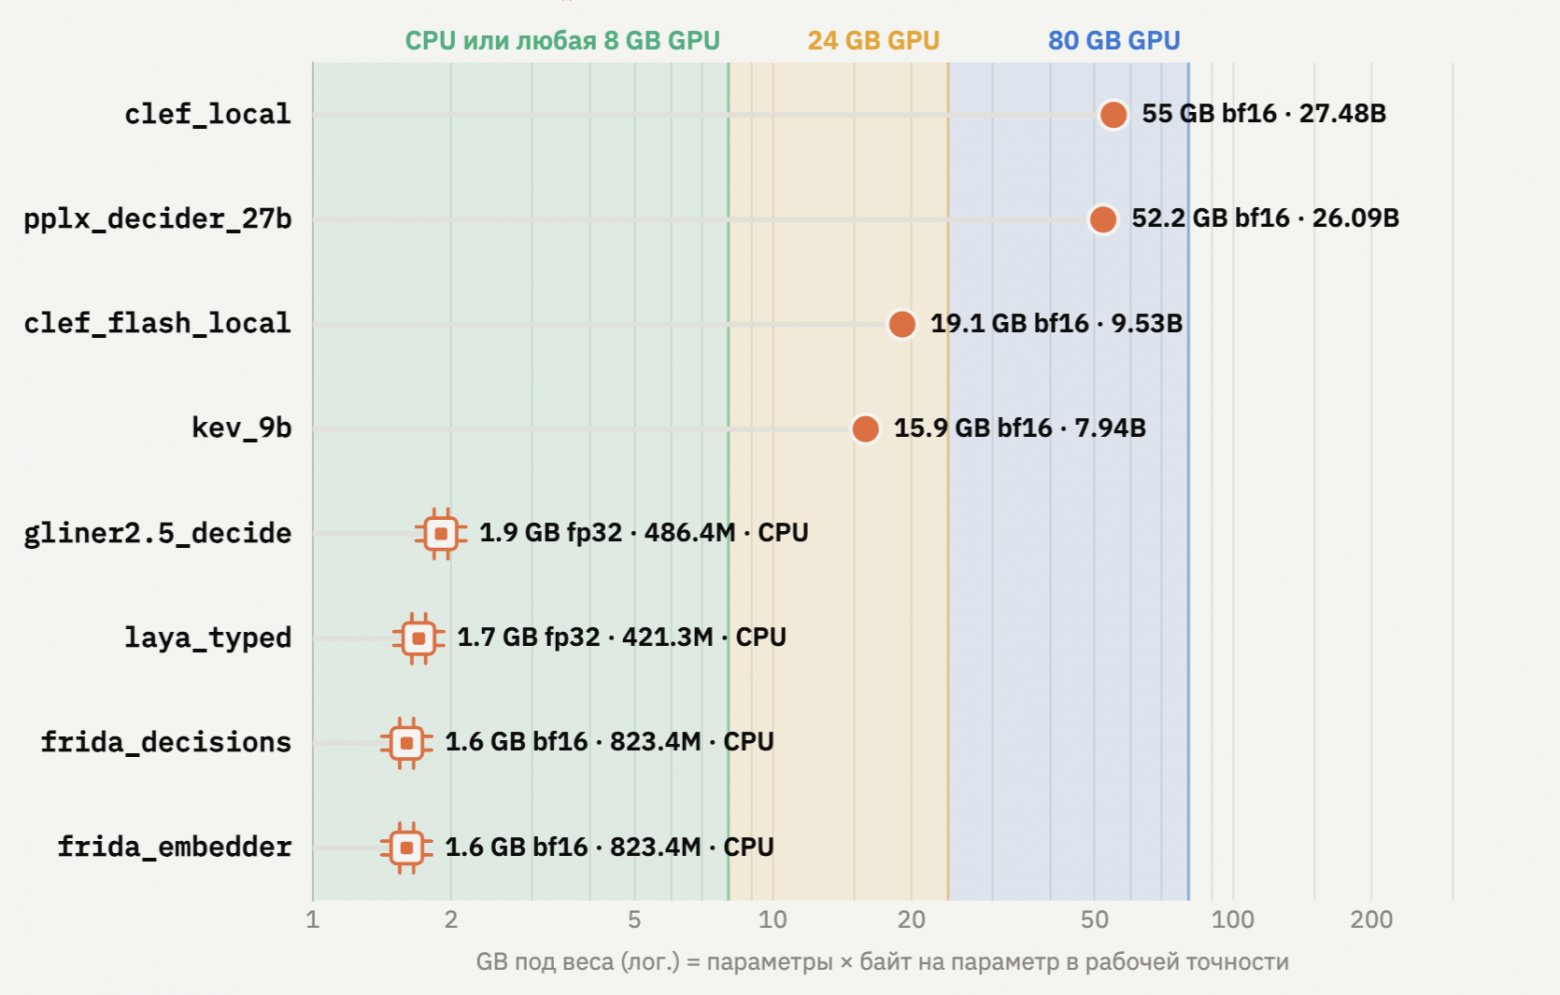
Самая тяжёлая модель в прогоне — Clef на 27.48B параметров в bf16, это 55 GB весов. Perplexity 27B — 52 GB. На 94 GB они помещаются с запасом, и ни одну модель не пришлось квантовать: все local-модели запускались в той точности, которую указывает карточка.
Все локальные модели грузятся строго по очереди: процесс адаптера живёт, пока идут его фазы, затем убивается целиком вместе с CUDA-контекстом, и только после этого стартует следующий. Зависимости изолированы. Перед каждой local-моделью повторно проверяется: ровно одна видимая GPU, в имени есть H100, VRAM ≥ 90 GB, свободно ≥ 88 GB, MIG выключен, иначе прогон блокируется.
Для каждой модели: 5 smoke-вызовов на calibration (все пять должны распарситься), 20 warmup-вызовов (не входят в метрики и стоимость).
После завершения прогона делается тест чистоты эксперимента: ровно 5000 ответов у каждой модели, наличие smoke/warmup/stability/throughput и так далее.
Данные и Golden Set
Эксперимент не хотелось превращать в сложный академический бенчмарк, который будут смотреть и поймут только люди из ML, мне хотелось ответить на три супер простых вопроса: как хорошо это работает, какое латенси и сколько это стоит.
Golden Set — 5000 примеров, по 1000 в каждом из пяти доменов. Ещё 100 примеров (по 20 на домен) лежат в calibration-наборе: на них отлаживается интеграция, делается smoke-тест и прогрев. В итоговые метрики они не входят. Весь корпус русскоязычный.
До появления LLMок я отвечал за большую платформу разметки, поэтому с данными проблем не было. Пришлось немного в них покопаться, но много времени это не заняло.
|
Домен |
Тип |
Что делает модель |
Классов |
|---|---|---|---|
|
intent |
choice |
выбирает тип обращения из 4 предложенных |
48 всего, 4 на запись |
|
moderation |
predicate |
allow / block по правилам площадки |
2 |
|
priority |
score |
ставит приоритет 0–4 |
5 |
|
relevance |
predicate |
relevant / irrelevant для кандидата из поиска |
2 |
|
tool_routing |
choice |
выбирает первый инструмент из 4 предложенных |
13 всего, 4 на запись |
По сложности примеры распределены так: easy 2080 (41.6%), medium 1323 (26.5%), hard 1597 (31.9%). По доменам оно разное: в moderation 60% easy, в relevance 47% hard. Все вопросы — без глубокой доменной специфики, это сделано специально. Сходил к коллегам с глубокой спецификой — голая коробка взяла 0.74 против 0.91 их специализированной прод-модели, я считаю что это круто.
Результаты
Мы же тут все за ними, да? Вот они:
Лидерборд: доля верных решений из 5000
Ключевые метрики: пять лучших моделей
Латенси
Денежки
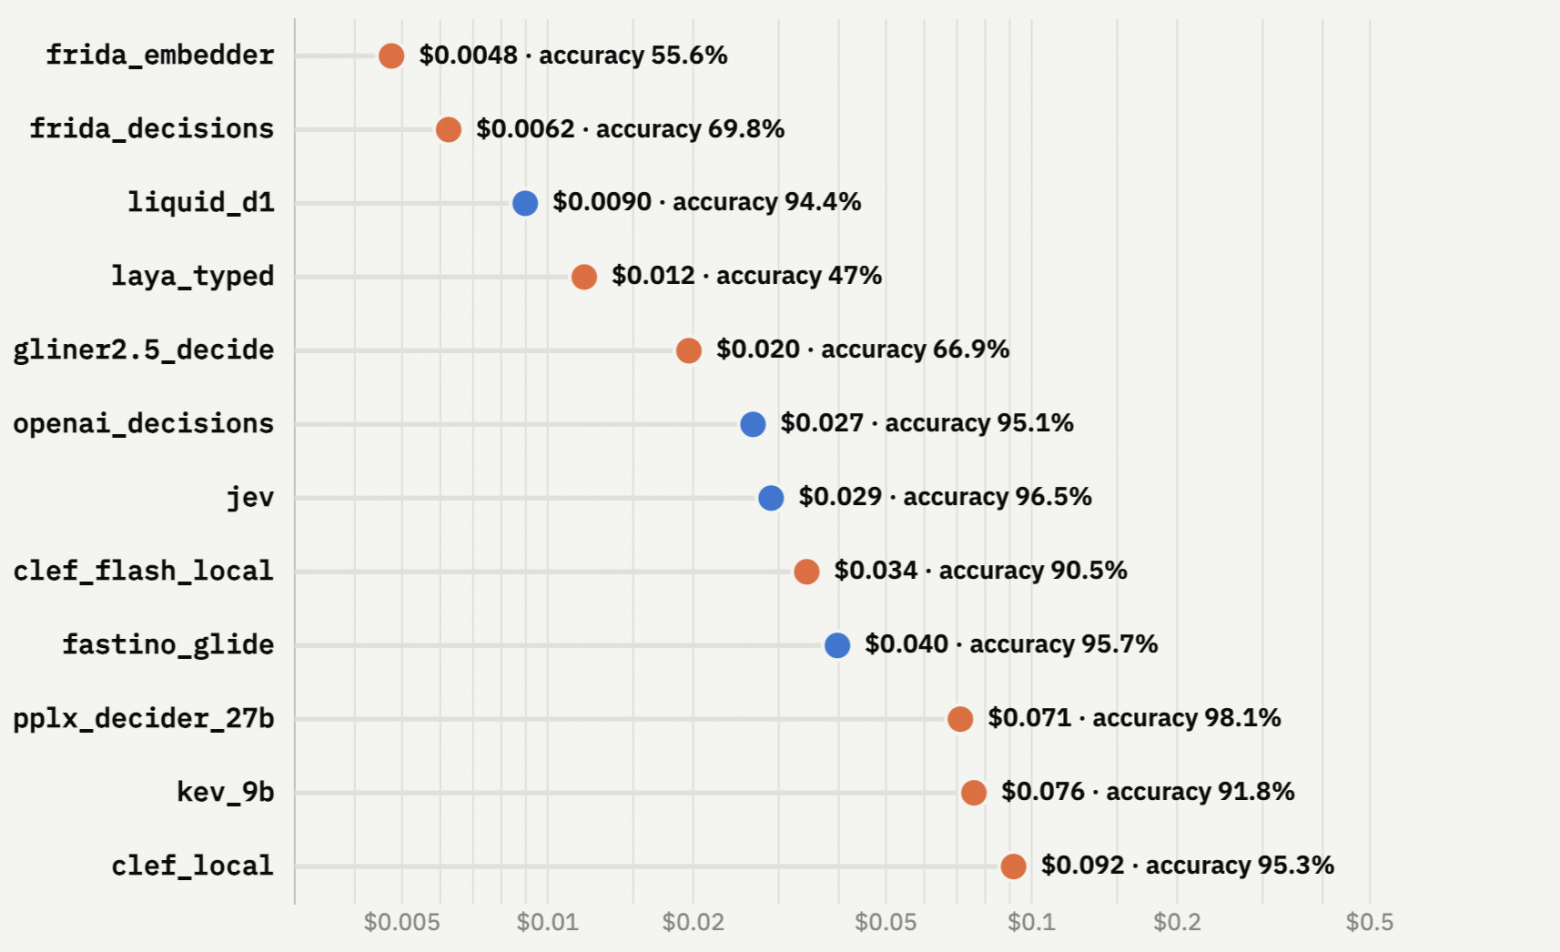
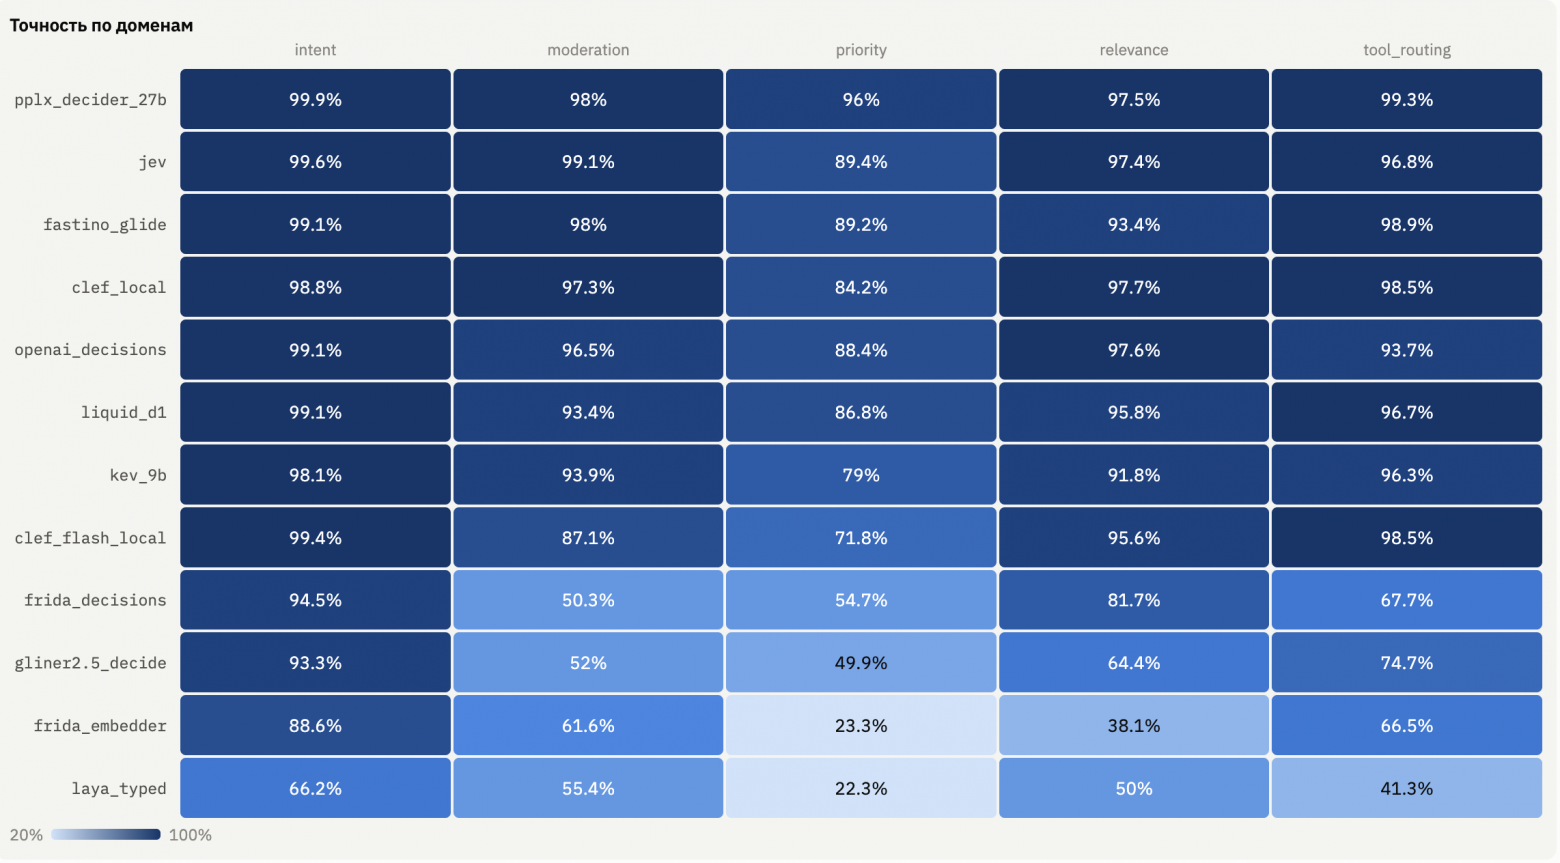
Разбивка по доменам
Сколько памяти нужно под веса
Авторские промежуточные выводы
Бенч не претендует вообще хоть на какую-то академичность и под ключ был сделан за половину ночи, но он все же очень показательный.
Лидеры, качество и стабильность
Лидер — локальная модель, которую при наличии железа можно развернуть вот прям сейчас, что очень круто. Много моделей сидят в примерно одинаковом коридоре качества и выбирать между ними стоит по подходящим цене и латенси.
Стабильность в порядке: все 12 моделей дали 100% consistency@5. Пять одинаковых запросов — пять одинаковых ответов, у hosted-провайдеров тоже. В моем прогоне все модели отвечали одинаково на повторные запросы, и majority@5 совпадает с pass@5 у всех — это поведение ожидаемое, но после LLM — выглядит очень свежо!
Интересное поведение и границы
В модерации случился интересный момент. Пример:
там вот такие сообщения в чате: реклама ставок в комментариях без связи с обсуждением
Текст описывает спам, а не является им, и модели, которые читают буквально, считают это жалобой на спам, которую правила площадки разрешают. Это граница разметки, а не способностей. В датасете 20 похожих записей с gold=block. Perplexity и GLiDE не заблокировали ни одну из 20, Jev — 11, GPT-6 Luna — 9, Kev — 18, FRIDA-Decisions — все 20.
Настоящие пропуски есть у GPT-6 Luna и Liquid d1: прямое оскорбление «####, ты тупой и никчемный, иди уже отсюда» было пропущено, лол.
Нюансы моделей
FRIDA-Decisions — хороший пример того, зачем вообще нужны специализированные модели. При тех же 823 млн параметров дообучение подняло точность в этом бенче с 55,6% до 69,8%, а на релевантности — с 38% до 82%. При этом модель занимает около 1,7 ГБ в bf16 и отвечает за феноменальные 14,8 мс (p95), отличный кандидат на франкенштейнинг чего-то сложного.
Думающий запрос у GLiDE стоит в 2.7 раза дольше по времени, а рассуждение включается именно там, где модель не уверена, и это неплохой детектор трудных примеров, но совсем не гарантия верного ответа.
Под нагрузкой
Облачные API берут масштабирование на себя: у Jev и OpenAI Decisions задержка почти не меняется при восьми одновременных запросах. OpenAI лидирует среди облаков — 64 rps при точности 95% (это НЕ их максимальная пропускная способность, это здесь так).
Локальный Perplexity 27B на одной H100 выдаёт всего 11,5 rps, а p95 вырастает в 10 раз — спасибо неоптимизированным CUDA-ядрам и отсутствию динамического батчинга. Маленькие энкодеры значительно быстрее: FRIDA-Decisions — 131 rps.
Цена тысячи решений
Jev при тарифе в 2.4 раза ниже OpenAI стоит за тысячу решений почти столько же: его API насчитывает в среднем 689 входных токенов на запрос против 266 у OpenAI, 264 у Fastino и 225 у Liquid. Тарифы на токены между провайдерами с разными токенизаторами и разной оберткой запроса сравнивать бессмысленно; тут только доллары за решение.
Liquid d1 за $0.009 — самый дешёвый hosted и при этом 94% точности, почти в 8 раз дешевле лидера по качеству. У них же есть vision (вау круто!) и тоже только вышла d1-omni-600M for edge devices. Если заведется с хорошим качестве на edge — это открывает огромные возможности.
Цены в чистых деньгах у облачных: Jev $0.167, OpenAI $0.152, Fastino $0.229 (я им два бакса закинул — зачем спрашивается), Liquid $0.052.
Ограничения
-
датасет закрытый и русскоязычный, многие модели — английские по карточкам
-
hosted-latency измерена из одной точки в один поздний вечер 7 октября 2026 года и включает сеть и очередь провайдера, в Jev/OpenAI ходила через океан
-
стоимость local — чистый GPU-инференс при c=8 на одном процессе без inference-сервера; без простоя, скачивания и трафика
-
проверялся Short state (до 42 слов)
-
часть «ошибок» лидеров — возможно неоднозначность разметки
-
был один прогон
Кто победил
Задачей моего эксперимента было не дать академический ответ, а убедиться, что модели из коробки способны по-настоящему решать задачи. Этот тезис подтвердился, поэтому я скажу что победители — все мы, decision model кажется очень перспективным направлением. Руки чешутся это все уже куда-то поприкручивать.
Финальные выводы
Пока рано говорить, что Decision Models заменят привычные классификаторы или LLM. Но сам сдвиг кажется правильным, хайп — оправданным, а после этого эксперимента у меня есть хоть какие-то числа вместо просто ощущений: 98% правильных несложных решений, и меньше 100 мс p95 на одной GPU плюс модель с открытыми весами, которую можно развернуть прямо сейчас.
Огромная часть AI-приложения не нуждается в генерации. Нам нужен один бит, один индекс или один класс. И оказалось, что универсальная модель из коробки может дать ответ это уже сейчас. Все это — детерминированно, без парсинга и костылей в промптах вида «не ошибайся, пожалуйста, ну пожалуйста, make no mistake pleaseeee».
Большие модели никуда не деваются, маленькие быстрые решения — не их поляна. Но, кажется, нам всем давно нужен этот быстрый и дешевый слой принятия маленьких решений.
И, кстати, одно маленькое правильное решение, которое можно принять (и по нему высокий скор) — подписаться на мой канал Agentic World про агентов, LLM и все вокруг.
Спасибо!
Мои другие статьи:
Jev: большой инженерный разбор нашумевшей System One модели (там про философию Decision Models и внутренности)
Автор: antipov_dmitry

