


Недавно я писал про edge-навигацию на руль — OLED, 2ГИС, велосипед/мотоцикл. Побочный эффект DIY: накопилось много не особо связаных между собой видосов. Медийку развивать мне хотелось, а времени на монтаж и разбор видео особо не было (на самом деле идея и базовая реализация появились давно, но сейчас это рпигодилось на практике).
Так появился NeuroCut — локальный AI-ассистент для rough cut. Кидаешь видео (или несколько), пишешь brief текстом, получаешь план монтажа и экспорт:
-
FCP7 XML для Premiere Pro / DaVinci Resolve;
-
ZIP с готовыми MP4-клипами (удобно для мобильных редакторов);
-
склеенный render «под ключ»;
-
субтитры на готовом клипе;
-
CEP-плагин для Premiere, который кладёт клипы на таймлайн без повторной загрузки медиа.
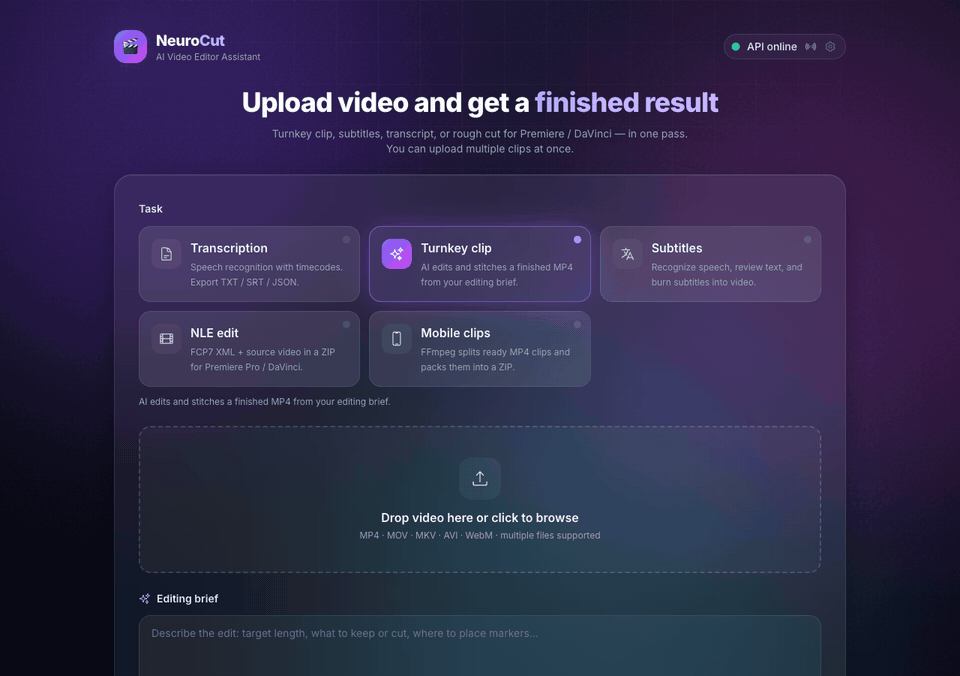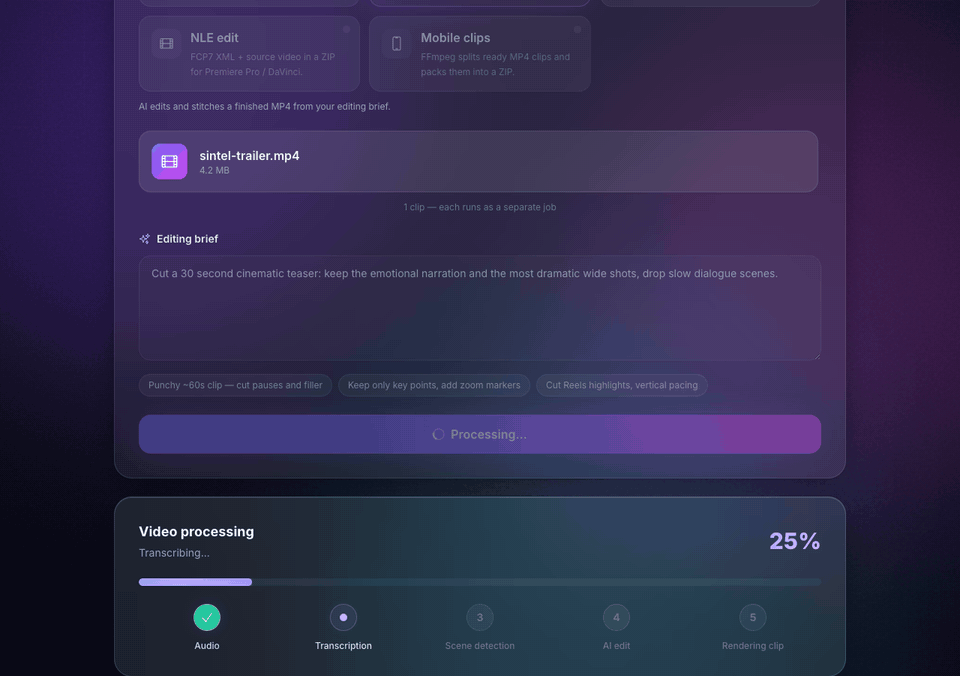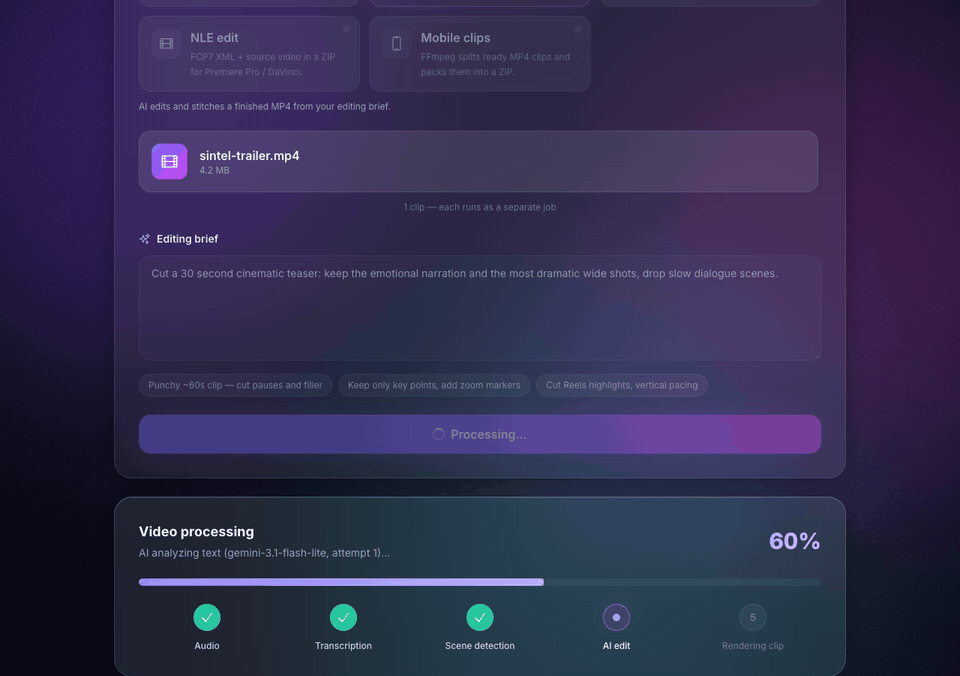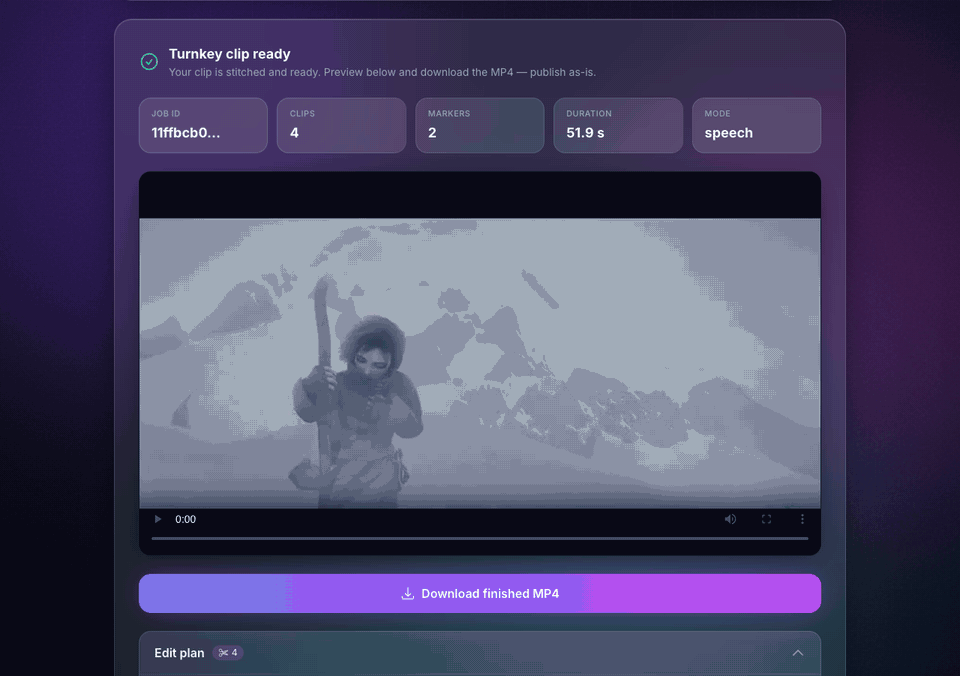
UI на старте: пять типов задач — от транскрипта и субтитров до NLE XML и turnkey MP4.
Репозиторий: https://github.com/jdmarshall95/neurocut
Разбор пайплайна, граблей и решений, на которых я споткнулся
Я не пытался полностью заменить монтажера. Цель снять с человека первый проход.
Типичный сценарий:
-
Есть запись интервью / вебинара / обзора / мультикамерный набор клипов.
-
Есть текстовое задание: «оставь только ответы про продукт, убери воду, добавь маркеры на ключевые мысли».
-
Нужен rough cut, который можно открыть в Premiere и уже руками довести.
Обьективно автоматический монтаж пока еще слабоват, примерно на уровне готовых шаблонов из кэпкат. Но задачи по типу “вырежи молчаливые паузы” он решает вполне сносно.
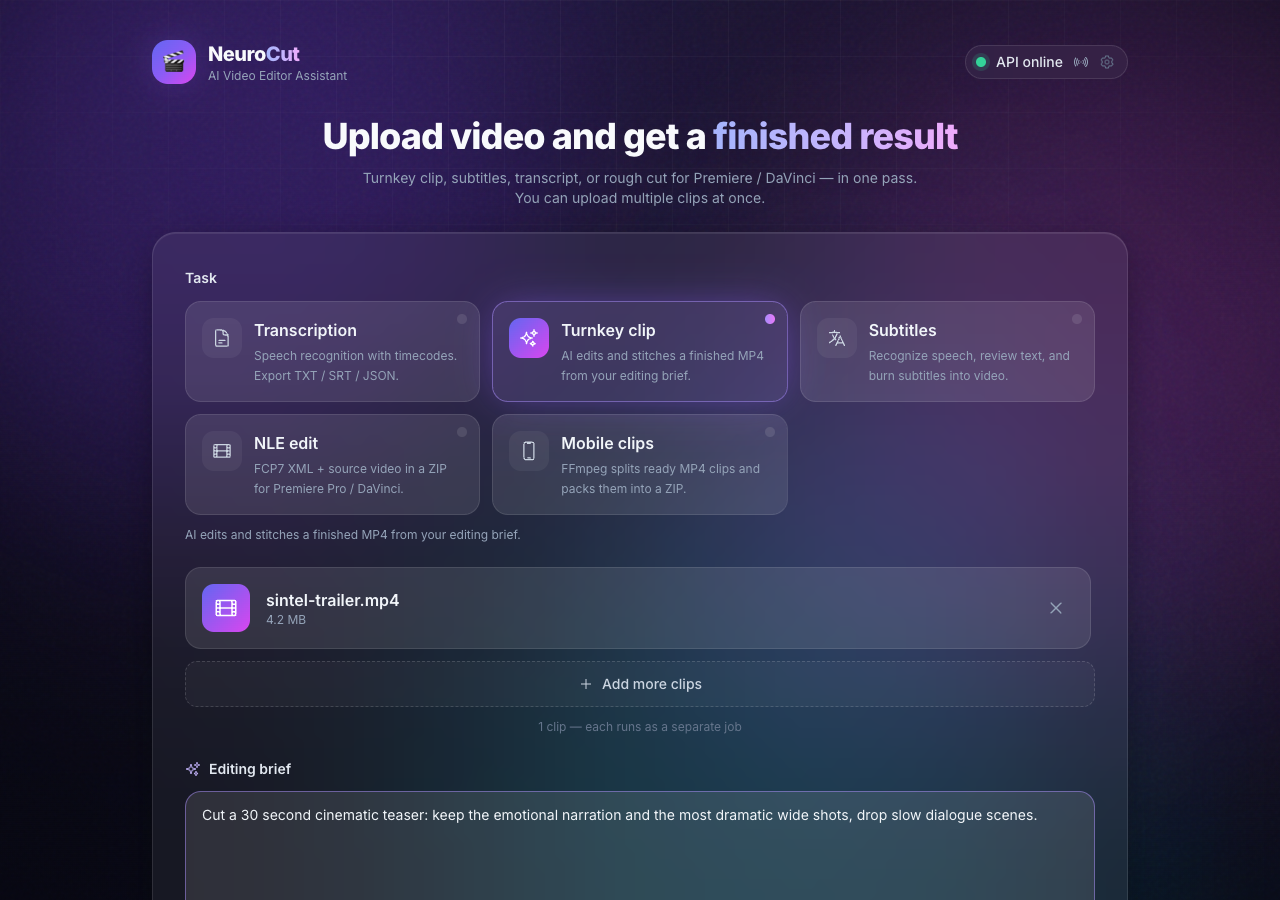
Пример: sintel-trailer.mp4 + «Cut a 30 second cinematic teaser…». Режим Turnkey clip.
Как устроен пайплайн
Схема простая по шагам и довольно жёсткая по контрактам данных.
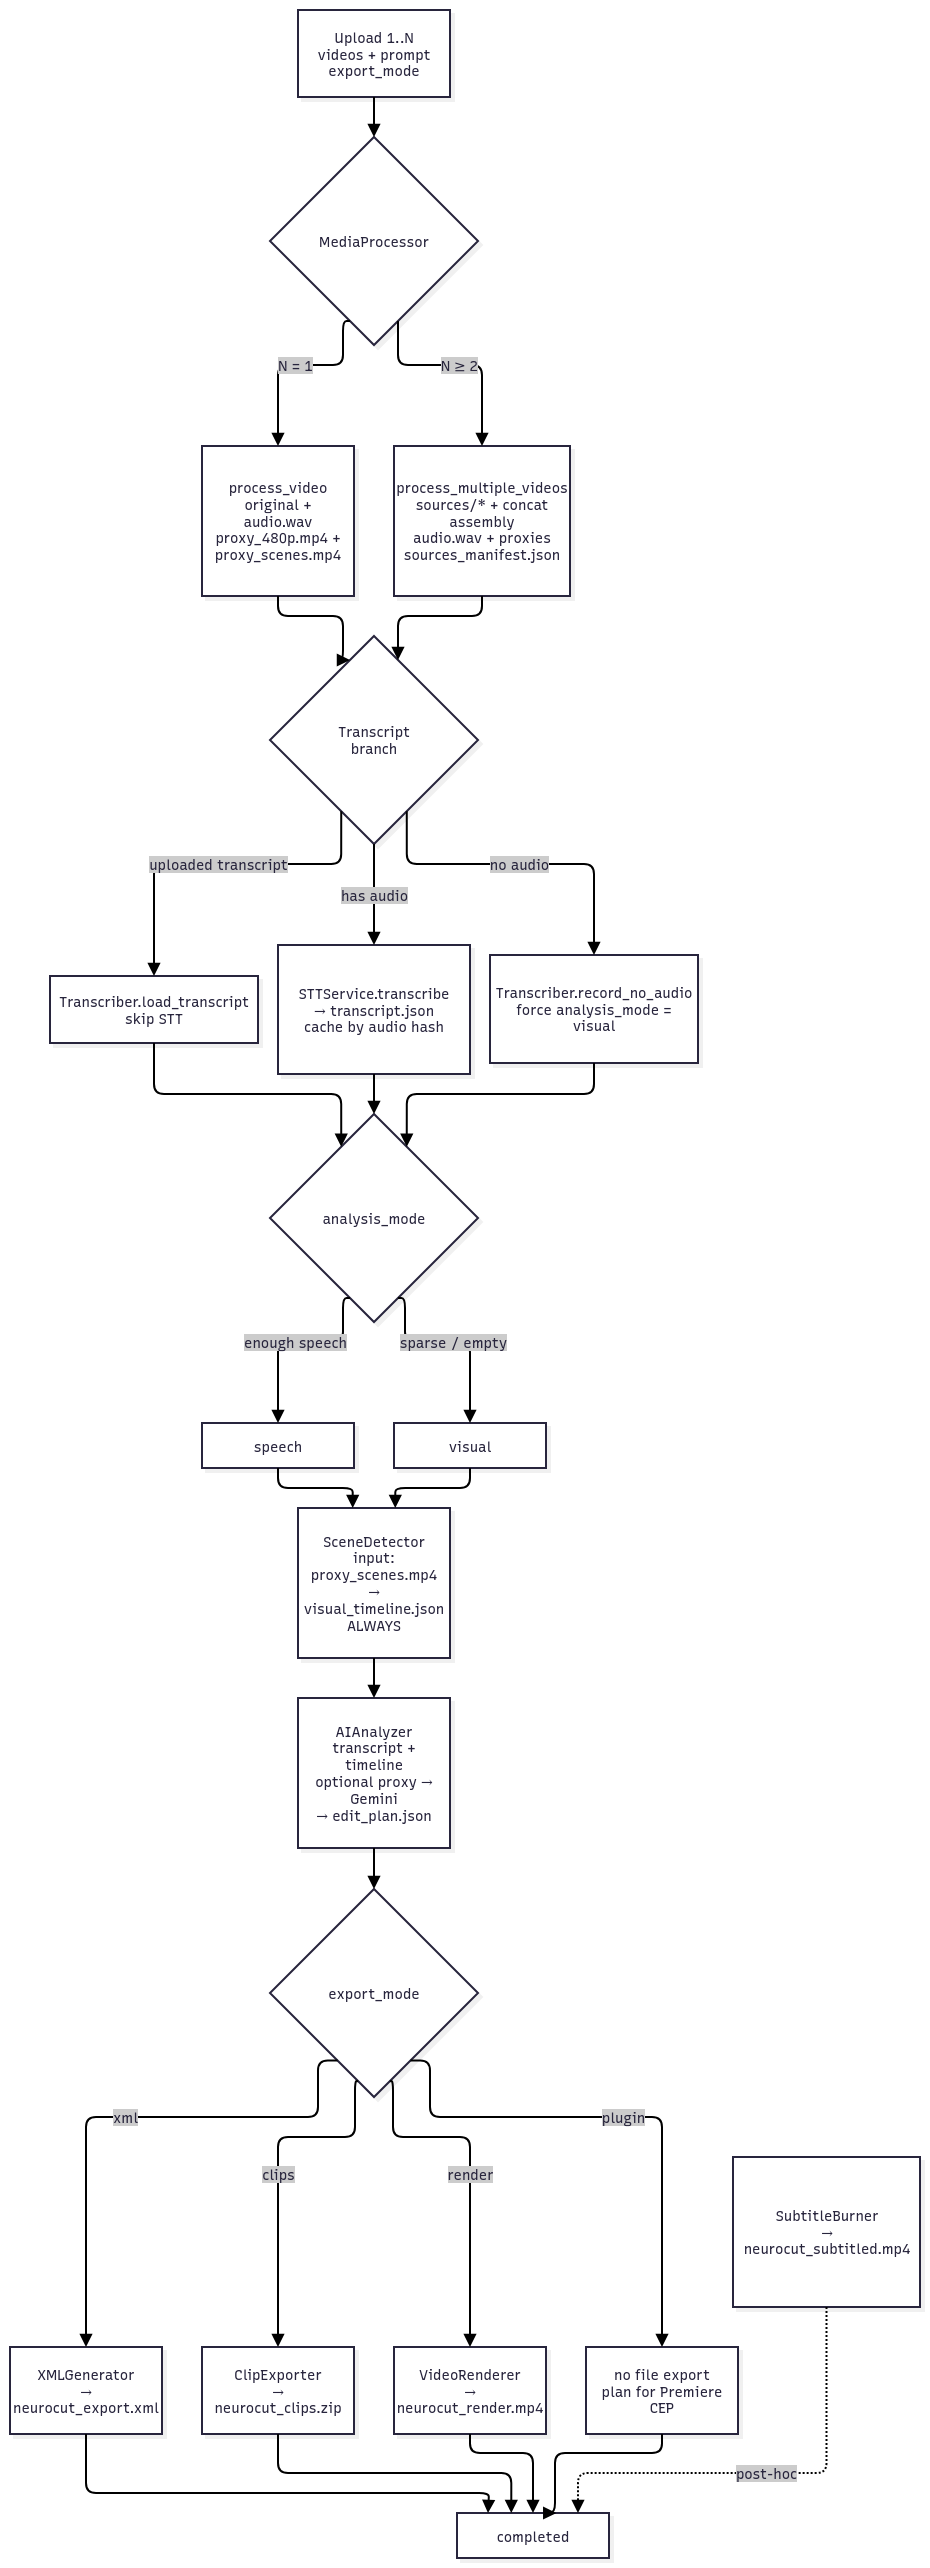
В UI живой progress с теми же стадиями:
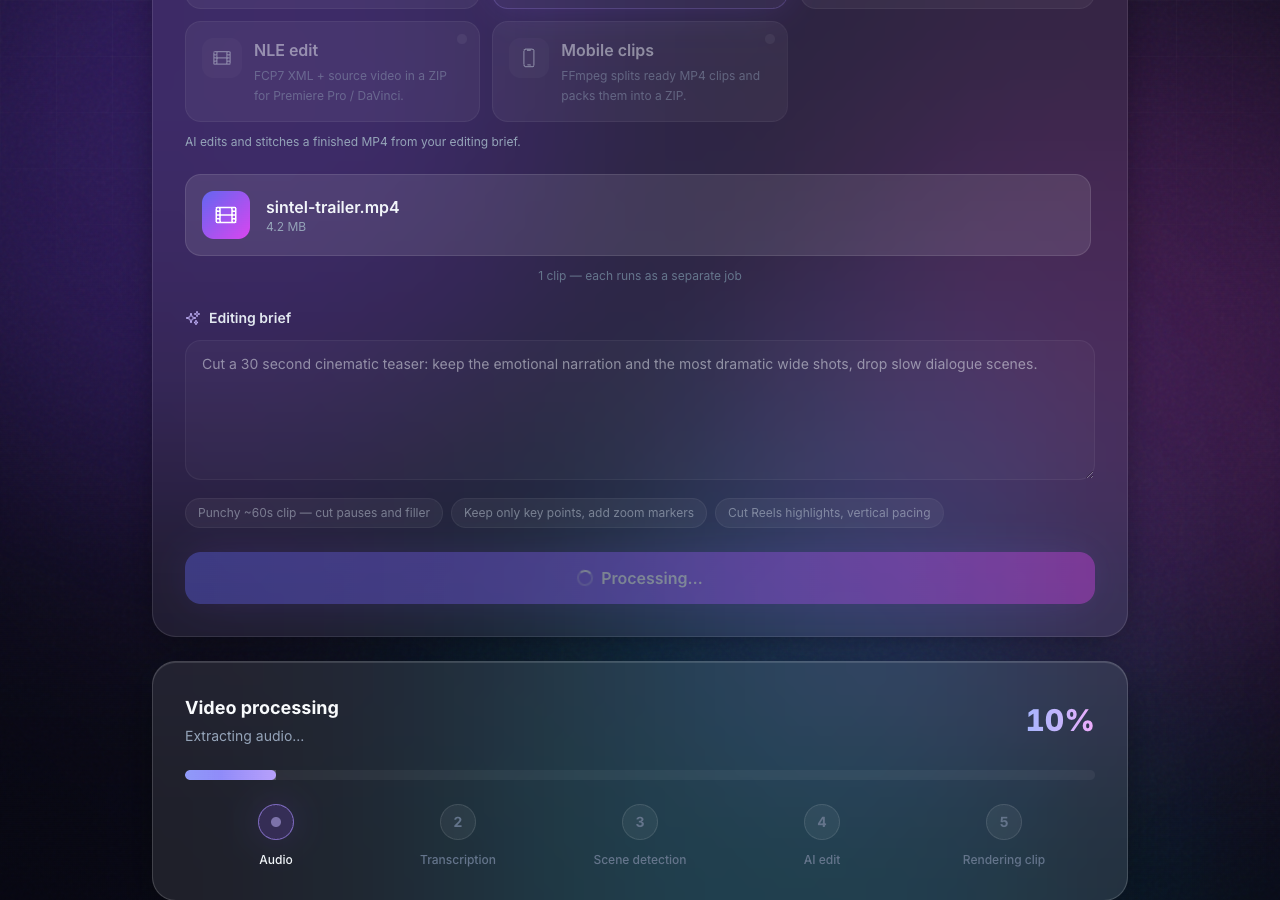
Старт: FFmpeg вытаскивает audio.wav.
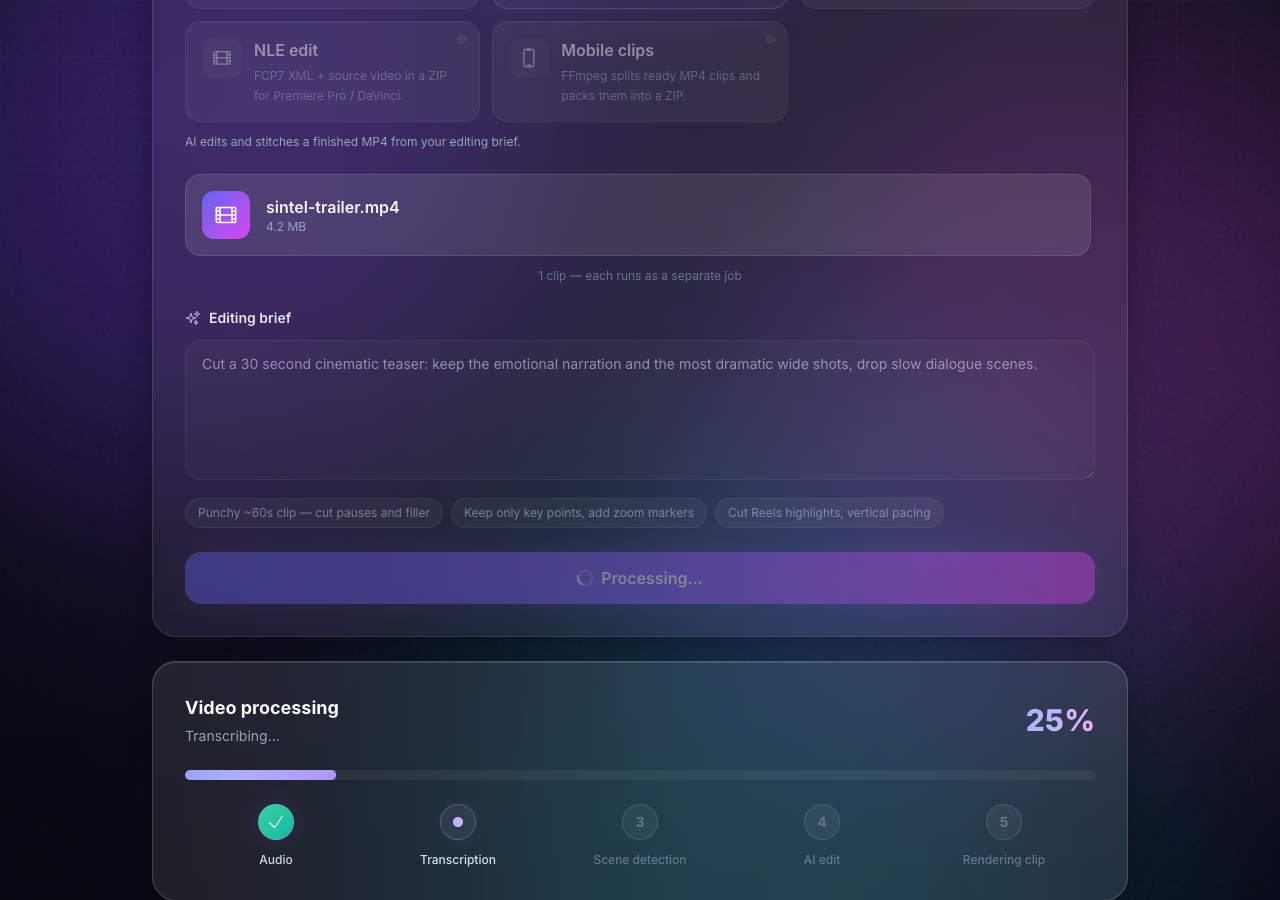
Дальше STT (Whisper / Silero / GigaAM) с таймкодами.
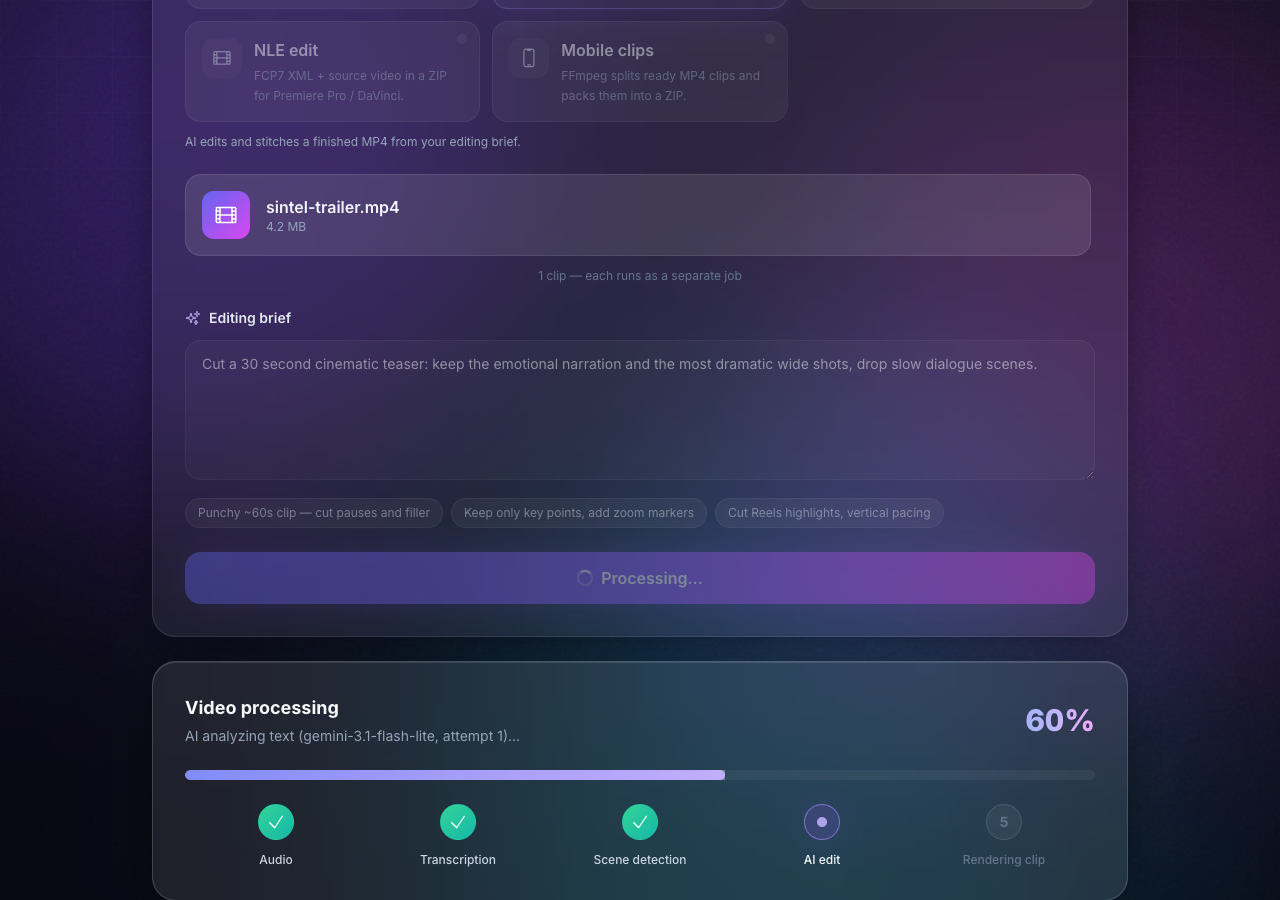
После scene detection LLM собирает edit plan. На скрине видно модель: gemini-3.1-flash-lite.
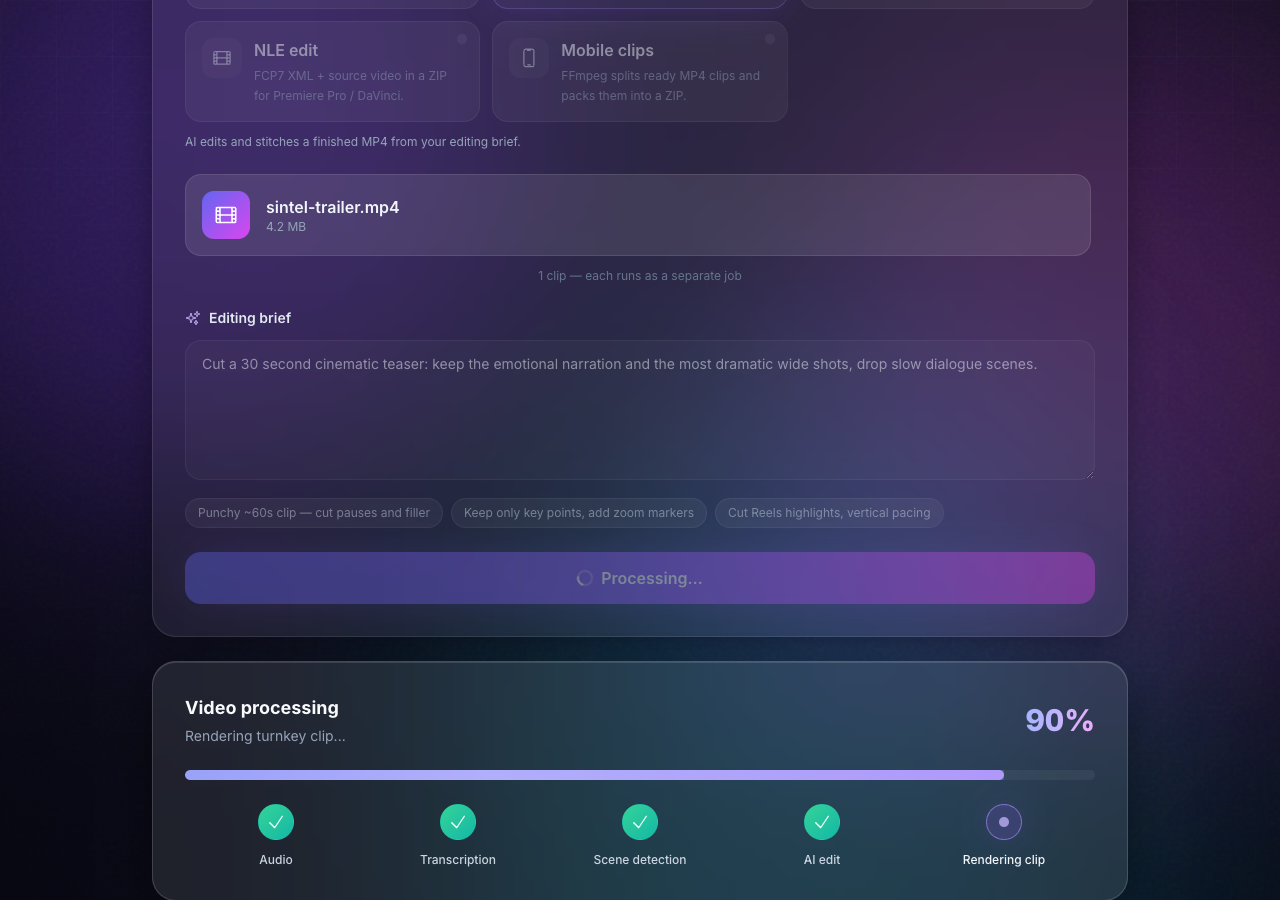
Финал для turnkey-режима: склейка MP4 по плану.
Стек:
-
Backend: Python 3.11, FastAPI;
-
Frontend: React + Vite;
-
Медиа: FFmpeg / ffprobe;
-
STT: Whisper (
faster-whisper), Silero, GigaAM; -
LLM: Google Gemini (по умолчанию), DeepSeek как fallback;
-
Экспорт в NLE: Jinja2-шаблон Final Cut Pro 7 XML.
С деплоем я пока не заморачивался, пдготовил просто докер компоузы.
Что получается на выходе
Я не прячу «магию» за одной кнопкой Download. После джоба можно раскрыть Edit plan — клипы с таймкодами и коротким rationale, маркеры, транскрипт, который в перспективе можно итеративно дорабатыввать.
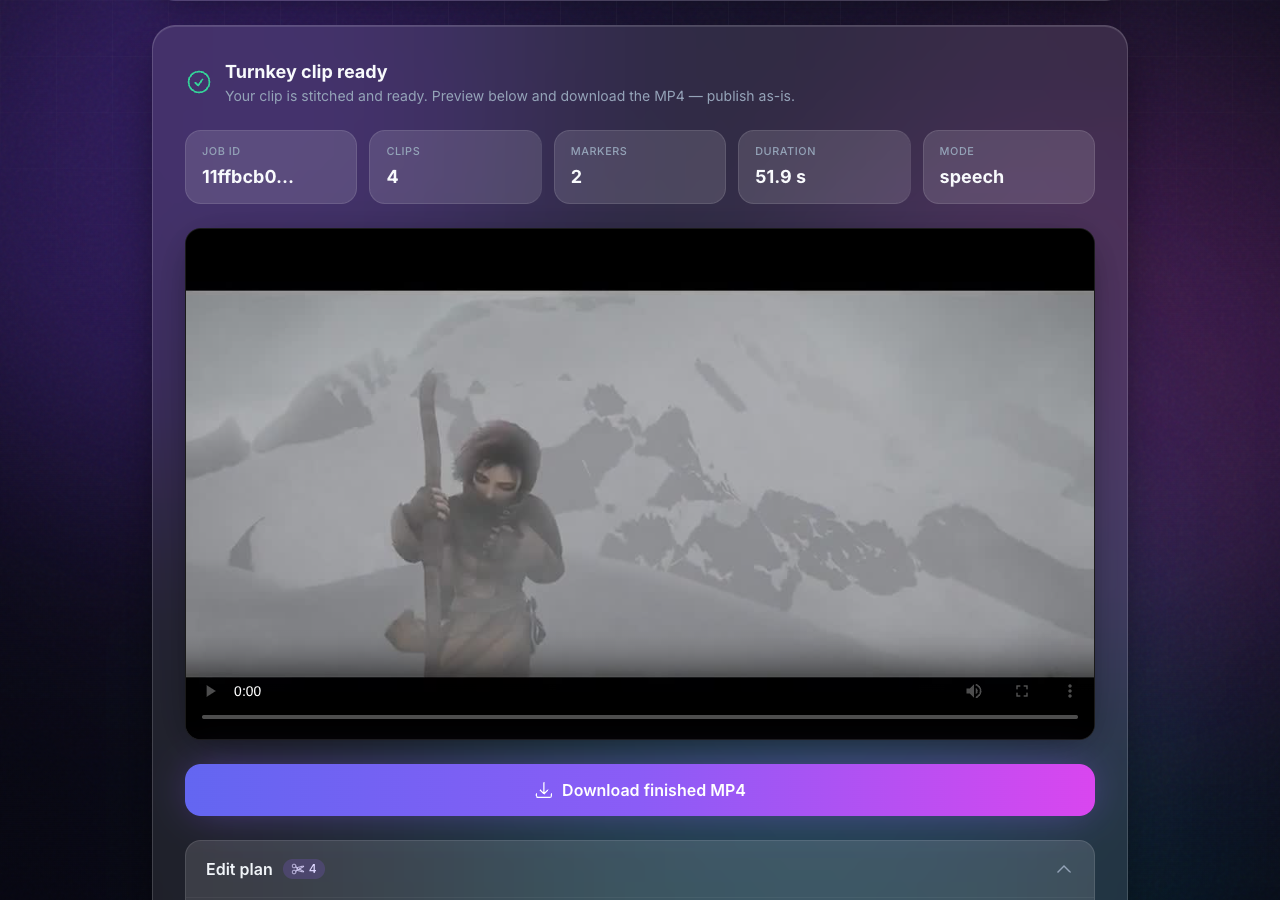
На этом прогоне: 4 клипа, 2 маркера, ~52 с, mode speech
Почему не «просто залить видео в мультимодальную модель»
Первый соблазн был очевидный: скормить proxy в Gemini и попросить «нарежь красиво». На практике это быстро упёрлось в три вещи:
-
Квоты и деньги. Загрузка видео в модель на каждом джобе сразу уничтожит лимит
-
Text-out модели. Многие актуальные Flash-модели удобнее и дешевле именно как text-in / text-out.
Поэтому дефолт такой (ADR в репо):
-
USE_VIDEO_FOR_LLM=false; -
на каждом джобе всё равно гоняется дешёвый scene proxy (низкий FPS, низкое разрешение);
-
в LLM уходит: brief + транскрипт с таймкодами + границы планов (+ manifest источников);
Итог: быстрее, дешевле по квотам и заметно честнее по стыкам. «Умный» отбор по резкости/стабильности — отдельный будущий слой эвристик.
Работа с озвучкой
Монтаж от транскрипта ломается на неожиданном месте: когда речи почти нет.
Если исходник без аудиодорожки или с неразборчивой речью, пайплайн не должен падать:
-
проверяется наличие аудио через ffprobe;
-
пустой/редкий транскрипт — валидный кейс;
-
включается visual mode на основе scene timeline.
Для русской речи есть first-class offline-путь через GigaAM (sherpa-onnx + модели в gigaam-ru/). В режиме STT_ENGINE=auto для ru система предпочтёт GigaAM, если модели скачаны. Whisper остаётся универсальным fallback.
Отдельно полезный функционал content-addressable cache транскриптов: ключ от хэша аудио + длительности. Повторная заливка того же файла не гоняет STT заново.
Нюанс: у GigaAM/Silero нет нормальных word-level timestamps. Для karaoke-субтитров интервал сегмента приходится делить пропорционально между словами. Работает, но это компромисс.
Почему FCP7 XML
Я сознательно выбрал Final Cut Pro 7 XML:
-
его стабильно едят Premiere и Resolve;
-
его реально шаблонизировать через Jinja2;
Не обошлось без нюансов: абсолютные pathurl ломаются, когда XML уезжает на другую машину. Решение — portable paths вида file://./filename и упаковка медиа рядом с XML.
Для тех, кому XML вообще не нужен, есть ветка экспорта клипов: FFmpeg режет куски по edit_plan.json, кладёт manifest.json и собирает ZIP. В UI это отдельные карточки задач — NLE edit и Mobile clips на первом скрине.
Premiere-плагин без повторного upload
Web-UI удобен для демо и self-host, но монтажёр часто уже сидит в Premiere с медиа на диске. Поэтому начал реализовывать именно плагин, но он сейчас в зачаточной стадии.
Как поднять у себя
Минимум:
git clone https://github.com/jdmarshall95/neurocut.git
cd neurocut
cp .env.example .env
# прописать GEMINI_API_KEY=...
docker compose up --build
Для CUDA Whisper:
docker compose -f docker-compose.yml -f docker-compose.gpu.yml up --buildДальше в UI выбираешь задачу (транскрипт / XML / клипы / render / субтитры), загружаешь видео, пишешь brief, забираешь артефакт — как на скринах выше.
Что уже есть и чего ещё нет
Уже работает как MVP/OSS-ассистент:
-
полный pipeline rough cut;
-
multi-file источники на одной шкале времени;
-
несколько STT-движков;
-
экспорт XML / clips / render / subtitles;
-
health, Prometheus metrics, CI, Docker resource limits.
В roadmap осознанно лежат вещи, которых пока нет:
-
более широкие экспорты (EDL / FCPXML / Resolve markers);
-
Premiere CEP plugin;
-
эвристики «стабильный / резкий» кадр;
-
публичный demo dataset и regression fixtures;
-
CapCut export
Это early open-source (API около 0.1.0), не SaaS.
Если сделаете issue/PR — буду рад. Особенно полезны:
-
реальные brief’ы и фейлы таймкодов;
-
предложения по export-форматам;
-
опыт с GigaAM vs Whisper;
Вместо заключения
Про «навигационную» ветку — скоро отдельный текст: в первой части я писал, что официального публичного API у 2ГИС нет, но оказалось ручка у приложения все таки есть – нашёлся Dashboard API и HUD перестал жить на парсинге шторки.
Репо ещё раз: https://github.com/jdmarshall95/neurocut
Спасибо, что дочитали. Пишите в комментарии, какие на ваш взгляд функции было бы еще интересно увидеть.
Автор: hiraetari

