


В 32 рабочих текстах из 84 нейросети оставили реплики для того, кто просил текст. Адресату письма или поста они не нужны. Gemini 4 Argon начинала с «Вот готовый вариант…» 9 текстов из 10, Claude Sonnet 5.5 и Kimi K3 чаще других заканчивали предложением что-нибудь доработать. А длинное тире, которое часто называют приметой нейросети, ею не оказалось. У моделей его в среднем почти столько же, сколько у Гиляровского.
Я посчитал такие привычки у 12 моделей от Google, Anthropic, OpenAI, Alibaba (Qwen), Moonshot (Kimi), Z.ai (GLM), Mistral, MiniMax и Meta. На каждую модель пришлось от 4 до 10 текстов, поэтому это портрет привычек, а не рейтинг качества. Сводка на тепловой карте.
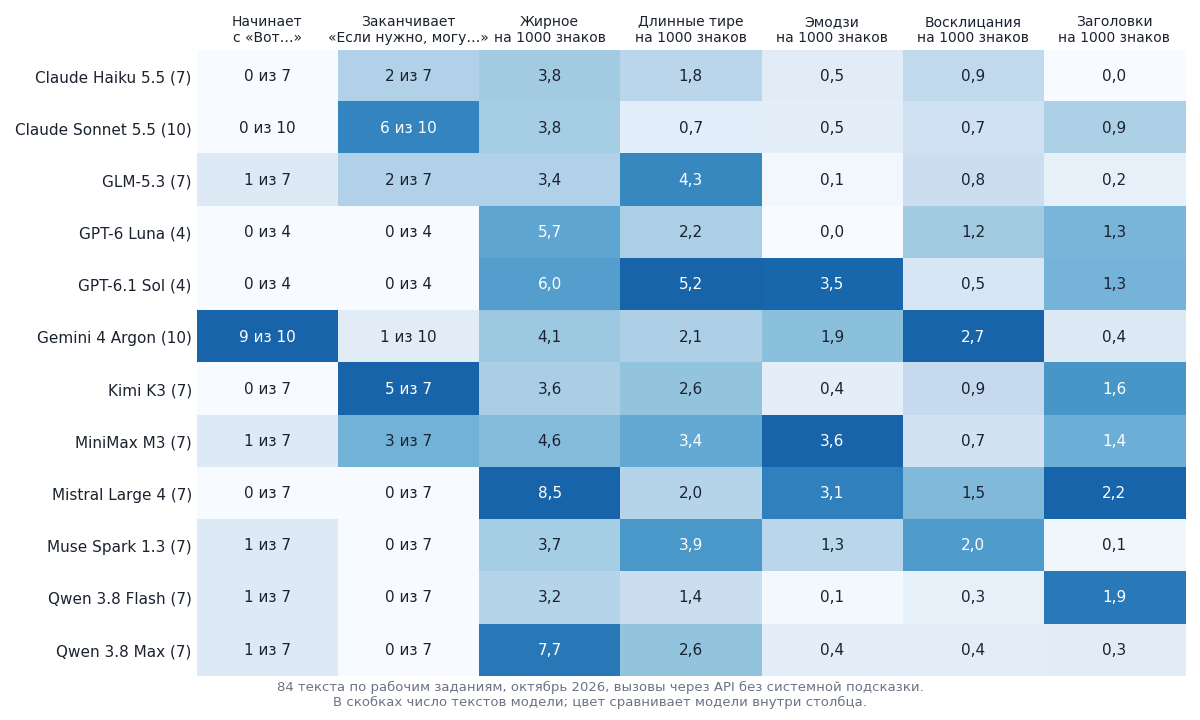
Цвет сравнивает модели внутри каждого столбца: чем темнее клетка, тем чаще привычка у этой модели по сравнению с остальными. В скобках число текстов.
Первая и последняя фраза
Самая тёмная клетка в первом столбце у Gemini 4 Argon. Её тексты начинаются так: «Вот проект письма, составленный в вежливом и деловом тоне. Вы можете скопировать его и подставить свои данные…», «Вот готовый вариант поста для Telegram-канала. Он структурирован так, …», «Вот готовая структура и текст для лендинга сервиса „Грядка“.» В 3 текстах из 10 Gemini дала несколько вариантов вместо одного. Во всём наборе таких ответов 4 из 84, и три из них её. Восклицательных знаков у Gemini тоже больше всех: 2,7 на 1000 знаков при среднем 1,1.
В концовках отличились другие модели. Kimi K3 в 5 текстах из 7 предлагала доработку: «Если нужно, могу сделать объявление короче, официальнее или добавить контактный телефон для вопросов.» Предложения у Kimi вообще самые длинные, в среднем 13 слов (у всех моделей вместе 10,2).
Claude Sonnet 5.5 делала то же в 6 текстах из 10: «Если хотите, добавлю разделы про установку, настройку расписания и восстановление из снимка. Для них мне понадобятся фактические команды и параметры утилиты.» Или короче: «Если расскажете, какие методы чистки вы используете, добавлю это в текст.» Это слова для заказчика текста, из готового письма их лучше убрать.
Хотя бы одна из двух реплик чат-бота есть в 32 текстах из 84, почти в каждом третьем. Обе сразу встретились только однажды. Горизонтальные линии «---» попадаются ещё чаще, в 51 тексте из 84: ими модели отделяют сам текст от своих пояснений до и после.
Жирное, заголовки, эмодзи
У Mistral Large 4 больше всех жирного (8,5 на 1000 знаков при среднем 4,7) и заголовков (2,2), а предложения самые короткие, 8,3 слова. Типичная строка:
- **Размер файла**: обработка файлов размером более **2 ГБ** пока не поддерживается
Часть этого объясняется жанрами: Mistral достались README, вики и карточка товара в Markdown. У Qwen 3.8 Max жирного почти столько же, 7,7, и в её наборе тоже FAQ в HTML, карточка товара и инструкция.
MiniMax M3 ставит больше всех эмодзи, 3,6 на 1000 знаков. Они встречаются и в заголовках (## 🚀 Первый экран (Hero)), и в обычной фразе: «Самое время 😊».
На другом краю Claude Haiku 5.5: ни одного заголовка Markdown в 7 текстах. Правда, и жанры ей выпали короткие.
Qwen 3.8 Flash писала длиннее всех, в среднем 5735 знаков, а самая длинная её статья заняла 14 052 знака. Но и задания ей достались длинные: три статьи для блога и вики.
Откуда тексты и как я считал
Тексты я собирал для слепого сравнения навыков, которые «очеловечивают» русский текст. Это часть моего открытого проекта humanizer-ru. Здесь меня интересуют сами исходники, какими их выдали модели.
В октябре 2026 года 12 моделей получили обычные рабочие просьбы от первого лица заказчика: «Напиши пост для телеграм-канала пекарни…», «Напиши письмо клиентке…», вакансию, памятку, FAQ, пресс-релиз, README, колонку, поздравление. В просьбах были суммы, даты, имена и условия. Модели я вызывал напрямую через API, без системной подсказки, которую добавляют чат-приложения, и по одной попытке на задание. В ChatGPT, Gemini или Claude в браузере поведение может быть другим.
Задания у моделей разные, каждой досталось от 4 до 10 текстов своих жанров. У GPT-6 Luna и GPT-6.1 Sol по 4 текста, у остальных 7–10. Поэтому качество моделей по этим данным сравнивать нельзя, получился портрет привычек в доставшихся жанрах. Сильнее всего жанр влияет на длину, заголовки и жирное.
Правила подсчёта простые и одинаковые для всех. Начало засчитывал, если первая фраза начинается с «Вот», «Конечно», «Отлично», «Ниже», «Предлагаю», «Держите» или «Готово». Конец засчитывал, если в последних 600–700 знаках есть «Если хотите», «Если нужно», «Могу добавить», «Надеюсь», «Дайте знать» и похожие обороты. Жирное, заголовки, эмодзи, восклицательные знаки и длинные тире считал на каждую 1000 знаков (это около полутора сотен слов), чтобы короткий пост и длинная статья сравнивались честно. Линии «---» считал по текстам: есть или нет.
Правила грубые. «Вот» бывает и в нормальном тексте, а «---» иногда оказывается обычной разметкой. Так что выводы здесь на уровне «у этой модели заметно чаще». В 9 текстов для проверки навыков я сам добавил служебные метки, которые остаются при копировании из чата (contentReference, хвосты utm, невидимые символы). Это не привычки моделей, и в подсчёт они не входят.
Тире, Гиляровский и Герцен
Чаще всех длинное тире ставят GLM-5.3 (4,3 на 1000 знаков) и Muse Spark 1.3 (3,9). У GPT-6.1 Sol цифра ещё выше, 5,2, но её тексты очень короткие, в среднем 385 знаков, и одно тире там сильно меняет счёт. Реже всех тире у Claude Sonnet 5.5: 0,7 на 1000 знаков, в три с лишним раза реже среднего по моделям (2,5).
В том же наборе были шесть человеческих текстов, их подкладывали навыкам как ловушки. У Гиляровского в «Москве и москвичах» 2,25 тире на 1000 знаков, у Герцена в «Былом и думах» 1,59, в статье Википедии 2,84. В коротких текстах (письмо Чехова, заметка Викиновостей, статья 2 Конституции) тире нет совсем.
Людей в выборке мало, и всё же по числу тире модель от Гиляровского не отличить. А у Sonnet, одной из самых популярных моделей, тире меньше, чем у Герцена.
Если вычищать тире механически, русский текст портится. В сравнении навыков участвовал английский навык stop-slop, который удаляет длинные тире. В двенадцати текстах он оставил одно тире из 52, и судьи жаловались на рубленые фразы. Во многих местах тире в русском требует грамматика: «Кэш — быстрая память».
В этой статье тире одно, в примере выше. Если судить по счётчику тире, она человечнее Гиляровского, и уже поэтому такому счётчику верить не стоит.
Что срезать до отправки
-
Первую фразу, если она рассказывает о самом тексте («Вот готовый вариант…»). Чаще всего так начинает Gemini 4 Argon.
-
Последний абзац с предложением доработать («Если нужно, могу…», «Если хотите, добавлю…»). Это Kimi K3 и Claude Sonnet 5.5, иногда MiniMax M3.
-
Линии «
---» до и после текста: ими модель отделяла ответ от своих пояснений. -
Лишние варианты. Если модель дала несколько, выберите один и уберите метки вроде «Вариант 1». Чаще всего варианты даёт Gemini.
-
Оформление, которое не нужно в письме или посте. Жирного больше всего у Mistral Large 4 и Qwen 3.8 Max, эмодзи у MiniMax M3, GPT-6.1 Sol и Mistral, заголовков у Mistral.
-
А тире оставьте там, где оно по грамматике.
Начало и конец можно попробовать отсечь заранее: допишите к просьбе «дай только текст, без вступления и предложений в конце».
Все задания и тексты из этой статьи открыты, их можно взять в папке eval/corpus репозитория https://github.com/Vladimir-Human/humanizer-ru и пересчитать самому. В том же репозитории лежит и сам навык humanizer-ru.
Автор: Vladimir-Human

