



Казалось бы, современные LLM должны неплохо справляться с подобными заданиями. Однако, даже передовые модели сталкиваются с серьезными трудностями. Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol и GPT-6 Luna уверенно проходили простые уровни, но на самых длинных заданиях с взаимосвязанными изменениями точность падала до 13% и ниже.
Исследователи из Allen Institute for AI решили выяснить, в какой момент модели начинают терять информацию о состоянии объектов. Их интересовали не только предельные возможности архитектур, но и различия между задачами, которые на первый взгляд выглядят почти одинаково.
Результаты оказались особенно интересными при сравнении трансформеров с рекуррентными и гибридными моделями. После специального обучения архитектуры начали вести себя совершенно по-разному, причем увеличение длины последовательностей лишь усиливало этот разрыв.
Почему найти информацию и отследить ее изменения не одно и то же
Представим детективный роман, в котором Джон передает Мэри нож. Если ближе к концу книги нужно выяснить, у кого находится предмет, достаточно найти соответствующий эпизод и проверить, не было ли последующих передач.
Теперь усложним ситуацию; ранее Эдвард положил нож в рюкзак Джона, а затем Джон передал Мэри предмет из своего рюкзака. Чтобы установить, кто получил нож, читателю приходится сопоставить несколько событий. Информация о предмете распределена между разными фрагментами текста.
Именно такие зависимости изучает state tracking, или отслеживание состояния. Модель должна учитывать, как меняются значения и связи между сущностями по мере обработки последовательности. Это необходимо при чтении программного кода, где переменные неоднократно переопределяются. Аналогичная задача возникает при анализе длинных историй, в которых персонажи перемещаются, обмениваются вещами и взаимодействуют друг с другом.
У трансформеров существуют известные теоретические ограничения на обработку некоторых видов длинных последовательных зависимостей. В том числе поэтому исследователи разрабатывают рекуррентные и гибридные архитектуры, способные переносить внутреннее состояние от одного шага обработки к следующему.
Но было неясно, насколько эти архитектурные различия заметны на задачах разной сложности. Большая часть предыдущих исследований концентрировалась на наиболее трудных вариантах отслеживания состояния, хотя в реальных приложениях встречаются и гораздо более простые случаи.
Четыре уровня StateBench
Для более подробного сравнения авторы разработали StateBench, набор тестов, разделенный на четыре уровня сложности.
Каждый уровень определяется тем, какие операции изменения состояния разрешены. Удобнее всего рассмотреть их через присваивание значений переменным.
1. R-trivial: неизменяемые значения
На первом уровне переменная получает значение, которое впоследствии не меняется. Например:
let x = 4;
Задача модели сводится к поиску первоначального значения. В обычной жизни похожим примером служит дата рождения человека, которая остается постоянной.
2. Aperiodic: перезапись значения
Следующий уровень допускает повторные присваивания:
x = 4;
x = 2;
Теперь модели необходимо найти последнее обновление. Предыдущие значения можно игнорировать, поскольку они больше не определяют текущее состояние переменной.
По такому принципу работает настройка термостата: важна последняя установленная температура.
3. Soluble: обновление на основе текущего состояния
Здесь появляется дополнительная зависимость. Новое значение вычисляется с использованием предыдущего:
x = x + 5;
Для правильного ответа уже недостаточно найти последнее присваивание. Модель должна учитывать последовательность изменений, поскольку каждое обновление зависит от накопленного результата.
Простой пример из повседневной жизни: счет в игре, который увеличивается после получения очков.
4. General finite: зависимости между переменными
Самый сложный уровень позволяет присваивать одной переменной текущее значение другой:
x = y;
В частности, такие операции позволяют моделировать перестановки. Их сложность состоит в том, что изменения одной переменной могут зависеть от истории нескольких других.
Авторы иллюстрируют этот уровень задачей с пятью стаканчиками и спрятанным шариком. После многократных перестановок необходимо определить, где находится шарик. Для этого приходится отслеживать всю цепочку перемещений.
В теории подобные операции связаны с задачей S₅, которая ранее использовалась для изучения ограничений нейросетевых архитектур. Эта классификация имеет математическое основание. Она опирается на теорию Крона и Родса, позволяющую разложить определенные системы переходов между состояниями на более простые составляющие. Формально задачи рассматриваются через конечные моноиды и последовательности операций над ними.
Важная особенность StateBench заключается в методике подготовки тестовых данных. Авторы берут последовательность присваиваний самого сложного уровня и на ее основе создают три упрощенных варианта.
Количество переменных, различных значений и расположение операций в последовательности сохраняются. Меняется только допустимый тип обновления. Это позволяет сравнивать сложность самих операций, минимизируя влияние посторонних различий между заданиями.
Что произошло с предварительно обученными моделями
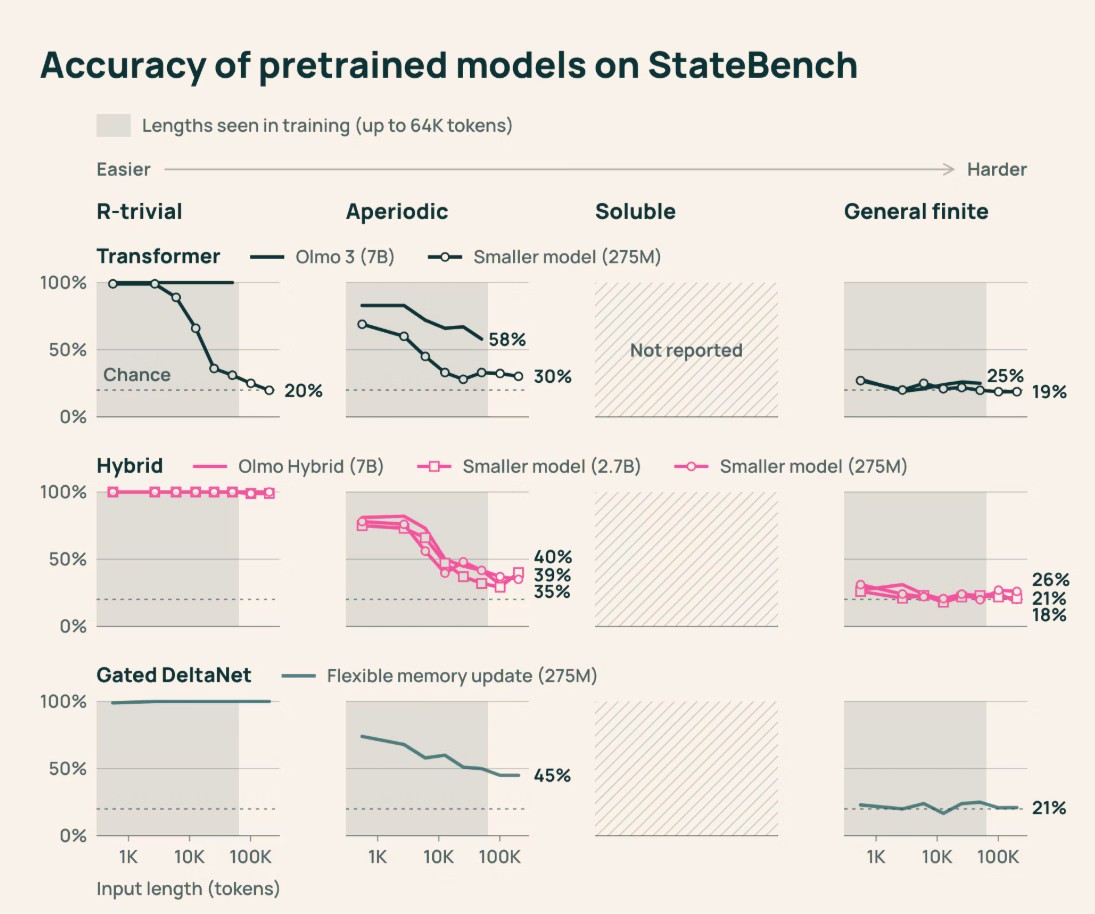
Сначала исследователи проверили открытые модели, для которых известны характеристики предварительного обучения и длины использованных контекстов.
В тестирование вошли Olmo 3 с 7 млрд параметров, построенная на трансформерной архитектуре, и Olmo Hybrid того же размера, включающая слои Gated DeltaNet. Также использовались более компактные модели с 275 млн и 2,7 млрд параметров. Все эти модели проходили предварительное обучение на одинаковых данных. При этом ни одна из них не обучалась на контекстах длиннее 64 тысяч токенов, а большинство проверяли на входных последовательностях, превышающих эту длину.
Результаты показали довольно устойчивую закономерность. Почти все модели успешно проходили простейшие R-trivial задания. На Aperiodic точность начинала снижаться по мере увеличения длины входа, а на General finite результаты оставались примерно на уровне случайного угадывания.
Однако исследователи обнаружили еще одну проблему: формат представления задания заметно влиял на точность.
Модели с 275 млн параметров на гибридной архитектуре и Gated DeltaNet почти безошибочно выполняли простые задания в формате, похожем на RULER. Но когда аналогичные по смыслу операции представлялись как редактирование электронных таблиц, результаты оказывались близкими к случайным.
Получается, даже при одинаковой underlying задаче изменение формы записи может существенно повлиять на ответ модели. Поэтому StateBench использует несколько способов представления одних и тех же операций, чтобы результаты не зависели исключительно от удачно подобранного формата.
Передовые LLM тоже столкнулись с ограничениями
Следующий этап исследования касался современных проприетарных моделей: Gemini 3.8 Flash, Claude Opus 5.5, GPT-6 Sol и GPT-6 Luna.
Каждая получала последовательность присваиваний и должна была определить итоговое значение каждой переменной.
На двух первых уровнях, R-trivial и Aperiodic, все четыре модели показали хорошие результаты. Они справлялись с поиском неизменяемых значений и последними обновлениями переменных. Ситуация заметно изменилась на уровнях Soluble и General finite. По мере увеличения длины последовательностей точность резко снижалась. На самых длинных заданиях General finite она составляла 13% или меньше.
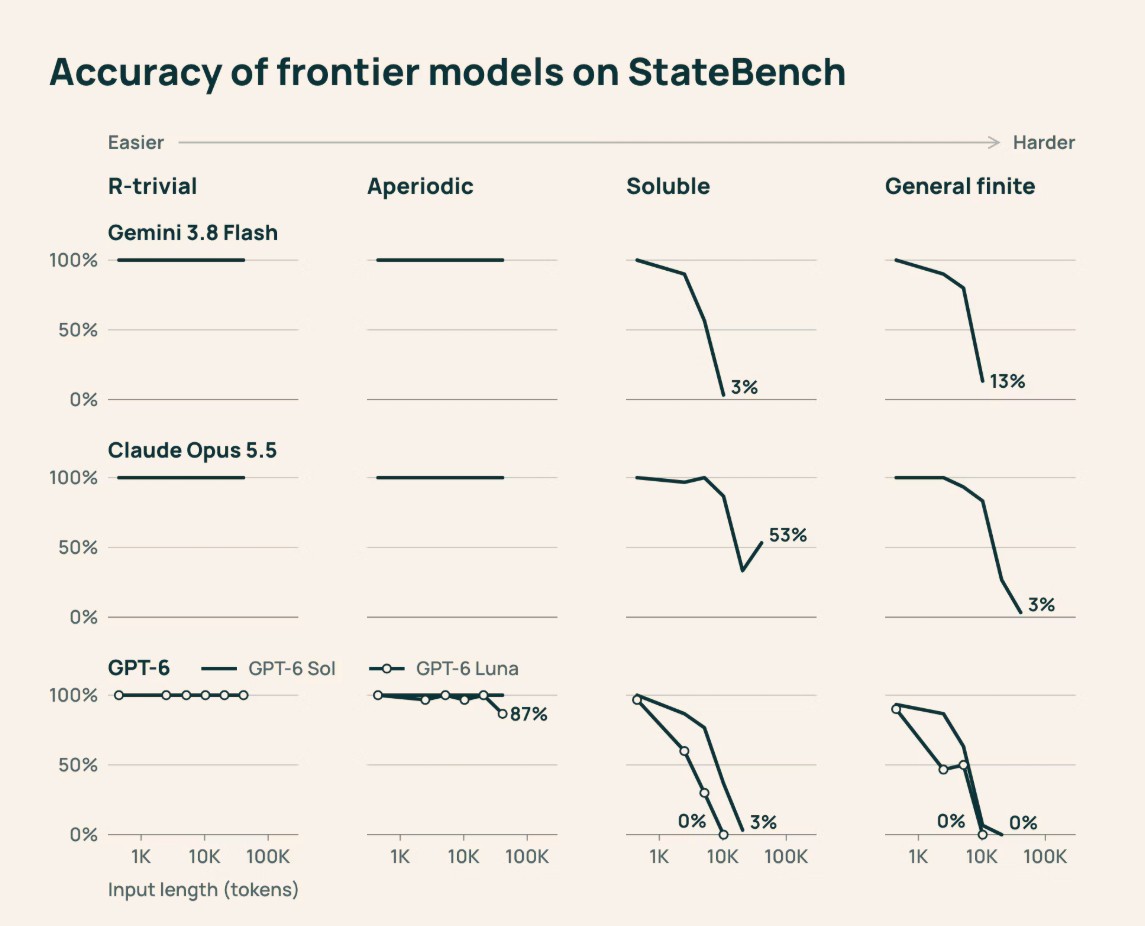
Эту цифру необходимо правильно интерпретировать. Она относится к конкретным заданиям StateBench с наиболее сложными зависимостями и большой длиной входа. Исследование не утверждает, что современные LLM правильно понимают только 13% длинных документов или разговоров.
Почему именно эти задания оказались настолько трудными?
Авторы предлагают одно из возможных объяснений через чувствительность конечного результата к промежуточным операциям. На более сложных уровнях множество отдельных шагов может повлиять на правильный ответ. Если модель пропускает значимое обновление, последующие вычисления уже опираются на неправильное состояние. При простом поиске последнего присваивания большую часть предыдущей истории действительно можно не учитывать. Когда значения зависят друг от друга, такой подход перестает работать.
Но остается вопрос: проблемы возникают из-за устройства самих архитектур или потому, что предварительное обучение недостаточно хорошо формирует навык последовательного отслеживания состояний?
Специальное обучение изменило результаты
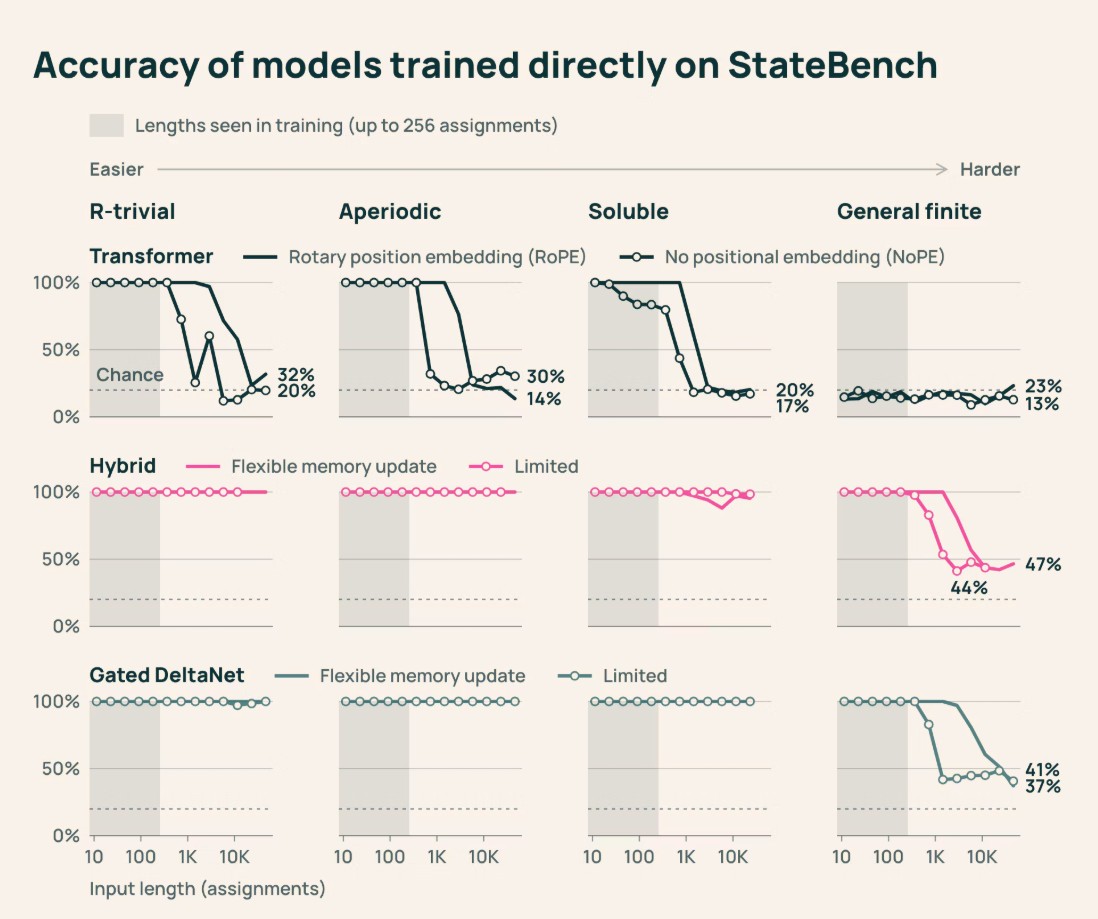
Чтобы разделить влияние архитектуры и обучения, авторы провели второй эксперимент. На этот раз модели обучались непосредственно на заданиях StateBench, без предварительного обучения на обычных текстовых данных.
Для сравнения использовали шесть моделей по 275 млн параметров: два варианта трансформеров, две гибридные архитектуры и две версии Gated DeltaNet с разными ограничениями на механизм обновления памяти.
На этапе обучения длина последовательностей составляла не более 256 присваиваний. Затем модели проверяли на последовательностях вплоть до 64 тысяч присваиваний. Получается, максимальная длина тестовых последовательностей была в 250 раз больше максимальной обучающей длины. Здесь важно различать присваивания и токены: речь идет о количестве операций, а не о размере контекстного окна в токенах.
Именно на этом этапе архитектурные различия стали особенно заметными.
Gated DeltaNet и гибридные модели почти безошибочно проходили первые три уровня даже на последовательностях из десятков тысяч операций. Они сохраняли способность отслеживать состояния далеко за пределами длины, использованной при обучении.
Трансформеры тоже освоили более простые задания, однако их результаты ухудшались при увеличении длины последовательностей. Самый сложный уровень General finite они так и не научились решать успешно даже после целевого обучения.
На General finite наиболее далеко продвинулась версия Gated DeltaNet с более гибким механизмом обновления памяти. Она сохраняла почти идеальную точность примерно до десятикратного превышения максимальной длины обучающих последовательностей.
Предварительно обученные рекуррентные и гибридные модели испытывали серьезные трудности с теми же типами задач, которые их архитектуры впоследствии смогли освоить при специальном обучении. Значит, по крайней мере часть проблем была связана с недостаточной подготовкой моделей к таким операциям.
У протестированных трансформеров ограничения проявились и после целевого обучения. Наиболее сложный класс заданий остался для них недоступным в рамках проведенных экспериментов.
Почему рекуррентная память не гарантирует успех
Полученные результаты позволяют лучше понять преимущества Gated DeltaNet, но их нельзя автоматически распространять на все рекуррентные архитектуры.
Еще в исследовании The Illusion of State in State-Space Models 2024 года Уильям Меррилл, Джексон Петти и Ашиш Сабхарвал изучали выразительные возможности моделей пространства состояний, включая S4 и Mamba.
Они показали, что рекуррентная организация вычислений сама по себе не устраняет теоретические ограничения. Некоторые подобные архитектуры, несмотря на наличие внутреннего состояния, не способны выразить определенные виды последовательных операций при рассматриваемых математических предположениях.
В новом исследовании авторы продолжают изучать эту проблему, уделяя внимание конкретным механизмам обновления памяти.
Для Gated DeltaNet с ограничением на неотрицательные собственные значения исследователи доказали возможность решения всех задач класса Aperiodic, а также некоторых периодических задач. Например, архитектура способна отслеживать четность количества повторений определенного входа при использовании описанной в работе арифметики фиксированной точности с округлением.
При этом точное положение такой версии Gated DeltaNet в иерархии сложности остается открытым вопросом.
Пока неизвестно, способна ли она выразить весь класс Soluble. Также требуется дополнительно изучить влияние численной точности и сочетания рекуррентных механизмов со слоями внимания. Следовательно, даже внутри одного семейства архитектур характеристики механизма памяти способны существенно менять доступные модели виды последовательных вычислений.
Автор: Nikita_Pro_IT

