


Amazon Web Services представила TorchNeuron — открытый backend для PyTorch, который делает чипы AWS Trainium стандартным устройством внутри привычного фреймворка. На базовом уровне переход выглядит так: вместо переноса модели на cuda разработчик указывает устройство neuron.
AWS утверждает, что для типового PyTorch-кода этого достаточно: переписывать модель и менять привычные API не требуется. TorchNeuron вышел в публичную beta-версию 20 октября и поддерживает инстансы с Trainium2 и Trainium3.
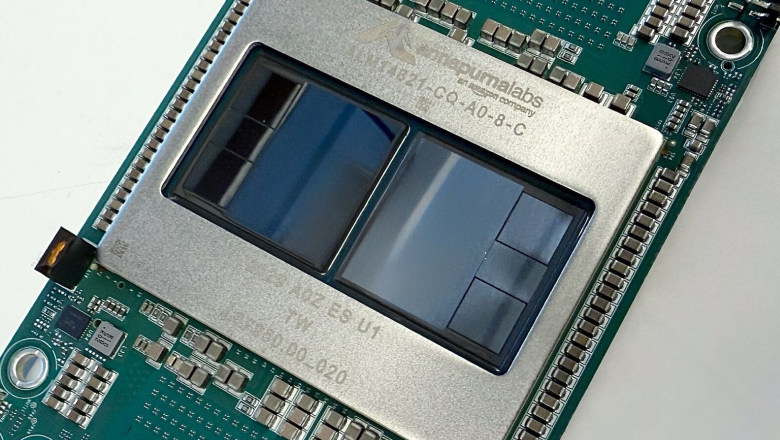
Новость важна не потому, что Amazon выпустила ещё один ИИ-чип. Trainium существует не первый год. Меняется другое: AWS пытается уменьшить стоимость перехода на альтернативное оборудовании — ту самую инженерную цену, которая делает экосистему NVIDIA привычным выбором для многих команд.
Главный барьер — не модель, а программный стек
Когда говорят о доминировании NVIDIA в ИИ-инфраструктуре, обычно вспоминают производительность GPU и поставки оборудования. Но для разработчиков не менее важна программная среда: CUDA, библиотеки, оптимизированные операции, инструменты профилирования, документация, примеры и готовые интеграции.
PyTorch стал одним из главных фреймворков для исследований и прикладной разработки. По данным AWS, на нём пишут код около 85% исследователей и разработчиков в области ИИ. В такой среде аппаратная платформа выигрывает не только за счёт характеристик чипа. Она выигрывает, если модель, распределённое обучение, отладка и инференс запускаются без отдельного проекта по адаптации к железу.
Именно здесь NVIDIA много лет накапливала преимущество. Разработчик создаёт модель в PyTorch, переносит тензоры на cuda, подключает привычные библиотеки — и получает предсказуемый рабочий путь. Альтернативные ускорители часто требовали другого backend, компиляции, ограничений по операциям или ручной оптимизации критичных участков. Даже если чип экономически интересен, команда может не захотеть тратить недели на миграцию и повторную валидацию модели.
Что делает TorchNeuron
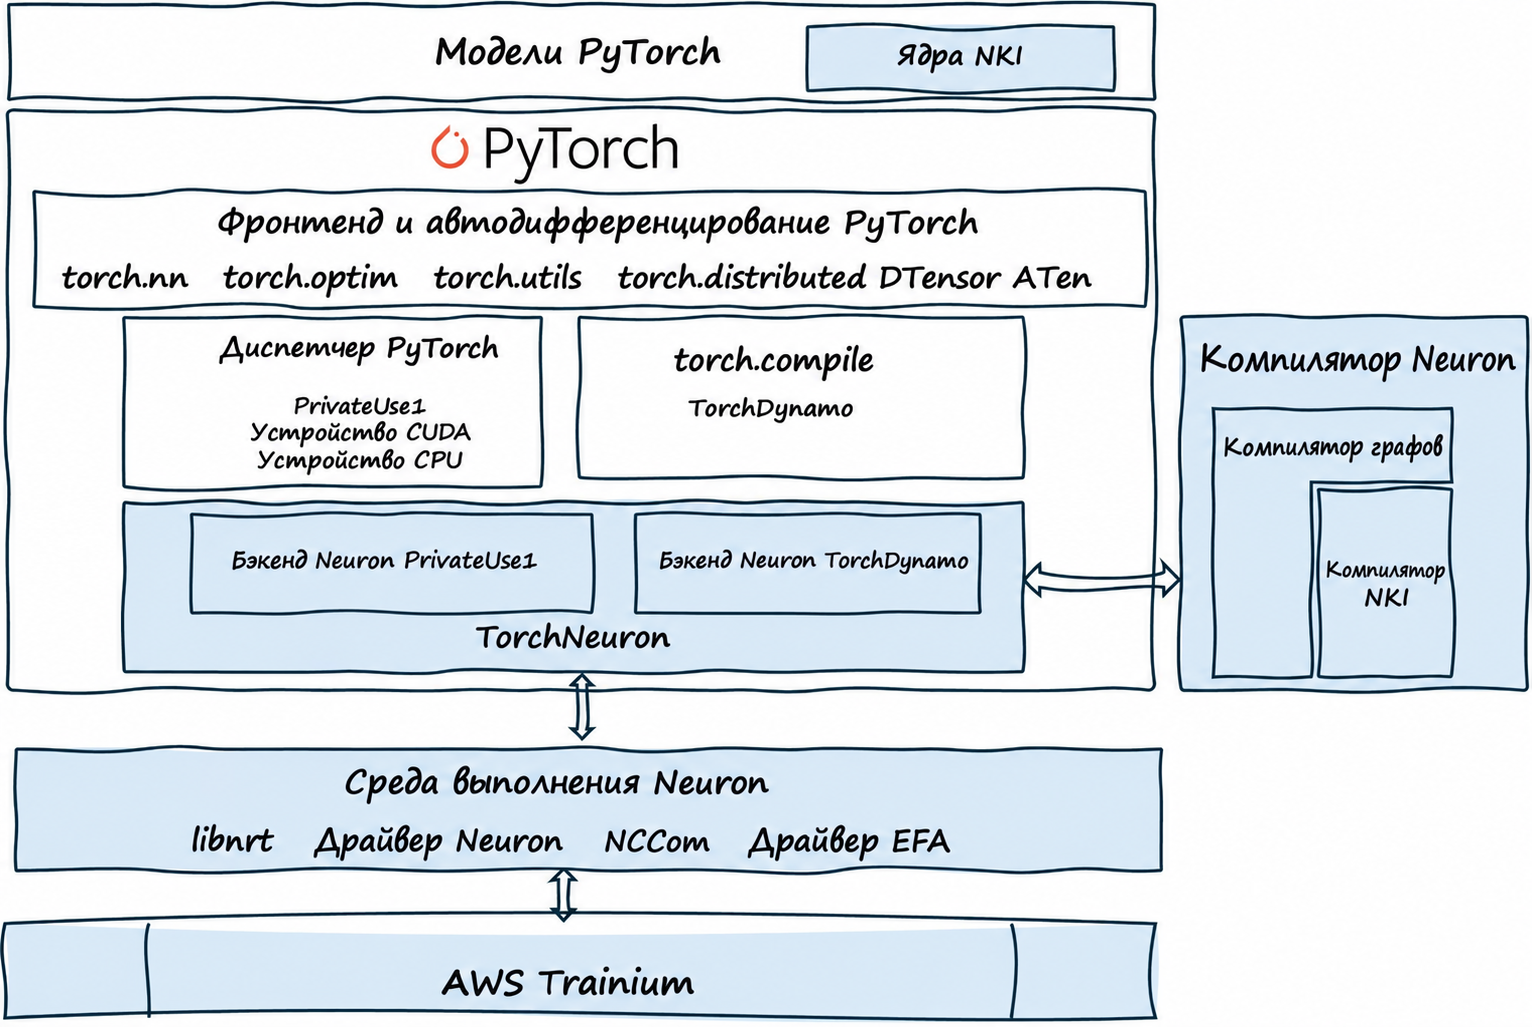
TorchNeuron регистрирует Trainium как стандартное устройство PyTorch через механизм PrivateUse1. Фреймворк направляет операции тензоров в backend AWS, а тот компилирует и исполняет их на Trainium. Поддерживаются привычные режимы работы PyTorch:
-
eager mode — для экспериментов, отладки и быстрых итераций;
-
torch.compile — для компиляции графа и оптимизации производительности;
-
API распределённого обучения из torch.distributed;
-
FSDP, DDP, DTensor и несколько схем параллелизма;
-
собственные низкоуровневые операции через Neuron Kernel Interface.
Для разработчика это означает, что модель, написанная на обычном PyTorch, не обязана получать отдельную ветку кода под Trainium. Если проект уже использует API torch.accelerator, смена устройства, по документации AWS, вообще не требует изменения исходников.
Это и есть главный удар по модели «железо выбирается вместе с экосистемой». AWS предлагает смотреть на Trainium не как на отдельную платформу с другим языком разработки, а как на ещё одно устройство PyTorch.
Одна строка — это начало, а не финал миграции
Формулировка «без переписывания кода» корректна для базового сценария, но её нельзя читать как обещание мгновенного переноса любого продакшен-стека.
В официальной документации AWS прямо указаны ограничения. В eager mode операция, для которой в TorchNeuron ещё нет реализации, может выполниться на CPU с предупреждением. В режиме torch.compile неподдерживаемые конструкции приводят к разрывам графа, а часть операций может завершить компиляцию ошибкой. Новые формы входных данных, типы или конфигурации способны вызвать повторную компиляцию.
Для исследовательского ноутбука это может быть почти незаметно. Для сервиса с высокой нагрузкой — уже инженерная задача: нужно проверить совместимость операторов, корректность результатов, скорость первого запуска, потребление памяти, поведение в распределённом режиме и фактическую стоимость инференса.
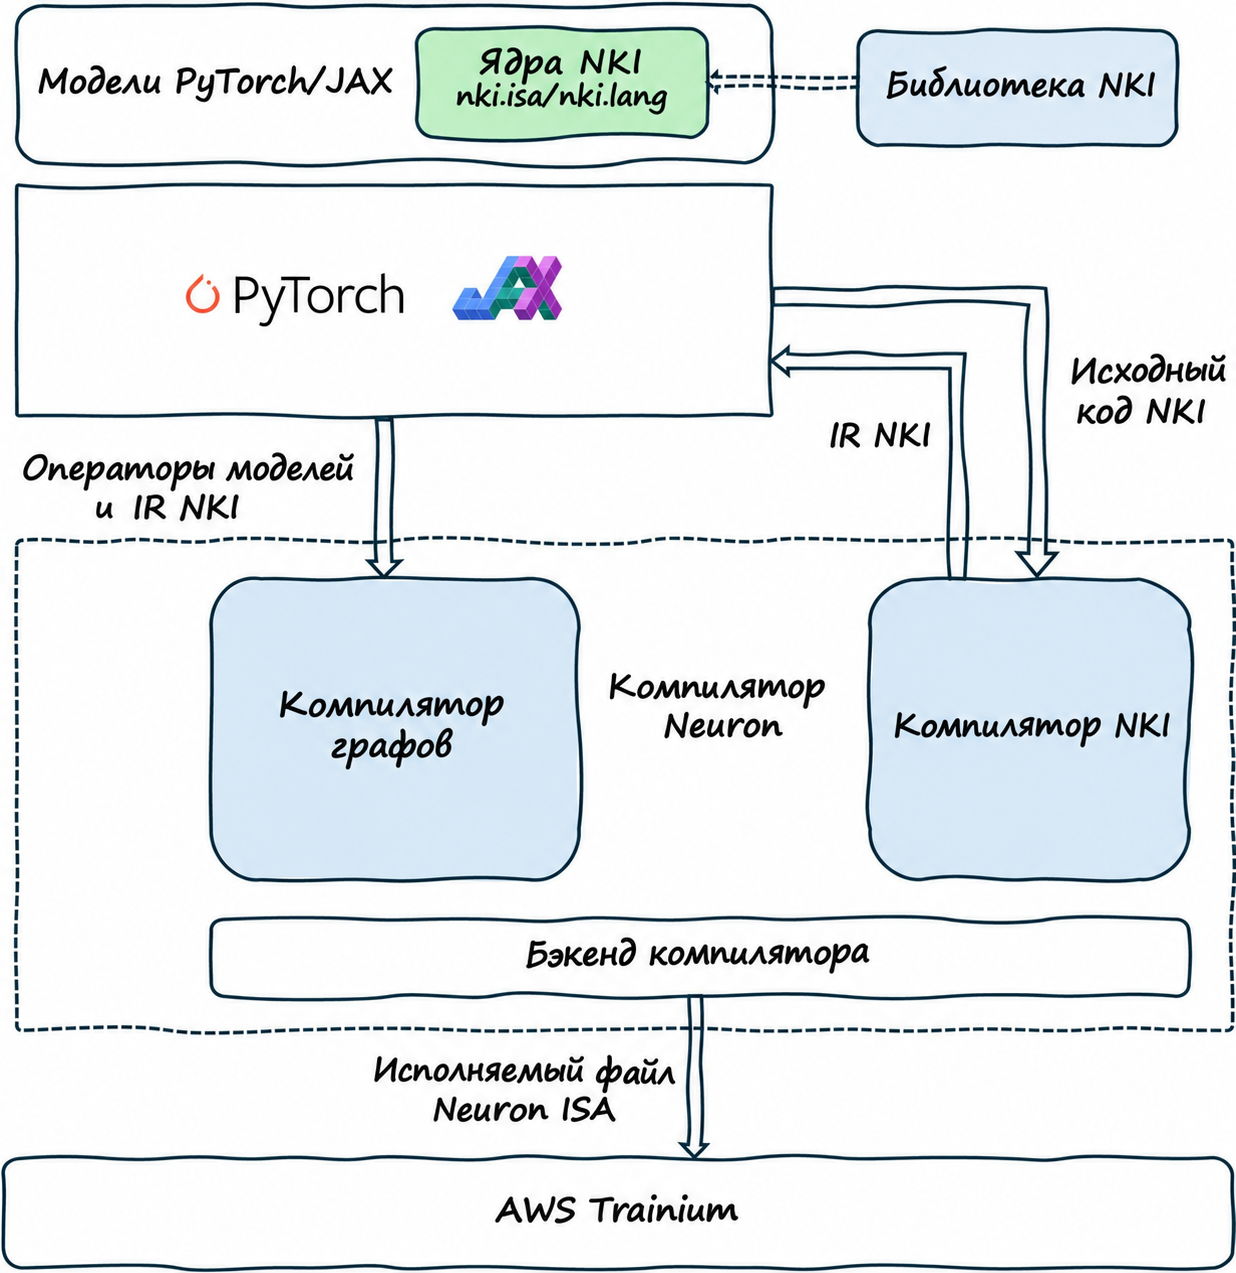
Отдельная история — собственные CUDA-ядра и глубоко оптимизированные пайплайны. Если команде нужна максимальная производительность, AWS предлагает Neuron Kernel Interface. Это близко по смыслу к работе с низкоуровневыми ядрами: разработчик получает больше контроля, но и больше ответственности за оптимизацию.
То есть TorchNeuron не отменяет работу инженеров. Он сокращает путь до первого запуска и позволяет начать с совместимого PyTorch-кода, а не с переписывания всего проекта.
Почему AWS делает ставку именно на PyTorch
Amazon продаёт не только Trainium. Компания продаёт весь путь от эксперимента до эксплуатации: вычисления, хранилище, сеть, управление доступом, мониторинг, оркестрацию и сервисы машинного обучения.
Для стартапа выбор ускорителя часто связан не с ценой одного часа работы инстанса, а с общей стоимостью системы. Если модель обучается на одной платформе, а инференс, логи, данные, CI/CD и безопасность находятся в другом месте, экономия на чипе может исчезнуть в интеграционных расходах.
AWS подчёркивает, что один стек можно использовать и для обучения, и для инференса. Это важно, но не отменяет необходимости сравнивать конкретную нагрузку. У разных моделей, размеров батча, типов задач и требований к задержке результаты будут отличаться.
Показателен кейс Deepgram, поставщика голосовых ИИ-решений. AWS и Deepgram перенесли модель распознавания речи Nova-3 на Trainium2. В итоговом решении команда не ограничилась сменой устройства: несколько месяцев ушло на проверку операций, компиляцию отдельных статических графов, настройку ядер и собственный runtime на Rust. Для офлайн-пакетной транскрибации компания получила от 11% до 70% больше обработанного аудио на каждый доллар по сравнению с ранее использовавшимися вычислительными вариантами.
Это не универсальный бенчмарк Trainium против GPU. Результат относится к конкретной модели и batch-сценарию. Но он хорошо показывает реальную механику: простой перенос кода открывает дверь, а заметная экономия появляется после профилирования и оптимизации.
Как проверить Trainium на своей модели
TorchNeuron имеет смысл рассматривать не как срочную причину переносить всё с NVIDIA, а как возможность провести честный технический тест.
-
Зафиксируйте базовые метрики. До миграции измерьте пропускную способность, задержку, стоимость обработки единицы данных, потребление памяти и качество модели. Без этого сравнение превратится в спор о маркетинговых цифрах.
-
Начните с неизменённого PyTorch-кода. Переведите модель на устройство neuron, проверьте запуск в eager mode и сравните выходы с текущим вариантом. Это покажет, насколько проект попадает в поддерживаемую поверхность TorchNeuron.
-
Проверьте fallback и разрывы графа. Если часть операторов уходит на CPU или граф разбивается на сегменты, производительность может оказаться ниже ожидаемой. Для production-нагрузки это критичнее, чем сам факт успешного запуска.
-
Тестируйте целевой сценарий, а не модель в вакууме. Отдельно измеряйте batch-инференс, онлайн-инференс, обучение, дообучение и нагрузку с реальными размерами входных данных. Результаты одного режима нельзя переносить на другой.
-
Считайте полную стоимость. В расчёт должны входить не только цены инстансов, но и время команды, компиляция, доработка ядер, хранение данных, сетевой трафик, наблюдаемость и поддержка готового сервиса.
Такой тест не требует заранее принимать стратегическое решение. Он даёт команде аргументы: где Trainium подходит без серьёзной доработки, а где преимущества CUDA-экосистемы пока перевешивают.
Что меняется для NVIDIA
TorchNeuron не лишает NVIDIA её программного преимущества за один релиз. У CUDA огромная экосистема, множество зрелых библиотек и многолетняя база кода, уже работающего на GPU. Кроме того, TorchNeuron пока находится в публичной beta-версии и поддерживает только Trainium2 и Trainium3.
Но AWS атакует наиболее чувствительную точку: стоимость смены поставщика. Если разработчик может запустить привычную PyTorch-модель на другом ускорителе, протестировать её без переписывания и затем постепенно оптимизировать узкие места, зависимость от единственной аппаратной платформы становится слабее.
Для рынка это полезный сдвиг. Конкуренция между ускорителями начнёт сильнее зависеть от цены, производительности, качества инструментов и удобства эксплуатации, а не только от того, насколько сложно уйти с уже выбранного железа.
NVIDIA по-прежнему остаётся стандартом для значительной части ИИ-разработки. Но AWS пытается сделать этот стандарт менее безальтернативным — не громким заявлением о новом чипе, а более прагматичным способом: дать разработчикам привычный интерфейс для выбора другого оборудования.
Автор: ai_scientist

