


Представьте, вот у вас на диске папка с договорами, сотня PDF, конспекты и внутренняя документация. Вы открываете ChatGPT, загружаете один файл — он его читает. Загружаете больше — контекст переполняется, или файл банально теряется. А если файлов десять? Двадцать? Подписка стоит денег, из России нужен VPN, и даже с ним модель не знает, что написано в ваших таблицах, пока вы не скормите ей всё вручную.
Вот тут и появляется AnythingLLM – опенсорсное приложение, которое превращает ваши файлы в базу знаний и позволяет общаться с ними через любую LLM. Хотите локально, бесплатно, на своей видеокарте? Пожалуйста. Хотите через облачную модель, но без подписки OpenAI и танцев с бубном? Тоже вариант — и ниже разберём его по шагам. Суть статьи простая, за вечер собрать приватного ассистента, который отвечает по вашим документам. С блекджеком и RAG!
Я долго откладывал AnythingLLM — думал, ну ещё один чат с документами, что там может быть интересного. А в итоге может! Приложение умеет не только искать куски текста в PDF. Оно держит workspace — изолированные пространства под разные проекты, где у каждого своя память, свои документы и своя модель. Один воркспейс крутится на локальной Ollama, второй ходит в Claude через API. Система сама решает, какой запрос уйдёт дешёвой модели, а какой — флагманской: в версии 1.13.0 появился Model Router, который ровно этим и занимается. Звучит как обещания с лендинга. Но работает без магии — правила задаёте вы.
Кстати, про модели. Чтобы всё это завелось, нужен доступ к LLM. Стандартный путь: подписка OpenAI, VPN, зарубежная карта. А можно проще — подключить OpenAI-совместимый шлюз от Bothub. Там Claude, GPT, DeepSeek, Qwen и ещё десятки моделей — без VPN, с оплатой российской картой. По реферальной ссылке дают 300 000 CAPS бесплатно, так что на все эксперименты из статьи хватит с запасом. Полный список моделей лежит здесь, а шлюз, который мы будем прописывать в AnythingLLM, выглядит так: https://openai.bothub.chat/v1.
Дальше — два сценария, либо быстрый старт на десктопе либо серверная установка через Docker. Покажу, где лежат настройки Generic OpenAI, как загружать документы в режиме Embed, чтобы они не съели всё контекстное окно, и на какие грабли лучше не наступать. Отдельно пройдёмся по безопасности — в 2026 году у AnythingLLM нашли несколько уязвимостей, и CVE-2026-48116 позволяет выполнить произвольную команду внутри Docker-контейнера. Не обновитесь до 1.13.0 — привет. Но об этом позже. Сначала — что вообще представляет собой AnythingLLM и почему в 2026-м он остаётся одним из самых практичных решений для работы с собственными документами.
Что такое AnythingLLM и кому он нужен
Формально — full-stack open-source приложение, которое берёт ваши файлы, режет на куски, складывает в векторную базу и подсовывает модели в нужный момент. Звучит суховато, согласен. На практике это рабочий стол, где документы, чат и агенты живут в одном окне, а не разбросаны по десяти вкладкам и трём сервисам.
Дистрибутива два. Десктоп — one-click установка на Mac, Windows или Linux. Всё крутится на вашей машине, ни один байт документов не уходит наружу, и на этом, по сути, всё. «Single-player» — в документации написано прямым текстом.
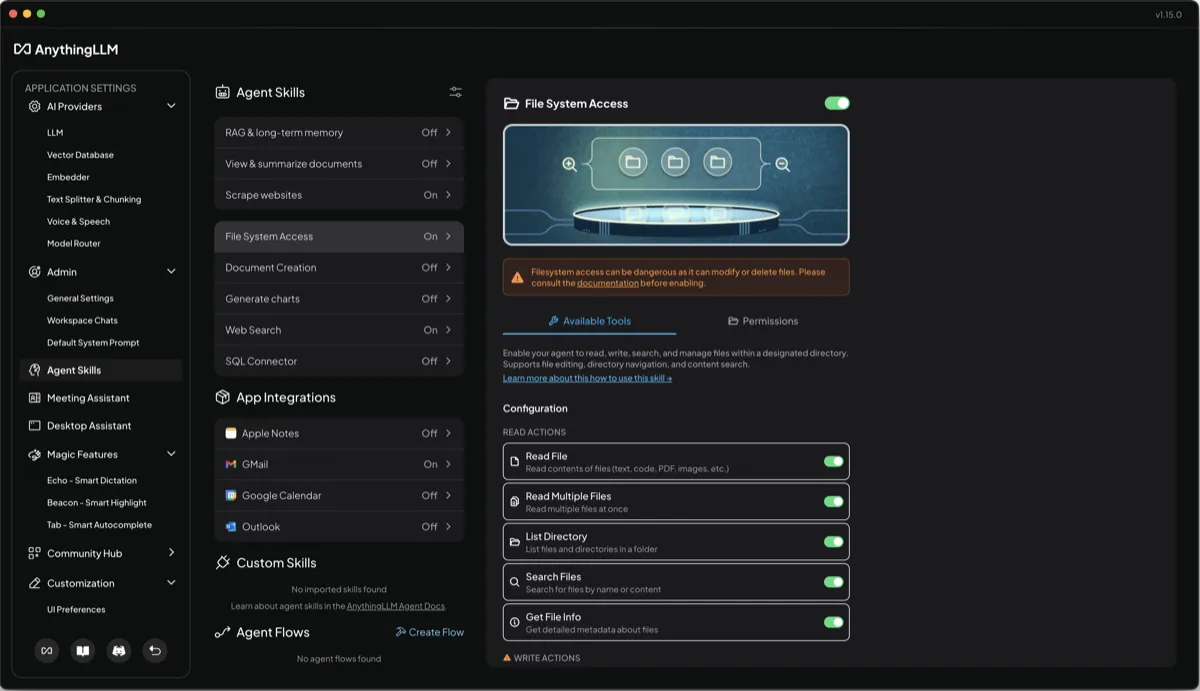
Docker — совсем другое дело. Та же кодовая база, но на сервере: мультипользовательский режим, приглашения, разграничение доступа к workspace, встраиваемые чат-виджеты на сайт. Хотите повесить ассистента на клиентский портал под своим логотипом? Можно — но только в Docker-версии.
Кому это нужно? Юристам с папкой договоров, аналитикам с выгрузками, разработчикам с внутренней документацией, малым командам, которые устали пересылать друг другу PDF в мессенджерах. Всем, у кого есть текст, но нет желания кормить им публичные облака.
А кому не нужно? Тем, кто ищет «просто чат без настройки». Кривая обучения у RAG есть, и местами она неприятная: чанкинг, эмбеддинги, пороги сходства — на первый взгляд набор слов из документации, а не инструмент для нормальной работы. Первый вечер уйдёт на разбирательства. Зато второй — на реальные задачи.
Ключевые возможности
Вот тут начинается самое интересное — за пару лет AnythingLLM, как говорится, оброс мясом.
RAG и работа с документами
Набор форматов простой: PDF, DOCX, TXT, веб-страницы, аудио через Whisper — всё это грузится в workspace и превращается в контекст. Но есть нюанс, на котором спотыкаются почти все. Документ можно «прикрепить» к чату — и тогда его полный текст летит в контекстное окно модели. Работает быстро, живёт недолго: пара больших файлов, и окно переполнено. Второй режим — Embed. Файл режется на чанки, каждый чанк векторизуется и уходит в базу, а в промпт попадают только релевантные фрагменты. Вот это и есть RAG в его нормальном виде. Контекстное окно кончилось? AnythingLLM сам разбивает документ — руками считать ничего не нужно.
Векторные базы
По умолчанию всё лежит в LanceDB — встроенной и приватной. Векторы никуда не уезжают, пока вы сами не решите иначе. Мало? Подключаются PGVector, Chroma, Milvus, Pinecone, Qdrant, Weaviate, AstraDB — смотря что уже стоит в вашей инфраструктуре. Вся миграция — одна переменная окружения, переписывать приложение не придётся.
Любые LLM
Ollama на своей видеокарте, OpenAI, Anthropic, Google, Azure, Bedrock — список длинный. И есть Generic OpenAI: универсальный адаптер для любого OpenAI-совместимого эндпоинта. Через него подключается Bothub, всего-то прописываете https://openai.bothub.chat/v1, вставляете ключ, выбираете модель из каталога — и работаете.
Агенты, Model Router и Scheduled Jobs
Вернусь к Model Router — штука на самом деле полезная. Он на ходу решает, какая модель ответит на конкретное сообщение: простой вопрос уходит дешёвой локальной, юридический — флагманской облачной. Правила настраиваются как хотите, хоть по ключевым словам, количеству токенов или времени суток, хоть по вложенной картинке.
Там же, в 1.13.0, появились Scheduled Jobs. Агент запускается по расписанию: собирает утренний брифинг, проверяет почту, мониторит сайт — без вашего участия. Визуальный конструктор вместо cron-синтаксиса. Мелочь? Мелочь еще та! Но тем, кто не любит лишний раз лезть в терминал, — приятно.
Мультимодальность и мультипользовательский режим
Speech-to-text, text-to-speech, генерация изображений — всё это есть, но «вау» не ждите. Приятный бонус к основному сценарию, не больше. А вот мультипользовательский режим в Docker — вещь серьёзная: приглашение пользователей, парольная защита, разграничение доступа к workspace и документам, полный API. Для команды из пяти человек, которая не хочет покупать пять подписок, — аргумент.
И снова безопасность. В 2026-м нашли ту самую CVE-2026-48116 — инъекцию команд, которая позволяла выполнить произвольный код внутри Docker-контейнера до версии 1.13.0. Патч вышел, но если разворачиваете инстанс сегодня — начните с обновления.
Установка: два пути
Раз уж предыдущий раздел закончился советом обновляться — вот цифра на момент подготовки статьи: 1.19.0. Дальше два варианта, от домашнего к серверному.
Desktop: скачал и работаешь
Официальный сайт отдаёт сборки под Mac (Silicon и Intel), Windows и Linux. Ставится как обычное приложение: скачал, открыл, прошёл короткий мастер первого запуска. Настраивать почти нечего — встроенная LLM включена по умолчанию и на старте сама предложит три модели под ваше железо: самую быструю, сбалансированную и самую умную. Качает их с Hugging Face в GGUF, прогресс ползёт в углу окна.
Под Linux — отдельная инструкция, приведу целиком:
curl -fsSL https://cdn.anythingllm.com/latest/installer.sh -o installer.sh
chmod +x installer.sh
./installer.sh
Скрипт скачивает AppImage под вашу архитектуру (x64 или arm64), кладёт в домашнюю директорию, создаёт ярлык для меню и правило apparmor, чтобы система не ругалась на неподписанный файл. Захотите обновиться — запустите тот же скрипт ещё раз. Три строки, и на компе живой клиент.
К слову, встроенный движок в свежих версиях собран поверх Lemonade — локального сервера от AMD, который гоняет GGUF через llama.cpp. Для проб и личных задач его хватает. С большой базой документов — увы: начнёт задыхаться, ресурсов-то у машины одни. Внешняя модель снимает проблему, про неё — ниже.
Docker: для сервера
Десктоп хорош, пока вы один. Как только ассистента нужно отдать коллегам или поселить на машине, живущей 24/7, — переходим к Docker:
export STORAGE_LOCATION=$HOME/anythingllm
mkdir -p $STORAGE_LOCATION
touch "$STORAGE_LOCATION/.env"
docker run -d -p 3001:3001
  --cap-add SYS_ADMIN
  -v ${STORAGE_LOCATION}:/app/server/storage
  -v ${STORAGE_LOCATION}/.env:/app/server/.env
  -e STORAGE_DIR="/app/server/storage"
  mintplexlabs/anythingllm:latest
В STORAGE_LOCATION лежит путь, куда встанет всё: база, документы, .env с ключами. Директория монтируется внутрь контейнера, так что сам контейнер можно убивать и пересоздавать хоть каждый день — хранилище переживёт. Флаг --cap-add SYS_ADMIN выглядит подозрительно, я тоже косился. Но без него встроенный headless-браузер, вытаскивающий текст с веб-страниц, откажется стартовать. Контейнер поднялся? Открывайте http://localhost:3001 и заводите админский аккаунт.
Теперь права — здесь застревают чаще всего. Контейнер запускается от непривилегированного пользователя anythingllm с UID/GID 1000. Если у вашего пользователя на хосте другие идентификаторы, примонтированная папка становится чужой: SQLite не может создать файл базы, и контейнер уходит в вечный перезапуск с ошибкой unable to open database file. Особенно коварны пути вроде /mnt, /data или /srv — обычно они принадлежат root. Лечится одной строкой до первого старта:
sudo chown -R 1000:1000 ${STORAGE_LOCATION}
Встроенную LLM можно включить и в Docker — добавьте -e ENABLE_BUILT_IN_LLM=true к docker run. Флаг появился в версии 1.18.0: контейнер умеет тянуть те же GGUF-модели с Hugging Face и задействует GPU — NVIDIA через CUDA, AMD и Intel через Vulkan. Нюанс: на уже работающем инстансе одного флага мало, контейнер придётся пересоздать. Хранилище при этом не пострадает. Для знакомства сойдёт, но для боевого RAG я всё же советую сразу внешнюю модель через шлюз.
Что брать? Потрогать и понять, своё это или чужое, — десктоп закрывает вопрос за десять минут. Для команды или постоянной жизни на сервере — только Docker: доступ для коллег уже встроен, а бэкап сводится к копированию одной директории STORAGE_LOCATION.
Подключаем Bothub как OpenAI-совместимого провайдера
Сначала ключ. Он живёт в личном кабинете Bothub: раздел «Для разработчиков», кнопка «Добавить ключ» — там же показан и базовый URL шлюза.
Дальше сам AnythingLLM. Иконка гаечного ключа в левом нижнем углу, затем AI Providers → LLM. В списке LLM Provider выбираете Generic OpenAI — пункт, который разговаривает на языке OpenAI API с любым совместимым шлюзом.
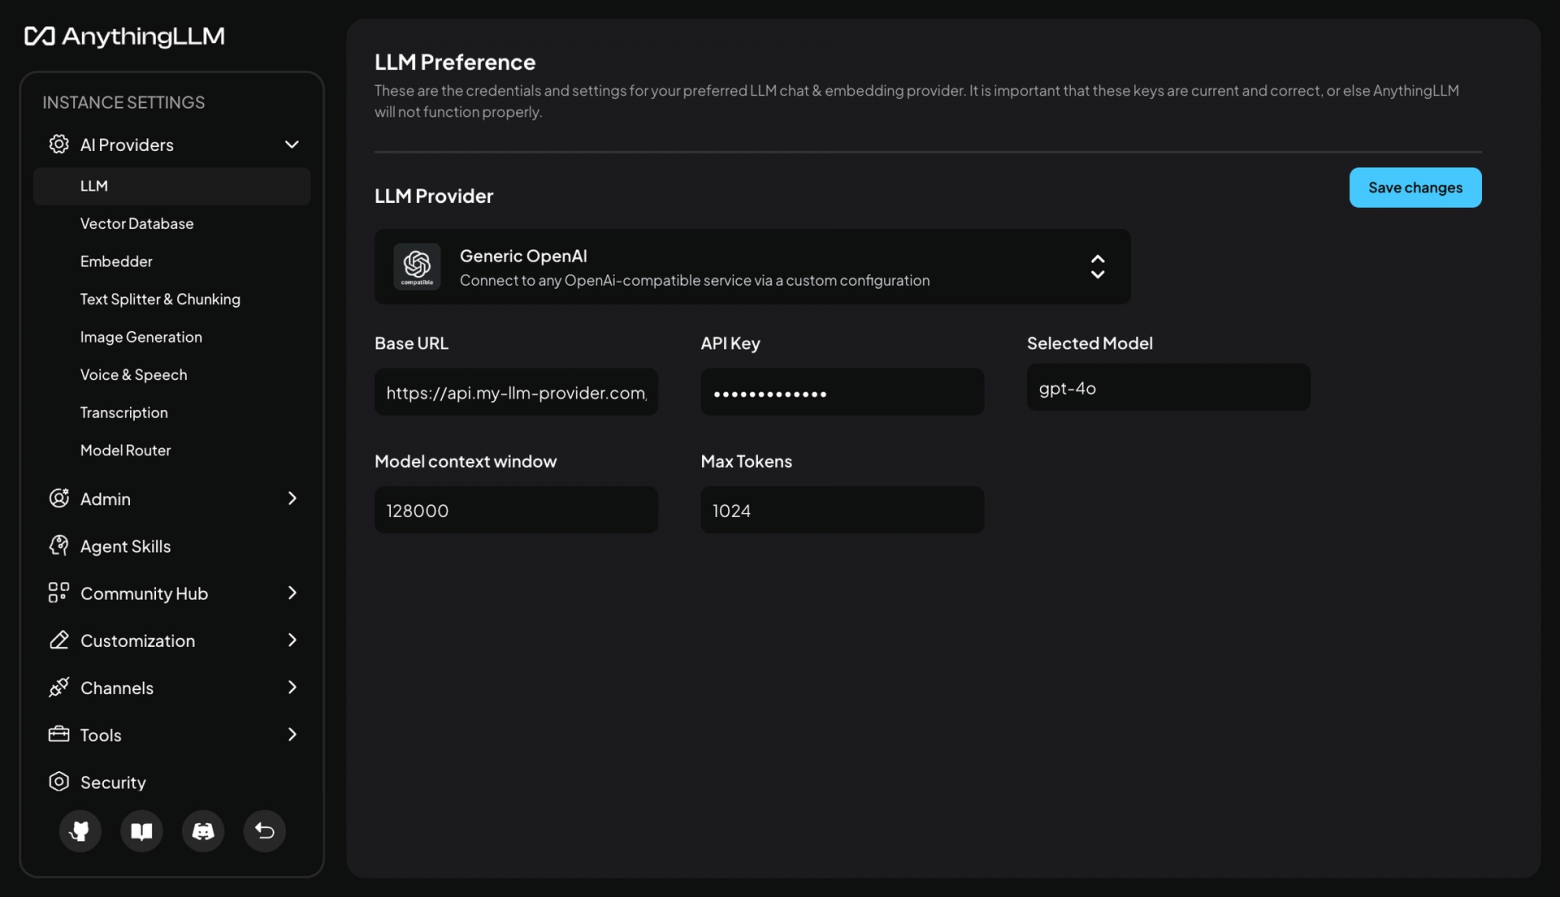
Из полей нас интересуют три:
|
Поле |
Что вписать |
|---|---|
|
Base URL |
|
|
API Key |
ваш ключ Bothub |
|
Chat Model Name |
ID модели, например |
ID модели вписывайте буква в букву, как в каталоге, — с точками, дефисами и суффиксами-датами, если они есть. Пришлёте «почти то же имя», API вернёт ошибку про неизвестную модель, а вы полчаса будете искать проблему там, где её нет.
Ниже есть ещё два поля — Token context window и Max tokens (в self-hosted они же переменные GENERIC_OPEN_AI_MODEL_TOKEN_LIMIT и GENERIC_OPEN_AI_MAX_TOKENS). Первое заполните реальным окном модели — тогда RAG смелее набьёт промпт релевантными чанками. Второе по умолчанию равно 1024, и длинные ответы молча обрежутся. Ставьте хотя бы 4096, если модель любит расписывать.
Жмите Save и открывайте воркспейс — лучше пустой. Короткий тестовый вопрос в чат, пара секунд ожидания. Ответила — связка собрана. Ругается на авторизацию — перепроверяйте ключ. Отдаёт 404 — вы уже знаете, где собака зарыта.
Тот же Generic OpenAI приживётся и с локальными серверами — LM Studio на
http://localhost:1234/v1, Ollama в режиме совместимости наhttp://localhost:11434/v1, vLLM, OpenRouter. Схема одна, меняется только Base URL. Пригодится, когда захотите часть воркспейсов держать на своей железке.
Самое приятное в этой связке — код трогать не нужно. AnythingLLM сам собирает запросы в формате OpenAI, Bothub их принимает, модель меняется одной строкой в настройках. Сегодня флагман от Anthropic, завтра дешёвый DeepSeek для рутины. Провайдер на месте, шлюз отвечает. Осталось главное — документы.
Ограничения
Теперь о том, о чём в обзорах обычно молчат. RAG в AnythingLLM работает из коробки. Но работает он средненько. Качество ответа зависит от того, как вы порежете документы на чанки, какую модель эмбеддингов возьмёте, какой порог сходства выставите. Дефолты — компромисс между скоростью и точностью, а не решение под вашу задачу. Придётся покрутить. И у вас закономерно встанет вопрос, почему модель отвечает по одному абзацу из середины PDF и упорно игнорирует три остальных — где написано то же самое, но другими словами.
И это ещё не самое неприятное.
В 2026 году всплыла история с утечками памяти в агентских сессиях. Каждый RAG-запрос в агенте добавлял от 100 до 650 мегабайт нативной памяти, которая не освобождалась. Для домашнего эксперимента — ладно. Для сервера с десятком пользователей — беда. Патчи частично закрыли дыру, но осадочек остался. Агенты в AnythingLLM временами ведут себя как стажёр, которому дали доступ к продакшену: вроде старается, но лучше пусть стоит рядом.
Безопасность, о которой хочется забыть, но нельзя
Дальше — CVE, и здесь станет менее весело. В мае 2026-го закрыли сразу несколько дыр, две из них стоит запомнить. CVE-2026-48116 — RCE через инъекцию аргумента в ripgrep. Если у вас включён файловый плагин (а в официальном Docker-образе он включён по умолчанию), любой, кто может написать сообщение агенту в чат, способен выполнить произвольную команду внутри контейнера. Вдумайтесь: сообщение в чат — и команда на вашей машине. Патч вышел в 1.13.0, но если развернулись раньше и не обновлялись, вы в зоне риска.
CVE-2026-45403 — path traversal через символические ссылки в том же файловом инструменте. Копируешь папку, а оттуда утекает /etc/passwd. Тоже починили в 1.13.0. До этого была SQL-инъекция в плагине SQL Agent — любой пользователь с доступом к агенту мог выполнять произвольные SQL-команды на подключённых базах.
Вывод простой, но скучный: обновляйтесь. И не выставляйте Desktop в интернет — там нет аутентификации в принципе. Docker-версия тоже по умолчанию не просит пароль, пока вы сами его не включите. Открытый порт без пароля — это уже не приватность, а лотерея.
Hosted-версия: не то, чем кажется
Облачный AnythingLLM выглядит соблазнительно: пятьдесят долларов в месяц, и ничего не надо разворачивать. Но есть нюанс. В hosted-версии нет встроенной LLM — только внешние провайдеры. Эмбеддер работает на CPU с жёсткими лимитами: загрузите PDF на пять тысяч страниц, и инстанс упадёт с 502-й ошибкой. Кастомные агенты отключены из соображений безопасности, MCP-серверы — тоже. Для быстрого старта — да. Для реальной работы с документами — только Desktop или self-hosted Docker.
Заключение
AnythingLLM — уже полноценная локальная база знаний: RAG, агенты, расписания, мультипользовательский режим. Да, с безопасностью у неё были проблемы. Да, память текла. Да, hosted-версия урезана по самое не хочу, а кривая обучения никуда не делась. И всё равно для сценария «чат по своим документам» это одно из самых практичных open-source решений — особенно если подключить внешний шлюз вроде Bothub и не мучиться с подписками.
Вечер на настройку, ноль подписок — и ChatGPT с его «загрузите один файл» вспоминается как дурной сон.
Автор: DrArgentum

