


Всем привет! Меня зовут Олег Малышев, я один из лидеров стека тестирования в компании «ТехВилл». Мы продолжаем разговор о том, как применять ИИ в тестировании так, чтобы он снимал рутину.
Что уже было в этой серии:
-
Перенос тест-кейсов из Яндекс Трекера в Allure TestOps одной командой;
-
Как мы превратили Swagger из документации в двигатель API-автотестов;
-
Как мы научили AI разбирать упавшие автотесты и заводить баги в Трекере.
В одной из статей я обещал рассказать, как ИИ у нас сам готовит тест-планы, проверяет задачу через БД, REST и gRPC и публикует отчёт в Трекер. Но об этом расскажет мой коллега в другой статье. И чем дальше мы туда шли, тем яснее становилось, что сначала нужно решить другую проблему. Агент каждый раз начинает с нуля. Поэтому сегодня расскажу про память: про MKP, нашу платформу баз знаний, и про то, как мы встраиваем её во все проекты, где QA работают с ИИ.
Проблема: знания QA живут где угодно, только не там, где их можно найти
Представьте обычный день QA. Пришла задача: на самовывозе пустая витрина категории. QA открывает код, логи, Jaeger, пишет в чат разработке. Через два часа выясняется, что это не баг. Витрина берёт наличие из кэша, кэш обновляется раз в несколько минут, а мок остатков на контуре перехватывал живой прокси с неправильным приоритетом.
Знание получено. И где оно теперь?
-
в голове этого QA;
-
в треде чата, который через неделю никто не найдёт;
-
в комментарии к задаче, который ищется только по ключу задачи;
-
в лучшем случае на странице wiki, которую кто-то когда-то напишет.
Через месяц другой QA получает похожую задачу и тратит те же два часа. А ИИ-агент, которому мы доверили тестирование, тратит их каждый раз: у него нет памяти между сессиями.
С корпоративной документацией у нас всё в порядке: есть EvaWiki, там требования и описания процессов. Но EvaWiki про продукт, а не про тестирование. Туда не пишут «на основном тестовом стенде свежий подарок не появляется в выдаче, онлайн-сценарий проверяй на test-qa» или «перед проверкой подожди пять минут, пока обновится кэш наличия». Это рабочее знание QA, и ему нужен свой дом.
Что такое MKP
MKP (Multi knowledge platform) – внутренняя платформа для тестировщиков и аналитиков: базы знаний и умный поиск по документам.
В MKP два типа баз.
evawiki — встроенная база EvaWiki. Она одна, идёт в коробке и обновляется каждый день сама. Через MKP по ней можно только спрашивать: создавать и править документы EvaWiki нужно через отдельный MCP EvaWiki.
markdown — базы команд тестирования. Их может быть сколько угодно. Туда складывают архитектуру тестирования, результаты прогонов, найденные баги и способы их обойти. Документы можно создавать, обновлять, удалять, искать по смыслу и получать по номеру.
Работать с платформой можно тремя путями:
-
веб-интерфейс с разделами «Чат», «Документы», «Запуски», «Пользователи» и «Профиль»;
-
REST API для интеграций;
-
MCP для ИИ-агентов: Cursor, Claude Code, Codex и всех, кто умеет в MCP.
Права везде одни. Пользователь входит в интерфейс по логину и паролю, а REST и MCP ходят по его персональному API-ключу. Нет доступа к базе — операция отклоняется в любом канале.
EvaWiki ──(ежедневное обновление)──┐
▼
┌──────────────┐ вопрос ┌─────────────────────────┐
│ QA в веб-чате│ ──────────────► │ MKP │
└──────────────┘ │ EvaWiki-база знаний │
│ markdown-базы команд │
┌──────────────┐ MCP-запрос │ RAG search │
│ ИИ-агент │ ──────────────► │ │
│ Cursor/Claude│ ◄────────────── │ ответ + источники │
└──────────────┘ └────────────┬────────────┘
▼
поисковый индекс
(Qdrant)
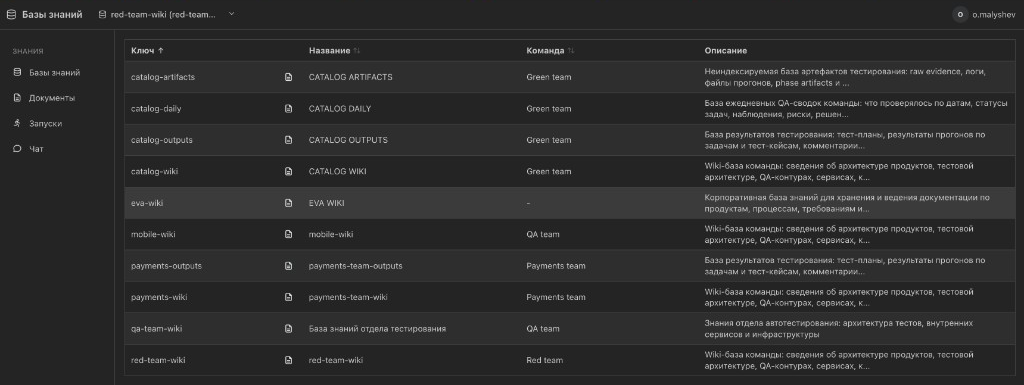
Базы знаний в веб-интерфейсе MKP: у каждой команды свои, плюс встроенная eva-wiki
Как MKP ищет
Под капотом RAG, но не самый наивный. Платформа комбинирует несколько техник:
-
hybrid dense/sparse retrieval – смысловой поиск вместе с поиском по ключевым словам. Это важно для QA: в наших вопросах много идентификаторов вроде GetExists, is_pickup, CMA-14699, а чистый векторный поиск такие строки любит терять;
-
multi-query – модель сама переформулирует вопрос в нескольких вариантах;
-
reranking – найденные фрагменты дополнительно ранжируются;
-
parent-child retrieve – ищем по маленьким фрагментам, а в ответ отдаём контекст раздела, из которого фрагмент взят.
В ответе всегда три вещи: сформулированный ответ, источники (документ, score, snippet) и trace_id для диагностики. Источники нам принципиально важны. QA и агент должны видеть, на чём построен ответ, и уметь открыть исходный документ.
MCP в коробке
У MKP есть свой MCP-сервер. Инструментов всего пять, и этого пока хватает:
|
Инструмент |
Что делает |
Права |
|
list_knowledge_bases |
список доступных баз с правами |
— |
|
query_knowledge_base |
смысловой запрос к базе |
read |
|
get_document |
документ по номеру |
read |
|
upsert_document |
создать или обновить документ |
write |
|
delete_document |
мягко удалить документ |
write |
Права и роли
Ролей две: admin (пользователи, модели, промпты, сплиттеры, создание баз) и user (работа в пределах выданных прав). Права выдаются на каждую базу отдельно: read — поиск и чтение, write — ещё и запись, удаление и запуск обработки.
Совет из документации платформы, который мы взяли как правило: для каждого ИИ-агента или интеграции заводите отдельного пользователя с минимально нужными правами. Агенту команды каталога не нужна запись в базу команды платежей. А у администратора есть удобный переключатель «Запретить вход в UI»: технический пользователь работает только через MCP, а в интерфейс войти не может.
Как документ попадает в поиск
Сохранённый документ находится в поиске не сразу: сначала платформа должна его обработать.
создание ──► draft ──► processing ──► published (участвует в поиске)
│ ▲ │
▼ │ │ обновление
error ─┘ ▼
processing
Пока документ обрабатывается, у него статус processing. После обработки он становится published и начинает находиться в поиске. Если обработка упала, документ получает статус error, и обработку запускают снова. Когда опубликованный документ обновляют, он ещё раз проходит processing, и новые правки попадают в поиск только после этого.
Как мы встроили MKP в работу QA
MKP сама по себе хорошая платформа с умным поиском. Но если документы в неё будут класть руками, через полгода получится ещё одна wiki, которую никто не обновляет.
Поэтому мы сделали иначе: знания в базу пишет ИИ-агент, в ходе обычной работы QA.
У нас есть QA-кит, о котором мы обязательно расскажем в будущем, репозиторий с правилами, skills и автоматизацией, через который QA работают в Cursor и Claude Code. Теперь в этот кит встроена MKP, и каждый запрос QA к агенту проходит через базу знаний.
Это уже не просто wiki. Это база знаний на максималках. QA в реальном времени занимается задачей, ИИ помогает ему: отвечает на вопросы, ходит в код, БД и логи, проверяет гипотезы. Всё, что выяснилось по ходу, агент структурирует и складывает в базу знаний проекта. На следующей задаче этим пользуется уже другой QA. Его агент находит знания коллег, тестирует быстрее и точнее и сам дописывает в базу то, что узнал. С каждой задачей тестирование становится лучше.
QA берёт задачу
│
▼
агент ищет в MKP: был ли ретест, что ловили на похожем,
что команда знает о сервисе, что говорит продуктовая документация
│
▼
тест-план строится с учётом найденного
│
▼
QA и агент тестируют: вопросы, гипотезы, проверки
│
▼
агент пишет в MKP: план, результат, комментарий,
запись дня, новый факт в wiki команды
│
▼
следующий QA (и его агент) находит это в чате или через MCP
Четыре базы на домен
Для каждого домена (каталог, поиск, рекомендации, BFF, остатки и так далее) у нас четыре markdown-базы, у каждой своя роль:
|
Роль |
Что лежит |
Пример ключа |
|
wiki |
устойчивые знания: архитектура, контуры, моки, контракты, «как правильно проверять» |
catalog-wiki |
|
outputs |
тест-планы, результаты прогонов, комментарии в Трекер — полные тексты |
catalog-outputs |
|
daily |
что проверяли по дням, статусы, риски, плюс оглавление index |
catalog-daily |
|
artifacts |
склад сырых доказательств: curl, SQL, JSON, моки |
catalog-artifacts |
Плюс продуктовая eva-wiki: её читают все, а пишет в неё только сама EvaWiki.
Кто куда может ходить, описано одним реестром в git:
product_read:
- eva-wiki
bases:
catalog-wiki:
access: write
team: catalog4
role: wiki
domain: catalog
# ... catalog-outputs, catalog-daily, catalog-artifacts
teams:
catalog4:
layout: dedicated
domain: catalog
wiki: catalog-wiki
outputs: catalog-outputs
daily: catalog-daily
artifacts: catalog-artifacts
Агент читает базы своего домена и eva-wiki, а пишет только в свои четыре. Чужой домен он не видит. Несколько команд одного домена (например, каталог и карточка товара) пишут в один набор баз. Какая команда записала документ, видно по полю team в метаданных. А конкретного автора MKP знает по API-ключу: ключ у каждого свой, и агент пишет под ключом того QA, с которым работает.
До тестирования: агент сначала вспоминает
Раньше агент начинал задачу с чистого листа. Теперь, до того как показать QA тест-план, он обязан сделать четыре поиска:
-
Был ли ретест. get_document по точным номерам <задача>-test-plan и <задача>-test-result. Для новой задачи промах — это нормально.
-
Что ловили на похожем. Один смысловой запрос в outputs по функциональности. Без ключа задачи, иначе поиск притянет документы этой же задачи и задушит поиск по смыслу.
-
Что команда знает о сервисе. Смысловой запрос в QA-wiki своей команды, например
catalog-wiki. Там то, что накопили сами QA и агенты: контуры, моки, как правильно проверять -
Что говорит продукт. Смысловой запрос во встроенную базу
eva-wiki, то есть в корпоративную документацию: требования. Если там пусто, агент ищет документ в самой EvaWiki через её отдельный MCP: свежего документа в ежедневной копии может ещё не быть.
После тестирования: агент записывает
На финише агент делает несколько записей:
-
в outputs — полный тест-план, полный результат и комментарий, который ушёл в Трекер. Без пересказа и без сокращений;
-
в daily — запись дня и обновлённое оглавление index;
-
в wiki — новый устойчивый факт, если он появился. Например, «на этом контуре прокси поиска отвечает 403, нужен статический мок».
Документы в outputs идут с обязательными метаданными, чтобы их потом можно было найти и отфильтровать:
{
"kb_key": "catalog-outputs",
"doc_id": "cma-14699-test-result",
"doc_name": "CMA-14699 — результат внешнего тестирования",
"doc_content": "# CMA-14699 ...полный текст результата...",
"doc_metadata": {
"task_key": "CMA-14699",
"doc_type": "test_result",
"team": "catalog4",
"artifact_refs": ""
}
}
Примеры из жизни
Покажу, как это выглядит на реальных запросах к нашим базам.
Пример 1. «Почему витрина пустая на самовывозе?»
Вернёмся к истории из начала статьи. Теперь QA, который получил похожую задачу, просто спрашивает в чате MKP или своего агента:
почему витрина категории пустая на самовывозе: остатки и тестовые данные
Запрос к catalog-wiki, ответ за ~24 секунды, status: sufficient. Сокращённо:
Витрина категории на самовывозе может быть пустой по нескольким причинам:
1. Кэш наличия (GetExists). Витрина берёт доступность из кэша, а не из
только что поставленного мока. Сразу после мока товары могут остаться
NotAvailable. Подождите ~5 минут и повторите — пустая витрина в первую
минуту не дефект.
2. Предзаказные товары. Предзаказ на самовывозе недоступен — проверяйте
категории с обычными товарами.
3. Приоритет мока. В WireMock побеждает меньший priority. Если ваш мок не
строго меньше живого прокси, остатки придут от прокси.
4. Поиск. Прокси SearchProducts на контуре отвечает 403 — нужен
статический мок, а те же product_id надо добавить в остатки магазина.
5. Пустая категория в БД. Если категория пустая в таблице связей,
выдача будет пустой ещё до рекомендаций — моком остатков это не лечится.
Что проверить по порядку: ветка самовывоза, корзина и shop_id, моки
остатков и их priority, пауза кэша…
Источник: catalog4-mocks-by-service (score 0.655)
Этот ответ никто не писал как статью. Он собран из разборов задач, которые разные QA делали вместе с агентом последние месяцы. Каждый раз, когда кто-то упирался в пустую витрину и находил причину, агент дописывал факт в wiki-документ «моки по сервису». Теперь это чек-лист на девять пунктов, и QA проходит его за десять минут вместо двух часов.
Пример 2. Новая задача на аналоги товаров
Приходит задача на рекомендации аналогов. До построения плана агент сам спрашивает catalog-outputs:
аналоги товара пост-фильтр InCart: какие риски дефектов и что проверяли
Ответ за ~26 секунд, источники — результаты двух прошлых задач по этой функциональности:
Подтверждённые проблемные места:
1. Data gaps из прошлого прогона: часть наборов пустая, нужны фикстуры
Feature Store и сценарий RecSys; граничный случай «после фильтра
меньше minCarouselProducts» требует мока с малым числом InCart.
В отчёте это пробелы данных, а не дефекты.
2. Легаси-путь getByABTest на контуре недостижим: meta.AB_tests=[],
ABSplit не маршрутизирует в этот путь, админка мока недоступна.
Отмечено как QUESTION, не DEFECT.
3. На TEST-контуре может стоять старый код без фильтра, пока MR не смержен.
Что проверяли: 12 спроектировано, 9 выполнено, 8 PASS, 4 не прогнаны
из-за данных, 0 DEFECT. Cross-oracle через /product/buttons подтвердил,
что кнопка вычисляется до пост-фильтра.
Источники:
cma-14663-test-result (0.34)
cma-14699-test-plan (0.16)
cma-14699-test-result (0.15)
cma-14699-tracker-comment (0.12)
Что это даёт новому QA:
-
он заранее знает, какие фикстуры нужно готовить, и не узнаёт об этом в середине прогона;
-
он не заведёт ложный DEFECT на легаси-путь: коллега уже выяснил, что на контуре путь недостижим, и поставил QUESTION;
-
агент сразу добавляет в план проверку «код на контуре уже с фильтром?», потому что в прошлый раз это стало сюрпризом.
Пример 3. Что команда делала на этой неделе
Документ index в базе daily — это оглавление, которое агент дописывает на каждом финише. Живой фрагмент:
## 2026-10-16
– CMA-14699 — внешний тест, аналоги, пост-фильтр InCart — PARTIAL (R_01 PASS).
Result: catalog-outputs/cma-14699-test-result
– CMA-16086 — повторное ревью ТК 103117 и 103118 — ревью закрыто, замечаний 0.
Result: catalog-outputs/cma-16086-test-result
## 2026-10-19
– CMA-13767 — повторное ревью 19 API-ТК вкусового паспорта — нужны правки,
замечаний 37, из них 2 вопроса.
– CMA-15892 — третий проход ревью девяти ТК по price_lists — ревью закрыто.
Лид открывает это утром и видит, что происходило в команде, без отдельного статус-митинга. Ревью тест-кейсов из первой статьи тоже сюда пишется: каждое ревью оставляет след в outputs и в дне.
Пример 4. Ответ из продуктовой документации
Не всё нужно хранить в базах QA. Когда агенту нужно понять, как фича должна работать, он спрашивает встроенную eva-wiki. MKP ищет по всей корпоративной документации и возвращает ответ со ссылками на документы EvaWiki. Если там пусто, агент идёт в MCP EvaWiki напрямую. Именно в таком порядке: сначала дешёвый смысловой поиск, потом точечное чтение.
Правила, которые мы для себя зафиксировали
Раз уж агенты пишут в базу сами, без правил она быстро превратится в свалку. Агент не переносит в базу диалог: он работает как редактор, отбирает из сессии проверенное знание и раскладывает его по документам. Вот что мы закрепили правилами и валидаторами:
-
Секреты в базу не попадают. Токены, пароли, номера карт и личные данные агент заменяет заглушками вроде <jwt-token>. Настоящие значения остаются только на компьютере QA.
-
Логи и сырые JSON не участвуют в поиске. Они забивают выдачу, поэтому лежат в отдельной базе. Агент открывает их по ссылке из результата теста.
-
Результат теста хранится целиком. В пересказе теряются детали, ради которых коллега потом откроет документ. Слишком большой результат делится на части.
-
В wiki только проверенные факты. Одна статья на тему, а не на задачу. Если агент сам пришёл к выводу, как должен работать продукт, например «пустой ответ здесь – норма, а не баг», в wiki он это сразу не пишет. Сначала вывод подтверждает QA, и только потом он попадает в базу.
-
Дописываем, а не плодим. Если статья по теме уже есть, агент дополняет её, а устаревшее заменяет. Всё, что может измениться, пишется с датой.
-
Статья подсказывает, как её искать. В некоторых базах у статьи есть раздел «Как меня найти»: три-пять вопросов, которыми её будут искать. Так поиску проще понять, когда её показывать.
-
Прошлый результат не заменяет требования. Он подсказывает, что проверить и где риск. Но ожидаемое поведение агент сверяет с актуальными требованиями, а не с тем, как было в прошлый раз.
-
Чужие базы агент не читает. Ему доступны базы своего направления и продуктовая документация. Так знания одной команды не сбивают с толку агента другой.
Веб-интерфейс: та же база, но для людей
У MKP есть и веб-интерфейс. Права там те же, что у API-ключа: пользователь видит только базы, к которым у него есть доступ.
Чат. Вопрос задаётся обычным языком, ответ приходит с источниками.
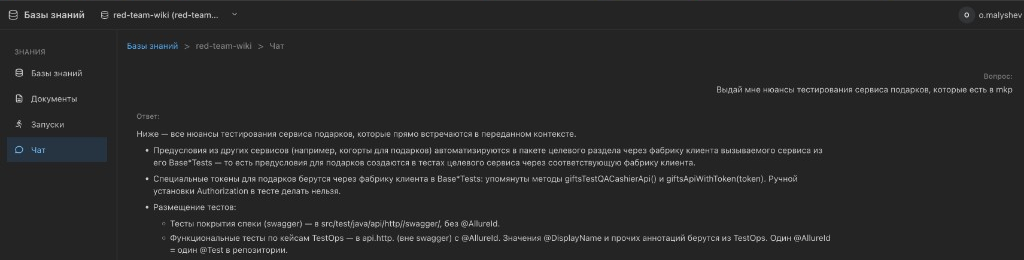
Чат по базе знаний команды: вопрос про нюансы тестирования сервиса подарков, ответ собран из статей базы
Документы. Список документов базы с датами создания и обновления. Видно, что агенты записали за последние дни: свежие тест-планы и результаты, новые статьи wiki, запись дня. У каждого документа показано состояние обработки, так что сразу понятно, попал ли он уже в поиск.
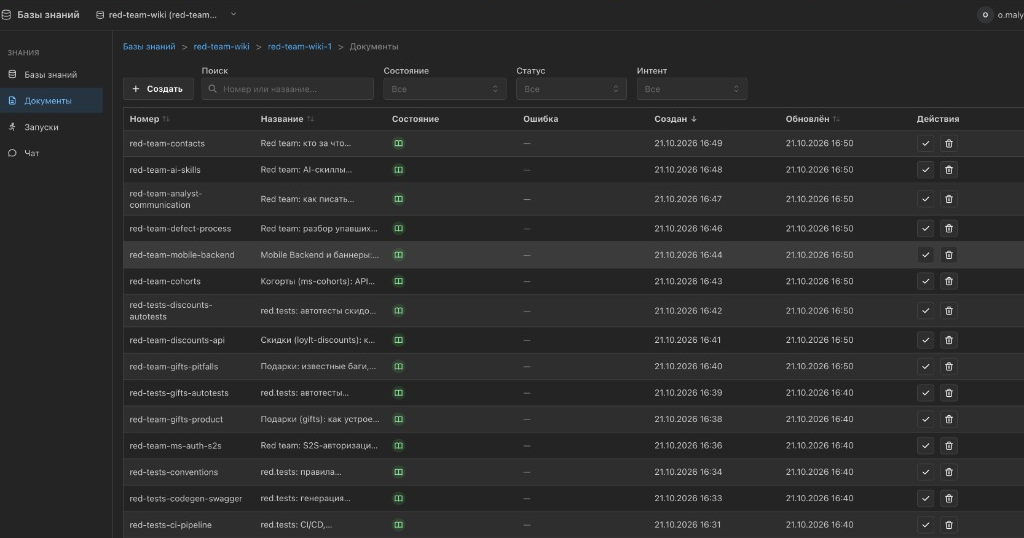
Документы базы знаний команды: что и когда записали агенты
Аудит. Администратор видит, кто и как часто работает с базами: сколько документов создал и изменил каждый пользователь и сколько запросов задал, с разбивкой по командам и базам за выбранный период. Пишется только тип действия, без содержимого запросов и документов. По графику сразу видно, какая команда живёт с базой каждый день, а какая подключилась и забыла.
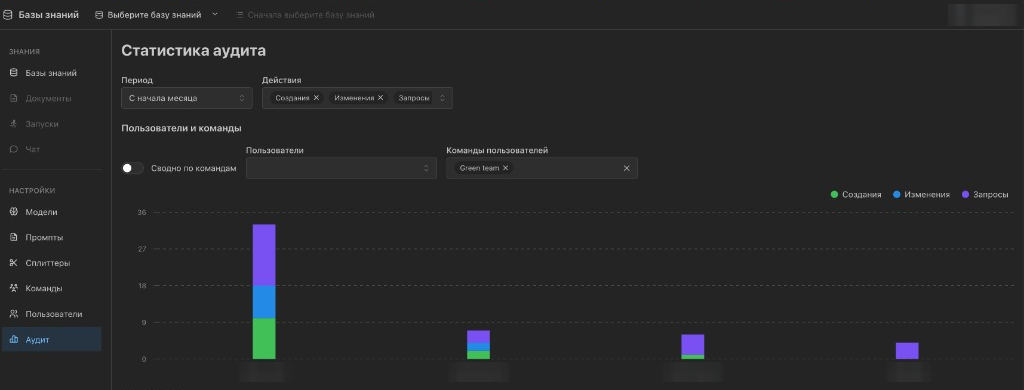
Статистика аудита: создания, изменения и запросы по пользователям одной команды
Аудит отвечает на вопрос «пользуются ли базой». А сколько времени уходит на тест задачи с ИИ и какими инструментами при этом работают, показывают события наших внутренних инструментов. О них — в следующем разделе.
Не только знания: кто, чем и сколько тестирует
MKP подключена не только к Cursor, Claude Code и Codex. К ней привязаны наши внутренние инструменты, через которые QA тестирует задачу с ИИ:
-
MCP http-client: REST- и gRPC-вызовы, trace в Jaeger, сравнение JSON, публикация отчёта в Трекер;
-
наш MCP для TestOps и MCP Яндекс Трекера;
-
skills из прошлых статей: ревью тест-кейсов, генерация автотестов, разбор упавших прогонов.
Каждый такой инструмент оставляет короткое событие жизненного цикла: начался workflow, прочитан skill, вызван MCP-инструмент, найден блокер, подтверждён дефект, записано знание, workflow закончился. В событии есть команда, workflow, skill, ключ задачи, результат и длительность:
{
"ts": "2026-05-24T10:08:00+04:00",
"event": "skill_used",
"actor": "agent",
"result": "completed",
"profile": "catalog",
"team_pack": "catalog4",
"workflow": "api",
"skill": "api-testing",
"task_key": "CMA-8741",
"target": "yandex_tracker",
"duration_ms": 43120,
"artifacts": ["rag://catalog-outputs/cma-8741-retest"]
}
Чего в событии нет, так же важно. Текста переписки с агентом там нет. Тел запросов и ответов, заголовков, токенов, номеров карт и телефонов тоже нет. Для вызова MCP пишется только сервер, инструмент, результат и время. Если помощник логирования видит в событии что-то похожее на токен, JWT или длинный номер, он такое событие просто не записывает. Ошибка логирования при этом не роняет тестирование, а только выводит предупреждение.
Из этих событий собирается агрегированный отчёт за нужный период: самые частые workflow, skills, задачи, команды и результаты. После проверки на приватные данные отчёт ложится в базу знаний рядом с результатами тестирования, и его можно открыть в том же веб-интерфейсе или спросить о нём в чате.
Что это даёт на практике:
-
Видно, кто и как часто пользуется инструментами. Какая команда тестирует API с агентом каждый день, а какая открывала кит один раз на онбординге. Какие skills работают постоянно, а какие можно спокойно удалить.
-
Видно, сколько реально уходит времени на тест задачи с ИИ. Между workflow_started и workflow_completed лежит полное время задачи. Внутри есть время этапов: исследование, исполнение, публикация.
-
Видно, где застревают. События blocker_found показывают, на чём QA и агент чаще всего останавливаются: нет доступа, нет тестовых данных, контур лежит.
-
Видно, приносит ли база пользу. События knowledge_written показывают, кто пополняет базу. По повторным задачам видно, стал ли тест быстрее, когда агент нашёл знания коллег.
MKP в проектах автотестов
MKP встроена не только в QA-кит: мы начали подключать её и к репозиториям автотестов. Там схема пока проще, без четырёх баз, манифестов и валидаторов. Проекту заводят одну wiki-базу, а в AGENTS.md добавляют короткое правило, когда и что агент в неё пишет. Cursor и Codex читают AGENTS.md сами, Claude Code — через строку @AGENTS.md в CLAUDE.md, так что правило одно на все три инструмента.
Где мы сейчас
Сейчас мы встраиваем MKP во все проекты, где QA пользуются ИИ для ручного тестирования и автотестов. Каталог и карточка товара уже работают так полностью. Поиск, рекомендации, BFF и остатки подключены через тот же реестр. У мобильных автотестов, платежей и других команд в MKP уже свои базы, часть из них работает по лёгкой схеме из предыдущего раздела.
Подключение новой команды к киту занимает два-три часа и не требует программирования. Админ заводит в MKP четыре базы, QA-лид проходит онбординг с агентом: профиль, контекст команды, правила приёмки. Самый долгий шаг – перенести в базу то, что команда и так знает: факты о своём сервисе, контуры, типовые грабли. Это осознанно, потому что это и есть результат.
Дальше работает маховик. Каждая задача, которую QA тестирует вместе с агентом, оставляет в базе план, результат и новые факты. Эти знания доступны всем QA команды двумя путями:
-
через веб-интерфейс MKP, где есть ИИ-чат по всей базе знаний: можно просто спросить «как мы проверяли X» и получить ответ с источниками;
-
через MCP, когда агент сам находит нужное ещё до того, как QA успел спросить.
Чем больше команда тестирует, тем умнее становятся её агенты.
Что дальше
-
Автотесты. Skills генерации автотестов из статьи про Swagger начнут брать из базы тестовые данные и предусловия: какую когорту, карту или магазин можно использовать на контуре и что не так с моками.
-
Разбор падений. Агент из прошлой статьи начнёт смотреть в базу до того, как заводить дефект. Если коллега уже выяснил, что эта ошибка — проблема данных, а не бэкенда, ложного бага в Трекере не будет.
-
Качество базы. Хотим регулярно гонять агента-библиотекаря: он склеивает дубли в wiki, помечает устаревшее и проверяет, что факты всё ещё подтверждаются.
-
Разработчики и аналитики. Сейчас базы команд наполняют и читают в основном QA. Хотим подключить к ним разработчиков и аналитиков: там уже копится то, что нужно всей команде.
Короткий итог
MKP – платформа баз знаний с умным поиском, MCP и правами на каждую базу. Сама по себе она хороший инструмент. А вместе с ИИ-агентом, который пишет в неё по ходу работы, получается общая память тестирования.
QA больше не нужно отдельно «документировать опыт». Он тестирует, агент помогает ему и складывает всё узнанное в базу. Следующий QA начинает не с нуля, а с того места, где остановился предыдущий. А события от наших внутренних инструментов показывают, кто и как часто ими пользуется и сколько на самом деле занимает тест задачи с ИИ.
Отдельное спасибо инженерам @Van1eo и @fenixnow, которые создают и развивают MKP. И @anton_verbi, нашему QA Lead: он придумал и сделал первую версию QA-кита, чтобы облегчить себе тестирование своих задач, и до сих пор остаётся самым активным пользователем MKP.
Автор: Tanki_sleva

