


Когда запросы к LLM приходят лишь несколько раз в день, GPU большую часть времени простаивает, но платить за ноду приходится круглосуточно. Хочется освобождать карту между запросами: удалять поды с моделью, когда нагрузки нет, и запускать их снова, когда она появляется. Для обычного веб-приложения такая схема работает с задержкой в несколько секунд, и это вполне допустимо. LLM же после запуска пода нужно загрузить веса и прогреть движок, поэтому первый запрос может ждать ответа несколько минут.
В июле команда H Company рассказала, что новая реплика их крупнейших моделей выходила в готовность до 27 минут. Команда использует vLLM на GPU-нодах Kubernetes и добавляет реплики по мере роста нагрузки от агентов. Автоскейлер быстро увеличивает число подов, но дальше начинаются скачивание образа, загрузка весов, компиляция и прогрев движка. Ускорить эти этапы настройками масштабирования не получится.
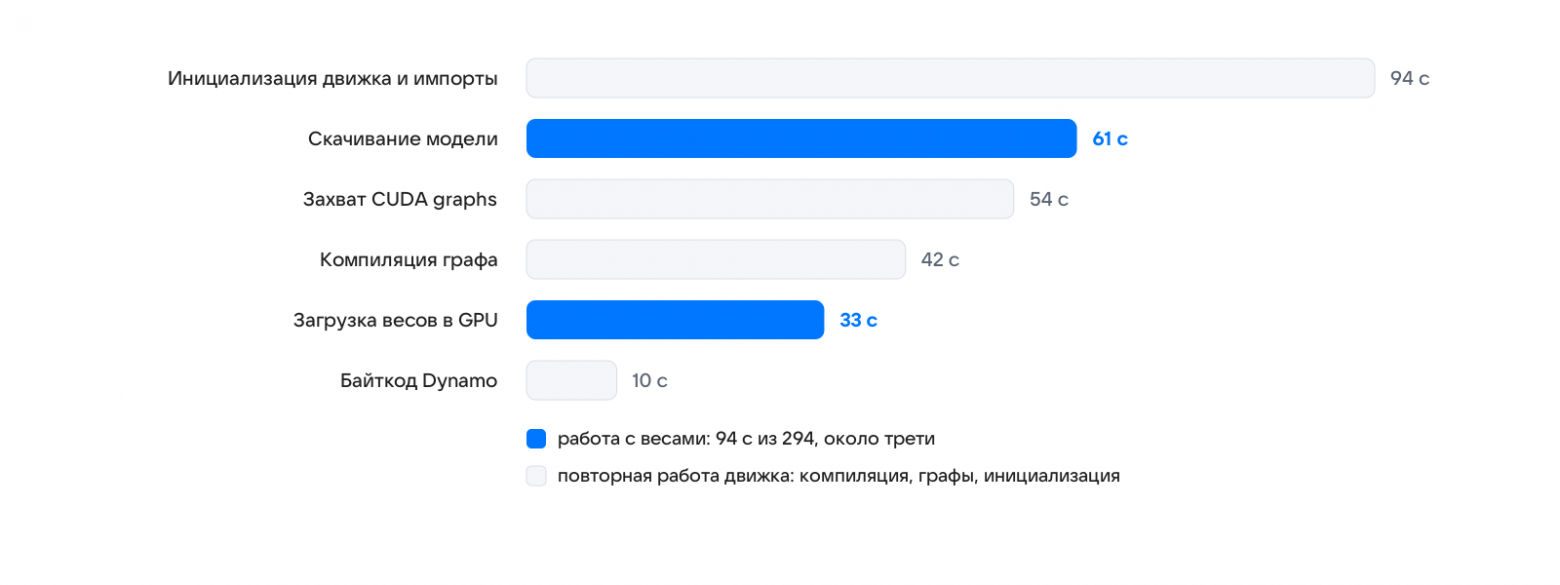
Я ожидал, что большую часть времени занимает загрузка весов, и решил посмотреть публичные замеры. У Tensorfuse запуск Llama 3.1 8B на L40S занял 294 секунды, из которых на скачивание модели и перенос весов в GPU ушло только 94. Остальные 200 секунд потребовались на компиляцию, захват CUDA graphs, инициализацию движка и импорты. Значительную часть этой работы новый под повторяет при каждом старте, хотя её результаты можно сохранить на ноде.
В статье разберём, как настроить запуск LLM из нуля и сократить холодный старт: откуда KEDA получает сигнал о нагрузке, пока подов нет, что стоит заранее закэшировать и какие таймауты позволят первому запросу дождаться модели. На публичных замерах посмотрим, сколько времени дают эти оптимизации, а затем перейдём к манифестам KEDA HTTP Add-on, DaemonSet для предзагрузки и настройкам vLLM. Это поможет платформенным инженерам оценить, подходит ли такой режим их нагрузке или лучше оставить тёплую реплику.
Откуда брать сигнал для запуска модели
Метрики GPU кажутся естественным выбором для автомасштабирования LLM, но определить спрос по ним сложно:
-
Утилизация показывает, какую долю времени карта занята. При непрерывном батчинге она может держаться около 100% при разной нагрузке.
-
Занятая видеопамять не отражает число запросов: vLLM заранее резервирует память под веса и KV-кэш — по умолчанию 90%.
-
Очередь vllm:num_requests_waiting доступна на /metrics только после запуска vLLM. Когда подов нет, эта метрика не поможет их запустить.
Поэтому сигнал для запуска модели нужно получать там, где запросы видны и без работающих подов, — на прокси или шлюзе перед моделью.
Когда подов с моделью нет, запрос принимает прокси или шлюз перед сервисом. Он видит нагрузку и может передать автоскейлеру сигнал для запуска реплики, а затем дождаться её готовности и отправить ей запрос.
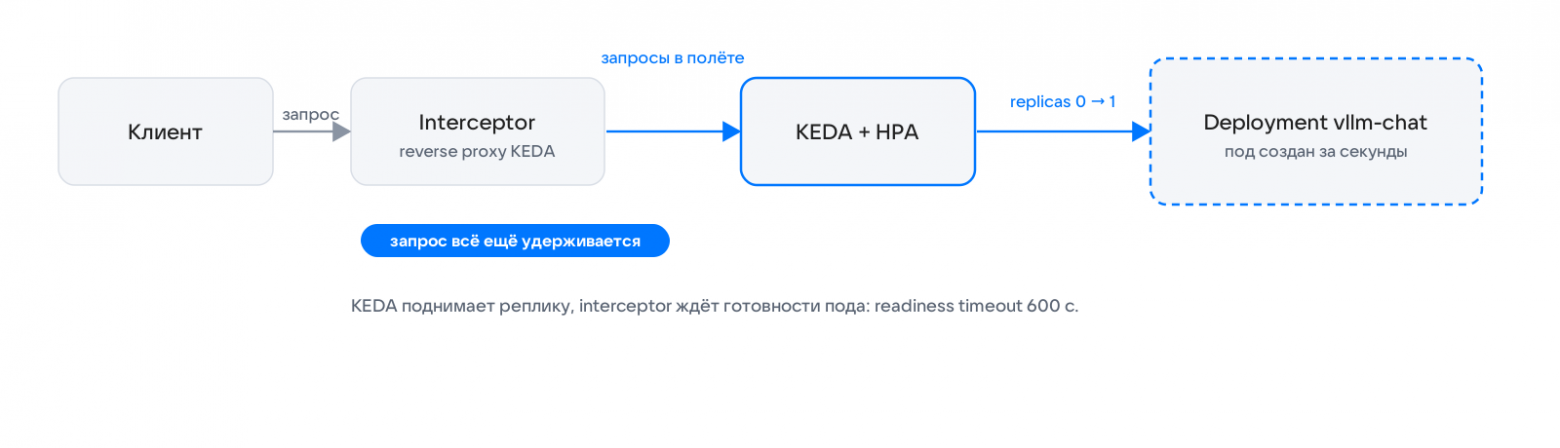
В KEDA HTTP Add-on эту задачу выполняет interceptor — обратный прокси, который считает запросы в обработке и передаёт метрики KEDA. Пока модель запускается, он удерживает запросы у себя. Сам Add-on пока находится в статусе beta, что стоит учесть перед использованием в продакшене.
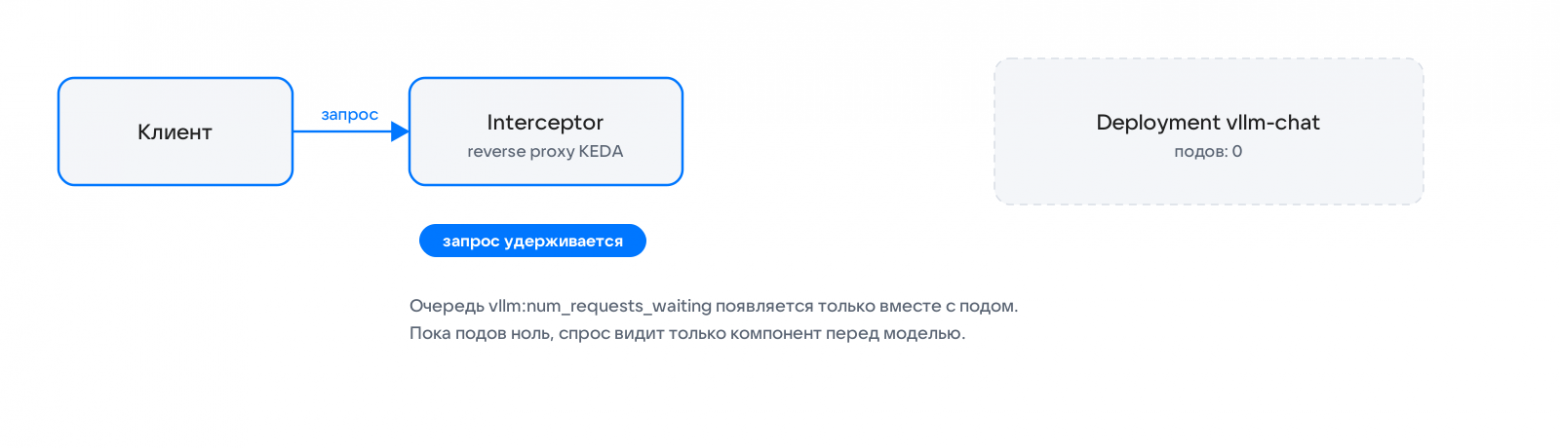
Запуск проходит в пять шагов:
-
Interceptor сопоставляет запрос с маршрутом и учитывает его в метрике.
-
Скейлер обнаруживает трафик и сообщает KEDA о нагрузке.
-
KEDA увеличивает число реплик Deployment с нуля до одной или нескольких.
-
Когда хотя бы один под готов принимать запросы, interceptor передаёт ему удержанный запрос.
-
Ответ возвращается через interceptor.
Маршрут задаётся ресурсом InterceptorRoute. Для модели с долгим стартом здесь особенно важны таймауты и ограничение числа ожидающих запросов:
apiVersion: http.keda.sh/v1beta1
kind: InterceptorRoute
metadata:
  name: llm-chat
  namespace: llm
spec:
  target:
    service: vllm-chat
    port: 8000
  rules:
    - hosts:
        - llm.example.internal
  scalingMetric:
    concurrency:
      targetValue: 16        # запросов в полёте на реплику
  timeouts:
    readiness: 600s          # сколько ждать готовности пода из нуля
    responseHeader: 120s     # без учёта ожидания холодного старта
    request: 900s            # весь запрос, включая генерацию
  coldStart:
    maxPendingRequests: 200
    overflow: Reject         # сверх лимита сразу 503
Параметр readiness определяет, сколько interceptor ждёт готовности бэкенда. Если модель не успела запуститься, он возвращает 504 или перенаправляет запрос на резервный обработчик, если тот настроен. Порог в 16 запросов на реплику я взял из гайда llm-d как начальное значение.
Каждый ожидающий запрос занимает соединение и буферы, поэтому всплеск нагрузки во время запуска модели может исчерпать память interceptor. В примере очередь ограничена 200 запросами; остальные получают 503. Вместо ошибки можно настроить заглушку.
Ресурс ScaledObject связывает масштабирование с маршрутом и разрешает удалять все реплики:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: llm-chat
  namespace: llm
spec:
  scaleTargetRef:
    name: vllm-chat
  minReplicaCount: 0
  maxReplicaCount: 4
  cooldownPeriod: 1800       # полчаса тишины перед уходом в ноль
  advanced:
    horizontalPodAutoscalerConfig:
      behavior:
        scaleUp:
          policies:
            - type: Pods
              value: 1
              periodSeconds: 300   # не больше одного нового пода за 5 минут
  triggers:
    - type: external-push
      metadata:
        scalerAddress: keda-add-ons-http-external-scaler.keda:9090
        interceptorRoute: llm-chat
По умолчанию cooldownPeriod равен 300 секундам. Для модели, которая запускается несколько минут, я увеличиваю его до получаса: иначе короткая пауза в нагрузке приведёт к удалению реплик, а следующий запрос снова будет ждать холодного старта. Добавление реплик ограничено одним подом за пять минут, чтобы первый всплеск не запустил сразу все четыре.
В llm-d сигнал о нагрузке поступает от Endpoint Picker — компонента шлюза, который выбирает реплику для запроса. KEDA читает его метрики из Prometheus: число запросов в обработке или длину очереди. Оба варианта поддерживают запуск при нуле реплик, поскольку метрики собираются перед моделью.
Долгий старт усложняет и дальнейшее масштабирование. Пока новые реплики загружают модель, HPA продолжает видеть неудовлетворённый спрос и может добавить лишние поды. В llm-d для сглаживания используют окна стабилизации по 300 секунд, но подбирать их нужно с учётом длительности своего холодного старта.
Таймауты тоже зависят от времени запуска и должны последовательно увеличиваться:
-
readiness— дольше холодного старта модели, с запасом на медленные запуски. -
request— дольше readiness плюс время генерации. -
Таймаут ingress или балансировщика перед interceptor — дольше
request. -
Клиентский таймаут — дольше всех предыдущих.
Самому vLLM нужно дать достаточно времени на запуск. Для этого задают startupProbe, иначе liveness-проба может перезапустить процесс ещё во время загрузки весов:
startupProbe:
  httpGet:
    path: /health
    port: 8000
  periodSeconds: 10
  failureThreshold: 60       # до 10 минут на старт
На что уходят 294 секунды запуска
Я ожидал, что холодный старт LLM почти целиком уходит на загрузку весов: модель занимает десятки гигабайт, которые нужно скачать и перенести в видеопамять. На этом фоне остальные этапы казались несущественными, пока я не посмотрел замер Tensorfuse для Llama 3.1 8B на L40S, где время каждой фазы измерили отдельно.
|
Фаза |
Время, с |
|
Скачивание модели |
61 |
|
Загрузка весов в GPU |
33 |
|
Байткод Dynamo |
10 |
|
Компиляция графа |
42 |
|
Захват CUDA graphs |
54 |
|
Инициализация движка и импорты |
94 |
|
Итого |
294 |
На скачивание модели и загрузку весов здесь ушло 94 секунды из 294 — около трети общего времени. Остальные 200 секунд заняли компиляция, захват CUDA graphs, инициализация движка и импорты.
Одна модель на одной карте могла оказаться частным случаем, поэтому я посмотрел ещё один замер. Route179 запускал Qwen3.6-35B-A3B в квантовании NVFP4 с локального NVMe на vLLM v0.22.1. Холодный старт занял 317 секунд: 142 на веса, 39 на torch.compile, 136 на профилирование и прогрев. На загрузку весов снова ушло меньше половины времени.
В разборе H Company запуск реплики разделён на четыре этапа:
-
Скачивание образа vLLM из реестра.
-
Доставка весов на ноду.
-
Инициализация движка и перенос весов в GPU.
-
Прогрев: захват CUDA graphs и JIT-компиляция ядер.
Скачивание образа с новым тегом добавляло к запуску около двух с половиной минут. Время доставки весов росло вместе с размером модели: от минуты для 27B почти до 11 минут для 397B в FP8. У модели 35B прогрев занимал до 58% всего старта, главным образом из-за JIT-компиляции DeepGEMM для FP8.
Если вместе с подами удаляются и GPU-ноды, перед запуском модели придётся дождаться ещё и создания ноды. По оценке ScaleOps, это добавляет от 60 до 120 секунд.
При каждом пересоздании пода запускается новый процесс, которому снова нужны те же веса, скомпилированный граф и CUDA graphs для тех же размеров батча. Я начал с поиска способов ускорить загрузку весов, но по замерам стало видно, сколько времени уходит на повторную работу движка.
Часть этой работы можно не выполнять заново. Компиляция зависит от архитектуры модели, типа данных, GPU и версий vLLM и PyTorch, но не от значений весов. Образ остаётся прежним до обновления, веса — до следующего релиза модели. Почти всё, что под делает при запуске, детерминировано.
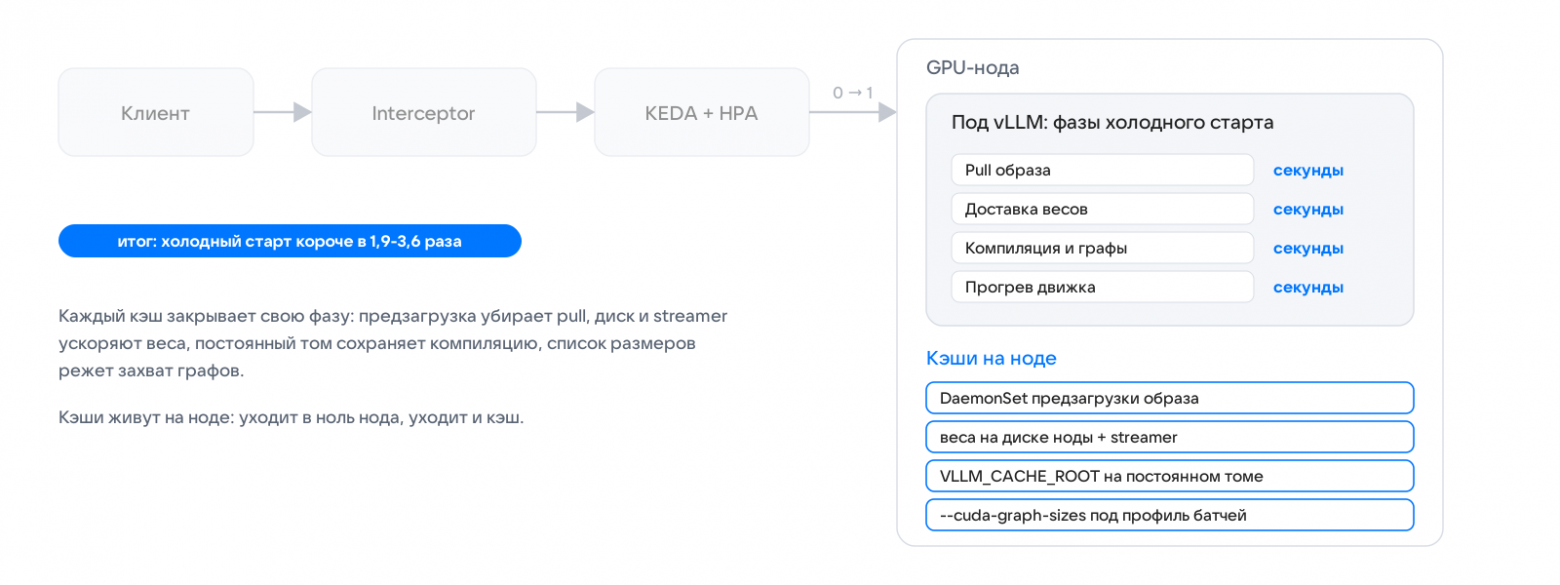
Если сохранить доступные для повторного использования результаты на ноде, следующему поду не придётся заново скачивать те же данные и выполнять ту же компиляцию. Здесь и появляется возможность сократить холодный старт: автоскейлер запускает реплику, а кэш уменьшает объём работы до её готовности.
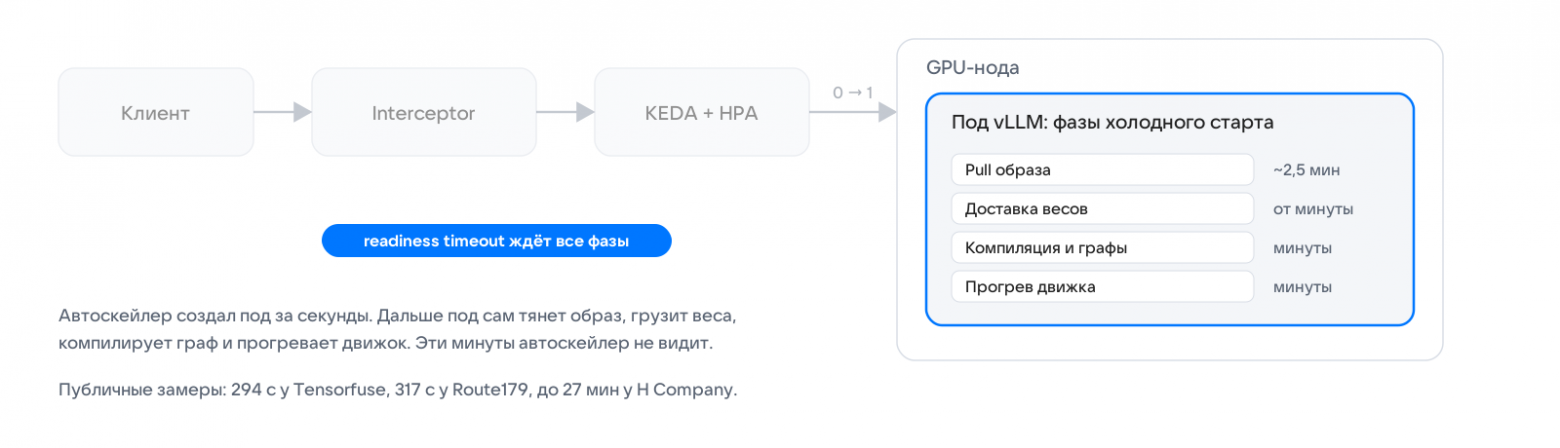
Получилось, что в разобранных публичных замерах веса занимают от трети до половины холодного старта. Остальное время уходит на скачивание образа, компиляцию, захват CUDA graphs, инициализацию и прогрев движка.
S3-совместимое объектное хранилище в облаке
Масштабируйте хранилище под любой объём данных и подключайте через стандартный S3 API без изменений в коде
Кэш на ноде
Начнём с того, что можно подготовить до запуска пода: заранее скачать образ и веса, а результаты компиляции сохранить между перезапусками. Разберём эти этапы по порядку, а затем посмотрим, как сократить время захвата CUDA graphs.
Образ
Kubelet скачивает образ, когда под назначен на ноду. Если нужного тега vLLM на ней ещё нет, модель начнёт запускаться только после скачивания. H Company вынесла этот этап в DaemonSet: init-контейнеры заранее загружают нужные образы на каждую GPU-ноду, а контейнер pause оставляет под работающим. Такая предзагрузка сократила среднее время холодного старта примерно на 2 минуты 25 секунд.
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: vllm-image-prepull
  namespace: llm
spec:
  selector:
    matchLabels:
      app: vllm-image-prepull
  template:
    metadata:
      labels:
        app: vllm-image-prepull
    spec:
      nodeSelector:
        nvidia.com/gpu.present: "true"
      tolerations:
        - key: nvidia.com/gpu
          operator: Exists
          effect: NoSchedule
      initContainers:
        - name: vllm
          image: vllm/vllm-openai:<тег-из-вашего-deployment>
          command: ["sh", "-c", "true"]   # только чтобы образ лёг на ноду
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.10
          resources:
            requests:
              cpu: 10m
              memory: 32Mi
Для предзагрузки ещё одного образа добавьте init-контейнер в initContainers. Метки и taint GPU-нод нужно подставить из своего кластера. До запуска модели проверьте, что образ уже скачан: выполните crictl images на ноде или найдите событие Pulled в выводе describe пода предзагрузки.
Веса
Загрузку весов можно ускорить двумя способами: заранее разместить их на диске ноды и читать параллельно. По умолчанию загрузчик читает файлы safetensors последовательно. В замере Route179 на локальном NVMe скорость чтения в один поток составила около 1,2 ГБ/с, а при параллельном чтении — почти 10 ГБ/с.
Run:ai Model Streamer читает тензоры в несколько потоков и сразу передаёт их на GPU. В vLLM он включается параметром --load-format. Сам пакет нужно заранее установить в образ, чтобы не тратить на установку время при запуске пода:
FROM vllm/vllm-openai:<тег>
RUN pip install --no-cache-dir runai-model-streamer runai-model-streamer-s3
В аргументах запуска vLLM задаём загрузчик и число потоков:
args:
  - --model=/models/chat-model
  - --load-format=runai_streamer
  - '--model-loader-extra-config={"concurrency":8}'   # для S3 и сетевых томов — больше
В этом примере веса хранятся в /models на диске ноды. Их заранее загружает DaemonSet предзагрузки или init-контейнер при первом запуске.
NVIDIA проверяла такой загрузчик на Llama 3 8B объёмом 15 ГБ с одной A10G. На диске GP3 время переноса весов в GPU сократилось с 48 до 14 секунд, после чего скорость упёрлась в пропускную способность диска. На более быстром IO2 загрузка заняла 7,5 секунды вместо 47 — примерно в шесть раз меньше.
Полное время до готовности vLLM на GP3 сократилось с 66 до 35 секунд. У Route179 загрузка весов ускорилась со 142 до 59 секунд.
Значение concurrency нужно подбирать под хранилище: увеличение числа потоков помогает лишь до тех пор, пока не исчерпана его пропускная способность. На локальном NVMe у Route179 прирост прекратился на восьми потоках.
У крупных моделей с тензорным параллелизмом, которые занимают ноду целиком, загрузку дополнительно усложняет число GPU-воркеров: каждый из них может скачивать полную копию весов, перегружая сеть ноды. H Company распределила чтение между восемью картами и сократила доставку весов модели 397B с 11 до 3,4 минуты. После этого скорость ограничивали сеть и NVLink.
Компиляция
По умолчанию vLLM сохраняет кэш torch.compile внутри контейнера. При пересоздании пода кэш теряется, и движку приходится компилировать всё заново. Чтобы сохранить результаты между запусками, нужно задать каталог через VLLM_CACHE_ROOT и подключить постоянный том на ноде. В примере используется hostPath, но он не допускается профилем Pod Security baseline, поэтому в продакшене его заменяют на local PersistentVolume.
env:
  - name: VLLM_CACHE_ROOT
    value: /cache/vllm
volumeMounts:
  - name: node-cache
    mountPath: /cache
volumes:
  - name: node-cache
    hostPath:
      path: /var/lib/llm-cache      # локальный диск ноды
      type: DirectoryOrCreate
У Route179 с сохранённым кэшем время компиляции сократилось с 39 до 10 секунд. Актуальность кэша движок проверяет сам: если изменились модель, версия vLLM или GPU, хэш не совпадёт и компиляция выполнится заново. H Company использовала общий кэш компиляции FP8 и получила ускорение прогрева в 4–5 раз.
После настройки проверьте, что кэш действительно переживает пересоздание пода: удалите под, дождитесь готовности нового и сравните время компиляции в логах vLLM с первым запуском. При повторном использовании кэша оно должно сократиться в разы.
CUDA graphs
По умолчанию vLLM захватывает CUDA graphs для широкого набора размеров батча. В замере Tensorfuse на это ушло 54 секунды. Когда набор ограничили размерами под реальную нагрузку, время захвата сократилось до 7 секунд.
vllm serve /models/chat-model --cuda-graph-sizes 1 2 4 8 16 24 32 64Сокращение набора может снизить пропускную способность: батчи, для которых графы не захвачены, будут обрабатываться без них.
Насколько кэш сокращает холодный старт
Кэш на ноде помогает, пока сама нода существует. Если пул GPU-нод уменьшается до нуля, новая нода запускается с пустым диском. Например, Karpenter удаляет последнюю ноду вместе с её кэшем, поэтому первый под на новой ноде снова проходит полный холодный старт. Для такого сценария образ и веса стоит заранее включить в образ ноды или разместить на сетевом томе, а кэш компиляции сделать общим для реплик, как у H Company.
|
Замер |
Модель и железо |
До |
После |
Что включили |
|---|---|---|---|---|
|
Llama 3.1 8B, L40S |
294 с |
82 с |
кэш модели и компиляции на томе, размеры CUDA graphs |
|
|
Qwen3.6-35B-A3B NVFP4, NVMe |
317 с |
167 с |
streamer, кэш компиляции |
|
|
Llama 3 8B, A10G, GP3 |
66 с |
35 с |
streamer |
|
|
Qwen3.5 397B-A17B FP8 |
до 27 мин |
в 3 раза быстрее холодный, до 12 раз тёплый |
предзагрузка образа, стриминг весов, общий кэш компиляции |
|
|
модель класса 70B |
42 мин |
около 1 мин |
кэш весов и предзагрузка через Fluid |
У Tensorfuse, Route179 и NVIDIA время холодного старта сократилось в 1,9–3,6 раза. NetEase получила гораздо больший выигрыш — с 42 минут примерно до минуты, но в исходном замере веса читались из хранилища в другом регионе.
После этих оптимизаций значительную часть старта всё ещё могут занимать профилирование и прогрев движка. У Route179 на них осталось 98 секунд из 167. Предзагрузка убирает ожидание скачивания образа, параллельное чтение ускоряет загрузку весов, постоянный кэш сокращает компиляцию, а ограничение размеров CUDA graphs — захват графов. Вместе они заметно ускоряют запуск, но у крупных моделей он всё равно может занимать минуты.
Спящий процесс vLLM
В vLLM есть режим сна — sleep mode, который освобождает видеопамять, сохраняя работающий процесс. На первом уровне сна веса переносятся в оперативную память, на втором — выгружаются полностью. Аллокатор, CUDA graphs и скомпилированные ядра сохраняются, поэтому при пробуждении движку не приходится готовить их заново.
Пробуждение с первого уровня занимает 0,1–0,8 секунды у малых моделей и 3–6 секунд у крупных. В замере переключения моделей со вторым уровнем сна среднее время составило около 2,6 секунды против примерно 48 секунд при полном перезапуске. Сохранение процесса даёт выигрыш, которого трудно добиться одним кэшированием на ноде.
Но в Kubernetes спящий процесс остаётся в поде, за которым по-прежнему закреплён GPU. Даже если веса перенесены в оперативную память, планировщик не может отдать карту другой нагрузке, а нода остаётся в пуле. Видеопамять освобождается, но само по себе это не позволяет отказаться от занятой GPU-ноды.
Выбор зависит от допустимой задержки первого ответа. Пользовательскому чату, который должен отвечать за секунды, нужна тёплая реплика или спящий процесс. Удаление всех подов освобождает карту между запросами, но следующий запрос может ждать запуска модели несколько минут. Такой режим подходит фоновым агентам, внутренним инструментам, ночной обработке и моделям, к которым обращаются несколько раз в день.
Если такое ожидание допустимо, нужно измерить время запуска своей модели. Публичные замеры дают ориентир, но таймауты зависят от вашего GPU, хранилища и версии vLLM.
Как измерить свой холодный старт
Как измерить свой холодный старт
Чтобы подобрать readiness timeout, нужно измерить время от запуска пода до его готовности, включая самые медленные запуски. Для этого пригодятся три инструмента:
-
Команда
vllm bench startupзапускает серии холодных и тёплых стартов. Число повторов задаётся флагами--num-iters-coldи--num-iters-warm. -
Трейсинг запуска через OpenTelemetry, который добавила H Company, позволяет разобрать время по этапам: загрузка весов, компиляция, захват графов и прогрев отображаются отдельными спанами.
-
События пода показывают время от его создания до состояния
Ready. По этим замерам оценивают медленные запуски и выбираютreadinesstimeout.
При сравнении с публичными результатами учитывайте версии движка и инструментов: от них тоже зависит время запуска.
|
Источник |
Движок и инструменты |
|
NVIDIA |
vLLM 0.5.5, Run:ai Model Streamer 0.6.0 |
|
Tensorfuse |
Образ |
|
H Company |
vLLM 0.19.1 в исходном замере |
|
Route179 |
vLLM v0.22.1 |
|
Interceptor |
KEDA HTTP Add-on 0.16 |
Как перейти к запуску модели по запросу
Каждое удаление последней реплики означает, что следующий запрос будет ждать запуска модели. Прежде чем включать такой режим, стоит проверить, насколько часто он позволит освобождать GPU и какой задержкой придётся за это платить.
-
Измерьте холодный старт до оптимизаций. Запустите серию тестов через
vllm bench startupи по событиям пода проверьте время от его создания доReady. Эти результаты понадобятся для сравнения после каждого изменения. -
Подключите KEDA HTTP Add-on, оставив
minReplicaCount: 1. В течение недели понаблюдайте за метриками interceptor: как часто паузы в нагрузке превышаютcooldownPeriod. -
Настройте кэши на ноде: предзагрузку образа через DaemonSet, хранение весов на локальном диске и постоянный том для
VLLM_CACHE_ROOT. После каждого изменения повторяйте замеры и проверяйте по логам, сколько времени удалось сэкономить на соответствующем этапе. -
Настройте таймауты по измеренному p99 холодного старта:
readinessдолжен покрывать запуск с запасом, а каждый следующий таймаут — быть длиннее предыдущего. Только после этого устанавливайтеminReplicaCount: 0. -
Если модель должна отвечать за секунды, попробуйте sleep mode вместо удаления подов. Сравните стоимость занятой карты со стоимостью тёплой реплики.
Что учесть перед отключением последней реплики
У крупнейшей модели H Company холодный старт до оптимизаций занимал почти полчаса. При интервале опроса в 15 секунд, как в гайде llm-d, автоскейлер за это время успевает проверить нагрузку больше сотни раз. Ускорение его реакции мало поможет, пока модель тратит минуты на загрузку и подготовку движка.
Чтобы запускать LLM по запросу, сигнал о нагрузке нужно получать перед моделью — на interceptor или шлюзе, который работает и при отсутствии подов. Дальше время ожидания зависит от того, что удалось подготовить заранее: скачать образ и веса, сохранить результаты компиляции, ограничить набор CUDA graphs. В разобранных замерах эти меры сокращали холодный старт в 1,9–3,6 раза, но не всегда позволяли уложиться в секунды. Поэтому таймауты нужно выбирать по собственным измерениям: readiness — выше p99 холодного старта, request — с дополнительным запасом на генерацию.
Для фоновых агентов и редко используемых моделей несколько минут ожидания могут быть приемлемой ценой за освобождение GPU между запросами. Чату, который должен отвечать за секунды, понадобится тёплая реплика или sleep mode с сохранением процесса. Выбор начинается с допустимой задержки первого ответа: именно она определяет, можно ли удалять последнюю реплику.
У нас в VK Cloud GPU-ноды подключаются к Managed Kubernetes в Cloud Containers с изоляцией задач и автомасштабированием. Описанную схему можно собрать на них из открытых компонентов: KEDA, vLLM и кэша на локальном диске ноды.
Какой readiness timeout стоит у вас и на каких замерах он основан? Расскажите в комментариях.
Автор: GRADDATA

