


Представим обычную задачу: нужно расширить покрытие REST API автотестами. Сейчас с такими задачами справляются ИИ-агенты: изучают существующий код, добавляют необходимые методы клиента, пишут тестовые сценарии и возвращают готовую реализацию. На первый взгляд все отлично. Тесты написаны, код аккуратный, а pytest успешно собирает новые проверки. Но означает ли это, что задача действительно выполнена? Не обязательно.
Например, агент может проверить, что при некорректном запросе API возвращает HTTP 400, но не проверить структуру тела ошибки. Или убедиться, что запрос на удаление Git-тега завершился успешно, но не проверить, исчез ли тег из самого репозитория. Формально тесты есть. Возможно, они даже проходят. Но насколько им можно доверять? С этой проблемой я столкнулся, когда начинал активно делегировать ИИ-агентам разработку автотестов.
В этой статье я покажу, как получилось организовать работу по методологии Specification-Driven Development (SDD), через фреймворк OpenSpec с помощью специализированных ИИ-агентов. Разберу реальные задачи по тестированию REST API и расскажу, почему успешный запуск тестов еще не означает, что тест не фигня.
Материал преимущественно для тех, кто на «ты» с API, Python, pytest, тест-дизайном и базово использует ИИ-агентов, но еще не разобрался с организацией работы через спецификации (SDD, OpenSpec), многоагентную оркестрацию и разделение ролей.
Я QA-инженер в Cloud.ru и еще недавно на выполнение одной задачи по тестированию у меня уходило примерно полдня. Причем речь не о четырех часах непрерывного написания кода: в течение дня постоянно возникают другие задачи, созвоны, срочные вопросы от коллег и кофе-брейки. Приходится переключаться и снова восстанавливать контекст.
С появлением ИИ-агентов я практически перестал самостоятельно писать код автотестов. Но довольно быстро понял, что просто передать задачу агенту недостаточно. Если требования сформулированы неточно, агент может написать технически корректные тесты, которые проверяют не то поведение. А если проверять результат только успешным запуском pytest, часть таких проблем останется незамеченной.
Поэтому вместо одного агента, которому я поручаю написать тесты, постепенно появился целый процесс: Specification-Driven Development (SDD), OpenSpec, отдельные агенты для планирования, реализации и ревью, а также дополнительные механизмы проверки качества.
В результате изменилось не только то, кто пишет код, но и моя роль в автоматизации. Теперь я больше времени уделяю требованиям, рискам, проектированию проверок и анализу результата. По моим приблизительным оценкам, похожая задача может занимать около часа-полутора вместо половины рабочего дня. При этом часть работы агента выполняется параллельно с другими моими задачами.
Почему нельзя просто поручить агенту написать тесты
Кажется, что, работать с ИИ-агентом довольно просто: получаем задачу от разработки, понимаем требования, описываем их для агента, просим написать автотесты и запускаем их. Если тесты зеленые, код выглядит архитектурно правильно, то задачу можно считать выполненной.
На практике все немного сложнее.
ИИ-агенты действительно уже неплохо справляются с написанием кода. Они могут изучить существующий фреймворк, разобраться с архитектурой, найти похожие тесты и реализовывать новые сценарии по существующим паттернам. Но проверять он может вообще не то, что мы от него ожидаем.
Приведу пример из собственной практики. У меня на проекте есть функциональность публикации структуры документации в Git-репозторий. Если при повторной публикации из структуры удаляется секция, соответствующий файл тоже должен удалиться из репозитория.
Агент написал тест test_update_structure_removes_orphan_doc_file. Сценарий выглядел вполне логично:
-
Опубликовать структуру с двумя секциями:
overviewиsetup. -
Повторно опубликовать структуру, но уже без
setup. -
Клонировать Git-репозиторий.
-
Убедиться, что файла
setupбольше нет.
Выглядит правильно: мы проверяем не просто ответ API, а реальное состояние Git-репозитория после выполнения операции. Однако, агент упустил важную деталь: перед удалением он ни разу не проверял, что файл setup действительно существовал в Git. Наличие документа подтверждалось через REST-метод get_repowiki_docs(), однако, этот метод может возвращать метаданные документа, не обращаясь непосредственно к содержимому Git-репозитория.
Получается, если из-за ошибки при первой публикации файл setup вообще не появился в Git, тест все равно мог успешно пройти. Ведь после повторной публикации файла действительно не было. Только вот бизнес-правило удаления в таком случае вообще не проверялась. Получается, что тест проверял конечное состояние системы, но не подтверждал исходное. А без этого невозможно достоверно проверить сам переход из состояния «файл существует» в состояние «файл удален».
Самое интересное, что агент-разработчик не обнаружил эту проблему даже во время самопроверки. Он пытается оценить, способен ли тест обнаружить ошибку, но ограничился анализом его логики, не выполняя экспериментальных проверок. Проблему обнаружил другой ИИ-агент — ревьювер. После исправления в тесте появился дополнительный шаг с repowiki_repo_clone() as clone_before. Теперь перед повторной публикацией проверяется, что файл физические существует в Git-репозитории. И только после этого выполняется удаление и проверяется конечное состояние.
Подобные ситуации хорошо показывают, почему недостаточно просто делегировать агенту написание тестов. Нужны понятные требования, критерии приемки и отдельный механизм проверки результата. К такому подходу я пришел постепенно, когда начал использовать Specification-Driven Development (SDD) и OpenSpec.
Вместо того чтобы сразу отправлять агента писать код, я сначала поручаю отдельному агенту исследовать задачу, подготовить спецификацию и план реализации. Затем проверяю их сам, и только после этого начинается разработка тестов. При этом написание тестов — только один из этапов. Весь процесс, от исследования задачи до проверки результата, я разделил между несколькими специальными агентами.
Как устроен многоагентный процесс
На практике начинается все так: я открываю Claude Code и передаю главному агенту номер задачи из Jira. Мне не нужно самостоятельно запускать каждого агента, расписывать последовательность действий или вручную переносить результаты между ними. За это отвечает главный агент — оркестратор.
Откуда он знает, кого запускать и какие действия выполнять? В репозитории есть файл CLAUDE.md, в котором описаны правила работы, доступные специализированные агенты и зоны их ответственности.
Сейчас в моем процессе участвуют четыре основных агента. Чтобы было понятнее, как оркестратор распределяет работу, приведу сокращенный фрагмент конфигурации из CLAUDE.md:
|
Агент |
Skill |
Ответственность |
|
test-planner |
opsx:propose |
Исследование, создание change |
|
test-qa-writer |
opsx:apply |
Реализация тестов по tasks.md |
|
test-reviewer |
opsx:archive |
Ревью, заключение, handoff |
|
docs-writer |
wiki-native-style |
Актуализация документации |
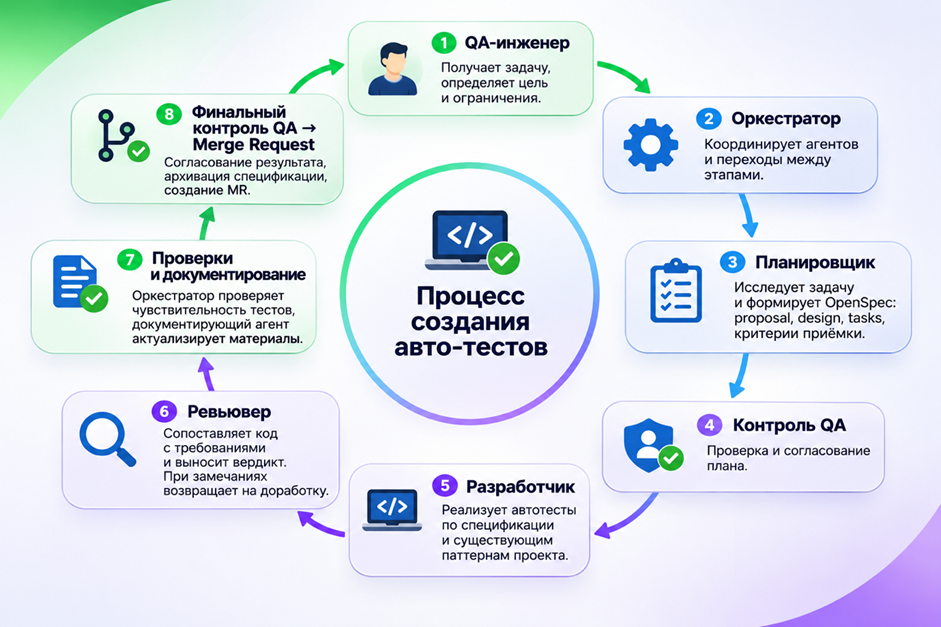
Помимо ролей, в конфигурации описаны правила перехода между этапами, используемые skills и условия, при которых требуется мое подтверждение. При этом наличие opsx:archive у ревьювера не означает автоматическую архивацию после его вердикта. Оркестратор сначала передает мне заключение и запрашивает решение о дальнейших действиях.
От задачи к спецификации
Допустим, разработчик передал мне задачу на исправление дефекта в API. Я отправляю ее номер оркестратору и прошу подготовить автоматизированное покрытие.
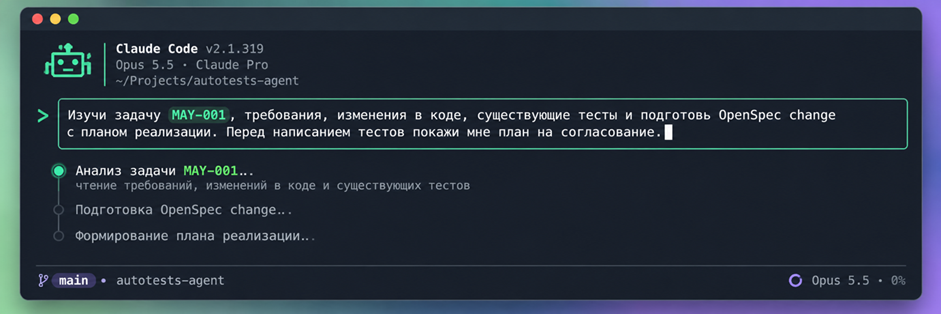
Первый в работу вступает test-planner. Он исследует задачу, изучает существующие тесты, архитектуру фреймворка и доступную документацию. При необходимости обращается к Jira и другим источникам контекста. Его цель — не написать код, а разобраться, какое поведение необходимо проверить и как лучше встроить новые тесты в существующий фреймворк. Для этого планировщик использует OpenSpec и создает отдельный change — набор артефактов, описывающих предстоящие изменения.
Основные файлы, с которыми я работаю:
-
proposal.md — зачем нужны изменения, какую проблему они решают и что затрагивают.
-
design.md — технический подход к реализации, принятые решения и ограничения.
-
task.md — конкретные шаги реализации, по которым агент-разработчик будет выполнять работу.
После завершения работы в change также сохраняются результаты проверки и заключение ревьювера. Например, так выглядит структура одной из уже архивных задач:
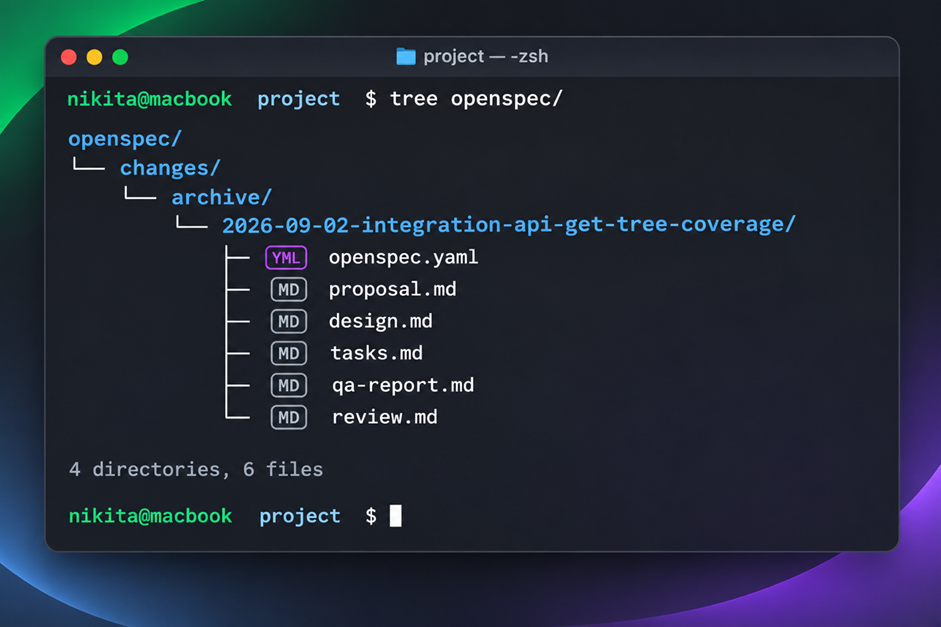
qa-report.md содержит результаты QA-проверок, а review.md — заключение по реализации. Таким образом, в репозитории сохраняется не только первоначальный план, но и информация о том, как оценивался результат.
После подготовки планировщик валидирует change через openspec validate strict <slug>. Но даже успешная валидация спецификации не означает, что план автоматические принимается. На этом этапе подключаюсь я: изучаю предложенные сценарии, проверяю, правильно ли агент понял задачу, нет ли пропущенных случаев и соответствует ли решение архитектуре тестового проекта. Если возникают вопросы по бизнес-логике, уточняю их у разработчиков. Если вижу недостатки в плане, возвращаю его на доработку. Только после согласования начинается реализация.
От спецификации к автотестам
Следующий участник процесса — test-qa-writer. Он получает подготовленный OpenSpec change и реализует тесты, ориентируясь на task.md, требования и существующие паттерны фреймворка.
Здесь важно, что агенту не приходится каждый раз заново интерпретировать исходную задачу из Jira. У него уже есть согласованный план, технические ограничения и критерии, по которым будет оцениваться результат. По мере выполнения работы агент отмечает завершенные пункты в task.md, а затем приводит самопроверку реализации. Однако, как показал пример из предыдущего раздела, самопроверки исполнителя недостаточно. Агент может не заметить собственную ошибку, даже если внимательно анализирует написанный код. Поэтому следующим этапом становится отдельное ревью.
Ревью и решение о дальнейших действиях
После реализации оркестратор передает результат агенту test-reviewer. Его задача — проверить, насколько написанные тесты соответствуют спецификации, соблюдены ли архитектурные договоренности и действительно ли проверки способны обнаружить заявленные дефекты. Ревьювер анализирует код и артефакты OpenSpec, формирует замечания и выносит заключение. При этом он не выполняет тесты самостоятельно: его проверка основана на анализе реализации и требований. Здесь есть интересный нюанс: разработчик и ревьювер могут использовать одну и ту же языковую модель. Разделение ролей само по себе не делает проверку полностью независимой, но позволяет оценить результат с другой позиции и по другим критериям. Именно такой ревьювер обнаружил проблему с проверкой удаления файла setup, о которой рассказывал выше. После завершения ревью оркестратор возвращается ко мне с заключением и предлагает определить дальнейшие действия. Если замечания обоснованы, реализация отправляется на доработку. Если возникают спорные моменты, я дополнительно изучаю их и при необходимости уточняю требования. Если результат меня устраивает, разрешаю переходить к следующим этапам.
Получается, что агент-ревьювер не принимает окончательное решение за меня. Он предоставляет информацию, на основании которой я могу принять решение. Для меня это одна из ключевых особенностей процесса: я делегировал агентам значительную часть инженерной работы, но не передал им ответственность за итоговое качество.
Проверки, документация и Merge Request
После согласования реализации работа еще не заканчивается. Необходимо убедиться, что тесты не только соответствуют спецификации, но и корректно ведут себя при выполнении. Для этого предусмотрены реальные прогоны тестов и дополнительные проверки их чувствительности к ошибкам. Например, можно намеренно изменить ожидаемое значение в утверждении и проверить, что тест действительно обнаруживает расхождение. Это не полноценное мутационное тестирование реализации сервиса, а дополнительные способ проверить, насколько осмысленно работают написанные утверждения. Подробно этот механизм я разберу отдельно, поскольку у него есть свои ограничения.
После необходимых проверок и моего подтверждения можно завершать работу с OpenSpec change: архивировать спецификацию и передавать результаты следующему агенту. За актуализацию документации отвечает docs-writer. Он получает информацию о выполненных изменениях и обновляет затронутые страницы документации проекта. Финальным этапом становится подготовка Merge Request с реализованными автотестами.
В результате у задачи остается не только код, но и история принятых решений: зачем понадобились изменения, какие сценарии планировались, что было реализовано и какие замечания возникали во время проверки. При этом описанная последовательность — не жесткий конвейер. Для небольших задач отдельные этапы могут быть избыточными, поэтому процесс можно упростить. Главное — не потерять требования и контроль результата.
Что остается мне
На схеме может показаться, что большую часть работы теперь выполняют агенты. В определенном смысле так и есть, по крайней мере, если говорить непосредственно о написании кода. Но моя роль не сводится к тому, чтобы передать номер задачи и дождаться готового Merge Request. Мне по-прежнему необходимо понимать требования, оценивать риски, определять достаточность покрытия. Просто теперь я трачу больше времени на проектирование и проверки, а не на непосредственную реализацию каждого теста. Кроме того, пока агенты работают с кодом, я могу заниматься другими задачами: ручным, нефункциональным тестированием, анализом дефектов. Именно это изменение для меня оказалось важнее простой экономии времени. Но пока все описанное выглядит как достаточно абстрактная схема. Поэтому дальше предлагаю разобрать конкретную задачу и посмотреть, какие спецификации подготовили агенты, какие тесты написали и что получилось в результате.
Практика: как агенты покрывали CRUD тегов
До этого момента я рассказывал преимущественно об устройстве процесса. Но одно дело — нарисовать схему с несколькими агентами, и совсем другое — посмотреть, как она работает на реальной задаче.
В качестве примера возьму задачу по расширению REST API для работы с Git-тегами. Здесь требовалось добавить создание и удаление тегов, а также расширить ответ существующего метода получения списка тегов. На момент постановки задачи у меня уже было три автотеста для GET /tags. Они проверяли наличие тегов в списке, пустой список и обращение к несуществующему репозиторию. При этом проверки ограничивались полем name. Для POST /tags и DELETE /tags автоматизированного покрытия вообще не существовало. Задача выглядела вполне стандартно: изучить контракт API, расширить клиент, подготовить фикстуры и написать позитивные и негативные сценарии. Но именно здесь хорошо проявились преимущества и ограничения моего подхода.
Что предложил планировщик
Я передал оркестратору задачу, после чего он запустил tests-planner. Агент исследовал существующее покрытие, изучил контракт API и подготовил OpenSpec change test-may-001-tags-crud. Первое, что мне понравилось в результате планирования, — агент не ограничился перечислением методов, которые нужно покрыть. Он разделил работу на несколько направлений: расширение моделей ответа, добавление методов клиента, подготовка тестовых данных, позитивные сценарии, негативные проверки и контроль фактического состояния Git-репозитория.
Например, для удаления тега было недостаточно проверить, что API вернул 204 No Content. Планировщик предусмотрел проверку отсутствия тега не только в последующем ответе GET /tags, но и непосредственно в Git через git ls-remote. Это важная деталь. Если API использует кэш или возвращает неактуальные данные, проверка только через другой REST-метод может дать ложное представление о состоянии репозитория.
## What Changes

### GET /tags — получение списка тегов

Расширить существующее покрытие GET /tags:

- Проверить полный набор полей ответа:
  `name`, `commit`, `message`, `author`, `date`.
- Для annotated-тега проверить данные автора тега (tagger).
- Для lightweight-тега проверить использование автора
  целевого коммита.
- Убедиться, что `commit` содержит SHA целевого коммита,
  а не SHA объекта тега.
- Проверить наличие созданных тегов в списке.

### POST /tags — создание тега

Добавить тесты создания Git-тегов:

- 201 — успешное создание lightweight- и annotated-тегов.
- 409 — повторное создание тега с существующим именем.
- 400 — несуществующая целевая ревизия.
- 400 — некорректные входные данные и превышение лимитов.
- 404 — несуществующий репозиторий или репозиторий
  другого проекта.
- 401 — запрос без авторизации.

### DELETE /tags — удаление тега

Добавить тесты удаления Git-тегов:

- 204 — успешное удаление существующего тега.
- Проверить отсутствие удалённого тега в GET /tags
  и в Git через `git ls-remote`.
- 404 — удаление несуществующего тега.
- 404 — повторное удаление того же тега.
- 404 — несуществующий репозиторий.
- 400 — некорректное имя тега.

### Ограничения окружения

На текущем dev-стенде невозможно надёжно проверить:

- 403 — отклонение операции Git-хуком.
- 409 — конкурентное обновление Git-ссылки.
- 403 — запрет операции для роли ниже Developer.

Эти сценарии необходимо зафиксировать как ограничения
покрытия, не подменяя полноценные проверки имитациями.
В task.md агент разложил реализацию на конкретные шаги. Например, для создания тега нужно было проверить создание lighweight- и annotated-тегов, повторное использование имени, несуществующую целевую ревизию, ограничения длины полей и работу без авторизации.
Для удаления — успешную операцию, повторное удаление, несуществующий тег, некорректные входные данные и ограничения доступа. При этом планировщик отдельно отметил сценарии, которые сложно воспроизвести на доступном тестовом стенде: отказ Git-хука, конкретное обновление ссылки и некоторые разграничения прав. И это тоже часть планирования. Недостаточно просто перечислить все возможные проверки — нужно понимать, какие из них действительно можно автоматизировать в имеющемся окружении.
От плана к реализации
После согласования спецификации оркестратор передал работу test-qa-writer. Агент расширил модель Tag, добавил методы создания и удаления тегов в REST-клиент, подготовил необходимые фикстуры и реализовал тестовые сценарии.
В результате покрытие распределилось по трем модулям:
-
test_content_tags.py — получение списка тегов и проверка дополнительных полей.
-
test_content_create_tag.py — создание тегов, валидация и негативные сцеарии.
-
test_content_delete_tag.py — удаление тегов и проверка результата операции.
В финальной версии pytest собирал 30 тестовых сценариев с учетом параметризации: четыре для GET, восемнадцать для POST и восемь для DELETE. При этом часть GET-покрытия существовала до начала работы — агент расширил его, а не создавал с нуля.
Один из показательных сценариев — успешное удаление Git-тега. Здесь агент не ограничился проверкой HTTP-статуса 204 No Content. Сначала тест создает тег через API, затем удаляет его и проверяет результат двумя способами: через GET /tags и непосредственно через Git. Ниже — сокращенная версия реального теста, убрал Allure-оформление.
def test_delete_tag_success(
    repo_client: RepoClient,
    content_repo: ContentRepo,
    tag_factory: TagFactory,
) -> None:
    # Arrange: создаём lightweight-тег через API
    name = f"autotest-del-{uuid4().hex[:8]}"
    repo_id = content_repo.info.id
    tag_factory(repo_id, name, content_repo.readme_sha, "")

    # Act: удаляем тег
    response = repo_client.delete_tag(
        repository_id=repo_id,
        name=name,
    )

    # Assert: проверяем ответ API
    assert response.status_code == HTTPStatus.NO_CONTENT
    assert response.text == ""

    # Assert: тег отсутствует в REST API
    listing = repo_client.get_tags(repository_id=repo_id)
    tags = ResponseValidator.validate(
        listing.json(), TagList, response=listing,
    ).tags
    assert all(tag.name != name for tag in tags)

    # Assert: тег отсутствует в Git
    remote_tags = content_repo.git.remote_tags()
    assert name not in remote_tags
В этом примере важно не количество утверждений, а то, что результат проверяется с разных сторон. HTTP-статус подтверждает успешную обработку запроса, GET /tags проверяет пользовательское представление данных, а Git — фактическое состояние репозитория. На первый взгляд все выглядело готовым. Но дальше началось самое интересное.
Первое ревью — REJECT
После реализации тестов к работе приступил test-reviewer. И здесь процесс не завершился успешным вердиктом с первого раза. Ревьювер обнаружил пять замечаний: два Major, три Minor. Итоговый вердикт — REJECT.
Самые существенным замечанием стала проверка негативных сценариев. Агент-разработчик проверял ожидаемые HTTP-статусы и отдельные фрагменты сообщений об ошибках. Но этого было недостаточно для полноценной проверки контракта API: структура тела ответа не валидировалась через существующие Pydantic-модели. Получилась ситуация, в которой тест мог подтвердить статус 400 или 409, но не обнаружить нарушение структуры ответа. Ревьювер потребовал использовать уже существующий в проекте ResponseValidator и модели ошибок. Причем не создавать новые модели под фактические ответы сервиса, а разобраться, какие структуры действительно предусмотрены и где именно возникают расхождения.
Второе Major-замечание касалось OpenAPI. План и отчет уже содержали информацию о несовпадении задокументированной и фактической формы некоторых ошибок 400, но это расхождение требовалось оформить отдельно от найденного дефекта продукта.
Были и менее критичные замечания: недостающая проверка эквивалентности отсутствующего и пустого message, обработка специальных Git-ссылок при получении тегов и противоречие в описании источников проверки.
## Code Review — REJECT

**Результат:** 2 Major / 3 Minor

### Major

1. [MAJOR] Неполная проверка ошибок API

   Негативные тесты проверяют HTTP-статус и фрагменты

   текста ошибки, но не валидируют тело ответа по

   существующим Pydantic-моделям ErrorResponse и

   ValidationErrorsResponse.

2. [MAJOR] Не задокументировано расхождение с OpenAPI

   Спецификация описывает для HTTP 400 только

   ValidationErrorsResponse, хотя некоторые ошибки

   Git-операций возвращаются как ErrorResponse.

   Необходимо зафиксировать расхождение в QA-отчёте.

### Minor

3. [MINOR] Пропущен acceptance criterion

   Нет теста, подтверждающего эквивалентность

   отсутствующего поля message и пустой строки.

4. [MINOR] Некорректная обработка Git-ссылок

   GitClient.remote_tags() не исключает peeled-refs

   с суффиксом ^{}, возвращаемые для annotated-тегов.

5. [MINOR] Противоречие в QA-отчёте

   Описание источника анализа найденного дефекта

   расходится с утверждением о подтверждённой

   первопричине в коде продукта.

**Вердикт: REJECT**

Требуется устранить замечания и повторить ревью.
Этот случай показал, что разделение ролей работает не только на уровне организации процесса. Ревьювер действительно смог обнаружить недостатки реализации и вернуть ее на доработку. Правда, такая проверка все еще не является полностью независимой: оба агента могут использовать одну и ту же языковую модель.
А что с дефектами самого API
Параллельно с проверкой качества тестов обнаружилось расхождение в поведении API. При создании тега с некорректными Git-именами, например .. или именем с суффиксом .lock, сервис возвращал 409 Conflict, хотя для некорректных входных данных ожидается 400 Bad Request. Здесь важно было не исправить тест под фактический ответ сервиса, а сохранить ожидаемое поведение. Поэтому соответствующие сценарии были отмечены через pytest.mark.xfail, а найденные расхождения зафиксированы как дефект.
Отдельно обнаружилось несоответствие OpenAPI: задокументированная структура некоторых ответов с ошибкой 400 отличалась от фактической. Это уже другая проблема — не ошибка бизнес-логики, а расхождения между документацией и реализацией.
Получилось, что в рамках одной задачи агенты помогли не только расширить покрытие, но и обнаружить проблемы самого API. При этом важно было не смешивать дефекты продукта с недостатками написанных автотестов.
Доработка и повторное ревью
После первого REJECT замечания были переданы обратно агенту-разработчику. Он доработал негативные проверки, добавил валидацию ответов через Pydantic-модели, реализовал недостающий сценарий с message и исправил вспомогательный метод работы с Git-тегами. Затем последовало повторное ревью.
На этот раз test-reviewer перепроверил все пять замечаний непосредственно по коду. В отчете зафиксировано, что они устроены, а новых проблем не обнаружено. Итоговый вердикт — APPROVE. Но здесь есть важная оговорка: одобрение от агента не заменяет реального выполнения тестов и просмотра написанного кода лично мной.
В моем случае прогоны против dev-стенда выполнял я. Агент мог проверить структуру кода, собрать тесты через pytest — collect-only, запустить линтер и проанализировать результат, но подтвердить поведение API в доступном окружении нужно было отдельно.
Кроме обычного прогона, я проверял чувствительность тестов к ошибкам. Для этого намеренно изменялись некоторые ожидаемые значения в утверждениях, после чего тесты запускались повторно. Это полезная дополнительная проверка, но она не доказывает правильность всей тестовой логики. Тест может реагировать на измененное утверждение и при этом по-прежнему проверять не то бизнес-правило. Пример с удалением файла setup из второго раздела как раз демонстрирует это ограничение.
Что получилось в результате
В финальном состоянии задача дала не просто набор тестов. Были расширены клиент и модели API, реализовано покрытие создания, получения и удаления тегов, добавлены проверки негативных сценариев, фактического состояния Git-репозитория и история принятых решений. При этом удалось обнаружить дефект в обработке некорректных имен тегов и отдельно зафиксировать неточность OpenAPI.
Некоторые сценарии, связанные с Git-хуками, конкурентным обновлением и ограничением прав, остались вне автоматизированного покрытия.
Здесь я заметил ещё одну полезную особенность SDD: спецификации продолжают приносить пользу даже после завершения задачи. Но об этом — дальше.
Спецификация как инженерная память
Когда я только начинал использовать OpenSpec, то воспринимал его прежде всего как инструмент для подготовки технического задания агенту. Планировщик формирует требования, агент-разработчик пишет по ним тесты, ревьювер проверяет результат. После завершения работы спецификация отправляется в архив, а задача закрывается. Но со временем я обратил внимание ещё на одну полезную особенность такого подхода.
В обычной работе после завершения задачи у нас остаются код, Merge Request и, возможно, комментарий в Jira. Этого достаточно, чтобы понять, что было изменено. Но далеко не всегда достаточно, чтобы разобраться, почему были приняты именно такие решения. Почему здесь проверяется фактическое состояние Git-репозитория, а не только ответ API? Почему определенный сценарий отсутствует в автотестах? Почему тест помечен xfail, хотя его можно было бы просто исправить под текущее поведение сервиса? Ответы на эти вопросы не всегда очевидны из самого кода.
В случае с CRUD тегов после завершения задачи в OpenSpec остались не только первоначальные требования и план реализации. Сохранились результаты проверок, замечания ревьювера, информация о найденных дефектах и ограничения автоматизированного покрытия.
Например, в предыдущем разделе я рассказывал, что часть сценариев, связанных с Git-хуками, конкурентным обновлениями и разграничением прав, не удалось автоматизировать на доступном стенде. Если посмотреть только на итоговые тесты, можно решить, что эти сценарии просто забыли. Но в спецификации зафиксировано, что они рассматривались, а также почему не вошли в реализованное покрытие. И это уже полезный инженерный контекст.
Представим, что через несколько месяцев появится задача расширить покрытие операции с Git-тегами. Мне или другому QA не обязательно начинать исследование с чистого листа. Можно вернуться к архивному change, посмотреть первоначальные требования, ограничения и результат ревью, а затем определить, что из этого по-прежнему актуально. То же самое относится к агентам. Вместо того чтобы каждый раз заново восстанавливать логику проекта только по исходному коду, они могут использовать сохраненные артефакты как дополнительные источник контекста.
Правда, здесь есть важное ограничение: наличие спецификации в репозитории еще не означает, что агент автоматические найдет ее, правильно интерпретирует и применит. Для этого нужны соответствующие инструкции и механизм поиска релевантных материалов. Кроме того, спецификация не становится истиной только потому, что она сохранена в Markdown.
Код развивается, требования меняются, а документация может устаревать. Поэтому архивированные спецификации я рассматриваю прежде всего как историю требований и принятых решений на момент выполнения задачи, а не как гарантированно актуальное описание текущего поведения сервиса. В дальнейшем мне хочется развивать этот подход в сторону Docs as Code: обновлять документацию вместе с изменениями в коде и добавить проверки, которые будут помогать обнаруживать расхождениями между ними.
Для меня это логичное продолжение SDD. Спецификация нужна не только для того, чтобы агент однажды написал правильные тесты. Она может помогать сохранять знания о проекте и передавать их между задачами, инженерами и агентами.
В итоге OpenSpec стал для меня не только инструментом управления агентами, но и способом сохранять инженерные решения. Агенты могут меняться, задачи закрываются, код переписываться, но история того, почему мы приняли определенное решение, остается в репозитории. Главное — не путать эту историю с гарантированно актуальной документацией.
Как убедиться, что ИИ не написал бесполезные тесты
Когда агент закончил писать автотесты, возникает вполне закономерный вопрос: а как убедиться, что они действительно проверяют то, что нужно?
Вроде запускаем pytest, получаем зеленый результат и считаем задачу выполненной. Но, как показал пример с удалением файла setup из второго раздела, успешно проходящий тест еще не означает, что он способен обнаружить нужный дефект. Поэтому в моем процессе появилось несколько уровней проверки результата.
Ревью — первая линия защиты
Первый уровень — отдельный агент test-reviewer. Его задача не просто проверить стиль написания кода, а сопоставить реализацию с требованиями и критериями приемки, который были сформированы на этапе планирования.
Ревьювер изучает артефакт OpenSpec, написанные тесты и изменения в репозитории. Он проверяет, все ли обязательные сценарии реализованы, насколько корректно используются существующие фикстуры и клиенты, нет ли нарушений архитектурных договоренностей и действительно ли утверждения соответствуют ожидаемому поведению сервиса.
В качестве примера можно вспомнить задачу с CRUD Get-тегов. Агент-разработчик реализовал тесты, но первое ревью закончилось вердиктом REJECT. Среди замечаний были недостаточно строгие проверки негативных сценариев: тесты проверяли HTTP-статус и отдельные поля сообщения об ошибке, но не валидировали структуру ответа через существующие Pydantic-модели. После замечаний реализация вернулась на доработку, и только повторное ревью завершилось APPROVE.
Однако, здесь есть ограничения. Ревьювер — тоже ИИ-агент. Более того, в моем случае разработчик и ревьювер могут использовать одну и ту же языковую модель. Разделение ролей позволяет посмотреть на результат с другой позиции, но не делает проверку полностью независимой.
И еще один важный момент: ревьювер не запускает тесты самостоятельно. Его заключение основано на анализе кода и требований. Поэтому APPROVE означает, что реализация прошла этот этап проверки, а не то, что корректность тестов уже доказана.
Реальный запуск и работа с xfail
Следующий уровень — выполнение тестов на доступном стенде.
Здесь я проверяю уже не только то, насколько убедительно выглядит код, но и как он взаимодействует с реальным API. Это позволяет обнаружить проблемы, которые сложно заметить при статическом анализе: ошибки в фикстурах, неверные предположения о формате ответа, особенности состояния тестовых данных и реальные дефекты сервиса.
Отдельно хочу остановиться на xfail.
При работе с агентами есть риск, что обнаруженное расхождение между ожидаемым и фактическим поведением они попытаются устранить изменением самого теста. Например, API возвращает некорректную структуру ответа, а агент подстраивает ожидаемые значения под то, что выдает сервис. В результате тест становится зеленым, но проверяет уже не исходное требование, а существующее поведение, которое может содержать дефект. Поэтому, если дефект подтвержден, я предпочитаю сохранять правильные ожидания и использовать pytest.mark.xfail(strict=True) с указанием причины.
Такой тест продолжает документировать ожидаемое поведение. Если тест падает, pytest отмечает его как XFAIL. Если неожиданно начинает проходить, результатом будет XPASS(strict), который считается ошибкой прогона. При этом важно самостоятельно убедиться, что падение действительно связано с известным дефектом.
Проверка чувствительности тестов
Есть еще один механизм, который я использую дополнительно к обычным прогонам.
Допустим, тест проверяет, что после удаления Git-тега его больше нет в репозитории:
assert tag_name not in remote_tagsПосле этого повторно запустить тест и убедиться, что он действительно реагирует на изменения утверждения.
В моем процессе такие проверки выполняются для отдельных значимых утверждений. Например, можно изменить ожидаемый статус ответа, инвертировать проверку наличия объекта или подменить ожидаемое значение поля. Если тест после такой модификации продолжает проходить, это повод разобраться, выполняется ли нужная проверка вообще и не скрывает ли проблему логика теста.
Важно не путать этот подход с полноценным мутационным тестированием. В классическом mutation testing изменения вносятся в тестируемую реализацию, после чего оценивается способность тестов обнаруживать внесенные ошибки.
Здесь же я намеренно изменяю утверждения самих автотестов. Это скорее локальная проверка их чувствительности, а не измерение качества покрытия через mutation score. И у этого механизма есть существенное ограничение.
Представим тест, которые проверяет удаление файла из Git-репозитория. Если до операции удаления файл вообще не был создан, проверка его отсутствия после удаления все равно может успешно пройти. Даже если инвертировать финальное утверждение и получить ожидаемое падение, это не докажет, что тест действительно проверяет бизнес-логику удаления. Он реагирует на изменение утверждения, но исходный сценарий по-прежнему может быть некорректным.
Именно такую проблему мы уже разбирали во втором разделе. Она хорошо показывает, почему проверки чувствительности не заменяют полноценный анализ тестового сценария.
Можно ли теперь доверять результату
В итоге у меня получается несколько последовательных проверок: сначала агент сопоставляет реализацию со спецификацией, затем я запускаю тесты на стенде, анализирую результаты и при необходимости дополнительно проверяю чувствительность отдельных утверждений.
Для меня задача этих механизмов — уменьшить вероятность пропуска ошибок и сделать результат более проверяемым. А решение о том, достаточно ли покрытие и можно ли принимать работу, по-прежнему остается за мной.
Где подход ломается
После предыдущих разделов может сложиться впечатление, что достаточно настроить несколько агентов, описать их обязанности в CLAUDE.md, добавить OpenSpec — и дальше система будет самостоятельно выполнять задачи, периодические обращаясь ко мне за подтверждением.
К сожалению, все не настолько просто. Даже при наличии спецификации, критериев приемки и отдельного этапа ревью агенты продолжаются ошибаться. Причем проблемы возникают не только при написании кода, но и при исследовании задачи, работе с инструментами и принятии решений.
Агент может выйти за пределы задачи
Одна из проблем, с которой я столкнулся — агенты не всегда правильно определяют границы доступного им контекста.
Например, при исследовании задачи агент самостоятельно начал обходить локальные директории и перешёл в репозиторий тестируемого сервиса. Он знал, где находится исходный код, и решил изучить реализацию API, хотя я не просил его этого делать. Задача заключалась в разработке автотестов, а не в исследовании внутреннего устройства сервиса.
На первый взгляд такое поведение даже кажется полезным: агент получает дополнительную информацию и может лучше разобраться в работе API. Но здесь возникает сразу несколько проблем. Во-первых, наличие технической возможности обратиться к исходному коду ещё не означает, что агенту разрешено это делать. Во-вторых, появляется риск, что тесты будут написаны под текущую реализацию, а не под ожидаемое поведение, описанное в контракте API.
Для меня это стало хорошим примером того, почему инструкции в CLAUDE.md не должны быть единственным механизмом контроля. Они помогают определить правило работы, но сами по себе не ограничивают доступ к файловой системе. Поэтому одно из направлений дальнейшего развития моей системы — ограничение доступных агентам директорий, инструментов и источников данных в соответствии с их задачами.
Спецификация тоже может быть неправильной
Второе ограничение связано с самим SDD.
Спецификация помогает отделить планирование от реализации, но не гарантирует, что требования были поняты правильно. Планировщик может неверно интерпретировать описание задачи, пропустить важный сценарий или сделать предложение о бизнес-логике, которое не соответствует действительности.
И если такая ошибка попадет в согласованный план, остальные агенты вполне способны последовательно ее воспроизвести. Агент-разработчик реализует тесты по спецификации. Ревьювер проверит их соответствует требованиям. Тесты могут успешно пройти. При этом вся цепочка будет опираться на изначальное неправильно предложение. Поэтому на этапе планирования я проверяю не только полноту сценариев, но и исходные предложения агента: откуда он получил требования, на какие существующие контракты описываются и какие решения принял самостоятельно. Если возникают неоднозначности, лучше уточнить их у разработчика до написания тестов, чем разбираться с последствиями уже после реализации.
Несколько агентов не означают несколько независимых мнений
Еще одно ограничение — независимость проверки. В моем процессе написанием тестов и ревью занимаются разные агенты. У каждого своя роль, инструкции и критерии оценки результата. Но разделение ролей не гарантирует независимость выводов, особенно если оба агента используют одну и ту же языковую модель.
Проблема в том, что у одной модели могут быть общие слепые зоны и характерные ошибки рассуждения. Представим, что агент-разработчик получил задачу проверить удаление Git-тега и ограничился проверкой HTTP-статуса 204 No Content. Если агент-ревьювер использует ту же LLM, он тоже может посчитать такую проверку достаточной и не заметить, что фактическое удаление тега из репозитория никак не подтверждено.
Получается, что два агента формально согласились друг с другом, но это согласие не доказывает корректность реализации. Ошибка может оказаться общей для обоих. Поэтому я стараюсь использовать связку из Sonnet + Оpus, есть теория, что сочетание классического трансформера и MoE может быть лучше, но практических данных, чтобы это утверждать у меня пока недостаточно, буду проверять.
Так что я не рассматриваю заключение ревьювера как окончательное подтверждение качества. Это дополнительный этап контроля, который помогает находить проблемы, но не заменяет реальные прогоны, анализ результатов и мою собственную проверку.
Автономность требует контроля
Наконец, не каждую задачу имеет смысл проводить через полный многоагентный процесс. Иногда задача небольшая, требования очевидны, а затраты времени на подготовку спецификации и несколько этапов проверки могут оказаться сопоставимыми с самой реализацией. В таких случаях процесс можно упростить. Бывают и противоположные ситуации: агенту не хватает контекста, требования противоречивы и для продолжения необходимо решение разработчика. Здесь попытка добиться полной автономности скорее увеличит количество ошибок, чем ускорит работу. Поэтому моя цель — не исключить человека из процесса, а определить, какие действия можно безопасно делегировать и в каких точках необходимо мое участие.
Для меня многоагентская система остается инженерным инструментом, а не самостоятельным QA-инженером. Она помогает выполнять работу, но ее надежность зависит от качества требований, ограничений доступа, механизмов проверки и решений человека, который управляет процессом.
Что изменилось для QA
Когда я только начинал использовать ИИ-агентов, то рассматривал их преимущественно как инструмент для ускорения написания автотестов. Получил задачу, передал ее агенту, получил готовый код — казалось бы, что еще нужно?
Постепенно я понял, что самое интересное изменение произошло не в скорости, а в том, чем я стал заниматься.
Раньше значительная часть моего времени уходила непосредственно на реализацию тестов: написание методов API-клиента, подготовка фикстур, работу с тестовыми данными, исправление ошибок и повторные запуски. Сейчас большую часть этой работы можно делегировать агентам.
При этом ответственность за качество продукта никуда не исчезла. Мне по-прежнему нужно разобраться в требованиях, определить риски, выбрать сценарии, оценить достаточность покрытия и убедиться, что тесты действительно проверяют ожидаемое поведение продукта. Просто теперь я уделяю больше внимания именно этим вопросам.
От написания тестов к проектированию проверок
На практике это выразилось в том, что теперь я начинаю работу над задачей с проектирования проверок, а не с написания тестового кода. Теперь, получая задачу, я в первую очередь думаю не о том, как написать тест на Python, а о том, что именно необходимо проверить, какие риски существуют и по каким критериям можно будет принять результат. Спецификация помогает зафиксировать эти решения до начала реализации. Агенты берут на себя подготовку кода, а ответственность за корректность требований и достаточность проверок остается за мной.
Значит ли это, что знание Python, pytest или устройства тестового фреймворка вдруг стало ненужным? Скорее наоборот: чтобы оценивать работу агента, нужно понимать, какие решения он принимает, и почему они могут оказаться неправильными.
Параллельная работа вместо последовательной
Еще одно важное изменение — возможность заниматься несколькими направлениями работы одновременно.
Пока агент реализует автотесты, я могу проверить изменения интерфейса, исследовать пользовательские сценарии, разобраться с падениями существующих тестов или заняться подготовкой релиза.
Раньше подобные задачи чаще приходилось ставить в очередь и проверять по одному. Теперь часть работы можно передать агентам и вернуться к ней на этапе согласования или проверки результата.
По моим наблюдениям, мое участие в выполнении сопоставимой задачи, включая планирование, согласование и проверку результатов, теперь может занимать примерно час-полтора. Это приблизительная оценка из моей практики, а не результат контролируемого измерения. К тому же задачи отличаются по сложности, поэтому напрямую сравнивать их не всегда корректно. Но для меня важнее другое: я могу использовать освободившееся время для задач, которые требуют моего непосредственного участия.
Что дальше
Пока я не считаю свой процесс окончательно сформированным. Есть несколько направлений, которые хочется развивать: безопасность, Docs as Code.
Отдельная задача — начать собирать метрики, которые позволят оценивать эффективность подхода не только по субъективным ощущениям. Например, учитывать время выполнения задач, количество итераций ревью, объем ручных доработок и дефектов, обнаруженных после реализации тестов.
Мне интересно понять не только то, насколько быстрее агенты помогают выполнять работу, но и то, как их использование влияет на качество конечного результата.
Вместо заключения
Я начинал с идеи делегировать ИИ написание автотестов, а в результате постепенно перестроил значительную часть своего рабочего процесса. Теперь у меня есть спецификации, специализированные агенты, этапы ревью и дополнительные механизмы проверки результата. При этом я не могу просто запустить оркестратор и считать задачу выполненной: агенты по-прежнему ошибаются, а их решения требуют контроля.
И, пожалуй, это главный вывод, к которому я пришел: ИИ-агенты не избавляют QA-инженера от необходимости думать о качестве. Они просто смещают точку приложения усилий с написания кода непосредственно на обеспечение качества. Хоть при этом я действительно стал гораздо реже писать автотесты самостоятельно.
Автор: Nottezz

