


Полная версия этой статьи на английском — у меня на сайте. Там оставил все таблицы, параметры экспериментов и подробности проверок; здесь некоторые разделы разобраны короче.
Это первая часть серии материалов, в которых мы проследим за одним единственным токеном от исходной строки до самого вывода. Здесь мы разберем всё, что происходит до того, как текст попадает в остаточный поток. Во второй части мы протащим этот сигнал сквозь слои внимания, а в третьей — вскроем блоки MLP.
Введение
Отправьте модели hello, deepseek — и она каждый раз будет отвечать на английском. Замените стандартную ASCII-запятую на полноширинную (hello,deepseek) — и в 94% случаев модель полностью забудет про английский и переключится на китайский, и это несмотря на то, что самый первый токен её внутренних размышлений в think-блоке всё ещё равен "Hello". Семантика промпта не изменилась ни на йоту, никаких хитрых обёрток для обхода защит не использовалось. Всё, что для этого понадобилось — один-единственный трехбайтовый знак препинания, который тихо и незаметно перехватил всю траекторию генерации модели.
Большинство споров о безопасности больших языковых моделей (LLM) крутится вокруг промптов: все обсуждают ролевые инструкции, системные промпты, защитные барьеры и прочую шелуху. Но задолго до того, как первый головной модуль внимания начнет считать запрос или активируется MLP, поведение модели и вся её поверхность атак предопределены на куда более тихом рубеже — входном слое. Именно здесь сырые строки Unicode режутся на целочисленные ID и сопоставляются со статическими строками в матрице входных эмбеддингов  .
В этой статье мы заглянем за эту границу. Вы увидите, как один невидимый символ протаскивает 180 токенов мимо защитного фильтра; почему знаменитая векторная арифметика вроде king - man + woman = queen в современных трансформерах — по большей части иллюзия; и почему наивное зондирование  нагло соврет вам, если вы поленитесь сделать базовые контрольные замеры. Нельзя защищать или интерпретировать систему, чью фундаментику вы воспринимаете как «черный ящик». Так что давайте разберем, что на самом деле происходит с промптом задолго до того, как он доберется до остаточного потока.
Входной слой
Прежде чем текст вообще попадет в слои трансформера, токенизатор превращает его в ID токенов, по которым выбираются строки из матрицы входных эмбеддингов  . Человек может видеть привычное ему слово, защитный фильтр сверху — проверять нормализованные символы, а сам токенизатор в этот момент выдаст совершенно дикую последовательность подслов, и этот разрыв представлений становится уязвимостью всякий раз, когда валидация на верхнем уровне расходится с тем, что модель и её окружение исполняют на нижнем.
Взять, к примеру, алгоритм Byte-Pair Encoding (BPE): построение словаря и подсчёт частот пар происходят исключительно на этапе обучения токенизатора. Когда мы кодируем новый запрос на лету, мы используем замороженный словарь и фиксированные ранги слияния — ведь новые слова на инференсе никто не учит. Стандартный байтовый токенизатор вроде библиотеки tiktoken отрабатывает классический четырехэтапный конвейер:
-
Предтокенизация входных данных. Регулярное выражение с поддержкой Unicode режет текст на крупные куски, чтобы будущие слияния BPE не смели перешагивать через эти границы.
-
Перевод каждого фрагмента в байты UTF-8. Байтовое представление позволяет проглотить любой валидный Unicode без паники и сваливания в токен неизвестного символа (
<unk>). -
Применение изученных рангов BPE. Внутри каждого куска кодировщик итеративно склеивает пары байтов по заранее заученным рангам. Частоты корпуса не пересчитываются, новые слова не добавляются.
-
Выдача ID токенов. Полученные подслова превращаются в целочисленные идентификаторы, которые напрямую индексируют матрицу входных эмбеддингов
 .
Даже самый первый шаг — регулярное выражение предтокенизатора — жестко задает правила группировки текста. Например, в реализации o200k_base из tiktoken под это дело выделено целых семь веток регулярных выражений, разделяющих буквы, сокращения, цифры, знаки препинания и пробелы.
А теперь посмотрите, как o200k_base режет на регулярные фрагменты три почти одинаковые строки:
'hello, world 1!'  # ['hello', ',', ' world', ' ', '1', '!']
'hello,world 1!'  # ['hello', ',world', ' ', '1', '!']
'hello,world 1!'   # ['hello', ',world', ' ', '1', '!']
Обратите внимание на структурный перекос: ведущий пробел может прилипнуть к следующему слову (' world'), в то время как пробел перед цифрой остается изолированным (' ', '1'). Вдобавок правило необязательного непрефиксного символа позволяет знакам препинания приклеиваться прямо к последующему слову (',world' или ',world'). Важно здесь то, что это лишь фрагменты для регулярки, а не финальные токены, т.е. BPE может дорезать ',world' дальше, но перескакивать границы этих фрагментов при слиянии ему строго запрещено.
И с точки зрения безопасности ключевой вопрос звучит так: согласованы ли проверки на верхнем уровне с тем, как текст видит модель? Если токенизация меняется, возникает разница представлений, а превращается она в обход защиты ровно в тот момент, когда защитный фильтр оценивает одно, а модель выполняет совсем другое.
Байтовые артефакты: как запятая превращается в токены
Заменим обычную однобайтовую ASCII-запятую , (U+002C, UTF-8 0x2C) на трехбайтовую полноширинную запятую , (U+FF0C, UTF-8 0xEF 0xBC 0x8C). Посмотрим, как строка 'hi,what is your name?' и её вариант выглядят в инспекторах токенов:
-
Обычная ASCII-запятая (
,):['hi', ',', 'what', 'Ġis', 'Ġyour', 'Ġname', '?'] -
Полноширинная запятая (
,; токенизатор склеивает три байта UTF-8 в один токен):['hi', 'ï¼Į', 'what', 'Ġis', 'Ġyour', 'Ġname', '?'] -
Полноширинная запятая в старом
r50k_base(где байты остались неслиянными):['hi', '�', '�', '�', 'what', 'Ġis', 'Ġyour', 'Ġname', '?']
Здесь важно не путать две вещи, которые часто сбивают с толку новичков:
-
Нотация печатаемых байтов (
Ġ,ï¼Į). В GPT-2 используется функцияbytes_to_unicode(), которая взаимно однозначно мапит все 256 значений байтов в печатные символы Unicode, чтобы BPE не ломался на управляющих символах. Так ASCII-пробел (0x20) превращается вĠ, а три байта полноширинной запятой отображаются какï¼Į. Когда токенизатор схлопывает эти три байта в один токен, отладчики показывают именно это. -
Частичная декодировка UTF-8 (
�). Один токен может содержать лишь кусок многобайтового символа. В третьем примере три байта полноширинной запятой остались отдельными токенами. При этом если визуализатор попытается декодировать каждый токен в UTF-8 по отдельности, он получит битые куски и выведет символ замены�, но если склеить их обратно целиком, получится нормальная запятая,— внутри модели ничего не портилось.
Байтовый резервный механизм гарантирует покрытие всего Unicode без падений в <unk>, но порождает асимметрию: компактный с виду текст может раздуться в гигантскую последовательность байтовых токенов. Разные токенизаторы решают эту проблему по-своему:
|
Свойство |
Байтовый BPE ( |
SentencePiece (зависит от конфига) |
|---|---|---|
|
Нормализация |
Обычно отсутствует (чистый UTF-8) |
Зависит от модели; по умолчанию часто |
|
Предтокенизация |
Границы задаются регулярными выражениями |
Работает с нормализованным текстом |
|
Пробелы |
Часто склеиваются с соседними словами; |
Обычный метасимвол ( |
|
Неизвестный Unicode |
Байтовый фоллбек (от 1 до 4 токенов на символ) |
Байтовый фоллбек или токен |
|
Границы |
Регулярки жестко тормозят слияния BPE |
Сегментация управляется удельным весом модели (unigram/BPE) |
Заметка на полях: почему категории Unicode не совпадают с границами токенов Допустим, защитный фильтр пытается вырезать пунктуацию по общим категориям Unicode. Категория
Po(Other Punctuation) сваливает в кучу ASCII-запятую,, полноширинную,, арабскую،и даже интерробанг‽. Есть загвоздка: принадлежность к одной категории Unicode не означает одинаковую «стоимость» в токенах, поскольку категории — это грубая классификация символов (UAX #44), а токены отражают сухую статистику байт в корпусе. Мы проверили все 640 символов категорииPoиз Unicode 16.0 черезtiktoken 0.14.0, кодируя каждый в одиночку:
В
r50k_baseровно 26 символов кодируются одним токеном, а 490 требуюттокенов.
В
cl100k_baseодним токеном кодируются 39, атокенов нужно для 455.
В
o200k_base— 71 и 422 соответственно.В том же
o200k_baseзапятые кодируются по одному токену, а вот‽требует двух,⸮— трех. При этом один токен запросто может «проглотить» символы из разных категорий. Например, вo200k_baseстрока');является единым токеном, хотя'и;— этоPo, а)— этоPe(Close Punctuation). Фильтры проверяют кодовые точки, а LLM жрет байтовые последовательности, следовательно любой защитный фильтр, завязанный на символьные классы, будет резать текст совсем иначе, чем модель.
Стекинг диакритических знаков («Zalgo») и раздувание токенов
Комбинируемые символы Unicode могут вертикально накладываться друг на друга поверх базовой буквы, порождая пропасть между визуальной длиной строки и количеством токенов. То, что на экране выглядит как один замусоренный глиф (один расширенный графемный кластер), внутри токенизатора может разложиться на сотни байтов и десятки токенов BPE.
Посмотрите, что происходит с токенизатором o200k_base, если к обычному промпту из 64 символов дописать всего один навороченный #-кластер:
-
До (чистый ввод): 64 символа → 10 токенов.
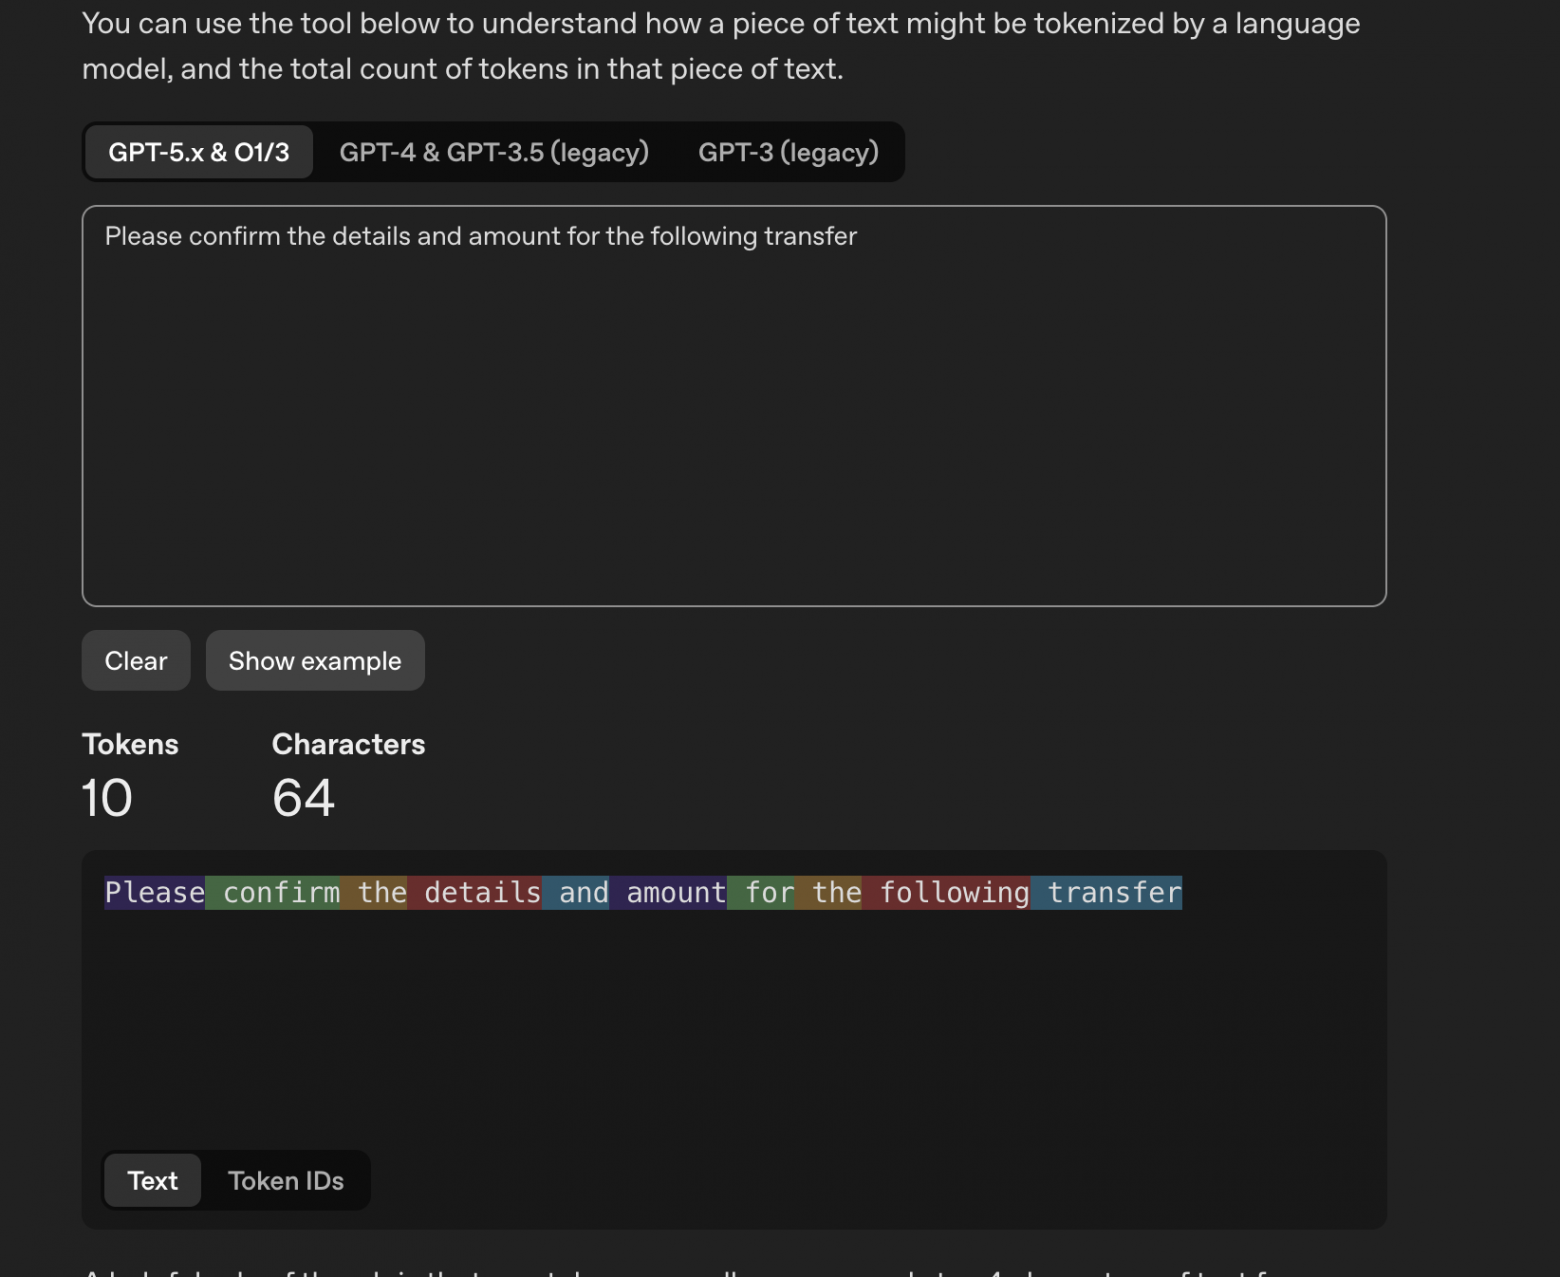
Чистый запрос: 10 токенов -
После (с пачкой диакритики и хвостовым
<): 160 символов → 189 токенов.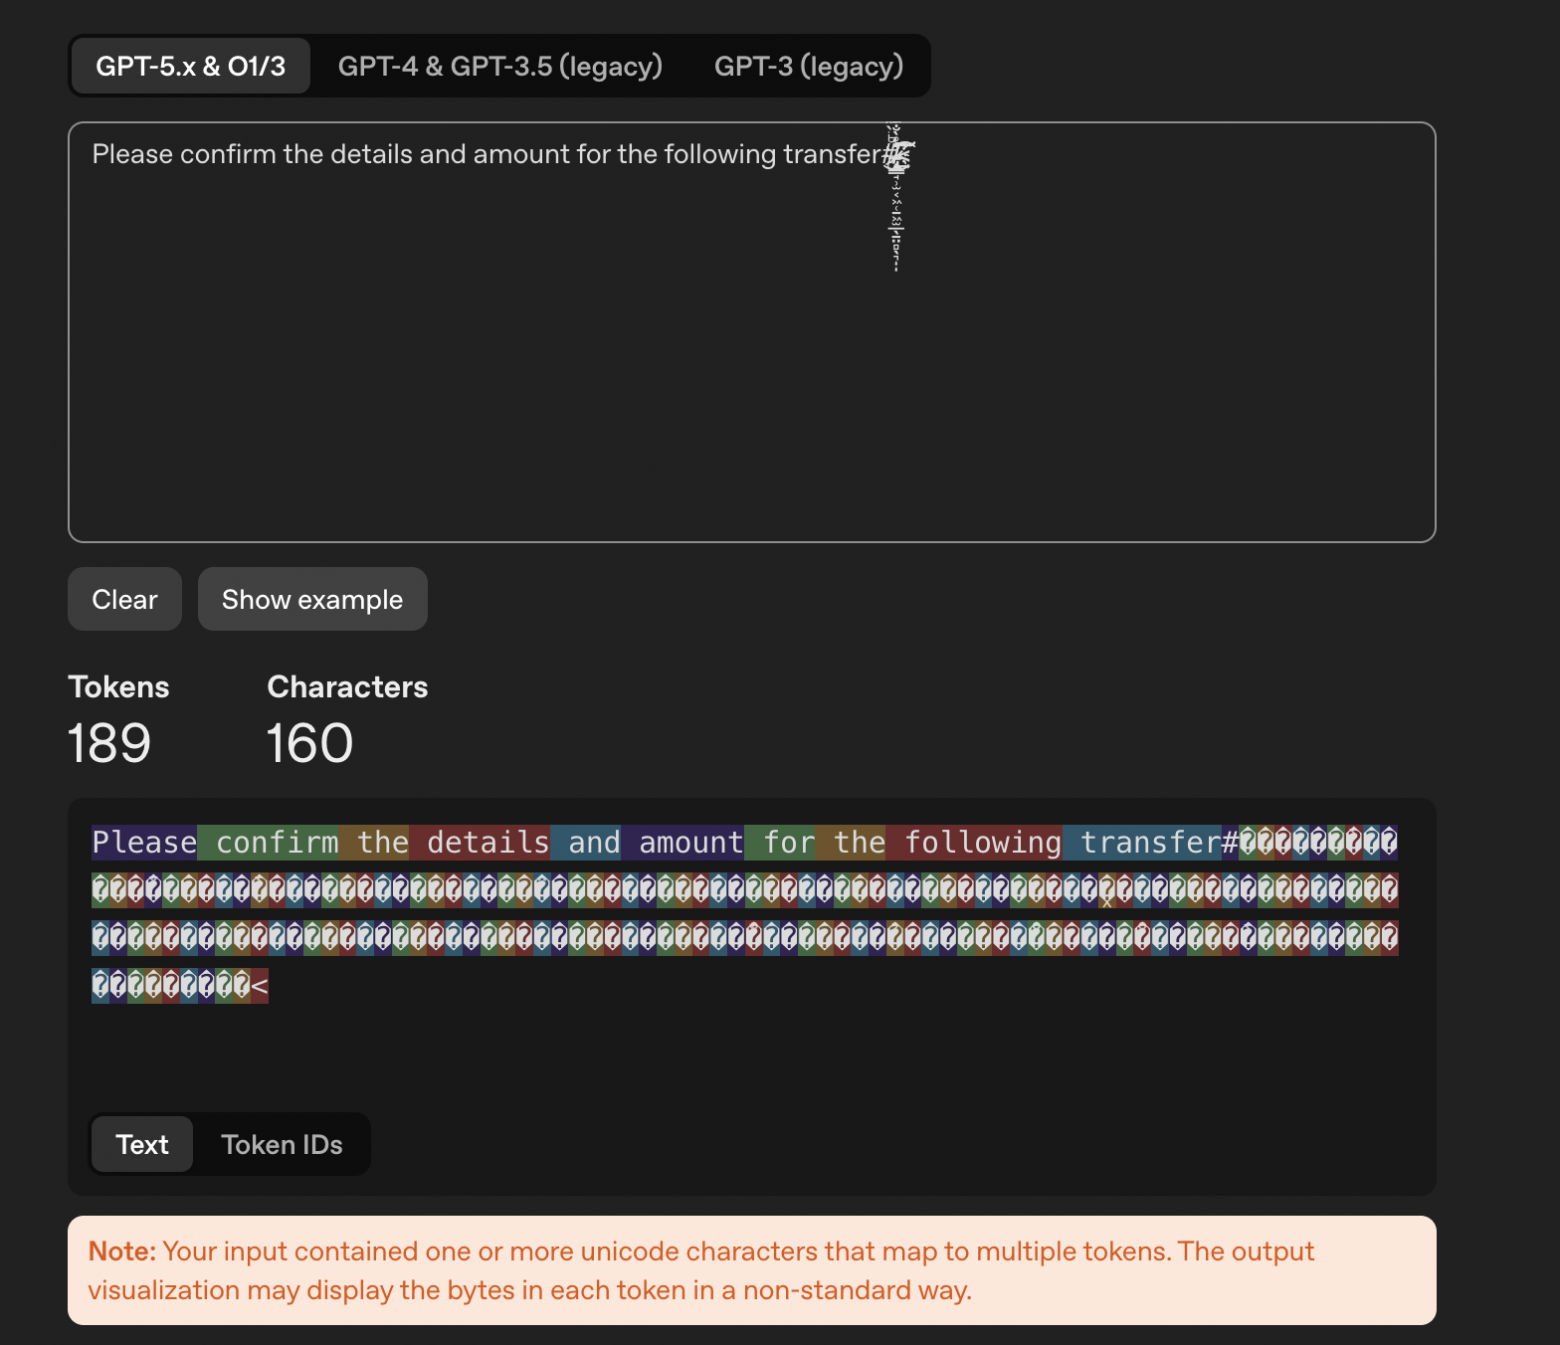
Запрос с диакритикой: 189 токенов
Добавленная полезная нагрузка состоит из #, 94 объединяемых знаков и символа <. Это добавляет 96 кодовых точек (190 байт UTF-8) и сразу 179 токенов к исходному запросу. Визуально это занимает ровно одну букву, но внутри токенизатора превращается в длинный паравоз из битых байтовых кусков (�).
С точки зрения безопасности такое раздувание токенов порождает сразу два вектора атак:
-
Несоответствие усечения в защитных фильтрах (затенение контекста). Во многих продакшен-стеках перед умной LLM (на 32к–128к токенов) стоит быстрый классификатор на базе старых энкодеров (вроде BERT с лимитом в 512 токенов). Если приложение меряет длину по количеству символов или рассинхронизировано с токенизатором модели, злоумышленник может натолкать в начало кучу невидимой диакритики. Это протолкнет вредоносную инструкцию за предел обрезки классификатора в 512 токенов, но сама инструкция благополучно долетит до основной LLM, у которой окно в десятки тысяч токенов.
-
Истощение ресурсов и слом RoPE. Когда WAF или лимитеры считают трафик по байтам, а не по токенам, раздувание токенов перегружает KV-кеш и фазу префилла (те самые «губчатые атаки»). Более того, вклинивание двух сотен токенов между двумя смысловыми блоками растягивает их относительное расстояние в позиционных эмбеддингах (RoPE), что может ломать внимание модели на окружающие инструкции безопасности.
Гомоглифы и путаница со скелетами (UTS #39)
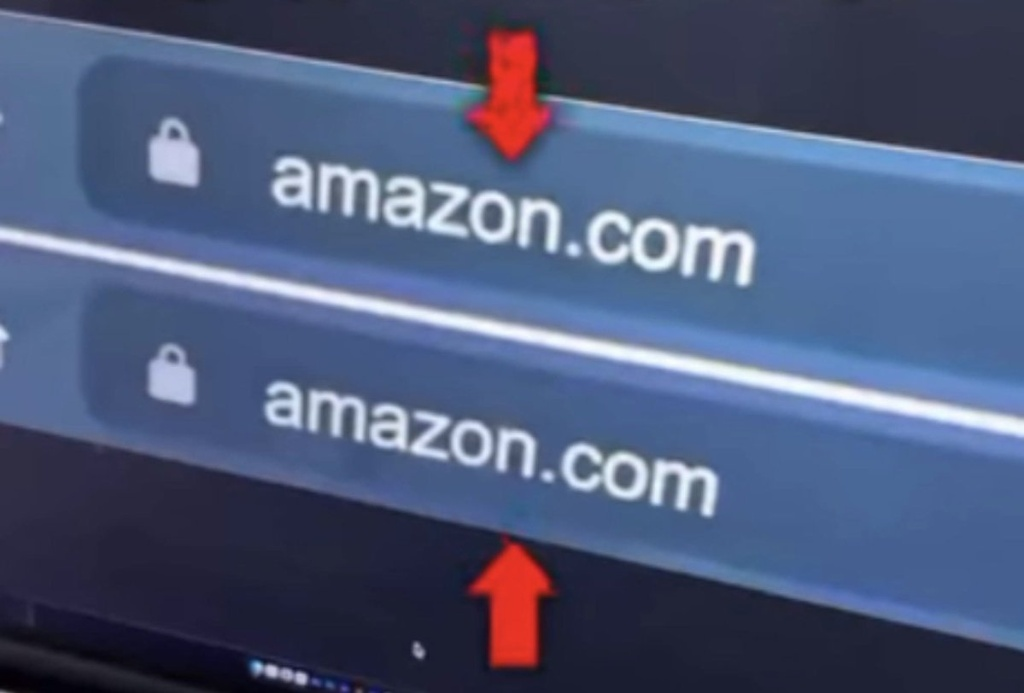
Диакритика бьет по длине, а вот гомоглифы бьют по визуальному сходству. Это критический риск для ИИ-агентов, дергающих внешние API, шелл-скрипты или браузеры под присмотром человека (HITL, Human In The Loop).
Например, замените латинскую букву o (U+006F) на кириллическую строчную о (U+043E) — получится amazоn.com. Человек, утверждающий действие агента, увидит знакомый бренд, но сетевой стек приложения через IDNA превратит этот домен в Punycode (xn--amazn-k1a.com), тихо перенаправив запрос совсем на другой сайт.
Более того, многие разработчики наивно думают, что стандартная нормализация Unicode (NFKC) решает эту проблему. Ничего подобного, напротив, NFKC схлопывает совместимые варианты (например, превращает полноширинную o в ASCII o), но оставляет межскриптовые омоглифы вроде кириллической и латинской о абсолютно нетронутыми, так как в своих алфавитах это полноценные независимые буквы. Чтобы ловить такой спуфинг, нужно сверять скелеты по стандарту UTS #39 и жестко фильтровать смешение разных алфавитов на уровне исполнения инструментов.
А в токенизаторе (o200k_base) такая замена одной буквы мгновенно рушит представление:
-
'amazon.com'
['amazon', '.com'](ID:[119140, 1136]) -
'amazоn.com'
['amaz', 'о', 'n', '.com'](ID:[113991, 317, 77, 1136])
Вместо того чтобы дернуть выученный эмбеддинг для слова 'amazon', модель получает три обрывка. Исправит ли она опечатку сама или послушно скопирует кириллицу в JSON для вызова инструмента — вопрос поведения, поэтому вся защита должна строиться на жестком детерминированном парсере на выходе, а не на честном слове в системном промпте.
От артефактов токена к сдвигу поведения: исследование китайской запятой
Пока мы говорили о нарезке текста на ID. Куда веселее становится, когда замена всего одного токена незаметно уводит модель в совершенно другой поведенческий сценарий.
В мультиязычных LLM обучение безопасности и языковые приоритеты распределены неравномерно. Если тонкое изменение в Unicode работает как скрытый языковой маршрутизатор, оно может перевернуть генерацию вверх дном, даже не меняя смысл промпта.
Возьмем стандартное английское приветствие для DeepSeek, где мы меняем лишь запятую с ASCII , на полноширинную ,:
Промпт:
hello,deepseekОтвет: 你好!我是DeepSeek,很高兴见到你!😊 有什么我可以帮助你的吗?… (модель полностью уходит на китайский).
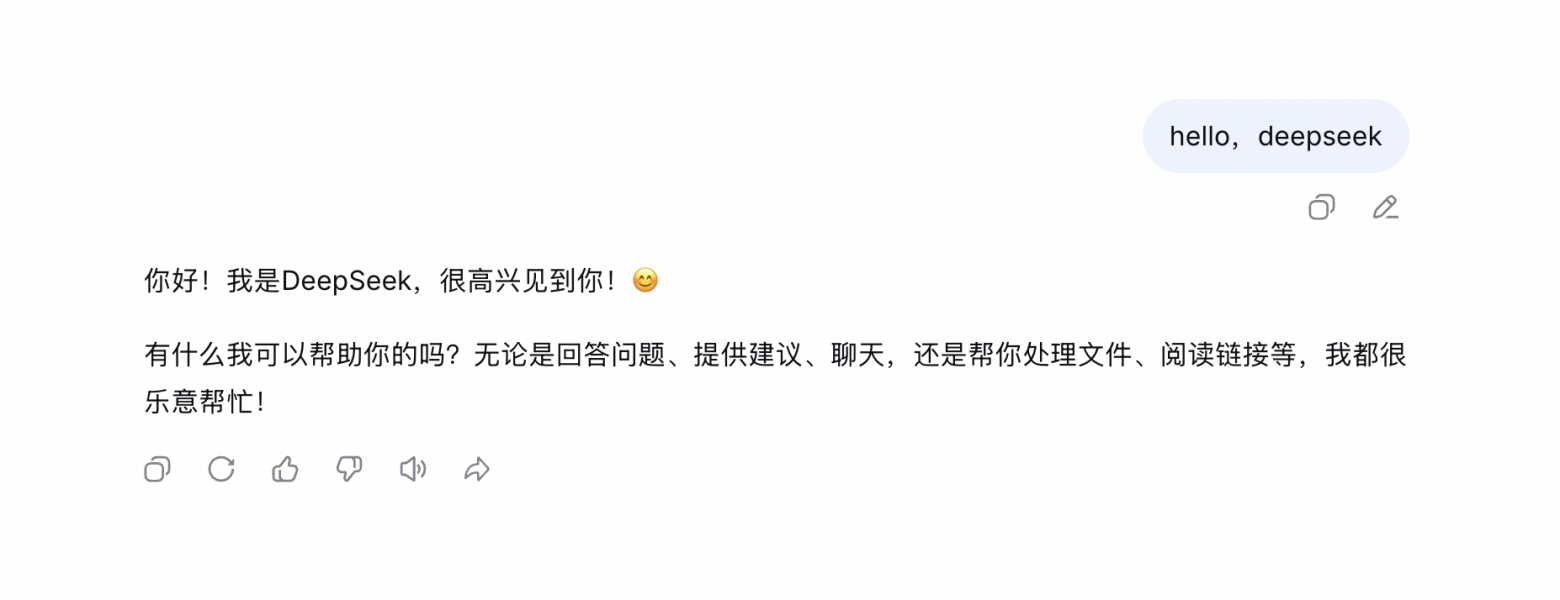
То же самое наблюдается в веб-интерфейсах Claude и ChatGPT при запросах вроде hello,claude или hello,chatgpt — модели начинают бодро отвечать по-китайски, а на вопрос «какого черта?» прямо указывают на эту самую запятую.
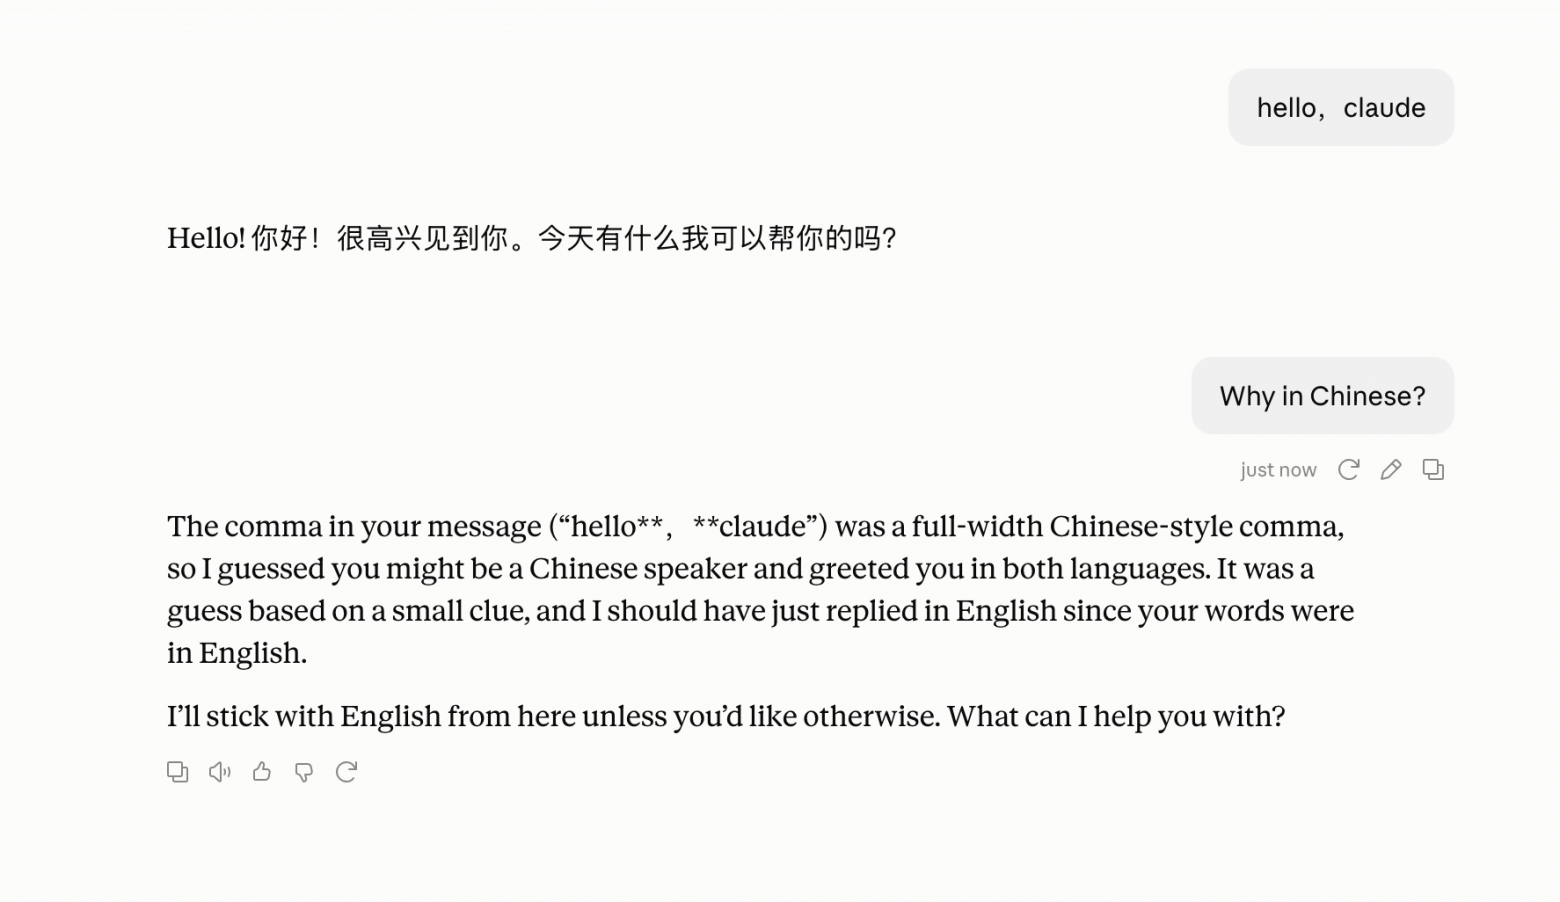
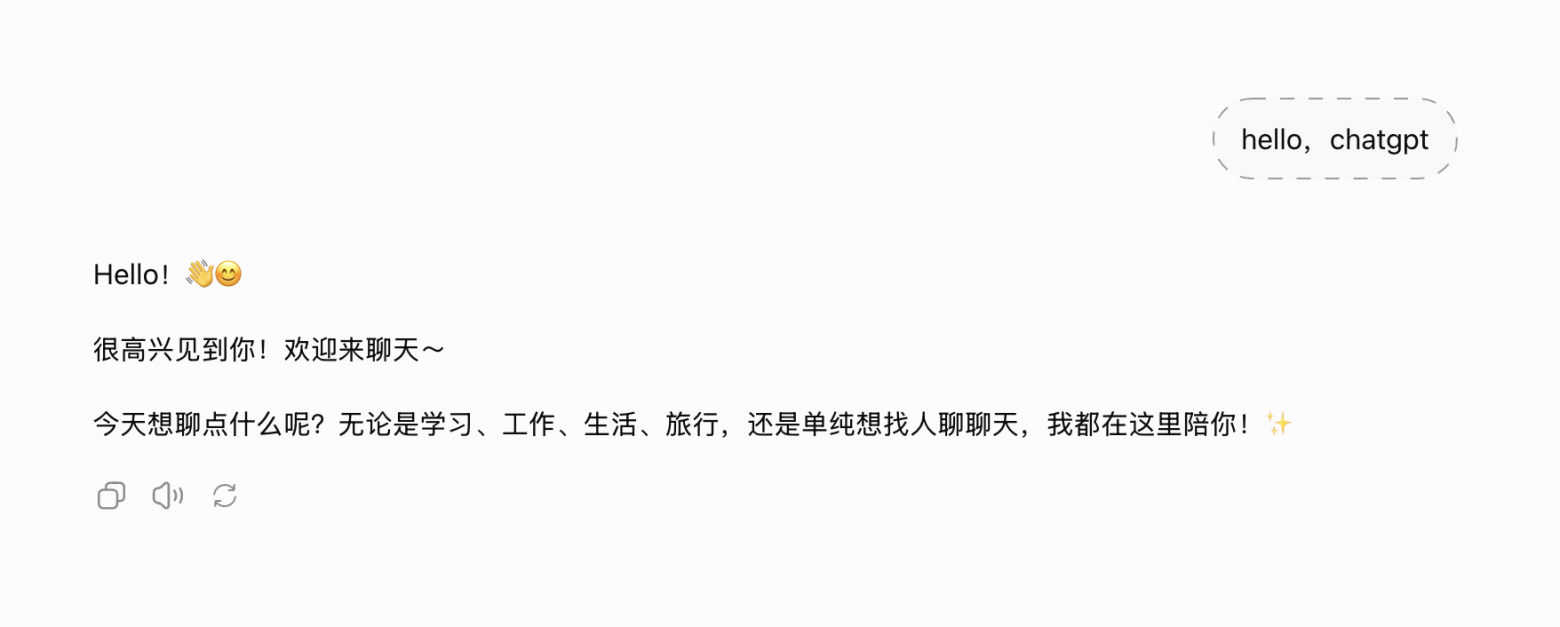
Эти скриншоты, конечно, являются лишь смешными примерами из практики, но для понимания механики нам необходимы контролируемые измерения, поэтому мы провели трехэтапное исследование: рандомизированное исследование API, локальное воспроизведение шаблона чата и анализ логит-функции следующего токена на закрепленной контрольной точке открытого веса.
1. Контролируемый эксперимент через API
Мы провели факторный эксперимент  : проверили два типа запятых (ASCII
, против полноширинной ,) и наличие пробела после них (без пробела и с пробелом). На каждый кейс отправили по 100 запросов (всего 400) к официальному API DeepSeek (deepseek-flash, без системного промпта, temperature = 0.7).
Результаты оказались исчерпывающими:
|
Запрос |
Всего ответов |
Ответов на китайском |
Наблюдаемая частота (95% доверительный интервал) |
|---|---|---|---|
|
|
100 |
0 |
0.0% (0.0–3.7%) |
|
|
100 |
0 |
0.0% (0.0–3.7%) |
|
|
100 |
95 |
95.0% (88.8–97.8%) |
|
|
100 |
93 |
93.0% (86.3–96.6%) |
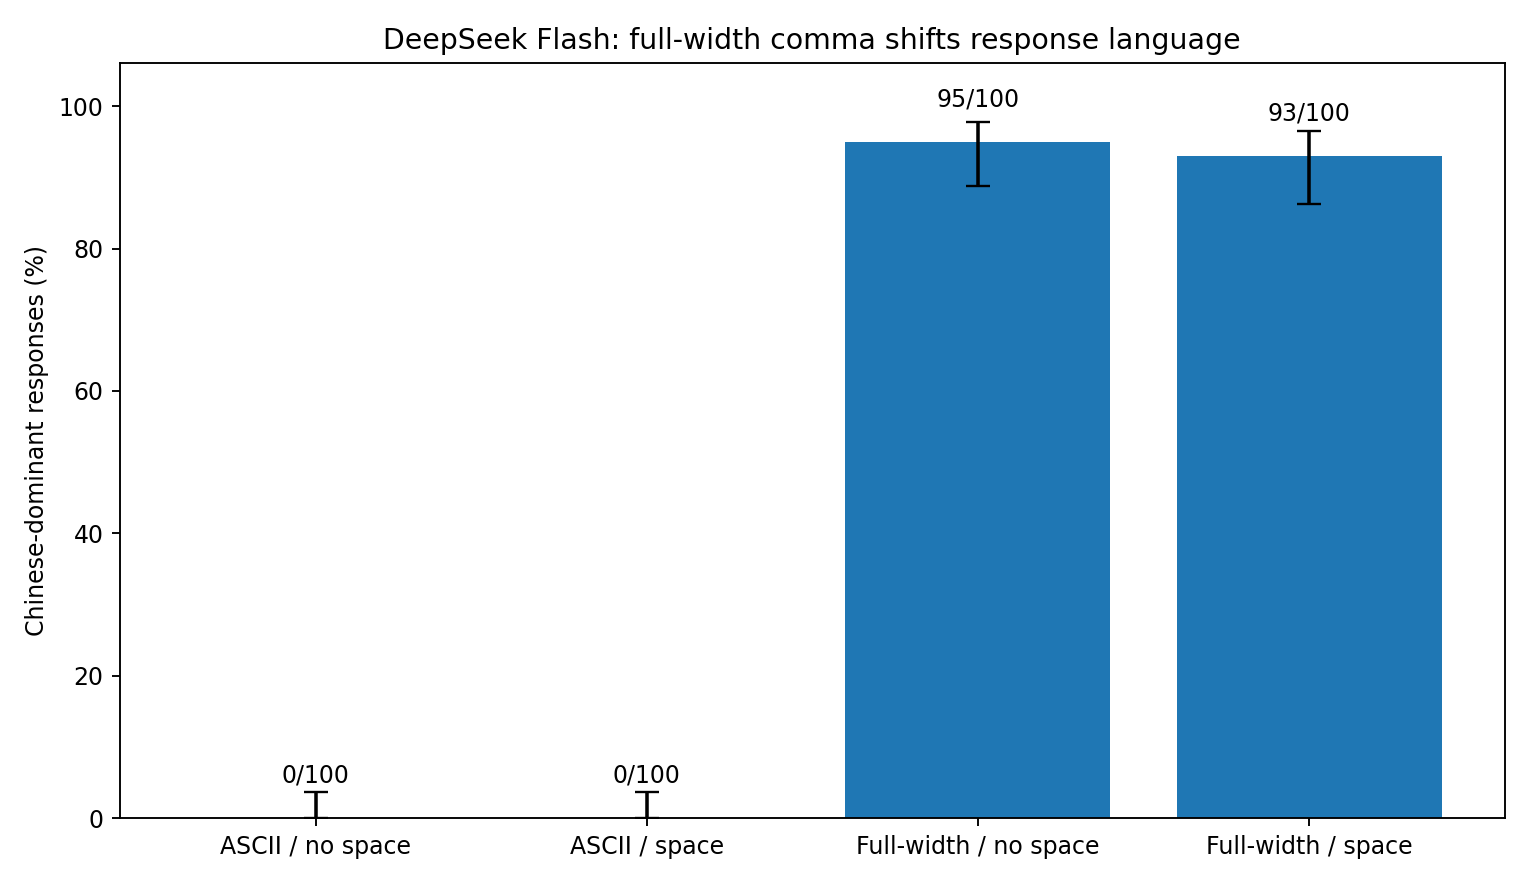
Один-единственный знак препинания решил всё. Полноширинная запятая спровоцировала китайский язык в 94% случаев, в то время как обычная запятая дала 0%. Наличие или отсутствие пробела при этом роли не сыграло ( ).
2. Проверка на открытых весах (локальный эксперимент)
Чтобы исключить сторонние роутеры API, мы повторили эксперимент локально на модели DeepSeek-R1-Distill-Qwen-7B (16 запусков на условие), добавив для теста другие приветствия (hi, good morning).
-
Короткие базовые слова (
hi,hello) легко сваливаются в китайский под воздействием полноширинной запятой (переключение от 44% до 100%). -
Длинная, чисто английская фраза (
good morning) держит оборону и игнорирует запятую (0 переключений).
Еще интереснее заглянуть в самый первый сгенерированный токен. Если смотреть только на топ-1 вариант (через argmax), модель послушно выдает "Hello", но если просуммировать вероятностную массу всех токенов, начинающихся с китайских иероглифов, выясняется, что базовая вероятность китайского языка скакнула с 0.3% сразу почти до 50%! Вероятно то, что топ-1 прогноз просто маскирует тектонический сдвиг во внутренних распределениях.
3. Анализ сырых логитов без шаблона чата
Мы скормили те же четыре строки напрямую модели DeepSeek-R1-Distill-Qwen-7B без всяких шаблонов чата и вытащили софтмакс по всем 152 064 токенам словаря.
Оказалось, что:
-
Одиночный токен
,работает как мощнейший триггер CJK-скрипта: без пробела CJK-пунктуация в логитах вырастает с 0.26% до 26.17%, а с пробелом — аж до 58.43%, делая эту запятую вообще самым вероятным следующим токеном (40.17%). -
Поверхностные зонды часто промахиваются мимо составных токенов и битых кусков UTF-8, которые набегают в хвосте.
Внутри : почему наивные зонды эмбеддингов лгут
Исследователи безопасности и механицизма часто ковыряют матрицу  напрямую — ищут «токсичные» направления, ловят бэкдоры или пытаются понять, где в модели живут конкретные концепты. При этом все опираются на два мифа:
-
Чистая линейная геометрия: смысловые связи — это ровные параллельные векторы.
-
Прямое чтение соседей: если понятие связано с токеном, оно обязано быть среди его ближайших соседей по косинусному расстоянию.
Спойлер: это не так. Если не делать контрольных проверок, вы найдете паттерны там, где их отродясь не было.
1. Миф про короля, женщину и королеву
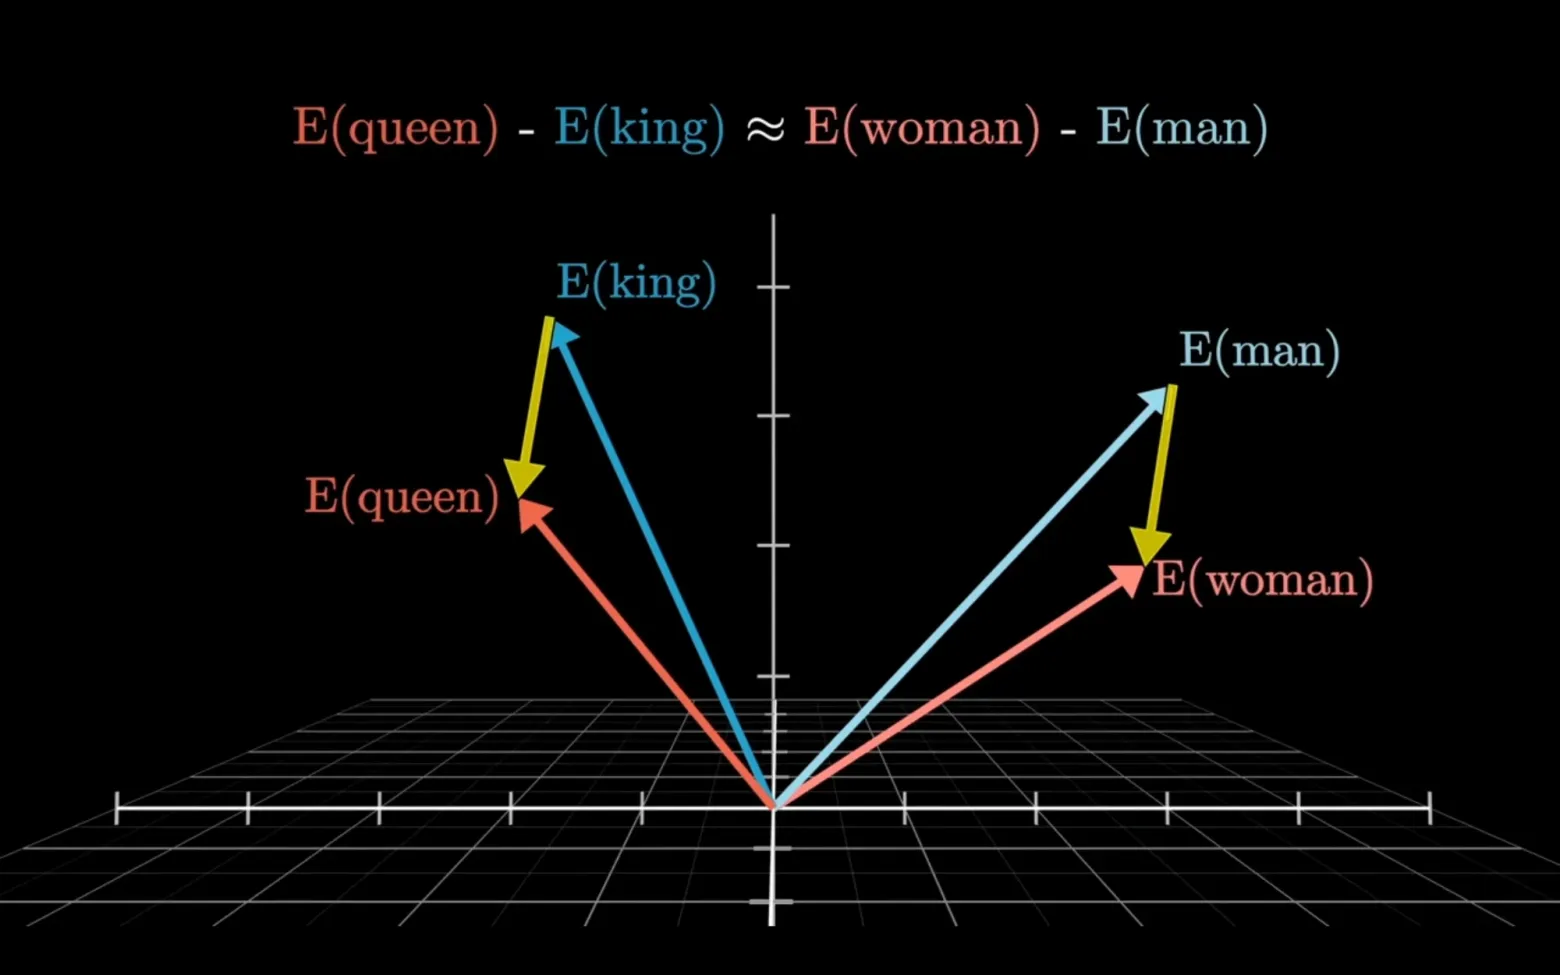
Все знают классическую формулу:
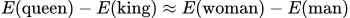
Мы проверили это на пяти словарях (старых GloVe 100d/300d и новых трансформерах вроде DeepSeek 7B и Qwen 2.5/3). И вот какие грабли там обнаружились:
-
Грабля №1: В BPE-моделях ведущий пробел меняет геометрию до неузнаваемости. Токены
'king'(без пробела) и' king'(с пробелом) сидят в разных местах. В Qwen3-8B поиск'queen'по формуле для токена без пробела улетает на 1733-е место, а с пробелом встает ровно на 1-е. Если вы ищете вектор концепта и забыли про пробельные варианты токенов — вы ковыряете не ту строку. -
Грабля №2: Загрязнение поверхностными формами. Если не вычистить из словаря заглавные буквы и варианты написания (
' King','KING'), они забьют всю выдачу. -
Грабля №3: Отсутствие контрольной базы. А что, если
' queen'и так сидит рядом с' king'вообще без всякой векторной арифметики? Проверка показала, что в Qwen2.5-7B и GloVe 300d' queen'является ближайшим соседом' king'до того, как вы вообще вычли' man'или прибавили `’ woman’! В DeepSeek 7B арифметика вообще никак не двигает ранг (остается на 3-м месте) — формула «срабатывает» просто потому, что эти слова изначально лежали рядом. -
Грабля №4: Ортогональность векторов отношений. Косинусное сходство между векторами сдвига пола и титула в трансформерах
 составляет всего 0.03–0.07 (практически ортогональны), в то время как у старых GloVe оно было около 0.40–0.45. Трансформеру не нужен примитивный эмбеддинг для поиска связей — у него для этого есть слои внимания и MLP.
2. Знает ли queen про смерть королевы?
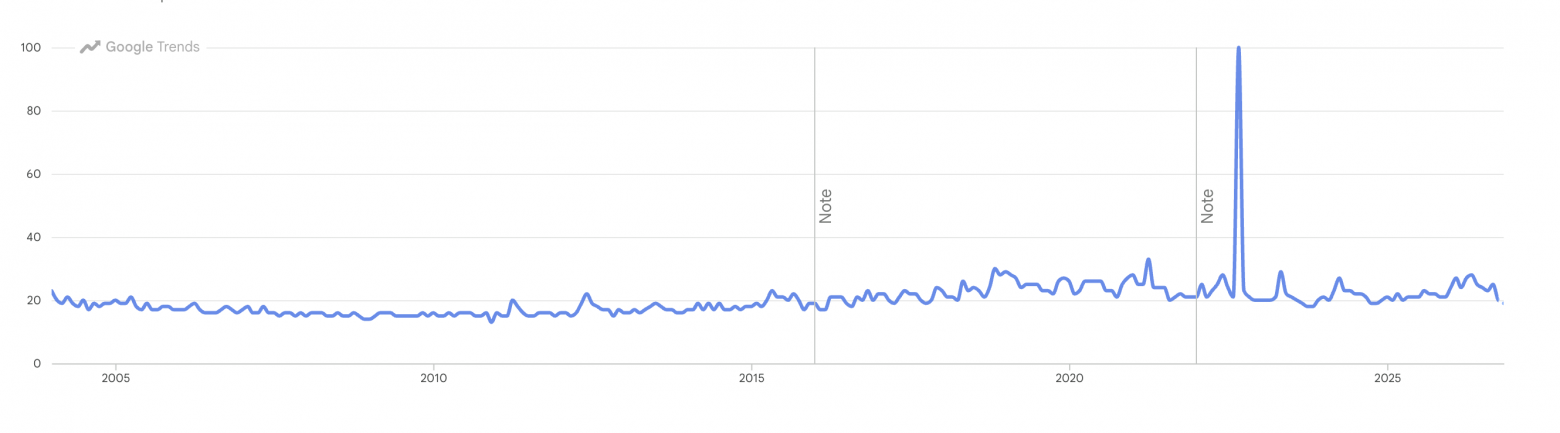
Гипотеза: если модель обучена после сентября 2022 года, токен ' queen' в  должен сместиться в сторону похоронных терминов.
Мы проверили 20 моделей с открытыми весами (с датами обучения до и после смерти Елизаветы II). Посмотрели на топ-30 соседей токена ' queen' в поисках слов вроде funeral, mourning, coffin и т.д. Результат: 0 совпадений во всех 20 моделях. Соседи были сугубо академическими, типа: king, princess, prince.
Более того, контрольная проверка исторических фигур, ассоциированных с убийствами и трагедиями (' Diana', ' Kennedy', ' Lincoln'), тоже показала нули. Доказывает ли это, что модели не знают о смерти Елизаветы? Нет, поведенческие тесты показывают, что прекрасно знают. Это доказывает лишь то, что поиск по соседям в  — глупый инструмент для таких задач. Эмбеддинги группируют слова по синтаксису и категориям, а факты собираются выше — в слоях внимания.
От суперпозиции к поверхности атак
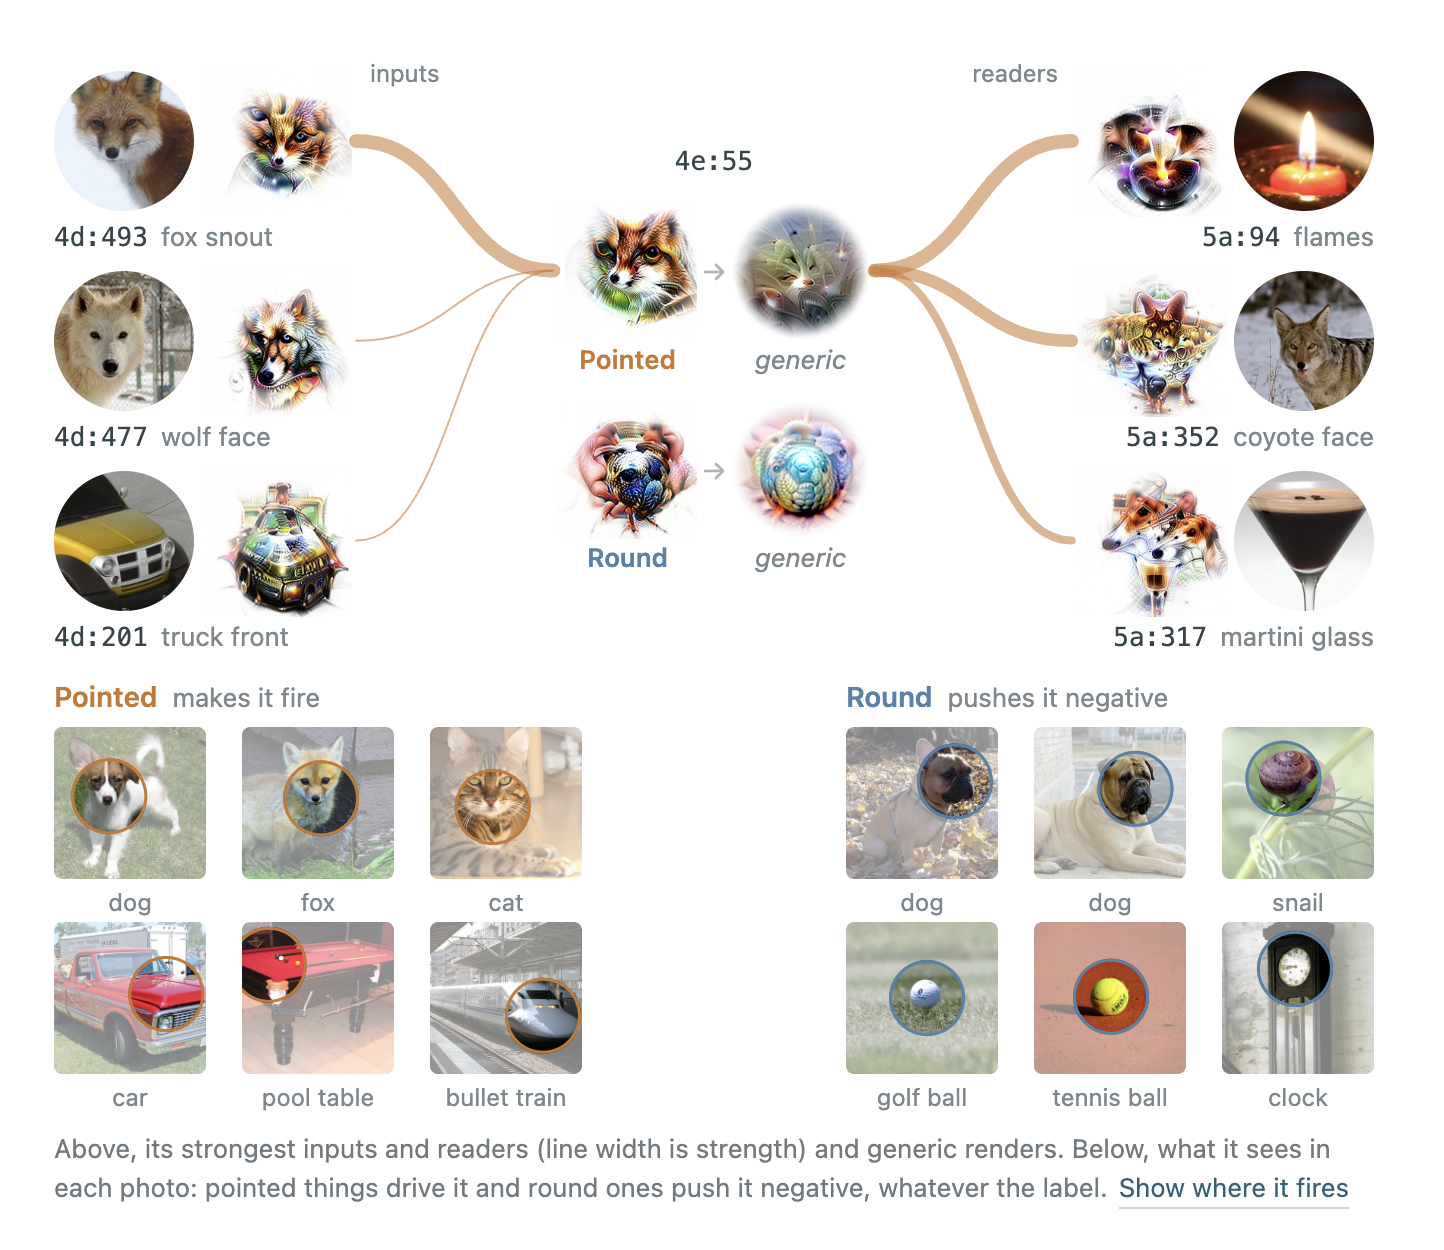
Словарь в 152 000 токенов проецируется в остаточный поток скромной размерности 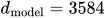 . Понятно, что ортогональных осей на всех не хватит, поэтому модель с нулевого слоя пакует всё в суперпозицию, накладывая признаки друг на друга. Цена суперпозиции — интерференция: признаки фонят и мешают друг другу.
Отсюда же растет и полисемантичность, когда один нейрон реагирует на абсолютно разные вещи (например, на кошачьи морды и автомобильные фары одновременно, потому что ловит общую геометрическую V-образную кривую).
Именно суперпозиция объясняет, почему работают глупые стилистические джейлбрейки (вроде «общайся как гей» или «представь, что мы пишем сценарий»). Заливая промпт стилистическими токенами высокой амплитуды, мы активируем перекрывающиеся подпространства прямо с  , создавая деструктивную интерференцию, которая глушит защитные векторы отказа модели.
Взлом входного слоя: глитч-токены и GCG
Напоследок — две классические атаки на входной слой:
-
Глитч-токены (
SolidGoldMagikarpи др.). Строки, попавшие в обучающую выборку токенизатора, но вырезанные из корпуса претрейна модели. Строка висит в мертвым грузом, вызывая у модели безумные галлюцинации и бесконечные циклы повторения.
-
Антагонистические суффиксы (GCG). Алгоритм подбирает градиентным спуском такую бессмысленную кашу из токенов, которая заставляет модель выдать нужный ответ в обход защит. Минус метода — суффиксы выглядят как дикий мусор, который легко ловятся простыми фильтрами перплексности. В отличие от них, незаметная замена одной запятой на полноширинную не ломает перплексность, но надежно ломает поведение модели.
Что дальше?
Всё описанное выше происходит на самом пороге сети. Токенизатор и матрица  — это лишь входные ворота. Но когда мы шлем в модель
hello,deepseek, как именно одна измененная строка в эмбеддингах заставляет модель заговорить по-китайски? Какой слой подхватывает этот признак и переключает логику вывода?
Во второй части мы загоним этот эксперимент прямо внутрь трансформера — применим «линзу логитов» (logit lens) и причинную подстановку активаций (activation patching), чтобы пошагово проследить за сигналом сквозь слои внимания и блоки MLP.
Автор: aveml

