


Мир Квестов — агрегатор квестов в реальности: больше десяти лет на рынке, 7,5 миллиона посетителей в год, около трёх тысяч квестов по России. Посетитель приходит с запросом вроде «хочу интересный квест» или «что-нибудь страшненькое на двоих», и поиск должен превратить это в подборку, из которой он что-то забронирует.
Статья написана по моему докладу на открытой сцене GTF 2026. Числа и слайды взяты из доклада. Первая часть про подсказки: как опрос покупателей заменил нам историю просмотров и как решающее дерево сжало анкету из 120 галочек до трёх кликов. Вторая часть про текст: шесть LLM-классификаторов, которые разбирают запрос, пока посетитель печатает. В конце метрики и то, как похожие задачи решают большие компании.
Поиск — главный путь к покупке
По открытым источникам, больше 70% покупателей Wildberries находят товар через поисковую строку; на Авито, где я раньше работал менеджером продукта, доля сделок из поиска того же порядка. Ozon переписал поиск с Elasticsearch на собственный движок и ускорил его втрое. Авито объявило, что потратит 500 млн ₽ на ассистента «Ави», который в диалоге уточняет параметры поиска. То есть поиск очень важен агрегаторам, классифайдам и маркетплейсам.
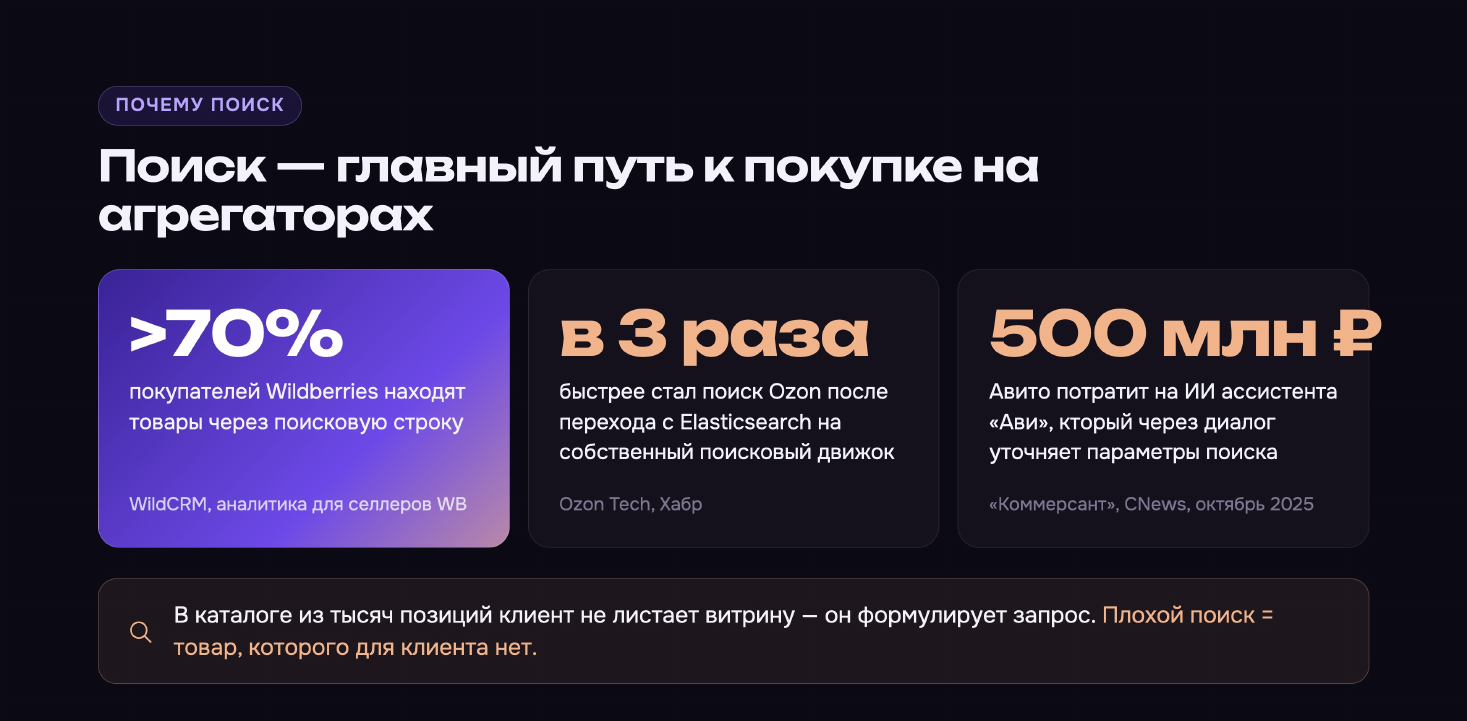
В каталоге из тысяч позиций клиент не листает витрину, он формулирует запрос. Если поиск его не понял, товара клиент не найдет. А значит не будет покупки.
Рынок на плато
Ниша квестов зрелая. Этап бурного роста прошёл, и ждать роста бизнеса за счёт нового трафика не приходится: спрос, например по запросу «страшный квест» в Вордстате, стоит на месте.
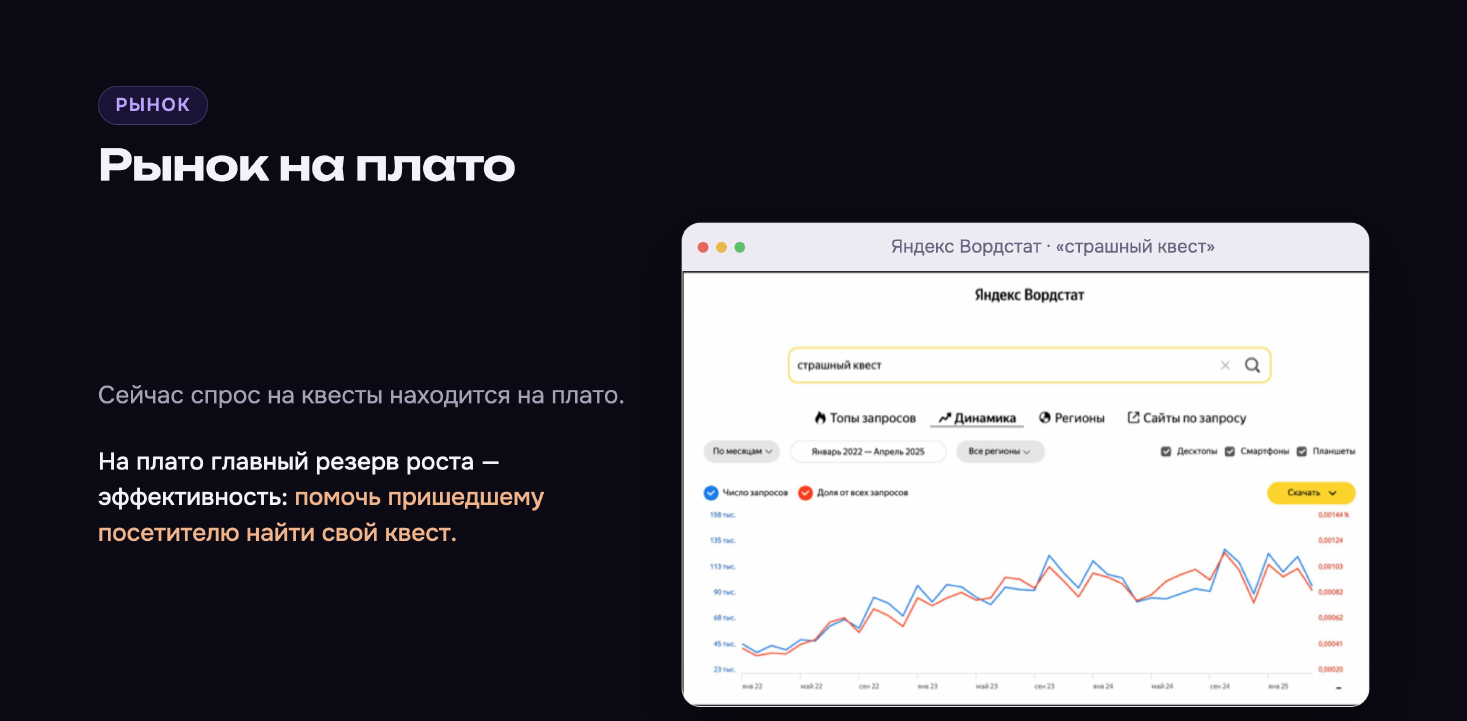
На плато главный резерв роста — эффективность: помочь уже пришедшему посетителю найти свой квест. Отсюда интерес к поиску и рекомендациям.
65% посетителей не авторизованы
Было бы удобно, если бы посетители знали каталог наизусть и писали точные запросы без ошибок, а лучше сразу на SQL. На практике пишут в общем, с опечатками и сами не всегда знают, чего хотят. «Интересный квест» у каждого свой, и чтобы на него ответить, нужна рекомендательная система.
Классическая рекомендательная система советует по истории: что человек смотрел и бронировал раньше. У нас 65% посетителей не авторизованы, истории у них нет, советовать не на чем.
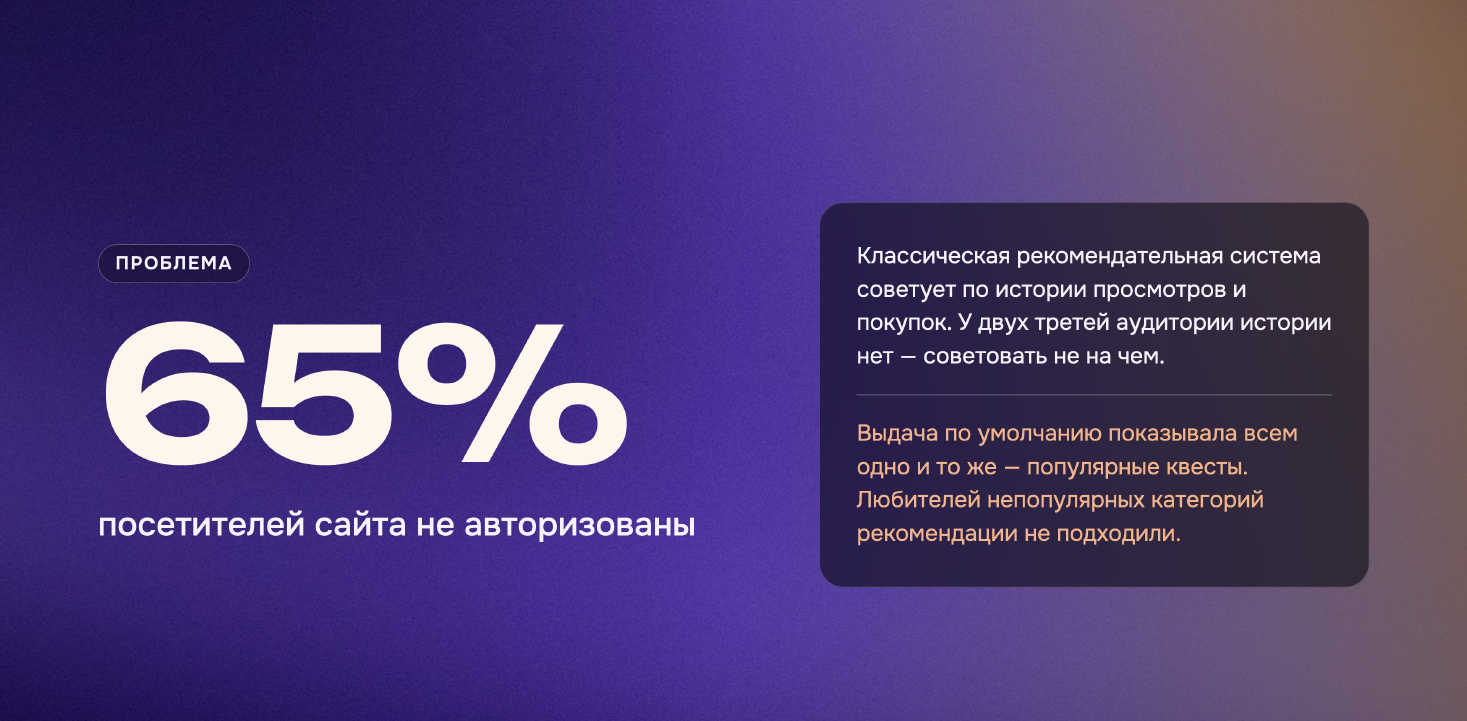
Выдача по умолчанию показывала всем одно и то же — популярные квесты. В нашей сфере это в основном страшные квесты и перформансы. Тем, кто пришёл за приключением или детективом, такие рекомендации не подходили.
Версия 1. Подсказки
Историю просмотров заменяет опрос покупателей
Если данных о пользователях нет, их можно спросить. После бронирования мы предлагаем анкету из 10–12 вопросов: какие нравятся жанры, декорации, форматы, уровень страха и сложности, с кем человек ходит и по какому поводу бронирует. За год набирается 20–30 тысяч анкет.
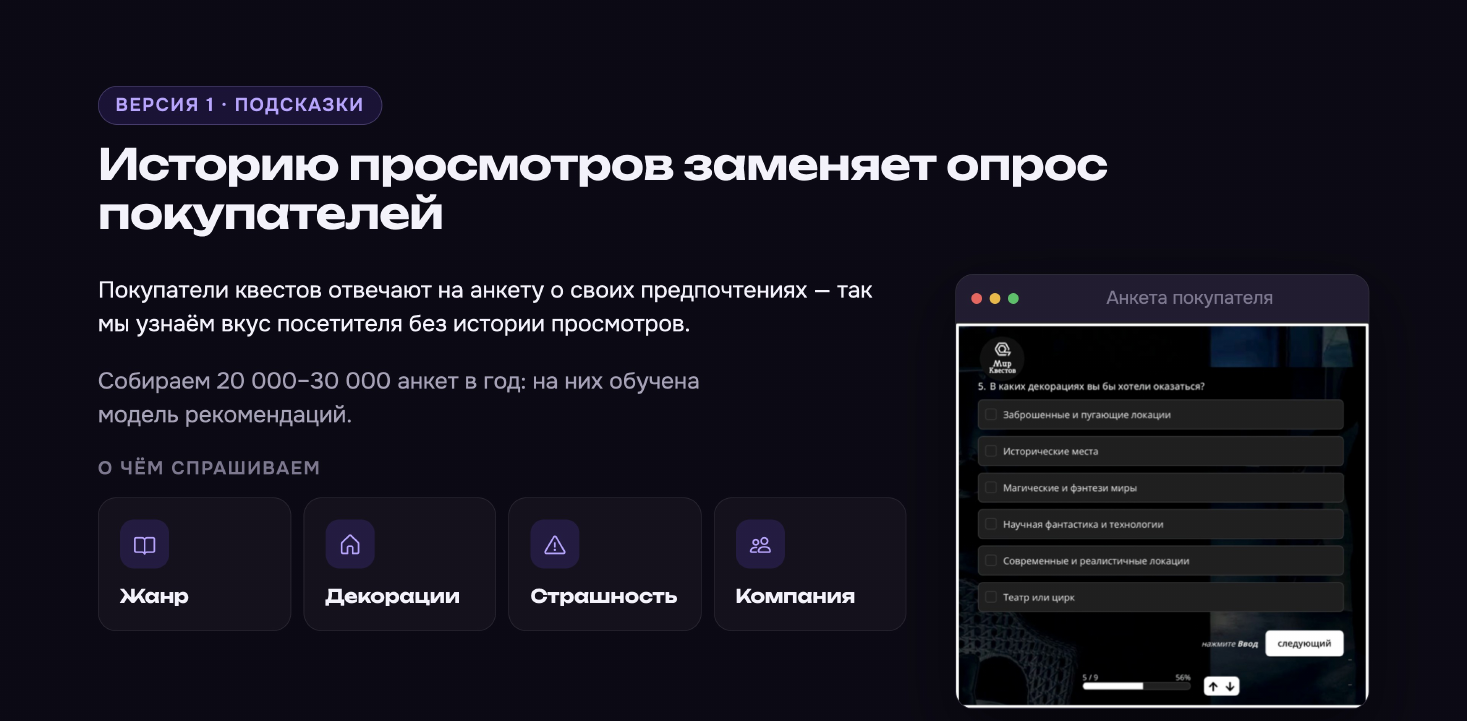
Каждая анкета помечена квестом, который респондент забронировал. Получается размеченный датасет: слева предпочтения, справа выбор. На таком объёме уже можно обучить модель, которая хорошо рекомендует тому, кто ответил на все вопросы.
Решающее дерево сжимает анкету
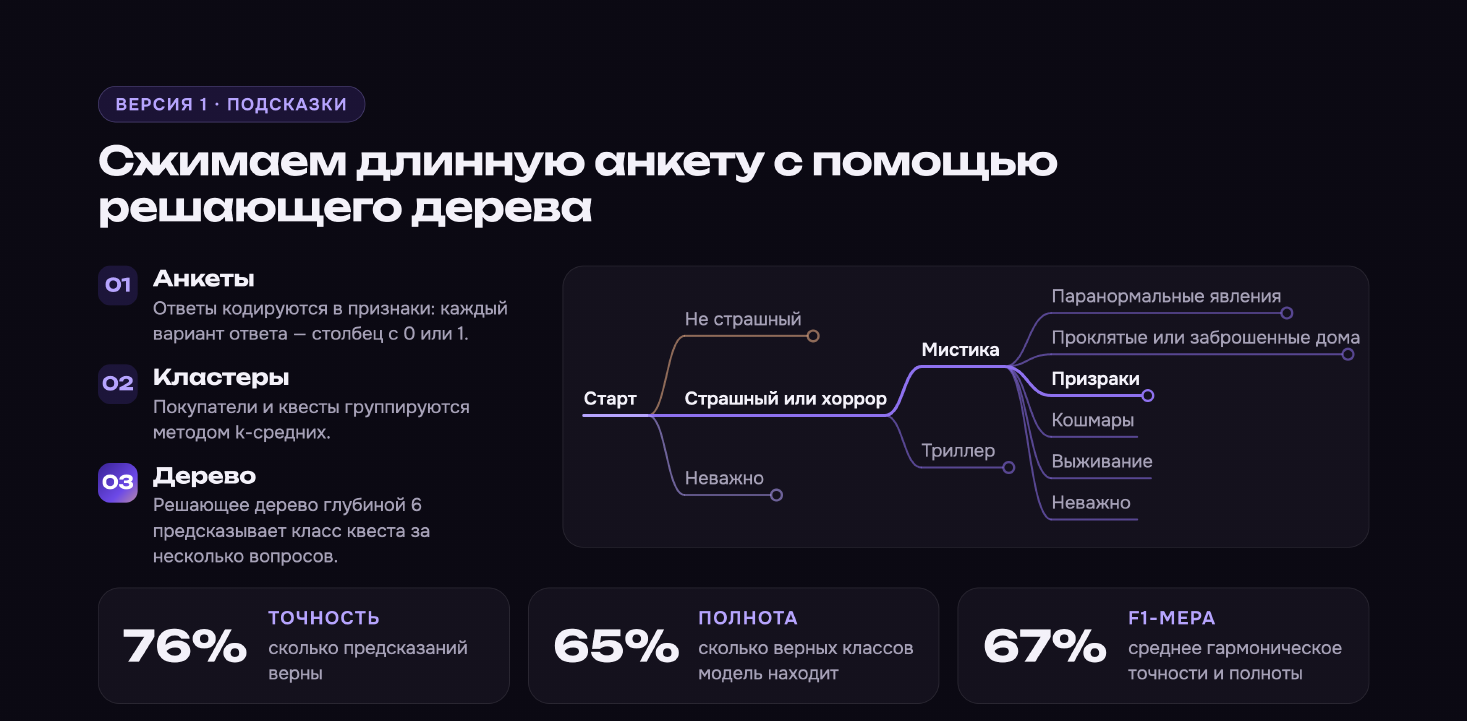
Проблема в слове «все». В анкете около 120 вариантов ответа. Если посетитель отметит на сайте 120 галочек, мы дадим точную рекомендацию, но никто этого делать не будет. Поэтому пространство вопросов мы сжимаем машинным обучением в три шага:
-
Анкеты. Ответы кодируются в признаки: каждый вариант ответа — столбец с 0 или 1.
-
Кластеры. Покупатели и квесты группируются методом k-средних.
-
Дерево. Решающее дерево глубиной 6 предсказывает класс квеста за несколько вопросов.
Упрощённая схема на scikit-learn выглядит так (иллюстрация подхода, имена файлов и параметры условные):
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.tree import DecisionTreeClassifier, export_text

# Одна строка — одна анкета. Столбцы — варианты ответов (0 или 1),
# quest_id — квест, который респондент забронировал.
answers = pd.read_parquet("surveys.parquet")
X = answers.drop(columns=["quest_id"])

# Квест описываем средним профилем ответов его покупателей
# и группируем квесты в классы методом k-средних.
N_CLASSES = 30  # подбирается на валидации
quest_profiles = X.groupby(answers["quest_id"]).mean()
kmeans = KMeans(n_clusters=N_CLASSES, random_state=0).fit(quest_profiles)
quest_class = pd.Series(kmeans.labels_, index=quest_profiles.index)
y = answers["quest_id"].map(quest_class)

# Дерево учится угадывать класс квеста по минимуму вопросов.
tree = DecisionTreeClassifier(max_depth=6, min_samples_leaf=50).fit(X, y)
print(export_text(tree, feature_names=list(X.columns)))
Дерево превращает датасет в граф вопросов и ответов. На каждом шаге посетителю предлагают 3–5 вариантов; выбрав один, он попадает в более узкую ветку, где вопросы уже другие. Любителя мистики спросят про призраков и заброшенные дома, а родителя с ребёнком — про волшебных существ и сокровища.
|
Метрика |
Значение |
Что показывает |
|---|---|---|
|
Точность |
76% |
сколько предсказаний верны |
|
Полнота |
65% |
сколько верных классов модель находит |
|
F1-мера |
67% |
среднее гармоническое точности и полноты |
Трёх кликов уже хватает для рекомендации, а люди кликают по 4–5 раз и больше.
Как это выглядит в интерфейсе
Под поисковой строкой стоят кнопки-подсказки, чипсы. Посетитель кликает: «Не страшный», «Квест», «Для детей», «волшебных существ». Пока он это делает, в строке собирается фраза на естественном языке: «Не страшный квест для детей про волшебных существ в жанре экшн для 4-х человек».
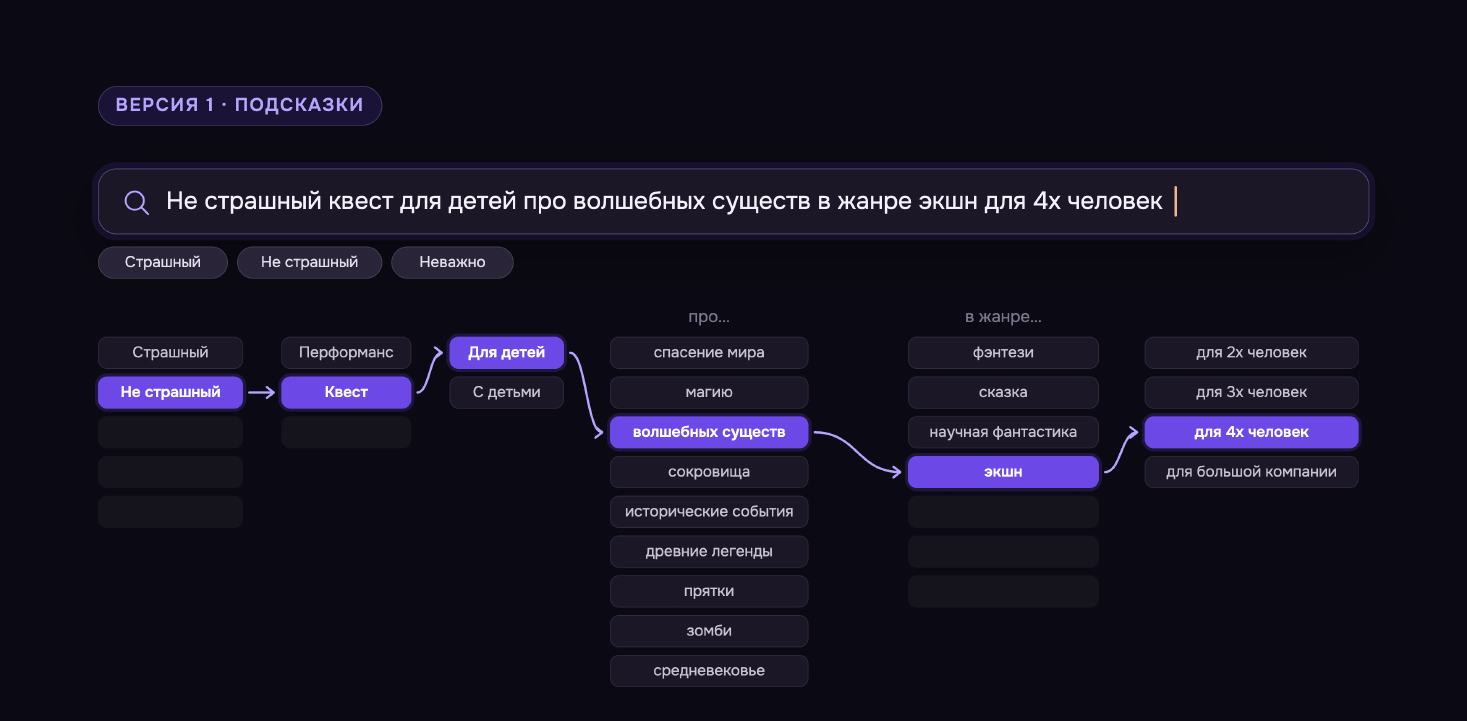
К последнему клику поиск знает все параметры и показывает подборку.
Минус первой версии
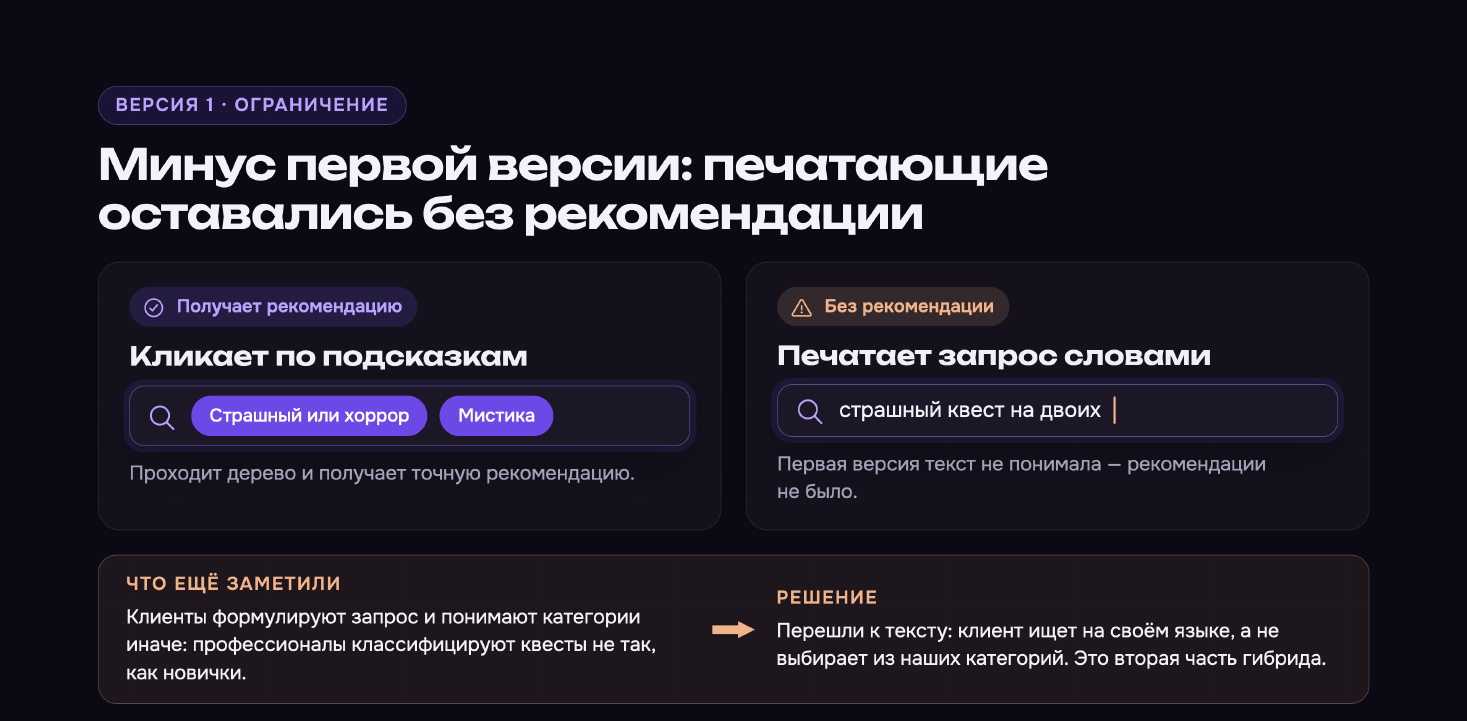
Мы профессионалы и классифицируем квесты по-своему: я знаю, что такое саспенс, чем триллер отличается от хоррора и чем один уровень страха отличается от соседнего. Посетитель сайта этого не знает. Он хочет «интересный квест» и «что-нибудь страшненькое». Наши категории не совпадают с его словами, и заставлять его учить наш язык бессмысленно. Нужно дать ему писать на своём и научиться это распознавать.
Версия 2. Распознавание текста
Модель о шести головах
Для этого мы используем большие языковые модели в режиме классификации. Классификаторов шесть, каждый отвечает за свой параметр:
-
Страшность — уровень страха квеста, от 0 до 3.
-
Сложность — уровень сложности загадок.
-
Число игроков — на сколько человек рассчитан квест.
-
Возраст — минимальный возраст участников.
-
Формат — тип игры, например перформанс.
-
Категория — тематика: мистика, детектив, фэнтези.
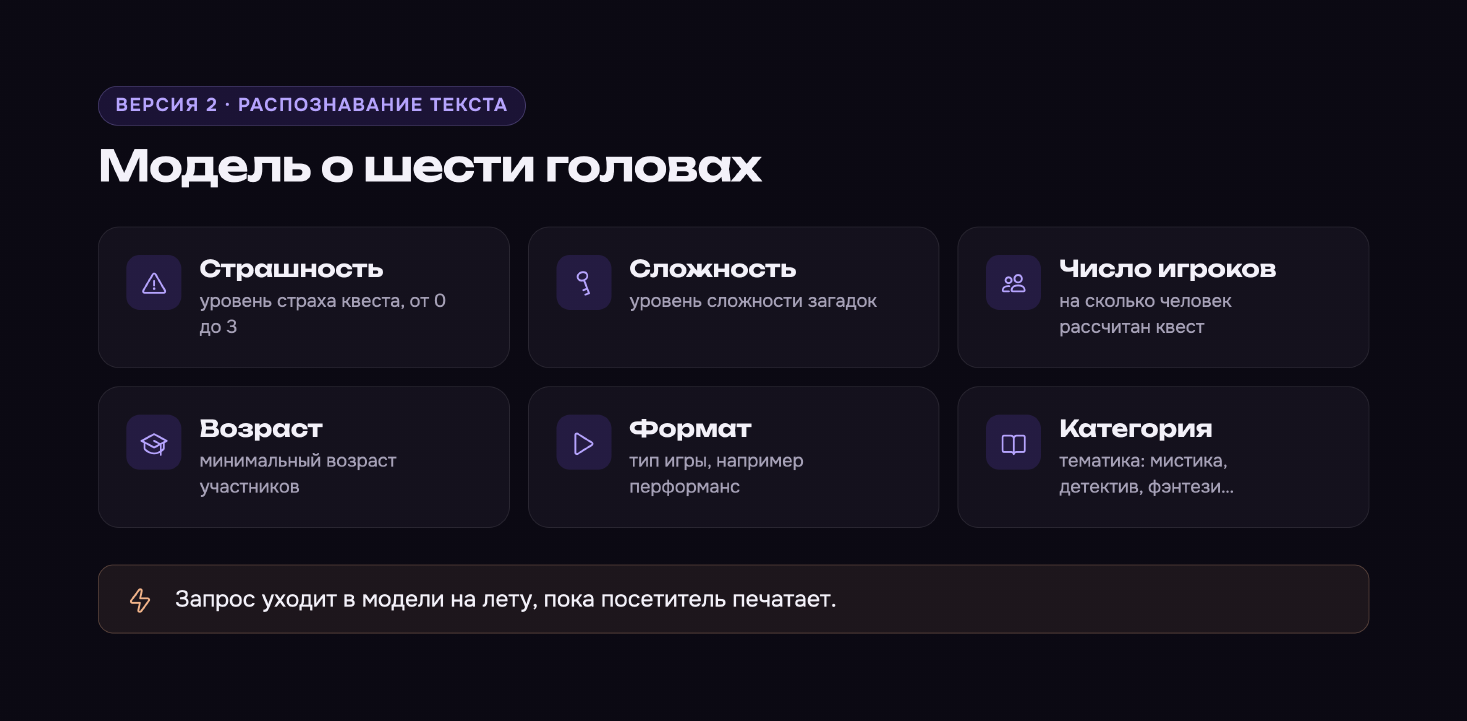
Запрос уходит в модели на лету, пока посетитель печатает. Каждая голова по набранным символам решает, сказано ли в них что-то про её параметр.
Пример: «страшный на двоих»
Человек написал «страшный на двоих». Модель поняла, что речь, скорее всего, про уровни страха 2–3 и про двух игроков. Результат разбора можно представить так (структура условная):
{
  "query": "страшный на двоих",
  "scary_level": [2, 3],
  "difficulty": null,
  "players": 2,
  "min_age": null,
  "format": null,
  "category": null,
  "unrecognized": ""
}
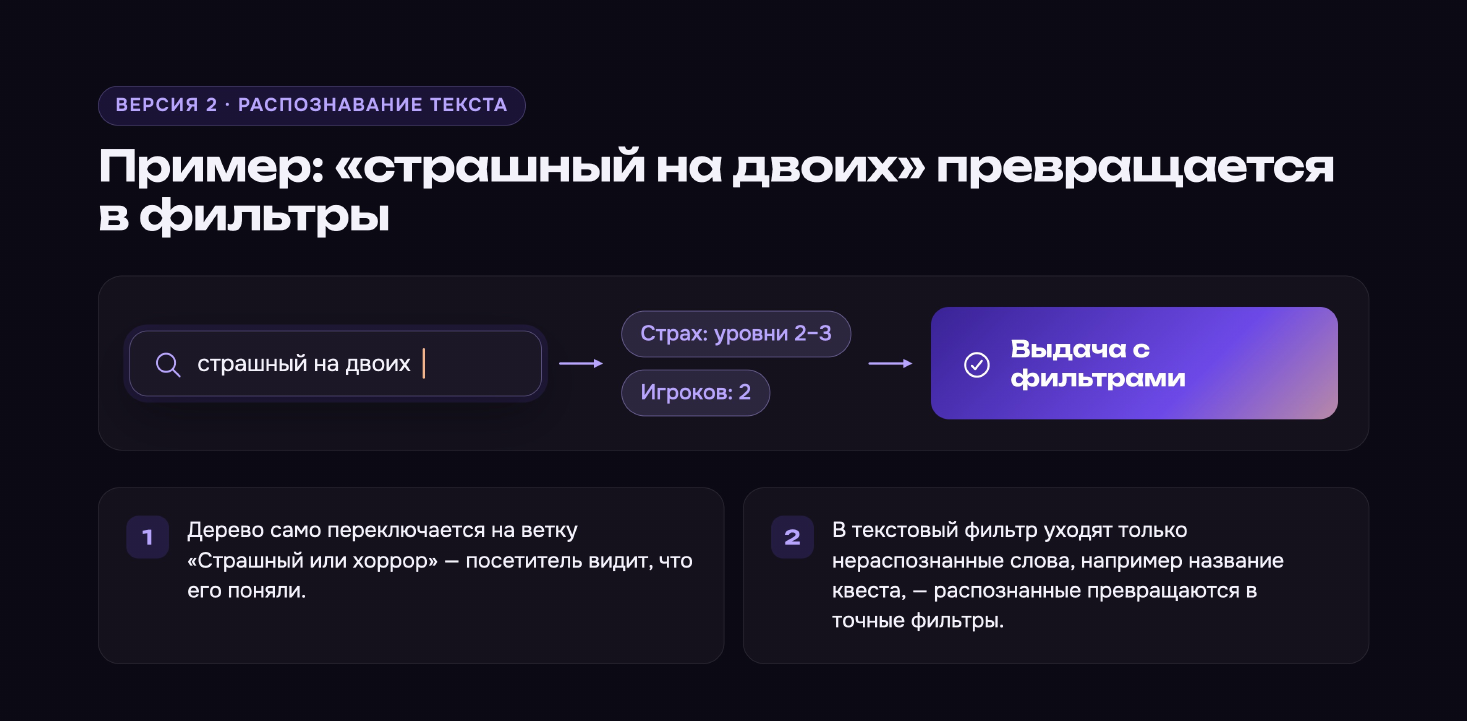
Дальше происходят две вещи:
-
Дерево подсказок само переключается на ветку «Страшный или хоррор». Чипсы под строкой меняются, посетителю не нужно кликать лишний раз, и он видит, что его поняли.
-
Распознанные слова становятся точными фильтрами. В текстовый поиск уходят только нераспознанные слова, например название квеста.
Гибрид: оба способа в одной строке
Подсказки и текст смешиваются в одной поисковой строке. Посетитель кликнул чипс «Мистика» и дописал словами «на двоих». Или наоборот: начал со слов и уточнил кликами. Порядок не важен. Чипс стирается одним нажатием целиком, текст — посимвольно.
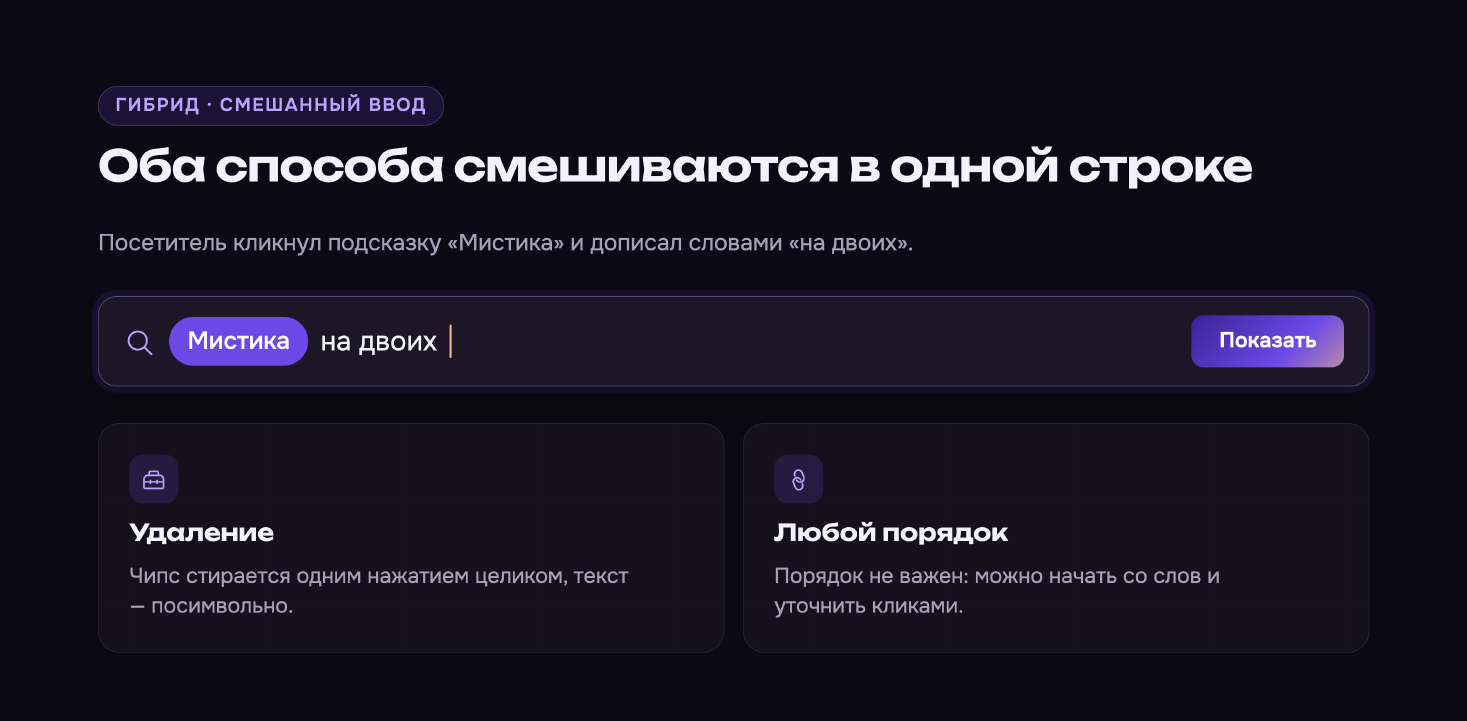
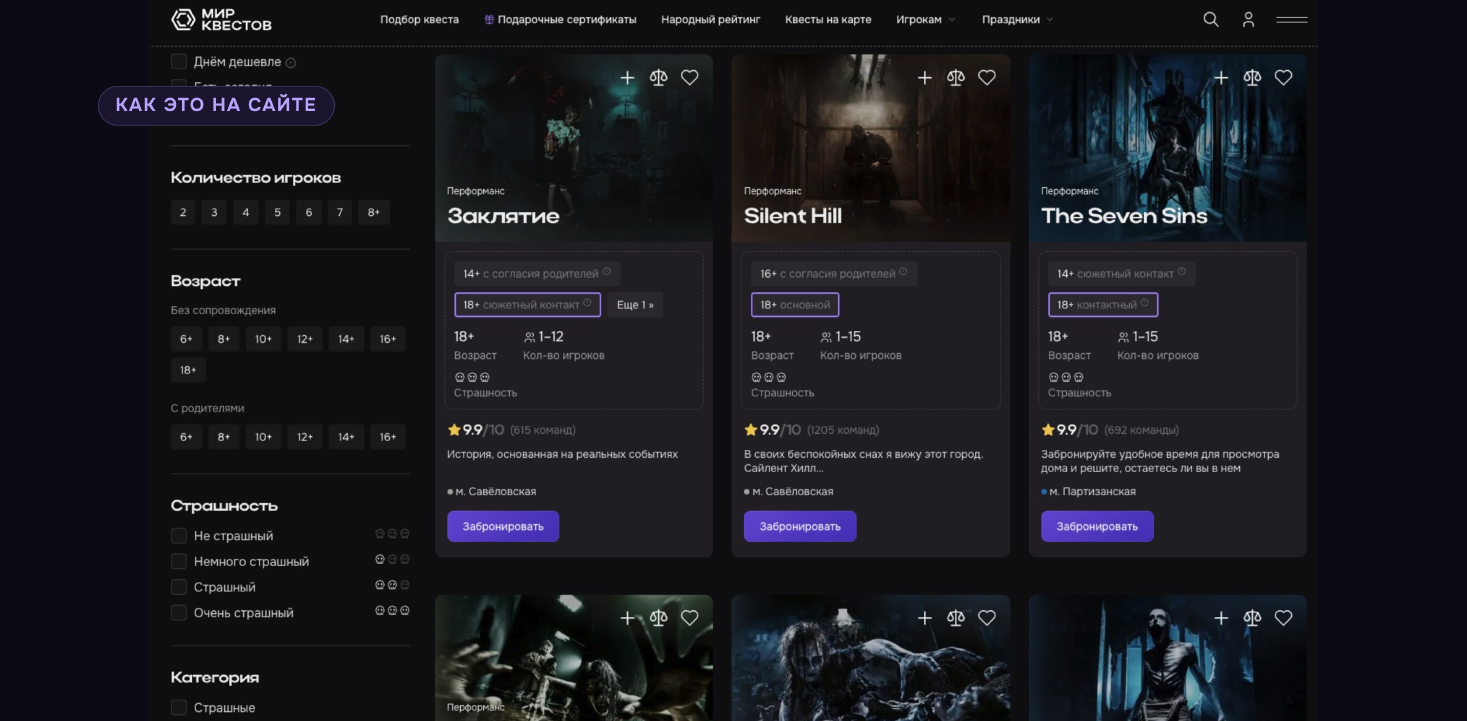
В любом случае посетитель получает рекомендацию и оказывается на поисковой выдаче с уже выставленными фильтрами.
Результаты
Как мы считали метрики
У поиска есть технические метрики (доля отказов, доля пустых выдач), продуктовые (доля успехов, доля переформулировок) и бизнес-метрики (конверсия, удержание, LTV). Продуктовые мы считали так:
|
Событие |
Определение |
|---|---|
|
Поиск |
показ выдачи сразу после действия посетителя в поисковом виджете |
|
Успех |
после поиска посетитель открыл карточку квеста |
|
Переформулировка |
карточку не открыл, но изменил фильтры и посмотрел выдачу снова |
|
Другое |
не открыл карточку и не менял фильтры |
Поисковая сессия — события одного посетителя; пауза больше 30 минут начинает новую сессию.
37% поисков заканчиваются карточкой квеста
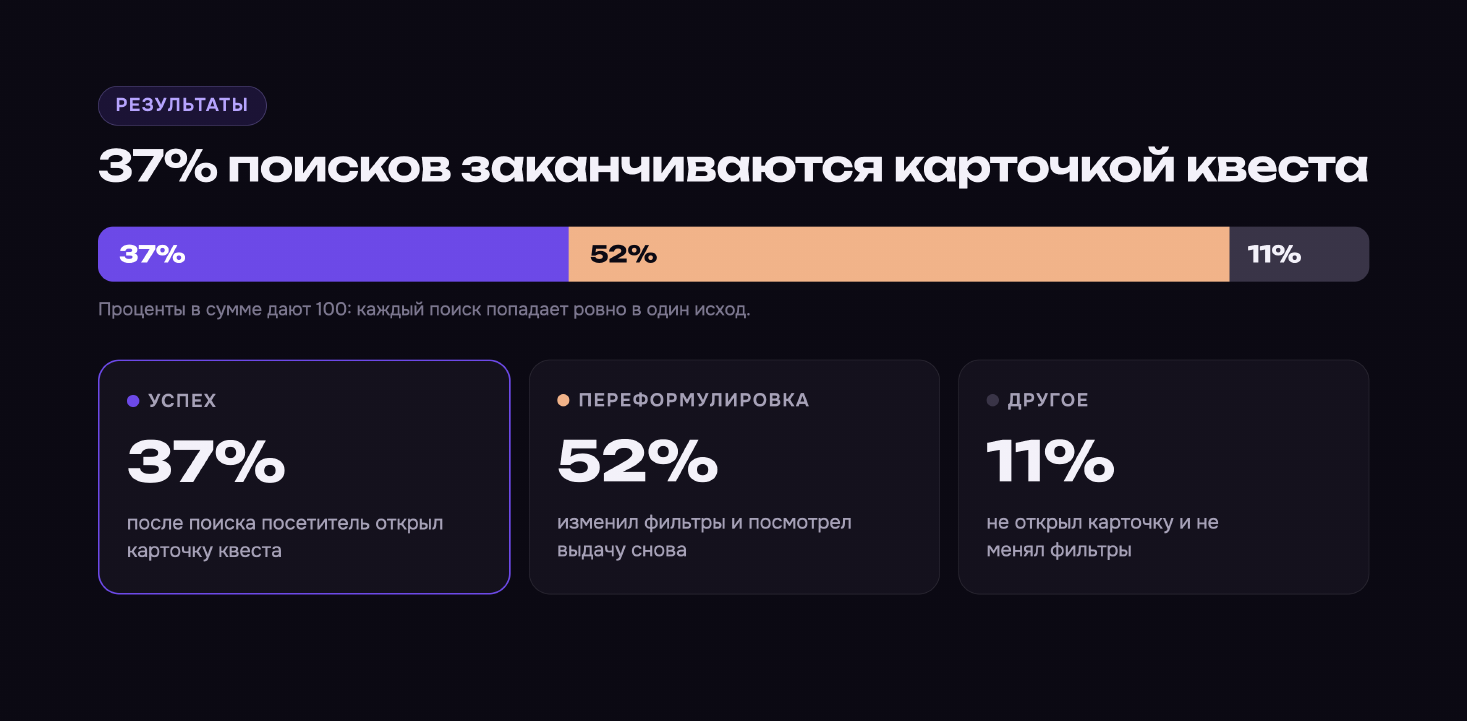
Успехом заканчиваются 37% поисков, переформулировкой — 52%, оставшиеся 11% — ни тем, ни другим. Переформулировка не обязательно провал: человек посмотрел выдачу и донастраивает запрос.
Много это или мало? По внутренним сравнениям — хорошо. Для внешнего ориентира есть открытые данные больших поисков.
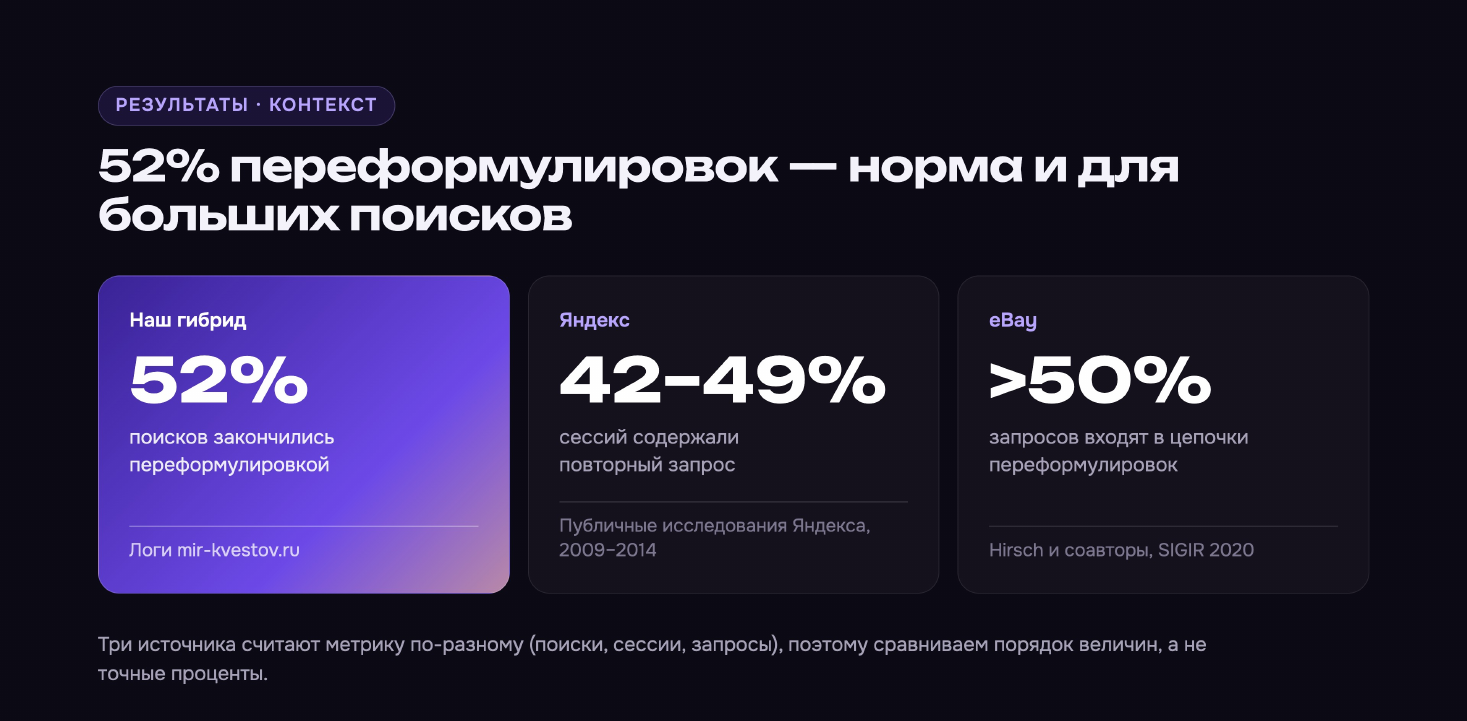
В публичных исследованиях Яндекса 2009–2014 годов повторный запрос содержали 42–49% сессий. В eBay больше половины запросов входят в цепочки переформулировок (Hirsch и соавторы, SIGIR 2020). Три источника считают метрику по-разному: поиски, сессии, запросы. Поэтому сравнивать можно порядок величин, а не точные проценты. По порядку величин мы там же, где большие поиски.
Кому гибрид полезнее всего
Сильнее всего конверсия растёт в небольших сегментах. Большинству наших посетителей нужны страшные квесты и перформансы, и выдача по умолчанию их устраивала. Но есть 11–17% людей, которым страх безразличен или не нужен; как правило, они хотят приключения или детективы. Гибридный поиск распознаёт их за пару действий и сразу показывает подходящее.
Как похожие задачи решают большие компании
-
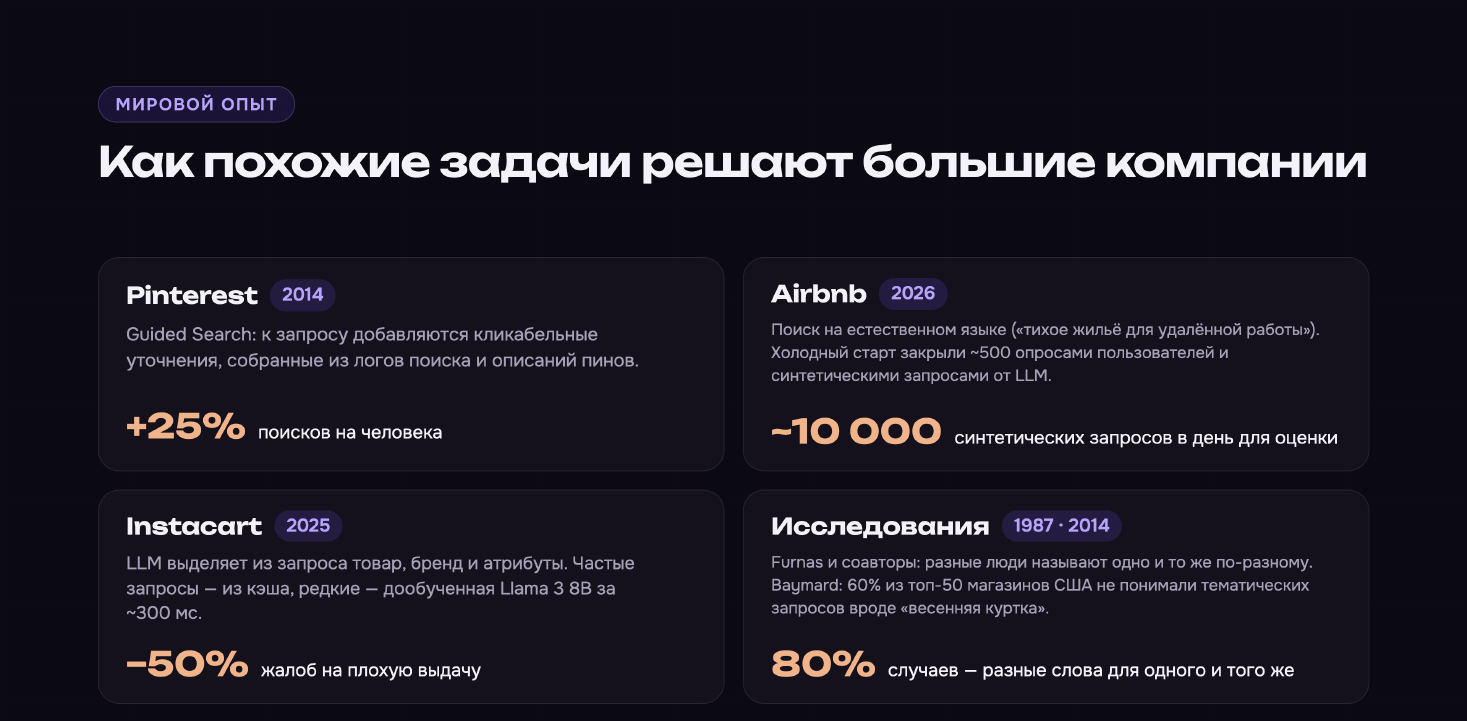
Pinterest, 2014. Guided Search: к запросу добавляются кликабельные уточнения, собранные из логов поиска и описаний пинов. Результат — плюс 25% поисков на человека.
-
Instacart, 2025. LLM выделяет из запроса товар, бренд и атрибуты. Частые запросы берутся из кеша, редкие обрабатывает дообученная Llama 3 8B примерно за 300 мс. Жалоб на плохую выдачу стало вдвое меньше.
-
Airbnb, 2026. Поиск на естественном языке вроде «тихое жильё для удалённой работы». Холодный старт закрыли примерно 500 опросами пользователей и синтетическими запросами от LLM; для оценки качества генерируют около 10 000 синтетических запросов в день.
-
Исследования. Furnas и соавторы (1987) показали, что в 80% случаев разные люди называют одно и то же разными словами. По данным Baymard (2014), 60% из топ-50 магазинов США не понимали тематических запросов вроде «весенняя куртка».
Приёмы те же: частотные подсказки, LLM-классификаторы, естественный язык. Разница в данных. У техногигантов миллионы товаров и миллионы пользователей, подсказки можно собрать из логов. У нас нишевой агрегатор и три тысячи квестов, логов для этого мало. Поэтому пришлось идти через опрос покупателей и дерево.
Что забрать с собой
-
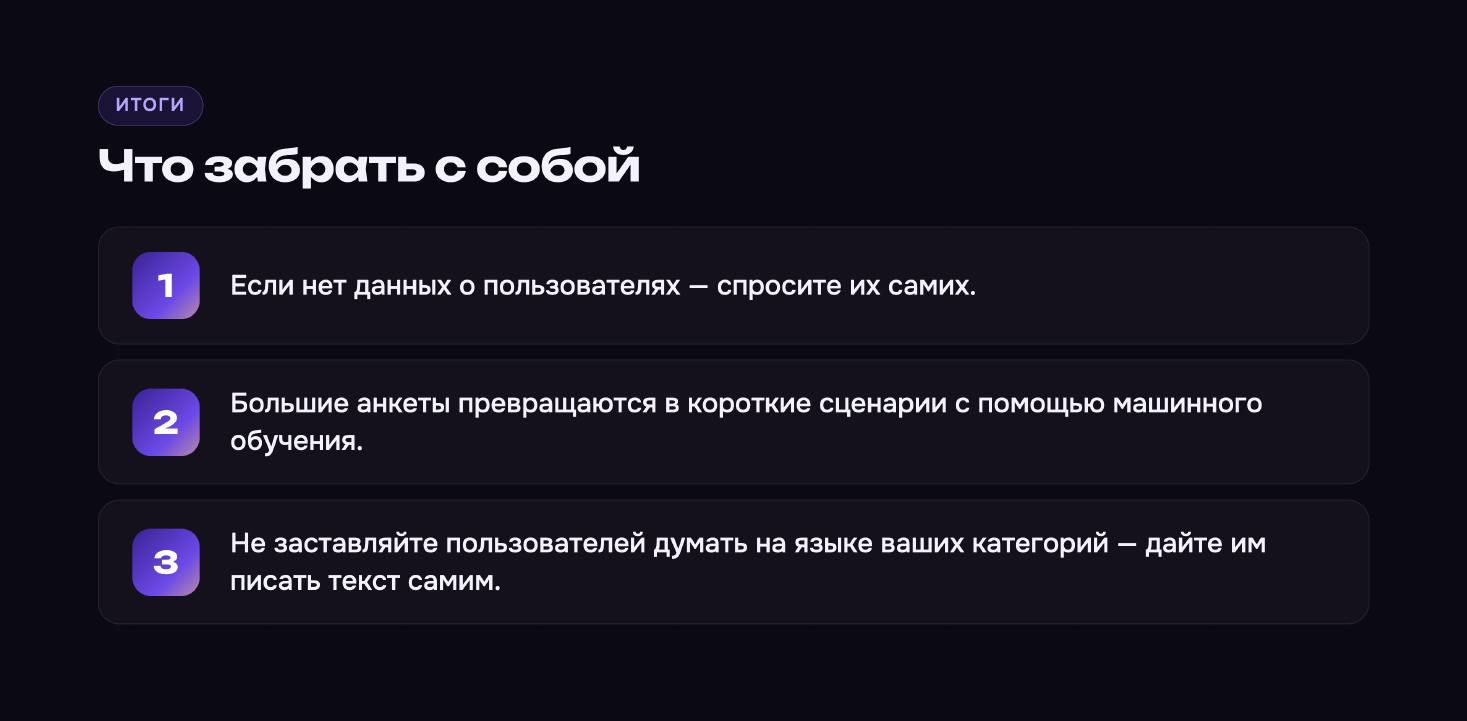
Если нет данных о пользователях — спросите их сами. Опрос тех, кто уже купил, даёт размеченный датасет.
-
Большие анкеты превращаются в короткие сценарии с помощью машинного обучения: 120 галочек сжимаются до трёх-пяти кликов.
-
Не заставляйте пользователей думать на языке ваших категорий. Дайте им писать текст самим и научитесь его понимать.
Гибридный поиск работает на mir-kvestov.ru, попробовать можно прямо сейчас. Там же в чате отвечает наш ИИ-помощник Квестоша, о нём я писал в предыдущей статье.
Мы благодарим фонд Сколково за поддержку инновационных проектов и научных исследований в компании. Вопросы про анкеты, дерево и классификаторы задавайте в комментариях.
Автор: Ipukhov

