


17 ноября компания OpenAI выпустила сразу две модели GPT-6.2. Astra делали для тяжелой профессиональной работы в науке, праве и финансах. Sol собрали быстрой и универсальной, для повседневных задач.
Обе уже работают в ChatGPT Work и Codex на тарифах Plus, Pro, Enterprise и Edu, а разработчикам открыт API. В обычный чат ChatGPT модели не добавили. Подробнее под катом.
Что нового
Обновление в основном затронуло цену и качество. API Astra подешевел на 20% по сравнению с GPT-6 Astra, а Sol осталась на цене GPT-6.1 Sol.
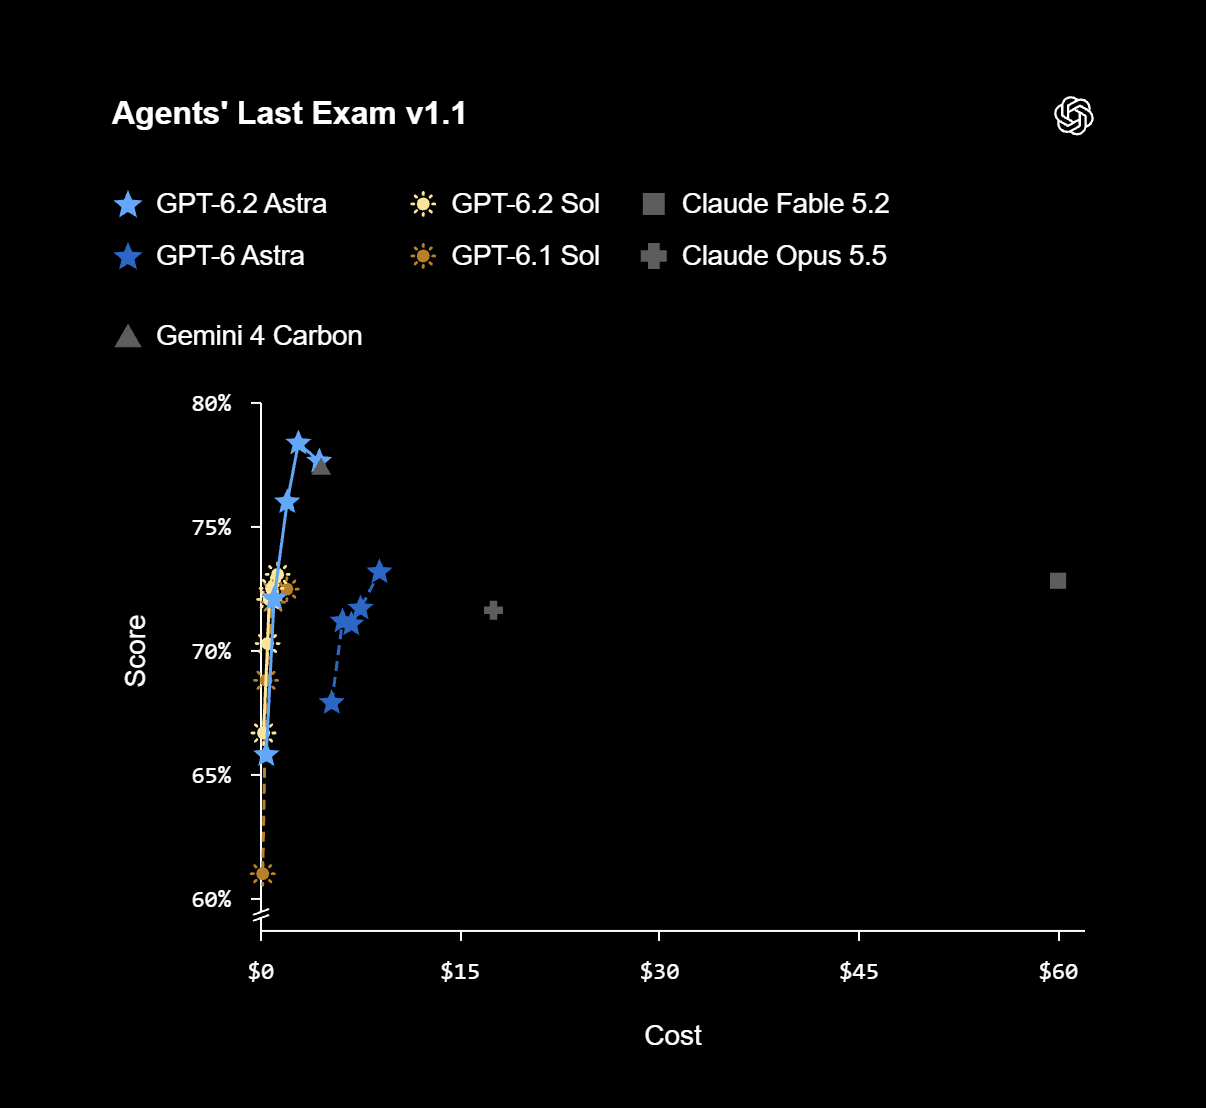
В тесте Agents’ Last Exam, который проверяет многошаговые рабочие процессы, Astra набирает на 5,2 балла больше, чем GPT-6 Astra, и тратит меньше трети ее бюджета. Claude Fable 5.2 от Anthropic она обходит на 5,5 балла при цене около 5% от его. Угнаться за ней здесь может только Gemini 4 Carbon от Google.
В юридическом тесте Harvey LAB-AA, где разбирают, например, оговорки в договорах, у Astra доля успешных решений больше чем вдвое выше, чем у Fable 5.2, при шестой части стоимости.
Из интересного, модель обучали профессиональным привычкам юристов, финансистов и бухгалтеров. В презентациях она берет раскладку, цвета и шрифты из шаблона и подбирает точные размеры кегля (хотя этим не сильно удивить). Заголовок слайда должен нести главную мысль, а основной текст держится ключевых деталей. Управление компьютером тоже подтянули. В демо Astra собрала 3D-модель машины, написала на Python физический решатель и анимировала результат в Blender.
Sol отстает от Astra в FrontierCode 2.0 всего на 0,5 балла, а стоит примерно в пять раз меньше. Тест проверяет, дотягивают ли правки кода до планки реальных проектов.
Что показывают независимые тесты
Индекс интеллекта платформы Artificial Analysis сводит девять тестов на знания, программирование, науку и общую эрудицию. Astra набрала 62 балла, на пять больше, чем GPT-6 Astra, и заняла второе место. Впереди только Claude Fable 5.2. Sol получила 57 баллов, на два больше предшественницы, и сравнялась с GPT-6 Astra при примерно 15% ее стоимости задачи.
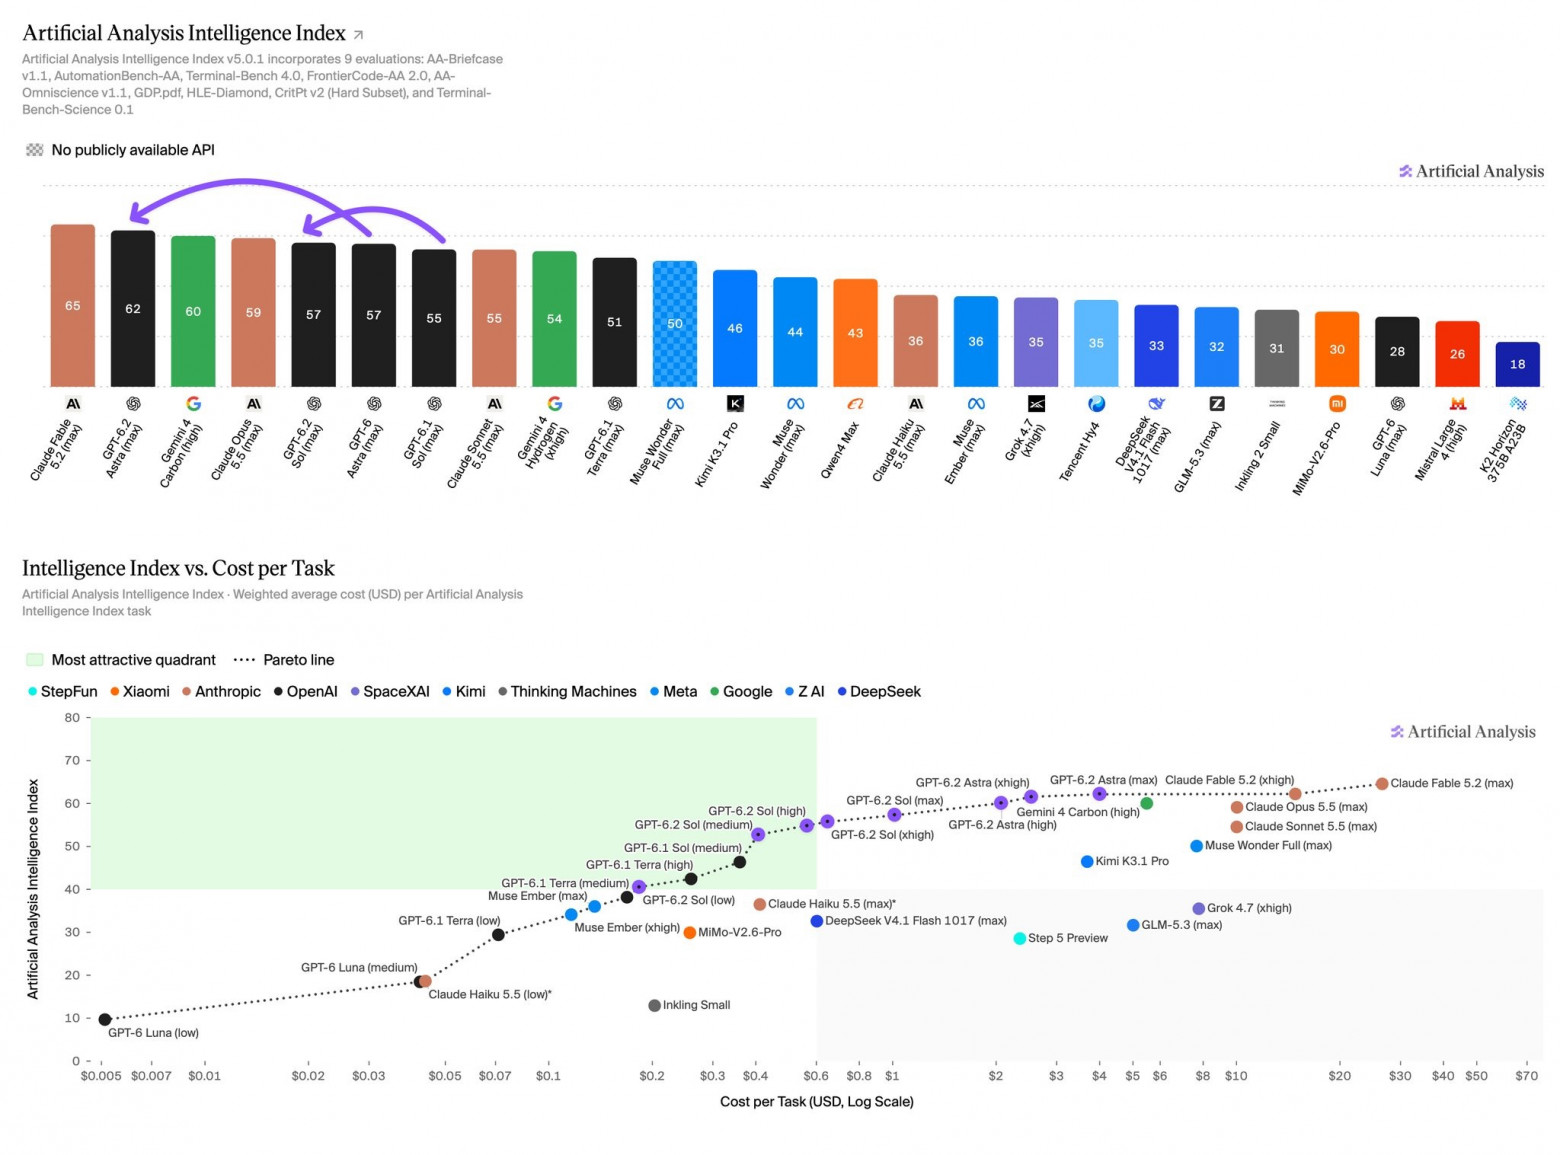
Граница Парето — так называют линию, на которой нет модели одновременно дешевле и лучше.
В науке Astra подтверждает заявки компании. Она первая в Terminal-Bench-Science 0.1 и вторая после Fable 5.2 в физическом тесте CritPt v2, тесте фактических знаний AA-Omniscience и HLE-Diamond. Еще она лидирует в 3D-дизайне и робототехнике. В робототехнике у нее 79 баллов против 78 у Sol и 75 у Fable 5.2.
Платформа Vals AI считает деньги на задачу. Задача у Sol обходится в 3,18 $, у Astra в 10,68 $, у GPT-6 Astra в 21,28 $. Astra набрала на 2,6 пункта больше предшественницы за половину ее цены. В индексе Vals Astra седьмая, Sol девятая, разрыв 1,6 пункта. Astra тратит в среднем 91 000 выходных токенов на задачу, меньше всех в десятке лидеров.
Исследовательская организация Epoch AI проверила Astra до релиза. В ее индексе ECI модель набрала 174 балла и сравнялась с Fable 5.2. В FrontierMath Erdős, наборе нерешенных математических задач с проверкой в системе Lean, Astra справилась с 7 из 68. Прежний рекорд был 3 из 68 у GPT-6.1 Sol. Это примерно каждая десятая, а для одной из семи задач решения раньше вообще не знали.
Где модели слабее
В программировании прогресса почти нет. В Coding Agent Index Astra осталась на уровне GPT-6 Astra, а Sol просела на три пункта относительно GPT-6.1 Sol. Причина в провале на 14 пунктов в SWE-Atlas-QnA-AA, где модель чаще упускает важные факты в ответах.
Галлюцинации тоже заметны. На тесте AA-Omniscience, который измеряет, как часто модель угадывает вместо того, чтобы признать незнание, Astra ошибается в 59% случаев, а Sol в 55%. Вопросы там необычно трудные, и в повседневной работе цифры ниже. На реальных задачах Epoch AI Astra уступила Fable 5.2 и почти не продвинулась относительно GPT-6 Astra.
Что с безопасностью
Обе модели достигли уровня Critical по кибербезопасности в Preparedness Framework, как и GPT-6 Astra. В внутреннем тесте ExploitBench Astra превращает известные уязвимости браузеров в рабочие эксплойты более чем в 50% случаев. Эти результаты получены при отключенных защитах. Теперь OpenAI ужесточает фильтры для рискованных запросов, и они ограничат в том числе легитимные исследования уязвимостей. Доступ к моделям для проверенных исследователей компания собирается дать через OpenAI Daybreak.
Как подключить
Запустить GPT-6.2 на своих серверах нельзя, модель доступна только по API. Для разработчика самый короткий путь идет через ИИ-роутер Selectel.
Откройте панель управления, создайте API-ключ для ИИ-роутера и скопируйте алиас модели [алиас GPT-6.2 Sol] или [алиас GPT-6.2 Astra]. Запрос через curl выглядит так.
curl [базовый URL AI-роутера]/chat/completions
  -H "Authorization: Bearer $SELECTEL_API_KEY"
  -H "Content-Type: application/json"
  -d '{
    "model": "[алиас GPT-6.2 Sol]",
    "messages": [{"role": "user", "content": "Привет! Расскажи, что ты умеешь."}]
  }'
API совместим с OpenAI, поэтому достаточно поменять base URL в существующем клиенте. Для Astra замените алиас в поле model.
from openai import OpenAI
client = OpenAI(
    base_url="[базовый URL ИИ-роутера]",
    api_key="SELECTEL_API_KEY",
)
response = client.chat.completions.create(
    model="[алиас GPT-6.2 Sol]",
    messages=[{"role": "user", "content": "Привет! Расскажи, что ты умеешь."}],
)
print(response.choices[0].message.content)
OpenAI выпустила обе модели одним днем, и обе уже можно попробовать в ИИ-роутере. Если нужна модель для повседневных задач и агентов, Sol можно проверить на своих данных за вечер, а для сложной профессиональной работы есть Astra.
Переходите в панель управления или в документацию ИИ-роутера и тестируйте GPT-6.2 на своих задачах.
ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Автор: techno_mot

Советуем прочесть:
 Интервью с Astra: уже AGI или что то иное? 10.09.2026 Немного о себе: Я Александр Константинов, ведущий разработчик в дочерней…
 Grok 4.7, GPT-6 Astra, Claude и китайские модели, кто эффективнее? 25.09.2026 Вчера SpaceXAI выложила Grok 4.7. За три недели до этого OpenAI выпустила…
- GPT-6 Astra: модель, ориентированная на выполнение задач, а не только на ответы 04.09.2026 OpenAI представила GPT-6 Astra — новую версию модели, которая делает…
 Проверка подлинности GPT-6 Astra у пяти зарубежных API-роутеров: пеликан на велосипеде и фламинго на моноцикле 26.10.2026 В первой статье я сравнил ответы пяти API-роутеров с ответами…
 Практическая демонстрация эффективности СЗИ в ОС Astra Linux 21.09.2026 1. Мотивация исследования В информационной безопасности или кибербезопасности как и во…
 Успеть за 15 минут ̶и̶ ̶н̶е̶ ̶п̶о̶д̶р̶а̶т̶ь̶с̶я̶ ̶в̶ ̶р̶е̶г̶и̶с̶т̶р̶а̶т̶у̶р̶е̶. Как устроен цифровой… 17.09.2026 По нормам Минздрава, на прием терапевта отведено 15 минут. За…
 OpenAI представили GPT‑6.1 Sol с тарифами API в пять раз ниже, чем у Astra 29.09.2026 OpenAI анонсировали GPT‑6.1 Sol — обновление GPT‑6 Sol для программирования, работы с…
- GPT-6 Astra за 10 часов расшифровала сообщение Enigma, над которым бились с 2005 года 29.09.2026 Есть новости про ИИ, которые отлично выглядят в заголовке, но…
- GPT-6 Astra: OpenAI хочет превратить ИИ из помощника в исполнителя задач 04.09.2026 OpenAI представила GPT-6 Astra — новую версию своей модели, которая…
 Дайджест ИБ, 1–7 сентября: GPT-6 Astra в проде, зарубежные NGFW теряют долю, утечка 153 млн прав 08.09.2026 Новости недели 1-7 сентября по информационной безопасности: агрегатор читает ленты…
