



15 сентября 2026 года TypeSafe AI выпустила модель Jev — и в западном AI сообществе это вызвало бурные обсуждения. Я внимательно прослушал интервью с основателем, посмотрел их cookbook и хочу поделиться полным инженерным разбором того, что у этой модели под капотом и почему хайп вокруг неё уместен и имеет право на существование.
Jev не умеет писать текст. Совсем. Это не чат-бот и не LLM в привычном смысле: модель не генерирует токен за токеном, а возвращает распределения над заданными вариантами. Для описания архитектуры CEO использует очень крутой термин Франкенштейнинг. Создание Jev — красивое и очень свежее по вайбу подтверждение того, что LLM давно ушли в сторону от задач, для которых их изначально придумывали. НО!
Я получил огромное удовольствие от идей создания модели и философии основателя.
Давайте разбираться.
Инженерный разрыв для Jev
Мы уже не удивляемся, что фронтирные языковые модели решают олимпиадные задачи, пишут хороший код, управляют браузером и могут рассуждать обо всем на свете. Но когда мы пытаемся встраивать LLM в реальные бизнес-процессы не как чатик, а как кусок бизнес-логики, то происходит странное — огромное количество усилий тратится на то, чтобы заставить модель делать только то, что мы от нее хотим. И делать это стабильно, причем миллионы раз в сутки, каждый раз укладываясь в десятки миллисекунд.
Пример из техподдержки
Для примера возьмём типовое обращение в поддержку авиакомпании: «рейс отменили, замену не предложили, верните деньги, и вообще это третий раз за год а я платиновый клиент». Софт на входе должен решить сразу несколько вещей: это запрос на возврат? насколько клиент зол? какой отдел? нужен ли живой оператор? Потом идет обычный код: проверка сроков чарджбэка, создание заявки, выставление приоритета и так далее
Здесь и возникает странный разрыв: сверхмощный интеллект уже есть, но адекватно встроить в процессы его можно только через разочарование, боль, потом принятие и десятки человекочасов написания эвалов, регулярок и подключения странных библиотек.
Я выразил этот разрыв так:
Мы хотим получить один бит — делать возврат авиабилета или нет — от технологии, которая попутно знает рецепт сырников, всех победителей Лиги чемпионов и первую тысячу знаков числа пи.
Стандартное решение последних лет — системный промпт на пару тысяч токенов со всеми видами текстовых запретов, constrained decoding для верности и флажки запроса с просьбой вернуть JSON. Оно работает, но с издержками: секунда на ответ и полное отсутствие ответа на вопрос «насколько модель уверена в том, что она вообще вернула». И да, у сгенерированной строки нет вероятности (есть logprob, но он не калиброван): "escalate": true выглядит одинаково и когда модель уверена на 99%, и когда она подбросила монетку. Попросить добавить поле "confidence": X не поможет, так как это будет еще одна генерация трансформера, а не измеренная уверенность.
TypeSafe AI
TypeSafe AI — компания из Сан-Франциско, основанная в 2024 году. Основатель и CEO — Диогу Алмейда (Diogo Almeida), соавтор статьи InstructGPT (Ouyang et al., 2022) и участник ранней волны пост-трейна в OpenAI. Его исходный тезис радикальнее, чем «мы делаем еще одну маленькую быструю модель»: индустрия годами оптимизировала модели под разговор с человеком, но с появлением агентов все большим потребителем результатов является софт, а не человек, а значит всё должно выглядеть иначе.
Всё — это действительно всё — модель, ее обучение и итоговый интерфейс взаимодействия. Разработка ПО в 2026 году, по его мнению, почти не изменилась со времен до бума GenAI: рантайм агента собирает отовсюду контекст, LLM продолжает последовательность этих токенов, результат в виде строки парсят обратно в действие. TypeSafe называет это ̶и̶з̶ ̶п̶у̶ш̶к̶и̶ ̶п̶о̶ ̶в̶о̶р̶о̶б̶ь̶я̶м̶ «несоответствием»: систему генерации текста принуждают выдавать структурированные решения, а потом снова восстанавливают структуру парсером.
TypeSafe переворачивает эту конструкцию и возвращает ее к более классической: рантайм изначально передаёт структурированное состояние, внутри которого модель принимает маленькое семантическое решение и возвращает типизированный результат с вероятностью, а дальше работает любой обычный флоу. Рабочая гипотеза компании: крупномасштабная автоматизация будет на ~99% (в оригинали many nines, то есть еще больше) состоять из взаимодействий машины с машиной и редким подключением человека.
TypeSafe называет такой класс моделей System One models, а Jev — первой его реализацией.
Недекоративные названия
Intelligence для real-time мира
Долю экономически ценной работы, автоматизированной моделями сейчас, Диогу оценивает как «пока даже не 1%», а ключевой метрикой (North Star) оценки своих моделей заявлена
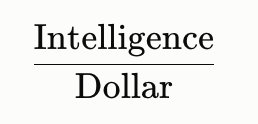
«Intelligence» не измеряется одним числом, и по мнению TypeSafe логика важнее значения метрики: если модель в десять раз дешевле, но для решения задачи требует двадцати дополнительных вызовов — экономия иллюзорна; а если модель в два раза умнее, но в сто раз дороже — фоновые задачи теряют смысл. Задача — искать границу Парето между intelligence и dollar и держать каждую версию около неё.
То есть Jev не пытается победить умные универсальные модели на их территории. TypeSafe целится в архитектуры, где нужно принимать очень быстрое умное решение в реальном времени. Например, если продукт имеет latency budget около 100 мс, сокращение одного AI-вызова с 80 до 40 мс позволяет не только сделать UI быстрее, оно позволяет уложить два последовательных интеллектуальных шага вместо одного — и это может качественно изменить наш опыт взаимодействия с софтом и изобрести такие архитектуры, которые сейчас мы не можем себе позволить.
RLHF, RLVR и RLCD
Здесь начинается наиболее спорная и одновременно интересная часть идей TypeSafe.
Диогу предлагает смотреть на пост-трейнинг не через конкретные алгоритмы вроде PPO, DPO или GRPO, а через цель, под которую оптимизируется модель. Это важное различие. Одну и ту же базовую LLM можно дообучать совершенно по-разному — и в итоге получить модели с разным поведением. После обычного претрейна модель умеет продолжать текст, но это еще не делает модель полезной. Большой сдвиг случился благодаря идеями instruction tuning и RLHF, то есть когда цель поменялась — модели стали оптимизировать не на просто правдободный текст, а на тот ответ, который человек сочтет «подходящим» или «хорошим». Отсюда вырос ChatGPT и другие ассистенты, но TypeSafe задает другой вопрос:
что, если основным потребителем результата будет не человек, а софт?
Тогда критерий «нравится ли этот ответ человеку» перестаёт быть определяющим. Софту не нужен убедительный кусок текста, ему нужно другое:
какой вариант выбрать? насколько вероятно событие? какой объект больше соответствует критерию? насколько можно доверять этому решению?
И именно здесь TypeSafe предлагает изменить задачу: не «дать хороший ответ», а «дать надежное решение, которое может использовать код». Для этого направления компания использует термин RLCD — Reinforcement Learning for Calibrated Decisions. Смысл здесь прежде всего в том, что считается хорошим результатом обучения.
|
Подход |
На что оптимизируется модель |
|
Претрейн |
Хорошо предсказывать продолжение данных |
|
RLHF |
Давать ответы, которые предпочитает человек |
|
RLVR |
Находить результат, который можно автоматически проверить |
|
RLCD |
Принимать надёжные и калиброванные решения для программ |
Это не означает, что RLCD — уже полностью описанный новый RL-алгоритм. На момент сейчас TypeSafe не публиковала технический репорт с деталями, но это может быть качественным архитектурным сдвигом — сейчас RLCD скорее как название новой North Star для пост-трейна: модель должна быть не хорошим собеседником и не решателем задач на бенчмарках, а надежным компонентом любого софта.
Именно поэтому для Jev так важны свойства, которые у чат-модели часто находятся на втором плане: калибровка вероятностей, устойчивость поведения, стоимость одного решения и возможность напрямую встроить результат куда угодно.
Критика RLHF
Диогу считает, что оптимизация под человеческие предпочтения может ухудшать свойства, которые важны для программного использования модели. По его мнению, RLHF отвечает за такие проблемы чрезмерная уверенность, предпочтение красивых ответов правильным и, конечно же, галлюцинации.
Для объяснения он использует аналогию с mode dropping. Представим, что у модели есть несколько правдоподобных вариантов ответа. Если система должна честно моделировать неопределённость, она должна в каком-то смысле сохранять это распределение. Но при оптимизации предпочтений модель получает сильный стимул выбирать ответы, которые люди чаще оценивают как хорошие.
В результате распределение может стать более «острым»: для чат-ассистента это почти всегда полезно, потому что пользователь не хочет видеть двадцать возможных ответов и распределение их вероятностей, он хочет один понятный финальный ответ.
Но для принятия решений в коде скрытие неопределенности оказывается проблемой. Именно поэтому Диогу считает, что chat-оптимизация и decision-оптимизация могут тянуть модель в разные стороны.
API Jev и программные примитивы
LLM-интерфейс выглядит как текст на вход и текст на выход. Jev предлагает другой набор базовых операций: Choice, Noulli, Score. И этой базой закрываются почти все потребности в принятии решений.
Choice: выбрать один вариант
Choice нужен там, где программа должна выбрать один вариант из конечного набора. То есть, по факту выбор из enum с дальнейшей классической обработкой.
Noulli (Noul в документации): вероятность бинарного признака
Noulli — игра со словом Bernoulli. Это операция для вопроса вида: насколько вероятно, что утверждение истинно? То есть, это вероятностный bool.
Score: оценить объект
Score используется там, где объект нужно оценить по некоторому критерию.
Пример входа в json
response = client.system_one(
    model="jev-1.13.0",           # версионный ID, не алиас; причина ниже
    state={
        "ticket": "Рейс отменили, хочу деньги назад, и вообще это третий раз за год.",
        "refund_policy": "Cancelled flights are eligible for a full refund.",
        "history": {"cancellations_12m": 3},
    },
    questions={
        "wants_refund": Noul(
            instructions="Does `ticket` explicitly request a refund?"
        ),
        "department": Choice(
            instructions="Which department should handle `ticket`?",
            criteria={
                "refunds":    "Money back, compensation, chargebacks.",
                "rebooking":  "Wants a different flight or date.",
                "complaints": "Expresses dissatisfaction without a concrete request.",
            },
        ),
        "anger": Score(
            instructions="How angry is the author of `ticket`?",
            criteria=["Calm.", "Irritated but civil.", "Furious."],
        ),
    },
)
Пример ответ в json
{
  "wants_refund": { "noul": 0.94 },
  "department": {
    "choice": "refunds",
    "probabilities": { "refunds": 0.81, "rebooking": 0.04, "complaints": 0.15 },
    "confidence": 0.72
  },
  "anger": {
    "score": 1.38,
    "legend": ["Calm.", "Irritated but civil.", "Furious."],
    "probabilities": [0.10, 0.42, 0.48],
    "confidence": 0.22
  }
}
TypeSafe сама пишет, что для Choice и Score confidence вычисляется из распределения вероятностей: peaked distribution → высокий confidence, flat distribution → низкий. Noul вообще отдельного confidence не имеет.
Если посмотреть на эти конструкции, то они очень похожи на стандартные примитивы языков программирования: Choice → switch / match, Noulli → if, Score → sorting / thresholding. И здесь становится хорошо понятно, на что делает ставку TypeSafe — детерминированное но интеллекутальное принятие решений в реальном времени.
Отличия от инструментов LLM
Каждый примитив действительно похож на тулколинг и их можно реализовать через LLM, но есть принципиальная разница: вызов тулов в LLM это доп интерфейс поверх модели, которая в первую очередь обучалась генерировать последовательности. То есть, решение хоть и зашивается в генерацию, но не является его первичным объектом вычислений. Jev принимает решение нативно и это качественно повышает возможности для его встройки — фактически, результат можно положить в переменную и оперировать им не переживая за «не делай ошибок и вызывай если очень уверен». Реально type safe, ну.
System prompt — глобальная переменная
Ещё одна сильная инженерная мысль TypeSafe касается того, как сегодня строятся LLM-приложения. Типичный агент получает большой system prompt: ты такой-то, вот политика, вот информация, вот правила, вот API. В обычном программировании похожая архитектура выглядела бы примерно как объявление глобальной функции с чтением ее целиком при каждом запуске. И в программировании это считается плохой практикой, Диогу в контексте LLM называет это «отвратительным» и предлагает понятный структурированный вход в виде state, instructions, criteria и передачей всего только необходимого.
Главная инженерная особенность: все вопросы в запросе видят один state, оцениваются независимо и параллельно. Состояние обрабатывается один раз, добавление вопросов «почти не меняет время ответа». У авторегрессионной LLM так не бывает: каждый токен ответа зависит от предыдущих, поэтому даже JSON из четырёх полей генерируется последовательно.
Обратная сторона независимости: ответ одного вопроса в запросе не становится контекстом для другого. Если «нужно ли эскалировать» зависит от «это возврат», второй запрос — или, что правильнее, оба вопроса задаются сразу, а зависимость нужно выражать в коде.
Декомпозиция задачи
Из предыдущего принципа следует достаточно полезная философия: не стоит просить модель решить большую задачу, если её можно разделить на несколько маленьких семантических решений. Переводя на другой язык — никто за вас вашу проблему магически не порешает — ровно то, что понимаешь, когда уже повнедрял LLM в процессы. Все равно нужно декомпозировать и разбираться в деталях.
Здесь эта идея возведена в культ — надо разбить каждый сложный процесс на небольшие понятные «семантические единицы» с решениями и Jev может помочь в каждом из них. Это позволяет отнести модель к классу Programmable AI — таких решений, которые уже не просто детерминированный код, но и не черная магия в коробочке.
Декомпозированные системы обладают кучей преимущество — их легко тестировать, они интерпретируемые и понятные.
В чем новизна
Если идея маленьких независимых AI-функций настолько естественна, но почему большинство LLM-приложений строятся иначе? Потому что до сих пор экономика работала против такой архитектуры. И в каком-то виде природа человека тоже на это повлияла.
Если сравнить одну задачу, которую можно разбить на 100 независимых маленьких проверок, то варианта два: либо 1 большой вызов умной модели или 100 маленьких вызовов. Исторически второй вариант был сильно хуже — по всем измеряемым параметрам (в том числе таком, что это 100 обращений к машине вероятностей), поэтому все складывалось в один большой промпт-контекст и отсылалось в модель поумнее.
Но если стоимость принятия решения не проигрывает по качеству, но становится на порядке дешевле, то при правильной декомпозиции второй вариант становится выигрышнее — он становится доступнее, надежнее и легкотестируемее. Про параллелизм Диогу подчеркивает отдельно — в реальных системах множество решений можно принимать параллельно.
Надежность важнее «просто детерминизма»
Отдельно TypeSafe проводит важное различие между детерминизмом и робастностью.
Детерминизм означает одинаковый результат на одинаковых входных данных. Но если AI всегда ошибается, то такой AI детерминированный — да, но и бесполезный. Просто повышения детерминизма недостаточно, нужна семантическая устойчивость: «Customer wants a refund» и «Customer wants a refund. request_id=4a92f1» должны давать одно и то же решение. TypeSafe отдельно тестирует такие конструкции — они из реального мира внутри систем, а не из человеческого общения — добавляя UUID или nonce и замеряя, поплыл ли ответ.
Но границы у этой робастности есть, и TypeSafe их сама честно описывает. Во-первых, нерелевантный мусор в state роняет точность — модель страдает от того же context rot, что и LLM, поэтому фильтровать вход рекомендуют в коде до вызова. Во-вторых, state не считается враждебным по умолчанию: текст, написанный так, чтобы сдвинуть решение, его сдвигает. В-третьих, не стоит ждать от модели структурных инвариантов, которые кажутся очевидными. Их же пример: на одном тикете Noul «клиент просит возврат» даёт 0.72, а Noul «клиент просит что-то другое» — 0.47. В сумме 1.19, а не 1.0. Порог, подобранный для Noul, нельзя переносить на Choice с теми же вариантами, и наоборот.
То есть робастность здесь — к шуму, а не к смыслу. Nonce в конце строки решение не меняет; абзац, который спорит с собственной классификацией, — меняет. Для роли «дешёвый control plane над агентами» это важное ограничение, и к нему в конце я еще вернусь.
Цель: будничность AI через девятки
Сегодня мы хорошо чувствуем, где начинается LLM — по всему харнессу вокруг нее. TypeSafe хочет стереть эту границу, ставя цель добавление дополнительных девяток в надежность результата. Не сделать модель абсолютно безошибочной (в мире AI это невозможно), а дойти до уровня, когда разработчик вообще перестает сомневаться можно ли сюда одновременно затащить модель и спокойно спать по ночам.
Идеальная конструкция — это все еще код, но на другом уровне:
if semantic_probability(message, "user wants to cancel subscription") > 0.97:
  do_something()
TypeSafe — data lab
При всей необычности Jev, TypeSafe не особенно пытается продать эту историю как «мы придумали новую архитектуру нейросети». Наоборот, Диогу несколько раз называет компанию data lab, а людей, которые занимаются возможностями модели, по сути data people.
Логика понятна и знакомая всем, кто хоть раз пытался довести LLM-фичу до прода: модель и харнесс важны, но последние проценты качества обычно добываются совсем не красивым копанием и сбором всех edge-кейсов.
То есть процесс обучения примерно такой: нашли класс ошибок, поняли, что именно модель систематически не умеет, собрали данные, проверили, что новая версия действительно исправляет общий случай, а не конкретный тест, повторили еще несколько сотен раз.
Причем TypeSafe утверждает, что не хочет учиться на пользовательских данных даже там, где это технически возможно. Причина не столько в приватности, сколько в распределении самих данных. Реальный пользовательский трафик всегда имеет длинный хвост и очень жирную голову: большая часть людей спрашивает примерно одно и то же. Если тупо оптимизироваться по этому трафику, модель быстро станет хорошей на сегодняшних популярных кейсах, но постепенно начнет переобучаться на настоящее.
А TypeSafe хочет обратного — чтобы модель оставалась достаточно общей для тех программных сценариев, которых сейчас еще вообще не существует.
Это довольно важный момент. Все обучается на синтетических данных и под синтой они имеют в виду не «попросили GPT нагенерировать миллион примеров», а полностью искусственно построенное распределение задач под конкретную North Star. У RLHF свои данные, у RLVR свои среды и проверяемые ответы, у RLCD должен быть свой тип данных. Как именно они это строят — публично пока не рассказано, очень ждем, должно быть интересно.
The Bitterest Lesson
Из этой мысли Диогу приходит к своей версии знаменитого The Bitter Lesson Рича Саттона.
Оригинальная мысль Саттона сильно упрощенно была в том, что универсальные методы, которые умеют эффективно поглощать больше компьюта, исторически побеждают ручные эвристики исследователей.
Диогу считает, что перед вопросом компьюта есть еще один, более важный:
а правильную ли задачу мы вообще оптимизируем?
Этот вопрос вообще лучше себе задавать всегда, но, увы, его так сложно себе задать. Можно бесконечно улучшать архитектуру, увеличивать датасет, размер модели и RL, но если выбранная функция ведет не туда, больше компьюта просто позволит быстрее туда приехать.
Именно поэтому главным достижением InstructGPT он считает не PPO. Главным достижением было то, что команда в какой-то момент сказала: «хватит просто хорошо продолжать интернет, давайте учить модель выполнять инструкции».
Модель архитектурно не превратилась в что-то принципиально новое, зато смена задачи полностью поменяла то, как этот интеллект начал использоваться.
Теперь TypeSafe пытается провернуть тот же трюк еще раз: не улучшать бесконечно instruction following, а поменять саму задачу на надежное программное принятие решений.
Это и есть их Bitterest Lesson: сначала правильная задача, потом данные, обучение и только потом компьют.
Миллиард долларов на претрейн? Нет
Если бы TypeSafe дали миллиард долларов, то он не станет тратить его на собственный претрейн. Не потому что претрейн бесполезен, нет, без него всего не существовало бы.
Просто на текущем этапе индустрии уже существует огромное количество очень дорогого pretrained intelligence, а повторно покупать примерно тот же самый интеллект за миллиард — не единственный способ двигать фронтир вперед.
Можно брать существующие модели, дообучать их, специализировать, комбинировать, строить каскады, дистиллить, менять пост-трейн и вообще делать то, что Диогу сам довольно честно называет Франкенштейнинг (Frankensteining).
И это важная оговорка для всех попыток угадать «что внутри Jev». TypeSafe не раскрывает архитектуру достаточно подробно. Мы не знаем размер модели, не знаем, одна ли это вообще модель в привычном смысле, нет опубликованной схемы MoE или какого-то нового механизма внимания. Сам Диогу лишь несколько раз говорит, что ради intelligence per dollar внутри делаются довольно мерзкие (лол!) с точки зрения архитектурной чистоты вещи — в хорошем смысле этого слова.
Так что дорисовывать красивую архитектуру по косвенным признакам здесь не стоит: открытых данных сейчас для этого недостаточно.
Каскады моделей
Зато из хорошо калиброванной уверенности очень естественно рождается одна архитектура, которую TypeSafe уже открыто обсуждает: каскады.
Допустим, у нас есть маленькая, средняя и большая модели. Маленькая самая дешевая, большая самая умная. Это, кстати, быстрый ответ на вопрос зачем у каждой фронтирной лабы по три модели.
Если маленькая модель отвечает с условными 99.9% уверенности, запускать большую вообще незачем. Если она выдает 51%, запрос можно передать следующей модели. Та либо принимает решение, либо эскалирует дальше.
По факту это позволяет покупать дорогой интеллект только там, где он реально понадобился. Средняя цена вызова тогда определяется не ценой самой большой модели, а тем, какая доля запросов вообще до нее доходит.
Это вообще не новая идея сама по себе — каскады моделей существуют давно. Но калибровка Jev делает ее очень естественной частью API: конфиденс тут нужен не для красивого вывода пользователю, а буквально для управления дальнейшими вычислениями.
Диогу прямо говорит, что TypeSafe хочет иметь разные точки на Парето и допускает динамический выбор модели в зависимости от сложности конкретного участка системы.
Где это вообще использовать
У TypeSafe есть несколько больших семейств применений, и тут уже становится понятнее, зачем вообще настолько упарываться в цену одного маленького решения.
Dark data
Первый — то, что они называют dark data.
У больших компаний лежат гигантские объемы данных, которые технически доступны, но семантически почти не анализируются: тикеты, звонки, CRM, логи, сообщения пользователей, чаты операторов, события внутри продукта.
Не потому что эти данные неинтересны, а потому что прогонять через большую LLM миллиарды записей слишком дорого.
Если же маленький семантический вопрос стоит совсем дешево, появляется возможность один раз прогнать через историю вопросы уровня «пользователь злой?», «обсуждалась цена?», «был обещан возврат?», «упомянут конкурент?» и превратить огромный неструктурированный массив в обычные признаки, которые дальше уже прекрасно отлетают в ClickHouse, Spark и что угодно еще.
То есть Jev здесь вообще не генератор текста. Это semantic feature extractor на очень большом масштабе и на максималках. И, кажется, именно здесь идея intelligence per dollar раскрывается лучше всего. Один вызов модели может быть не особенно впечатляющим, но миллиард таких вызовов может блокировать множество классных инициатив.
Здесь же $0.042 за 1M входных токенов, выход бесплатен; 64k токенов на запрос, state биллится один раз на весь список вопросов — оочень хорошо!
Verify everything
Второй большой сценарий — дешевые проверки вокруг больших моделей.
Есть ризонинг-модель, которая сделала сложную работу, вызвала инструменты, что-то нашла и вернула ответ. Сегодня мы часто либо доверяем результату, либо запускаем еще одну такую же дорогую модель в роли судьи/критика.
Если семантическая проверка действительно становится дешевой, проверок можно сделать много: соответствует ли результат политике, не противоречит ли он данным, правильный ли выбран тул, есть ли признаки галлюцинации, нужный ли объект вернулся из поиска.
Получается что-то похожее на runtime assertions вокруг недетерминированной программы. Большая модель делает сложную работу, маленькая постоянно проверяет отдельные свойства результата.
Мне эта идея кажется сильно интереснее классического «LLM-as-a-judge», просто потому что этот самый judge перестает стоить примерно столько же, сколько исходная операция.
Real-time intelligence
Третья категория — все, где решение нужно прямо внутри пользовательского цикла: computer use, голос, игры, рекомендации, интерактивные интерфейсы.
И здесь разница между 500 мс и 30 мс уже не про приятный UX, а про целесообразность и минимальный SLA вообще.
Очень хороший пример — игры. Не нужно генерировать NPC по странице текста каждую секунду, можно оставить обычную стейт-машину, но дать модели выбирать отдельные переходы на основании сложного состояния мира. То есть игра остается нормальной игрой со всеми ее правилами, просто некоторые переходы становятся семантическими, а не захардкоженными.
Smart software
И наконец самая широкая категория — то, что TypeSafe называет smart software.
Идея буквально в том, что раньше программа умела хорошо работать с числами, строками, датами и строгими правилами, а теперь внутри обычного кода появляется возможность дешево вычислять еще и смысл.
### НЕ
if country == "RU" and age >= 30:

### А
if wants_to_pay(message) > 0.97:
Это маленькое изменение в синтаксисе, но довольно большое в модели программирования.
Смысл, намерение, релевантность, тональность, сходство начинают вести себя как обычные вычисляемые свойства данных и выглядят как одна строчка в привычном коде.
Coding agents и тирания KV-cache
Диогу считает, что текущая архитектура кодинговых агентов в огромной степени определяется не тем, как мы хотели бы строить агента, а экономикой KV-cache (я тоже так считаю!).
Сегодня Claude Code, Codex и похожие системы держат большую часть работы внутри одной сильной модели и постоянно дописывают новые события в один длинный контекст.
Это кажется естественным, но на самом деле причина довольно низкоуровневая.
В трансформерах для уже обработанных токенов сохраняются key/value тензоры внимания, когда мы дописываем в конец контекста новые токены, модель не обязана заново вычислять K/V для всего старого префикса. Поэтому продолжать ту же самую сессию той же самой моделью дешево относительно полного пересчета контекста.
И эта особенность начинает диктовать архитектуру всей системы.
Допустим, у агента уже 150 тысяч токенов состояния и ему понадобилось сделать простую задачу — найти определение класса.
Инженерно хочется отправить ее маленькой дешевой модели.
Но маленькая модель не имеет уже сформированный KV-cache большой. Чтобы понять контекст задачи, ей нужно заново прочитать достаточно большую часть состояния. И в какой-то момент такой роутинг становится дороже, чем просто продолжить спрашивать ту же дорогую модель.
В итоге получаем то, что Диогу называет tyranny of the KV cache: мы держимся за один гигантский контекст и одну модель не обязательно потому, что это лучший software design, а потому, что экономика такого инференса очень сильно наказывает альтернативы.
Отсюда же растут сразу несколько знакомых проблем: компактизация, дорогие субагенты, сложности с роутингом моделей и вечное желание впихнуть в текущий контекст еще что-нибудь полезное, потому что «оно уже закэшировано».
И вот тут Jev потенциально интересен, но не как модель, которая тянет кодингового агента.
Он интересен как дешевый control plane вокруг кодинговых моделей.
Например, хранить состояние агента отдельно и спрашивать маленькую модель, какой кусок этого состояния нужен текущей подзадаче. Или выбирать, какой модели отдать конкретный шаг. Или искать релевантное решение среди предыдущих подзадач. Или отдельно проверять, что вернул субагент-работяга.
То есть сильная модель продолжает писать сложный код, а вокруг нее появляется дешевый слой решений, который занимается маршрутизацией, памятью и контролем. И это уже начинает напоминать нормальную контролируемую распределенную систему, а не чат, который мы очень долго дописываем в конец.
Память агента — это тоже retrieval
Сегодня агент начинает новую сессию и в каком-то смысле снова узнает проект. Можно писать саммари, складывать воспоминания, вести свежийAGENTS.md, но предыдущий опыт все равно находится где-то отдельно и сам по себе в рабочий контекст не попадет.
Обычно это описывается как отдельная большая проблема continuous memory.
Но если посмотреть глазами TypeSafe, это в значительной степени обычная задача поиска по состоянию. За предыдущие сессии у нас уже накопились решения, измененные файлы, ошибки, тесты, результаты исследований, куски архитектуры. Не обязательно тащить всё это в модель, но нужно уметь дешево понять, какие именно части истории относятся к текущей задаче.
То есть проблема становится гораздо менее мистической: хранить стейт отдельно, нормально его размечать и делать семантический ретрив перед каждым конкретным действием.
Тот же принцип можно применить к нескольким агентам. Если два воркера работают параллельно, им не обязательно постоянно пересылать друг другу полные контексты. Они могут иметь общее структурированное состояние и читать только релевантные части.
Диогу даже рассуждает про координацию таких агентов на уровне того, кто сейчас должен писать, кто только читает и какой кусок стейт кому доступен. Пока это скорее направление для экспериментов, чем готовая архитектура, но мысль хорошая: мультиагентная система без хорошего стейт-менеджмента превращается в очень дорогой (и малополезный) чатик нескольких дорогих моделей друг с другом.
Почему TypeSafe не любит публичные бенчмарки
Еще одна довольно принципиальная позиция TypeSafe — отказ делать публичный бенчмарк главной метрикой модели. При этом измерения внутри есть: бенчмарки, эвалы и все-все.
Проблема начинается в тот момент, когда внешний бенчмарк превращается в цель. Тут работает старый добрый закон Гудхарта: как только метрика становится целью, она перестает быть хорошей метрикой. В LLM мире способов случайно или намеренно «подкрутить» бенч огромное количество: контаминация, подбор похожих тренировочных данных, специальные промпты, отдельные оптимизации под формат задач.
Диогу вспоминает, что еще во времена MMLU лаборатории могли просто собирать данные, очень похожие на MMLU. Формально это не обучение на тесте, практически — ну мы же все понимаем.
Поэтому TypeSafe предлагает достаточно скучную, но правильную вещь: если вам надо маршрутизировать тикеты поддержки, лучшими эвалами будут ваши тикеты поддержки. Не MMLU. Не JevBench. Не среднее число из двадцати бенчей.
Правда, есть очевидная обратная сторона: когда компания принципиально не показывает публичные бенчмарки, независимо проверить заявления о качестве сильно сложнее. Но все же, в своем cookbook они все же какие-то цифры показали.
Отказы как type error
Еще один довольно холиварный тезис Диогу касается отказов модели.
Для ChatGPT отказ — нормальная часть продукта. У OpenAI есть своя политика работы, пользователь общается непосредственно с их продуктом и получает либо ответ, либо отказ.
Но если модель становится глубокой зависимостью бэкенда, поведение начинает выглядеть странно. Мы вызываем функцию, которая должна вернуть вероятность, enum или score, а она в какой-то момент по собственной внутренней политике решает вернуть «извините, я не могу помочь».
Диогу буквально сравнивает это с type error. Аргумент TypeSafe состоит не в том, что безопасность вообще не нужна. Он считает, что политика должна находиться на уровне конечного продукта, а не быть неотделимой частью самого intelligence API.
Разные продукты могут иметь совершенно разные допустимые риски и пороги. Детский продукт, банковская система и условный AI Dungeon очевидно должны по-разному принимать решения. Если это зашито в саму модель, управлять этим разработчик может только очередным «please do not» в system prompt.
С точки зрения чистоты API аргумент очень понятный. С точки зрения реального мира все сложнее: есть законодательство, абьюзинг, ответственность провайдера и куча вещей, которые нельзя просто вынести наверх в пользовательский код. Поэтому здесь я бы воспринимал позицию TypeSafe именно как архитектурную крайность, которая хорошо подсвечивает проблему, но хорошо рецепта тут нет.
Версионирование
Еще одна вещь, о которой внезапно мало говорят применительно к моделям: если AI действительно становится зависимостью, его нельзя тихо менять под ногами. Для чата обновить бэкенд с модели 1.13 на 1.14 и получить немного другой стиль ответов — может быть нормально.
Но если ваш бэк принимает бизнес-решения на основе конкретного распределения вероятностей, уже нет. Допустим, на версии 1.13 вы подобрали к чему-то трешхолд 0.93, прогнали эвалы, получили нужный precision/recall и выкатили это в прод.
Если завтра под тем же именем провайдер незаметно поставит другую модель, даже «в среднем более умную», трешхолд может стать неправильным.
Поэтому TypeSafe обещает не менять уже выпущенную версию модели под тем же version ID (так Диогу говорит в интервью, но в их доке явного обещания так не делать нет). При этом вечный LTS для всех релизов тоже невозможен: компания хочет выпускать новые версии быстро, а поддерживать сотню старых моделей на GPU — очень дорогая роскошь.
То есть здесь они довольно быстро упираются в классическую инфраструктурную проблему совместимости: инновации хочется выкатывать быстро, но зависимости ломать нельзя.
Так что же здесь нового
Если раскладывать Jev на компоненты отдельно, почти все уже существовало. Классификаторы, reward models, каскады, семантический роутинг, LLM-судья и уже тем более structured outputs и function calling. Если раскладывать Jev на компоненты отдельно, почти все публично понятные компоненты уже существовали.
Новизна здесь в том, вокруг чего собрана вся система.
Последние годы базовой единицей AI-программирования был промпт. Мы научились строить вокруг него раги, тулы, агентов, заниматься контекст инжинирингом, упарывались по KV-кэшингу и много чего еще.
TypeSafe предлагает сделать основной единицей не промпт, а маленькую семантическую функцию.
Условно:
duplicate(a, b)
relevance(document, query)
choose_support_queue(ticket)
То есть не просить LLM сгенерировать ответ, который мы потом превратим обратно в значение, а сразу обращаться к модели как к вычислителю семантического свойства.
Само по себе это не выглядит революционно. Но если такая функция одновременно дешевая, быстрая, хорошо калиброванная и достаточно надежная, то архитектура программы действительно начинает меняться.
Если у них получится — это может изменить архитектуру многих систем.
Где пока вопросики
Мне оочень нравится философия TypeSafe. И не мне одному, судя по огромному хайпу вокруг их лабы и Jev. Но что пока есть?
Первое — мы не знаем деталей RLCD. Есть название, философия, работающая модель, но нет нормального технического репорта. Поэтому сейчас невозможно понять, насколько RLCD — действительно новый метод трейна, а насколько удачная новая постановка задачи поверх известных методов.
Второе — нет хорошей независимой картины качества. Позиция против публичных лидербордов понимаема, но ведь и все рады бы там не замеряться, но какие альтернативы? Просто доверие?
Третье — System One не отменяет reasoning.
В самом интервью обсуждается, что Jev хорошо работает на single-hop задачах и хуже по мере роста количества зависимых шагов. Это абсолютно нормально и на самом деле даже хорошо укладывается в их философию: не надо заставлять один тип модели делать вообще всё. Но это лишь определенный класс моделей, требующий достаточно низкоуровневого понимания работы систем и софта.
Четвертое — confidence не является магией.
Если модель говорит 0.93, это полезно только в том случае, если на нашем датасете это реально 0.93. Поэтому эвалы, мониторинги и фолбэки никто не отменял.
И пятое — самая большая проверка еще впереди: философия хорошо, но многие LLM уже годами проходят проверку продом, а здесь это все только предстоит. С миллиардами вызовов, разными доменами и теми самыми горами пограничных случаев. К слову, TypeSafe сама отдельно предупреждает, что adversarial-атаки внутри стейта могут сдвигать решение — для роли control plane над агентами это может быть важным ограничением.
Но идея — просто блеск.
И да, по железу — вопрос тоже пока не раскрыт, но публично заявляется об интересных оптимизациях.
Что мне во всем этом нравится
Мне Jev был интересен не потому, что это еще одна модель, которая лучше кого-то на каком-то тесте. Честно говоря, совсем не интересно читать, что фронтирная лаба выпустила новую версию своей и так мощной модели (но ресеты по этому повоуд бесконечно люблю), гораздо интереснее читать про тех, кто пытается делать что-то концептуально новое, при том что очень привязанное к практике.
Последние годы движение было почти односторонним: модель должна быть универсальнее, контекст длиннее, ризонинг глубже, а агент автономнее.
TypeSafe предлагает практически обратную идею: давайте возьмем огромный претрейн-интеллект, вытащим из него дешевую способность принимать очень маленькие решения и вернем нормальную часть ответственности обратно в код. Не «пусть AI управляет всей системой» или бизнесом целиком, а «воот конкретное место, где обычной программе не хватает семантики».
И эта идея хорошо ложится на то, куда вообще движется production AI.
Модели становятся разными. Где-то нужен тяжелый ризонинг. Где-то вижн. Где-то быстрый классификатор. Где-то маленький проверятор. Где-то вообще обычный if, который назвали агентом.
Возможно, следующий хороший AI-рантайм будет не вокруг одного большого агента, а вокруг умения нормально собрать все эти компоненты вместе. И если Jev окажется первым реально удачным универсальным примитивом для такого System One слоя — хайп вокруг него действительно был не зря.
Но даже если конкретно Jev через два года исчезнет, сам вопрос TypeSafe, кажется, уже никуда не денется:
почему мы до сих пор пытаемся использовать одну и ту же форму модели и для разговора с человеком, и для принятия миллиарда маленьких решений внутри софта?
И вот на этот вопрос у индустрии пока как будто бы действительно нет хорошего ответа.
Спасибо!
Мой канал про агентов, LLM, продукты и людей: Agentic World и другие статьи:
Автор: antipov_dmitry

