


1. Рутина душит
Однажды услышав про Obsidian и увидев красивую картину, где мысли переплетаются друг с другом и образуют стройную систему, которой удобно пользоваться, я тоже решил, что мне это нужно. Установив и запустив приложение я увидел… удручающую картину, я увидел пустоту. Пустоту, которую мне нужно было заполнить. Я побежал смотреть уроки, а после заполнять свою базу знаний. Мне скорее хотелось увидеть, как то, что я узнал, построиться в граф знаний. Но столкнувшись с тем, что мне придётся учиться делать заметки, связывать их друг с другом, да и просто выделять и записывать важное из всей информации урока, моё рвение резко испарилось.
После этого я больше и не открывал Obsidian, решив, что удобнее учиться мне от этого не станет. Мне также не хотелось искать подходящие плагины, потому что это было долго. Я представлял себе этот процесс лёгким и непринуждённым, когда поток звука и текста проходящего по информационным каналам сам складывается по коробочкам и встает на нужные полочки, а для меня в Obsidian уже лежат готовые заметки, которые сразу можно читать.
Сказка… Или нет? Я так уж и быть нашел силы спросить у ChatGPT о существовании подобных инструментов и узнал об автоматических ИИ помощников, они помогали искать заметки, могли пользоваться ими, но не один не воплощал в жизнь мои заветных желания. Возможно, копнув глубже, я бы нашёл, то что мне нужно, но я всё‑таки я и сам разработчик, нуждающийся в хороших кейсах, демонстрирующих мои навыки, чтобы наконец‑то кто‑то предложил мне стажировку (хоть на собес позовите 0_0). Было принято решение создать такой инструмент самостоятельно.
2. Мой идеальный Obsidian
Сперва нужно разобраться, как должно работать то, что я хочу получить. Представим это в виде pipeline информации:
-
Я открываю YouTube, слушаю подкаст, читаю статью, не важно, инструмент должен уметь работать с любым приложением на компьютере, а не привязываться к конкретным.
-
Естественно, я смотрю, или слушаю, или читаю этот источник информации
-
После самостоятельного ознакомления с материалом, я открываю Obsidian и вижу готовые заметки.
Преимущественно информацию мы получаем через звук и текст. Также есть видео и картинки, но обычно в обучающих видео они визуализируют то, что мы слышим. Чтобы не привязываться к конкретному приложению, будем читать системный звук ОС, а текст можно получать, к примеру, из буфера обмена.
Далее эту информацию нужно обработать. Для этого, конечно нужно использовать LLM. Но я бы точно не хотел, чтобы моя личная информация отправлялась в чужие облака, к тому же инструмент хочется сделать бесплатным. Поэтому LLM мы выбираем локальную. Она постоянно обрабатывает непрерывный поток информации и выдает нам структурированные ответы.
Далее эти ответы нужно просто сохранить, например, в.md файлах, обычным алгоритмом построить их и положить в хранилище Obsidian. Далее мы просто открываем, смотрим и наслаждаемся тем, что не тратили сил на построение нашей базы знаний.
3. Создание прототипа
После того, как цели стали ясны, я приступил к созданию прототипа. Я решил, что работать со звуком будет сложнее и интереснее всего, поэтому с него и начал. Чтение системного звука, это как ни странно работа с ОС. Так как на разных ОС этот механизм может сильно различаться, необходимо было определиться с первой платформой. Я выбрал Windows, так как у самого Windows ноутбук, да и в мире это самая популярная платформа. В дальнейшем также появились причины не распылятся и сделать инструмент для одной платформы.
Написав часть программы, читающей звук, я начал получать его в виде байт. Я был неуверен, что LLM сможет сама расшифровывать его, поэтому интегрировал Whisper в свой пайплайн. Это небольшая модель, разработанная специально для транскрибации аудио. Из потока байт он формировал chunks текстовой информации, которые уже можно было скормить LLM.
Появился вопрос, как много чанков нужно скормить LLM, чтобы она выдавала качественные ответы. Сложность вопроса состоит даже не в количестве передаваемых чанков, а в том, какие чанки будут входить в набор. К примеру, у нас есть фраза: «Докер — это инструмент для контейнеризации». Возможна ситуация, когда мы получим два чанка (или две группы чанков), текст в которых будет: «Докер — это инструмент» и «для контейнеризации». LLM будет обрабатывать каждый чанк по отдельности, без контекста предыдущего.
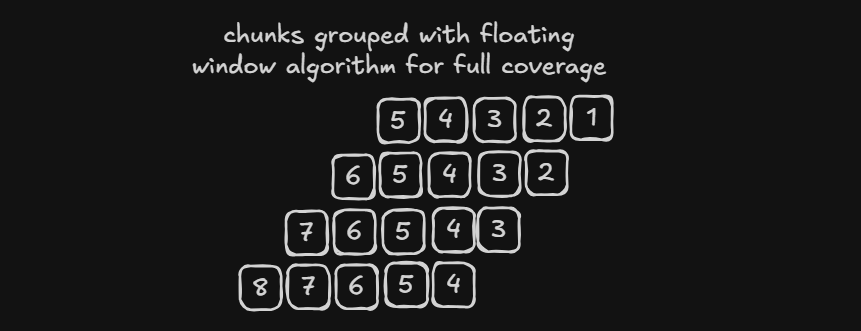
Самым наивным методом было объединять чанки в группы так, чтобы часть последних чанков предыдущей группы было началом группы следующей, так называемое FloatingWindow, таким образом часть контекста будет передаваться в следующую группу, что снизит частоту появления ситуаций недостатка этого самого контекста.
Следующий шаг, это поднять инференс и запустить в нём какую‑нибудь LLM. На эту роль я выбрал этих кандидатов: llama.cpp в качестве инференса и Qwen3-4B‑Q4 в качестве LLM обработчика, компактная и умная модель.
Чтобы все заработало, нужно подготовить промпт, который объяснит LLM, что она должна делать, и прикрепить текст который она должна обработать. В промпте нужно указать, чтобы LLM выдавала нам .json формат для того, чтобы мы могли автоматически распарсить ответ в необходимую нам структуру.
И вообщем‑то, все готово, звук бежит, Whisper делает транскрибацию, LLM выделяет заметки, мы радуемся.
4. Делаем лучше
Чтобы в дальнейшем вести повествование, определю некоторые термины и нюансы, которые я выделил в процессе разработки.
-
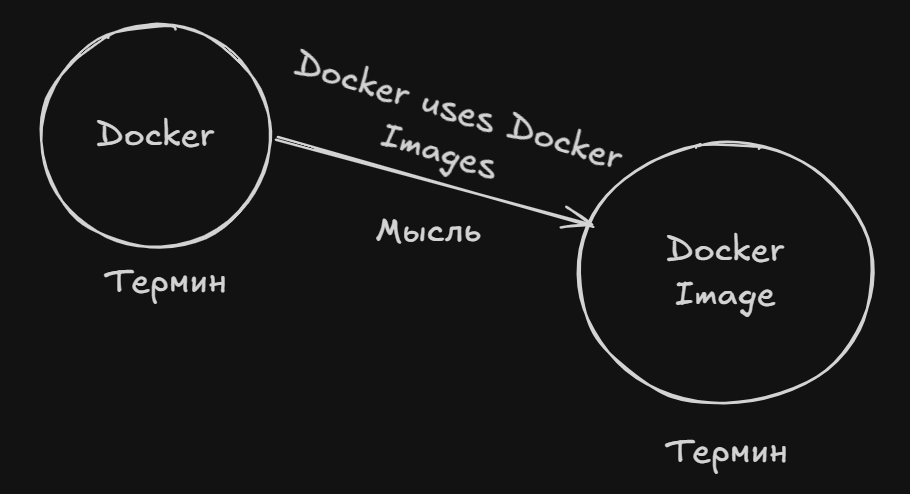
Термин — самодостаточная сущность у которой есть имя и определение
-
Мысль — сущность, связывающая между собой несколько терминов
-
Конспект — набор терминов и мыслей, получается на выходе работы LLM по преобразованию группы чанков
4.1 Новые механики
Первое, что было допустимо в прототипе, но нельзя было оставлять в финальном варианте приложения, это ответы LLM. Всё дело в том, что мы не можем быть уверены в том, что она выдает нам информацию ровно такой, какой мы хотим её видеть в нашей базе знаний. Чтобы не засорять её, обязательно нужно добавить этап ручного подтверждения пользователем добавления информации в базу. Кроме того, тут же должны появиться механизмы проверки входящей информации на схожесть с уже существующей в базе, ручное редактирование входящей информации и того, что мы записываем в базу. Тут может показаться, что мы отходим от первоначальной идеи полной автоматизации, но на самом деле LLM и так колоссально сокращает время на составление заметок, выдавая нам свой, возможно, не вполне идеальный вариант, который мы быстро редактируем и подтверждаем. Это делает систему только надежнее, не убивая скорость заполнения.
4.2 Новые проблемы
Второе, введение системы подтверждения порождает не сразу очевидную вещь, убивающую время создания конспектов. Дело в том, что наш пробный механизм группировки чанков FloatingWindow, порождает много одинаковой информации. Порой дополнительный контекст, который мы несём из предыдущей группы, включает в себя много повторяющейся информации, которую LLM повторно обрабатывает. В таком случае пользователь получает n‑ое количество одинаковых терминов и мыслей, который он должен подтвердить.
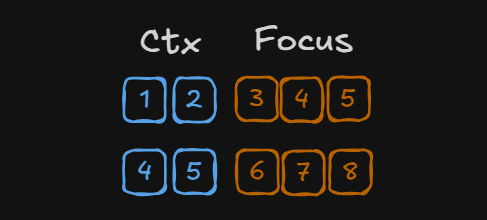
Для решения этой проблемы попрощаемся с наивным подходом. Теперь мы будем разделять текст на котором у нас фокус работы и дополнительный контекст, не объединяя их в одну chunk group. LLM мы укажем, что сущности для конспекта мы можем выделять только из фокус группы, а контекст используем только в случае, когда он дополняет сущность из фокус группы.
По итогу LLM не плодит новые сущности в рамках одной сессии, а если пользователь решил посмотреть другое видео по этой теме или пересмотреть старое видео, он сможет вручную убедиться что в базу не запишется лишняя информация.
5. Доведение до «production»
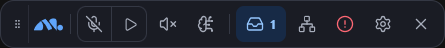
Чтобы приложением можно было удобно пользоваться, ему необходим UI, желательно графический. Основную рабочую панель я решил сделать небольшим виджетом, это позволяет всегда держать под рукой необходимые кнопки запуска записи и в целом весь рабочий функционал, при этом приложение не занимает много места на экране.
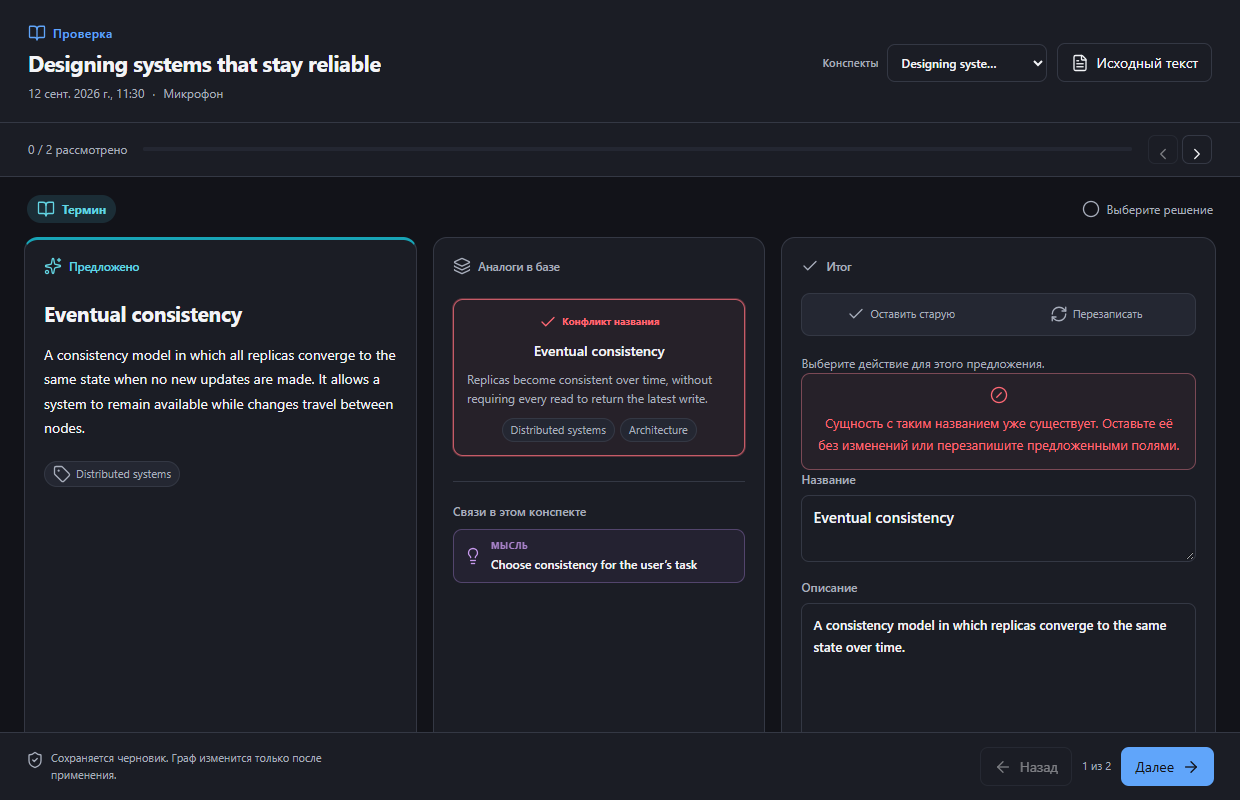
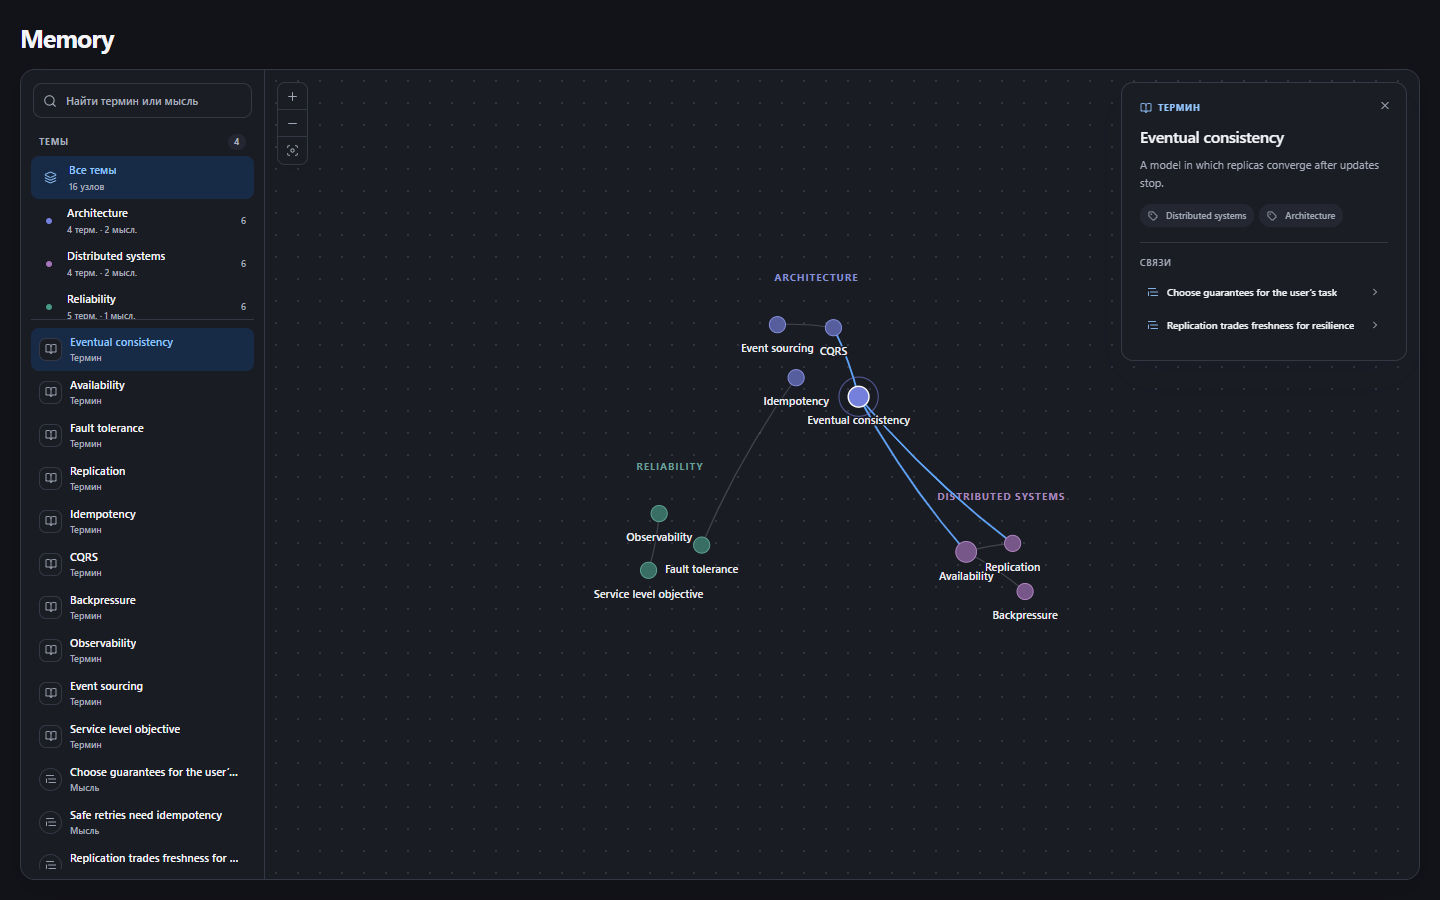
Предполагалось, что конспекты будут экспортироваться в Obsidian, но ради полноценности внутри самого приложения было добавлено собственное визуальное представление базы знаний, хотя экспорт в Obsidian так же возможен. В принципе, ни что не мешает по разному интерпретировать получаемую информацию, речь не только о построении базы знаний, это может быть summary созвона, история твоего дня и много еще чего, всё что нужно, написать необходимый «интерпретатор».
В конце концов, было решено дать этому проекту собственное имя memplua. Я позиционирую это как open‑source проект, было бы замечательно, если бы кому‑нибудь это тоже пригодилось, а кто‑то захотел бы внести свой вклад в развитие этого инструмента. Сейчас проект находиться в alpha стадии, готовый к использованию и дальнейшему улучшению.
Результатами своей работы я вполне доволен, я действительно пользуюсь memplua, потому что мне удалось реализовать все свои идеи такими, какими я их задумывал. Собственно, GitHub проекта: https://github.com/Ijne/memplua. Там можно найти больше документации по проекту, посмотреть код. Удобный установщик можно найти на https://memplua.space, он сразу скачивает все необходимые модели и само приложения.
Всем кто дочитал эту статью, спасибо за внимание!
Автор: ijne

